העדפות
הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף
הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף

מצא ותקן שגיאות סריקה: DNS, שרת, robots.txt, 404, soft 404 ושגיאות הפניה. איך Googlebot מגיב לכל אחת, ושיטה ב-6 צעדים לתקן אותן לפי הסדר.
כלים

בקצרה
שגיאות סריקה הן בקשות שמנוע חיפוש או סורק בינה מלאכותית שולח לאתר שלך ונכשלות: השרת לא עונה בזמן, ה-DNS לא מגיב, אי אפשר לטעון את robots.txt, הפניה נכנסת ללולאה, או שהעמוד מחזיר קוד 4xx או 5xx. שגיאות ברמת האתר (DNS, שרת, robots.txt) עלולות לעצור את הסריקה של Google בכל האתר, לכן תקן אותן ראשונות; שגיאות ברמת הכתובת (404, soft 404, שגיאות הפניה) חשובות רק כשהן פוגעות בעמודים שאתה רוצה שיאונדקסו. מוצאים אותן בדוחות Crawl Stats ו-Page indexing של Search Console, מאמתים עם כלי סריקה ועם יומני השרת, ואז מתקנים את הסיבה ומאשרים את התיקון.
רוצים להעמיק? שאלו את
שאלון קצר
מי צריך לתקן את הצד הטכני של האתר שלכם?
ההמלצה שלנו עבורכם
בדקו בעצמכם עם הכלים החינמיים של Google
Search Console מפרט את הדפים ש-Google לא מצליח לקרוא, ו-PageSpeed Insights בודק מהירות. הרבה בעיות קטנות מתקנים מההגדרות של בונה האתרים שלכם.
ההמלצה שלנו עבורכם
מפתח אתרים
הבעיה שלכם בקוד או בשרת: מפתח שמבין ב-SEO הוא האדם הנכון. תנו לו את רשימת השגיאות מ-Search Console.
ההמלצה שלנו עבורכם
כלי לבדיקה טכנית
יש באתר שלכם הרבה דפים: סורק קורא את כולם כמו ש-Google עושה ונותן רשימה מלאה של שגיאות לתיקון, דף אחר דף.
ההמלצה שלנו עבורכם
בדיקה אוטומטית, ואז תוכן
האתר שלכם עובד אבל מביא מעט מבקרים: בעיות טכניות הן רק לעיתים רחוקות הסיבה. Sorank בודק את האתר, ואז כותב את הדפים שמביאים תנועה.
סורק פועל כמו מבקר סבלני מאוד. הוא מבקש מהשרת שלך כתובת, מחכה לתשובה, קורא את קוד הסטטוס ואת התוכן, ואז עובר לקישורים שמצא. שגיאת סריקה היא כל שלב בשרשרת הזו שנכשל. המבקר אף פעם לא מקבל עמוד שמיש.
ההגדרה הזו חשובה כי דוחות רבים מערבבים שגיאות סריקה עם החלטות אינדוקס. "Crawled, currently not indexed" אינה שגיאת סריקה: Google טען את העמוד בהצלחה ובחר לא לשמור אותו. גם "Excluded by noindex" אינה שגיאת סריקה: אתה ביקשת מ-Google להסיר את העמוד. שגיאת סריקה פירושה שהטעינה עצמה נכשלה.
Google מחלקת את הבעיות לשתי רמות, וכדאי שגם אתה תעשה כך.
שגיאות אתר מול שגיאות כתובת
חנות עם 4000 כתובות מוצר ישנות שמחזירות 404 יכולה להיות בריאה לגמרי אם המוצרים האלה נעלמו לתמיד. אותה חנות עם קובץ robots.txt שמחזיר 503 במשך שש שעות נמצאת במצב חירום אמיתי, גם אם כל עמודי המוצר עובדים. התחל במארח, אחר כך בכתובות שמכניסות כסף, ואחר כך בכל השאר.
כדי לתקן שגיאות סריקה כמו שצריך, צריך לדעת מה Google באמת עושה כשהיא נתקלת באחת מהן. התיעוד של Google על איך קודי סטטוס HTTP ושגיאות רשת משפיעים על חיפוש Google (Google Search Central) קובע את הכללים. הנה מה שהם אומרים בפועל.
| תגובה | מה Google עושה | האם זו בעיה? |
|---|---|---|
| 2xx | מעבירה את התוכן לאינדוקס. האינדוקס אינו מובטח. | לא, אלא אם העמוד ריק (soft 404). |
| 301, 308 | אות חזק שהיעד הוא הכתובת החדשה. | לא, אם זו קפיצה אחת ל-200. |
| 302, 303, 307 | אות חלש: הכתובת המקורית נוטה להישאר הכתובת הקנונית. | כן, אם המעבר קבוע. |
| שרשראות 3xx | עוקבת עד 10 קפיצות כברירת מחדל, ואז מוותרת. | כן: כל קפיצה מבזבזת בקשה, ולולאות אף פעם לא נפתרות. |
| 404, 410 וקודי 4xx אחרים (חוץ מ-429) | מתייחסת לתוכן כלא קיים, מסירה כתובות מאונדקסות עם הזמן וסורקת אותן פחות. | רק אם העמוד אמור להתקיים. |
| 401, 403 | כמו קודי 4xx אחרים. הם לא מאטים את הסריקה. | כן, אם הם חוסמים את Googlebot מעמודים ציבוריים. |
| 429 | מטופל כאות לעומס בשרת, כמו 5xx. | כן: הסריקה מואטת. |
| 5xx | מאטה את הסריקה ביחס לכמות השגיאות. כתובות שממשיכות להיכשל מוסרות מהאינדקס. | כן, תמיד. |
שני פרטים מפילים צוותים רבים. ראשית, 401 ו-403 לא מורידים את קצב הסריקה. אם השרת שלך מתקשה, החזרת 403 ל-Googlebot לא עוזרת; Google מבקשת להחזיר 503 או 429 באופן זמני במקום. שנית, 404 אינו עונש. זו התשובה הנכונה לעמוד שכבר לא קיים.
התיעוד של דוח Crawl Stats (Search Console Help) מסביר את הכלל. קובץ robots.txt שעונה 200 (גם אם ריק) או 403, 404 או 410 (אין קובץ) תקין. קובץ robots.txt שעונה 429 או 5xx הוא כשל, ואז Google נוקטת זהירות.
מה Google עושה כש-robots.txt ממשיך להיכשל
מקור: Google Search Console Help, דוח Crawl Stats
לכן כלל ב-CDN או חומת אש שמחזירים 503 על /robots.txt יכולים להקפיא את כל האתר שלך לחצי יום, גם אם כל שאר הכתובות תקינות. בדוק את הקובץ הזה ראשון בכל חקירה של שגיאות סריקה. המדריך שלנו על הסטטוס "Blocked by robots.txt" עוסק בבעיה ההפוכה, כשהקובץ עובד אבל חוסם יותר מדי.
מגבלות הסריקה של Google שכדאי לזכור
מקורות: Google Search Central, קודי סטטוס HTTP ושגיאות רשת; Search Console Help, דוח Crawl Stats
הנה הרשימה המלאה שתפגוש ב-Search Console ובכלי סריקה, עם הסיבה והתיקון לכל אחת. השמות לקוחים מהתיעוד של דוח Page indexing (Search Console Help).
Google לא הצליחה לתרגם את שם הדומיין שלך לכתובת IP, או ששרת ה-DNS לא ענה. סיבות נפוצות: דומיין שפג תוקפו, תקלה אצל ספק ה-DNS, רשומה שגויה אחרי מעבר, או הגדרת DNSSEC שגויה. בדוק עם שאילתה מחוץ לרשת שלך:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
התיקון: תקן את הרשומות, הורד את ה-TTL לפני כל מעבר, והשתמש בספק DNS עם גיבוי. אם קיימים גם example.com וגם www.example.com, שניהם חייבים להיתרגם, גם אם אחד מהם רק מפנה.
השרת לא ענה בזמן, סגר את החיבור, או ענה 500, 502, 503 או 504. סיבות טיפוסיות: מסד נתונים עמוס, תהליך PHP או Node שקורס תחת עומס, פסק זמן ב-reverse proxy, עדכון תוסף, או חומת אש שמגבילה קצב לבוטים. הסתכל על הדפוס בזמן: שגיאות באותה שעה כל לילה מצביעות לרוב על גיבוי או משימת cron.
התיקון: קרא את יומן השגיאות של השרת בזמנים ש-Google מדווחת, הגדל פסקי זמן או מספר תהליכים, שמור במטמון עמודים כבדים, וודא שהגנת הבוטים מאפשרת ל-Googlebot מאומת לעבור. לתחזוקה מתוכננת, החזר 503 עם כותרת Retry-After ולא עמוד 200 שאומר "נחזור בקרוב":
HTTP/1.1 503 Service Unavailable
Retry-After: 3600העמוד לא קיים. זה בסדר כשהוא נמחק בכוונה ושום דבר לא מקשר אליו. זו בעיה כשלכתובת עדיין יש קישורים נכנסים, תנועה או קישורים פנימיים, או כשהעמוד אמור להתקיים ופריסה שברה אותו.
התיקון: אם התוכן עבר, הוסף הפניית 301 אחת למקבילה הקרובה ביותר. אם הוא נעלם לתמיד, השאר 404 או השתמש ב-410, והסר את הקישורים הפנימיים ואת רשומות מפת האתר שמצביעים עליו. לעולם אל תפנה כל 404 לדף הבית: Google נוטה להתייחס אליהן כ-soft 404.
השרת אומר 200 אבל העמוד נראה ריק או אומר "לא נמצא": קטגוריה ריקה, עמוד חיפוש בלי תוצאות, מוצר שאזל מהמלאי בלי תוכן. Google מבזבזת בקשה ולא מקבלת כלום. אנחנו מכסים אותה לעומק במדריך שלנו על שגיאות soft 404.
Googlebot אף פעם לא שולח פרטי התחברות, לכן 401 או 403 על עמוד ציבורי פירושו שהשרת שלך או שכבת אבטחה חוסמים אותו. אשמים נפוצים: סיסמת סביבת הבדיקות שנשארה בייצור, כלל WAF, חסימה לפי מדינה, או כלל הגנה מקישור ישיר שהוחל על HTML. תקן את הכלל, לא את הסימפטום, ובדוק עם כלי URL Inspection ב-Search Console.
Google מדווחת על שגיאת הפניה כשהיא נתקלת בלולאה, בשרשרת ארוכה מדי, בכתובת שחורגת מהאורך המרבי, או בכתובת שגויה או ריקה בשרשרת. המקרה הקלאסי אחרי מעבר: מ-http ל-https, אחר כך ל-www, אחר כך ללוכסן בסוף, אחר כך לנתיב חדש. ארבע קפיצות במקום שאחת מספיקה. המדריך המלא שלנו על הפניות ב-SEO מסביר איך לקצר אותן.
טיפ
הדבק כל כתובת חשודה בבודק ההפניות החינמי של Sorank: הוא עוקב אחרי השרשרת המלאה, מציג כל קפיצה ואת קוד הסטטוס שלה, ואומר לך איפה הלולאה או הקפיצה המיותרת.
חלק מהשגיאות לא מציגות שום קוד סטטוס. העמוד מתחיל להיטען ונעצר, או שהוא כבד כל כך שהסורק קורא רק חלק ממנו. הסורקים של Google קוראים מספר מוגבל של בתים לכל קובץ, כך שעמוד מנופח בסקריפטים מוטמעים או בתמונות base64 עלול לאבד את התוכן שבתחתיתו. בדוק תבניות כבדות עם בודק גודל העמוד.
אין כלי אחד שמציג את כל שגיאות הסריקה. כל שיטה רואה את הבעיה מזווית אחרת, וביקורת רצינית משלבת לפחות שתיים.
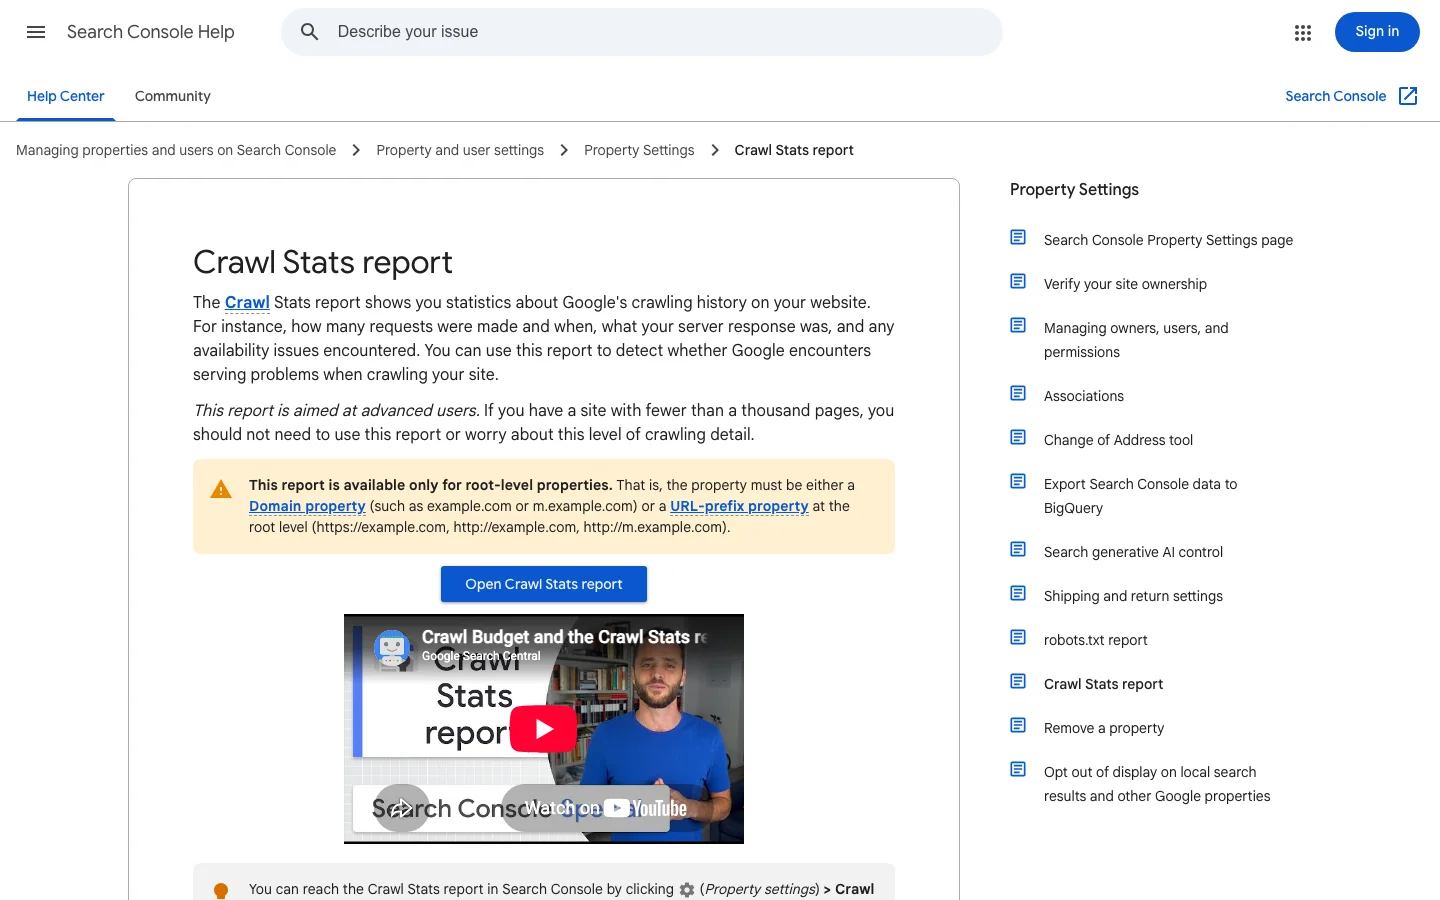
העיקרון: Google מציגה את בקשות הסריקה שלה ב-90 הימים האחרונים, מקובצות לפי תגובה, סוג קובץ, מטרה וסוג Googlebot, וגם את מצב המארח עבור DNS, שרת ו-robots.txt. מתי להשתמש: תמיד, וראשונה, לשגיאות אתר. יתרונות: זו האמת מ-Google עצמה. מגבלות: רק לנכסים ברמת השורש, דוגמאות מדוגמות, ו-Google אומרת שאתרים עם פחות מאלף עמודים כמעט לא צריכים אותו. דוגמה: קפיצה בתגובות "page timeout" כל יום ראשון ב-3 לפנות בוקר שמתאימה לגיבוי של מסד הנתונים.
העיקרון: מציג את הכתובות ש-Google מכירה ולמה הן לא מאונדקסות, עם סיבות כמו Server error (5xx), Redirect error, Not found (404) או Soft 404. מתי להשתמש: למיון שגיאות כתובת ולאימות תיקונים. יתרונות: קשור לעמודים ש-Google באמת ניסתה. מגבלות: הדוחות מתעכבים בימים, רשימות הדוגמאות מוגבלות, והוא מערבב שגיאות סריקה עם בחירות אינדוקס. דוגמה: 300 כתובות תחת "Redirect error" שכולן חולקות את אותה קידומת ישנה /blog/.
העיקרון: כלי כמו Screaming Frog סורק את האתר שלך כמו בוט, עוקב אחרי קישורים מדף הבית, ומתעד כל קוד סטטוס, שרשרת הפניות וקישור שבור. מתי להשתמש: לפני ואחרי מעבר, עיצוב מחדש או פריסה גדולה, ומדי חודש באתרים גדולים. יתרונות: מיידי, מלא עבור עמודים מקושרים, ומראה איפה נמצא כל קישור שבור. מגבלות: הוא לא יודע מה Google באמת ביקשה, מפספס עמודים יתומים, והשרת שלך עשוי להתייחס אליו אחרת מאשר ל-Googlebot. מדריך ההגדרה של Screaming Frog שלנו מוביל ביקורת מלאה.
העיקרון: יומני הגישה מתעדים כל בקשה, כולל של Googlebot, Bingbot, GPTBot, ClaudeBot ו-PerplexityBot, עם קוד הסטטוס המדויק וזמן התגובה. מתי להשתמש: באתרים גדולים, אחרי ירידות תנועה לא מוסברות, וכדי לראות מה סורקי הבינה המלאכותית פוגשים. יתרונות: בקשות אמיתיות, קודים אמיתיים, בלי דגימה, כל הבוטים. מגבלות: צריך גישה ליומנים וקצת כתיבת סקריפטים; צריך לוודא ש-"Googlebot" הוא באמת Google. המדריך שלנו על ניתוח קובצי יומן ל-SEO מוביל צעד אחר צעד. מבט ראשון מהיר:
# Googlebot requests that did not return 200, 301 or 304, most frequent first
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50העיקרון: בדוק כתובת אחת בכל פעם עם curl או בודק חינמי ברשת. מתי להשתמש: כדי לאשר תיקון, או לבדוק עמוד מפתח אחרי פריסה. יתרונות: מיידי ומדויק. מגבלות: לא מתאים לכמויות. השתמש ב-user agent של Googlebot כדי לתפוס כללים שמתייחסים לבוטים אחרת:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| שיטה | רואה שגיאות אתר | רואה שגיאות כתובת | נתוני Googlebot אמיתיים | רואה סורקי בינה מלאכותית | הכי טובה ל |
|---|---|---|---|---|---|
| דוח Crawl Stats | כן | דגימה | כן | לא | בריאות המארח |
| דוח Page indexing | חלקית | כן | כן | לא | מיון ואימות |
| כלי סריקה (Screaming Frog...) | לא | כן, עמודים מקושרים | לא | לא | מציאת קישורים שבורים במקורם |
| יומני שרת | חלקית | כן | כן | כן | אתרים גדולים, סיבות שורש |
| בדיקת כתובת בודדת | לא | אחת בכל פעם | לא | לא | אישור תיקונים |
סטטוס 5xx פירושו שהשרת לא הצליח לטפל בבקשה שנראתה תקינה. Google מאטה את הסריקה בתגובה לכך, ומאטה יותר כשיותר מהכתובות שלכם מחזירות שגיאות. Google שומרת כתובות שכבר מאונדקסות זמן מה, אבל מסירה כתובות שמחזירות שגיאת שרת באופן מתמשך. פרץ קצר מתאושש, כי Google מעלה בהדרגה את קצב הסריקה לאחר שהשרת שלכם עונה בקודי 2xx. רצף ארוך של שגיאות הוא מה שפוגע באינדקס.
לכל קוד 5xx יש חלק אחר בערימה. הטבלה נותנת לכם מקום ראשון לבדוק לכל אחד מהם.
| קוד | מה הוא בדרך כלל אומר | מה לבדוק קודם |
|---|---|---|
| 500 | היישום נכשל בזמן טיפול בבקשה | יומן השגיאות של היישום בזמן המדויק של הבקשה |
| 502 | ה-proxy או ה-CDN קיבלו תשובה לא תקינה מהיישום, לרוב מפני שהוא קרס או הופעל מחדש | הפעלות מחדש וזמינות של תהליך היישום |
| 503 | השירות עמוס, מוגבל בקצב או בתחזוקה | גרפי עומס, היסטוריית פריסות וחלונות תחזוקה |
| 504 | ה-proxy ויתר על המתנה ליישום | שאילתות איטיות למסד הנתונים והגדרות timeout של ה-proxy |
| 429 | מגביל הקצב אומר שיש יותר מדי בקשות | כללי הגבלת הקצב, והאם הם חלים על Googlebot מאומת |
Crawl Stats מציג את הימים והשעות שבהם Google נתקלה בשגיאות (מדריך ה-Crawl Stats שלנו מסביר כל גרף). יומן השרת מראה מה קרה ברגעים המדויקים האלה. סננו את בקשות Googlebot וספרו את תגובות ה-5xx לפי שעה:
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
כל שורת פלט היא שעה, קוד סטטוס וספירה. אשכול באותה שעה בכל לילה מצביע בדרך כלל על גיבוי, משימה מתוזמנת או ייבוא מתוזמן. שגיאות שפזורות לאורך היום מצביעות בדרך כלל על עומס, ולכן התיקון הוא קיבולת או מטמון ולא באג יחיד. לשיטה מעמיקה יותר, ראו את המדריך שלנו לניתוח קובצי לוג.
Google מפחיתה את הסריקה ביחס למספר הכתובות שמחזירות שגיאות. תבנית שבורה שמשפיעה על כמה כתובות עולה לכם מעט זמן סריקה. הפסקת מסד נתונים שמפילה כל עמוד עולה לכם הרבה, ולכן היא צריכה להיות התיקון הראשון.
שגיאת 429 גורמת לאותה השפעה כמו 5xx, כי Google קוראת אותה כשרת עמוס. אם כלל הגבלת הקצב או הגנת הבוטים שלכם מחזיר 429 ל-Googlebot, אתם משלמים על כך בזמן סריקה. התיעוד של Google לא מזכיר את כותרת Retry-After. המשיכו לשלוח אותה לגולשים אנושיים ולקליינטים של API, אבל אל תסתמכו על כך ש-Googlebot יחכה את הזמן שקבעתם.
סטטוס 4xx פירושו שהשרת דחה את הבקשה בגלל משהו בצד הלקוח: הכתובת לא קיימת, הגישה אסורה, או הכתובת מנוסחת לא נכון. Google מתייחסת לכל 4xx מלבד 429 באותה צורה. היא מפסיקה להשתמש בתוכן שמאחורי הכתובת, ואם הכתובת הייתה מאונדקסת, היא מסירה אותה מהאינדקס. לפני שנוגעים בשגיאת 4xx, מוצאים מאיפה הבקשה מגיעה, כי התיקון נמצא לעיתים קרובות במקום אחד: קישור, תבנית או כלל הפניה.
יומן הגישה (access log) רושם את ה-referrer של כל בקשה, כלומר איזה עמוד שלח את הגולש או הבוט לכתובת הזו. ספרו את תגובות ה-4xx לפי נתיב ולפי referrer:
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
קראו את עמודת ה-referrer כך:
שחרור שמשנה נתיב, מחליף slug או בונה מחדש תבנית, מייצר לרוב גל של 404 באותו יום. ייצאו את מספר תגובות ה-4xx לכל יום עבור השבוע שלפני הפריסה והשבוע שאחריה. קפיצה שמרוכזת בתיקייה אחת מצביעה ישירות על השינוי. הוסיפו את ההפניה מהכתובת הישנה לחדשה באותו שחרור, לא בכרטיס נפרד לאחר מכן. להעברה מלאה, ראו את רשימת הבדיקה להעברת SEO שלנו.
טיפ
אל תחליפו עמוד חסר בתגובת 200 שמציגה הודעה קצרה או רשימה ריקה. Google עשויה לראות בכך soft 404, וזה עולה לה בבקשה מלאה ולא מניב כלום.
זו השיטה שאנחנו משתמשים בה. היא עוברת מהשגיאות שיכולות לעצור את כל האתר שלך לאלה שרק מבזבזות קצת סריקה.
שיטת שגיאות הסריקה ב-6 צעדים
ב-Search Console, פתח Settings, אחר כך Crawl stats, אחר כך Host status. ירוק פירושו שאין בעיה משמעותית ב-90 יום. "Recent issue" פירושו בעיה משמעותית בשבוע האחרון: עזוב כל דבר אחר. לחץ על כל קטגוריה כדי לראות את שיעור הכשל לפי יום, ואז התאם את הימים הרעים להיסטוריית האחסון, ה-CDN והפריסות שלך.
פתח Indexing, אחר כך Pages, וייצא כל סיבת שגיאה. אל תתקן כתובות אחת אחת. שים אותן בגיליון אלקטרוני וחלץ את התיקייה הראשונה:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")טבלת ציר על העמודה הזו מראה בדרך כלל שרוב השגיאות מגיעות משתיים או שלוש תבניות: קטגוריית בלוג שהוצאה משימוש, פרמטר סינון, פיד מוצרים ישן.
לכל דפוס, שאל ארבע שאלות. האם הוא מקבל קליקים אורגניים? האם יש לו קישורים נכנסים? האם הוא מקושר פנימית? האם הוא במפת האתר? 404 בלי אף אחד מהארבעה יכול לחכות לנצח. 404 עם קישורים נכנסים צריך 301 היום. בודק הקישורים השבורים החינמי מראה אילו מהעמודים שלך עדיין מקשרים לכתובות מתות.
תקן כללים, לא כתובות. מפת הפניות בהגדרות השרת עדיפה על 400 הפניות שנוספו ידנית בתוסף. לדוגמה, ב-nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
עבור 5xx, תקן את הקיבולת או את הבאג. עבור 401 ו-403, תקן את כלל האבטחה. עבור soft 404, הוסף תוכן אמיתי או החזר 404 אמיתי.
כל קישור פנימי צריך להצביע ישירות על כתובת שמחזירה 200. כל רשומה במפת האתר צריכה להיות כתובת קנונית, ניתנת לאינדוקס, שמחזירה 200. מפת אתר מלאה בהפניות וב-404 מלמדת את Google לסמוך עליה פחות. המדריך שלנו על איך ליצור מפת אתר מסביר מה שייך אליה.
בדוח Page indexing, פתח את הסיבה שתוקנה ולחץ Validate fix. Google בודקת קודם דגימה, ואז את השאר; זה לוקח בדרך כלל עד כשבועיים, וזה נעצר אם אפילו כתובת אחת עדיין נכשלת. אל תלחץ שוב בזמן שזה רץ. אחר כך קבע שגרה שבועית: Crawl Stats למארח, יומנים לקפיצות, סריקה אחרי כל פריסה.
שרשרת הפניות לפני ואחרי התיקון
מה זה: תוסף או כלל ששולח כל כתובת חסרה אל /. איך מזהים: הרבה כתובות ב-"Soft 404" או "Page with redirect" שכולן נוחתות בדף הבית; כלי סריקה מראה מאות 301 עם אותו יעד. איך מתקנים: הפנה רק למקבילה קרובה, ותן לשאר להחזיר 404 או 410.
מה זה: WAF, מנהל בוטים או מגביל קצב שמגיש ל-Google קוד 403, 429 או עמוד אתגר. איך מזהים: 403 או 429 ב-Crawl Stats, בזמן שהעמוד נטען היטב בדפדפן שלך; היומנים מראים את החסימות לפי IP. איך מתקנים: אפשר ל-Googlebot מאומת, בעזרת DNS הפוך או טווחי ה-IP ש-Google מפרסמת, במקום לסמוך על מחרוזת ה-user agent.
מה זה: robots.txt שהאפליקציה מייצרת, כך שהוא נכשל בכל פעם שהאפליקציה נכשלת, או שמוגש דרך כלל ב-CDN ששומר 5xx במטמון. איך מזהים: קטגוריית טעינת robots.txt ב-Host status אינה ירוקה. איך מתקנים: הגש אותו כקובץ סטטי, מחוץ לאפליקציה, ובדוק אותו עם בודק robots.txt.
מה זה: עמוד "נחזור בקרוב" שמוגש עם סטטוס 200 בכל הכתובות. איך מזהים: אחרי התחזוקה, גל של soft 404 או כותרות כפולות. איך מתקנים: החזר 503 עם Retry-After בזמן התחזוקה, ושמור אותה קצרה.
מה זה: לענות 403 ל-Googlebot כשהשרת עמוס. איך מזהים: קפיצות ב-403 שמתאימות לקפיצות עומס. איך מתקנים: Google אומרת שלקודי 4xx מלבד 429 אין השפעה על קצב הסריקה. החזר 503 או 429 לזמן קצר, ותקן את הקיבולת.
מה זה: ללחוץ על רשימת Search Console ולערוך כל כתובת. איך מזהים: אותה סיבה חוזרת כל חודש. איך מתקנים: קבץ לפי דפוס, תקן את התבנית או את הכלל, ואז אמת פעם אחת.
מה זה: לבזבז ימים על 404 של כתובות ספאם או עמודים שנמחקו מזמן בלי קישורים. איך מזהים: לכתובות אין קליקים, אין קישורים נכנסים ואין קישורים פנימיים. איך מתקנים: עזוב אותן. Google אומרת ש-404 לעמוד שהוסר אינה בהכרח בעיה.
אזהרה
לעולם אל תחסום כתובת ב-robots.txt כדי "להסתיר" שגיאת סריקה. Google כבר לא תוכל לראות את ה-404 או את ההפניה, הכתובת עלולה להישאר מאונדקסת, ואתה מאבד את האות שניסית לשלוח.
באתר עם כמה מאות עמודים, ל-Google יש זמן להכול, ושגיאות סריקה חשובות בעיקר לעמודים שהן שוברות. באתרים גדולים (חנויות עם מסננים, שווקים מקוונים, חדשות), כל בקשה שנכשלה או בוזבזה לוקחת זמן מהעמודים האמיתיים שלך. זה הרעיון שמאחורי תקציב סריקה.
5xx ו-429 גורמים ל-Google להאט בכל המארח, כך שכמה תבניות שבורות יכולות לעכב את סריקת עמודי המוצר החדשים שלך. שרשראות הפניות עולות בקשה לכל קפיצה. Soft 404 עולה טעינה מלאה ולא נותנת כלום. תקן את שלושתן ואותו תקציב יכסה יותר עמודים מועילים.
כש-Google מוצאת כתובות אבל דוחה את סריקתן, הסיבה היא לרוב שרת שהיא מחשיבה שביר. אם אתה רואה ספירה עולה של "Discovered, currently not indexed" יחד עם שגיאות שרת ב-Crawl Stats, תקן קודם את השרת. שני הדוחות מספרים את אותו סיפור.
Googlebot כבר אינו המבקר היחיד שחשוב. GPTBot, OAI-SearchBot, ClaudeBot ו-PerplexityBot טוענים עמודים כדי לאמן מודלים או כדי לענות על שאלות בזמן אמת. הם פוגעים באותו שרת, וסובלים מאותן שגיאות, עם הבדל אחד: אין להם Search Console.
רוב סורקי הבינה המלאכותית לא מריצים JavaScript, כך שעמוד שבונה את התוכן שלו רק בדפדפן עלול להיראות להם ריק, סוג של soft 404 שלעולם לא תראה בדוחות של Google. רבים מהם חסומים כברירת מחדל על ידי שירותי הגנת בוטים, לרוב עם 403. ומכיוון שהם טוענים לפי דרישה כשמשתמש שואל שאלה, פסק זמן באותו רגע פירושו שהתשובה מצטטת מישהו אחר. המדריך שלנו על SEO ל-JavaScript עוסק ברינדור גם לסורקי חיפוש וגם לסורקי בינה מלאכותית.
יומני השרת שלך הם המקור האמין היחיד. סנן לפי user agent והסתכל על קודי הסטטוס:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnאם בוטים של בינה מלאכותית מקבלים 403 שלא התכוונת אליהם, תקן את הכלל. אחר כך בדוק אם הם באמת מצטטים אותך: מעקב האזכורים בבינה מלאכותית של Sorank עוקב כמה פעמים ChatGPT, Gemini, Claude ו-Perplexity מזכירים את המותג שלך, כך שתוכל לראות אם תיקון סריקה משנה משהו.
הרץ את הרשימה הזו אחרי כל מעבר, עיצוב מחדש או פריסה גדולה, ופעם בחודש באתרים גדולים.
רשימת בדיקה לבריאות הסריקה
פתח את Crawl Stats ובדוק את שלוש שורות מצב המארח. אחר כך הרץ את בודק יכולת האינדוקס החינמי על חמשת העמודים החשובים ביותר שלך. אם שניהם נקיים, ייצא את שגיאות Page indexing וקבץ אותן לפי תיקייה: עכשיו יש לך רשימת תיקונים קצרה וממוינת במקום דוח מפחיד.
כשהסריקה נקייה, המגבלה הבאה היא התוכן עצמו. אופטימיזציית התוכן של Sorank כותבת מחדש ומרעננת את העמודים הקיימים שלך ב-autopilot, כך שהעמודים ש-Google יכולה להגיע אליהם עכשיו שווים אינדוקס וציטוט. לעמודים ש-Google סרקה והשאירה בחוץ, קרא את המדריך שלנו על "Crawled, currently not indexed".
שגיאות סריקה הן בקשות של מנוע חיפוש או סורק בינה מלאכותית שנכשלות: ה-DNS לא מתרגם, השרת מתעכב או מחזיר 5xx, אי אפשר לטעון את robots.txt, הפניה נכנסת ללולאה, או שהעמוד מחזיר קוד 4xx. שגיאות ברמת האתר עלולות לעצור את סריקת כל האתר, בעוד ששגיאות כתובת פוגעות רק בעמוד הנוגע בדבר.
לא כשלעצמן. Google אומרת ש-404 לעמוד שהוסר בלי תחליף אינה בהכרח בעיה. היא הופכת לבעיה כשלכתובת עדיין יש קישורים נכנסים, תנועה או קישורים פנימיים, ואז התיקון הנכון הוא הפניית 301 אחת למקבילה קרובה.
אחרי לחיצה על Validate fix בדוח Page indexing של Search Console, האימות לוקח בדרך כלל עד כשבועיים. Google בודקת קודם דגימה של כתובות ואז את השאר, וזה נעצר אם אפילו כתובת אחת עדיין נכשלת.
אנחנו מנתחים את המתחרים שלכם, את האתר שלכם ואת הנראות שלכם ב-AI כדי ליצור עבורכם תוכנית תוכן מותאמת אישית בחינם.
 מחולל תדריך תוכן בבינה מלאכותית
 מחולל סכמת FAQ
 מחולל רעיונות למאמרים בבינה מלאכותית
 בודק נתונים מובנים (Schema Validator)
 בודק טקסט חלופי
 מנתח קישורים פנימיים
 אתגר הבקלינקים
 מחולל תיאורי מטא ב-AI
 מחולל כותרות לבלוג ב-AI
 בודק יכולת אינדוקס ב-Google
 מחולל מבנה מאמר ב-AI
 מחולל קישורי UTM
 כלי לקיבוץ מילות מפתח
 בודק תגית קנונית
 מחולל מפת אתר XML
 בודק קישורים שבורים
 מחולל כותרות SEO ב-AI
 מנתח כותרות
 תצוגה מקדימה של תוצאות Google
 בודק הפניות
 מחולל תגיות hreflang
 מנתח מבנה כותרות
 בודק כותרות HTTP
 מחלץ Favicon
 מחשבון נתח קול ב-SEO
 מחשבון תחזית תנועה והכנסות SEO
 מחשבון תקציב SEO
 סימולטור שיפור דירוג
 מחשבון השקעה בתוכן GEO
 מחשבון CTR
 מחשבון חיסכון: SEO מול חיפוש ממומן
 מחשבון ציון הזדמנות למילת מפתח
 מחשבון תנועת הפניה מ-ChatGPT
 מחשבון נתח קול ב-AI
 כלי דירוג Gemini
 מחולל llms.txt
 בודק Sitemap
 ממיר עמודי אינטרנט ל-Markdown
 מונה מילים
 מחולל Schema
 תצוגה מקדימה של Open Graph
 כלי לדחיסת תמונות
 כלי לניתוח קישורים נכנסים
 מחשבון נקודת איזון ל-SEO
 מחשבון זמן קריאה
 מחשבון ROI ל-GEO
 מחשבון ROI לקישורים נכנסים
 בדיקת נתונים מובנים עבור LLM
 ביקורת GEO
 חיישן תנודתיות בתוצאות החיפוש
 מחולל כתובות URL
 מחולל תגיות מטא
 כלי מחקר מילות מפתח
 מחשבון CTR בתוצאות החיפוש
 מחשבון ROI ל-SEO
 מחשבון יחס LTV ל-CAC
 מעריך תנועה אורגנית ובודק תנועה לאתרים
 מחשבון עלות בניית קישורים
 מחשבון ערך חיי לקוח
 מחשבון עלות למאמר
 מחשבון שיעור המרה
 מחשבון שיעור נטישה
 מחשבון ערך התנועה מ-AI
 בודק AI Overview ובודק מיקומים ב-AI Overviews
 ביקורת AI SEO
 אודיט אופטימיזציה למנועי תשובות
 מחשבון ROI ל-SEO של SaaS
 מחשבון ROAS
 מחשבון ROI ל-SEO מקומי
 מחשבון ערך מילת מפתח
 מחשבון צפיפות מילות מפתח
 מחשבון ROI ל-SEO בסחר אלקטרוני
 מחשבון עלות רכישת לקוח
 מחשבון ROI לשיווק תוכן
 מחשבון ציון נראות ב-AI
 מחשבון עלות ההיעדרות מתשובות ה-AI
 מחשבון שיעור ציטוט בבינה מלאכותית
 בודק ציטוטי LLM
 בדיקת SEO בעמוד: בודק SEO ומנתח SEO
 מחשבון ערך תנועה אורגנית
 מאמת llms.txt
 בודק קריאות ל-LLM
 בדיקת מוכנות ל-SearchGPT
 בדיקת סריקה לסורקי בינה מלאכותית
 למה ChatGPT לא ממליץ על האתר שלי
 בודק דירוג ב-Perplexity
 בדיקת נראות בחיפוש מבוסס AI
 בודק נראות ב-ChatGPT
 מחלץ כתובות URL
 בודק גודל עמוד
 מחולל robots.txt
 מחולל Favicon
 בודק robots.txt
 בודק סמכות דומיין
 “אנחנו סוכנות פרסום (Ads) ורצינו סוף סוף להחזיר את ה-SEO שלנו למסלול. Sorank נתנה לנו תמונה ברורה של האתר שלנו, עזרה לנו לתעדף אופטימיזציות ולבנות נכון את התוכן. הכלי קל לשימוש, מעוצב היטב לעבודת צוות, ומאוד מעשי לריכוז המעקב בלי לקפוץ בין מספר פלטפורמות. בסיס איתן מאוד לפתיחת דף חדש עם ה-SEO שלנו.”
 Gaspard Madouiסוכנות פרסום (Ads)“במשך שנתיים, 100% מהלקוחות שלי הגיעו מ-LinkedIn. פרסום יומי, תגובות, מעקבים בהודעות פרטיות... תלות מוחלטת באלגוריתם. ידעתי שאני צריך לעבוד על SEO אבל תמיד דחיתי את זה: ארוך מדי, טכני מדי, לא התחום שלי. עם Sorank, סוף סוף עשיתי את הצעד. בתוך 4 חודשים, אני מייצר 15 לידים אורגניים בחודש בלי לפרסם כלום. זה עדיין לא 50/50 מול LinkedIn, אבל אני ישן טוב יותר בידיעה שיש לי עכשיו מקור לידים שני שגדל באופן אוטומטי.”

 Valentin Thomyoffbound.fr
 “פשוט נתתי לתוכנה של Sorank לעשות את שלה, ועכשיו ציון DR של האתר שלי הוא 25 והדף שלי מדורג גבוה יותר.”
 Lucas Flandrefoundertrace.fr“פתרון מצוין לניהול SEO בלי כאב ראש. הביקורות מהירות, הממשק ברור, ואתה רואה במהירות אילו פעולות ליישם. זה הפך לכלי חיוני למעקב ולשיפור ה-SEO של האתרים שלי. ממליץ בחום.”
 Xavיזם