Confidențialitatea contează pentru noi, așa că ai opțiunea de a dezactiva anumite tipuri de stocare care nu sunt necesare pentru funcționarea de bază a site-ului. Blocarea categoriilor poate afecta experiența ta pe site. Mai multe informații (Politica privind cookie-urile)
Mulțumim! Trimiterea ta a fost primită!
Ups! A apărut o eroare la trimiterea formularului.
Erori de crawling: cum găsești, prioritizezi și repari fiecare tip
Găsește și repară erorile de crawling: DNS, server, robots.txt, 404, soft 404 și redirecționări. Cum reacționează Googlebot și o metodă în 6 pași, în ordinea corectă.
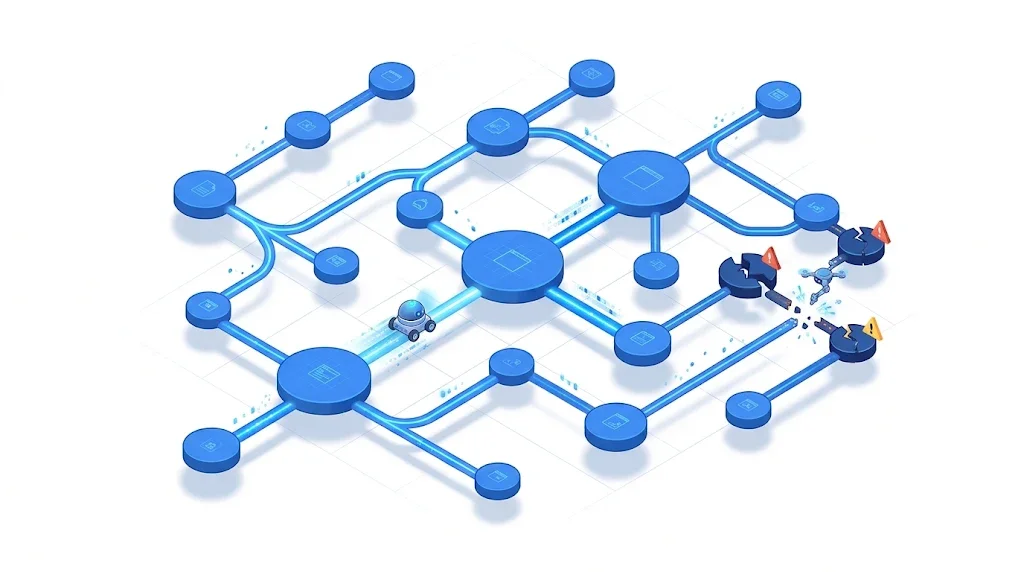
O hartă a unui site în care câteva pagini sunt marcate cu semnale de eroare, în timp ce un crawler urmărește linkurile dintre ele.
Instrumente
Pe această pagină
Pe scurt
erorile de crawling (crawl errors) sunt cererile pe care un motor de căutare sau un crawler AI le face către site-ul tău și care eșuează: serverul depășește timpul de răspuns, DNS-ul nu răspunde, robots.txt nu poate fi preluat, o redirecționare intră în buclă sau o pagină returnează un cod 4xx sau 5xx. Erorile la nivel de site (DNS, server, robots.txt) pot opri Google din crawlingul întregului site, așa că repară-le primele; erorile la nivel de URL (404, soft 404, erori de redirecționare) contează doar când afectează pagini pe care vrei să le ai în index. Le găsești în rapoartele Statistici privind accesarea cu crawlere și Indexarea paginilor din Search Console, le confirmi cu un crawler și cu logurile serverului, apoi repari cauza și validezi.
Cine ar trebui să repare partea tehnică a site-ului tău?
Întrebarea 1 din 425%
Recomandarea noastră pentru tine
Verifică singur cu instrumentele gratuite Google
Search Console listează paginile pe care Google nu le poate citi, iar PageSpeed Insights testează viteza. Multe probleme mici se rezolvă din setările constructorului tău de site.
Recomandarea noastră pentru tine
Un dezvoltator web
Problema ta este în cod sau pe server: un dezvoltator care cunoaște SEO este persoana potrivită. Dă-i lista erorilor din Search Console.
Recomandarea noastră pentru tine
Un instrument de audit tehnic
Site-ul tău are multe pagini: un crawler le citește pe toate, așa cum face Google, și oferă o listă completă de erori de corectat, pagină cu pagină.
Recomandarea noastră pentru tine
Un audit automat, apoi conținut
Site-ul tău funcționează, dar aduce puțini vizitatori: problemele tehnice rareori sunt cauza. Sorank auditează site-ul, apoi scrie paginile care aduc trafic.
Ce sunt erorile de crawling și ce nu sunt
Un crawler se comportă ca un vizitator foarte răbdător. Cere serverului un URL, așteaptă răspunsul, citește codul de stare și conținutul, apoi trece la linkurile găsite. O eroare de crawling este orice pas din acest lanț care eșuează. Vizitatorul nu primește niciodată o pagină utilizabilă.
Definiția contează, pentru că multe rapoarte amestecă erorile de crawling cu deciziile de indexare. „Accesată cu crawlere, neindexată momentan” nu este o eroare de crawling: Google a preluat pagina fără probleme și a ales să nu o păstreze. „Exclusă de eticheta noindex” nu este nici ea: tu i-ai cerut lui Google să elimine pagina. O eroare de crawling înseamnă că preluarea în sine a eșuat.
Două familii: erori de site și erori de URL
Google împarte problemele pe două niveluri, iar tu ar trebui să faci la fel.
Erori de site (Google le numește probleme de stare a gazdei): eșecuri de rezolvare DNS, eșecuri de conectare la server și eșecuri de preluare a robots.txt. Afectează fiecare URL de pe gazdă. O zi proastă aici poate îngheța crawlingul întregului site.
Erori de URL: o pagină returnează 404, 410, 401, 403, 5xx, soft 404 sau o redirecționare defectă. Afectează doar acel URL, iar multe sunt inofensive.
Erori de site și erori de URL
Erori de site (repară azi)
DNS-ul nu se rezolvă
Serverul depășește timpul sau închide conexiunea
robots.txt returnează 5xx sau 429
Vizibile în Statistici de crawling, Starea gazdei
Pot opri crawlingul fiecărei pagini
Erori de URL (triere)
404, 410, soft 404
401, 403, alte 4xx
Buclă de redirecționare sau lanț prea lung
Vizibile în raportul Indexarea paginilor
Contează doar pe paginile pe care vrei să le indexezi
De ce această distincție îți schimbă prioritățile
Un magazin cu 4000 de URL-uri vechi de produse care returnează 404 poate fi perfect sănătos dacă acele produse au dispărut definitiv. Același magazin cu un robots.txt care returnează 503 timp de șase ore are o urgență reală, chiar dacă fiecare pagină de produs funcționează. Începe cu gazda, apoi cu URL-urile care aduc bani, apoi cu restul.
Trimite conținutul spre indexare. Indexarea nu este garantată.
Nu, decât dacă pagina e goală (soft 404).
301, 308
Semnal puternic că ținta este noul URL.
Nu, dacă este un singur salt către 200.
302, 303, 307
Semnal slab: URL-ul original tinde să rămână canonic.
Da, dacă mutarea este permanentă.
Lanțuri 3xx
Urmează implicit cel mult 10 salturi, apoi renunță.
Da: fiecare salt irosește o cerere, iar buclele nu se rezolvă niciodată.
404, 410, alte 4xx (în afară de 429)
Consideră conținutul inexistent, elimină treptat URL-urile indexate, le accesează mai rar.
Doar dacă pagina ar trebui să existe.
401, 403
La fel ca alte 4xx. Nu încetinesc crawlingul.
Da, dacă blochează Googlebot pe pagini publice.
429
Tratat ca semnal de suprasolicitare a serverului, ca un 5xx.
Da: crawlingul încetinește.
5xx
Încetinește crawlingul proporțional cu erorile. URL-urile care eșuează constant sunt scoase din index.
Da, întotdeauna.
Două detalii păcălesc multe echipe. Primul: 401 și 403 nu reduc rata de crawling. Dacă serverul are probleme, să returnezi 403 către Googlebot nu ajută; Google cere să returnezi temporar 503 sau 429. Al doilea: un 404 nu este o penalizare. Este răspunsul corect pentru o pagină care nu mai există.
Eșecurile robots.txt sunt cele mai periculoase
Documentația raportului Statistici privind accesarea cu crawlere (Ajutor Search Console) explică regula. Un robots.txt care răspunde 200 (chiar gol) sau 403, 404 ori 410 (fără fișier) este în regulă. Un robots.txt care răspunde 429 sau 5xx este un eșec, iar Google joacă atunci la sigur.
Ce face Google când robots.txt eșuează în continuu
Primele 12 oreGoogle oprește complet crawlingul site-ului.
Până la 30 de zileGoogle folosește ultimul robots.txt preluat cu succes.
După 30 de zileComportamentul depinde de accesibilitatea paginii de start.
Sursă: Ajutor Google Search Console, raportul Statistici privind accesarea cu crawlere
Așadar, o regulă CDN sau un firewall care servește 503 pe /robots.txt poate îngheța întregul site pentru o jumătate de zi, chiar dacă toate celelalte URL-uri funcționează. Verifică acest fișier primul în orice investigație de erori de crawling. Ghidul nostru despre starea „Blocată de robots.txt” tratează problema opusă: fișierul funcționează, dar blochează prea mult.
Limitele de crawling Google de reținut
10salturi de redirecționare urmate cel mult de crawlerele Google
12 hoprire a crawlingului când robots.txt returnează 5xx sau 429
30 de zileGoogle continuă să folosească ultimul robots.txt valid
5%rată zilnică de eșec DNS dată ca exemplu de problemă a gazdei
Surse: Google Search Central, coduri de stare HTTP și erori de rețea; Ajutor Search Console, raportul Statistici privind accesarea cu crawlere
Erorile de crawling sunt punctele în care drumul unui crawler prin site-ul tău se întrerupe.
Fiecare tip de eroare de crawling, explicat cu soluția sa
Iată lista completă pe care o vei întâlni în Search Console și în crawlere, cu cauza și soluția pentru fiecare. Denumirile urmează documentația raportului Indexarea paginilor (Ajutor Search Console).
Erori DNS
Google nu a putut transforma numele domeniului într-o adresă IP sau serverul DNS nu a răspuns. Cauze frecvente: domeniu expirat, pană la furnizorul DNS, înregistrare greșită după o migrare sau DNSSEC configurat greșit. Verifică printr-o interogare din afara rețelei tale:
Soluție: corectează înregistrările, scade TTL-ul înaintea oricărei migrări și folosește un furnizor DNS cu redundanță. Dacă există atât example.com, cât și www.example.com, ambele trebuie să se rezolve, chiar dacă unul doar redirecționează.
Erori de conectare la server și 5xx
Serverul nu a răspuns la timp, a închis conexiunea sau a răspuns cu 500, 502, 503 sau 504. Cauze tipice: o bază de date suprasolicitată, un proces PHP sau Node care cade sub sarcină, un timeout al proxy-ului invers, o actualizare de plugin sau un firewall care limitează boții. Uită-te la tiparul orar: erorile la aceeași oră în fiecare noapte indică adesea un backup sau o sarcină cron.
Soluție: citește logul de erori al serverului la orele raportate de Google, crește timpii de așteptare sau numărul de workeri, pune în cache paginile grele și asigură-te că protecția anti-boți lasă să treacă Googlebot verificat. Pentru mentenanța planificată, returnează 503 cu antetul Retry-After în loc de o pagină 200 cu mesajul „revenim curând”:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 și 410 (Negăsit)
Pagina nu există. Este în regulă dacă a fost ștearsă intenționat și nimic nu trimite spre ea. Devine o problemă când URL-ul încă are backlinkuri, trafic sau linkuri interne, ori când pagina ar trebui să existe și o publicare a stricat-o.
Soluție: dacă conținutul s-a mutat, adaugă un singur 301 către cel mai apropiat echivalent. Dacă a dispărut definitiv, păstrează 404 sau folosește 410 și elimină linkurile interne și intrările din sitemap care trimit spre el. Nu redirecționa niciodată toate paginile 404 către pagina de start: Google tinde să le trateze ca soft 404.
Soft 404
Serverul spune 200, dar pagina pare goală sau scrie „negăsit”: o categorie goală, o pagină de căutare fără rezultate, un produs epuizat fără conținut. Google consumă o cerere și nu primește nimic. Tratăm subiectul în detaliu în ghidul nostru despre erorile soft 404.
401, 403 și alte 4xx
Googlebot nu trimite niciodată date de autentificare, deci un 401 sau 403 pe o pagină publică înseamnă că serverul sau un strat de securitate îl blochează. Vinovați obișnuiți: o parolă de staging rămasă în producție, o regulă WAF, o blocare pe țară sau o protecție anti-hotlink aplicată pe HTML. Repară regula, nu simptomul, și testează cu instrumentul Inspectarea adresei URL din Search Console.
Erori de redirecționare
Google raportează o eroare de redirecționare când dă de o buclă, un lanț prea lung, un URL care depășește lungimea maximă sau un URL greșit ori gol în lanț. Cazul clasic după o migrare: http spre https, apoi spre www, apoi spre bara finală, apoi spre o cale nouă. Patru salturi acolo unde ar ajunge unul. Ghidul nostru complet despre redirecționările SEO explică cum să le reduci.
Sfat
Lipește orice URL suspect în verificatorul gratuit de redirecționări Sorank: urmărește tot lanțul, arată fiecare salt și codul său de stare și îți spune unde este bucla sau saltul în plus.
Timeouturi, răspunsuri trunchiate și pagini prea mari
Unele erori nu arată niciodată un cod de stare. Pagina începe să se încarce și se oprește sau este atât de grea încât crawlerul citește doar o parte. Crawlerele Google citesc un număr limitat de octeți pe fișier, așa că o pagină umflată cu scripturi inline sau imagini base64 poate pierde conținutul de la final. Verifică șabloanele grele cu verificatorul de dimensiune a paginii.
Toate metodele de a găsi erorile de crawling, comparate
Niciun instrument singur nu arată toate erorile de crawling. Fiecare metodă vede problema din alt unghi, iar un audit serios combină cel puțin două.
Metoda 1: Search Console, raportul Statistici privind accesarea cu crawlere
Principiu: Google îți arată propriile cereri de crawling din ultimele 90 de zile, grupate după răspuns, tip de fișier, scop și tip de Googlebot, plus starea gazdei pentru DNS, server și robots.txt. Când o folosești: mereu și prima, pentru erorile de site. Avantaje: sunt datele reale, direct de la Google. Limite: doar pentru proprietățile la nivel de rădăcină, exemplele sunt eșantionate, iar Google spune că site-urile sub o mie de pagini rareori au nevoie de el. Exemplu: un vârf de răspunsuri „pagina a depășit timpul” în fiecare duminică la ora 3 noaptea, care coincide cu un backup al bazei de date.
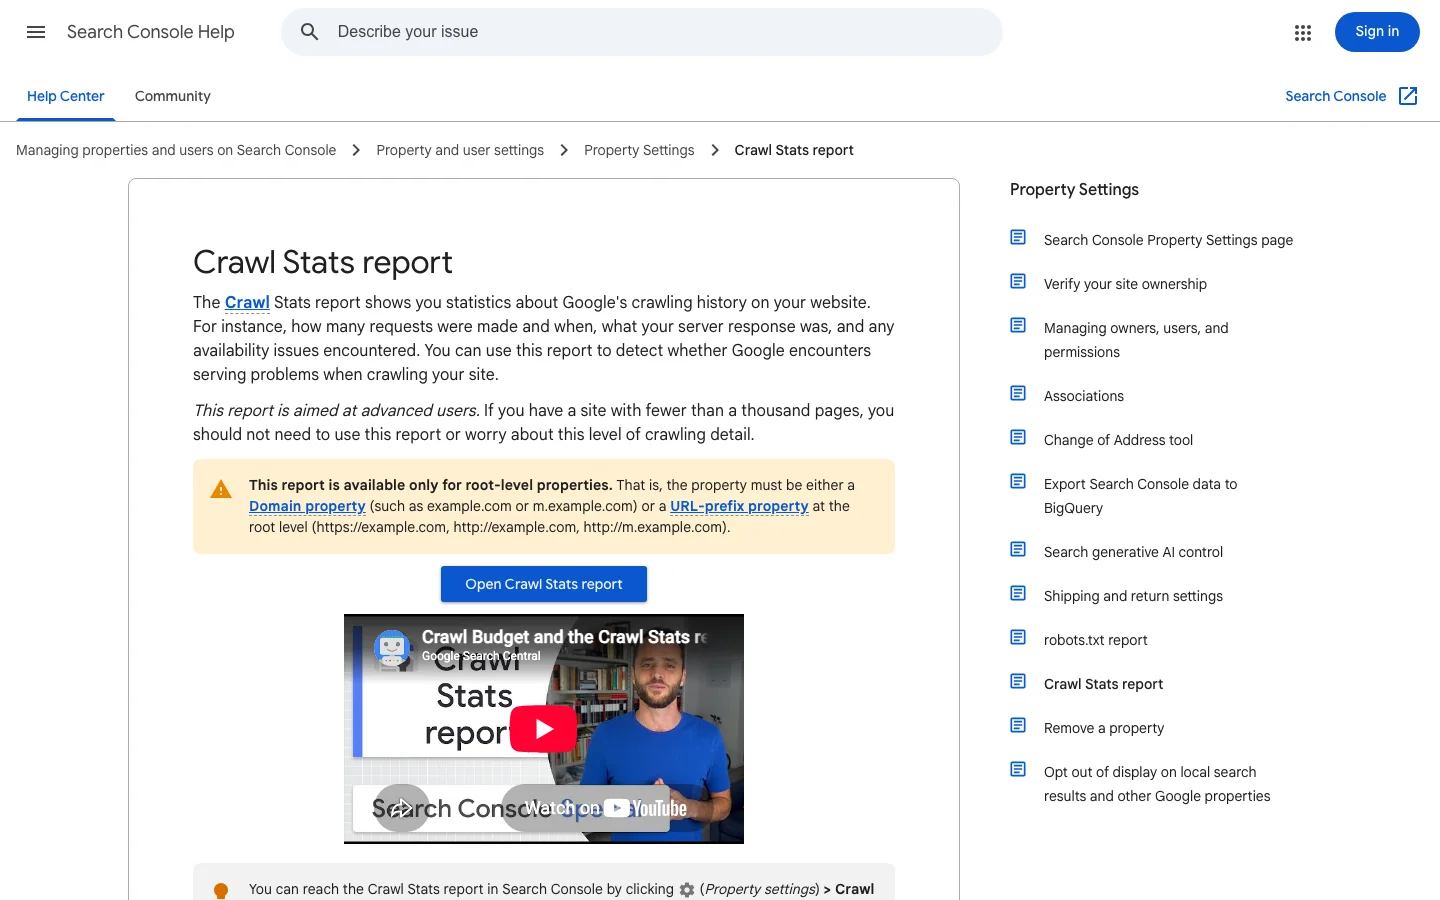
Documentația Google a raportului Statistici privind accesarea cu crawlere, unde este explicată starea gazdei pentru DNS, server și robots.txt.
Metoda 2: Search Console, raportul Indexarea paginilor și Inspectarea adresei URL
Principiu: listează URL-urile cunoscute de Google și motivele pentru care nu sunt indexate, de exemplu Eroare de server (5xx), Eroare de redirecționare, Negăsit (404) sau Soft 404. Când o folosești: pentru trierea erorilor de URL și validarea remedierilor. Avantaje: legată de paginile pe care Google chiar le-a încercat. Limite: rapoartele au întârzieri de câteva zile, listele de exemple sunt limitate și amestecă erorile de crawling cu alegerile de indexare. Exemplu: 300 de URL-uri la „Eroare de redirecționare”, toate cu același vechi prefix /blog/.
Metoda 3: Un crawler desktop sau în cloud
Principiu: un instrument precum Screaming Frog parcurge site-ul ca un bot, urmărind linkurile de la pagina de start, și înregistrează fiecare cod de stare, lanț de redirecționare și link defect. Când o folosești: înainte și după o migrare, un redesign sau o publicare mare, și lunar pe site-urile mari. Avantaje: imediat, complet pentru paginile legate, arată unde se află fiecare link defect. Limite: nu știe ce a cerut de fapt Google, ratează paginile orfane, iar serverul îl poate trata altfel decât pe Googlebot. Ghidul nostru de configurare Screaming Frog te conduce printr-un audit complet.
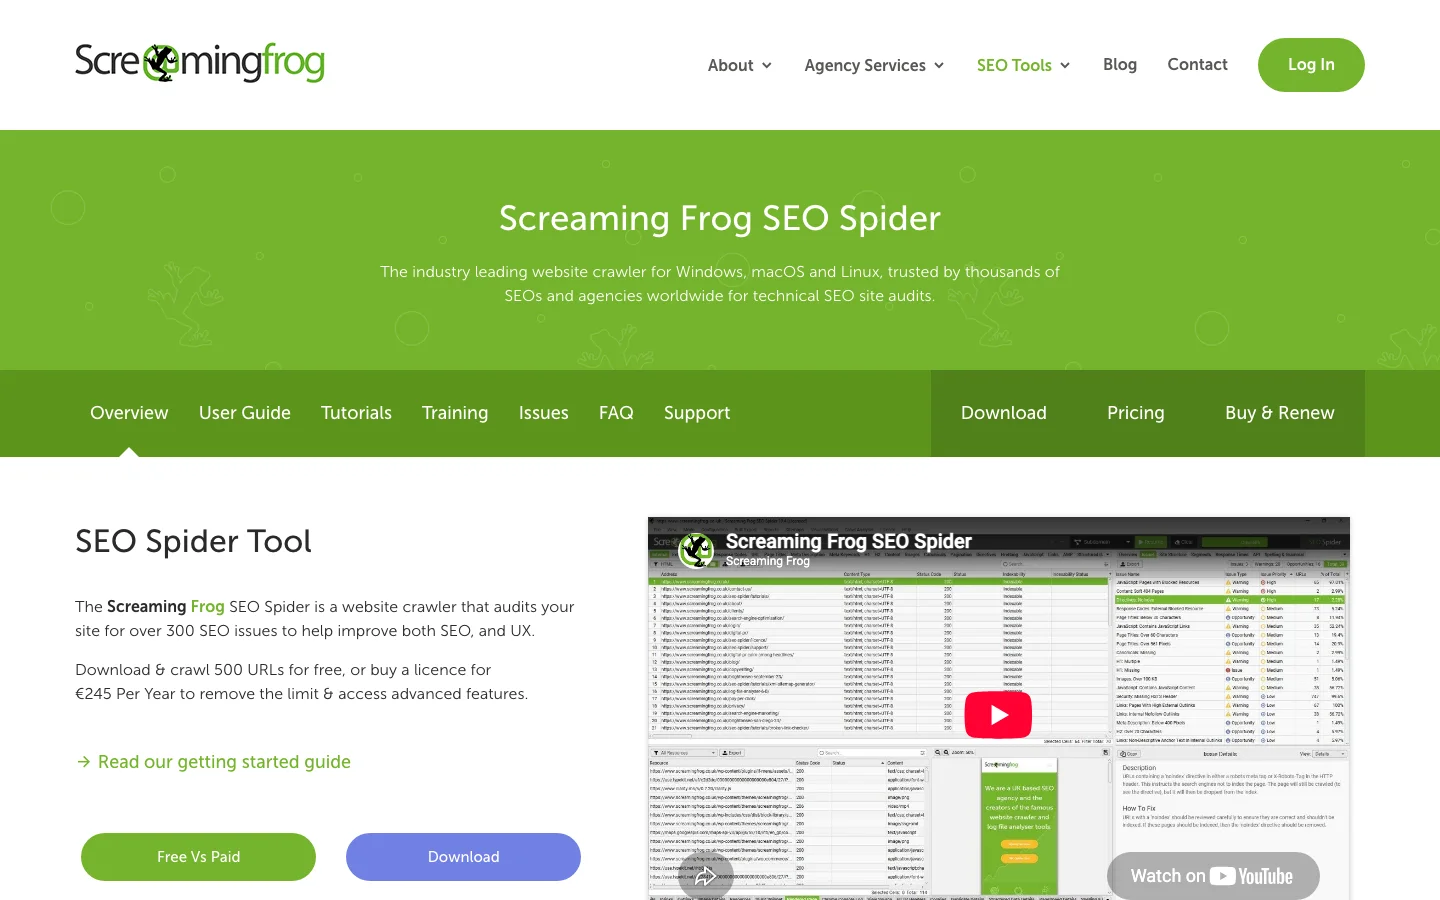
Screaming Frog SEO Spider parcurge site-ul ca un bot și listează fiecare cod de stare, lanț de redirecționare și link defect.
Metoda 4: Analiza logurilor serverului
Principiu: logurile de acces înregistrează fiecare cerere, inclusiv de la Googlebot, Bingbot, GPTBot, ClaudeBot și PerplexityBot, cu codul de stare exact și timpul de răspuns. Când o folosești: pe site-uri mari, după scăderi de trafic inexplicabile și ca să vezi ce accesează crawlerele AI. Avantaje: cereri reale, coduri reale, fără eșantionare, toți boții. Limite: necesită acces la loguri și puțin scripting; trebuie să verifici că „Googlebot” este într-adevăr Google. Ghidul nostru despre analiza fișierelor de log pentru SEO merge pas cu pas. O primă privire rapidă:
# Cereri Googlebot care nu au returnat 200, 301 sau 304, cele mai frecvente primele
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Metoda 5: Verificări pe URL-uri individuale
Principiu: testează câte un URL cu curl sau cu un verificator online gratuit. Când o folosești: ca să confirmi o remediere sau să verifici o pagină importantă după o publicare. Avantaje: instant și precis. Limite: nu se scalează. Folosește un user agent Googlebot ca să prinzi regulile care tratează boții altfel:
Erori 5xx: citește codul de stare ca să găsești stratul care a eșuat
Un status 5xx înseamnă că serverul n-a putut procesa o cerere care părea validă. Google își încetinește crawlingul ca răspuns și îl încetinește mai mult când tot mai multe dintre URL-urile tale returnează erori. Google păstrează pentru o vreme URL-urile deja indexate, dar elimină URL-urile care returnează constant o eroare de server. O scurtă rafală de erori se poate recupera, pentru că Google crește treptat rata de crawling după ce serverul tău răspunde din nou cu coduri 2xx. Ce îți dăunează indexului este o serie lungă de erori.
Codul îți arată ce strat s-a defectat
Fiecare cod 5xx indică o altă parte a stivei. Tabelul îți oferă un prim loc unde să te uiți pentru fiecare.
Cod
De obicei înseamnă
Verifică mai întâi
500
Aplicația a eșuat în timp ce procesa cererea
Logul de erori al aplicației, exact la momentul cererii
502
Proxy-ul sau CDN-ul a primit de la aplicație un răspuns invalid, adesea pentru că aplicația a căzut sau a repornit
Reporniri și uptime-ul procesului aplicației
503
Serviciul este supraîncărcat, limitat ca rată sau în mentenanță
Grafice de încărcare, istoricul deploy-urilor și ferestrele de mentenanță
504
Proxy-ul a renunțat să mai aștepte aplicația
Interogări lente către baza de date și setările de timeout ale proxy-ului
429
Un limitator de rată spune că sunt prea multe cereri
Regulile de limitare a ratei și dacă se aplică Googlebot-ului verificat
Potrivește marcajele de timp Google cu logurile tale
Crawl Stats arată zilele și orele în care Google a întâlnit erori (ghidul nostru despre Crawl Stats explică fiecare grafic). Logul serverului tău arată ce s-a întâmplat exact în acele momente. Filtrează cererile Googlebot și numără răspunsurile 5xx pe oră:
Fiecare linie din rezultat este o oră, un cod de stare și un număr. O grupare în aceeași oră în fiecare noapte indică de obicei un backup, un job cron sau un import programat. Erorile împrăștiate pe toată ziua indică de obicei încărcarea, deci remedierea este capacitatea sau cache-ul, nu un singur bug. Pentru o metodă mai detaliată, vezi ghidul nostru despre analiza logurilor de fișiere.
Măsoară costul unui 5xx înainte să intri în panică
Google reduce crawlingul proporțional cu numărul de URL-uri care returnează erori. Un șablon defect care afectează câteva URL-uri te costă puțin timp de crawling. O pană de baze de date care strică fiecare pagină te costă mult, iar aceasta trebuie reparată prima.
Un 429 are același efect ca un 5xx, pentru că Google îl citește ca pe un server supraîncărcat. Dacă limitatorul de rată sau protecția împotriva botilor returnează 429 către Googlebot, plătești prin timpul de crawling. Documentația Google nu menționează antetul Retry-After. Continuă să-l trimiți vizitatorilor reali și clienților API, dar nu conta pe faptul că Googlebot va aștepta timpul pe care l-ai stabilit.
Erori 4xx: află de unde vin înainte să le repari
Un status 4xx înseamnă că serverul a respins cererea din cauza unui lucru de partea clientului: URL-ul nu există, accesul este interzis sau adresa este malformată. Google tratează toate codurile 4xx, cu excepția lui 429, în același fel. Încetează să folosească conținutul din spatele acelui URL și scoate URL-ul din index dacă fusese indexat. Înainte să atingi un 4xx, află de unde vine cererea, pentru că remedierea se află adesea într-un singur loc: un link, un șablon sau o regulă de redirecționare.
Găsește sursa fiecărui 4xx în loguri
Logul de acces înregistrează referrerul fiecărei cereri, care îți arată ce pagină a trimis vizitatorul sau botul la acel URL. Numără răspunsurile 4xx după cale și după referrer:
Un referrer de pe propriul domeniu înseamnă că una dintre paginile tale trimite spre un URL mort. Repară linkul sau șablonul care îl generează. Aceasta este cea mai valoroasă remediere, pentru că ține de tine. Ghidul nostru despre repararea linkurilor rupte acoperă metoda completă.
Un referrer de pe alt site înseamnă că un backlink indică spre un URL care nu mai funcționează. Dacă linkul merită păstrat, adaugă un singur 301 către cea mai apropiată pagină activă. Dacă nu merită, lasă 404-ul acolo.
Un referrer gol sau o cale pe care n-ai publicat-o niciodată, de exemplu o pagină de login pe un site static, înseamnă de obicei că un bot sau un scanner a încercat adresa. Lasă-l să primească 404 și nu pierde timp cu asta.
Prinde vârfurile de 4xx imediat după fiecare lansare
O lansare care redenumește o rută, schimbă un slug sau reconstruiește un șablon produce adesea un val de erori 404 în aceeași zi. Exportă numărul de răspunsuri 4xx pe zi pentru săptămâna dinaintea deploy-ului și săptămâna de după. O creștere concentrată într-un singur folder indică direct schimbarea. Adaugă redirecționarea de la vechiul URL la cel nou în aceeași lansare, nu într-un tichet ulterior. Pentru o mutare completă, vezi lista noastră de verificare pentru migrarea SEO.
Sfat
Nu înlocui o pagină lipsă cu un răspuns 200 care afișează un mesaj scurt sau o listă goală. Google o poate trata ca pe un soft 404, ceea ce costă o descărcare completă și nu oferă nimic în schimb.
Pas cu pas: repară erorile de crawling în ordinea corectă
Aceasta este metoda pe care o folosim. Merge de la erorile care pot opri întregul site la cele care irosesc doar puțin crawling.
Metoda în 6 pași pentru erorile de crawling
Verifică starea gazdeiDeschide Statisticile de crawling și uită-te la DNS, conectarea la server și robots.txt în ultimele 90 de zile.
Exportă și grupează erorile de URLExportă fiecare motiv din Indexarea paginilor și grupează URL-urile după folder sau șablon.
Sortează după valoarePăstrează URL-urile cu trafic, backlinkuri, linkuri interne sau intrări în sitemap.
Repară cauza la nivel de șablonO regulă, o hartă de redirecționări sau o setare de server repară sute de URL-uri.
Curăță semnaleleActualizează linkurile interne și sitemapurile ca să trimită spre URL-urile finale cu 200.
Validează și monitorizeazăApasă Validează remedierea, apoi urmărește săptămânal Statisticile de crawling și logurile.
Pasul 1: verifică întâi gazda
În Search Console, deschide Setări, apoi Statistici privind accesarea cu crawlere, apoi Starea gazdei. Verde înseamnă nicio problemă semnificativă în 90 de zile. „Problemă recentă” înseamnă o problemă serioasă în ultima săptămână: lasă orice altceva. Apasă pe fiecare categorie ca să vezi rata de eșec pe zile, apoi pune zilele proaste în dreptul istoricului de hosting, CDN și publicări.
Pasul 2: exportă și grupează după tipar
Deschide Indexare, apoi Pagini, și exportă fiecare motiv de eroare. Nu repara URL-urile unul câte unul. Pune-le într-o foaie de calcul și extrage primul folder:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
Un tabel pivot pe această coloană arată de obicei că majoritatea erorilor vin din două sau trei șabloane: o categorie de blog retrasă, un parametru de filtrare, un feed vechi de produse.
Pasul 3: sortează după valoarea de business
Pentru fiecare tipar, pune patru întrebări. Primește clicuri organice? Are backlinkuri? Are linkuri interne? Este în sitemap? Un 404 fără niciuna dintre cele patru poate aștepta la nesfârșit. Un 404 cu backlinkuri are nevoie de un 301 chiar azi. Verificatorul gratuit de linkuri defecte arată care dintre paginile tale încă trimit spre URL-uri moarte.
Pasul 4: repară cauza de fond
Repară regulile, nu URL-urile. O hartă de redirecționări în configurația serverului este mai bună decât 400 de redirecționări adăugate manual într-un plugin. De exemplu, în nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Pentru 5xx, repară capacitatea sau bugul. Pentru 401 și 403, repară regula de securitate. Pentru soft 404, fie adaugă conținut real, fie returnează un 404 real.
Pasul 5: curăță linkurile interne și sitemapurile
Fiecare link intern ar trebui să trimită direct spre un URL care returnează 200. Fiecare intrare din sitemap ar trebui să fie un URL canonic, indexabil, cu 200. Un sitemap plin de redirecționări și 404 îl învață pe Google să aibă mai puțină încredere în el. Ghidul nostru despre cum să creezi un sitemap explică ce trebuie să conțină.
Pasul 6: validează și monitorizează
În raportul Indexarea paginilor, deschide motivul reparat și apasă Validează remedierea. Google verifică întâi un eșantion, apoi restul; durează de obicei până la circa două săptămâni și se oprește dacă măcar un URL încă eșuează. Nu apăsa din nou cât timp rulează. Apoi stabilește o rutină săptămânală: Statistici de crawling pentru gazdă, loguri pentru vârfuri, un crawl după fiecare publicare.
Un lanț de redirecționări înainte și după remediere
Înainte
http://site.com/page
301 spre https://site.com/page
301 spre https://www.site.com/page
301 spre https://www.site.com/page/
Linkurile interne încă trimit spre primul URL
După
Un singur 301 direct spre https://www.site.com/page/
Linkuri interne actualizate spre URL-ul final
Sitemapul conține doar URL-ul final
O cerere în loc de patru
Greșeli frecvente și cum le depistezi și le corectezi
Greșeala 1: redirecționarea fiecărui 404 spre pagina de start
Ce este: un plugin sau o regulă care trimite orice URL lipsă spre /. Cum o depistezi: multe URL-uri în „Soft 404” sau „Pagină cu redirecționare” care ajung toate pe pagina de start; un crawler arată sute de 301 cu aceeași țintă. Cum o corectezi: redirecționează doar spre un echivalent apropiat și lasă restul să returneze 404 sau 410.
Greșeala 2: blocarea Googlebot cu instrumente de securitate
Ce este: un WAF, un manager de boți sau un limitator care servește lui Google 403, 429 sau o pagină de verificare. Cum o depistezi: 403 sau 429 în Statisticile de crawling, deși pagina se încarcă normal în browser; logurile arată blocările pe IP. Cum o corectezi: permite Googlebot verificat prin DNS invers sau intervalele IP publicate de Google, în loc să te bazezi pe șirul user agent.
Greșeala 3: un robots.txt fragil
Ce este: un robots.txt generat de aplicație, care deci cade de fiecare dată când cade aplicația, sau servit printr-o regulă CDN care pune în cache un 5xx. Cum o depistezi: categoria de preluare robots.txt din Starea gazdei nu este verde. Cum o corectezi: servește-l ca fișier static, în afara aplicației, și testează-l cu verificatorul de robots.txt.
Greșeala 4: pagini de mentenanță care returnează 200
Ce este: o pagină „Revenim curând” servită cu codul 200 pe fiecare URL. Cum o depistezi: după mentenanță, un val de soft 404 sau de titluri duplicate. Cum o corectezi: în timpul mentenanței returnează 503 cu Retry-After și păstrează intervalul scurt.
Greșeala 5: folosirea lui 403 ca să încetinești Google
Ce este: răspunsul cu 403 către Googlebot când serverul este suprasolicitat. Cum o depistezi: vârfuri de 403 care coincid cu vârfuri de sarcină. Cum o corectezi: Google spune că codurile 4xx, în afară de 429, nu au efect asupra ratei de crawling. Returnează 503 sau 429 pentru scurt timp și crește capacitatea.
Greșeala 6: repararea erorilor una câte una
Ce este: parcurgerea listei din Search Console și editarea fiecărui URL. Cum o depistezi: același motiv revine în fiecare lună. Cum o corectezi: grupează după tipar, repară șablonul sau regula, apoi validează o singură dată.
Greșeala 7: panica din cauza unor 404 inofensive
Ce este: zile întregi pierdute cu 404 pentru URL-uri spam sau pagini șterse demult, fără linkuri. Cum o depistezi: URL-urile nu au clicuri, backlinkuri sau linkuri interne. Cum o corectezi: lasă-le. Google spune că un 404 pentru o pagină eliminată nu este neapărat o problemă.
Atenție
Nu bloca niciodată un URL în robots.txt ca să „ascunzi” o eroare de crawling. Google nu mai poate vedea 404-ul sau redirecționarea, URL-ul poate rămâne indexat și pierzi semnalul pe care voiai să-l transmiți.
Erorile de crawling și bugetul de crawling
Pe un site cu câteva sute de pagini, Google are timp pentru tot, iar erorile de crawling contează mai ales pentru paginile pe care le strică. Pe site-urile mari (magazine cu filtre, marketplace-uri, site-uri de știri), fiecare cerere eșuată sau irosită ia timp paginilor tale reale. Aceasta este ideea din spatele bugetului de crawling.
Cum consumă erorile capacitatea de crawling
5xx și 429 îl fac pe Google să încetinească pe toată gazda, așa că câteva șabloane defecte pot întârzia crawlingul noilor pagini de produs. Lanțurile de redirecționare costă o cerere pe salt. Paginile soft 404 costă o preluare completă și nu aduc nimic. Repară aceste trei lucruri și același buget acoperă mai multe pagini utile.
Ce legătură are „Descoperită, neindexată momentan”
Când Google găsește URL-uri, dar amână crawlingul lor, cauza este adesea un server pe care îl consideră fragil. Dacă vezi un număr tot mai mare de „Descoperită, neindexată momentan” împreună cu erori de server în Statisticile de crawling, repară întâi serverul. Cele două rapoarte spun aceeași poveste.
Erorile de crawling pentru crawlerele AI
Googlebot nu mai este singurul vizitator care contează. GPTBot, OAI-SearchBot, ClaudeBot și PerplexityBot preiau pagini ca să antreneze modele sau să răspundă la întrebări în timp real. Ajung pe același server și suferă de aceleași erori, cu o diferență: pentru ei nu ai Search Console.
Ce se schimbă cu boții AI
Majoritatea crawlerelor AI nu rulează JavaScript, așa că o pagină care își construiește conținutul doar în browser le poate părea goală, un fel de soft 404 pe care nu îl vei vedea niciodată în rapoartele Google. Mulți sunt blocați implicit de serviciile de protecție anti-boți, adesea cu 403. Și pentru că preiau paginile la cerere, când un utilizator pune o întrebare, un timeout în acel moment înseamnă că răspunsul citează pe altcineva. Ghidul nostru despre SEO pentru JavaScript tratează randarea atât pentru motoarele de căutare, cât și pentru crawlerele AI.
Cum îi monitorizezi
Logurile serverului sunt singura sursă de încredere. Filtrează după user agent și uită-te la codurile de stare:
Dacă boții AI primesc 403 pe care nu le-ai vrut, repară regula. Apoi verifică dacă te citează cu adevărat: monitorizarea mențiunilor în AI de la Sorank urmărește cât de des ChatGPT, Gemini, Claude și Perplexity îți menționează brandul, ca să vezi dacă o remediere de crawling schimbă ceva.
Lista ta de verificare pentru sănătatea crawlingului
Parcurge această listă după fiecare migrare, redesign sau publicare majoră și o dată pe lună pe site-urile mari.
Lista de verificare pentru sănătatea crawlingului
Starea gazdei verde pentru DNS, conectarea la server și robots.txt
robots.txt servit ca fișier static și returnează 200
Fără vârfuri de 5xx sau 429 în Statisticile de crawling sau în loguri
Googlebot verificat și boții AI doriți nu sunt blocați de firewall
Fiecare redirecționare este un singur salt, 301 sau 308, spre o pagină 200
Linkurile interne trimit spre URL-urile finale cu 200
Sitemapurile conțin doar URL-uri canonice, indexabile, cu 200
404-urile cu backlinkuri sau trafic redirecționate spre un echivalent apropiat
Paginile goale reparate sau returnează un 404 real
Mentenanța returnează 503 cu Retry-After
Validarea remedierii pornită pentru fiecare motiv corectat
Ce faci chiar azi
Deschide Statisticile de crawling și verifică cele trei linii de stare a gazdei. Apoi rulează verificatorul gratuit de indexabilitate pe cele mai valoroase cinci pagini ale tale. Dacă ambele sunt curate, exportă erorile din Indexarea paginilor și grupează-le după folder: acum ai o listă scurtă și ordonată de remedieri în locul unui raport înspăimântător.
Odată ce crawlingul e curat, următoarea limită este conținutul însuși. Optimizarea conținutului de la Sorank rescrie și actualizează paginile existente pe autopilot, astfel încât paginile la care Google ajunge acum să merite indexate și citate. Pentru paginile pe care Google le-a accesat, dar le-a lăsat deoparte, citește ghidul nostru despre „Accesată cu crawlere, neindexată momentan”.
Întrebări frecvente
Ce sunt erorile de crawling în SEO?
Erorile de crawling sunt cereri ale unui motor de căutare sau ale unui crawler AI care eșuează: DNS-ul nu se rezolvă, serverul depășește timpul sau returnează 5xx, robots.txt nu poate fi preluat, o redirecționare intră în buclă sau o pagină returnează un cod 4xx. Erorile la nivel de site pot opri crawlingul întregului site, iar erorile de URL afectează doar pagina respectivă.
Sunt erorile 404 dăunătoare pentru SEO?
Nu prin ele însele. Google spune că un 404 pentru o pagină eliminată fără înlocuitor nu este neapărat o problemă. Devine una când URL-ul încă are backlinkuri, trafic sau linkuri interne; atunci soluția corectă este o singură redirecționare 301 spre un echivalent apropiat.
Cât durează până când Google vede că erorile de crawling au fost reparate?
După ce apeși Validează remedierea în raportul Indexarea paginilor din Search Console, validarea durează de obicei până la circa două săptămâni. Google verifică întâi un eșantion de URL-uri, apoi restul, și se oprește dacă măcar un URL afectat încă eșuează.
y!
Primește gratuit planul tău de conținut pe 30 de zile
Analizăm concurenții, site-ul tău și vizibilitatea ta în AI pentru a crea gratuit un plan de conținut personalizat.
“Am testat Sorank pe un site real de client și este incredibil. Face tot ce o agenție ți-ar factura 1500$ pe lună. Acum este deja în producție la acel client.”Guillaume Guersanguersanguillaume.com
“Suntem o agenție de publicitate și am vrut să punem în sfârșit SEO-ul pe picioare. Sorank ne-a oferit o viziune clară asupra site-ului nostru, ne-a ajutat să prioritizăm optimizările și să ne structurăm conținutul corect. Instrumentul este ușor de utilizat, bine gândit pentru o echipă și foarte practic pentru a centraliza urmărirea fără să jonglăm între mai multe platforme. O bază foarte solidă pentru a începe din nou cu SEO-ul nostru.”Gaspard MadouiAgenție de publicitate
Dominiqueflight-sensations-idf.comAgrement și aviație
“Am lăsat pur și simplu software-ul Sorank să își facă treaba, iar acum DR-ul meu este 25 și pagina mea se clasează mai sus.”Lucas Flandrefoundertrace.fr
“M-am specializat în GEO datorită Sorank. Clasamentul GEO îmi permite să îmi arăt clienții poziția față de concurenți în ChatGPT. Este un avantaj comercial real.”MélanieFreelancer SEO
“Serviciu excelent, funcționează bine pentru site-ul nostru și ne ajută să înțelegem cum să îl îmbunătățim pentru a ne clasa mai bine pe Google și în alte părți. Felicitări, continuați așa, vă recomand.”Hugo T.Comerciant e-commerce