Настройки
Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее
Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее

Исправьте ошибки сканирования: DNS, сервер, robots.txt, 404, soft 404 и ошибки переадресации. Как реагирует Googlebot и метод исправления в 6 шагов.

Инструменты

Коротко
ошибки сканирования это запросы поисковой системы или AI-краулера к вашему сайту, которые завершаются неудачей: сервер не отвечает вовремя, DNS не отвечает, robots.txt не удаётся загрузить, переадресация зацикливается или страница возвращает код 4xx или 5xx. Ошибки уровня сайта (DNS, сервер, robots.txt) могут остановить сканирование Google по всему сайту, поэтому исправляйте их первыми; ошибки уровня URL (404, soft 404, ошибки переадресации) важны только тогда, когда затрагивают страницы, которые вы хотите видеть в индексе. Вы находите их в отчётах Search Console «Статистика сканирования» и «Индексирование страниц», подтверждаете краулером и серверными логами, затем устраняете причину и запускаете проверку.
Хотите узнать больше? Спросите
Короткий тест
Кто должен исправить техническую часть сайта?
Наш совет для вас
Проверьте сами в бесплатных инструментах Google
Search Console показывает страницы, которые Google не может прочитать, а PageSpeed Insights проверяет скорость. Многие мелкие проблемы решаются в настройках вашего конструктора сайтов.
Наш совет для вас
Веб-разработчик
Проблема в коде или на сервере: нужен разработчик, который разбирается в SEO. Передайте ему список ошибок из Search Console.
Наш совет для вас
Инструмент для технического аудита
На вашем сайте много страниц: краулер прочитает их все так же, как Google, и выдаст полный список ошибок, страница за страницей.
Наш совет для вас
Автоматический аудит, потом контент
Сайт работает, но посетителей мало: технические проблемы редко бывают причиной. Sorank проверяет сайт, а затем пишет страницы, которые приводят трафик.
Краулер работает как очень терпеливый посетитель. Он запрашивает у сервера URL, ждёт ответа, читает код состояния и содержимое, а затем переходит по найденным ссылкам. Ошибка сканирования это любой шаг этой цепочки, который не удался. Посетитель так и не получает пригодную страницу.
Определение важно, потому что многие отчёты смешивают ошибки сканирования с решениями об индексировании. «Страница просканирована, но пока не проиндексирована» не является ошибкой сканирования: Google без проблем загрузил страницу и решил её не сохранять. «Исключено тегом noindex» тоже не ошибка сканирования: вы сами попросили Google убрать страницу. Ошибка сканирования означает, что сбой произошёл в самой загрузке.
Google делит проблемы на два уровня, и вам стоит делать так же.
Ошибки сайта и ошибки URL
Интернет-магазин с 4000 старыми URL товаров, которые возвращают 404, может быть полностью здоров, если эти товары исчезли навсегда. Тот же магазин с robots.txt, который шесть часов возвращает 503, находится в настоящей аварийной ситуации, даже если все карточки товаров работают. Начинайте с хоста, затем с URL, которые приносят деньги, затем со всего остального.
Чтобы правильно исправлять ошибки сканирования, нужно знать, что Google делает на самом деле, когда сталкивается с ними. Документация Google о том, как коды состояния HTTP и сетевые ошибки влияют на Google Поиск (Google Search Central), задаёт правила. Вот что они означают на практике.
| Ответ | Что делает Google | Это проблема? |
|---|---|---|
| 2xx | Передаёт содержимое на индексирование. Индексирование не гарантировано. | Нет, если страница не пустая (soft 404). |
| 301, 308 | Сильный сигнал, что целевой адрес и есть новый URL. | Нет, если это один переход на страницу с кодом 200. |
| 302, 303, 307 | Слабый сигнал: исходный URL обычно остаётся каноническим. | Да, если перенос постоянный. |
| Цепочки 3xx | По умолчанию следует максимум за 10 переходами, затем сдаётся. | Да: каждый переход тратит запрос, а циклы никогда не разрешаются. |
| 404, 410, другие 4xx (кроме 429) | Считает содержимое несуществующим, со временем удаляет проиндексированные URL и сканирует их реже. | Только если страница должна существовать. |
| 401, 403 | Как и другие 4xx. Они не замедляют сканирование. | Да, если блокируют Googlebot на публичных страницах. |
| 429 | Воспринимается как сигнал перегрузки сервера, как 5xx. | Да: сканирование замедляется. |
| 5xx | Замедляет сканирование пропорционально числу ошибок. URL, которые продолжают давать сбой, удаляются из индекса. | Да, всегда. |
На двух деталях спотыкаются многие команды. Во-первых, 401 и 403 не снижают частоту сканирования. Если сервер не справляется, возврат 403 для Googlebot не поможет; Google просит вместо этого временно возвращать 503 или 429. Во-вторых, 404 это не санкция. Это правильный ответ для страницы, которой больше нет.
Документация Google по отчёту «Статистика сканирования» (Справка Search Console) объясняет правило. robots.txt, который отвечает 200 (даже пустой) или 403, 404 либо 410 (файла нет), в порядке. robots.txt, который отвечает 429 или 5xx, считается сбоем, и тогда Google действует осторожно.
Что делает Google, когда robots.txt продолжает давать сбой
Источник: Справка Search Console, отчёт «Статистика сканирования»
Значит, правило CDN или файрвол, отдающие 503 по адресу /robots.txt, могут заморозить весь сайт на полдня, даже если все остальные URL работают. В любом расследовании ошибок сканирования проверяйте этот файл первым. Наше руководство по статусу «Заблокировано в файле robots.txt» разбирает обратную проблему, когда файл работает, но блокирует слишком много.
Лимиты сканирования Google, которые стоит запомнить
Источники: Google Search Central, коды состояния HTTP и сетевые ошибки; Справка Search Console, отчёт «Статистика сканирования»
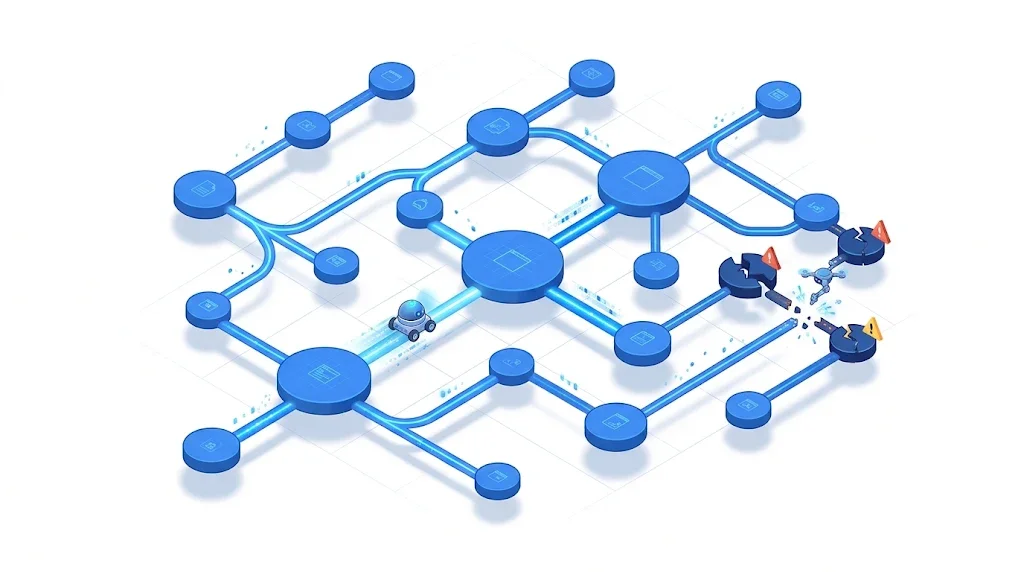
Вот полный список того, что вы встретите в Search Console и в краулерах, с причиной и исправлением для каждого случая. Названия соответствуют документации Google по отчёту «Индексирование страниц» (Справка Search Console).
Google не смог преобразовать доменное имя в IP-адрес, или DNS-сервер не ответил. Частые причины: истёкший домен, сбой у DNS-провайдера, неверная запись после миграции или ошибка в настройке DNSSEC. Проверьте запросом из-за пределов вашей сети:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
Исправление: поправьте записи, снижайте TTL перед любой миграцией и используйте DNS-провайдера с резервированием. Если существуют и example.com, и www.example.com, оба должны разрешаться, даже если один только переадресует.
Сервер не ответил вовремя, закрыл соединение или ответил кодом 500, 502, 503 или 504. Типичные причины: перегруженная база данных, процесс PHP или Node, падающий под нагрузкой, тайм-аут обратного прокси, обновление плагина или файрвол, ограничивающий ботов. Посмотрите на распределение по времени: ошибки в один и тот же час каждую ночь часто указывают на резервное копирование или задачу cron.
Исправление: изучите журнал ошибок сервера в моменты, указанные Google, увеличьте тайм-ауты или число рабочих процессов, кэшируйте тяжёлые страницы и убедитесь, что защита от ботов пропускает проверенный Googlebot. Для плановых работ возвращайте 503 с заголовком Retry-After, а не страницу с кодом 200 и надписью «скоро вернёмся»:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600Страница не существует. Это нормально, если её удалили намеренно и на неё ничего не ссылается. Это проблема, если у URL всё ещё есть обратные ссылки, трафик или внутренние ссылки, или если страница должна существовать, а её сломал деплой.
Исправление: если содержимое переехало, поставьте одну 301 на ближайший аналог. Если оно исчезло навсегда, оставьте 404 или используйте 410 и удалите внутренние ссылки и записи в карте сайта, которые на него ведут. Никогда не переадресуйте все 404 на главную: Google обычно считает такие случаи soft 404.
Сервер отвечает 200, но страница выглядит пустой или сообщает «не найдено»: пустая категория, страница поиска без результатов, товар не в наличии без содержимого. Google тратит на неё запрос и ничего не получает. Мы подробно разбираем это в руководстве по ошибкам soft 404.
Googlebot никогда не отправляет учётные данные, поэтому 401 или 403 на публичной странице означает, что её блокирует ваш сервер или слой защиты. Частые виновники: пароль тестовой среды, забытый на рабочем сайте, правило WAF, блокировка по странам или защита от хотлинкинга, применённая к HTML. Исправляйте правило, а не симптом, и проверяйте инструментом проверки URL в Search Console.
Google сообщает об ошибке переадресации, когда встречает цикл, слишком длинную цепочку, URL длиннее допустимого или неверный либо пустой URL в цепочке. Классический случай после миграции: http на https, затем на www, затем на завершающий слеш, затем на новый путь. Четыре перехода там, где хватило бы одного. Наше полное руководство по SEO-переадресациям объясняет, как их объединить.
Совет
Вставьте подозрительный URL в бесплатный инструмент проверки переадресаций Sorank: он проходит всю цепочку, показывает каждый переход и его код состояния и подсказывает, где находится цикл или лишний переход.
Некоторые ошибки вообще не показывают код состояния. Страница начинает загружаться и останавливается, или она настолько тяжёлая, что краулер читает лишь её часть. Краулеры Google читают ограниченное число байт на файл, поэтому страница, раздутая встроенными скриптами или изображениями в base64, может потерять содержимое внизу. Проверяйте тяжёлые шаблоны инструментом проверки размера страницы.
Ни один инструмент не показывает все ошибки сканирования. Каждый метод видит проблему под своим углом, и серьёзный аудит сочетает как минимум два.
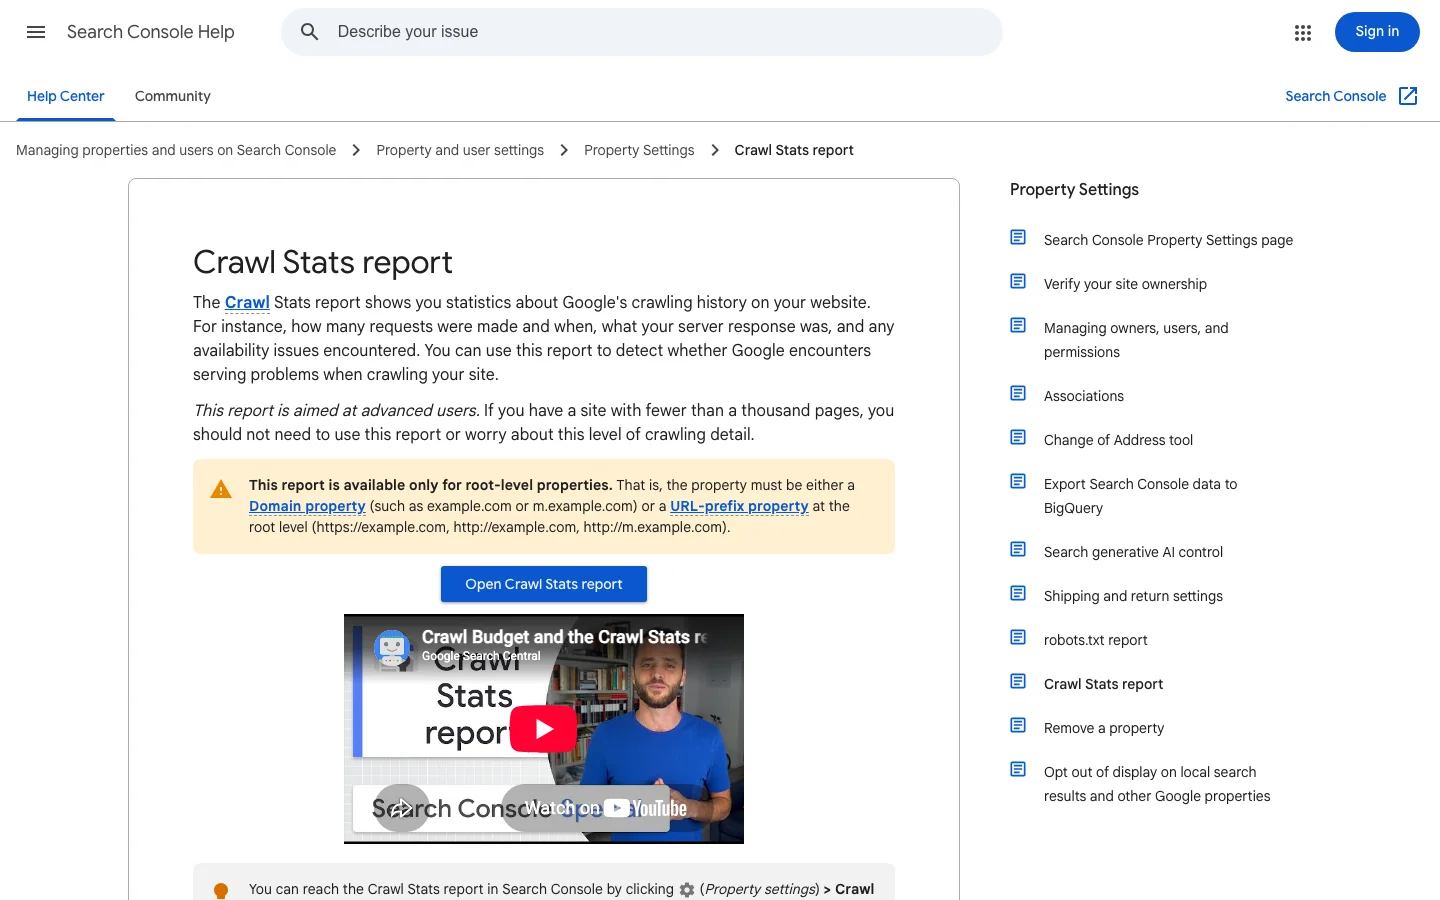
Принцип: Google показывает собственные запросы сканирования за последние 90 дней, сгруппированные по ответу, типу файла, цели и типу Googlebot, а также статус хоста для DNS, сервера и robots.txt. Когда использовать: всегда и в первую очередь для ошибок сайта. Преимущества: это истина из первых рук, от самого Google. Ограничения: только для ресурсов корневого уровня, примеры выборочные, и Google говорит, что сайтам меньше тысячи страниц он редко нужен. Пример: всплеск ответов «тайм-аут страницы» каждое воскресенье в 3 часа ночи, совпадающий с резервным копированием базы данных.
Принцип: перечисляет известные Google URL и причины, по которым они не проиндексированы, например «Ошибка сервера (5xx)», «Ошибка переадресации», «Не найдено (404)» или «Soft 404». Когда использовать: для сортировки ошибок URL и проверки исправлений. Преимущества: привязан к страницам, которые Google действительно пытался загрузить. Ограничения: отчёты запаздывают на несколько дней, списки примеров ограничены, и он смешивает ошибки сканирования с решениями об индексировании. Пример: 300 URL в разделе «Ошибка переадресации», и у всех одинаковый старый префикс /blog/.
Принцип: инструмент вроде Screaming Frog сканирует сайт так, как это сделал бы бот: идёт по ссылкам с главной и записывает каждый код состояния, цепочку переадресаций и битую ссылку. Когда использовать: до и после миграции, редизайна или крупного деплоя, а на больших сайтах ежемесячно. Преимущества: мгновенно, полно для страниц со ссылками, показывает, где находится каждая битая ссылка. Ограничения: не знает, что на самом деле запрашивал Google, пропускает страницы-сироты, а ваш сервер может обращаться с ним иначе, чем с Googlebot. Наше руководство по настройке Screaming Frog проводит через полный аудит.
Принцип: журналы доступа фиксируют каждый запрос, включая запросы Googlebot, Bingbot, GPTBot, ClaudeBot и PerplexityBot, с точным кодом состояния и временем ответа. Когда использовать: на больших сайтах, после необъяснимого падения трафика и чтобы увидеть, что посещают AI-краулеры. Преимущества: реальные запросы, реальные коды, без выборки, все боты. Ограничения: нужен доступ к логам и немного скриптов; необходимо проверять, что «Googlebot» действительно Google. Наше руководство по анализу логов для SEO идёт шаг за шагом. Быстрый первый взгляд:
# Запросы Googlebot, которые не вернули 200, 301 или 304, самые частые сверху
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50Принцип: проверяйте по одному URL через curl или бесплатный онлайн-инструмент. Когда использовать: чтобы подтвердить исправление или проверить ключевую страницу после деплоя. Преимущества: мгновенно и точно. Ограничения: не масштабируется. Используйте user-agent Googlebot, чтобы поймать правила, по-другому обращающиеся с ботами:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| Метод | Видит ошибки сайта | Видит ошибки URL | Реальные данные Googlebot | Видит AI-краулеров | Лучше всего для |
|---|---|---|---|---|---|
| Статистика сканирования | Да | Выборочно | Да | Нет | Здоровье хоста |
| Индексирование страниц | Частично | Да | Да | Нет | Сортировка и проверка |
| Краулер (Screaming Frog...) | Нет | Да, страницы со ссылками | Нет | Нет | Поиск битых ссылок у источника |
| Серверные логи | Частично | Да | Да | Да | Большие сайты, первопричины |
| Проверка одного URL | Нет | По одному | Нет | Нет | Подтверждение исправлений |
Статус 5xx означает, что сервер не смог обработать запрос, который выглядел корректным. Google в ответ снижает частоту сканирования, и снижает сильнее, когда больше ваших URL возвращают ошибки. Google какое-то время сохраняет уже проиндексированные URL, но удаляет те, которые постоянно возвращают ошибку сервера. Короткий всплеск пережить можно: Google постепенно снова повышает частоту сканирования, как только ваш сервер начинает отвечать кодами 2xx. Долгая серия ошибок как раз и портит индекс.
Каждый код 5xx указывает на свою часть стека. Таблица даёт первое место, куда стоит посмотреть для каждого из них.
| Код | Что обычно означает | Что смотреть в первую очередь |
|---|---|---|
| 500 | Приложение дало сбой при обработке запроса | Журнал ошибок приложения на точное время запроса |
| 502 | Прокси или CDN получил некорректный ответ от приложения, часто из-за падения или перезапуска | Перезапуски и время работы процесса приложения |
| 503 | Сервис перегружен, ограничен по частоте запросов или находится на обслуживании | Графики нагрузки, история развёртываний и окна техобслуживания |
| 504 | Прокси перестал ждать ответа от приложения | Медленные запросы к базе данных и настройки таймаута прокси |
| 429 | Ограничитель частоты сообщает, что запросов слишком много | Правила ограничения частоты и то, распространяются ли они на подтверждённого Googlebot |
Статистика сканирования показывает дни и часы, когда Google столкнулся с ошибками (наше руководство по статистике сканирования объясняет каждый график). Серверный журнал показывает, что происходило в эти моменты. Отфильтруйте запросы Googlebot и подсчитайте ответы 5xx по часам:
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
Каждая строка результата: это час, код состояния и количество. Скопление в один и тот же час каждую ночь обычно указывает на резервное копирование, задание cron или запланированный импорт. Ошибки, разбросанные по всему дню, чаще говорят о нагрузке, поэтому решение: мощности или кэширование, а не одна конкретная ошибка. Более глубокий метод описан в нашем руководстве по анализу файлов логов.
Google снижает сканирование пропорционально числу URL, которые возвращают ошибки. Сломанный шаблон, затрагивающий несколько URL, стоит вам немного времени сканирования. Сбой базы данных, который ломает каждую страницу, обходится очень дорого, и его нужно чинить в первую очередь.
Ответ 429 действует так же, как 5xx, потому что Google воспринимает его как перегруженный сервер. Если ваш ограничитель или защита от ботов отдают Googlebot код 429, вы платите за это временем сканирования. В документации Google не упоминается заголовок Retry-After. Продолжайте отправлять его людям и API-клиентам, но не рассчитывайте, что Googlebot подождёт указанное вами время.
Статус 4xx означает, что сервер отклонил запрос из-за чего-то на стороне клиента: URL не существует, доступ запрещён или адрес составлен неверно. Google обрабатывает все коды 4xx, кроме 429, одинаково. Он перестаёт использовать содержимое по этому URL и удаляет URL из индекса, если тот был проиндексирован. Прежде чем трогать 4xx, выясните, откуда приходит запрос, потому что исправление часто находится в одном месте: в ссылке, шаблоне или правиле переадресации.
Журнал доступа фиксирует реферер каждого запроса, то есть показывает, какая страница отправила посетителя или бота на этот URL. Подсчитайте ответы 4xx по путям и по рефереру:
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
Читайте столбец реферера так:
Релиз, который переименовывает маршрут, меняет slug или перестраивает шаблон, часто в тот же день вызывает волну 404. Выгрузите количество ответов 4xx по дням за неделю до выкладки и за неделю после. Рост, сосредоточенный в одной папке, указывает прямо на изменение. Добавьте переадресацию со старого URL на новый в том же релизе, а не в отдельной задаче позже. При полном переносе см. наш чек-лист SEO-миграции.
Совет
Не заменяйте отсутствующую страницу ответом 200, который показывает короткое сообщение или пустой список. Google может счесть её soft 404, и тогда загрузка потратится впустую, а взамен вы ничего не получите.
Это метод, которым пользуемся мы. Он идёт от ошибок, способных остановить весь сайт, к тем, что лишь немного тратят сканирование впустую.
Метод исправления ошибок сканирования в 6 шагов
В Search Console откройте «Настройки», затем «Статистика сканирования», затем «Статус хоста». Зелёный цвет означает отсутствие серьёзных проблем за 90 дней. «Недавняя проблема» означает серьёзную проблему за последнюю неделю: отложите всё остальное. Нажмите на каждую категорию, чтобы увидеть долю сбоев по дням, затем сопоставьте плохие дни с историей хостинга, CDN и деплоев.
Откройте «Индексирование», затем «Страницы», и выгрузите каждую причину ошибки. Не исправляйте URL по одному. Перенесите их в таблицу и извлеките первую папку:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")Сводная таблица по этому столбцу обычно показывает, что большая часть ошибок приходит из двух или трёх шаблонов: закрытой категории блога, параметра фильтра, старого фида товаров.
Для каждого шаблона задайте четыре вопроса. Получает ли он органические клики? Есть ли у него обратные ссылки? Есть ли на него внутренние ссылки? Есть ли он в карте сайта? 404 без всех четырёх признаков может ждать вечно. 404 с обратными ссылками нуждается в 301 уже сегодня. Бесплатный инструмент поиска битых ссылок показывает, какие из ваших страниц всё ещё ссылаются на мёртвые URL.
Исправляйте правила, а не URL. Карта переадресаций в конфигурации сервера лучше, чем 400 переадресаций, добавленных вручную в плагине. Например, в nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Для 5xx исправьте мощность сервера или ошибку. Для 401 и 403 исправьте правило безопасности. Для soft 404 либо добавьте настоящее содержимое, либо возвращайте настоящий 404.
Каждая внутренняя ссылка должна вести прямо на URL, который возвращает 200. Каждая запись в карте сайта должна быть каноническим, индексируемым URL с кодом 200. Карта сайта, полная переадресаций и 404, приучает Google доверять ей меньше. Наше руководство о том, как создать карту сайта, объясняет, что в неё должно входить.
В отчёте «Индексирование страниц» откройте исправленную причину и нажмите «Проверить исправление». Google сначала проверяет выборку, затем остальное; обычно это занимает примерно до двух недель, и проверка останавливается, если хоть один URL всё ещё даёт сбой. Не нажимайте повторно, пока она идёт. Затем заведите еженедельную рутину: «Статистика сканирования» для хоста, логи для всплесков, сканирование после каждого деплоя.
Цепочка переадресаций до и после исправления
Что это: плагин или правило, которое отправляет любой отсутствующий URL на /. Как заметить: много URL в разделах «Soft 404» или «Страница с переадресацией», и все они ведут на главную; краулер показывает сотни 301 с одной и той же целью. Как исправить: переадресуйте только на близкий аналог, а остальные пусть возвращают 404 или 410.
Что это: WAF, менеджер ботов или ограничитель частоты, который отдаёт Google 403, 429 или страницу проверки. Как заметить: 403 или 429 в «Статистике сканирования», при том что в вашем браузере страница открывается нормально; логи показывают блокировки по IP. Как исправить: разрешите проверенный Googlebot через обратный DNS или опубликованные Google диапазоны IP, а не доверяйте строке user-agent.
Что это: robots.txt генерируется приложением и поэтому ломается каждый раз, когда ломается приложение, или отдаётся через правило CDN, которое кэширует 5xx. Как заметить: категория загрузки robots.txt в «Статусе хоста» не зелёная. Как исправить: отдавайте его как статический файл вне приложения и проверяйте инструментом проверки robots.txt.
Что это: страница «Скоро вернёмся», которая отдаётся с кодом 200 на всех URL. Как заметить: после техработ волна soft 404 или дублирующихся заголовков. Как исправить: во время техработ возвращайте 503 с Retry-After и делайте их короткими.
Что это: ответ 403 для Googlebot, когда сервер перегружен. Как заметить: всплески 403, совпадающие с пиками нагрузки. Как исправить: Google говорит, что коды 4xx, кроме 429, не влияют на частоту сканирования. Ненадолго возвращайте 503 или 429 и увеличьте мощность.
Что это: пролистывать список в Search Console и править каждый URL. Как заметить: та же причина возвращается каждый месяц. Как исправить: группируйте по шаблону, исправьте шаблон или правило, затем запустите проверку один раз.
Что это: тратить дни на 404 для спамных URL или давно удалённых страниц без ссылок. Как заметить: у этих URL нет кликов, обратных и внутренних ссылок. Как исправить: оставьте их как есть. Google говорит, что 404 для удалённой страницы не обязательно является проблемой.
Внимание
Никогда не блокируйте URL в robots.txt, чтобы «спрятать» ошибку сканирования. Google больше не увидит 404 или переадресацию, URL может остаться в индексе, а вы потеряете сигнал, который пытались передать.
На сайте из нескольких сотен страниц у Google хватает времени на всё, и ошибки сканирования важны в основном для тех страниц, которые они ломают. На больших сайтах (магазины с фильтрами, маркетплейсы, новостные сайты) каждый неудачный или потраченный впустую запрос отнимает время у ваших настоящих страниц. В этом и состоит идея краулингового бюджета.
Из-за 5xx и 429 Google замедляется на всём хосте, так что несколько сломанных шаблонов могут задержать сканирование ваших новых карточек товаров. Цепочки переадресаций стоят по запросу на каждый переход. Soft 404 стоит полной загрузки и ничего не даёт взамен. Исправьте эти три вещи, и тот же бюджет покроет больше полезных страниц.
Когда Google находит URL, но откладывает их сканирование, причиной часто оказывается сервер, который он считает ненадёжным. Если вы видите, что растёт число страниц «Страница обнаружена, но не проиндексирована», а в «Статистике сканирования» есть ошибки сервера, сначала исправьте сервер. Оба отчёта рассказывают одну и ту же историю.
Googlebot больше не единственный важный посетитель. GPTBot, OAI-SearchBot, ClaudeBot и PerplexityBot загружают страницы, чтобы обучать модели или отвечать на вопросы в реальном времени. Они обращаются к тому же серверу и страдают от тех же ошибок, с одним отличием: для них нет Search Console.
Большинство AI-краулеров не выполняют JavaScript, поэтому страница, которая собирает содержимое только в браузере, может выглядеть для них пустой: это своего рода soft 404, который вы никогда не увидите в отчётах Google. Многих из них по умолчанию блокируют сервисы защиты от ботов, часто кодом 403. А поскольку они загружают страницы по запросу, когда пользователь задаёт вопрос, тайм-аут в этот момент означает, что ответ процитирует кого-то другого. Наше руководство по SEO для JavaScript разбирает рендеринг и для поисковых, и для AI-краулеров.
Серверные логи единственный надёжный источник. Отфильтруйте по user-agent и посмотрите коды состояния:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnЕсли AI-боты получают 403, которых вы не планировали, исправьте правило. Затем проверьте, цитируют ли они вас на самом деле: отслеживание упоминаний в AI от Sorank показывает, как часто ChatGPT, Gemini, Claude и Perplexity упоминают ваш бренд, и вы видите, изменило ли что-то исправление сканирования.
Проходите этот список после каждой миграции, редизайна или крупного деплоя, а на больших сайтах раз в месяц.
Чек-лист здоровья сканирования
Откройте «Статистику сканирования» и проверьте три строки статуса хоста. Затем запустите бесплатный инструмент проверки индексируемости для пяти самых ценных страниц. Если и там, и там чисто, выгрузите ошибки из «Индексирования страниц» и сгруппируйте их по папкам: у вас появится короткий упорядоченный список исправлений вместо пугающего отчёта.
Когда сканирование в порядке, следующим ограничением становится само содержимое. Оптимизация контента от Sorank переписывает и обновляет ваши существующие страницы в режиме autopilot, чтобы страницы, до которых теперь добирается Google, стоило индексировать и цитировать. Для страниц, которые Google просканировал, но не включил в индекс, прочитайте наше руководство по статусу «Страница просканирована, но пока не проиндексирована».
Ошибки сканирования это неудачные запросы поисковой системы или AI-краулера: DNS не разрешается, сервер не отвечает вовремя или возвращает 5xx, robots.txt не удаётся загрузить, переадресация зацикливается или страница возвращает код 4xx. Ошибки уровня сайта могут приостановить сканирование всего сайта, а ошибки URL затрагивают только конкретную страницу.
Сами по себе нет. Google говорит, что 404 для страницы, удалённой без замены, не обязательно является проблемой. Проблемой это становится, когда у URL остались обратные ссылки, трафик или внутренние ссылки, и тогда правильное решение это одна 301 на близкий аналог.
После нажатия «Проверить исправление» в отчёте «Индексирование страниц» Search Console проверка обычно занимает примерно до двух недель. Google сначала проверяет выборку URL, затем остальные, и останавливает проверку, если хоть один затронутый URL всё ещё даёт сбой.
Мы бесплатно анализируем ваших конкурентов, ваш сайт и вашу видимость в ИИ и составляем персональный контент-план.
 ИИ-генератор брифа для контента
 Генератор схемы FAQ
 ИИ-генератор идей для постов в блоге
 Валидатор структурированных данных (валидатор Schema)
 Проверка альтернативного текста
 Анализатор внутренних ссылок
 Челлендж по обратным ссылкам
 ИИ-генератор метаописаний
 ИИ-генератор заголовков для блога
 Проверка индексируемости в Google
 ИИ-генератор плана статьи для блога
 Конструктор UTM-ссылок
 Инструмент кластеризации ключевых слов
 Проверка тега canonical
 Генератор XML-карты сайта
 Проверка битых ссылок
 ИИ-генератор SEO-заголовков
 Анализатор заголовков
 Предпросмотр поисковой выдачи
 Проверка редиректов
 Генератор тегов hreflang
 Анализатор структуры заголовков
 Проверка HTTP-заголовков
 Экстрактор фавиконок
 Калькулятор CTR в выдаче
 Калькулятор экономии SEO в сравнении с платным поиском
 Калькулятор доли голоса в SEO
 Калькулятор ROI от SEO
 Калькулятор прогноза трафика и выручки от SEO
 Калькулятор бюджета на SEO
 Калькулятор точки безубыточности SEO
 Калькулятор ROI от SEO для SaaS
 Калькулятор ROAS
 Калькулятор времени чтения
 Симулятор прироста позиций
 Калькулятор стоимости органического трафика
 Оценка органического трафика и проверка посещаемости сайта
 Калькулятор соотношения LTV к CAC
 Калькулятор ROI от локального SEO
 Калькулятор стоимости линкбилдинга
 Калькулятор ценности ключевого слова
 Калькулятор оценки возможностей ключевого слова
 Калькулятор плотности ключевых слов
 Калькулятор ROI от GEO
 Калькулятор инвестиций в GEO-контент
 Калькулятор ROI от SEO для интернет-магазина
 Калькулятор пожизненной ценности клиента
 Калькулятор стоимости привлечения клиента
 Калькулятор CTR
 Калькулятор стоимости статьи
 Калькулятор коэффициента конверсии
 Калькулятор ROI контент-маркетинга
 Оценка реферального трафика из ChatGPT
 Калькулятор показателя отказов
 Калькулятор ROI обратных ссылок
 Калькулятор AI Visibility Score
 Калькулятор стоимости AI-трафика
 Калькулятор доли голоса в ИИ
 Калькулятор стоимости невидимости в ИИ
 Калькулятор частоты цитирования в ИИ
 Валидатор llms.txt
 Проверка AI Overview и позиций в AI Overviews
 Проверка robots.txt
 ИИ SEO-аудит
 Проверка читаемости для LLM
 Проверка готовности к SearchGPT
 Аудит структурированных данных для LLM
 Аудит доступности сайта для ИИ-роботов
 Почему ChatGPT не рекомендует мой сайт
 Инструмент позиций в Gemini
 Проверка позиций в Perplexity
 Проверка цитирования в LLM
 Аудит Answer Engine Optimization
 GEO-аудит
 Тест видимости в ИИ-поиске
 Проверка видимости в ChatGPT
 Генератор llms.txt
 Извлечение URL
 Веб-страница в Markdown
 Проверка карты сайта
 Датчик волатильности выдачи
 Проверка размера страницы
 Счётчик слов
 Генератор slug
 Генератор Schema
 Генератор robots
 Предпросмотр OG
 Генератор метатегов
 Компрессор изображений
 Генератор фавиконок
 Аудит внутренней SEO-оптимизации: SEO-проверка и SEO-анализ
 Инструмент анализа обратных ссылок
 Инструмент подбора ключевых слов
 Проверка авторитета домена
 “Я протестировал Sorank на реальном клиентском сайте, и это потрясающе. Он делает всё то, за что агентство выставило бы вам счёт на $1500 в месяц. Теперь он запускается в работу на этом клиенте.”

 Guillaume Guersanguersanguillaume.com“Мы рекламное агентство и хотели раз и навсегда вернуть своё SEO в нужное русло. Sorank дал нам чёткое представление о нашем сайте, помог расставить приоритеты в оптимизации и правильно структурировать наш контент. Инструмент прост в использовании, хорошо продуман для работы в команде и очень удобен для централизованного отслеживания без необходимости жонглировать несколькими платформами. Очень прочная основа, чтобы начать наше SEO с чистого листа.”
 Gaspard MadouiРекламное агентство
 “Я просто позволил программе Sorank делать своё дело, и теперь мой показатель DR равен 25, а моя страница ранжируется выше.”
 Lucas Flandrefoundertrace.fr“Я специализировался на GEO благодаря Sorank. Рейтинг GEO позволяет мне показывать клиентам их позицию относительно конкурентов в ChatGPT. Это реальное коммерческое преимущество.”
 MélanieФрилансер по SEO“Отличный сервис, хорошо подходит для нашего сайта и помогает понять, как его улучшить, чтобы лучше ранжироваться в Google и не только. Поздравляю, так держать, рекомендую.”
 Hugo T.Владелец интернет-магазина