Prywatność jest dla nas ważna, dlatego możesz wyłączyć niektóre rodzaje przechowywania danych, które nie są niezbędne do podstawowego działania strony. Zablokowanie kategorii może wpłynąć na Twoje doświadczenie podczas korzystania z witryny. Więcej informacji (Polityka cookies)
Dziękujemy! Twoje zgłoszenie zostało odebrane!
Ups! Podczas wysyłania formularza coś poszło nie tak.
Błędy indeksowania: jak znaleźć, uszeregować i naprawić każdy typ
Znajdź i napraw błędy indeksowania: DNS, serwer, robots.txt, 404, soft 404 i przekierowania. Jak reaguje Googlebot i metoda 6 kroków, by naprawić je po kolei.
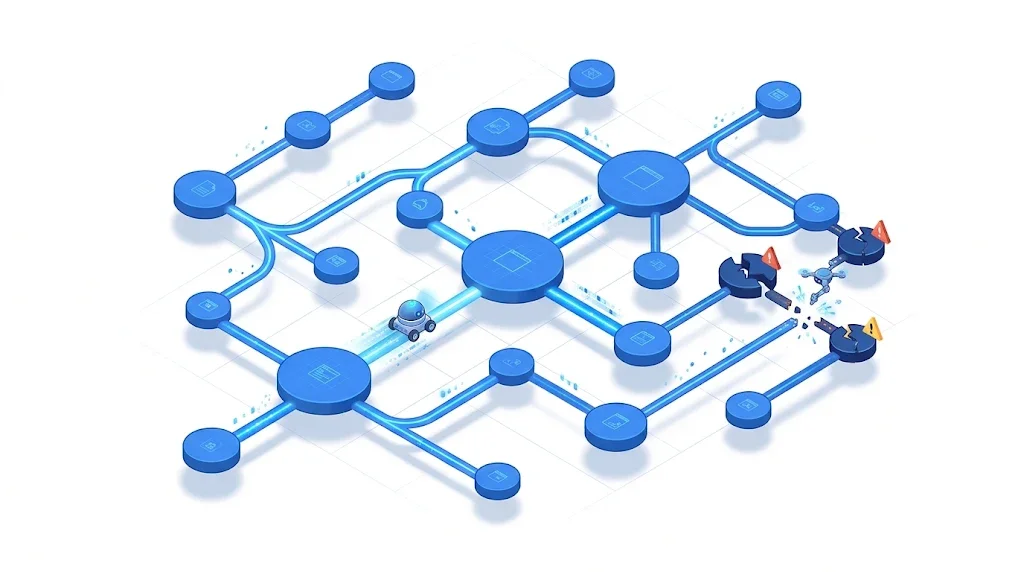
Mapa witryny, na której kilka stron oznaczono sygnałami błędu, a robot podąża za linkami między nimi.
Narzędzia
Na tej stronie
W skrócie
błędy indeksowania (crawl errors) to żądania robota wyszukiwarki lub robota AI do Twojej witryny, które kończą się niepowodzeniem: serwer przekracza limit czasu, DNS nie odpowiada, nie da się pobrać pliku robots.txt, przekierowanie się zapętla albo strona zwraca kod 4xx lub 5xx. Błędy na poziomie witryny (DNS, serwer, robots.txt) mogą zatrzymać skanowanie całej witryny przez Google, więc napraw je najpierw; błędy na poziomie adresu URL (404, soft 404, błędy przekierowania) mają znaczenie tylko wtedy, gdy dotyczą stron, które chcesz mieć w indeksie. Znajdziesz je w raportach Statystyki indeksowania i Indeksowanie stron w Search Console, potwierdzisz crawlerem i logami serwera, a potem usuniesz przyczynę i zatwierdzisz poprawkę.
Kto powinien naprawić techniczną stronę Twojej witryny?
Pytanie 1 z 425%
Nasza rada dla Ciebie
Sprawdź to sam w bezpłatnych narzędziach Google
Search Console wypisuje podstrony, których Google nie może odczytać, a PageSpeed Insights mierzy szybkość. Wiele drobnych problemów naprawisz w ustawieniach kreatora stron.
Nasza rada dla Ciebie
Programista stron internetowych
Problem leży w kodzie lub na serwerze: właściwą osobą jest programista, który zna SEO. Przekaż mu listę błędów z Search Console.
Nasza rada dla Ciebie
Narzędzie do audytu technicznego
Twoja strona ma wiele podstron: crawler czyta je wszystkie tak jak Google i podaje pełną listę błędów do naprawy, podstrona po podstronie.
Nasza rada dla Ciebie
Automatyczny audyt, a potem treści
Twoja strona działa, ale przyciąga mało odwiedzających: problemy techniczne rzadko są przyczyną. Sorank robi audyt strony, a potem pisze podstrony, które przyciągają ruch.
Czym są błędy indeksowania, a czym nie są
Robot działa jak bardzo cierpliwy gość. Prosi serwer o adres URL, czeka na odpowiedź, odczytuje kod stanu i treść, a potem przechodzi do znalezionych linków. Błąd indeksowania to każdy etap tego łańcucha, który się nie udaje. Gość nigdy nie dostaje użytecznej strony.
Ta definicja ma znaczenie, bo wiele raportów miesza błędy indeksowania z decyzjami o indeksowaniu. „Strona przeskanowana, ale obecnie nie zindeksowana” („Crawled, currently not indexed”) to nie błąd indeksowania: Google pobrał stronę bez problemu i postanowił jej nie zachować. „Wykluczona przez tag noindex” też nim nie jest: sam kazałeś Google usunąć stronę. Błąd indeksowania oznacza, że coś poszło nie tak przy samym pobieraniu.
Dwie rodziny: błędy witryny i błędy URL
Google dzieli problemy na dwa poziomy i Ty też powinieneś.
Błędy witryny (Google nazywa je problemami ze stanem hosta): błędy rozpoznawania DNS, błędy połączenia z serwerem i błędy pobierania robots.txt. Dotyczą każdego adresu URL na hoście. Zły dzień w tym obszarze może zamrozić skanowanie całej witryny.
Błędy URL: jedna strona zwraca 404, 410, 401, 403, 5xx, soft 404 albo uszkodzone przekierowanie. Dotyczą tylko tego adresu i wiele z nich jest nieszkodliwych.
Błędy witryny a błędy URL
Błędy witryny (napraw dziś)
DNS nie rozpoznaje domeny
Serwer przekracza limit czasu lub zrywa połączenie
robots.txt zwraca 5xx lub 429
Widoczne w Statystykach indeksowania, Stan hosta
Mogą wstrzymać skanowanie każdej strony
Błędy URL (selekcja)
404, 410, soft 404
401, 403, inne 4xx
Pętla przekierowań lub zbyt długi łańcuch
Widoczne w raporcie Indeksowanie stron
Liczą się tylko na stronach, które chcesz indeksować
Dlaczego to rozróżnienie zmienia priorytety
Sklep z 4000 starych adresów produktów zwracających 404 może być w pełni zdrowy, jeśli te produkty zniknęły na dobre. Ten sam sklep z plikiem robots.txt, który przez sześć godzin zwraca 503, ma prawdziwy alarm, nawet jeśli każda strona produktu działa. Zacznij od hosta, potem adresy, które zarabiają, a na końcu reszta.
Przekazuje treść do indeksowania. Indeksowanie nie jest gwarantowane.
Nie, chyba że strona jest pusta (soft 404).
301, 308
Silny sygnał, że cel to nowy adres URL.
Nie, jeśli to jeden skok do 200.
302, 303, 307
Słaby sygnał: oryginalny adres zwykle pozostaje kanoniczny.
Tak, jeśli przeniesienie jest trwałe.
Łańcuchy 3xx
Domyślnie podąża za maksymalnie 10 skokami, potem rezygnuje.
Tak: każdy skok marnuje żądanie, a pętle nigdy się nie kończą.
404, 410, inne 4xx (poza 429)
Traktuje treść jako nieistniejącą, z czasem usuwa zindeksowane adresy, skanuje je rzadziej.
Tylko jeśli strona powinna istnieć.
401, 403
Tak samo jak inne 4xx. Nie spowalniają skanowania.
Tak, jeśli blokują Googlebota na stronach publicznych.
429
Traktowany jako sygnał przeciążenia serwera, jak 5xx.
Tak: skanowanie zwalnia.
5xx
Spowalnia skanowanie proporcjonalnie do liczby błędów. Adresy, które stale zawodzą, są usuwane z indeksu.
Tak, zawsze.
Dwa szczegóły myli wiele zespołów. Po pierwsze, 401 i 403 nie zmniejszają tempa skanowania. Jeśli serwer ma problemy, zwracanie 403 Googlebotowi nie pomaga; Google prosi, by tymczasowo zwracać 503 lub 429. Po drugie, 404 to nie kara. To poprawna odpowiedź dla strony, której już nie ma.
Awarie robots.txt są najgroźniejsze
Dokumentacja raportu Statystyki indeksowania (Pomoc Search Console) wyjaśnia zasadę. robots.txt, który odpowiada 200 (nawet pusty) albo 403, 404 lub 410 (brak pliku), jest w porządku. robots.txt, który odpowiada 429 lub 5xx, to awaria, i Google wtedy działa ostrożnie.
Co robi Google, gdy robots.txt stale zawodzi
Pierwsze 12 godzinGoogle całkowicie przestaje skanować witrynę.
Do 30 dniGoogle używa ostatniego poprawnie pobranego robots.txt.
Po 30 dniachZachowanie zależy od tego, czy strona główna jest dostępna.
Źródło: Pomoc Google Search Console, raport Statystyki indeksowania
Reguła CDN lub zapora, która serwuje 503 na /robots.txt, może więc zamrozić całą witrynę na pół dnia, nawet jeśli każdy inny adres działa. Sprawdzaj ten plik jako pierwszy przy każdej analizie błędów indeksowania. Nasz przewodnik po stanie „Zablokowana przez plik robots.txt” opisuje odwrotny problem: plik działa, ale blokuje za dużo.
Limity skanowania Google, które warto pamiętać
10maksymalna liczba skoków przekierowań, za którymi podążają roboty Google
12 hwstrzymanie skanowania, gdy robots.txt zwraca 5xx lub 429
30 dniGoogle nadal używa ostatniego poprawnego robots.txt
5%dzienny odsetek błędów DNS podany jako przykład problemu z hostem
Źródła: Google Search Central, kody stanu HTTP i błędy sieci; Pomoc Search Console, raport Statystyki indeksowania
Błędy indeksowania to miejsca, w których ścieżka robota przez Twoją witrynę się urywa.
Każdy typ błędu indeksowania z wyjaśnieniem i poprawką
Oto pełna lista typów, które spotkasz w Search Console i w crawlerach, z przyczyną i poprawką dla każdego. Nazwy pochodzą z dokumentacji raportu Indeksowanie stron (Pomoc Search Console).
Błędy DNS
Google nie mógł zamienić nazwy domeny na adres IP albo serwer DNS nie odpowiedział. Typowe przyczyny: wygasła domena, awaria dostawcy DNS, błędny rekord po migracji lub źle skonfigurowany DNSSEC. Sprawdź zapytaniem spoza swojej sieci:
Poprawka: popraw rekordy, obniż TTL przed każdą migracją i wybierz dostawcę DNS z redundancją. Jeśli istnieją zarówno example.com, jak i www.example.com, obie muszą się rozpoznawać, nawet jeśli jedna tylko przekierowuje.
Błędy połączenia z serwerem i 5xx
Serwer nie odpowiedział na czas, zamknął połączenie albo odpowiedział 500, 502, 503 lub 504. Typowe przyczyny: przeciążona baza danych, proces PHP lub Node, który pada pod obciążeniem, limit czasu reverse proxy, aktualizacja wtyczki albo zapora ograniczająca boty. Spójrz na rozkład w czasie: błędy o tej samej godzinie każdej nocy często wskazują na kopię zapasową lub zadanie cron.
Poprawka: przeczytaj log błędów serwera w momentach podanych przez Google, zwiększ limity czasu lub liczbę workerów, cachuj ciężkie strony i upewnij się, że ochrona przed botami przepuszcza zweryfikowanego Googlebota. Na czas planowanej przerwy zwracaj 503 z nagłówkiem Retry-After zamiast strony 200 z napisem „wracamy wkrótce”:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 i 410 (Nie znaleziono)
Strona nie istnieje. To w porządku, gdy usunięto ją celowo i nic do niej nie linkuje. Problem pojawia się, gdy adres nadal ma linki zwrotne, ruch lub linki wewnętrzne, albo gdy strona powinna istnieć, a wdrożenie ją zepsuło.
Poprawka: jeśli treść się przeniosła, dodaj jedno przekierowanie 301 do najbliższego odpowiednika. Jeśli zniknęła na dobre, zostaw 404 lub użyj 410 i usuń linki wewnętrzne oraz wpisy w mapie witryny, które do niej prowadzą. Nigdy nie przekierowuj wszystkich 404 na stronę główną: Google zwykle traktuje je jako soft 404.
Soft 404
Serwer mówi 200, ale strona wygląda na pustą albo pisze „nie znaleziono”: pusta kategoria, wyszukiwarka bez wyników, niedostępny produkt bez treści. Google wydaje na nią żądanie i nic nie dostaje. Szczegółowo opisujemy to w przewodniku o błędach soft 404.
401, 403 i inne 4xx
Googlebot nigdy nie wysyła danych logowania, więc 401 lub 403 na stronie publicznej oznacza, że blokuje go serwer albo warstwa bezpieczeństwa. Typowi winowajcy: hasło ze środowiska testowego pozostawione na produkcji, reguła WAF, blokada kraju albo ochrona przed hotlinkowaniem zastosowana do HTML. Popraw regułę, a nie objaw, i przetestuj narzędziem Sprawdzanie adresu URL w Search Console.
Błędy przekierowania
Google zgłasza błąd przekierowania, gdy trafia na pętlę, zbyt długi łańcuch, adres przekraczający maksymalną długość albo błędny lub pusty adres w łańcuchu. Klasyczny przypadek po migracji: http na https, potem na www, potem na ukośnik końcowy, potem na nową ścieżkę. Cztery skoki tam, gdzie wystarczy jeden. Nasz pełny przewodnik po przekierowaniach SEO wyjaśnia, jak je skrócić.
Wskazówka
Wklej podejrzany adres do darmowego narzędzia do sprawdzania przekierowań Sorank: śledzi cały łańcuch, pokazuje każdy skok i jego kod stanu oraz wskazuje, gdzie jest pętla lub zbędny skok.
Przekroczenia czasu, ucięte odpowiedzi i zbyt duże strony
Niektóre błędy nigdy nie pokazują kodu stanu. Strona zaczyna się ładować i staje albo jest tak ciężka, że robot czyta tylko jej część. Roboty Google czytają ograniczoną liczbę bajtów na plik, więc strona napchana skryptami inline lub obrazami base64 może stracić treść na dole. Sprawdź ciężkie szablony narzędziem do sprawdzania rozmiaru strony.
Wszystkie sposoby wykrywania błędów indeksowania w porównaniu
Żadne pojedyncze narzędzie nie pokazuje wszystkich błędów indeksowania. Każda metoda widzi problem z innej strony, a poważny audyt łączy co najmniej dwie.
Metoda 1: Search Console, raport Statystyki indeksowania
Zasada: Google pokazuje własne żądania z ostatnich 90 dni, pogrupowane według odpowiedzi, typu pliku, celu i typu Googlebota, plus stan hosta dla DNS, serwera i robots.txt. Kiedy używać: zawsze i jako pierwszej, dla błędów witryny. Zalety: to dane prosto od Google. Ograniczenia: tylko dla usług na poziomie domeny głównej, przykłady są próbkowane, a Google pisze, że witryny poniżej tysiąca stron rzadko go potrzebują. Przykład: skok odpowiedzi „przekroczenie czasu strony” w każdą niedzielę o 3 w nocy, zbieżny z kopią zapasową bazy danych.
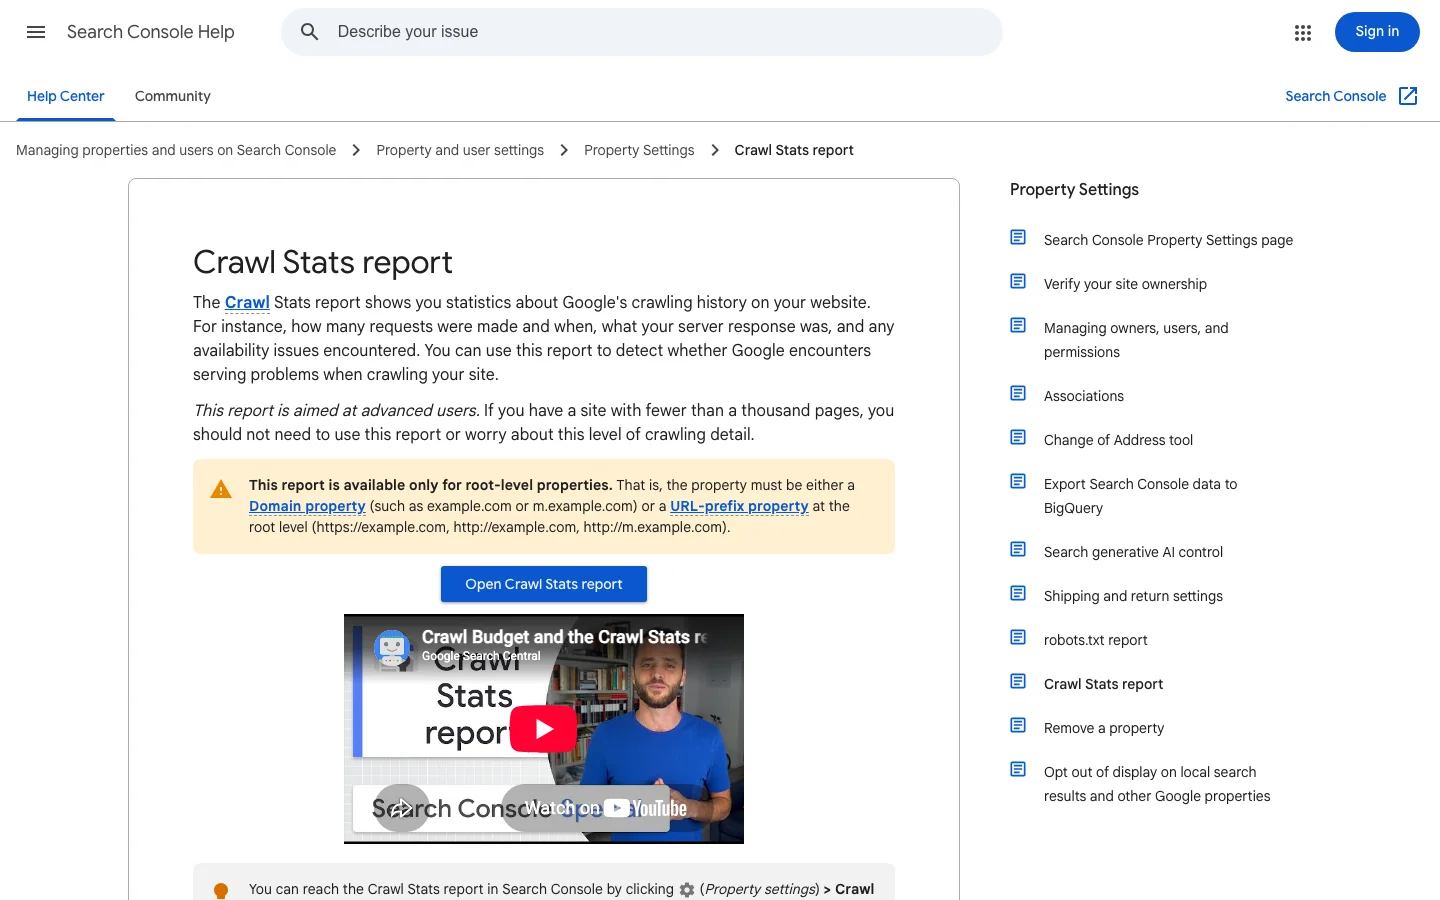
Dokumentacja Google raportu Statystyki indeksowania, gdzie opisano stan hosta dla DNS, serwera i robots.txt.
Metoda 2: Search Console, raport Indeksowanie stron i Sprawdzanie adresu URL
Zasada: lista adresów znanych Google i powodów, dla których nie są zindeksowane, np. Błąd serwera (5xx), Błąd przekierowania, Nie znaleziono (404) lub Soft 404. Kiedy używać: do selekcji błędów URL i zatwierdzania poprawek. Zalety: powiązany ze stronami, które Google faktycznie próbował pobrać. Ograniczenia: raporty mają kilka dni opóźnienia, listy przykładów są ograniczone, a raport miesza błędy indeksowania z decyzjami o indeksowaniu. Przykład: 300 adresów w „Błąd przekierowania” ze wspólnym starym prefiksem /blog/.
Metoda 3: Crawler desktopowy lub w chmurze
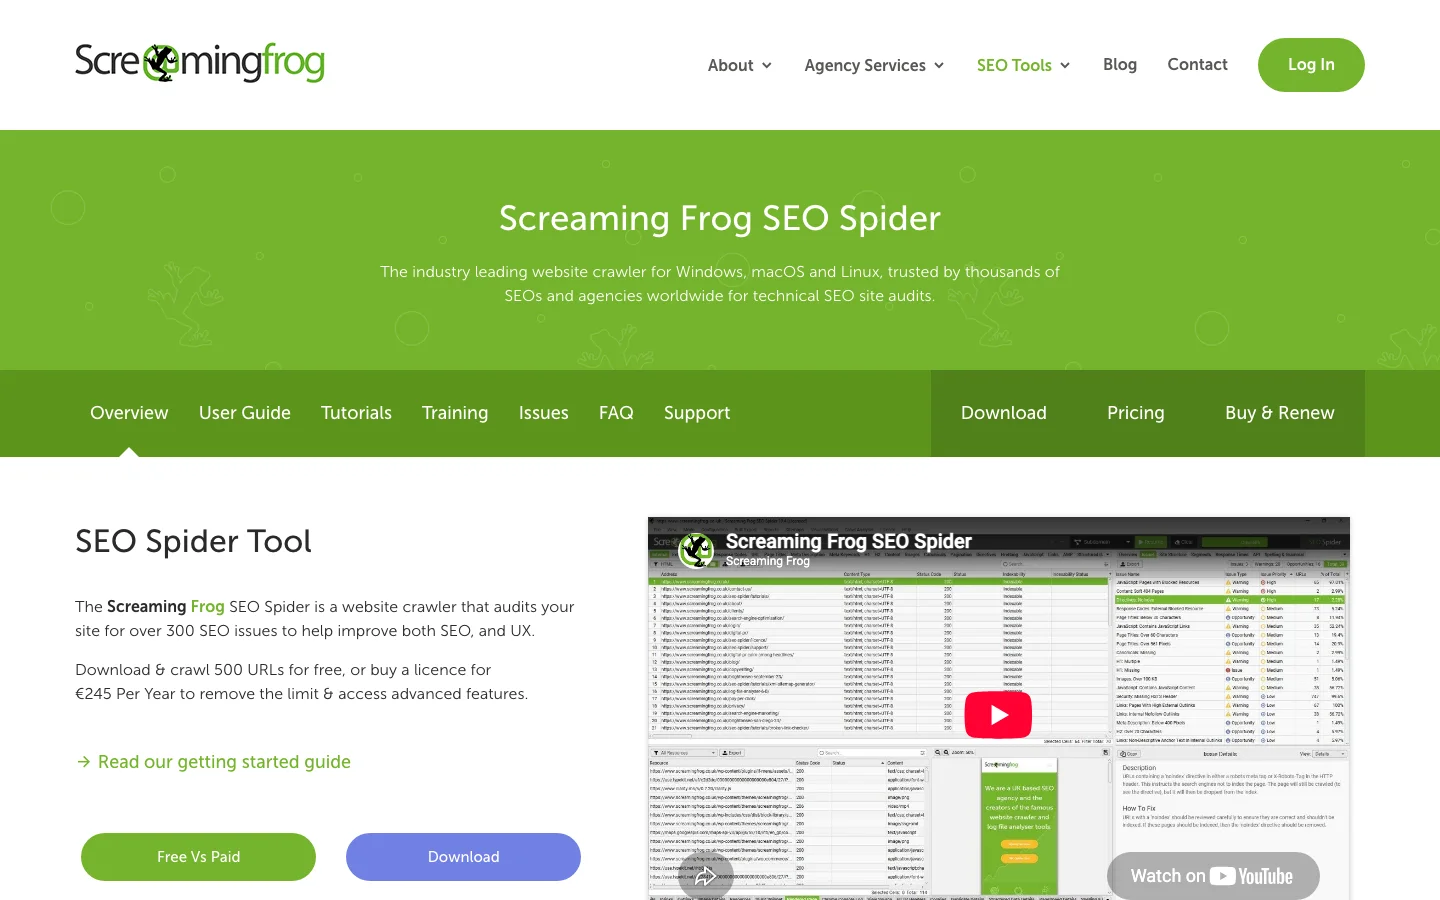
Zasada: narzędzie takie jak Screaming Frog skanuje witrynę tak jak bot, podąża za linkami od strony głównej i zapisuje każdy kod stanu, łańcuch przekierowań i uszkodzony link. Kiedy używać: przed migracją, przeprojektowaniem lub dużym wdrożeniem i po nich, a co miesiąc na dużych witrynach. Zalety: natychmiastowy, kompletny dla stron podlinkowanych, pokazuje, gdzie stoi każdy uszkodzony link. Ograniczenia: nie wie, o co naprawdę prosił Google, pomija strony osierocone, a serwer może traktować go inaczej niż Googlebota. Nasz przewodnik konfiguracji Screaming Frog prowadzi przez pełny audyt.
Screaming Frog SEO Spider skanuje witrynę jak bot i wyświetla każdy kod stanu, łańcuch przekierowań i uszkodzony link.
Metoda 4: Analiza logów serwera
Zasada: logi dostępu zapisują każde żądanie, także od Googlebota, Bingbota, GPTBota, ClaudeBota i PerplexityBota, z dokładnym kodem stanu i czasem odpowiedzi. Kiedy używać: na dużych witrynach, po niewyjaśnionych spadkach ruchu i żeby zobaczyć, co odwiedzają roboty AI. Zalety: prawdziwe żądania, prawdziwe kody, bez próbkowania, każdy bot. Ograniczenia: wymaga dostępu do logów i trochę skryptów; trzeba zweryfikować, czy „Googlebot” to naprawdę Google. Nasz przewodnik po analizie logów w SEO idzie krok po kroku. Szybki pierwszy rzut oka:
# Żądania Googlebota, które nie zwróciły 200, 301 ani 304, najczęstsze na górze
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Metoda 5: Kontrole pojedynczych adresów
Zasada: testuj jeden adres naraz przez curl lub darmowe narzędzie online. Kiedy używać: do potwierdzenia poprawki albo sprawdzenia kluczowej strony po wdrożeniu. Zalety: natychmiastowe i precyzyjne. Ograniczenia: nie skaluje się. Użyj user agenta Googlebota, żeby wychwycić reguły, które inaczej traktują boty:
Błędy 5xx: odczytaj kod statusu, żeby znaleźć warstwę, która zawiodła
Status 5xx oznacza, że serwer nie mógł obsłużyć żądania, które wyglądało poprawnie. Google w odpowiedzi zwalnia indeksowanie, a zwalnia tym mocniej, im więcej twoich adresów URL zwraca błędy. Google przez pewien czas zachowuje już zindeksowane adresy, ale usuwa te, które trwale zwracają błąd serwera. Krótki zryw błędów da się odrobić, bo Google stopniowo zwiększa częstotliwość indeksowania, gdy serwer znów odpowiada kodami 2xx. Długa seria błędów to dopiero coś, co niszczy indeks.
Kod pokazuje, która warstwa się zepsuła
Każdy kod 5xx wskazuje na inną część stosu. Tabela podpowiada, od czego zacząć przy każdym z nich.
Kod
Co zwykle oznacza
Co sprawdzić najpierw
500
Aplikacja zawiodła podczas obsługi żądania
Log błędów aplikacji z dokładnym czasem żądania
502
Proxy lub CDN dostało nieprawidłową odpowiedź z aplikacji, często dlatego, że się wywaliła lub zrestartowała
Restarty i czas działania procesu aplikacji
503
Usługa jest przeciążona, ograniczona limitem albo w trybie konserwacji
Wykresy obciążenia, historia wdrożeń i okna serwisowe
504
Proxy przestało czekać na aplikację
Wolne zapytania do bazy i ustawienia limitu czasu proxy
429
Ogranicznik liczby żądań mówi, że jest ich zbyt wiele
Reguły limitów i to, czy obejmują zweryfikowanego Googlebota
Dopasuj znaczniki czasu Google do swoich logów
Statystyki indeksowania pokazują dni i godziny, w których Google napotkał błędy (nasz przewodnik po Statystykach indeksowania wyjaśnia każdy wykres). Log serwera pokazuje, co działo się w te dokładnie chwile. Przefiltruj żądania Googlebota i policz odpowiedzi 5xx na godzinę:
Każda linia wyniku to godzina, kod statusu i liczba. Skupisko w tej samej godzinie każdej nocy zwykle wskazuje na kopię zapasową, zadanie cron albo zaplanowany import. Błędy rozłożone na cały dzień zwykle oznaczają przeciążenie, więc rozwiązaniem jest pojemność lub cache, a nie pojedynczy błąd. Głębszą metodę znajdziesz w naszym przewodniku po analizie logów serwera.
Zmierz koszt 5xx, zanim zaczniesz panikować
Google ogranicza indeksowanie proporcjonalnie do liczby adresów URL zwracających błędy. Uszkodzony szablon, który dotyczy kilku adresów, kosztuje niewiele czasu indeksowania. Awaria bazy danych, która psuje każdą stronę, kosztuje dużo i to ją naprawiasz w pierwszej kolejności.
Kod 429 działa tak samo jak 5xx, bo Google odczytuje go jako przeciążony serwer. Jeśli ogranicznik lub ochrona przed botami zwraca Googlebotowi 429, płacisz za to czasem indeksowania. Dokumentacja Google nie wspomina o nagłówku Retry-After. Nadal wysyłaj go prawdziwym użytkownikom i klientom API, ale nie licz na to, że Googlebot poczeka tyle, ile ustawiłeś.
Błędy 4xx: najpierw ustal, skąd pochodzą, a dopiero potem je napraw
Status 4xx oznacza, że serwer odrzucił żądanie z powodu czegoś po stronie klienta: adres URL nie istnieje, dostęp jest zabroniony albo adres jest błędnie zapisany. Google traktuje wszystkie kody 4xx oprócz 429 tak samo. Przestaje korzystać z treści pod tym adresem i usuwa go z indeksu, jeśli był zindeksowany. Zanim zabierzesz się za 4xx, sprawdź, skąd pochodzi żądanie, bo poprawka często znajduje się w jednym miejscu: w linku, szablonie albo regule przekierowania.
Znajdź źródło każdego błędu 4xx w logach
Log dostępu zapisuje referer każdego żądania, dzięki czemu wiesz, która strona wysłała odwiedzającego albo bota pod ten adres. Policz odpowiedzi 4xx według ścieżki i według referera:
Referer z twojej własnej domeny oznacza, że jedna z twoich stron linkuje do martwego adresu. Napraw link albo szablon, który go generuje. To najcenniejsza poprawka, bo masz nad nią kontrolę. Nasz przewodnik po naprawianiu uszkodzonych linków opisuje całą metodę.
Referer z innej strony oznacza, że backlink wskazuje na adres, który już nie działa. Jeśli link jest wart zachowania, dodaj pojedyncze przekierowanie 301 na najbliższą działającą stronę. Jeśli nie, zostaw błąd 404.
Pusty referer albo ścieżka, której nigdy nie opublikowałeś, na przykład strona logowania w statycznym serwisie, zwykle oznacza, że bot lub skaner sprawdzał ten adres. Niech zwraca 404 i nie trać na to czasu.
Wyłapuj skoki 4xx zaraz po każdym wdrożeniu
Wydanie, które zmienia nazwę trasy, slug albo przebudowuje szablon, często w tym samym dniu generuje falę błędów 404. Wyeksportuj liczbę odpowiedzi 4xx dziennie za tydzień przed wdrożeniem i za tydzień po nim. Skok skupiony w jednym katalogu wskazuje wprost na zmianę. Dodaj przekierowanie ze starego adresu na nowy w tym samym wydaniu, a nie w późniejszym zgłoszeniu. Przy pełnej migracji zobacz nasz checklistę migracji SEO.
Wskazówka
Nie zastępuj brakującej strony odpowiedzią 200 z krótkim komunikatem lub pustą listą. Google może potraktować ją jako soft 404, co kosztuje pełne pobranie strony i nic nie daje w zamian.
Krok po kroku: napraw błędy indeksowania we właściwej kolejności
Tej metody używamy sami. Idzie od błędów, które mogą zatrzymać całą witrynę, do tych, które marnują tylko odrobinę skanowania.
Metoda 6 kroków na błędy indeksowania
Sprawdź stan hostaOtwórz Statystyki indeksowania i przejrzyj DNS, połączenie z serwerem i robots.txt za ostatnie 90 dni.
Wyeksportuj i pogrupuj błędy URLWyeksportuj każdy powód z Indeksowania stron i pogrupuj adresy według folderu lub szablonu.
Posortuj według wartościZachowaj adresy z ruchem, linkami zwrotnymi, linkami wewnętrznymi lub wpisami w mapie witryny.
Usuń przyczynę na poziomie szablonuJedna reguła, jedna mapa przekierowań lub jedno ustawienie serwera naprawia setki adresów.
Wyczyść sygnałyZaktualizuj linki wewnętrzne i mapy witryny, by wskazywały końcowe adresy 200.
Zatwierdź i monitorujKliknij Zatwierdź poprawkę, potem co tydzień obserwuj Statystyki indeksowania i logi.
Krok 1: najpierw sprawdź hosta
W Search Console otwórz Ustawienia, następnie Statystyki indeksowania, a potem Stan hosta. Zielony oznacza brak istotnych problemów przez 90 dni. „Niedawny problem” oznacza poważny kłopot w ostatnim tygodniu: rzuć wszystko inne. Kliknij każdą kategorię, by zobaczyć odsetek błędów dzień po dniu, a potem dopasuj złe dni do historii hostingu, CDN i wdrożeń.
Krok 2: wyeksportuj i pogrupuj według wzorca
Otwórz Indeksowanie, następnie Strony, i wyeksportuj każdy powód błędu. Nie poprawiaj adresów pojedynczo. Wrzuć je do arkusza i wyodrębnij pierwszy folder:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
Tabela przestawna na tej kolumnie zwykle pokazuje, że większość błędów pochodzi z dwóch lub trzech szablonów: wycofanej kategorii bloga, parametru filtra, starego feedu produktów.
Krok 3: posortuj według wartości biznesowej
Dla każdego wzorca zadaj cztery pytania. Czy ma kliknięcia z wyszukiwarki? Czy ma linki zwrotne? Czy jest podlinkowany wewnętrznie? Czy jest w mapie witryny? 404 bez żadnego z tych czterech może czekać w nieskończoność. 404 z linkami zwrotnymi potrzebuje 301 dziś. Darmowe narzędzie do wykrywania uszkodzonych linków pokazuje, które z Twoich stron wciąż linkują do martwych adresów.
Krok 4: usuń przyczynę źródłową
Naprawiaj reguły, nie adresy. Mapa przekierowań w konfiguracji serwera jest lepsza niż 400 przekierowań dodanych ręcznie we wtyczce. Na przykład w nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Przy 5xx napraw wydajność lub błąd. Przy 401 i 403 napraw regułę bezpieczeństwa. Przy soft 404 dodaj prawdziwą treść albo zwróć prawdziwe 404.
Krok 5: wyczyść linki wewnętrzne i mapy witryny
Każdy link wewnętrzny powinien prowadzić bezpośrednio do adresu zwracającego 200. Każdy wpis w mapie witryny powinien być kanonicznym, indeksowalnym adresem 200. Mapa pełna przekierowań i 404 uczy Google, by ufał jej mniej. Nasz przewodnik, jak utworzyć mapę witryny, wyjaśnia, co powinno się w niej znaleźć.
Krok 6: zatwierdź i monitoruj
W raporcie Indeksowanie stron otwórz naprawiony powód i kliknij Zatwierdź poprawkę. Google najpierw sprawdza próbkę, potem resztę; zwykle trwa to do około dwóch tygodni i zatrzymuje się, jeśli choć jeden adres nadal zawodzi. Nie klikaj ponownie w trakcie. Potem ustal cotygodniową rutynę: Statystyki indeksowania dla hosta, logi dla skoków, skanowanie po każdym wdrożeniu.
Łańcuch przekierowań przed poprawką i po niej
Przed
http://site.com/page
301 na https://site.com/page
301 na https://www.site.com/page
301 na https://www.site.com/page/
Linki wewnętrzne wciąż wskazują pierwszy adres
Po
Jedno 301 prosto na https://www.site.com/page/
Linki wewnętrzne zaktualizowane do końcowego adresu
Mapa witryny zawiera tylko końcowy adres
Jedno żądanie zamiast czterech
Częste błędy oraz jak je wykryć i poprawić
Błąd 1: przekierowanie każdego 404 na stronę główną
Na czym polega: wtyczka lub reguła, która wysyła każdy brakujący adres na /. Jak go wykryć: wiele adresów w „Soft 404” lub „Strona z przekierowaniem”, które lądują na stronie głównej; crawler pokazuje setki 301 z tym samym celem. Jak go poprawić: przekierowuj tylko do bliskiego odpowiednika, a resztę zostaw z 404 lub 410.
Błąd 2: blokowanie Googlebota narzędziami bezpieczeństwa
Na czym polega: WAF, menedżer botów lub limiter, który serwuje Google 403, 429 lub stronę z wyzwaniem. Jak go wykryć: 403 lub 429 w Statystykach indeksowania, podczas gdy strona ładuje się dobrze w przeglądarce; logi pokazują blokady według IP. Jak go poprawić: przepuszczaj zweryfikowanego Googlebota przez odwrotny DNS lub opublikowane zakresy IP Google, zamiast ufać ciągowi user agenta.
Błąd 3: kruchy robots.txt
Na czym polega: robots.txt generowany przez aplikację, więc pada zawsze, gdy pada aplikacja, albo serwowany przez regułę CDN, która cachuje 5xx. Jak go wykryć: kategoria pobierania robots.txt w Stanie hosta nie jest zielona. Jak go poprawić: serwuj go jako plik statyczny, poza aplikacją, i testuj narzędziem do sprawdzania robots.txt.
Błąd 4: strony konserwacji zwracające 200
Na czym polega: strona „Wracamy wkrótce” serwowana z kodem 200 na każdym adresie. Jak go wykryć: po konserwacji fala soft 404 lub zduplikowanych tytułów. Jak go poprawić: w czasie konserwacji zwracaj 503 z Retry-After i niech trwa krótko.
Błąd 5: używanie 403, żeby spowolnić Google
Na czym polega: odpowiadanie Googlebotowi 403, gdy serwer jest przeciążony. Jak go wykryć: skoki 403 zbieżne ze skokami obciążenia. Jak go poprawić: Google pisze, że kody 4xx inne niż 429 nie wpływają na tempo skanowania. Zwracaj przez krótki czas 503 lub 429 i zwiększ wydajność.
Błąd 6: poprawianie błędów pojedynczo
Na czym polega: przeklikiwanie listy w Search Console i edytowanie każdego adresu. Jak go wykryć: ten sam powód wraca co miesiąc. Jak go poprawić: grupuj według wzorca, napraw szablon lub regułę, a potem zatwierdź raz.
Błąd 7: panika z powodu nieszkodliwych 404
Na czym polega: spędzanie dni na 404 dla adresów spamowych lub dawno usuniętych stron bez linków. Jak go wykryć: adresy nie mają kliknięć, linków zwrotnych ani linków wewnętrznych. Jak go poprawić: zostaw je. Google pisze, że 404 dla usuniętej strony niekoniecznie jest problemem.
Uwaga
Nigdy nie blokuj adresu w robots.txt, żeby „ukryć” błąd indeksowania. Google nie widzi już 404 ani przekierowania, adres może pozostać w indeksie, a Ty tracisz sygnał, który chciałeś wysłać.
Błędy indeksowania a budżet indeksowania
Na witrynie z kilkuset stronami Google ma czas na wszystko, a błędy indeksowania liczą się głównie dla stron, które psują. Na dużych witrynach (sklepy z filtrami, marketplace’y, serwisy informacyjne) każde nieudane lub zmarnowane żądanie zabiera czas Twoim prawdziwym stronom. Na tym polega idea budżetu indeksowania.
Jak błędy zjadają przepustowość skanowania
5xx i 429 sprawiają, że Google zwalnia na całym hoście, więc kilka zepsutych szablonów może opóźnić skanowanie nowych stron produktów. Łańcuchy przekierowań kosztują jedno żądanie na skok. Soft 404 kosztują pełne pobranie i nic nie dają. Napraw te trzy, a ten sam budżet obejmie więcej użytecznych stron.
Co ma z tym wspólnego „Wykryta, obecnie nie zindeksowana”
Gdy Google znajduje adresy, ale odkłada ich skanowanie, przyczyną jest często serwer, który uważa za niestabilny. Jeśli rośnie liczba „Wykryta, obecnie nie zindeksowana” i jednocześnie widzisz błędy serwera w Statystykach indeksowania, najpierw napraw serwer. Oba raporty opowiadają tę samą historię.
Błędy indeksowania u robotów AI
Googlebot nie jest już jedynym gościem, który się liczy. GPTBot, OAI-SearchBot, ClaudeBot i PerplexityBot pobierają strony, by trenować modele lub odpowiadać na pytania w czasie rzeczywistym. Trafiają na ten sam serwer i cierpią z powodu tych samych błędów, z jedną różnicą: nie masz dla nich Search Console.
Co zmienia się przy botach AI
Większość robotów AI nie uruchamia JavaScriptu, więc strona, która buduje treść tylko w przeglądarce, może wyglądać dla nich na pustą, czyli jak rodzaj soft 404, którego nigdy nie zobaczysz w raportach Google. Wiele z nich jest domyślnie blokowanych przez usługi ochrony przed botami, często kodem 403. A ponieważ pobierają strony na żądanie, gdy użytkownik zadaje pytanie, przekroczenie czasu w tym momencie oznacza, że odpowiedź zacytuje kogoś innego. Nasz przewodnik po JavaScript SEO omawia renderowanie dla wyszukiwarek i robotów AI.
Jak je monitorować
Logi serwera to jedyne wiarygodne źródło. Filtruj według user agenta i patrz na kody stanu:
Jeśli boty AI dostają 403, których nie planowałeś, popraw regułę. Potem sprawdź, czy faktycznie Cię cytują: śledzenie wzmianek w AI od Sorank pokazuje, jak często ChatGPT, Gemini, Claude i Perplexity wspominają Twoją markę, więc zobaczysz, czy poprawka skanowania coś zmienia.
Twoja lista kontrolna kondycji skanowania
Przechodź tę listę po każdej migracji, przeprojektowaniu lub dużym wdrożeniu, a na dużych witrynach raz w miesiącu.
Lista kontrolna kondycji skanowania
Stan hosta zielony dla DNS, połączenia z serwerem i robots.txt
robots.txt serwowany jako plik statyczny i zwraca 200
Brak skoków 5xx lub 429 w Statystykach indeksowania i logach
Zweryfikowany Googlebot i pożądane boty AI nie są blokowane przez zaporę
Każde przekierowanie to jeden skok, 301 lub 308, do strony 200
Linki wewnętrzne wskazują końcowe adresy 200
Mapy witryny zawierają tylko kanoniczne, indeksowalne adresy 200
404 z linkami zwrotnymi lub ruchem przekierowane do bliskiego odpowiednika
Puste strony poprawione lub zwracające prawdziwe 404
Konserwacja zwraca 503 z Retry-After
Zatwierdzanie poprawki uruchomione dla każdego naprawionego powodu
Co zrobić dziś
Otwórz Statystyki indeksowania i sprawdź trzy linie stanu hosta. Potem uruchom darmowe narzędzie do sprawdzania indeksowalności na pięciu najcenniejszych stronach. Jeśli oba są czyste, wyeksportuj błędy z Indeksowania stron i pogrupuj je według folderu: masz krótką, uporządkowaną listę poprawek zamiast przerażającego raportu.
Gdy skanowanie jest czyste, kolejnym ograniczeniem jest sama treść. Optymalizacja treści od Sorank przepisuje i odświeża istniejące strony na autopilot, więc strony, do których Google teraz dociera, są warte zindeksowania i cytowania. O stronach, które Google zeskanował, ale pominął, przeczytaj nasz przewodnik po stanie „Strona przeskanowana, ale obecnie nie zindeksowana”.
Najczęściej zadawane pytania
Czym są błędy indeksowania w SEO?
Błędy indeksowania to żądania robota wyszukiwarki lub robota AI, które kończą się niepowodzeniem: DNS nie rozpoznaje domeny, serwer przekracza limit czasu lub zwraca 5xx, nie da się pobrać robots.txt, przekierowanie się zapętla albo strona zwraca kod 4xx. Błędy witryny mogą wstrzymać skanowanie całej witryny, a błędy URL dotyczą tylko danej strony.
Czy błędy 404 szkodzą SEO?
Same w sobie nie. Google pisze, że 404 dla strony usuniętej bez zamiennika niekoniecznie jest problemem. Staje się nim, gdy adres wciąż ma linki zwrotne, ruch lub linki wewnętrzne; wtedy właściwą poprawką jest jedno przekierowanie 301 do bliskiego odpowiednika.
Ile czasu Google potrzebuje, by zauważyć, że błędy indeksowania zostały naprawione?
Po kliknięciu Zatwierdź poprawkę w raporcie Indeksowanie stron w Search Console weryfikacja zwykle trwa do około dwóch tygodni. Google najpierw sprawdza próbkę adresów, potem resztę, i przerywa, jeśli choć jeden adres nadal zawodzi.
y!
Odbierz za darmo plan treści na 30 dni
Analizujemy Twoich konkurentów, Twoją stronę i Twoją widoczność w AI, aby bezpłatnie przygotować dla Ciebie dopasowany plan treści.
“Przetestowałem Sorank na prawdziwej stronie klienta i to jest szalone. Robi wszystko, za co agencja policzyłaby Ci $1500 miesięcznie. Teraz trafia na produkcję u tego klienta.”Guillaume Guersanguersanguillaume.com
“Jesteśmy agencją reklamową i chcieliśmy raz na zawsze uporządkować nasze SEO. Sorank dał nam przejrzysty obraz naszej strony, pomógł ustalić priorytety optymalizacji i właściwie uporządkować nasze treści. Narzędzie jest proste w obsłudze, dobrze zaprojektowane do pracy zespołowej i bardzo praktyczne do centralizacji monitoringu bez żonglowania wieloma platformami. Bardzo solidna podstawa, by zacząć SEO od nowa.”Gaspard MadouiAgencja reklamowa
“Dzięki Sorank wyspecjalizowałem się w GEO. Ranking GEO pozwala mi pokazywać klientom ich pozycję na tle konkurencji w ChatGPT. To realna przewaga handlowa.”MélanieFreelancer SEO
“Świetna usługa, dobrze działa dla naszej strony i pomaga zrozumieć, jak ją ulepszyć, aby lepiej pozycjonować się w Google i nie tylko. Gratulacje, tak trzymać, polecam.”Hugo T.Sprzedawca e-commerce