Налаштування
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

Виправте помилки сканування: DNS, сервер, robots.txt, 404, soft 404 і помилки переспрямування. Як реагує Googlebot і метод виправлення у 6 кроків.

Інструменти

Коротко
помилки сканування це запити пошукової системи або AI-краулера до вашого сайту, які завершуються невдачею: сервер не відповідає вчасно, DNS не відповідає, robots.txt не вдається завантажити, переспрямування зациклюється або сторінка повертає код 4xx чи 5xx. Помилки рівня сайту (DNS, сервер, robots.txt) можуть зупинити сканування Google на всьому сайті, тому виправляйте їх першими; помилки рівня URL (404, soft 404, помилки переспрямування) важливі лише тоді, коли зачіпають сторінки, які ви хочете бачити в індексі. Ви знаходите їх у звітах Search Console «Статистика сканування» та «Індексування сторінок», підтверджуєте краулером і серверними логами, потім усуваєте причину та запускаєте перевірку.
Хочете дізнатися більше? Запитайте
Швидкий тест
Хто має виправляти технічну частину вашого сайту?
Наша порада для вас
Перевірте самі безкоштовними інструментами Google
Search Console показує сторінки, які Google не може прочитати, а PageSpeed Insights перевіряє швидкість. Багато дрібних проблем виправляються в налаштуваннях конструктора сайту.
Наша порада для вас
Веб-розробник
Проблема в коді або на сервері: вам потрібен розробник, який знається на SEO. Дайте йому список помилок із Search Console.
Наша порада для вас
Інструмент технічного аудиту
На вашому сайті багато сторінок: сканер читає їх усі так, як Google, і дає повний список помилок для виправлення, сторінка за сторінкою.
Наша порада для вас
Автоматичний аудит, потім контент
Ваш сайт працює, але відвідувачів мало: технічні проблеми рідко є причиною. Sorank перевіряє сайт, а потім пише сторінки, що приводять відвідувачів.
Краулер працює як дуже терплячий відвідувач. Він запитує в сервера URL, чекає на відповідь, читає код стану та вміст, а потім переходить за знайденими посиланнями. Помилка сканування це будь-який крок цього ланцюжка, що не вдався. Відвідувач так і не отримує придатну сторінку.
Визначення важливе, бо багато звітів змішують помилки сканування з рішеннями щодо індексування. «Проскановано, наразі не проіндексовано» не є помилкою сканування: Google без проблем завантажив сторінку і вирішив її не зберігати. «Виключено тегом noindex» теж не помилка сканування: ви самі попросили Google прибрати сторінку. Помилка сканування означає, що збій стався в самому завантаженні.
Google поділяє проблеми на два рівні, і вам варто робити так само.
Помилки сайту та помилки URL
Інтернет-магазин із 4000 старих URL товарів, що повертають 404, може бути цілком здоровим, якщо ці товари зникли назавжди. Той самий магазин із robots.txt, який шість годин повертає 503, перебуває в справжній аварійній ситуації, навіть якщо всі картки товарів працюють. Починайте з хоста, потім з URL, які приносять гроші, потім з усього іншого.
Щоб правильно виправляти помилки сканування, треба знати, що Google робить насправді, коли з ними стикається. Документація Google про те, як коди стану HTTP і мережеві помилки впливають на Google Пошук (Google Search Central), задає правила. Ось що вони означають на практиці.
| Відповідь | Що робить Google | Це проблема? |
|---|---|---|
| 2xx | Передає вміст на індексування. Індексування не гарантоване. | Ні, якщо сторінка не порожня (soft 404). |
| 301, 308 | Сильний сигнал, що цільова адреса і є новим URL. | Ні, якщо це один перехід на сторінку з кодом 200. |
| 302, 303, 307 | Слабкий сигнал: вихідний URL зазвичай залишається канонічним. | Так, якщо перенесення постійне. |
| Ланцюжки 3xx | За замовчуванням проходить максимум 10 переходів, потім здається. | Так: кожен перехід витрачає запит, а цикли ніколи не розв'язуються. |
| 404, 410, інші 4xx (крім 429) | Вважає вміст неіснуючим, з часом видаляє проіндексовані URL і сканує їх рідше. | Лише якщо сторінка має існувати. |
| 401, 403 | Як і інші 4xx. Вони не сповільнюють сканування. | Так, якщо блокують Googlebot на публічних сторінках. |
| 429 | Сприймається як сигнал перевантаження сервера, як 5xx. | Так: сканування сповільнюється. |
| 5xx | Сповільнює сканування пропорційно до кількості помилок. URL, які й надалі дають збій, видаляються з індексу. | Так, завжди. |
На двох деталях спотикаються багато команд. По-перше, 401 і 403 не знижують частоту сканування. Якщо сервер не справляється, повернення 403 для Googlebot не допоможе; Google просить натомість тимчасово повертати 503 або 429. По-друге, 404 це не санкція. Це правильна відповідь для сторінки, якої більше немає.
Документація Google щодо звіту «Статистика сканування» (Довідка Search Console) пояснює правило. robots.txt, який відповідає 200 (навіть порожній) або 403, 404 чи 410 (файлу немає), у порядку. robots.txt, який відповідає 429 або 5xx, вважається збоєм, і тоді Google діє обережно.
Що робить Google, коли robots.txt і далі дає збій
Джерело: Довідка Search Console, звіт «Статистика сканування»
Отже, правило CDN або файрвол, що віддають 503 за адресою /robots.txt, можуть заморозити весь сайт на пів дня, навіть якщо всі інші URL працюють. У будь-якому розслідуванні помилок сканування перевіряйте цей файл першим. Наш посібник щодо статусу «Заблоковано файлом robots.txt» розбирає протилежну проблему, коли файл працює, але блокує забагато.
Ліміти сканування Google, які варто запам'ятати
Джерела: Google Search Central, коди стану HTTP і мережеві помилки; Довідка Search Console, звіт «Статистика сканування»
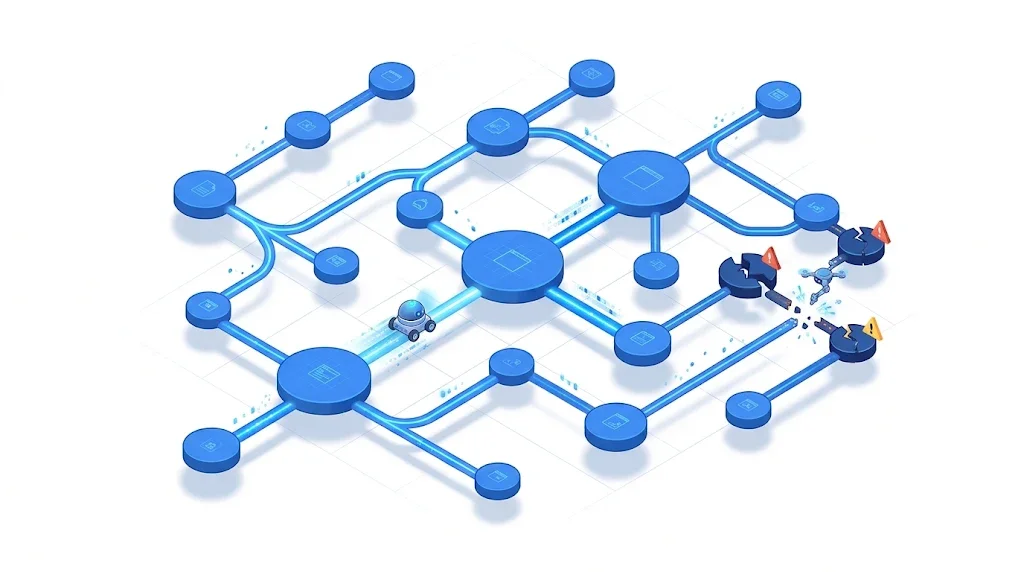
Ось повний список того, що ви зустрінете в Search Console і в краулерах, із причиною та виправленням для кожного випадку. Назви відповідають документації Google щодо звіту «Індексування сторінок» (Довідка Search Console).
Google не зміг перетворити доменне ім'я на IP-адресу, або DNS-сервер не відповів. Часті причини: прострочений домен, збій у DNS-провайдера, хибний запис після міграції або помилка в налаштуванні DNSSEC. Перевірте запитом поза вашою мережею:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
Виправлення: виправте записи, знижуйте TTL перед будь-якою міграцією і використовуйте DNS-провайдера з резервуванням. Якщо існують і example.com, і www.example.com, обидва мають розпізнаватися, навіть якщо один лише переспрямовує.
Сервер не відповів вчасно, закрив з'єднання або відповів кодом 500, 502, 503 чи 504. Типові причини: перевантажена база даних, процес PHP або Node, що падає під навантаженням, тайм-аут зворотного проксі, оновлення плагіна або файрвол, який обмежує ботів. Подивіться на розподіл у часі: помилки щоночі о тій самій годині часто вказують на резервне копіювання або завдання cron.
Виправлення: вивчіть журнал помилок сервера в моменти, які вказує Google, збільште тайм-аути або кількість робочих процесів, кешуйте важкі сторінки і переконайтеся, що захист від ботів пропускає перевірений Googlebot. Для планових робіт повертайте 503 із заголовком Retry-After, а не сторінку з кодом 200 і написом «скоро повернемося»:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600Сторінка не існує. Це нормально, якщо її видалили навмисно і на неї ніщо не посилається. Це проблема, якщо в URL досі є зворотні посилання, трафік або внутрішні посилання, або якщо сторінка має існувати, а її зламав деплой.
Виправлення: якщо вміст переїхав, поставте одну 301 на найближчий аналог. Якщо він зник назавжди, залиште 404 або використовуйте 410 і видаліть внутрішні посилання та записи в карті сайту, що на нього ведуть. Ніколи не переспрямовуйте всі 404 на головну: Google зазвичай вважає такі випадки soft 404.
Сервер відповідає 200, але сторінка виглядає порожньою або повідомляє «не знайдено»: порожня категорія, сторінка пошуку без результатів, товар, якого немає в наявності, без вмісту. Google витрачає на неї запит і нічого не отримує. Ми докладно розбираємо це в посібнику щодо помилок soft 404.
Googlebot ніколи не надсилає облікові дані, тому 401 або 403 на публічній сторінці означає, що її блокує ваш сервер або шар захисту. Часті винуватці: пароль тестового середовища, забутий на робочому сайті, правило WAF, блокування за країнами або захист від хотлінкінгу, застосований до HTML. Виправляйте правило, а не симптом, і перевіряйте інструментом перевірки URL у Search Console.
Google повідомляє про помилку переспрямування, коли натрапляє на цикл, задовгий ланцюжок, URL, довший за допустимий, або хибний чи порожній URL у ланцюжку. Класичний випадок після міграції: http на https, потім на www, потім на завершальну скісну риску, потім на новий шлях. Чотири переходи там, де вистачило б одного. Наш повний посібник щодо SEO-переспрямувань пояснює, як їх об'єднати.
Порада
Вставте підозрілий URL у безкоштовний інструмент перевірки переспрямувань Sorank: він проходить увесь ланцюжок, показує кожен перехід і його код стану та підказує, де саме цикл або зайвий перехід.
Деякі помилки взагалі не показують код стану. Сторінка починає завантажуватися і зупиняється, або вона настільки важка, що краулер читає лише її частину. Краулери Google читають обмежену кількість байтів на файл, тож сторінка, роздута вбудованими скриптами або зображеннями в base64, може втратити вміст унизу. Перевіряйте важкі шаблони інструментом перевірки розміру сторінки.
Жоден інструмент не показує всіх помилок сканування. Кожен метод бачить проблему під своїм кутом, і серйозний аудит поєднує щонайменше два.
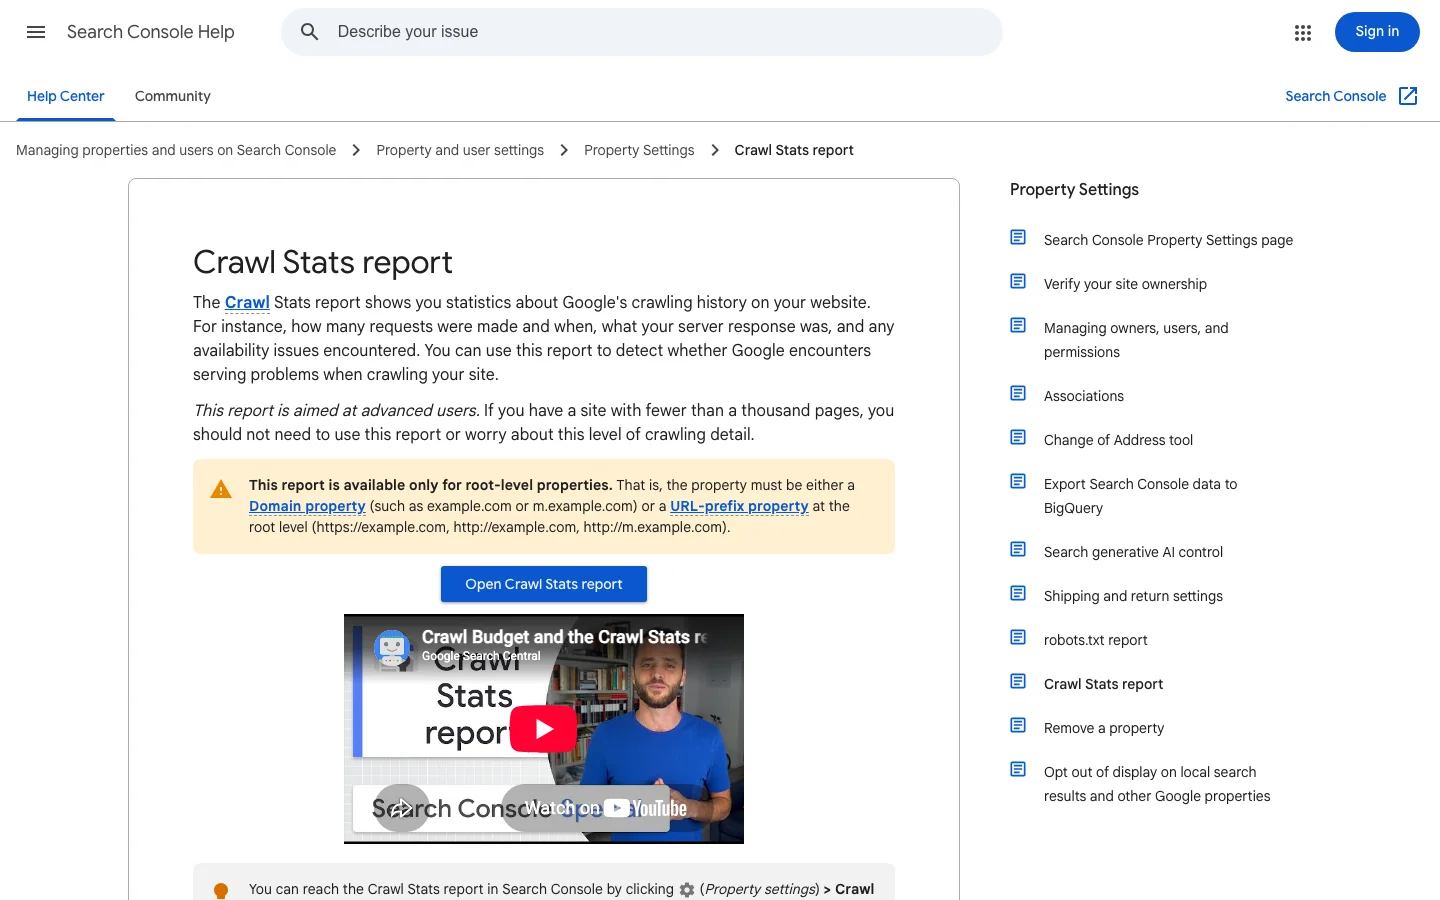
Принцип: Google показує власні запити сканування за останні 90 днів, згруповані за відповіддю, типом файлу, метою та типом Googlebot, а також статус хоста для DNS, сервера та robots.txt. Коли використовувати: завжди і насамперед для помилок сайту. Переваги: це істина з перших рук, від самого Google. Обмеження: лише для ресурсів кореневого рівня, приклади вибіркові, і Google каже, що сайтам до тисячі сторінок він рідко потрібен. Приклад: сплеск відповідей «тайм-аут сторінки» щонеділі о 3 ночі, що збігається з резервним копіюванням бази даних.
Принцип: перелічує відомі Google URL і причини, з яких вони не проіндексовані, наприклад «Помилка сервера (5xx)», «Помилка переспрямування», «Не знайдено (404)» або «Soft 404». Коли використовувати: для сортування помилок URL і перевірки виправлень. Переваги: прив'язаний до сторінок, які Google справді намагався завантажити. Обмеження: звіти запізнюються на кілька днів, списки прикладів обмежені, і він змішує помилки сканування з рішеннями щодо індексування. Приклад: 300 URL у розділі «Помилка переспрямування», і всі мають однаковий старий префікс /blog/.
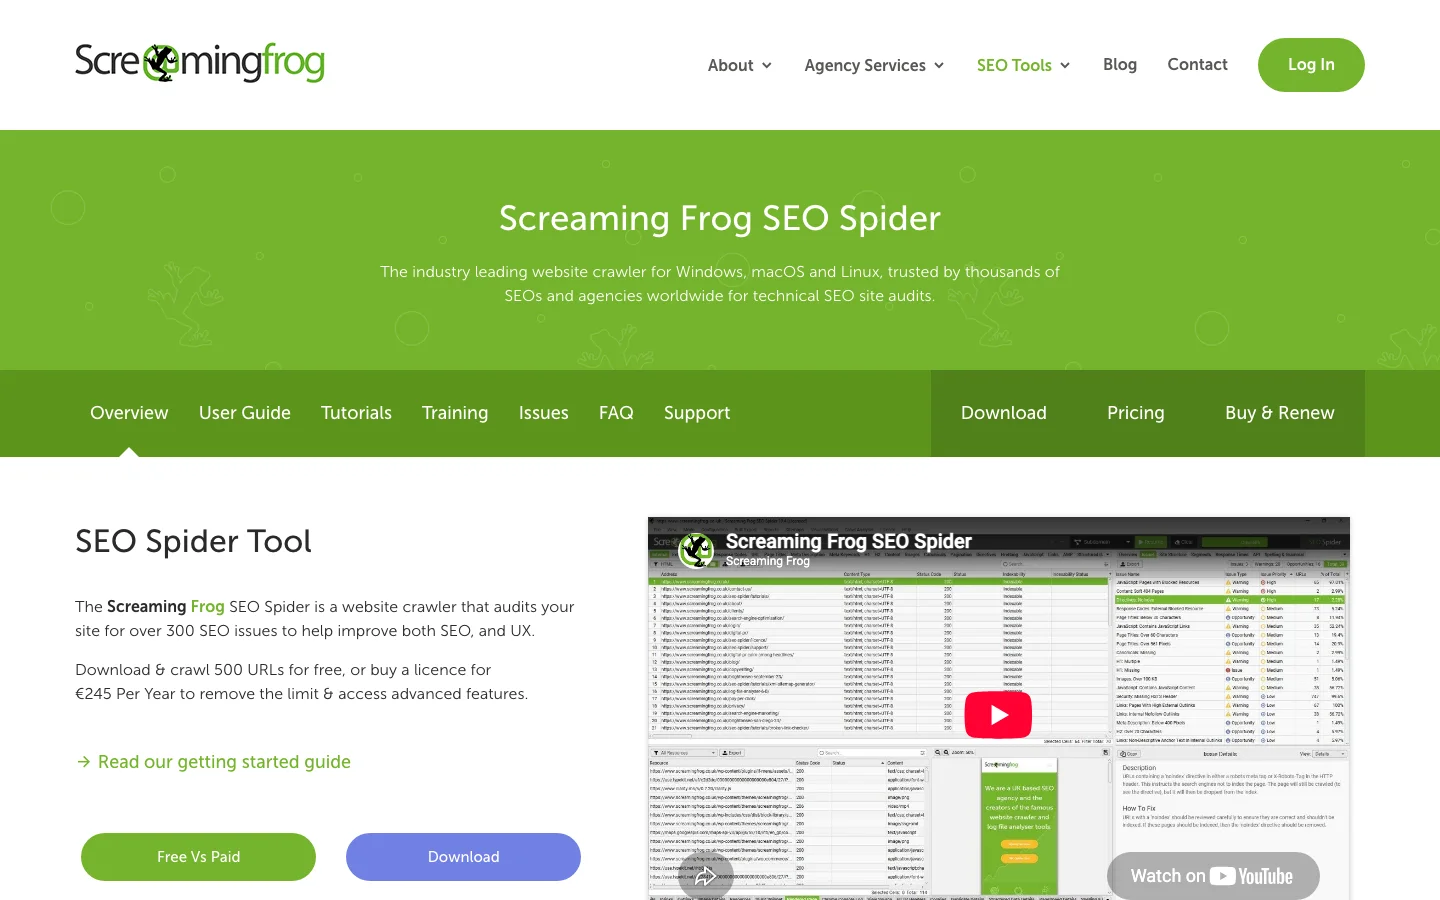
Принцип: інструмент на кшталт Screaming Frog сканує сайт так, як це зробив би бот: іде за посиланнями з головної і записує кожен код стану, ланцюжок переспрямувань і бите посилання. Коли використовувати: до і після міграції, редизайну або великого деплою, а на великих сайтах щомісяця. Переваги: миттєво, повно для сторінок із посиланнями, показує, де розташоване кожне бите посилання. Обмеження: не знає, що насправді запитував Google, пропускає сторінки-сироти, а ваш сервер може поводитися з ним інакше, ніж із Googlebot. Наш посібник із налаштування Screaming Frog проводить через повний аудит.
Принцип: журнали доступу фіксують кожен запит, зокрема запити Googlebot, Bingbot, GPTBot, ClaudeBot і PerplexityBot, із точним кодом стану та часом відповіді. Коли використовувати: на великих сайтах, після незрозумілого падіння трафіку і щоб побачити, що відвідують AI-краулери. Переваги: реальні запити, реальні коди, без вибірки, усі боти. Обмеження: потрібен доступ до логів і трохи скриптів; треба перевіряти, що «Googlebot» справді Google. Наш посібник з аналізу логів для SEO іде крок за кроком. Швидкий перший погляд:
# Запити Googlebot, що не повернули 200, 301 або 304, найчастіші зверху
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50Принцип: перевіряйте по одному URL через curl або безкоштовний онлайн-інструмент. Коли використовувати: щоб підтвердити виправлення або перевірити ключову сторінку після деплою. Переваги: миттєво і точно. Обмеження: не масштабується. Використовуйте user-agent Googlebot, щоб упіймати правила, які по-іншому поводяться з ботами:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| Метод | Бачить помилки сайту | Бачить помилки URL | Реальні дані Googlebot | Бачить AI-краулерів | Найкраще для |
|---|---|---|---|---|---|
| Статистика сканування | Так | Вибірково | Так | Ні | Здоров'я хоста |
| Індексування сторінок | Частково | Так | Так | Ні | Сортування і перевірка |
| Краулер (Screaming Frog...) | Ні | Так, сторінки з посиланнями | Ні | Ні | Пошук битих посилань біля джерела |
| Серверні логи | Частково | Так | Так | Так | Великі сайти, першопричини |
| Перевірка одного URL | Ні | По одному | Ні | Ні | Підтвердження виправлень |
Статус 5xx означає, що сервер не зміг обробити запит, який виглядав коректним. Google у відповідь сповільнює сканування, і сповільнює більше, коли більше ваших URL повертають помилки. Google деякий час зберігає вже проіндексовані URL, але вилучає ті, що стабільно повертають серверну помилку. Короткий сплеск можна пережити, бо Google поступово знову підвищує частоту сканування, щойно ваш сервер починає відповідати кодами 2xx. Довга серія помилок саме й псує індекс.
Кожен код 5xx вказує на іншу частину стеку. Таблиця дає перше місце, куди варто подивитися для кожного з них.
| Код | Що зазвичай означає | Що перевірити насамперед |
|---|---|---|
| 500 | Застосунок збився під час обробки запиту | Журнал помилок застосунку на точний час запиту |
| 502 | Проксі або CDN отримав некоректну відповідь від застосунку, часто через те, що він упав або перезапустився | Перезапуски та час роботи процесу застосунку |
| 503 | Сервіс перевантажений, обмежений за частотою запитів або на обслуговуванні | Графіки навантаження, історія розгортань і вікна технічного обслуговування |
| 504 | Проксі перестав чекати на відповідь застосунку | Повільні запити до бази даних і налаштування таймауту проксі |
| 429 | Обмежувач частоти каже, що запитів забагато | Правила обмеження частоти і те, чи поширюються вони на перевіреного Googlebot |
Статистика сканування показує дні й години, коли Google натрапив на помилки (наш посібник зі статистики сканування пояснює кожен графік). Серверний журнал показує, що відбувалося саме в ці моменти. Відфільтруйте запити Googlebot і порахуйте відповіді 5xx за годинами:
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
Кожен рядок результату: це година, код стану і кількість. Скупчення в ту саму годину щоночі зазвичай вказує на резервне копіювання, завдання cron або заплановане імпортування. Помилки, розкидані впродовж дня, зазвичай вказують на навантаження, тож розв'язок: потужність або кешування, а не одна окрема помилка. Глибший метод описано в нашому посібнику з аналізу файлів логів.
Google зменшує сканування пропорційно до кількості URL, які повертають помилки. Зламаний шаблон, що зачіпає кілька URL, коштує вам мало часу сканування. Збій бази даних, який ламає кожну сторінку, коштує дуже дорого, і його треба полагодити першим.
Відповідь 429 діє так само, як 5xx, бо Google читає її як перевантажений сервер. Якщо ваш обмежувач або захист від ботів віддає Googlebot код 429, ви платите за це часом сканування. У документації Google не згадується заголовок Retry-After. Надсилайте його далі людям і API-клієнтам, але не розраховуйте, що Googlebot чекатиме вказаний вами час.
Статус 4xx означає, що сервер відхилив запит через щось на боці клієнта: URL не існує, доступ заборонено або адресу сформовано некоректно. Google обробляє всі коди 4xx, крім 429, однаково. Він перестає використовувати вміст за цим URL і вилучає URL з індексу, якщо той був проіндексований. Перш ніж торкатися 4xx, з'ясуйте, звідки надходить запит, бо виправлення часто знаходиться в одному місці: в посиланні, шаблоні або правилі переспрямування.
Журнал доступу фіксує реферер кожного запиту, тобто показує, яка сторінка надіслала відвідувача або бота на цей URL. Порахуйте відповіді 4xx за шляхами та за рефером:
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
Читайте стовпець реферера так:
Реліз, який перейменовує маршрут, змінює slug або перебудовує шаблон, часто в той самий день спричиняє хвилю 404. Вивантажте кількість відповідей 4xx за днями за тиждень до викладки і за тиждень після. Зростання, зосереджене в одній папці, вказує прямо на зміну. Додайте переспрямування зі старого URL на новий у тому самому релізі, а не в окремому завданні пізніше. Для повного переносу див. наш чек-лист SEO-міграції.
Порада
Не замінюйте відсутню сторінку відповіддю 200, яка показує коротке повідомлення або порожній список. Google може вважати її soft 404, а це коштує повного завантаження і нічого не повертає.
Це метод, яким користуємося ми. Він іде від помилок, здатних зупинити весь сайт, до тих, що лише трохи марнують сканування.
Метод виправлення помилок сканування у 6 кроків
У Search Console відкрийте «Налаштування», потім «Статистика сканування», потім «Статус хоста». Зелений колір означає відсутність серйозних проблем за 90 днів. «Нещодавня проблема» означає серйозну проблему за останній тиждень: відкладіть усе інше. Натисніть на кожну категорію, щоб побачити частку збоїв за днями, а потім зіставте погані дні з історією хостингу, CDN і деплоїв.
Відкрийте «Індексування», потім «Сторінки», і вивантажте кожну причину помилки. Не виправляйте URL по одному. Перенесіть їх у таблицю і витягніть першу папку:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")Зведена таблиця за цим стовпцем зазвичай показує, що більшість помилок походить із двох-трьох шаблонів: закритої категорії блогу, параметра фільтра, старого фіда товарів.
Для кожного шаблону поставте чотири запитання. Чи отримує він органічні кліки? Чи має зворотні посилання? Чи є на нього внутрішні посилання? Чи є він у карті сайту? 404 без жодної з цих ознак може чекати вічно. 404 зі зворотними посиланнями потребує 301 уже сьогодні. Безкоштовний інструмент пошуку битих посилань показує, які з ваших сторінок досі посилаються на мертві URL.
Виправляйте правила, а не URL. Карта переспрямувань у конфігурації сервера краща за 400 переспрямувань, доданих уручну в плагіні. Наприклад, у nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Для 5xx виправте потужність сервера або помилку. Для 401 і 403 виправте правило безпеки. Для soft 404 або додайте справжній вміст, або повертайте справжній 404.
Кожне внутрішнє посилання має вести прямо на URL, який повертає 200. Кожен запис у карті сайту має бути канонічним, індексованим URL із кодом 200. Карта сайту, повна переспрямувань і 404, привчає Google довіряти їй менше. Наш посібник про те, як створити карту сайту, пояснює, що до неї має входити.
У звіті «Індексування сторінок» відкрийте виправлену причину і натисніть «Перевірити виправлення». Google спочатку перевіряє вибірку, потім решту; зазвичай це триває приблизно до двох тижнів, і перевірка зупиняється, якщо хоч один URL досі дає збій. Не натискайте повторно, поки вона триває. Потім заведіть щотижневу рутину: «Статистика сканування» для хоста, логи для сплесків, сканування після кожного деплою.
Ланцюжок переспрямувань до і після виправлення
Що це: плагін або правило, яке надсилає будь-який відсутній URL на /. Як помітити: багато URL у розділах «Soft 404» або «Сторінка з переспрямуванням», і всі вони ведуть на головну; краулер показує сотні 301 з однаковою ціллю. Як виправити: переспрямовуйте лише на близький аналог, а решта хай повертає 404 або 410.
Що це: WAF, менеджер ботів або обмежувач частоти, який віддає Google 403, 429 або сторінку перевірки. Як помітити: 403 або 429 у «Статистиці сканування», хоча у вашому браузері сторінка відкривається нормально; логи показують блокування за IP. Як виправити: дозвольте перевірений Googlebot через зворотний DNS або опубліковані Google діапазони IP, а не довіряйте рядку user-agent.
Що це: robots.txt генерується застосунком і тому ламається щоразу, коли ламається застосунок, або віддається через правило CDN, яке кешує 5xx. Як помітити: категорія завантаження robots.txt у «Статусі хоста» не зелена. Як виправити: віддавайте його як статичний файл поза застосунком і перевіряйте інструментом перевірки robots.txt.
Що це: сторінка «Скоро повернемося», яка віддається з кодом 200 на всіх URL. Як помітити: після технічних робіт хвиля soft 404 або дубльованих заголовків. Як виправити: під час технічних робіт повертайте 503 з Retry-After і робіть їх короткими.
Що це: відповідь 403 для Googlebot, коли сервер перевантажений. Як помітити: сплески 403, що збігаються з піками навантаження. Як виправити: Google каже, що коди 4xx, крім 429, не впливають на частоту сканування. Ненадовго повертайте 503 або 429 і збільште потужність.
Що це: гортати список у Search Console і редагувати кожен URL. Як помітити: та сама причина повертається щомісяця. Як виправити: групуйте за шаблоном, виправте шаблон або правило, потім запустіть перевірку один раз.
Що це: витрачати дні на 404 для спамних URL або давно видалених сторінок без посилань. Як помітити: ці URL не мають кліків, зворотних і внутрішніх посилань. Як виправити: залиште їх. Google каже, що 404 для видаленої сторінки не обов'язково є проблемою.
Увага
Ніколи не блокуйте URL у robots.txt, щоб «сховати» помилку сканування. Google більше не побачить 404 або переспрямування, URL може залишитися в індексі, а ви втратите сигнал, який намагалися передати.
На сайті з кількох сотень сторінок Google має час на все, і помилки сканування важливі здебільшого для тих сторінок, які вони ламають. На великих сайтах (магазини з фільтрами, маркетплейси, новинні сайти) кожен невдалий або змарнований запит забирає час у ваших справжніх сторінок. У цьому й полягає ідея краулінгового бюджету.
Через 5xx і 429 Google сповільнюється на всьому хості, тож кілька зламаних шаблонів можуть затримати сканування ваших нових карток товарів. Ланцюжки переспрямувань коштують по запиту на кожен перехід. Soft 404 коштує повного завантаження і нічого не дає натомість. Виправте ці три речі, і той самий бюджет покриє більше корисних сторінок.
Коли Google знаходить URL, але відкладає їх сканування, причиною часто є сервер, який він вважає ненадійним. Якщо ви бачите, що зростає кількість сторінок «Виявлено, наразі не проіндексовано», а в «Статистиці сканування» є помилки сервера, спершу виправте сервер. Обидва звіти розповідають одну й ту саму історію.
Googlebot уже не єдиний важливий відвідувач. GPTBot, OAI-SearchBot, ClaudeBot і PerplexityBot завантажують сторінки, щоб навчати моделі або відповідати на запитання в реальному часі. Вони звертаються до того самого сервера і страждають від тих самих помилок, з однією відмінністю: для них немає Search Console.
Більшість AI-краулерів не виконують JavaScript, тож сторінка, яка збирає вміст лише в браузері, може здаватися їм порожньою: це своєрідний soft 404, якого ви ніколи не побачите у звітах Google. Багатьох із них за замовчуванням блокують сервіси захисту від ботів, часто кодом 403. А оскільки вони завантажують сторінки на вимогу, коли користувач ставить запитання, тайм-аут у цю мить означає, що відповідь процитує когось іншого. Наш посібник з SEO для JavaScript розбирає рендеринг і для пошукових, і для AI-краулерів.
Серверні логи єдине надійне джерело. Відфільтруйте за user-agent і подивіться коди стану:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnЯкщо AI-боти отримують 403, яких ви не планували, виправте правило. Потім перевірте, чи справді вони вас цитують: відстеження згадок в AI від Sorank показує, як часто ChatGPT, Gemini, Claude і Perplexity згадують ваш бренд, і ви бачите, чи змінило щось виправлення сканування.
Проходьте цей список після кожної міграції, редизайну або великого деплою, а на великих сайтах раз на місяць.
Чек-лист здоров'я сканування
Відкрийте «Статистику сканування» і перевірте три рядки статусу хоста. Потім запустіть безкоштовний інструмент перевірки індексованості для п'яти найцінніших сторінок. Якщо і там, і там чисто, вивантажте помилки з «Індексування сторінок» і згрупуйте їх за папками: у вас з'явиться короткий упорядкований список виправлень замість страшного звіту.
Коли сканування в порядку, наступним обмеженням стає сам вміст. Оптимізація контенту від Sorank переписує та оновлює ваші наявні сторінки в режимі autopilot, щоб сторінки, до яких тепер дістається Google, варто було індексувати й цитувати. Для сторінок, які Google просканував, але не включив до індексу, прочитайте наш посібник щодо статусу «Проскановано, наразі не проіндексовано».
Помилки сканування це невдалі запити пошукової системи або AI-краулера: DNS не розпізнається, сервер не відповідає вчасно або повертає 5xx, robots.txt не вдається завантажити, переспрямування зациклюється або сторінка повертає код 4xx. Помилки рівня сайту можуть призупинити сканування всього сайту, а помилки URL зачіпають лише конкретну сторінку.
Самі по собі ні. Google каже, що 404 для сторінки, видаленої без заміни, не обов'язково є проблемою. Проблемою це стає, коли в URL залишилися зворотні посилання, трафік або внутрішні посилання, і тоді правильне рішення це одна 301 на близький аналог.
Після натискання «Перевірити виправлення» у звіті «Індексування сторінок» Search Console перевірка зазвичай триває приблизно до двох тижнів. Google спочатку перевіряє вибірку URL, потім решту, і зупиняє перевірку, якщо хоч один зачеплений URL досі дає збій.
Ми аналізуємо ваших конкурентів, ваш сайт і вашу видимість у ШІ, щоб безкоштовно скласти персоналізований контент-план.
 ШІ-генератор брифів для контенту
 Генератор FAQ-розмітки
 ШІ-генератор ідей для статей у блозі
 Валідатор структурованих даних (валідатор Schema)
 Перевірка alt-тексту
 Аналізатор внутрішніх посилань
 Челендж із зворотних посилань
 ШІ-генератор мета-описів
 ШІ-генератор заголовків для блогу
 Перевірка індексованості в Google
 ШІ-генератор плану статті для блогу
 Конструктор UTM-посилань
 Інструмент кластеризації ключових слів
 Перевірка тегу canonical
 Генератор XML-карти сайту
 Перевірка битих посилань
 ШІ-генератор SEO-заголовків
 Аналізатор заголовків
 Попередній перегляд пошукової видачі
 Перевірка перенаправлень
 Генератор тегів hreflang
 Аналізатор структури заголовків
 Перевірка HTTP-заголовків
 Екстрактор фавіконок
 Калькулятор CTR у видачі
 Калькулятор економії SEO порівняно з платним пошуком
 Калькулятор частки голосу в SEO
 Калькулятор ROI від SEO
 Калькулятор прогнозу трафіку та доходу від SEO
 Калькулятор бюджету SEO
 Калькулятор беззбитковості SEO
 Калькулятор ROI від SEO для SaaS
 Калькулятор ROAS
 Калькулятор часу читання
 Симулятор приросту позицій
 Калькулятор вартості органічного трафіку
 Оцінювач органічного трафіку та перевірка відвідуваності сайту
 Калькулятор співвідношення LTV до CAC
 Калькулятор ROI локального SEO
 Калькулятор вартості лінкбілдингу
 Калькулятор вартості ключового слова
 Калькулятор оцінки можливостей ключових слів
 Калькулятор щільності ключових слів
 Калькулятор ROI GEO
 Калькулятор інвестицій у GEO-контент
 Калькулятор ROI SEO для інтернет-магазину
 Калькулятор пожиттєвої цінності клієнта
 Калькулятор вартості залучення клієнта
 Калькулятор CTR
 Калькулятор вартості статті
 Калькулятор коефіцієнта конверсії
 Калькулятор ROI контент-маркетингу
 Оцінювач реферального трафіку з ChatGPT
 Калькулятор показника відмов
 Калькулятор ROI зворотних посилань
 Калькулятор оцінки видимості у ШІ
 Калькулятор вартості AI-трафіку
 Калькулятор частки голосу в ШІ
 Калькулятор вартості невидимості в ШІ
 Калькулятор частоти цитування в ШІ
 Валідатор llms.txt
 Перевірка AI Overview і позицій в AI Overviews
 Перевірка robots.txt
 SEO-аудит для ШІ
 Перевірка читабельності для LLM
 Перевірка готовності до SearchGPT
 Аудит структурованих даних для LLM
 ШІ-аудит доступності сайту для краулерів
 Чому ChatGPT не рекомендує мій сайт
 Інструмент позицій у Gemini
 Перевірка позицій у Perplexity
 Перевірка цитування в LLM
 Аудит оптимізації для відповідних систем (AEO)
 GEO-аудит
 Тест видимості в ШІ-пошуку
 Перевірка видимості в ChatGPT
 Генератор llms.txt
 Екстрактор URL
 Веб-сторінка в Markdown
 Перевірка карти сайту
 Сенсор волатильності видачі
 Перевірка розміру сторінки
 Лічильник слів
 Генератор слагів
 Генератор Schema
 Генератор Robots
 Попередній перегляд Open Graph
 Генератор мета-тегів
 Компресор зображень
 Генератор фавіконок
 SEO-аудит сторінки: SEO-перевірка та SEO-аналіз
 Інструмент аналізу зворотних посилань
 Інструмент підбору ключових слів
 Перевірка авторитету домену
 “Я протестував Sorank на реальному сайті клієнта, і це неймовірно. Він робить усе, за що агенція виставила б вам рахунок на 1500 доларів на місяць. Тепер його запускають у роботу на цьому клієнті.”

 Guillaume Guersanguersanguillaume.com“Ми рекламна агенція і хотіли раз і назавжди повернути своє SEO в нормальне русло. Sorank дав нам чітке уявлення про наш сайт, допоміг розставити пріоритети оптимізацій і належним чином структурувати наш контент. Інструмент простий у використанні, добре продуманий для команди й дуже зручний для централізованого відстеження без жонглювання кількома платформами. Дуже міцна основа, щоб почати наше SEO з нуля.”
 Gaspard MadouiРекламна агенція
 “Я просто дозволив програмі Sorank повністю робити свою справу, і тепер мій показник DR дорівнює 25, а моя сторінка піднялася вище в пошуку.”
 Lucas Flandrefoundertrace.fr“Я спеціалізувалася на GEO завдяки Sorank. Рейтинг GEO дає змогу показувати клієнтам їхню позицію щодо конкурентів у ChatGPT. Це справжня комерційна перевага.”
 MélanieSEO-фрілансерка“Чудовий сервіс, добре працює для нашого сайту й допомагає зрозуміти, як його покращити, щоб вище ранжуватися в Google та поза ним. Вітаю, так тримати, рекомендую.”
 Hugo T.Власник інтернет-магазину