La privacy è importante per noi, quindi hai la possibilità di disabilitare alcuni tipi di archiviazione che potrebbero non essere necessari per il funzionamento di base del sito web. Il blocco delle categorie può influire sulla tua esperienza sul sito web. Ulteriori informazioni (Politica sui cookie)
Grazie! La tua richiesta è stata ricevuta!
Ops! Qualcosa è andato storto durante l'invio del modulo.
Errori di scansione: come trovare, prioritizzare e correggere ogni tipo
Correggi gli errori di scansione: DNS, server, robots.txt, 404, soft 404 e reindirizzamenti. Come reagisce Googlebot a ciascuno e un metodo in 6 passaggi.
Una mappa di un sito in cui alcune pagine sono segnalate con errori mentre un crawler segue i link tra di esse.
Strumenti
In questa pagina
In breve
gli errori di scansione sono le richieste che un motore di ricerca o un crawler di IA invia al tuo sito e che falliscono: il server va in timeout, il DNS non risponde, il robots.txt non è recuperabile, un reindirizzamento va in loop o una pagina restituisce un codice 4xx o 5xx. Gli errori a livello di sito (DNS, server, robots.txt) possono impedire a Google di scansionare tutto il sito, quindi correggili per primi; gli errori a livello di URL (404, soft 404, errori di reindirizzamento) contano solo quando colpiscono pagine che vuoi indicizzare. Li trovi nei rapporti Statistiche di scansione e Indicizzazione delle pagine di Search Console, li confermi con un crawler e con i log del server, poi correggi la causa e convalidi.
Controlla da solo con gli strumenti gratuiti di Google
Search Console elenca le pagine che Google non riesce a leggere e PageSpeed Insights misura la velocità. Molti piccoli problemi si risolvono dalle impostazioni del tuo strumento di creazione del sito.
Il nostro consiglio per te
Uno sviluppatore web
Il problema è nel codice o nel server: uno sviluppatore che conosce la SEO è la persona giusta. Dagli l'elenco degli errori di Search Console.
Il nostro consiglio per te
Uno strumento di audit tecnico
Il tuo sito ha molte pagine: un crawler le legge tutte come Google e fornisce l'elenco completo degli errori da correggere, pagina per pagina.
Il nostro consiglio per te
Un audit automatico, poi contenuti
Il tuo sito funziona ma porta pochi visitatori: i problemi tecnici raramente sono la causa. Sorank fa l'audit del sito, poi scrive le pagine che portano traffico.
Cosa sono gli errori di scansione, e cosa non sono
Un crawler si comporta come un visitatore molto paziente. Chiede un URL al tuo server, aspetta la risposta, legge il codice di stato e il contenuto, poi passa ai link che ha trovato. Un errore di scansione è qualsiasi passaggio di questa catena che fallisce. Il visitatore non riceve mai una pagina utilizzabile.
Questa definizione è importante perché molti rapporti mescolano errori di scansione e decisioni di indicizzazione. «Pagina sottoposta a scansione, ma attualmente non indicizzata» non è un errore di scansione: Google ha recuperato la pagina senza problemi e ha scelto di non tenerla. «Esclusa tramite tag noindex» non lo è nemmeno: sei tu ad aver chiesto a Google di toglierla. Un errore di scansione significa che il recupero stesso è andato storto.
Le due famiglie: errori del sito ed errori degli URL
Google divide i problemi in due livelli, e dovresti farlo anche tu.
Errori del sito (Google li chiama problemi di stato dell'host): errori di risoluzione DNS, errori di connessione al server ed errori di recupero del robots.txt. Colpiscono ogni URL dell'host. Una brutta giornata a questo livello può congelare la scansione dell'intero sito.
Errori degli URL: una pagina restituisce 404, 410, 401, 403, 5xx, un soft 404 o un reindirizzamento rotto. Colpiscono solo quell'URL, e molti sono innocui.
Errori del sito ed errori degli URL
Errori del sito (da correggere oggi)
Il DNS non si risolve
Il server va in timeout o chiude la connessione
Il robots.txt restituisce 5xx o 429
Visibili in Statistiche di scansione, Stato host
Possono sospendere la scansione di tutte le pagine
Errori degli URL (da smistare)
404, 410, soft 404
401, 403, altri 4xx
Loop di reindirizzamento o catena troppo lunga
Visibili nel rapporto Indicizzazione delle pagine
Contano solo sulle pagine da indicizzare
Perché questa distinzione cambia le tue priorità
Un negozio con 4000 vecchi URL di prodotto in 404 può essere in perfetta salute se quei prodotti sono spariti per sempre. Lo stesso negozio con un robots.txt che restituisce 503 per sei ore vive una vera emergenza, anche se ogni scheda prodotto funziona. Parti dall'host, poi dagli URL che portano fatturato, poi dal resto.
Passa il contenuto all'indicizzazione. L'indicizzazione non è garantita.
No, a meno che la pagina sia vuota (soft 404).
301, 308
Segnale forte che la destinazione è il nuovo URL.
No, se è un solo salto verso una pagina 200.
302, 303, 307
Segnale debole: l'URL originale tende a restare il canonico.
Sì, se lo spostamento è definitivo.
Catene di 3xx
Segue fino a 10 salti per impostazione predefinita, poi rinuncia.
Sì: ogni salto spreca una richiesta e i loop non si risolvono mai.
404, 410, altri 4xx (tranne 429)
Considera il contenuto inesistente, rimuove col tempo gli URL indicizzati e li scansiona meno spesso.
Solo se la pagina dovrebbe esistere.
401, 403
Come gli altri 4xx. Non rallentano la scansione.
Sì, se bloccano Googlebot su pagine pubbliche.
429
Trattato come segnale di sovraccarico del server, come un 5xx.
Sì: la scansione rallenta.
5xx
Rallenta la scansione in proporzione agli errori. Gli URL che continuano a fallire vengono rimossi dall'indice.
Sì, sempre.
Due dettagli mettono in difficoltà molti team. Primo, 401 e 403 non riducono la frequenza di scansione. Se il tuo server è in affanno, restituire 403 a Googlebot non aiuta; Google chiede invece di restituire temporaneamente 503 o 429. Secondo, un 404 non è una penalizzazione. È la risposta corretta per una pagina che non esiste più.
Gli errori del robots.txt sono i più pericolosi
La documentazione del rapporto Statistiche di scansione (Guida di Search Console) spiega la regola. Un robots.txt che risponde 200 (anche vuoto) o 403, 404 o 410 (nessun file) va bene. Un robots.txt che risponde 429 o 5xx è un errore, e Google allora va sul sicuro.
Cosa fa Google quando il robots.txt continua a fallire
Prime 12 oreGoogle interrompe del tutto la scansione del sito.
Fino a 30 giorniGoogle usa l'ultimo robots.txt recuperato con successo.
Dopo 30 giorniIl comportamento dipende dalla raggiungibilità della home page.
Fonte: Guida di Google Search Console, rapporto Statistiche di scansione
Una regola della CDN o un firewall che restituisce 503 su /robots.txt può quindi congelare tutto il sito per mezza giornata, anche se ogni altro URL funziona. Controlla questo file per primo in ogni indagine sugli errori di scansione. La nostra guida sullo stato «Bloccata da robots.txt» tratta il problema opposto, quando il file funziona ma blocca troppo.
I limiti di scansione di Google da ricordare
10salti di reindirizzamento seguiti al massimo dai crawler di Google
12 hdi stop della scansione quando il robots.txt restituisce 5xx o 429
30 giorniin cui Google continua a usare l'ultimo robots.txt valido
5%di errori DNS giornalieri citato come esempio di problema dell'host
Fonti: Google Search Central, codici di stato HTTP ed errori di rete; Guida di Search Console, rapporto Statistiche di scansione
Gli errori di scansione sono i punti in cui il percorso di un crawler nel tuo sito si interrompe.
Ogni tipo di errore di scansione, spiegato con la sua correzione
Google non è riuscito a trasformare il tuo nome di dominio in un indirizzo IP, oppure il server DNS non ha risposto. Cause comuni: un dominio scaduto, un disservizio del provider DNS, un record errato dopo una migrazione o una configurazione DNSSEC sbagliata. Verifica con una query lanciata dall'esterno della tua rete:
Correzione: sistema i record, abbassa il TTL prima di ogni migrazione e scegli un provider DNS ridondato. Se esistono sia example.com sia www.example.com, entrambi devono risolversi, anche se uno si limita a reindirizzare.
Errori di connessione al server e 5xx
Il server non ha risposto in tempo, ha chiuso la connessione o ha risposto con 500, 502, 503 o 504. Cause tipiche: un database sovraccarico, un processo PHP o Node che va in crash sotto carico, un timeout del reverse proxy, un aggiornamento di un plugin o un firewall che limita i bot. Guarda la distribuzione nel tempo: errori alla stessa ora ogni notte indicano spesso un backup o un cron job.
Correzione: leggi il log degli errori del server negli orari indicati da Google, aumenta i timeout o il numero di worker, metti in cache le pagine pesanti e assicurati che la protezione anti-bot lasci passare il Googlebot verificato. Per una manutenzione programmata, restituisci un 503 con un'intestazione Retry-After invece di una pagina 200 con scritto «torniamo presto»:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 e 410 (non trovata)
La pagina non esiste. Va bene se è stata eliminata di proposito e nulla vi rimanda più. È un problema quando l'URL ha ancora backlink, traffico o link interni, oppure quando la pagina dovrebbe esistere e un rilascio l'ha rotta.
Correzione: se il contenuto si è spostato, aggiungi un solo 301 verso l'equivalente più vicino. Se è sparito per sempre, tieni il 404 o usa il 410, e rimuovi i link interni e le voci della sitemap che vi puntano. Non reindirizzare mai tutti i 404 alla home page: Google tende a trattarli come soft 404.
Soft 404
Il server dice 200 ma la pagina sembra vuota o dice «non trovata»: una categoria vuota, una pagina di ricerca senza risultati, un prodotto esaurito senza contenuto. Google spende una richiesta e non ottiene nulla. Ne parliamo in dettaglio nella nostra guida sugli errori soft 404.
401, 403 e altri 4xx
Googlebot non invia mai credenziali, quindi un 401 o un 403 su una pagina pubblica significa che il tuo server o un livello di sicurezza lo sta bloccando. Colpevoli abituali: una password di staging rimasta in produzione, una regola del WAF, un blocco per paese o una protezione anti-hotlink applicata all'HTML. Correggi la regola, non il sintomo, e verifica con lo strumento Controllo URL di Search Console.
Errori di reindirizzamento
Google segnala un errore di reindirizzamento quando trova un loop, una catena troppo lunga, un URL che supera la lunghezza massima o un URL non valido o vuoto nella catena. Il caso classico dopo una migrazione: da http a https, poi a www, poi alla barra finale, poi a un nuovo percorso. Quattro salti dove ne basterebbe uno. La nostra guida completa ai reindirizzamenti SEO spiega come accorciarli.
Consiglio
Incolla qualsiasi URL sospetto nel verificatore di reindirizzamenti gratuito di Sorank: segue tutta la catena, mostra ogni salto con il suo codice di stato e ti dice dove si trova il loop o il salto in più.
Timeout, risposte troncate e pagine troppo pesanti
Alcuni errori non mostrano mai un codice di stato. La pagina inizia a caricarsi e si ferma, oppure è così pesante che il crawler ne legge solo una parte. I crawler di Google leggono un numero limitato di byte per file, quindi una pagina gonfia di script inline o di immagini in base64 può perdere il contenuto in fondo. Controlla i template pesanti con il verificatore del peso della pagina.
Tutti i metodi per trovare gli errori di scansione, a confronto
Nessuno strumento da solo mostra tutti gli errori di scansione. Ogni metodo vede il problema da un'angolazione diversa, e un audit serio ne combina almeno due.
Metodo 1: Search Console, rapporto Statistiche di scansione
Principio: Google mostra le proprie richieste di scansione degli ultimi 90 giorni, raggruppate per risposta, tipo di file, scopo e tipo di Googlebot, più lo stato dell'host per DNS, server e robots.txt. Quando usarlo: sempre, e per primo, per gli errori del sito. Vantaggi: sono i dati reali forniti da Google stesso. Limiti: solo per le proprietà a livello di dominio principale, esempi a campione, e Google precisa che i siti con meno di mille pagine raramente ne hanno bisogno. Esempio: un picco di risposte «timeout della pagina» ogni domenica alle 3, in corrispondenza di un backup del database.
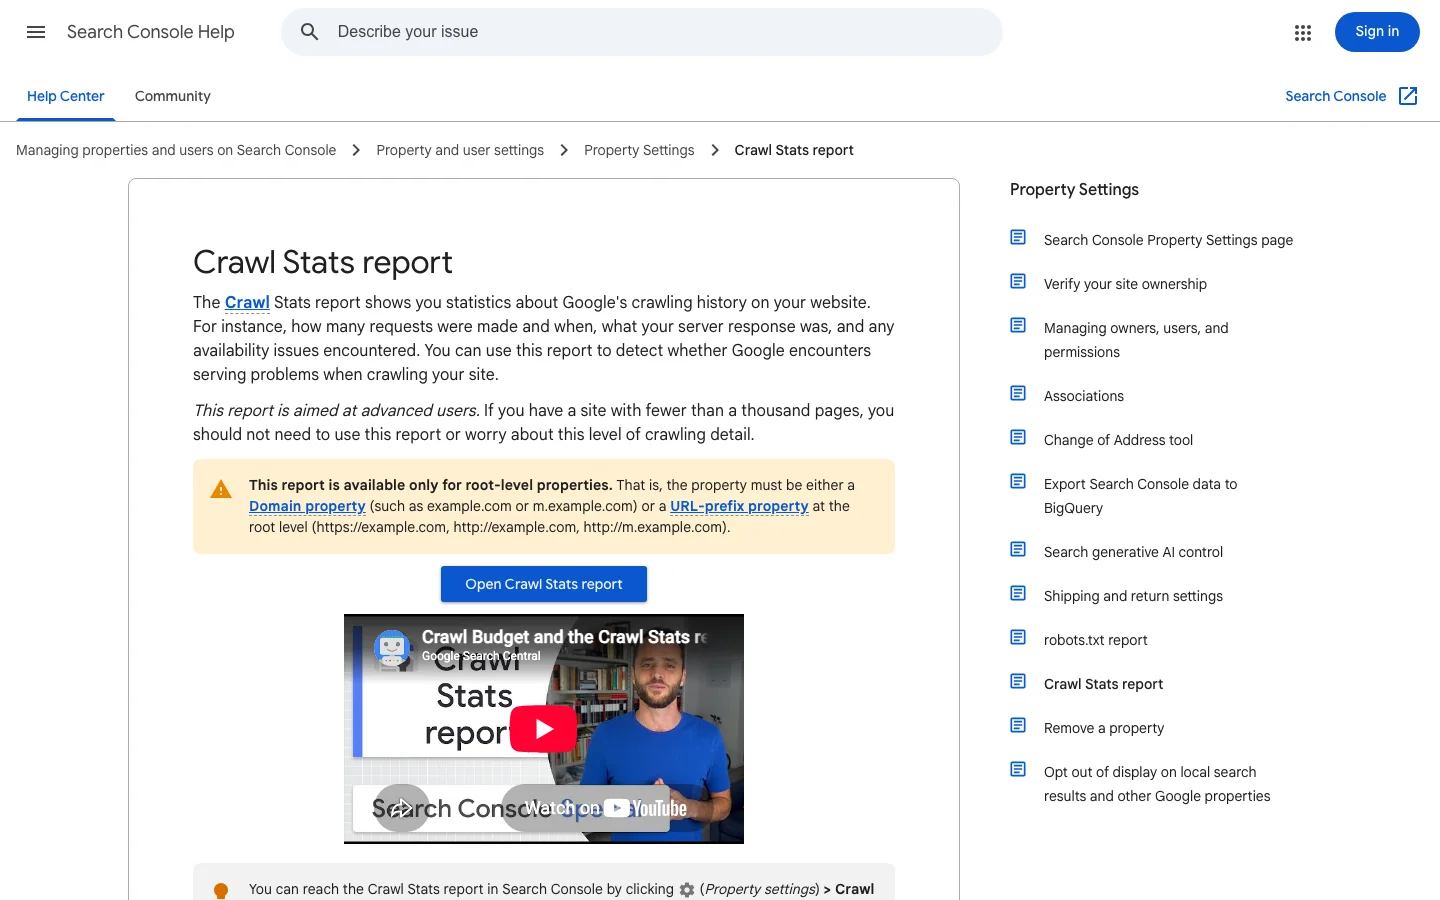
La documentazione di Google sul rapporto Statistiche di scansione, che spiega lo stato dell'host per DNS, server e robots.txt.
Metodo 2: Search Console, rapporto Indicizzazione delle pagine e Controllo URL
Principio: elenca gli URL che Google conosce e il motivo per cui non sono indicizzati, con voci come Errore del server (5xx), Errore di reindirizzamento, Non trovata (404) o Soft 404. Quando usarlo: per smistare gli errori degli URL e convalidare le correzioni. Vantaggi: legato alle pagine che Google ha davvero tentato. Limiti: i rapporti hanno giorni di ritardo, gli elenchi di esempi hanno un limite e mescola errori di scansione e scelte di indicizzazione. Esempio: 300 URL in «Errore di reindirizzamento» che condividono tutti il vecchio prefisso /blog/.
Metodo 3: un crawler desktop o in cloud
Principio: uno strumento come Screaming Frog scansiona il tuo sito come farebbe un bot, seguendo i link dalla home page, e registra ogni codice di stato, ogni catena di reindirizzamenti e ogni link rotto. Quando usarlo: prima e dopo una migrazione, un restyling o un grande rilascio, e ogni mese sui siti grandi. Vantaggi: immediato, completo per le pagine collegate, mostra dove si trova ogni link rotto. Limiti: non sa cosa Google abbia davvero richiesto, non vede le pagine orfane e il tuo server può trattarlo diversamente da Googlebot. La nostra guida alla configurazione di Screaming Frog accompagna in un audit completo.
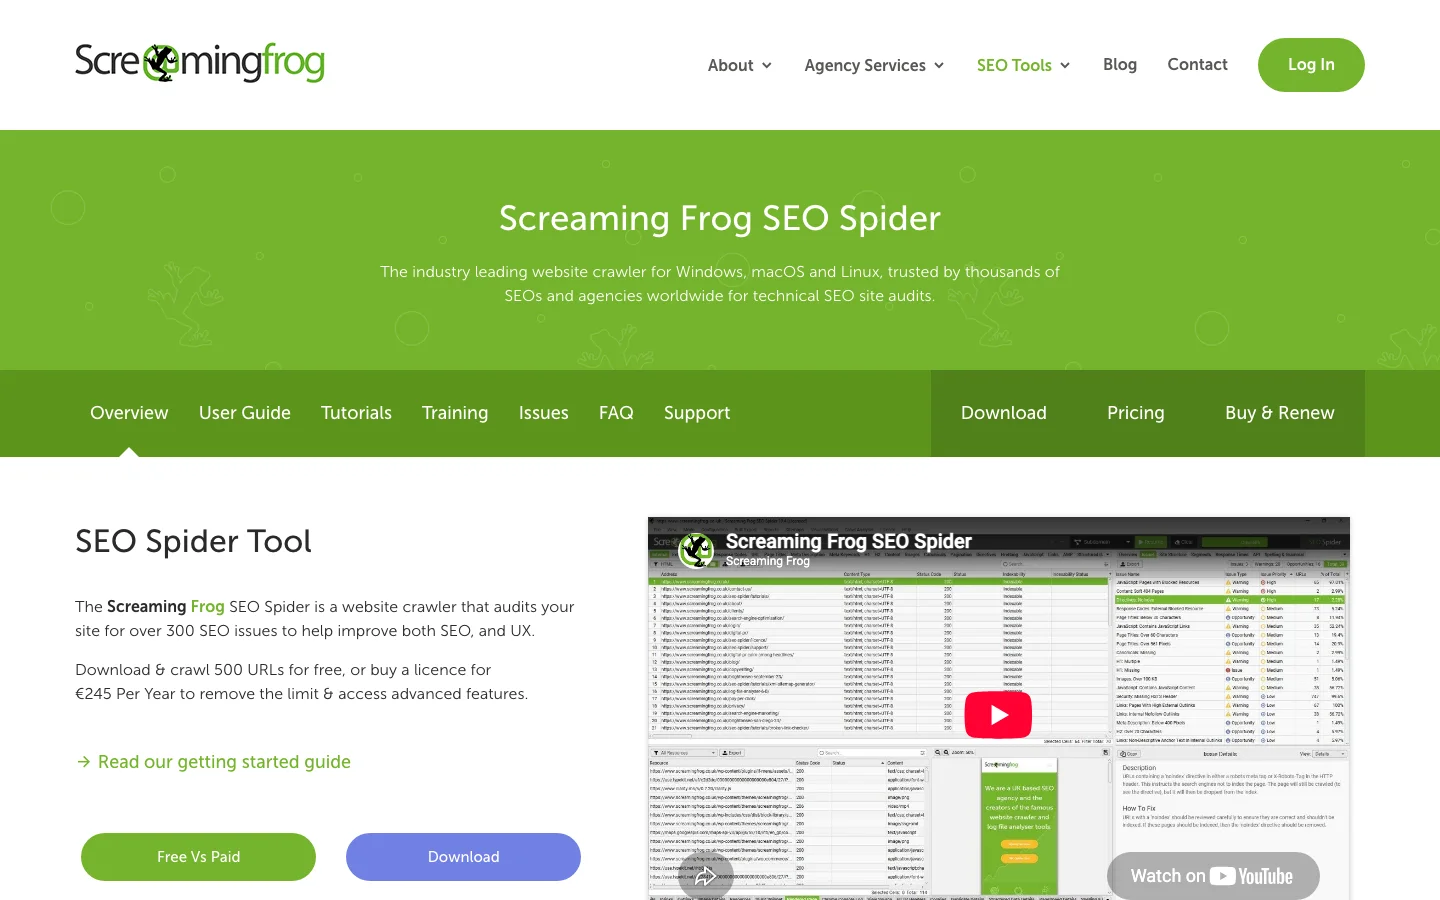
Screaming Frog SEO Spider scansiona il tuo sito come un bot ed elenca ogni codice di stato, catena di reindirizzamenti e link rotto.
Metodo 4: analisi dei log del server
Principio: i log di accesso registrano ogni richiesta, comprese quelle di Googlebot, Bingbot, GPTBot, ClaudeBot e PerplexityBot, con il codice di stato esatto e il tempo di risposta. Quando usarlo: sui siti grandi, dopo cali di traffico inspiegabili e per vedere cosa visitano i crawler di IA. Vantaggi: richieste reali, codici reali, nessun campionamento, tutti i bot. Limiti: serve accesso ai log e un po' di scripting; bisogna verificare che «Googlebot» sia davvero Google. La nostra guida all'analisi dei log per la SEO procede passo dopo passo. Un primo sguardo rapido:
# Richieste di Googlebot che non hanno restituito 200, 301 o 304, le più frequenti per prime
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Metodo 5: controlli puntuali sui singoli URL
Principio: testare un URL alla volta con curl o con un verificatore online gratuito. Quando usarlo: per confermare una correzione o controllare una pagina chiave dopo un rilascio. Vantaggi: immediato e preciso. Limiti: non scala. Usa lo user agent di Googlebot per individuare le regole che trattano i bot in modo diverso:
Errori 5xx: leggi il codice di stato per trovare il livello che ha ceduto
Uno stato 5xx significa che il server non è riuscito a gestire una richiesta che sembrava valida. Google rallenta la scansione in risposta, e la rallenta di più quando più URL restituiscono errori. Google conserva per un po' gli URL già indicizzati, ma rimuove quelli che restituiscono un errore del server in modo persistente. Una raffica breve si recupera, perché Google riporta gradualmente al rialzo il ritmo di scansione appena il server risponde con codici 2xx. Un lungo periodo di errori è ciò che danneggia l'indice.
Il codice indica quale livello ha ceduto
Ogni codice 5xx punta a una parte diversa dello stack. La tabella ti indica un primo punto da controllare per ciascuno.
Codice
Di solito significa
Da controllare per primo
500
L'applicazione è fallita mentre gestiva la richiesta
Il log degli errori dell'applicazione nel momento esatto della richiesta
502
Il proxy o la CDN ha ricevuto una risposta non valida dall'applicazione, spesso perché si è bloccata o riavviata
Riavvii e disponibilità del processo dell'applicazione
503
Il servizio è sovraccarico, limitato nelle richieste o in manutenzione
Grafici di carico, storico dei deploy e finestre di manutenzione
504
Il proxy ha smesso di attendere l'applicazione
Query lente sul database e impostazioni di timeout del proxy
429
Un rate limiter segnala troppe richieste
Regole di rate limit e se si applicano al Googlebot verificato
Confronta gli orari di Google con i tuoi log
Il rapporto Statistiche di scansione mostra i giorni e le ore in cui Google ha incontrato errori (la nostra guida alle Statistiche di scansione spiega ogni grafico). Il log del server mostra cosa è successo in quei momenti precisi. Filtra le richieste di Googlebot e conta le risposte 5xx per ora:
Ogni riga dell'output corrisponde a un'ora, un codice e un conteggio. Un gruppo nella stessa ora ogni notte di solito indica un backup, un cron job o un import pianificato. Errori sparsi lungo tutta la giornata indicano più spesso un problema di carico, quindi la soluzione è capacità o cache e non un singolo bug. Per un metodo più approfondito, consulta la nostra guida all'analisi dei file di log.
Misura il costo di un 5xx prima di farti prendere dal panico
Google riduce la scansione in proporzione al numero di URL che restituiscono errori. Un modello difettoso che colpisce pochi URL costa poco tempo di scansione. Un'interruzione del database che fa fallire ogni pagina costa molto, ed è quella da sistemare per prima.
Un 429 ha lo stesso effetto di un 5xx, perché Google lo legge come un server sovraccarico. Se il tuo rate limiter o la protezione dai bot restituisce un 429 a Googlebot, lo paghi in tempo di scansione. La documentazione di Google non menziona l'header Retry-After. Continua a inviarlo ai visitatori umani e ai client API, ma non contare sul fatto che Googlebot aspetti il tempo che hai indicato.
Errori 4xx: scopri da dove arrivano prima di correggerli
Uno stato 4xx significa che il server ha rifiutato la richiesta per qualcosa lato client: l'URL non esiste, l'accesso è vietato o l'indirizzo è malformato. Google tratta allo stesso modo tutti i 4xx tranne il 429. Smette di usare il contenuto dietro quell'URL e rimuove l'URL dall'indice se vi era presente. Prima di intervenire su un 4xx, scopri da dove parte la richiesta, perché la correzione spesso sta in un solo punto: un link, un modello o una regola di redirect.
Trova la fonte di ogni 4xx nei log
Il log di accesso registra il referrer di ogni richiesta, cioè la pagina che ha mandato il visitatore o il bot a quell'URL. Conta le risposte 4xx per percorso e per referrer:
Un referrer del tuo dominio significa che una tua pagina rimanda a un URL morto. Correggi il link o il modello che lo genera. È la correzione più preziosa, perché dipende da te. La nostra guida su come correggere i link rotti illustra il metodo completo.
Un referrer di un altro sito significa che un backlink punta a un URL che non funziona più. Se il link vale la pena, aggiungi un singolo 301 verso la pagina attiva più vicina. Se non vale, lascia il 404 così com'è.
Un referrer vuoto, o un percorso che non hai mai pubblicato, come una pagina di login su un sito statico, di solito indica che un bot o uno scanner ha provato l'indirizzo. Lascia che restituisca 404 e non perderci tempo.
Individua i picchi di 4xx subito dopo ogni rilascio
Un rilascio che rinomina un percorso, cambia uno slug o ricostruisce un modello produce spesso un'ondata di 404 nello stesso giorno. Esporta il numero di risposte 4xx per giorno per la settimana prima del deploy e per quella dopo. Un aumento concentrato in una cartella indica direttamente la modifica. Aggiungi il redirect dal vecchio URL al nuovo nello stesso rilascio, non in un ticket successivo. Per uno spostamento completo, consulta la nostra checklist per le migrazioni SEO.
Suggerimento
Non sostituire una pagina mancante con una risposta 200 che mostra un messaggio breve o un elenco vuoto. Google può considerarla una soft 404, che costa una scansione completa senza dare nulla in cambio.
Passo dopo passo: correggere gli errori di scansione nell'ordine giusto
Questo è il metodo che usiamo. Va dagli errori che possono fermare tutto il sito a quelli che sprecano solo un po' di scansione.
Il metodo in 6 passaggi contro gli errori di scansione
Controllare lo stato dell'hostApri Statistiche di scansione e guarda DNS, connessione al server e robots.txt degli ultimi 90 giorni.
Esportare e raggruppare gli errori degli URLEsporta ogni motivo di Indicizzazione delle pagine e raggruppa gli URL per cartella o template.
Ordinare per valoreTieni gli URL con traffico, backlink, link interni o voci nella sitemap.
Correggere la causa a livello di templateUna regola, una mappa di reindirizzamenti o un'impostazione del server sistema centinaia di URL.
Pulire i segnaliAggiorna link interni e sitemap perché puntino agli URL finali in 200.
Convalidare e monitorareFai clic su Convalida correzione, poi controlla ogni settimana le statistiche di scansione e i log.
Passaggio 1: controlla prima l'host
In Search Console apri Impostazioni, poi Statistiche di scansione, poi Stato host. Il verde significa nessun problema rilevante in 90 giorni. «Problema recente» significa un problema rilevante nell'ultima settimana: lascia perdere tutto il resto. Fai clic su ogni categoria per vedere la percentuale di errori al giorno, poi confronta i giorni negativi con lo storico di hosting, CDN e rilasci.
Passaggio 2: esporta e raggruppa per schema
Apri Indicizzazione, poi Pagine, ed esporta ogni motivo di errore. Non correggere gli URL uno a uno. Mettili in un foglio di calcolo ed estrai la prima cartella:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
Una tabella pivot su questa colonna di solito mostra che la maggior parte degli errori viene da due o tre template: una categoria del blog dismessa, un parametro di filtro, un vecchio feed di prodotti.
Passaggio 3: ordina per valore di business
Per ogni schema, fai quattro domande. Riceve clic organici? Ha backlink? È collegato internamente? È nella sitemap? Un 404 senza nessuna delle quattro può aspettare per sempre. Un 404 con backlink ha bisogno di un 301 oggi. Il verificatore di link rotti gratuito mostra quali pagine del tuo sito puntano ancora a URL morti.
Passaggio 4: correggi la causa profonda
Correggi le regole, non gli URL. Una mappa di reindirizzamenti nella configurazione del server è meglio di 400 reindirizzamenti aggiunti a mano in un plugin. Per esempio, in nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Per i 5xx, correggi la capacità o il bug. Per 401 e 403, correggi la regola di sicurezza. Per i soft 404, aggiungi contenuto vero oppure restituisci un vero 404.
Passaggio 5: pulisci link interni e sitemap
Ogni link interno deve puntare direttamente a un URL che restituisce 200. Ogni voce della sitemap deve essere un URL canonico, indicizzabile e in 200. Una sitemap piena di reindirizzamenti e 404 insegna a Google a fidarsi meno di lei. La nostra guida su come creare una sitemap spiega cosa deve contenere.
Passaggio 6: convalida e monitora
Nel rapporto Indicizzazione delle pagine, apri il motivo corretto e fai clic su Convalida correzione. Google controlla prima un campione, poi il resto; di solito servono fino a circa due settimane, e la convalida si ferma se anche un solo URL continua a fallire. Non fare di nuovo clic mentre è in corso. Poi imposta una routine settimanale: Statistiche di scansione per l'host, log per i picchi, una scansione dopo ogni rilascio.
Una catena di reindirizzamenti prima e dopo la correzione
Prima
http://site.com/page
301 verso https://site.com/page
301 verso https://www.site.com/page
301 verso https://www.site.com/page/
I link interni puntano ancora al primo URL
Dopo
Un solo 301 diretto verso https://www.site.com/page/
Link interni aggiornati all'URL finale
La sitemap elenca solo l'URL finale
Una richiesta invece di quattro
Errori comuni: come individuarli e correggerli
Errore 1: reindirizzare ogni 404 alla home page
Cos'è: un plugin o una regola che manda qualsiasi URL mancante su /. Come individuarlo: molti URL in «Soft 404» o «Pagina con reindirizzamento» che finiscono tutti sulla home page; un crawler mostra centinaia di 301 verso la stessa destinazione. Come correggerlo: reindirizza solo verso un equivalente vicino e lascia che il resto restituisca 404 o 410.
Errore 2: bloccare Googlebot con gli strumenti di sicurezza
Cos'è: un WAF, un bot manager o un rate limiter che serve a Google un 403, un 429 o una pagina di verifica. Come individuarlo: 403 o 429 nelle Statistiche di scansione mentre la pagina si carica bene nel browser; i log mostrano i blocchi per IP. Come correggerlo: consenti il Googlebot verificato, tramite DNS inverso o gli intervalli IP pubblicati da Google, invece di fidarti dello user agent.
Errore 3: un robots.txt fragile
Cos'è: un robots.txt generato dall'applicazione, che quindi cade ogni volta che cade l'applicazione, oppure servito da una regola della CDN che mette in cache un 5xx. Come individuarlo: la categoria recupero del robots.txt in Stato host non è verde. Come correggerlo: servilo come file statico, fuori dall'applicazione, e testalo con il verificatore di robots.txt.
Errore 4: pagine di manutenzione che restituiscono 200
Cos'è: una pagina «Torniamo presto» servita con stato 200 su ogni URL. Come individuarlo: dopo la manutenzione, un'ondata di soft 404 o di titoli duplicati. Come correggerlo: restituisci un 503 con Retry-After durante la manutenzione, e tienila breve.
Errore 5: usare il 403 per rallentare Google
Cos'è: rispondere 403 a Googlebot quando il server è sovraccarico. Come individuarlo: picchi di 403 che coincidono con i picchi di carico. Come correggerlo: Google afferma che i codici 4xx diversi da 429 non hanno effetto sulla frequenza di scansione. Restituisci 503 o 429 per poco tempo e correggi la capacità.
Errore 6: correggere gli errori uno per uno
Cos'è: scorrere l'elenco di Search Console e modificare ogni URL. Come individuarlo: lo stesso motivo ritorna ogni mese. Come correggerlo: raggruppa per schema, correggi il template o la regola, poi convalida una sola volta.
Errore 7: andare nel panico per 404 innocui
Cos'è: passare giorni su 404 di URL di spam o di pagine eliminate da tempo e senza link. Come individuarlo: gli URL non hanno clic, né backlink, né link interni. Come correggerlo: lasciali stare. Google dice che un 404 per una pagina rimossa non è necessariamente un problema.
Attenzione
Non bloccare mai un URL nel robots.txt per «nascondere» un errore di scansione. Google non vede più il 404 né il reindirizzamento, l'URL può restare indicizzato e perdi il segnale che volevi inviare.
Errori di scansione e crawl budget
Su un sito di qualche centinaio di pagine Google ha tempo per tutto, e gli errori di scansione contano soprattutto per le pagine che rompono. Sui siti grandi (negozi con filtri, marketplace, testate giornalistiche) ogni richiesta fallita o sprecata toglie tempo alle tue pagine vere. È l'idea alla base del crawl budget.
Come gli errori consumano capacità di scansione
5xx e 429 fanno rallentare Google su tutto l'host, quindi pochi template rotti possono ritardare la scansione delle tue nuove schede prodotto. Le catene di reindirizzamenti costano una richiesta per ogni salto. I soft 404 costano un recupero completo e non restituiscono nulla. Correggi questi tre e lo stesso budget coprirà più pagine utili.
Cosa c'entra «Rilevata, ma attualmente non indicizzata»
Quando Google trova degli URL ma ne rimanda la scansione, la causa è spesso un server che considera fragile. Se vedi crescere il numero di pagine «Rilevata, ma attualmente non indicizzata» insieme a errori del server nelle Statistiche di scansione, correggi prima il server. I due rapporti raccontano la stessa storia.
Errori di scansione dei crawler di IA
Googlebot non è più l'unico visitatore che conta. GPTBot, OAI-SearchBot, ClaudeBot e PerplexityBot recuperano pagine per addestrare modelli o per rispondere a domande in tempo reale. Colpiscono lo stesso server e soffrono degli stessi errori, con una differenza: per loro non hai una Search Console.
Cosa cambia con i bot di IA
La maggior parte dei crawler di IA non esegue JavaScript, quindi una pagina che costruisce il contenuto solo nel browser può sembrare loro vuota, una sorta di soft 404 che non vedrai mai nei rapporti di Google. Molti vengono bloccati di default dai servizi di protezione anti-bot, spesso con un 403. E siccome recuperano le pagine su richiesta quando un utente fa una domanda, un timeout in quel momento significa che la risposta cita qualcun altro. La nostra guida alla SEO per JavaScript tratta il rendering per motori di ricerca e crawler di IA.
Come monitorarli
I log del server sono l'unica fonte affidabile. Filtra per user agent e guarda i codici di stato:
Se i bot di IA ricevono 403 non voluti, correggi la regola. Poi verifica se ti citano davvero: il monitoraggio delle menzioni nell'IA di Sorank segue quanto spesso ChatGPT, Gemini, Claude e Perplexity citano il tuo brand, così vedi se una correzione della scansione cambia qualcosa.
La tua checklist per una scansione sana
Esegui questa lista dopo ogni migrazione, restyling o grande rilascio, e una volta al mese sui siti grandi.
Checklist per una scansione sana
Stato host verde per DNS, connessione al server e robots.txt
robots.txt servito come file statico che restituisce 200
Nessun picco di 5xx o 429 nelle Statistiche di scansione o nei log
Googlebot verificato e bot di IA desiderati non bloccati dal firewall
Ogni reindirizzamento è un solo salto, 301 o 308, verso una pagina 200
I link interni puntano agli URL finali in 200
Le sitemap elencano solo URL canonici, indicizzabili e in 200
404 con backlink o traffico reindirizzati a un equivalente vicino
Pagine vuote corrette o che restituiscono un vero 404
La manutenzione restituisce 503 con Retry-After
Convalida correzione avviata per ogni motivo corretto
Cosa fare oggi
Apri Statistiche di scansione e controlla le tre righe dello stato dell'host. Poi lancia il verificatore di indicizzabilità gratuito sulle tue cinque pagine più preziose. Se è tutto pulito, esporta gli errori di Indicizzazione delle pagine e raggruppali per cartella: ora hai un breve elenco di correzioni in ordine di priorità invece di un rapporto che fa paura.
Una volta pulita la scansione, il limite successivo è il contenuto stesso. L'ottimizzazione dei contenuti di Sorank riscrive e aggiorna le tue pagine esistenti in autopilot, così le pagine che Google ora raggiunge meritano di essere indicizzate e citate. Per le pagine che Google ha scansionato ma lasciato fuori, leggi la nostra guida su «Pagina sottoposta a scansione, ma attualmente non indicizzata».
Domande frequenti
Cosa sono gli errori di scansione nella SEO?
Gli errori di scansione sono richieste di un motore di ricerca o di un crawler di IA che falliscono: il DNS non si risolve, il server va in timeout o restituisce 5xx, il robots.txt non è recuperabile, un reindirizzamento va in loop o una pagina restituisce un codice 4xx. Gli errori del sito possono sospendere la scansione di tutto il sito, mentre gli errori degli URL colpiscono solo la pagina interessata.
Gli errori 404 fanno male alla SEO?
Non di per sé. Google afferma che un 404 per una pagina rimossa senza sostituto non è necessariamente un problema. Lo diventa quando l'URL ha ancora backlink, traffico o link interni: in quel caso la correzione giusta è un solo 301 verso un equivalente vicino.
Quanto tempo impiega Google a vedere che gli errori di scansione sono stati corretti?
Dopo aver fatto clic su Convalida correzione nel rapporto Indicizzazione delle pagine di Search Console, la convalida richiede di solito fino a circa due settimane. Google controlla prima un campione di URL, poi il resto, e si ferma se anche un solo URL interessato continua a fallire.
y!
Ricevi gratis il tuo piano di contenuti per 30 giorni
Analizziamo i tuoi concorrenti, il tuo sito web e la tua visibilità nelle IA per creare gratuitamente un piano di contenuti su misura.
“Ho testato Sorank sul sito reale di un cliente ed è pazzesco. Fa tutto quello che un'agenzia fa pagare 1.500 € al mese. Ora va in produzione su quel cliente.”Guillaume Guersanguersanguillaume.com
“Siamo un'agenzia pubblicitaria e volevamo rimettere in carreggiata il nostro SEO una volta per tutte. Sorank ci ha dato una visione chiara del nostro sito, ci ha aiutato a dare priorità alle ottimizzazioni e a strutturare correttamente i nostri contenuti. Lo strumento è facile da usare, ben progettato per un team e molto pratico per centralizzare il monitoraggio senza dover destreggiarsi tra più piattaforme. Una base molto solida per ripartire da zero con il nostro SEO.”Gaspard MadouiAgenzia Pubblicitaria
“Mi sono specializzata in GEO grazie a Sorank. Il GEO Leaderboard mi permette di mostrare ai miei clienti il loro posizionamento rispetto ai concorrenti su ChatGPT. È un vero differenziatore commerciale.”MélanieFreelancer SEO
“Ottimo servizio, funziona bene per il nostro sito web e ci aiuta a capire come migliorarlo per posizionarci meglio su Google e altrove. Complimenti, continuate così, ve lo consiglio.”Hugo T.Commerciante e-commerce