Riepilogo
Il generatore di robots.txt crea il file che indica ai crawler quali parti del suo sito possono scansionare, con le direttive User-agent, Disallow, Allow e Sitemap. Una regola Disallow impedisce solo la scansione, non l'indicizzazione: per nascondere una pagina usi i meta tag noindex e testi il file prima di metterlo in produzione.
Vuoi approfondire? Chiedi a


Oltre il 25% dei siti web ha file robots.txt configurati in modo errato, con la conseguenza che pagine critiche vengono bloccate accidentalmente per i motori di ricerca.
Il file robots.txt è il primo documento che i crawler dei motori di ricerca leggono quando visitano il suo sito. Una singola direttiva fuori posto può impedire a Google di indicizzare le sue pagine più importanti o, peggio, esporre URL sensibili che intendeva mantenere privati. Il Generatore di Robots.txt di sorank.com la aiuta a creare file robots.txt perfettamente strutturati in pochi secondi, assicurando che il suo crawl budget sia ottimizzato e che l'architettura del sito sia comunicata correttamente a ogni motore di ricerca importante.
Che cos'è un file robots.txt e perché è importante per la SEO?
Un file robots.txt è un file di testo semplice collocato nella radice del suo sito web (ad esempio, https://example.com/robots.txt) che fornisce istruzioni ai web crawler su quali pagine o sezioni del sito debbano o non debbano essere scansionate. Segue il Robots Exclusion Protocol, uno standard che governa il comportamento dei crawler dal 1994.
Sebbene robots.txt non controlli direttamente l'indicizzazione (questo è il ruolo dei meta tag robots e dei tag canonical), svolge un ruolo cruciale nella gestione del crawl budget. Per i siti web di grandi dimensioni con migliaia di pagine, indicare ai crawler di saltare le aree a basso valore, come i pannelli di amministrazione, i contenuti duplicati o gli ambienti di staging, assicura che le sue pagine più importanti vengano scansionate e indicizzate più velocemente.
I motivi principali per cui robots.txt è importante:
- Ottimizzazione del crawl budget, indirizzi i crawler verso le sue pagine ad alta priorità invece di sprecare risorse su URL irrilevanti
- Riduzione del carico del server, impedisca ai bot aggressivi di sovraccaricare il suo server con richieste inutili
- Protezione della privacy, blocchi l'accesso dei crawler a strumenti interni, siti di staging o directory sensibili
- Individuazione della sitemap, indichi ai motori di ricerca la sua sitemap XML per una scansione più efficiente
Comprendere le direttive di robots.txt: il riferimento completo
Un file robots.txt utilizza una sintassi semplice costruita attorno a poche direttive fondamentali. Padroneggiare queste direttive è essenziale per un corretto controllo della scansione:
User-agent: specifica a quale crawler si applicano le regole. Usi * per tutti i crawler, oppure indirizzi bot specifici come Googlebot, Bingbot o GPTBot.
Disallow: indica ai crawler di non accedere a percorsi specifici. Ad esempio, Disallow: /admin/ blocca l'intera directory admin.
Allow: annulla una regola Disallow per percorsi specifici all'interno di una directory bloccata. Utile per un controllo granulare, ad esempio per consentire /admin/public-page bloccando il resto di /admin/.
Sitemap: dichiara la posizione della sua sitemap XML. Questa direttiva è indipendente dal crawler e aiuta i motori di ricerca a individuare tutti i suoi URL indicizzabili.
Crawl-delay: imposta un ritardo (in secondi) tra le richieste successive del crawler. È supportato da Bing e Yandex, ma ignorato da Google, che si affida invece alle impostazioni di Search Console.
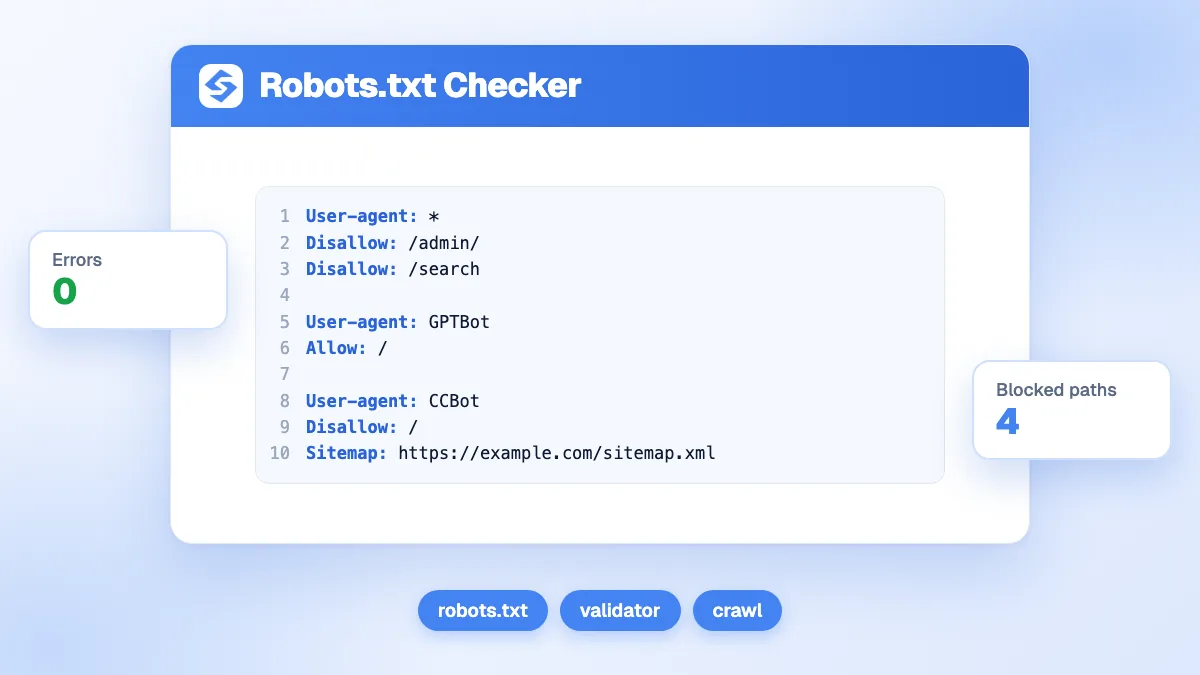
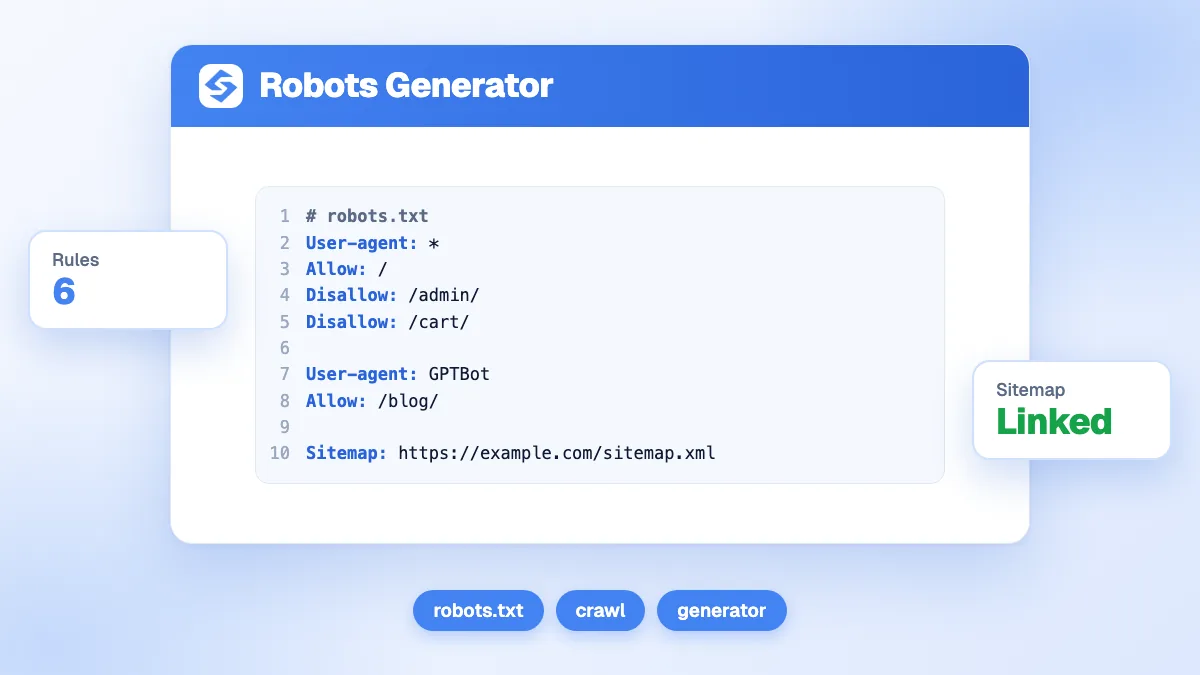
Esempio di un robots.txt ben strutturato:
User-agent: *
Disallow: /admin/
Disallow: /cart/
Disallow: /checkout/
Disallow: /search?
Allow: /admin/public/

User-agent: GPTBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Come utilizzare il Generatore di Robots.txt di Sorank
Il nostro generatore gratuito di robots.txt semplifica il processo di creazione con un'interfaccia intuitiva:
- Selezioni i suoi user-agent, scelga tra i crawler più comuni (Googlebot, Bingbot, GPTBot, ecc.) o usi il carattere jolly
*per regole universali - Definisca le sue regole Disallow, inserisca i percorsi che vuole bloccare dalla scansione, come
/wp-admin/,/staging/o parametri di query come/search? - Aggiunga eccezioni Allow, se deve consentire l'accesso a pagine specifiche all'interno di directory bloccate, aggiunga regole Allow
- Includa l'URL della sua sitemap, inserisca la posizione della sua sitemap XML in modo che i crawler possano individuarla automaticamente
- Imposti un Crawl-delay opzionale, configuri i valori di ritardo per i crawler supportati se il suo server necessita di una limitazione
- Generi e scarichi, copi il robots.txt generato o lo scarichi, poi lo carichi nella directory radice del suo sito
Errori comuni di robots.txt che danneggiano la SEO
Anche i webmaster esperti commettono errori di robots.txt che possono compromettere gravemente la loro visibilità nei motori di ricerca:
1. Bloccare i file CSS e JavaScript: Google ha bisogno di renderizzare le sue pagine per comprenderne il contenuto. Bloccare le directory /css/ o /js/ impedisce a Googlebot di renderizzare le sue pagine, il che può danneggiare in modo significativo il suo posizionamento.
2. Usare robots.txt per nascondere pagine dall'indice: una direttiva Disallow non rimuove una pagina dall'indice di Google, impedisce solo la scansione. Se altri siti rimandano a una pagina bloccata, Google potrebbe comunque indicizzare l'URL (mostrandolo senza uno snippet). Usi invece i meta tag noindex.
3. Bloccare accidentalmente l'intero sito: un singolo Disallow: / sotto User-agent: * blocca tutti i crawler dall'intero suo sito. Controlli sempre con attenzione le sue regole con carattere jolly.
4. Dimenticare le barre finali: Disallow: /admin blocca qualsiasi URL che inizi con /admin, inclusa /administration. Usi Disallow: /admin/ per bloccare solo la directory.
5. Non includere una direttiva Sitemap: sebbene non sia obbligatorio, dichiarare la sua sitemap nel robots.txt assicura che tutti i motori di ricerca possano individuarla, anche se non l'ha inviata tramite i rispettivi strumenti per webmaster.
6. Regole in conflitto: quando le regole Allow e Disallow si sovrappongono, la regola più specifica ha la precedenza nell'implementazione di Google. Testi sempre la sua configurazione per evitare blocchi indesiderati.
Best practice di robots.txt per le diverse piattaforme CMS
WordPress: blocchi /wp-admin/ ma consenta /wp-admin/admin-ajax.php (necessario per le funzionalità front-end). Non blocchi mai /wp-content/uploads/ poiché contiene i suoi file multimediali. Valuti di bloccare /wp-includes/ per gli script non essenziali.
Webflow: Webflow genera automaticamente un robots.txt, ma può personalizzarlo nelle impostazioni del suo sito. Si assicuri di non bloccare le pagine delle collezioni o i percorsi dei template che generano contenuti dinamici.
Shopify: Shopify ha un robots.txt predefinito che blocca percorsi interni come /admin, /cart, /checkout e /orders. Dal 2021 è possibile personalizzarlo tramite il template del tema robots.txt.liquid.
Next.js / SPA React: si assicuri che il suo robots.txt sia servito come file statico dalla directory pubblica. Per le app renderizzate lato server, verifichi che Googlebot possa accedere a tutti gli endpoint API necessari per renderizzare il contenuto.
Gestire i crawler IA con robots.txt
Con la crescita dei modelli di IA che raccolgono contenuti dal web, robots.txt ha acquisito una nuova importanza per il controllo dell'accesso dei crawler IA:
GPTBot, il crawler di OpenAI per la raccolta di dati di addestramentoChatGPT-User, il crawler di OpenAI per le funzionalità di navigazione in tempo realeGoogle-Extended, il crawler di Google per i dati di addestramento dell'IA (separato da Googlebot)anthropic-ai, il web crawler di AnthropicCCBot, il bot di Common Crawl, usato da molti dataset di addestramento dell'IA
Per bloccare tutti i crawler IA consentendo al contempo i motori di ricerca:
User-agent: GPTBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: anthropic-ai
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: *
Allow: /
Testare e convalidare il suo robots.txt
Dopo aver generato il suo file robots.txt, lo convalidi sempre prima di metterlo in produzione:
- Google Search Console, usi lo strumento "robots.txt Tester" (nelle impostazioni di scansione) per verificare errori di sintassi e testare URL specifici rispetto alle sue regole
- Bing Webmaster Tools, offre un analizzatore di robots.txt che mostra come Bingbot interpreta il suo file
- Test nel browser, visiti direttamente
suodominio.com/robots.txtper verificare che sia accessibile e formattato correttamente - Analisi dei file di log, monitori i log del suo server dopo la pubblicazione per confermare che i crawler rispettino le sue direttive
Ricordi che i motori di ricerca memorizzano nella cache il suo file robots.txt e lo aggiornano periodicamente (in genere ogni 24 ore). Dopo aver apportato modifiche, può richiedere una nuova scansione tramite Google Search Console per aggiornamenti più rapidi.
Usi il Generatore di Robots.txt di Sorank per creare un file formattato correttamente in pochi secondi, senza alcuna conoscenza di programmazione. Protegga il suo crawl budget, gestisca l'accesso dei bot e si assicuri che le pagine più preziose del suo sito ricevano l'attenzione che meritano dai motori di ricerca.