Resumen
El generador de robots.txt crea el archivo que indica a los rastreadores qué partes de su sitio pueden rastrear, con las directivas User-agent, Disallow, Allow y Sitemap. Una regla Disallow solo impide el rastreo, no la indexación: use etiquetas meta noindex para ocultar una página y pruebe el archivo antes de desplegarlo.
¿Quiere ir más lejos? Pregunte a


Más del 25% de los sitios web tienen archivos robots.txt mal configurados, lo que lleva a que páginas críticas sean bloqueadas accidentalmente por los motores de búsqueda.
Su archivo robots.txt es el primer documento que los rastreadores de los motores de búsqueda leen cuando visitan su sitio. Una sola directiva mal colocada puede impedir que Google indexe sus páginas más importantes, o peor aún, exponer URLs sensibles que intentaba mantener privadas. El Generador de Robots.txt sorank.com le ayuda a crear archivos robots.txt perfectamente estructurados en segundos, asegurando que su presupuesto de rastreo esté optimizado y que la arquitectura de su sitio esté correctamente comunicada a todos los principales motores de búsqueda.
¿Qué es un archivo Robots.txt y por qué es importante para el SEO?
Un archivo robots.txt es un archivo de texto plano colocado en la raíz de su sitio web (p.ej. https://example.com/robots.txt) que proporciona instrucciones a los rastreadores web sobre qué páginas o secciones de su sitio deben o no deben ser rastreadas. Sigue el Robots Exclusion Protocol, un estándar que ha regido el comportamiento de los rastreadores desde 1994.
Aunque robots.txt no controla directamente la indexación (ese es el rol de las etiquetas meta robots y las etiquetas canónicas), desempeña un papel crucial en la gestión del presupuesto de rastreo. Para sitios web grandes con miles de páginas, indicar a los rastreadores que se salten áreas de bajo valor, como paneles de administración, contenido duplicado o entornos de prueba, garantiza que sus páginas más importantes se rastreen e indexen más rápido.
Principales razones por las que robots.txt importa:
- Optimización del presupuesto de rastreo, Dirige los rastreadores a sus páginas de alta prioridad en lugar de desperdiciar recursos en URLs irrelevantes
- Reducción de la carga del servidor, Evita que bots agresivos sobrecarguen su servidor con solicitudes innecesarias
- Protección de la privacidad, Bloquea a los rastreadores de acceder a herramientas internas, sitios de prueba o directorios sensibles
- Descubrimiento del sitemap, Dirige a los motores de búsqueda a su sitemap XML para un rastreo más eficiente
Comprender las directivas de Robots.txt: la referencia completa
Un archivo robots.txt usa una sintaxis simple basada en unas pocas directivas principales. Dominar estas directivas es esencial para un control adecuado del rastreo:
User-agent: Especifique a qué rastreador se aplican las reglas. Use * para todos los rastreadores, o apunte a bots específicos como Googlebot, Bingbot o GPTBot.
Disallow: Indica a los rastreadores que no accedan a rutas específicas. Por ejemplo, Disallow: /admin/ bloquea todo el directorio de administración.
Allow: Anula una regla Disallow para rutas específicas dentro de un directorio bloqueado. Útil para un control detallado, como permitir /admin/public-page mientras se bloquea el resto de /admin/.
Sitemap: Declara la ubicación de su sitemap XML. Esta directiva es independiente del rastreador y ayuda a los motores de búsqueda a descubrir todas sus URLs indexables.
Crawl-delay: Establece un retardo (en segundos) entre solicitudes sucesivas del rastreador. Compatible con Bing y Yandex pero ignorado por Google, que se basa en la configuración de Search Console.
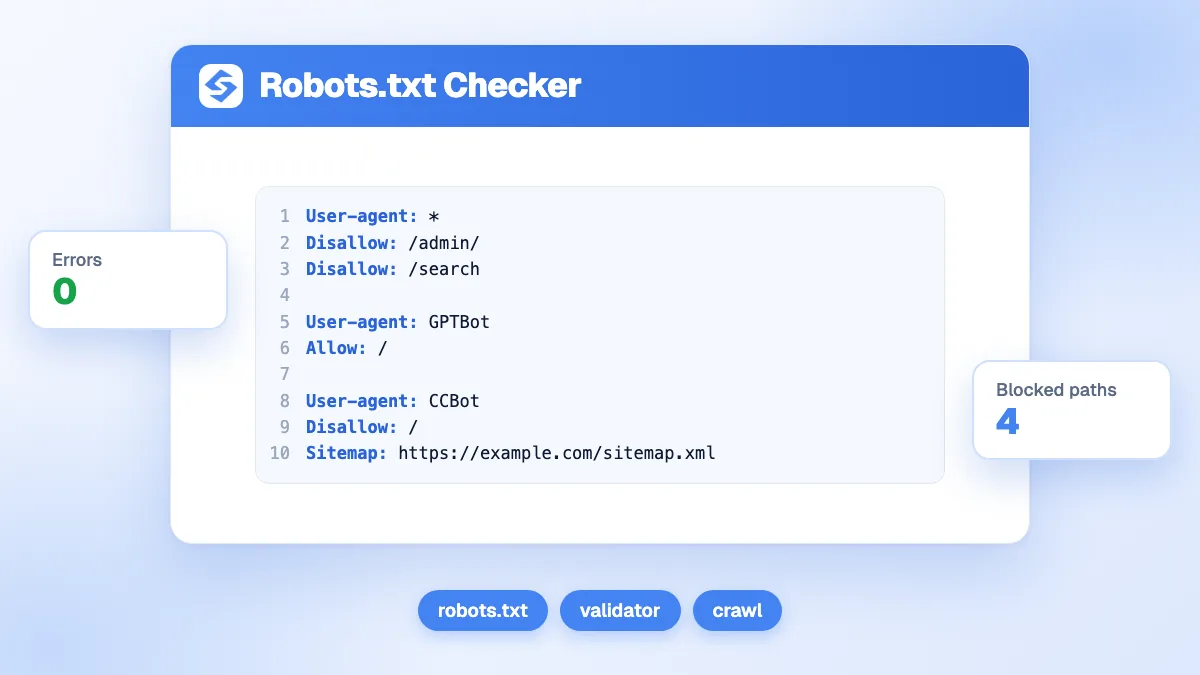
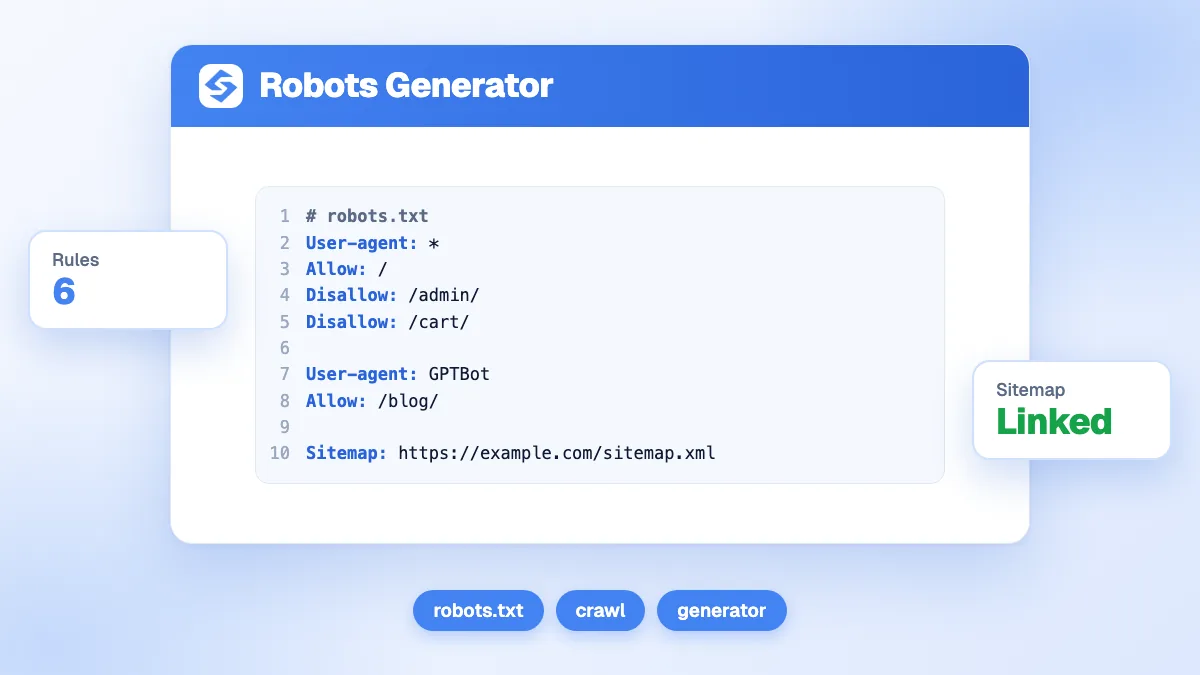
Ejemplo de un archivo robots.txt bien estructurado:
User-agent: *
Disallow: /admin/
Disallow: /cart/
Disallow: /checkout/
Disallow: /search?
Allow: /admin/public/

User-agent: GPTBot
Disallow: /

Sitemap: https://example.com/sitemap.xml
Cómo usar el Generador de Robots.txt de Sorank
Nuestro generador de robots.txt gratuito simplifica el proceso de creación con una interfaz intuitiva:
- Seleccione sus user-agents, Elija entre rastreadores comunes (Googlebot, Bingbot, GPTBot, etc.) o use el comodín
*para reglas universales - Defina sus reglas Disallow, Introduzca las rutas que desea bloquear del rastreo, como
/wp-admin/,/staging/, o parámetros de consulta como/search? - Añada excepciones Allow, Si necesita permitir el acceso a páginas específicas dentro de directorios bloqueados, agregue reglas Allow
- Incluya la URL de su sitemap, Introduzca la ubicación de su sitemap XML para que los rastreadores puedan descubrirlo automáticamente
- Configure el Crawl-delay opcional, Configure valores de retardo para los rastreadores compatibles si su servidor necesita limitación
- Genere y descargue, Copie el robots.txt generado o descárguelo, luego súbalo al directorio raíz de su sitio
Errores comunes en Robots.txt que perjudican el SEO
Incluso los webmasters experimentados cometen errores en robots.txt que pueden afectar gravemente su visibilidad en las búsquedas:
1. Bloquear archivos CSS y JavaScript: Google necesita renderizar sus páginas para comprender su contenido. Bloquear los directorios /css/ o /js/ impide que Googlebot renderice sus páginas, lo que puede perjudicar significativamente su posicionamiento.
2. Usar robots.txt para ocultar páginas del índice: Una directiva Disallow no elimina una página del índice de Google, solo evita el rastreo. Si otros sitios enlazan a una página bloqueada, Google puede igualmente indexar la URL (mostrándola sin fragmento). Use etiquetas meta noindex en su lugar.
3. Bloquear todo el sitio accidentalmente: Un simple Disallow: / bajo User-agent: * bloquea todos los rastreadores de todo su sitio. Compruebe siempre sus reglas de comodín.
4. Olvidar las barras diagonales finales: Disallow: /admin bloquea cualquier URL que comience por /admin, incluida /administration. Use Disallow: /admin/ para bloquear solo el directorio.
5. No incluir una directiva Sitemap: Aunque no es obligatorio, declarar su sitemap en robots.txt garantiza que todos los motores de búsqueda puedan descubrirlo, aunque no lo haya enviado a través de sus respectivas herramientas para webmasters.
6. Reglas conflictivas: Cuando las reglas Allow y Disallow se superponen, la regla más específica tiene prioridad en la implementación de Google. Pruebe siempre su configuración para evitar bloqueos no deseados.
Buenas prácticas de Robots.txt para diferentes plataformas CMS
WordPress: Bloquee /wp-admin/ pero permita /wp-admin/admin-ajax.php (necesario para la funcionalidad del front-end). Nunca bloquee /wp-content/uploads/ ya que contiene sus archivos multimedia. Considere bloquear /wp-includes/ para scripts no esenciales.
Webflow: Webflow genera automáticamente un robots.txt, pero puede personalizarlo en la configuración de su sitio. Asegúrese de no estar bloqueando sus páginas de colección ni las rutas de plantilla que generan contenido dinámico.
Shopify: Shopify tiene un robots.txt predeterminado que bloquea rutas internas como /admin, /cart, /checkout y /orders. Desde 2021, puede personalizarlo mediante la plantilla de tema robots.txt.liquid.
Next.js / React SPAs: Asegúrese de que su robots.txt se sirva como un archivo estático desde el directorio público. Para aplicaciones renderizadas en el servidor, verifique que Googlebot pueda acceder a todos los endpoints de API necesarios para renderizar el contenido.
Gestión de rastreadores IA con Robots.txt
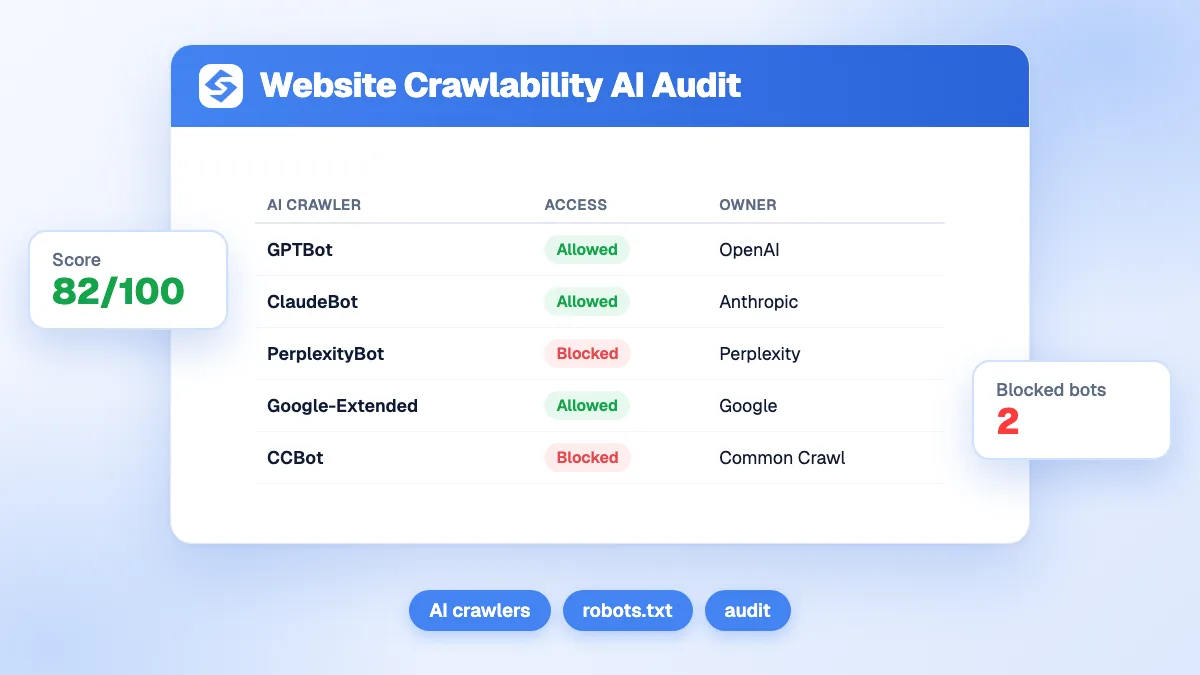
Con el auge de los modelos de IA que rastrean contenido web, robots.txt ha adquirido nueva importancia para controlar el acceso de los rastreadores IA:
GPTBot, rastreador de OpenAI para la recopilación de datos de entrenamientoChatGPT-User, rastreador de OpenAI para las funciones de navegación en directoGoogle-Extended, rastreador de datos de entrenamiento IA de Google (separado de Googlebot)anthropic-ai, rastreador web de AnthropicCCBot, bot de Common Crawl, utilizado por muchos conjuntos de datos de entrenamiento IA
Para bloquear todos los rastreadores IA mientras se permiten los motores de búsqueda:
User-agent: GPTBot
Disallow: /

User-agent: ChatGPT-User
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: anthropic-ai
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: *
Allow: /
Probar y validar su archivo Robots.txt
Después de generar su archivo robots.txt, valídelo siempre antes de desplegarlo:
- Google Search Console, Use la herramienta "Probador de robots.txt" (en la configuración de rastreo) para buscar errores de sintaxis y probar URLs específicas contra sus reglas
- Bing Webmaster Tools, Ofrece un analizador de robots.txt que muestra cómo Bingbot interpreta su archivo
- Pruebe en el navegador, Visite
sudominio.com/robots.txtdirectamente para verificar que es accesible y está correctamente formateado - Análisis de archivos de registro, Supervise los registros de su servidor tras el despliegue para confirmar que los rastreadores respetan sus directivas
Recuerde que los motores de búsqueda guardan en caché su archivo robots.txt y lo actualizan periódicamente (típicamente cada 24 horas). Después de realizar cambios, puede solicitar un nuevo rastreo a través de Google Search Console para obtener actualizaciones más rápidas.
Use el Generador de Robots.txt Sorank para crear un archivo correctamente formateado en segundos, sin necesidad de conocimientos de programación. Proteja su presupuesto de rastreo, gestione el acceso de los bots y asegúrese de que las páginas más valiosas de su sitio reciban la atención que merecen de los motores de búsqueda.