Resumen
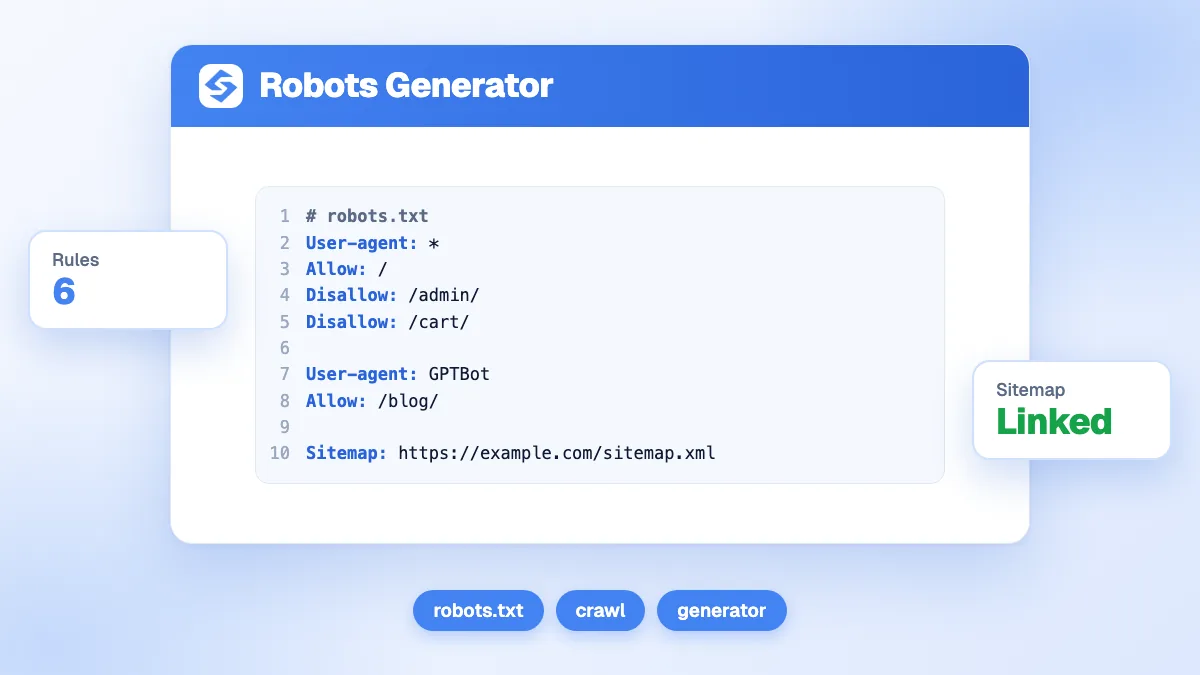
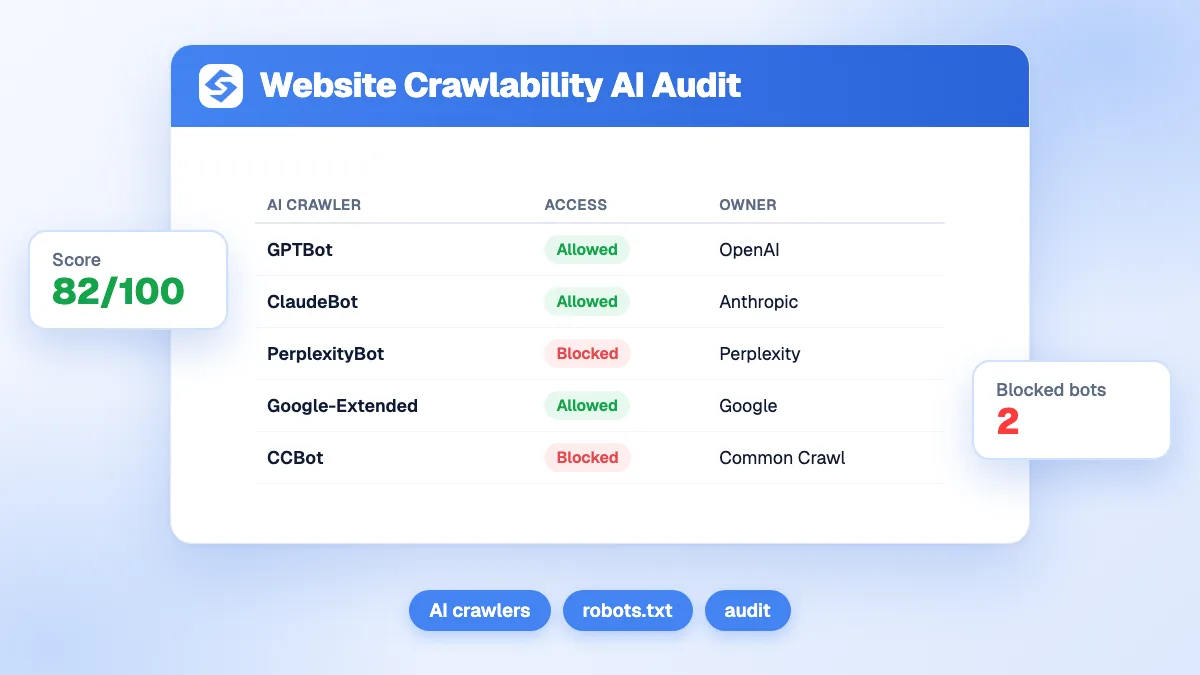
Esta auditoría comprueba si los rastreadores IA pueden llegar a sus páginas y renderizarlas, revisando robots.txt, las directivas meta robots, el renderizado JavaScript, el sitemap.xml y llms.txt. La rastreabilidad es el prerrequisito del GEO: si un bot de IA no puede acceder a su contenido, ninguna optimización on-page le conseguirá una cita.
¿Quiere ir más lejos? Pregunte a


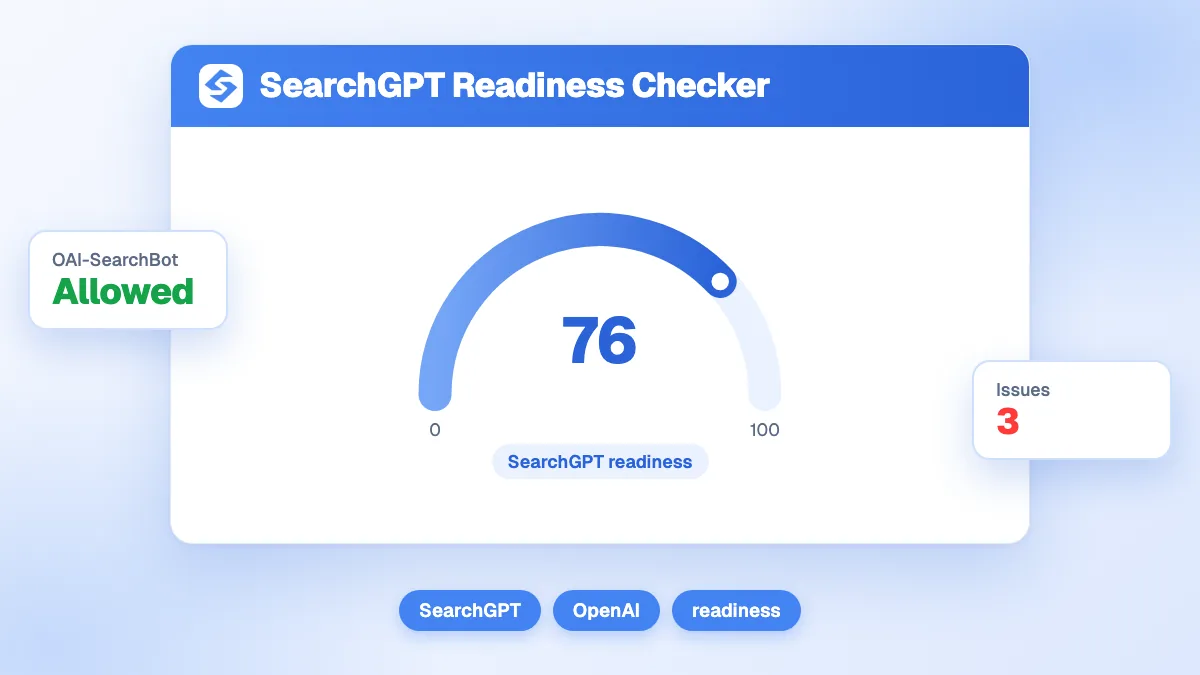
Producir contenido de alta calidad y bien estructurado solo es útil para el GEO si los rastreadores IA pueden llegar y renderizar ese contenido. Una sola directiva robots.txt mal colocada, un stack de renderizado muy dependiente de JavaScript o un archivo llms.txt ausente pueden excluir silenciosamente todo su sitio de los pipelines de entrenamiento y recuperación de todas las grandes IA. La herramienta anterior audita un dominio que usted proporciona y comprueba si los principales rastreadores IA, incluidos GPTBot, OAI-SearchBot, PerplexityBot, Google-Extended y ClaudeBot, pueden acceder a sus páginas y procesarlas correctamente.
Qué verifica la auditoría
La herramienta anterior evalúa cuatro categorías principales de rastreabilidad:
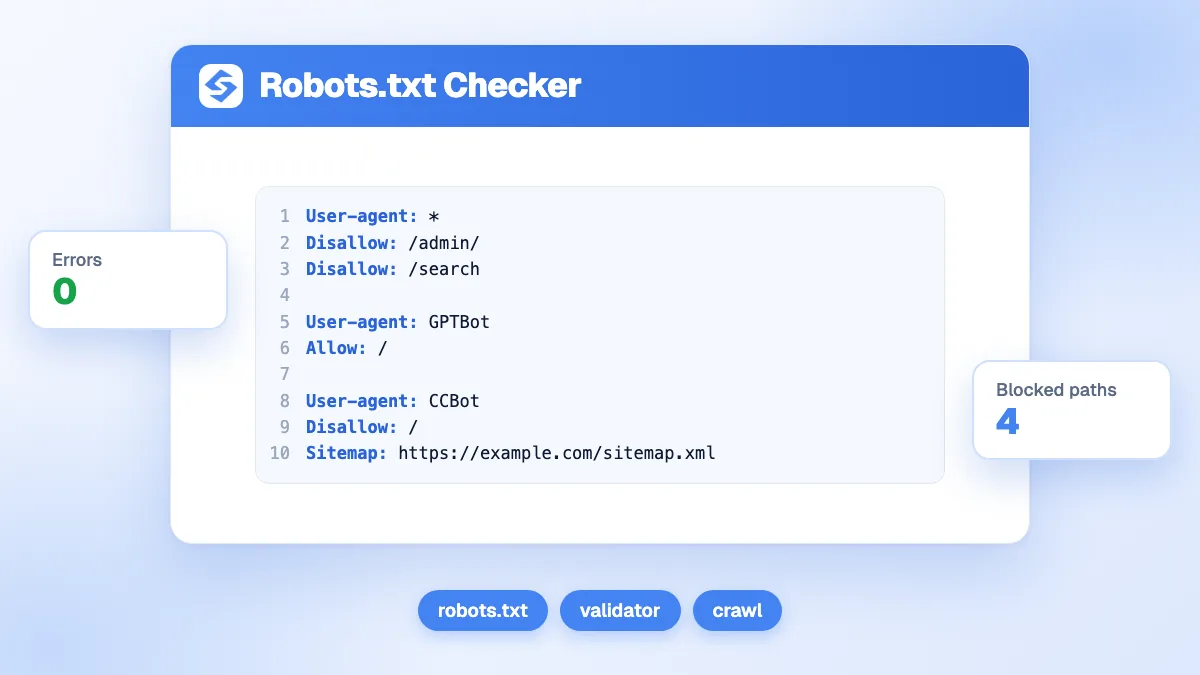
- Directivas robots.txt: la auditoría lee su archivo robots.txt e identifica qué agentes de usuario de rastreadores IA están explícitamente bloqueados, bloqueados accidentalmente por reglas comodín, o ausentes de cualquier lista de permisos. También comprueba que el propio archivo sea accesible, esté correctamente formateado y no supere el límite de 500 KB que algunos rastreadores aplican.
- Meta robots y cabeceras X-Robots-Tag: un robots.txt que permite el rastreo es insuficiente si páginas individuales llevan una etiqueta meta
noindexonoarchive, o si las cabeceras de respuesta del servidor indican a los bots que omitan la página. La auditoría inspecciona ambas fuentes. - Dependencia del renderizado JavaScript: las páginas que entregan contenido crítico exclusivamente mediante JavaScript son invisibles para los rastreadores que no ejecutan scripts. La auditoría detecta si el contenido principal de sus páginas está disponible en el HTML bruto o solo después del renderizado en el cliente.
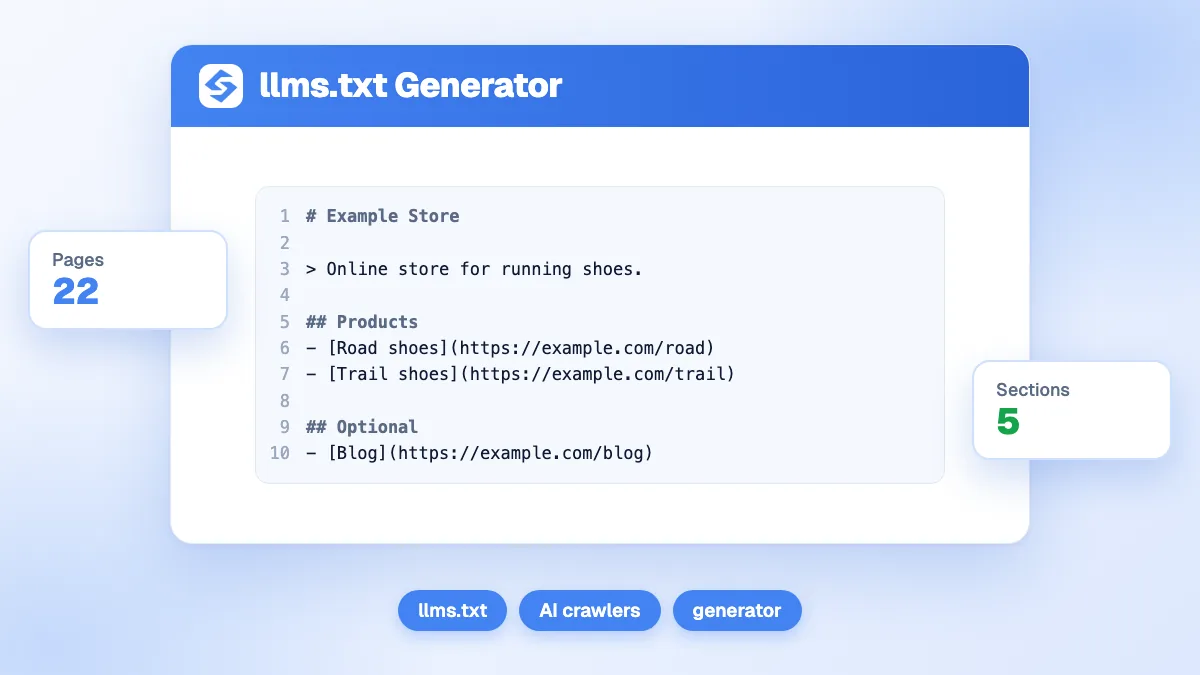
- Sitemaps y llms.txt: un sitemap.xml bien mantenido ayuda a los rastreadores IA a descubrir páginas eficientemente. El estándar más reciente llms.txt, modelado en robots.txt pero diseñado específicamente para LLM, le permite declarar qué secciones de su sitio son adecuadas para el consumo IA y resumir su contenido de forma legible por máquinas. La auditoría comprueba si ambos archivos existen y están correctamente formateados.
Cómo interpretar y actuar sobre los resultados
La herramienta anterior marca cada problema con un nivel de gravedad. Así es como priorizar sus medidas correctivas:
- Rastreadores IA bloqueados en robots.txt: elimine o restrinja la directiva que bloquea el agente de usuario relevante. Si bloquea intencionalmente todos los rastreadores IA por razones de licencia, confirme que es una decisión de política deliberada y no un bloqueo comodín accidental heredado de una plantilla CMS.
- Noindex en páginas clave: revise cada página marcada. Si una página contiene contenido valioso que quiere que sea citado, elimine la directiva noindex. Si la página está intencionalmente excluida, verifique que el bloqueo fue efectivamente intencional y no una directiva del entorno de staging que quedó después del lanzamiento.
- Contenido solo en JavaScript: implemente renderizado del lado del servidor (SSR) o generación de sitios estáticos (SSG) para el contenido que quiera que los rastreadores IA indexen. Como mínimo, asegúrese de que los títulos de página, encabezados y las primeras 200 palabras del cuerpo del texto estén disponibles en el HTML renderizado por el servidor antes de que se ejecute JavaScript.
- Sitemap ausente o desactualizado: genere un nuevo sitemap.xml que incluya todas las URL canónicas, excluya las páginas redirigidas o con noindex, y esté referenciado en robots.txt. Actualícelo automáticamente cada vez que se publique nuevo contenido.
- Sin archivo llms.txt: cree un archivo llms.txt en la raíz de su dominio. Incluya al menos una breve descripción de su sitio, los temas principales cubiertos y enlaces a sus páginas más importantes. Esta es una señal de bajo esfuerzo que puede mejorar significativamente cómo los rastreadores IA categorizan su sitio.
Un punto de referencia sobre el acceso al crawl IA
Los AI Overviews aparecen ahora en aproximadamente el 31% de las consultas de Google, y las páginas en posición 1 detrás de un AI Overview pierden hasta el 58% de los clics esperados (Ahrefs, 2025). Las páginas que capturan ese tráfico desplazado son las citadas dentro de la respuesta IA. La rastreabilidad es el prerrequisito: si un bot de IA no puede acceder a su contenido, ningún volumen de optimización on-page le conseguirá una cita. Corregir las barreras de crawl es por lo tanto el punto de partida con mayor apalancamiento para cualquier estrategia GEO.
Para el monitoreo continuo de su rastreabilidad IA y rendimiento de citas en todas las principales IA, Sorank rastrea su visibilidad GEO y le alerta cuando el acceso cambia.