Riepilogo
Questo audit verifica se i crawler IA possono raggiungere e renderizzare le sue pagine, controllando robots.txt, direttive meta robots, rendering JavaScript, sitemap.xml e llms.txt. La scansionabilità è il prerequisito del GEO: se un bot IA non può accedere ai suoi contenuti, nessuna ottimizzazione on-page le farà guadagnare una citazione.
Vuoi approfondire? Chiedi a


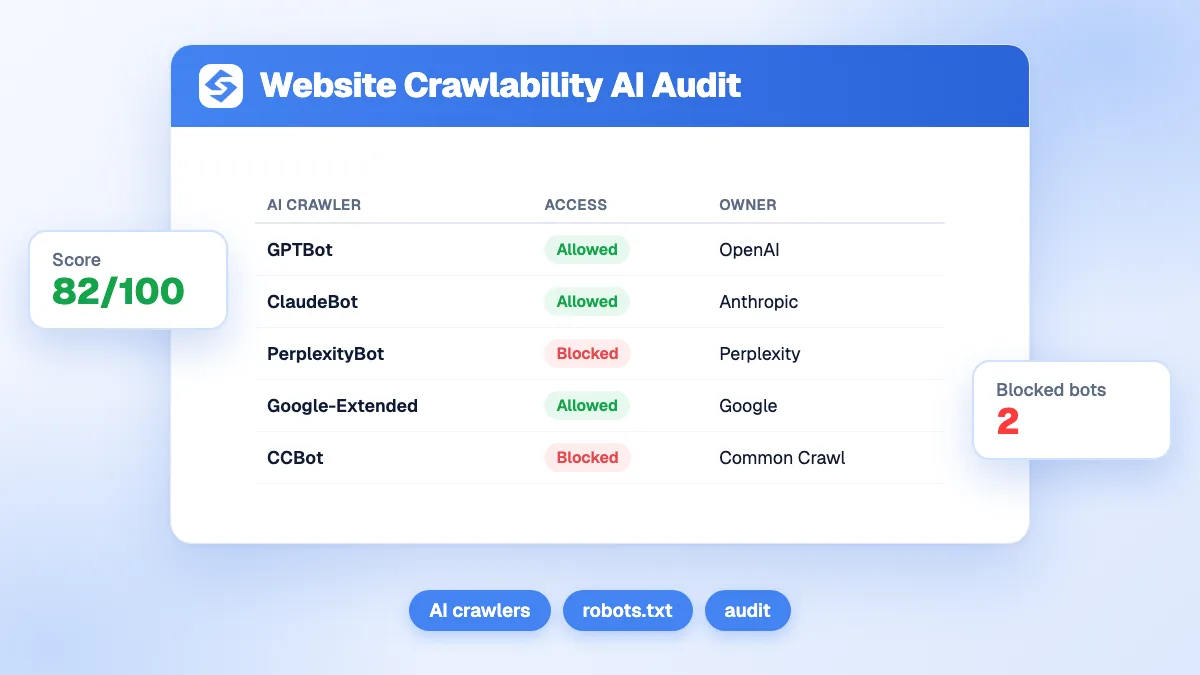
Produrre contenuti di alta qualità e ben strutturati è utile per il GEO solo se i crawler IA riescono effettivamente a raggiungere e a renderizzare quei contenuti. Una singola direttiva del robots.txt fuori posto, uno stack di rendering pesante in JavaScript o un file llms.txt assente possono escludere in silenzio l'intero sito dalle pipeline di addestramento e recupero di tutte le principali IA. Lo strumento qui sopra esegue l'audit di un dominio da lei fornito e verifica se i principali crawler IA, tra cui GPTBot, OAI-SearchBot, PerplexityBot, Google-Extended e ClaudeBot, possono accedere alle sue pagine ed elaborarle correttamente.
Cosa verifica l'audit
Lo strumento qui sopra valuta quattro categorie principali di scansionabilità:
- Direttive del robots.txt: l'audit legge il suo file robots.txt e individua quali user-agent dei crawler IA sono bloccati esplicitamente, bloccati accidentalmente da regole con wildcard o assenti da qualsiasi lista di autorizzazione. Verifica inoltre che il file stesso sia accessibile, formattato correttamente e non superi il limite di 500 KB imposto da alcuni crawler.
- Header meta robots e X-Robots-Tag: un robots.txt che consente la scansione non è sufficiente se singole pagine recano un meta tag
noindexonoarchive, oppure se gli header di risposta del server indicano ai bot di saltare la pagina. L'audit ispeziona entrambe le fonti. - Dipendenza dal rendering JavaScript: le pagine che forniscono contenuti critici esclusivamente tramite JavaScript sono invisibili ai crawler che non eseguono script. L'audit rileva se il contenuto principale delle sue pagine è disponibile nell'HTML grezzo o solo dopo il rendering lato client.
- Sitemap e llms.txt: una sitemap.xml ben mantenuta aiuta i crawler IA a scoprire le pagine in modo efficiente. Il più recente standard llms.txt, modellato sul robots.txt ma pensato specificamente per gli LLM, le consente di dichiarare quali sezioni del suo sito sono adatte al consumo da parte dell'IA e di riassumere i suoi contenuti in un formato leggibile dalle macchine. L'audit verifica se entrambi i file esistono e sono formattati correttamente.
Come interpretare i risultati e agire
Lo strumento qui sopra segnala ogni problema con un livello di gravità. Ecco come stabilire le priorità della sua correzione:
- Crawler IA bloccati nel robots.txt: rimuova o restringa la direttiva che blocca lo user-agent in questione. Se blocca intenzionalmente tutti i crawler IA per ragioni di licenza, verifichi che si tratti di una scelta deliberata e non di un blocco accidentale con wildcard ereditato da un template del CMS.
- Noindex su pagine chiave: esamini ogni pagina segnalata. Se una pagina contiene contenuti di valore che vuole vedere citati, rimuova la direttiva noindex. Se la pagina è esclusa intenzionalmente, verifichi che il blocco fosse effettivamente voluto e non una direttiva di un ambiente di staging rimasta in vigore dopo la pubblicazione.
- Contenuti solo in JavaScript: implementi il rendering lato server (SSR) o la generazione di siti statici (SSG) per i contenuti che vuole far indicizzare dai crawler IA. Come minimo, si assicuri che titoli delle pagine, intestazioni e le prime 200 parole del corpo del testo siano disponibili nell'HTML renderizzato dal server prima dell'esecuzione del JavaScript.
- Sitemap assente o obsoleta: generi una nuova sitemap.xml che includa tutti gli URL canonici, escluda le pagine reindirizzate o noindex e sia referenziata nel robots.txt. La aggiorni automaticamente ogni volta che pubblica nuovi contenuti.
- Nessun file llms.txt: crei un file llms.txt nella radice del suo dominio. Come minimo, includa una breve descrizione del suo sito, gli argomenti principali trattati e i link alle sue pagine più importanti. È un segnale a basso sforzo che può migliorare in modo significativo il modo in cui i crawler IA categorizzano il suo sito.
Un benchmark sull'accesso alla scansione IA
Le AI Overview compaiono ormai in circa il 31% delle query su Google e le pagine in posizione 1 dietro un'AI Overview perdono fino al 58% dei clic previsti (Ahrefs, 2025). Le pagine che catturano quel traffico spostato sono quelle citate all'interno della risposta IA. La scansionabilità è il prerequisito: se un bot IA non può accedere ai suoi contenuti, nessuna ottimizzazione on-page le farà guadagnare una citazione. Correggere le barriere alla scansione è quindi il punto di partenza con la leva più alta per qualsiasi strategia GEO.
Per un monitoraggio continuo della sua scansionabilità IA e delle prestazioni di citazione su tutte le principali IA, Sorank traccia la sua visibilità GEO e la avvisa quando l'accesso cambia.