設定
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

クロールエラーを見つけて直す方法:DNS、サーバー、robots.txt、404、ソフト 404、リダイレクトエラー。Googlebot の反応と、順番に直す 6 ステップの手順を解説します。
ツール

要点
クロールエラーとは、検索エンジンや AI クローラーがあなたのサイトに送ったリクエストが失敗することです。サーバーがタイムアウトする、DNS が応答しない、robots.txt を取得できない、リダイレクトがループする、ページが 4xx や 5xx を返す、といったケースです。サイトレベルのエラー(DNS、サーバー、robots.txt)は Google によるサイト全体のクロールを止めてしまう可能性があるため、最初に修正します。URL レベルのエラー(404、ソフト 404、リダイレクトエラー)は、インデックスさせたいページで起きている場合にだけ重要です。Search Console の Crawl Stats と Page indexing レポートで見つけ、クローラーツールとサーバーログで確認し、原因を修正して検証します。
さらに詳しく知るには、こちらに質問
クイック診断
サイトの技術面は誰が直すべき?
あなたへのおすすめ
Googleの無料ツールで自分で確認する
Search ConsoleはGoogleが読み取れないページを一覧にし、PageSpeed Insightsは表示速度を測ります。小さな問題の多くは、サイト作成ツールの設定で直せます。
あなたへのおすすめ
Web開発者
問題がコードやサーバーにあるなら、SEOに詳しい開発者が適任です。Search Consoleのエラー一覧を渡しましょう。
あなたへのおすすめ
技術診断ツール
ページ数が多いサイトなら、クローラーがGoogleと同じようにすべてを読み、直すべきエラーをページごとに一覧にします。
あなたへのおすすめ
自動診断のあとにコンテンツ
サイトは動いているのに訪問者が少ないなら、原因が技術面であることはまれです。Sorankはサイトを診断し、集客につながるページを書きます。
クローラーはとても辛抱強い訪問者のように動きます。サーバーに URL をリクエストし、応答を待ち、ステータスコードとコンテンツを読み、見つけたリンクへ移ります。クロールエラーとは、この流れのどこかが失敗することです。訪問者は使えるページを一度も受け取れません。
この定義が大切なのは、多くのレポートがクロールエラーとインデックス判断を混同しているからです。"Crawled, currently not indexed" はクロールエラーではありません。Google はページを問題なく取得したうえで、登録しないことを選んだのです。"Excluded by noindex" もクロールエラーではありません。ページを外すよう Google に指示したのはあなたです。クロールエラーとは、取得そのものが失敗したことを意味します。
Google は問題を 2 つのレベルに分けています。あなたも同じように分けるべきです。
サイトエラーと URL エラーの比較
古い商品 URL が 4000 件 404 を返している EC サイトでも、その商品が完全に終売なら、まったく健全な場合があります。一方、同じサイトで robots.txt が 6 時間 503 を返していたら、すべての商品ページが正常でも本当の緊急事態です。まずホスト、次に売上を生む URL、最後に残りを見ます。
クロールエラーをきちんと直すには、Google が実際にどう振る舞うかを知る必要があります。Google のドキュメント「HTTP ステータスコード、ネットワークエラーが Google 検索に与える影響」(Google Search Central)がルールを示しています。実務での意味は次のとおりです。
| 応答 | Google の動作 | 問題か? |
|---|---|---|
| 2xx | コンテンツをインデックス処理に渡す。インデックス登録は保証されない。 | いいえ。ただしページが空なら別(ソフト 404)。 |
| 301、308 | 転送先が新しい URL であるという強いシグナル。 | いいえ。200 まで 1 回で届くなら。 |
| 302、303、307 | 弱いシグナル。元の URL が正規 URL のまま残りやすい。 | はい。移転が恒久的な場合。 |
| 3xx のチェーン | 既定で最大 10 回までたどり、その後あきらめる。 | はい。1 回ごとにリクエストが無駄になり、ループは終わらない。 |
| 404、410、その他の 4xx(429 を除く) | コンテンツが存在しないと判断し、登録済み URL を徐々に削除し、クロール頻度を下げる。 | そのページが存在すべき場合のみ。 |
| 401、403 | 他の 4xx と同じ。クロール速度は下がらない。 | はい。公開ページで Googlebot をブロックしているなら。 |
| 429 | 5xx と同じくサーバー過負荷のシグナルとして扱う。 | はい。クロールが遅くなる。 |
| 5xx | エラーの量に応じてクロールを減らす。失敗し続ける URL はインデックスから削除される。 | はい、常に。 |
多くのチームがつまずく点が 2 つあります。1 つ目に、401 と 403 はクロール頻度を下げません。サーバーが苦しいときに Googlebot へ 403 を返しても効果はなく、Google は一時的に 503 か 429 を返すよう求めています。2 つ目に、404 はペナルティではありません。存在しなくなったページに対する正しい答えです。
Google のCrawl Stats レポートのドキュメント(Search Console Help)がルールを説明しています。robots.txt が 200(空でも可)や 403、404、410(ファイルなし)を返すなら問題ありません。429 や 5xx を返すと失敗とみなされ、Google は慎重に振る舞います。
robots.txt の失敗が続いたときの Google の動作
出典:Google Search Console Help、Crawl Stats レポート
つまり、/robots.txt に 503 を返す CDN ルールやファイアウォールがあるだけで、他の URL がすべて正常でもサイト全体が半日止まることがあります。クロールエラーの調査では、まずこのファイルを確認してください。"Blocked by robots.txt" ステータスのガイドでは、ファイルは動いているのにブロックしすぎるという逆の問題を扱っています。
覚えておきたい Google のクロール上限
出典:Google Search Central、HTTP ステータスコードとネットワークエラー;Search Console Help、Crawl Stats レポート
Search Console やクローラーツールで目にする全リストを、原因と修正方法とあわせて紹介します。名称は Google のPage indexing レポートのドキュメント(Search Console Help)に合わせています。
Google がドメイン名を IP アドレスに変換できなかった、または DNS サーバーが応答しなかった状態です。よくある原因:ドメインの期限切れ、DNS プロバイダーの障害、移転後の誤ったレコード、DNSSEC の設定ミス。自分のネットワークの外から問い合わせて確認します:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
修正:レコードを直し、移転前には TTL を下げ、冗長構成のある DNS プロバイダーを使います。example.com と www.example.com の両方があるなら、片方がリダイレクトするだけでも、両方とも名前解決できなければなりません。
サーバーが時間内に応答しない、接続を閉じる、または 500、502、503、504 を返す状態です。典型的な原因:データベースの過負荷、負荷で落ちる PHP や Node のプロセス、リバースプロキシのタイムアウト、プラグインの更新、ボットを速度制限するファイアウォール。時間のパターンを見てください。毎晩同じ時刻のエラーは、たいていバックアップか cron ジョブが原因です。
修正:Google が報告した時刻のサーバーエラーログを読み、タイムアウトやワーカー数を増やし、重いページをキャッシュし、ボット対策が認証済みの Googlebot を通すようにします。計画メンテナンスでは、「まもなく再開します」と書いた 200 のページではなく、Retry-After ヘッダー付きの 503 を返します:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600ページが存在しない状態です。意図的に削除し、どこからもリンクされていないなら問題ありません。その URL にまだ被リンク、流入、内部リンクがある場合や、本来あるべきページがデプロイで壊れた場合は問題です。
修正:コンテンツが移動したなら、最も近いページへ 301 を 1 回だけ設定します。完全に消えたなら 404 のままにするか 410 を使い、そのページを指す内部リンクとサイトマップの項目を削除します。すべての 404 をトップページへリダイレクトするのは絶対にやめてください。Google はそれをソフト 404 とみなしがちです。
サーバーは 200 を返しているのに、ページが空に見える、または「見つかりません」と表示している状態です。空のカテゴリ、結果ゼロの検索ページ、内容のない在庫切れ商品などです。Google はリクエストを使って何も得られません。詳しくはソフト 404 エラーのガイドで解説しています。
Googlebot は認証情報を送らないため、公開ページの 401 や 403 は、サーバーかセキュリティ層がブロックしていることを意味します。よくある原因:本番環境に残ったステージング用パスワード、WAF のルール、国別ブロック、HTML に適用された直リンク防止ルール。症状ではなくルールを直し、Search Console の URL Inspection ツールでテストします。
ループ、長すぎるチェーン、最大長を超える URL、チェーン内の不正または空の URL に遭遇すると、Google はリダイレクトエラーを報告します。移転後の典型例:http から https、次に www、次に末尾スラッシュ、さらに新しいパスへ。1 回で済むところを 4 回飛んでいます。SEO のリダイレクトの完全ガイドで、まとめ方を説明しています。
ヒント
怪しい URL は無料の Sorank リダイレクトチェッカーに貼り付けてください。チェーン全体をたどり、各ステップとそのステータスコードを表示し、ループや余分なステップの場所を教えてくれます。
ステータスコードがまったく出ないエラーもあります。ページの読み込みが始まって止まる、または重すぎてクローラーが一部しか読まない、といったケースです。Google のクローラーは 1 ファイルあたり読み込むバイト数に上限があるため、インラインスクリプトや base64 画像で膨れたページは下部のコンテンツを失うことがあります。重いテンプレートはページサイズチェッカーで確認してください。
すべてのクロールエラーを表示できるツールは 1 つもありません。方法ごとに見える角度が違うため、本格的な監査では少なくとも 2 つを組み合わせます。
仕組み:Google 自身の過去 90 日間のクロールリクエストを、応答、ファイル形式、目的、Googlebot の種類ごとにまとめ、DNS、サーバー、robots.txt のホストステータスも表示します。使う場面:常に、そしてサイトエラーについては最初に。利点:Google 自身による正確なデータです。限界:ルートレベルのプロパティのみで、例はサンプルで、Google は 1000 ページ未満のサイトではほとんど必要ないとしています。例:毎週日曜の午前 3 時に "page timeout" の応答が急増し、データベースのバックアップと一致している。
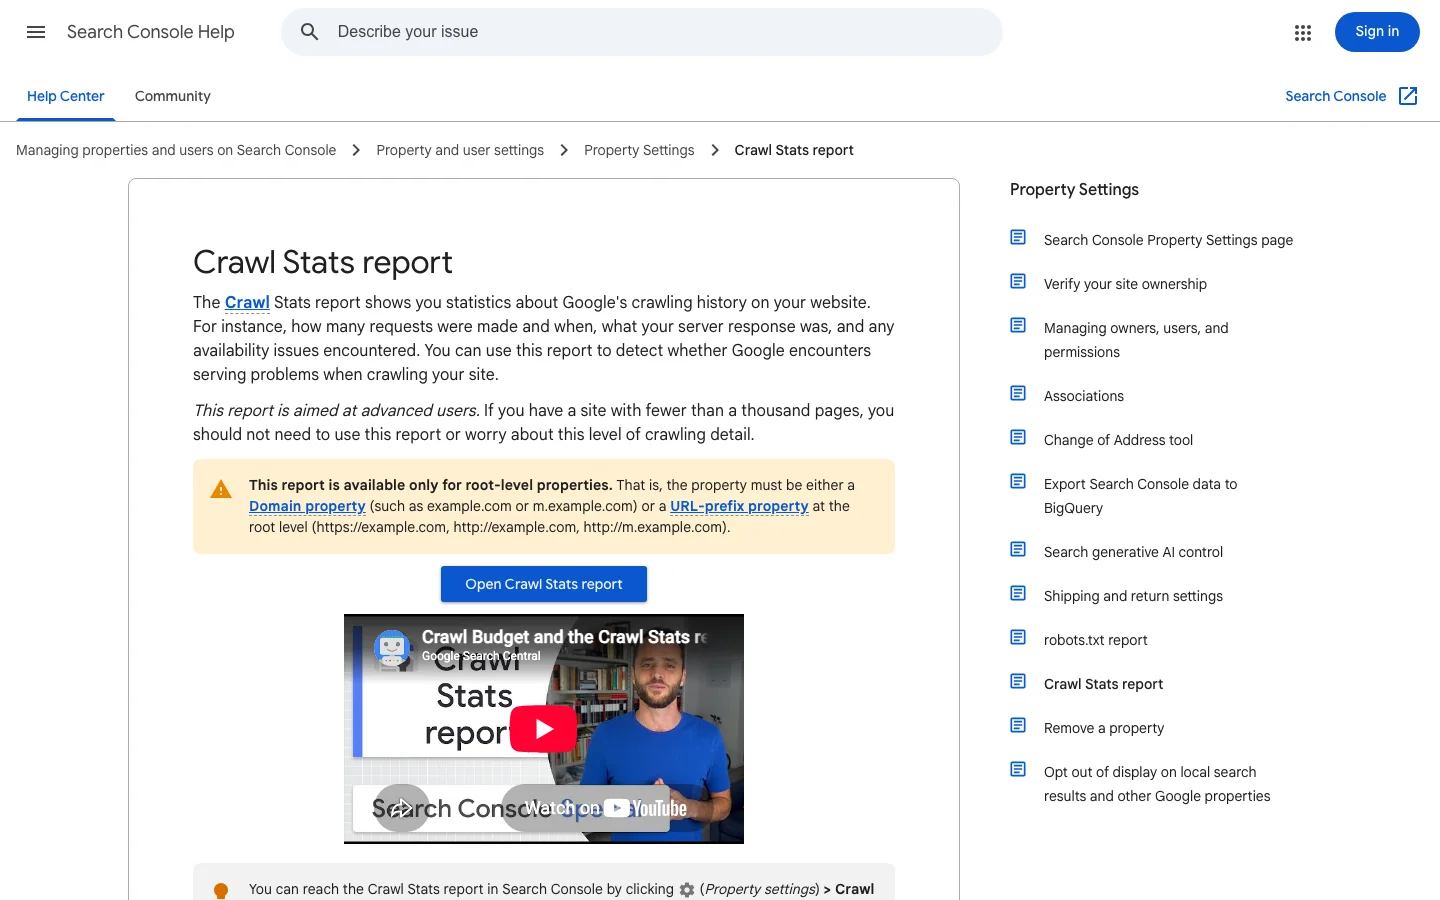
仕組み:Google が把握している URL と、それがインデックスされない理由を一覧にします。理由には Server error (5xx)、Redirect error、Not found (404)、Soft 404 などがあります。使う場面:URL エラーの仕分けと修正の検証。利点:Google が実際に試したページに結びついています。限界:数日の遅れがあり、例の一覧には上限があり、クロールエラーとインデックスの判断が混在しています。例:"Redirect error" の 300 件の URL が、すべて同じ古いプレフィックス /blog/ を持っている。
仕組み:Screaming Frog のようなツールが、ボットと同じようにトップページからリンクをたどってサイトをクロールし、すべてのステータスコード、リダイレクトチェーン、リンク切れを記録します。使う場面:移転、リニューアル、大きなデプロイの前後、そして大規模サイトでは毎月。利点:即時で、リンクされたページは網羅でき、各リンク切れの場所がわかります。限界:Google が実際に何をリクエストしたかはわからず、孤立ページを見落とし、サーバーが Googlebot とは違う扱いをすることがあります。Screaming Frog 設定ガイドで、完全な監査の手順を紹介しています。
仕組み:アクセスログには、Googlebot、Bingbot、GPTBot、ClaudeBot、PerplexityBot を含むすべてのリクエストが、正確なステータスコードと応答時間とともに記録されます。使う場面:大規模サイト、説明のつかない流入減少の後、AI クローラーが何にアクセスしているかを知りたいとき。利点:実際のリクエスト、実際のコード、サンプリングなし、すべてのボット。限界:ログへのアクセスと多少のスクリプトが必要で、「Googlebot」が本当に Google か確認しなければなりません。SEO のためのログファイル分析のガイドで順を追って説明しています。まずはざっと確認:
# Googlebot requests that did not return 200, 301 or 304, most frequent first
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50仕組み:curl や無料のオンラインチェッカーで 1 つずつ URL をテストします。使う場面:修正の確認や、デプロイ後の重要ページのチェック。利点:即時で正確。限界:大量には向きません。ボットを別扱いするルールを見つけるため、Googlebot のユーザーエージェントを使います:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| 方法 | サイトエラーが見える | URL エラーが見える | 実際の Googlebot データ | AI クローラーが見える | 最適な用途 |
|---|---|---|---|---|---|
| Crawl Stats レポート | はい | サンプル | はい | いいえ | ホストの健全性 |
| Page indexing レポート | 一部 | はい | はい | いいえ | 仕分けと検証 |
| クローラー(Screaming Frog など) | いいえ | はい、リンクされたページ | いいえ | いいえ | リンク切れを発生源で見つける |
| サーバーログ | 一部 | はい | はい | はい | 大規模サイト、根本原因 |
| 個別 URL チェック | いいえ | 1 件ずつ | いいえ | いいえ | 修正の確認 |
5xx ステータスは、サーバーが正当に見えるリクエストを処理できなかったことを示します。Google はこれに応じてクロールを遅くし、5xx を返す URL が増えるほどさらに遅くします。Google は既にインデックスされた URL をしばらく保持しますが、継続的にサーバーエラーを返す URL は削除します。短時間の障害は回復できます。サーバーが 2xx を返すようになると、Google はクロール頻度を徐々に戻すからです。長く続くエラーこそがインデックスを傷つけます。
5xx の各コードは、スタックの異なる部分を指しています。下の表は、それぞれのコードについて最初に確認する場所を示しています。
| コード | 通常の意味 | 最初に確認すること |
|---|---|---|
| 500 | アプリケーションがリクエストの処理中に失敗した | リクエストの発生時刻のアプリケーションエラーログ |
| 502 | プロキシまたは CDN がアプリケーションから不正な応答を受け取った。多くはアプリがクラッシュまたは再起動したため | アプリケーションプロセスの再起動履歴と稼働時間 |
| 503 | サービスが過負荷、レート制限中、またはメンテナンス中 | 負荷グラフ、デプロイ履歴、メンテナンス時間帯 |
| 504 | プロキシがアプリケーションの応答を待ちきれなかった | 遅いデータベースクエリとプロキシのタイムアウト設定 |
| 429 | レートリミッターがリクエストの多さを通知している | レート制限のルールと、それが認証済みの Googlebot に適用されるか |
Crawl Stats には、Google がエラーに遭遇した日と時間帯が表示されます(各グラフの説明はCrawl Stats ガイドをご覧ください)。サーバーログには、その正確な瞬間に何が起きたかが記録されています。Googlebot のリクエストを絞り込み、時間ごとの 5xx 応答を数えてください。
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
出力の各行は、時間、ステータスコード、件数を表します。毎晩同じ時間に集中している場合は、バックアップ、cron ジョブ、または定期インポートが原因であることが多いです。一日を通して散らばっている場合は、負荷が原因であることが多く、その場合の対策は単一のバグ修正ではなく、キャパシティやキャッシュの強化です。より詳しい方法はログファイル分析ガイドをご覧ください。
Google は、エラーを返す URL の数に応じてクロールを減らします。数ページに影響する壊れたテンプレートは、クロール時間の損失がわずかです。すべてのページを壊すデータベース障害は大きな損失になるため、最優先で直してください。
429 は、Google がサーバーの過負荷として読み取るため、5xx と同じ影響があります。レートリミッターやボット対策が Googlebot に 429 を返している場合、そのコストはクロール時間として支払うことになります。Google のドキュメントには Retry-After ヘッダーの記載がありません。人間の訪問者や API クライアントには引き続き送ってください。ただし、設定した時間だけ Googlebot が待つことを前提にしないでください。
4xx ステータスは、クライアント側の理由(URL が存在しない、アクセスが禁止されている、アドレスの形式が不正など)でサーバーがリクエストを拒否したことを示します。Google は 429 を除くすべての 4xx を同じように扱います。その URL の内容の利用をやめ、インデックスされていた場合は除外します。4xx に手をつける前に、リクエストがどこから来ているかを確認してください。修正箇所は多くの場合ひとつだけです。リンク、テンプレート、またはリダイレクトのルールがそれにあたります。
アクセスログには各リクエストのリファラーが記録されており、どのページが訪問者やボットをその URL に送ったかがわかります。4xx のレスポンスをパスとリファラーごとに数えてください。
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
リファラー列は次のように読みます。
パスの名前変更、スラッグの変更、テンプレートの再構築を含むリリースは、同じ日に 404 が大量に発生することがよくあります。デプロイの前週と後週について、1 日ごとの 4xx 件数を書き出してください。特定のフォルダに集中した増加は、変更箇所を直接示します。旧 URL から新 URL へのリダイレクトは、後日のチケットではなく同じリリースに含めてください。サイト移行全体については、SEO 移行チェックリストをご覧ください。
ヒント
存在しないページを、短いメッセージや空の一覧を表示する 200 レスポンスで置き換えないでください。Google はソフト 404とみなすことがあり、クロールのコストだけがかかって何も得られなくなります。
私たちが使っている方法です。サイト全体を止めかねないエラーから始め、クロールを少し無駄にするだけのエラーへと進みます。
クロールエラー対応の 6 ステップ
Search Console で Settings、Crawl stats、Host status の順に開きます。緑なら 90 日間に大きな問題はありません。"Recent issue" は直近 1 週間に大きな問題があったという意味なので、他のことはすべて後回しにします。各カテゴリをクリックして日ごとの失敗率を見て、悪い日をホスティング、CDN、デプロイの履歴と照らし合わせます。
Indexing、Pages の順に開き、エラーの理由ごとに書き出します。URL を 1 件ずつ直してはいけません。スプレッドシートに入れて、最初のフォルダを抜き出します:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")この列でピボットテーブルを作ると、たいていエラーの大半が 2〜3 個のテンプレートから来ていることがわかります。廃止したブログカテゴリ、絞り込みパラメータ、古い商品フィードなどです。
パターンごとに 4 つの質問をします。自然検索のクリックはあるか。被リンクはあるか。内部リンクされているか。サイトマップに入っているか。4 つとも当てはまらない 404 はずっと放置してかまいません。被リンクのある 404 には今日 301 が必要です。無料のリンク切れチェッカーで、自サイトのどのページがまだ死んだ URL にリンクしているかがわかります。
URL ではなくルールを直します。プラグインで手作業で追加した 400 件のリダイレクトより、サーバー設定の 1 つのリダイレクト表のほうが優れています。たとえば nginx なら:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
5xx なら、処理能力かバグを直します。401 と 403 なら、セキュリティルールを直します。ソフト 404 なら、実際のコンテンツを加えるか、本物の 404 を返します。
すべての内部リンクは、200 を返す URL を直接指すべきです。サイトマップの各項目は、正規で、インデックス可能で、200 を返す URL であるべきです。リダイレクトや 404 だらけのサイトマップは、Google にそのサイトマップを信用しないよう教えてしまいます。サイトマップの作り方のガイドで、何を載せるべきかを説明しています。
Page indexing レポートで修正した理由を開き、Validate fix をクリックします。Google はまずサンプルを確認し、その後に残りを確認します。通常は 2 週間ほどかかり、1 件でも失敗が残っていると止まります。実行中にもう一度クリックしないでください。その後、毎週の習慣を作ります。ホストは Crawl Stats、急増はログ、デプロイのたびにクロール。
修正前と修正後のリダイレクトチェーン
内容:存在しない URL をすべて / へ送るプラグインやルール。見つけ方:"Soft 404" や "Page with redirect" に、トップページに着地する URL が大量にある。クローラーで同じ転送先の 301 が数百件見つかる。直し方:近い内容のページにだけリダイレクトし、残りは 404 か 410 を返すようにします。
内容:WAF、ボット管理ツール、レート制限が Google に 403、429、チャレンジページを返す。見つけ方:ブラウザではページが正常に表示されるのに、Crawl Stats に 403 や 429 が出る。ログに IP ごとのブロックが記録されている。直し方:ユーザーエージェントの文字列を信用するのではなく、逆引き DNS や Google が公開している IP 範囲を使って、認証済みの Googlebot を許可します。
内容:アプリが生成する robots.txt で、アプリが落ちるたびに失敗する。あるいは 5xx をキャッシュする CDN ルール経由で配信されている。見つけ方:Host status の robots.txt 取得カテゴリが緑ではない。直し方:アプリの外で静的ファイルとして配信し、robots.txt チェッカーでテストします。
内容:すべての URL で「まもなく再開します」ページをステータス 200 で返す。見つけ方:メンテナンス後にソフト 404 や重複タイトルが一気に増える。直し方:メンテナンス中は Retry-After 付きの 503 を返し、期間は短くします。
内容:サーバーが過負荷のときに Googlebot へ 403 を返す。見つけ方:403 の急増が負荷の急増と一致している。直し方:Google は、429 以外の 4xx はクロール頻度に影響しないとしています。短期間だけ 503 か 429 を返し、処理能力を改善します。
内容:Search Console の一覧を 1 件ずつクリックして各 URL を編集する。見つけ方:同じ理由が毎月戻ってくる。直し方:パターンでまとめ、テンプレートやルールを直し、検証は 1 回で済ませます。
内容:スパム URL や、ずっと前に削除されリンクもないページの 404 に何日も費やす。見つけ方:その URL にクリックも被リンクも内部リンクもない。直し方:放置します。Google は、削除したページの 404 は必ずしも問題ではないとしています。
注意
クロールエラーを「隠す」ために robots.txt で URL をブロックしてはいけません。Google は 404 やリダイレクトを確認できなくなり、URL がインデックスに残ることがあり、伝えたかったシグナルも失われます。
数百ページのサイトなら Google にはすべてを見る時間があり、クロールエラーが重要なのは主に壊れたページについてです。大規模サイト(絞り込みのある EC、マーケットプレイス、ニュース)では、失敗したリクエストや無駄なリクエストのひとつひとつが本当のページから時間を奪います。これがクロールバジェットの考え方です。
5xx と 429 は Google にホスト全体でクロールを遅くさせるため、いくつかの壊れたテンプレートが新商品ページのクロールを遅らせることがあります。リダイレクトチェーンは 1 回ごとに 1 リクエストかかります。ソフト 404 は完全な取得 1 回分のコストがかかるのに、何も返しません。この 3 つを直せば、同じバジェットでより多くの有用なページをカバーできます。
Google が URL を見つけてもクロールを後回しにする場合、原因はたいてい Google が不安定と見なしているサーバーです。"Discovered, currently not indexed" の件数が増え、同時に Crawl Stats でサーバーエラーが出ているなら、まずサーバーを直します。2 つのレポートは同じことを語っています。
重要な訪問者はもう Googlebot だけではありません。GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBot は、モデルの学習やリアルタイムの回答のためにページを取得します。同じサーバーにアクセスし、同じエラーに悩まされますが、違いが 1 つあります。彼らには Search Console がありません。
多くの AI クローラーは JavaScript を実行しないため、ブラウザ上でだけコンテンツを組み立てるページは空に見えることがあります。これは Google のレポートには決して出てこない一種のソフト 404 です。多くはボット対策サービスで標準設定のままブロックされ、たいてい 403 になります。さらに、ユーザーが質問した瞬間にオンデマンドで取得するため、そのときタイムアウトすると回答には別のサイトが引用されます。JavaScript SEO のガイドでは、検索クローラーと AI クローラーの両方に向けたレンダリングを扱っています。
信頼できる情報源はサーバーログだけです。ユーザーエージェントで絞り込み、ステータスコードを確認します:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnAI ボットに意図しない 403 が返っていたら、ルールを直します。そのうえで、実際に引用されているかを確認します。Sorank の AI 言及トラッキングは、ChatGPT、Gemini、Claude、Perplexity があなたのブランドに言及する頻度を追跡するので、クロールの修正で何かが変わったかがわかります。
移転、リニューアル、大きなデプロイのたびに、そして大規模サイトでは毎月、このリストを確認してください。
クロール健全性チェックリスト
Crawl Stats を開き、ホストステータスの 3 行を確認します。次に、最も価値のある 5 ページに無料のインデックス可否チェッカーをかけます。どちらも問題なければ、Page indexing のエラーを書き出してフォルダ別にまとめます。これで、怖いレポートではなく、短く優先順位のついた修正リストが手に入ります。
クロールがきれいになったら、次の壁はコンテンツそのものです。Sorank のコンテンツ最適化は、既存ページを autopilot で書き直して更新するので、Google がたどり着けるようになったページを、インデックスされ引用される価値のあるものにできます。Google がクロールしたのに登録しなかったページについては、"Crawled, currently not indexed" のガイドをお読みください。
クロールエラーとは、検索エンジンや AI クローラーのリクエストが失敗することです。DNS が名前解決できない、サーバーがタイムアウトするか 5xx を返す、robots.txt を取得できない、リダイレクトがループする、ページが 4xx を返す、といったケースです。サイトレベルのエラーはサイト全体のクロールを止めることがあり、URL エラーは該当ページにだけ影響します。
それ自体は問題ではありません。Google は、代わりのないまま削除したページの 404 は必ずしも問題ではないとしています。その URL にまだ被リンク、流入、内部リンクがある場合は問題になり、近い内容のページへの 301 を 1 回設定するのが正しい対応です。
Search Console の Page indexing レポートで Validate fix をクリックすると、検証には通常 2 週間ほどかかります。Google はまず URL のサンプルを確認し、その後に残りを確認します。該当する URL が 1 件でも失敗し続けていると検証は止まります。
競合、あなたのサイト、AIでの可視性を分析し、あなた専用のコンテンツプランを無料で作成します。
 AI コンテンツブリーフ生成ツール
 FAQ スキーマ生成ツール
 AI ブログ記事アイデア生成ツール
 構造化データ検証ツール(スキーマバリデーター)
 代替テキストチェッカー
 内部リンク分析ツール
 被リンクチャレンジ
 AI メタディスクリプション生成ツール
 AI ブログタイトル生成ツール
 Google インデックス可否チェッカー
 AI 記事構成案生成ツール
 UTM リンク作成ツール
 キーワードのグループ化ツール
 canonical タグチェッカー
 XML サイトマップ生成ツール
 リンク切れチェッカー
 AI SEO タイトル生成ツール
 見出しアナライザー
 検索結果プレビューツール
 リダイレクトチェッカー
 hreflang タグ生成ツール
 見出し構造チェッカー
 HTTP ヘッダーチェッカー
 Favicon 抽出ツール
 SEO トラフィック・売上予測計算ツール
 SEO 予算計算ツール
 順位上昇シミュレーター
 キーワード機会スコア計算ツール
 GEO コンテンツ投資計算ツール
 顧客生涯価値計算ツール
 CTR 計算ツール
 AI トラフィック価値計算ツール
 AI シェア・オブ・ボイス計算ツール
 Gemini ランキングツール
 ROAS 計算ツール
 自然検索トラフィック価値計算ツール
 ローカル SEO ROI 計算ツール
 被リンク獲得コスト計算ツール
 キーワード密度計算ツール
 顧客獲得コスト計算ツール
 記事単価計算ツール
 直帰率計算ツール
 AI 引用率計算ツール
 LLM 向け構造化データ監査
 llms.txt ジェネレーター
 Sitemap チェッカー
 SERP 変動センサー
 文字数カウンター
 Schema マークアップ生成ツール
 キーワード調査ツール
 SEO 損益分岐点計算ツール
 読了時間計算ツール
 自然検索トラフィック予測ツール・サイトのアクセス数チェック
 ChatGPT 参照トラフィック予測ツール
 AI 可視性スコア計算ツール
 AI 可読性チェッカー
 SearchGPT 対応チェッカー
 ChatGPT が自社サイトを推薦しない理由
 URL 抽出ツール
 ウェブページ Markdown 変換ツール
 robots.txt 生成ツール
 Open Graph プレビュー
 オンページ SEO 監査:SEO チェッカーと SEO 分析ツール
 LTV:CAC 比率計算ツール
 GEO ROI 計算ツール
 コンバージョン率計算ツール
 AI クローラー巡回監査
 AI 検索可視性テスト
 ページサイズチェッカー
 URL スラッグ生成ツール
 メタタグ生成ツール
 画像圧縮ツール
 ファビコン生成ツール
 ドメインオーソリティチェッカー
 検索結果 CTR 計算ツール
 EC SEO ROI 計算ツール
 コンテンツマーケティング ROI 計算ツール
 AI での不可視コスト計算ツール
 AI Overviews チェッカーと AI Overviews 順位チェック
 robots.txt チェッカー
 SEO・AI 監査
 Perplexity ランキングチェッカー
 アンサーエンジン最適化の監査
 ChatGPT 可視性チェッカー
 被リンク分析ツール
 SEO とリスティング広告の節約額計算ツール
 SEO シェア・オブ・ボイス計算ツール
 SaaS SEO ROI 計算ツール
 被リンク ROI 計算ツール
 llms.txt バリデーター
 LLM 引用チェッカー
 GEO 監査
 SEO ROI 計算ツール
 キーワード価値計算ツール
 “2年間、クライアントの100%がLinkedIn経由でした。毎日の投稿、コメント、DMでのフォローアップ…完全にアルゴリズム頼みでした。SEOに取り組むべきだとわかっていても、時間がかかる、技術的すぎる、自分の仕事ではないと、いつも後回しにしていました。Sorankでようやく一歩を踏み出しました。4か月で、何も投稿しなくても毎月15件のオーガニックリードを獲得しています。まだLinkedInと半々ではありませんが、自動で育つ2つ目のリード源ができたことで安心して眠れるようになりました。”

 Valentin Thomyoffbound.fr“Sorankは、クライアントに提供する成果を大きく変えてくれました。AIが実際に使っているキーワードを特定し、特定の競合が引用される理由を理解し、以前は完全に見落としていたチャンスを見つけられるようになりました。クライアントは、より早い順位上昇、AIの回答での可視性向上、そしてすべての施策のROIがより明確になったことを実感しています。”
 Benjamin Rouxovirank.com
 “私はマーケターではなく開発者です。私のShopifyテーマは口コミと広告だけで売れていました。Sorankのおかげで、SEOの組み立て方と上位表示される記事の書き方がようやくわかりました。監査で商品ページが遅すぎることも判明しました。2か月でオーガニックトラフィックは2倍になり、ShopifyテーマについてChatGPTで検索されたときの回答にも表示され始めています。しかも、週に約2時間の作業だけです。”
 Thème FullStackgo.themefullstack.com“Sorankのおかげで、私たちのSEOエージェンシーの働き方は大きく変わりました。すべてが一元化・自動化されたため、クライアント1社あたりにかける時間が大幅に減りました。以前は何時間もかかっていた作業が今では数分で終わり、ようやくビジネスの中で働くのではなく、ビジネスそのものに取り組めるようになりました。”
 Océane Bondismaison-leverage.com