La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Merci ! Vos choix ont bien été enregistrés.
Oups ! Une erreur s'est produite lors de l'envoi du formulaire.
Erreurs d'exploration : comment les trouver, les prioriser et corriger chaque type
Corrigez les erreurs d'exploration : DNS, serveur, robots.txt, 404, soft 404 et redirections. La réaction de Googlebot à chacune et une méthode en 6 étapes.
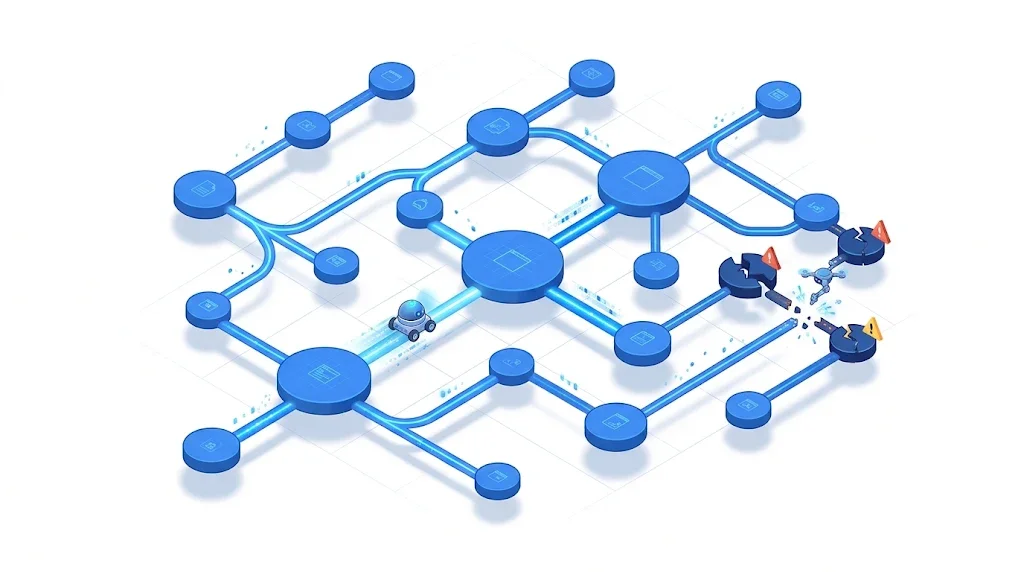
Un plan de site où quelques pages sont signalées en erreur pendant qu'un robot d'exploration suit les liens entre elles.
Outils
Sur cette page
En bref
les erreurs d'exploration sont les requêtes qu'un moteur de recherche ou un robot d'IA envoie à votre site et qui échouent : le serveur ne répond pas à temps, le DNS ne répond pas, le fichier robots.txt est inaccessible, une redirection tourne en boucle ou une page renvoie un code 4xx ou 5xx. Les erreurs au niveau du site (DNS, serveur, robots.txt) peuvent empêcher Google d'explorer tout votre site : corrigez-les en premier. Les erreurs au niveau de l'URL (404, soft 404, erreurs de redirection) ne comptent que si elles touchent des pages que vous voulez voir indexées. Vous les trouvez dans les rapports Statistiques sur l'exploration et Indexation des pages de la Search Console, vous les confirmez avec un crawler et vos journaux serveur, puis vous corrigez la cause et vous validez.
Qui doit corriger la partie technique de votre site ?
Question 1 sur 425%
Notre conseil pour vous
Vérifiez vous-même avec les outils gratuits de Google
Search Console liste les pages que Google n'arrive pas à lire, et PageSpeed Insights teste la vitesse. Beaucoup de petits problèmes se règlent dans les paramètres de votre outil de création de site.
Notre conseil pour vous
Un développeur web
Votre problème est dans le code ou le serveur : un développeur qui connaît le SEO est la bonne personne. Donnez-lui la liste des erreurs de Search Console.
Notre conseil pour vous
Un outil d'audit technique
Votre site a beaucoup de pages : un robot d'exploration les lit toutes comme Google et donne la liste complète des erreurs à corriger, page par page.
Notre conseil pour vous
Un audit automatique, puis du contenu
Votre site fonctionne mais attire peu de visiteurs : la technique est rarement en cause. Sorank audite le site, puis rédige les pages qui amènent du trafic.
Ce que sont les erreurs d'exploration, et ce qu'elles ne sont pas
Un robot d'exploration se comporte comme un visiteur très patient. Il demande une URL à votre serveur, attend la réponse, lit le code d'état et le contenu, puis passe aux liens qu'il a trouvés. Une erreur d'exploration, c'est n'importe quelle étape de cette chaîne qui échoue. Le visiteur ne reçoit jamais de page exploitable.
Cette définition compte, car beaucoup de rapports mélangent erreurs d'exploration et décisions d'indexation. « Explorée, actuellement non indexée » n'est pas une erreur d'exploration : Google a bien récupéré la page et a choisi de ne pas la garder. « Exclue par la balise noindex » n'en est pas une non plus : c'est vous qui avez demandé à Google de retirer la page. Une erreur d'exploration signifie que la récupération elle-même s'est mal passée.
Les deux familles : erreurs de site et erreurs d'URL
Google sépare les problèmes en deux niveaux, et vous devriez faire de même.
Erreurs de site (Google parle de problèmes d'état de l'hôte) : échecs de résolution DNS, échecs de connexion au serveur et échecs de récupération du robots.txt. Elles touchent toutes les URL de l'hôte. Une mauvaise journée à ce niveau peut geler l'exploration de tout le site.
Erreurs d'URL : une page renvoie 404, 410, 401, 403, 5xx, une soft 404 ou une redirection cassée. Elles ne touchent que cette URL, et beaucoup sont sans gravité.
Erreurs de site et erreurs d'URL
Erreurs de site (à corriger aujourd'hui)
Le DNS ne se résout pas
Le serveur expire ou coupe la connexion
Le robots.txt renvoie 5xx ou 429
Visibles dans Statistiques sur l'exploration, État de l'hôte
Peuvent suspendre l'exploration de toutes les pages
Erreurs d'URL (à trier)
404, 410, soft 404
401, 403, autres 4xx
Boucle de redirection ou chaîne trop longue
Visibles dans le rapport Indexation des pages
Ne comptent que sur les pages à indexer
Pourquoi cette distinction change vos priorités
Une boutique avec 4000 anciennes URL de produits en 404 peut être en parfaite santé si ces produits ont disparu pour de bon. La même boutique avec un robots.txt qui renvoie 503 pendant six heures vit une vraie urgence, même si toutes ses fiches produits fonctionnent. Commencez par l'hôte, puis les URL qui rapportent de l'argent, puis le reste.
Comment Googlebot réagit à chaque échec
Pour bien corriger les erreurs d'exploration, il faut savoir ce que Google fait vraiment quand il en rencontre une. La documentation de Google sur l'effet des codes d'état HTTP et des erreurs réseau sur la recherche Google (Google Search Central) donne les règles. Voici ce qu'elles signifient en pratique.
Les codes d'état, famille par famille
Réponse
Ce que fait Google
Est-ce un problème ?
2xx
Transmet le contenu à l'indexation. L'indexation n'est pas garantie.
Non, sauf si la page est vide (soft 404).
301, 308
Signal fort que la cible est la nouvelle URL.
Non, s'il s'agit d'un seul saut vers une page 200.
302, 303, 307
Signal faible : l'URL d'origine reste souvent la canonique.
Oui, si le déplacement est définitif.
Chaînes de 3xx
Suit jusqu'à 10 sauts par défaut, puis abandonne.
Oui : chaque saut gaspille une requête, et les boucles ne se résolvent jamais.
404, 410, autres 4xx (sauf 429)
Considère que le contenu n'existe pas, retire peu à peu les URL indexées et les explore moins souvent.
Seulement si la page devrait exister.
401, 403
Comme les autres 4xx. Ils ne ralentissent pas l'exploration.
Oui, s'ils bloquent Googlebot sur des pages publiques.
429
Traité comme un signal de surcharge du serveur, comme un 5xx.
Oui : l'exploration ralentit.
5xx
Ralentit l'exploration en proportion des erreurs. Les URL qui échouent durablement sont retirées de l'index.
Oui, toujours.
Deux détails piègent beaucoup d'équipes. D'abord, 401 et 403 ne réduisent pas la vitesse d'exploration. Si votre serveur souffre, renvoyer 403 à Googlebot n'aide pas ; Google demande de renvoyer temporairement 503 ou 429. Ensuite, une 404 n'est pas une pénalité. C'est la bonne réponse pour une page qui n'existe plus.
Les échecs du robots.txt sont les plus dangereux
La documentation du rapport Statistiques sur l'exploration (aide de la Search Console) explique la règle. Un robots.txt qui répond 200 (même vide) ou 403, 404 ou 410 (pas de fichier) ne pose aucun problème. Un robots.txt qui répond 429 ou 5xx est un échec, et Google joue alors la prudence.
Ce que fait Google quand le robots.txt échoue durablement
12 premières heuresGoogle arrête complètement d'explorer le site.
Jusqu'à 30 joursGoogle utilise le dernier robots.txt récupéré avec succès.
Après 30 joursLe comportement dépend de l'accessibilité de la page d'accueil.
Source : aide de la Google Search Console, rapport Statistiques sur l'exploration
Une règle de CDN ou un pare-feu qui sert un 503 sur /robots.txt peut donc geler tout votre site pendant une demi-journée, même si toutes les autres URL fonctionnent. Vérifiez ce fichier en premier dans toute enquête sur les erreurs d'exploration. Notre guide sur le statut « Bloquée par le fichier robots.txt » traite le problème inverse, quand le fichier fonctionne mais bloque trop.
Les limites d'exploration de Google à retenir
10sauts de redirection suivis au maximum par les robots de Google
12 hd'arrêt de l'exploration quand le robots.txt renvoie 5xx ou 429
30 jourspendant lesquels Google garde le dernier robots.txt valide
5%d'échecs DNS par jour, cité en exemple de problème d'hôte
Sources : Google Search Central, codes d'état HTTP et erreurs réseau ; aide de la Search Console, rapport Statistiques sur l'exploration
Les erreurs d'exploration sont les points où le parcours d'un robot dans votre site se casse.
Chaque type d'erreur d'exploration, expliqué avec sa correction
Voici la liste complète des erreurs que vous croiserez dans la Search Console et dans les crawlers, avec la cause et la correction de chacune. Les noms suivent la documentation du rapport Indexation des pages (aide de la Search Console).
Erreurs DNS
Google n'a pas pu transformer votre nom de domaine en adresse IP, ou le serveur DNS n'a pas répondu. Causes fréquentes : un domaine expiré, une panne du fournisseur DNS, un enregistrement erroné après une migration ou une mauvaise configuration DNSSEC. Vérifiez avec une requête lancée depuis l'extérieur de votre réseau :
Correction : rectifiez les enregistrements, baissez le TTL avant toute migration et choisissez un fournisseur DNS redondant. Si example.com et www.example.com existent tous les deux, les deux doivent se résoudre, même si l'un ne fait que rediriger.
Erreurs de connexion au serveur et 5xx
Le serveur n'a pas répondu à temps, a fermé la connexion, ou a répondu 500, 502, 503 ou 504. Causes typiques : une base de données surchargée, un processus PHP ou Node qui plante sous la charge, un délai dépassé sur le proxy inverse, une mise à jour d'extension ou un pare-feu qui limite les robots. Regardez la répartition dans le temps : des erreurs à la même heure chaque nuit pointent souvent vers une sauvegarde ou une tâche planifiée.
Correction : lisez le journal d'erreurs du serveur aux heures indiquées par Google, augmentez les délais ou le nombre de processus, mettez en cache les pages lourdes et vérifiez que votre protection anti-robots laisse passer le vrai Googlebot. Pour une maintenance prévue, renvoyez un 503 avec un en-tête Retry-After plutôt qu'une page 200 qui annonce « bientôt de retour » :
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 et 410 (introuvable)
La page n'existe pas. C'est normal quand elle a été supprimée volontairement et que plus rien ne pointe vers elle. C'est un problème quand l'URL a encore des backlinks, du trafic ou des liens internes, ou quand la page devrait exister et qu'un déploiement l'a cassée.
Correction : si le contenu a déménagé, ajoutez une seule 301 vers l'équivalent le plus proche. S'il a disparu pour de bon, gardez la 404 ou passez en 410, et retirez les liens internes et les entrées du sitemap qui pointent vers lui. Ne redirigez jamais toutes les 404 vers la page d'accueil : Google les traite souvent comme des soft 404.
Soft 404
Le serveur répond 200 mais la page semble vide ou affiche « introuvable » : une catégorie vide, une page de recherche sans résultat, un produit en rupture sans contenu. Google dépense une requête et ne récupère rien. Nous traitons ce cas en détail dans notre guide sur les erreurs soft 404.
401, 403 et autres 4xx
Googlebot n'envoie jamais d'identifiants, donc un 401 ou un 403 sur une page publique signifie que votre serveur ou une couche de sécurité le bloque. Coupables habituels : un mot de passe de préproduction oublié en production, une règle de pare-feu applicatif, un blocage par pays ou une protection anti-hotlink appliquée au HTML. Corrigez la règle, pas le symptôme, et testez avec l'outil Inspection de l'URL de la Search Console.
Erreurs de redirection
Google signale une erreur de redirection quand il tombe sur une boucle, une chaîne trop longue, une URL qui dépasse la longueur maximale ou une URL invalide ou vide dans la chaîne. Le cas classique après une migration : http vers https, puis vers www, puis vers une barre oblique finale, puis vers un nouveau chemin. Quatre sauts là où un seul suffirait. Notre guide complet sur les redirections SEO explique comment les regrouper.
Astuce
Collez n'importe quelle URL suspecte dans le vérificateur de redirections gratuit de Sorank : il suit toute la chaîne, affiche chaque saut et son code d'état, et vous montre où se trouve la boucle ou le saut en trop.
Délais dépassés, réponses tronquées et pages trop lourdes
Certaines erreurs n'affichent jamais de code d'état. La page commence à charger puis s'arrête, ou elle est si lourde que le robot n'en lit qu'une partie. Les robots de Google lisent un nombre limité d'octets par fichier : une page gonflée de scripts en ligne ou d'images en base64 peut perdre le contenu du bas. Vérifiez les gabarits lourds avec le vérificateur de poids de page.
Toutes les méthodes pour trouver les erreurs d'exploration, comparées
Aucun outil ne montre à lui seul toutes les erreurs d'exploration. Chaque méthode voit le problème sous un angle différent, et un audit sérieux en combine au moins deux.
Méthode 1 : la Search Console, rapport Statistiques sur l'exploration
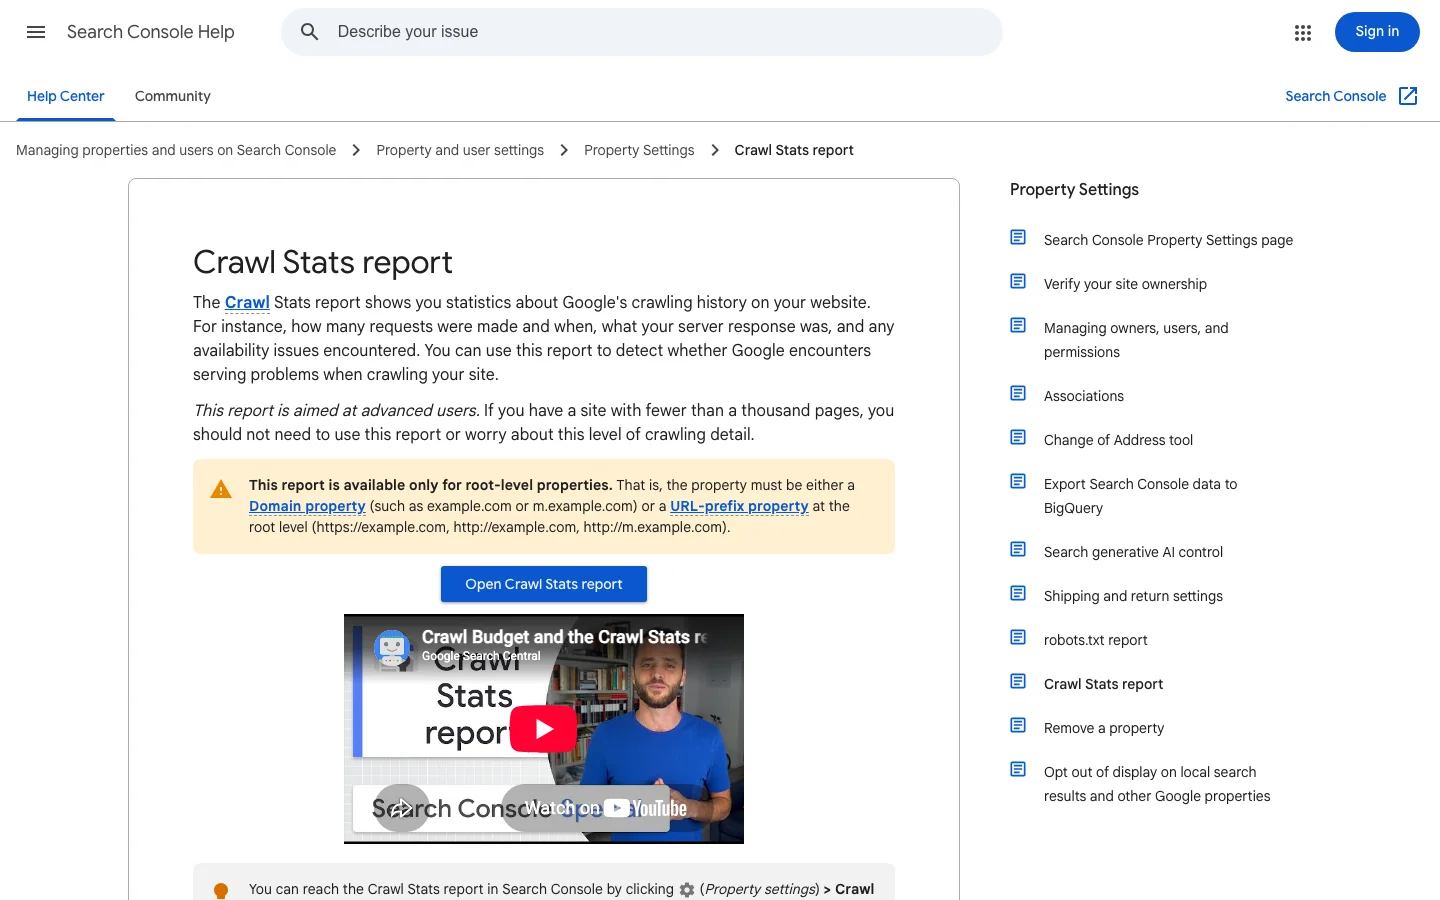
Principe : Google montre ses propres requêtes d'exploration des 90 derniers jours, regroupées par réponse, type de fichier, objectif et type de Googlebot, ainsi que l'état de l'hôte pour le DNS, le serveur et le robots.txt. Quand l'utiliser : toujours, et en premier, pour les erreurs de site. Avantages : c'est la vérité donnée par Google lui-même. Limites : réservé aux propriétés de niveau racine, exemples échantillonnés, et Google précise que les sites de moins de mille pages en ont rarement besoin. Exemple : un pic de réponses « délai de la page dépassé » chaque dimanche à 3 h, qui correspond à une sauvegarde de la base de données.
La documentation de Google sur le rapport Statistiques sur l'exploration, qui explique l'état de l'hôte pour le DNS, le serveur et le robots.txt.
Méthode 2 : la Search Console, rapport Indexation des pages et Inspection de l'URL
Principe : liste les URL que Google connaît et la raison pour laquelle elles ne sont pas indexées : Erreur de serveur (5xx), Erreur de redirection, Introuvable (404) ou Soft 404. Quand l'utiliser : pour trier les erreurs d'URL et valider les corrections. Avantages : lié aux pages que Google a réellement tentées. Limites : les rapports ont plusieurs jours de retard, les listes d'exemples sont plafonnées, et le rapport mélange erreurs d'exploration et choix d'indexation. Exemple : 300 URL en « Erreur de redirection » qui partagent toutes l'ancien préfixe /blog/.
Méthode 3 : un crawler de bureau ou en ligne
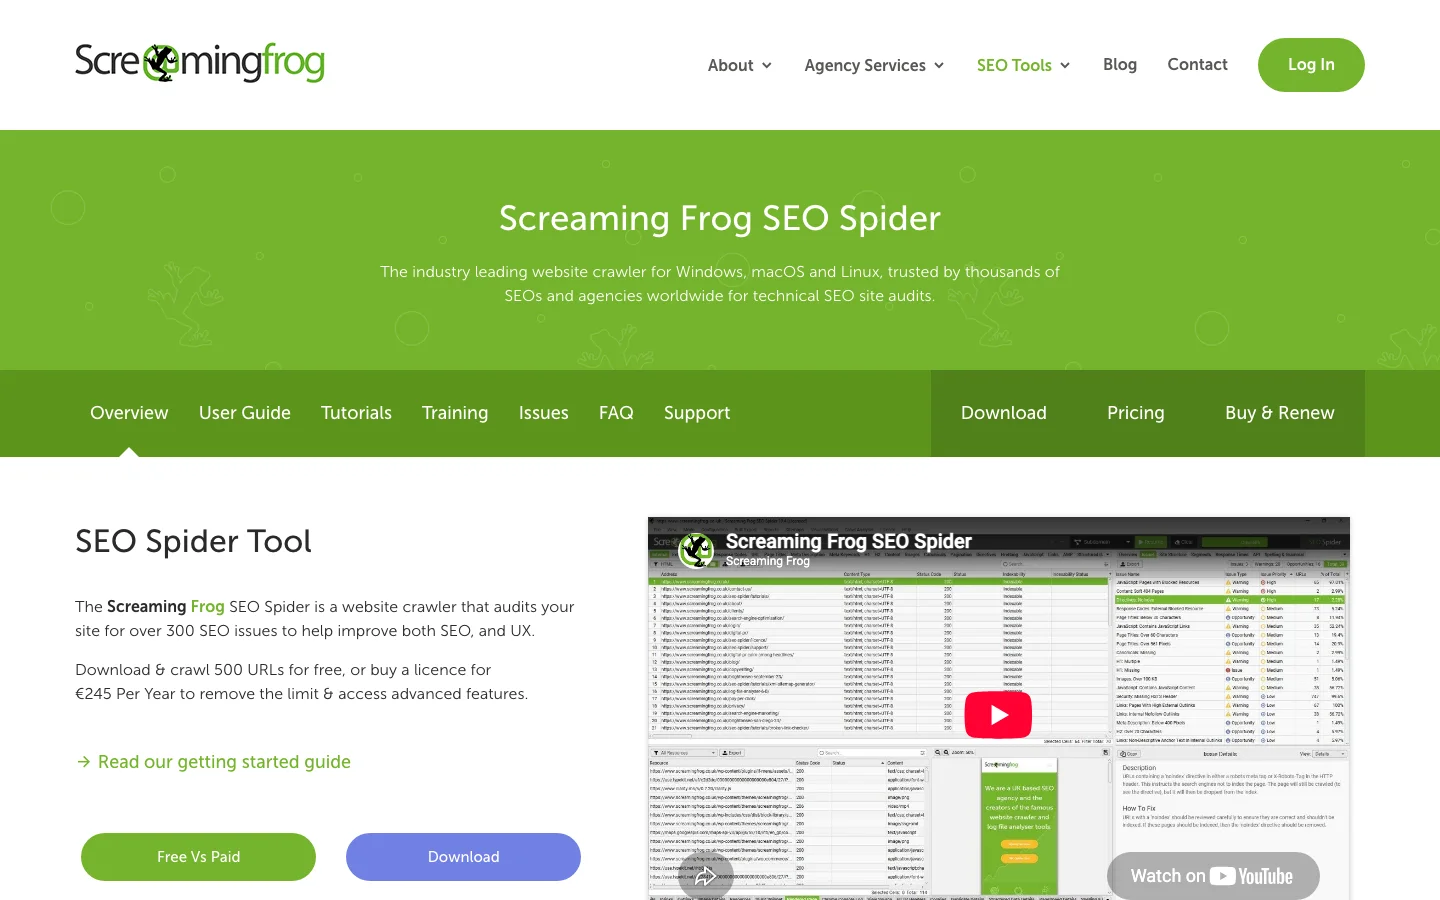
Principe : un outil comme Screaming Frog explore votre site comme le ferait un robot, en suivant les liens depuis la page d'accueil, et note chaque code d'état, chaque chaîne de redirection et chaque lien cassé. Quand l'utiliser : avant et après une migration, une refonte ou un gros déploiement, et chaque mois sur les gros sites. Avantages : immédiat, complet pour les pages liées, montre où se trouve chaque lien cassé. Limites : il ne sait pas ce que Google a vraiment demandé, il rate les pages orphelines, et votre serveur peut le traiter autrement que Googlebot. Notre guide de configuration de Screaming Frog détaille un audit complet.
Screaming Frog SEO Spider explore votre site comme un robot et liste chaque code d'état, chaîne de redirection et lien cassé.
Méthode 4 : l'analyse des journaux serveur
Principe : vos journaux d'accès enregistrent chaque requête, y compris celles de Googlebot, Bingbot, GPTBot, ClaudeBot et PerplexityBot, avec le code d'état exact et le temps de réponse. Quand l'utiliser : sur les gros sites, après une baisse de trafic inexpliquée, et pour voir ce que visitent les robots d'IA. Avantages : de vraies requêtes, de vrais codes, aucun échantillonnage, tous les robots. Limites : il faut accéder aux journaux et savoir écrire quelques scripts ; il faut aussi vérifier que « Googlebot » est bien Google. Notre guide sur l'analyse de logs pour le SEO avance pas à pas. Un premier coup d'œil rapide :
# Requêtes Googlebot qui n'ont pas renvoyé 200, 301 ou 304, les plus fréquentes d'abord
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Méthode 5 : les contrôles ponctuels sur une URL
Principe : tester une URL à la fois avec curl ou un vérificateur en ligne gratuit. Quand l'utiliser : pour confirmer une correction, ou vérifier une page clé après un déploiement. Avantages : instantané et précis. Limites : ne passe pas à l'échelle. Utilisez l'agent utilisateur de Googlebot pour repérer les règles qui traitent les robots différemment :
Erreurs 5xx : lisez le code de statut pour trouver la couche défaillante
Un statut 5xx signifie que le serveur n'a pas pu traiter une requête pourtant valide. Google ralentit l'exploration en réaction, et il la ralentit davantage quand un nombre plus élevé de vos URL renvoient des erreurs. Google conserve un certain temps les URL déjà indexées, mais il retire celles qui renvoient durablement une erreur serveur. Une courte rafale est récupérable : Google augmente à nouveau progressivement le rythme d'exploration dès que votre serveur répond avec des codes 2xx. C'est une longue série d'erreurs qui abîme votre index.
Le code indique quelle couche a cassé
Chaque code 5xx pointe vers une partie différente de la pile technique. Le tableau vous donne un premier endroit où regarder pour chacun.
Code
Ce que cela signifie en général
À regarder en premier
500
L'application a échoué pendant le traitement de la requête
Le journal d'erreurs de l'application à l'heure exacte de la requête
502
Le proxy ou le CDN a reçu une réponse invalide de l'application, souvent parce qu'elle a planté ou redémarré
Les redémarrages et la disponibilité du processus applicatif
503
Le service est surchargé, limité en débit ou en maintenance
Les graphiques de charge, l'historique des déploiements et les fenêtres de maintenance
504
Le proxy a abandonné l'attente de l'application
Les requêtes de base de données lentes et les délais d'expiration du proxy
429
Un limiteur de débit signale trop de requêtes
Les règles de limitation, et leur application ou non à Googlebot vérifié
Faites correspondre les horodatages de Google avec vos journaux
Le rapport Statistiques sur l'exploration montre les jours et les heures où Google a rencontré des erreurs (notre guide sur les statistiques d'exploration explique chaque graphique). Votre journal serveur montre ce qui s'est passé à ces instants précis. Filtrez les requêtes de Googlebot et comptez les réponses 5xx par heure :
Chaque ligne du résultat correspond à une heure, un code de statut et un nombre. Un groupe d'erreurs à la même heure chaque nuit indique en général une sauvegarde, une tâche planifiée ou un import programmé. Des erreurs réparties sur toute la journée pointent plutôt vers une charge excessive : la solution est alors la capacité ou le cache, et non un bug isolé. Pour une méthode plus poussée, consultez notre guide d'analyse des fichiers journaux.
Mesurez ce que coûte un 5xx avant de paniquer
Google réduit l'exploration en proportion du nombre d'URL qui renvoient une erreur. Un modèle défectueux qui touche quelques URL coûte peu de temps d'exploration. Une panne de base de données qui casse toutes les pages coûte beaucoup, et c'est celle qu'il faut corriger en premier.
Un 429 a le même effet qu'un 5xx, car Google le lit comme un serveur surchargé. Si votre limiteur de débit ou votre protection anti-robots renvoie un 429 à Googlebot, vous le payez en temps d'exploration. La documentation de Google ne mentionne pas l'en-tête Retry-After. Continuez de l'envoyer aux visiteurs humains et aux clients d'API, mais ne comptez pas sur Googlebot pour attendre le délai que vous avez indiqué.
Erreurs 4xx : trouvez d'où elles viennent avant de les corriger
Un statut 4xx signifie que le serveur a refusé la requête à cause de quelque chose côté client : l'URL n'existe pas, l'accès est interdit ou l'adresse est mal formée. Google traite tous les 4xx de la même façon, sauf le 429. Il cesse d'utiliser le contenu derrière cette URL et retire l'URL de l'index si elle y figurait. Avant de toucher à un 4xx, cherchez d'où vient la requête, car la correction se trouve souvent à un seul endroit : un lien, un modèle ou une règle de redirection.
Trouvez la source de chaque 4xx dans vos journaux
Votre journal d'accès enregistre le referrer de chaque requête, c'est-à-dire la page qui a envoyé le visiteur ou le robot vers cette URL. Comptez les réponses 4xx par chemin et par referrer :
Lisez la colonne du referrer (la page d'où vient la requête) de cette façon :
Un referrer de votre propre domaine signifie qu'une de vos pages renvoie vers une URL morte. Corrigez le lien ou le modèle qui la produit. C'est la correction la plus utile, car vous la maîtrisez. Notre guide sur la correction des liens cassés détaille la méthode complète.
Un referrer d'un autre site signifie qu'un lien entrant pointe vers une URL qui ne fonctionne plus. Si ce lien vaut la peine d'être gardé, ajoutez une seule 301 vers la page active la plus proche. Sinon, laissez le 404 en place.
Un referrer vide, ou un chemin que vous n'avez jamais publié, comme une page de connexion sur un site statique, indique en général qu'un robot ou un scanner a essayé l'adresse. Laissez-le renvoyer 404 et n'y passez pas de temps.
Repérez les pics de 4xx juste après chaque mise en production
Une mise en production qui renomme une route, modifie un slug ou reconstruit un modèle provoque souvent une vague de 404 le même jour. Exportez le nombre de réponses 4xx par jour pour la semaine précédant le déploiement et pour la semaine suivante. Une hausse concentrée dans un seul dossier désigne directement le changement. Ajoutez la redirection de l'ancienne URL vers la nouvelle dans la même mise en production, et non dans un ticket ultérieur. Pour un changement de structure complet, consultez notre checklist de migration SEO.
Astuce
Ne remplacez pas une page manquante par une réponse 200 qui affiche un court message ou une liste vide. Google peut la traiter comme une soft 404, ce qui coûte un crawl complet sans rien rapporter.
Pas à pas : corriger les erreurs d'exploration dans le bon ordre
C'est la méthode que nous appliquons. Elle va des erreurs qui peuvent arrêter tout votre site à celles qui ne font que gaspiller un peu d'exploration.
La méthode en 6 étapes contre les erreurs d'exploration
Vérifier l'état de l'hôteOuvrez Statistiques sur l'exploration et regardez le DNS, la connexion au serveur et le robots.txt sur 90 jours.
Exporter et regrouper les erreurs d'URLExportez chaque motif du rapport Indexation des pages et regroupez les URL par dossier ou par gabarit.
Trier par valeurGardez les URL qui ont du trafic, des backlinks, des liens internes ou une entrée dans le sitemap.
Corriger la cause au niveau du gabaritUne règle, une table de redirections ou un réglage serveur corrige des centaines d'URL.
Nettoyer les signauxMettez à jour liens internes et sitemaps pour qu'ils pointent vers les URL finales en 200.
Valider et surveillerCliquez sur Valider la correction, puis suivez les statistiques et vos journaux chaque semaine.
Étape 1 : vérifier l'hôte en premier
Dans la Search Console, ouvrez Paramètres, puis Statistiques sur l'exploration, puis État de l'hôte. Le vert signifie aucun problème important en 90 jours. « Problème récent » signifie un problème important la semaine dernière : laissez tout le reste de côté. Cliquez sur chaque catégorie pour voir le taux d'échec par jour, puis comparez les mauvais jours avec l'historique de votre hébergeur, de votre CDN et de vos déploiements.
Étape 2 : exporter et regrouper par motif
Ouvrez Indexation, puis Pages, et exportez chaque motif d'erreur. Ne corrigez pas les URL une par une. Placez-les dans un tableur et extrayez le premier dossier :
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
Un tableau croisé sur cette colonne montre en général que la plupart des erreurs viennent de deux ou trois gabarits : une ancienne catégorie de blog, un paramètre de filtre, un vieux flux de produits.
Étape 3 : trier par valeur business
Pour chaque motif, posez quatre questions. Reçoit-il des clics organiques ? A-t-il des backlinks ? Est-il lié en interne ? Est-il dans le sitemap ? Une 404 qui ne coche aucune case peut attendre indéfiniment. Une 404 avec des backlinks mérite une 301 aujourd'hui. Le vérificateur de liens cassés gratuit montre quelles pages de votre site pointent encore vers des URL mortes.
Étape 4 : corriger la cause profonde
Corrigez des règles, pas des URL. Une table de redirections dans la configuration du serveur vaut mieux que 400 redirections ajoutées à la main dans une extension. Par exemple, avec nginx :
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Pour les 5xx, corrigez la capacité ou le bug. Pour les 401 et 403, corrigez la règle de sécurité. Pour les soft 404, ajoutez du vrai contenu ou renvoyez une vraie 404.
Étape 5 : nettoyer les liens internes et les sitemaps
Chaque lien interne doit pointer directement vers une URL qui répond 200. Chaque entrée de sitemap doit être une URL canonique, indexable et en 200. Un sitemap rempli de redirections et de 404 apprend à Google à lui faire moins confiance. Notre guide sur la création d'un sitemap explique ce qu'il doit contenir.
Étape 6 : valider et surveiller
Dans le rapport Indexation des pages, ouvrez le motif corrigé et cliquez sur Valider la correction. Google vérifie d'abord un échantillon, puis le reste ; cela prend en général jusqu'à deux semaines environ, et la validation s'arrête si une seule URL échoue encore. Ne recliquez pas pendant qu'elle tourne. Mettez ensuite en place une routine hebdomadaire : Statistiques sur l'exploration pour l'hôte, journaux pour les pics, un crawl après chaque déploiement.
Une chaîne de redirections avant et après la correction
Avant
http://site.com/page
301 vers https://site.com/page
301 vers https://www.site.com/page
301 vers https://www.site.com/page/
Les liens internes pointent encore vers la première URL
Après
Une seule 301 directe vers https://www.site.com/page/
Liens internes mis à jour vers l'URL finale
Le sitemap ne contient que l'URL finale
Une requête au lieu de quatre
Erreurs courantes : comment les repérer et les corriger
Erreur 1 : rediriger toutes les 404 vers la page d'accueil
Ce que c'est : une extension ou une règle qui envoie toute URL manquante vers /. Comment la repérer : beaucoup d'URL en « Soft 404 » ou « Page avec redirection » qui atterrissent toutes sur la page d'accueil ; un crawler affiche des centaines de 301 vers la même cible. Comment la corriger : redirigez seulement vers un équivalent proche, et laissez le reste en 404 ou 410.
Erreur 2 : bloquer Googlebot avec des outils de sécurité
Ce que c'est : un pare-feu applicatif, un gestionnaire de robots ou un limiteur de débit qui sert à Google un 403, un 429 ou une page de vérification. Comment la repérer : des 403 ou 429 dans les statistiques d'exploration alors que la page s'affiche bien dans votre navigateur ; les journaux montrent les blocages par IP. Comment la corriger : autorisez le vrai Googlebot, vérifié par DNS inverse ou par les plages d'IP publiées par Google, au lieu de vous fier à l'agent utilisateur.
Erreur 3 : un robots.txt fragile
Ce que c'est : un robots.txt généré par l'application, qui tombe donc chaque fois qu'elle tombe, ou servi par une règle de CDN qui met un 5xx en cache. Comment la repérer : la catégorie récupération du robots.txt dans État de l'hôte n'est pas verte. Comment la corriger : servez-le comme un fichier statique, hors de l'application, et testez-le avec le vérificateur de robots.txt.
Erreur 4 : des pages de maintenance qui répondent 200
Ce que c'est : une page « Nous revenons bientôt » servie avec un code 200 sur toutes les URL. Comment la repérer : après la maintenance, une vague de soft 404 ou de titres en double. Comment la corriger : renvoyez un 503 avec Retry-After pendant la maintenance, et gardez-la courte.
Erreur 5 : utiliser le 403 pour ralentir Google
Ce que c'est : répondre 403 à Googlebot quand le serveur est surchargé. Comment la repérer : des pics de 403 qui coïncident avec les pics de charge. Comment la corriger : Google indique que les codes 4xx autres que 429 n'ont aucun effet sur la vitesse d'exploration. Renvoyez 503 ou 429 pendant peu de temps, et corrigez la capacité.
Erreur 6 : corriger les erreurs une par une
Ce que c'est : parcourir la liste de la Search Console et modifier chaque URL. Comment la repérer : le même motif revient tous les mois. Comment la corriger : regroupez par motif, corrigez le gabarit ou la règle, puis validez une seule fois.
Erreur 7 : paniquer devant des 404 sans gravité
Ce que c'est : passer des jours sur des 404 d'URL de spam ou de pages supprimées depuis longtemps et sans liens. Comment la repérer : les URL n'ont ni clics, ni backlinks, ni liens internes. Comment la corriger : laissez-les. Google indique qu'une 404 pour une page supprimée n'est pas forcément un problème.
Attention
Ne bloquez jamais une URL dans le robots.txt pour « cacher » une erreur d'exploration. Google ne voit plus la 404 ni la redirection, l'URL peut rester indexée, et vous perdez le signal que vous vouliez envoyer.
Erreurs d'exploration et budget d'exploration
Sur un site de quelques centaines de pages, Google a le temps de tout voir, et les erreurs d'exploration comptent surtout pour les pages qu'elles cassent. Sur les gros sites (boutiques avec filtres, places de marché, médias), chaque requête ratée ou gaspillée prend du temps à vos vraies pages. C'est l'idée du budget d'exploration.
Comment les erreurs mangent la capacité d'exploration
Les 5xx et 429 font ralentir Google sur tout l'hôte : quelques gabarits cassés peuvent donc retarder l'exploration de vos nouvelles fiches produits. Les chaînes de redirections coûtent une requête par saut. Les soft 404 coûtent une récupération complète et ne rapportent rien. Corrigez ces trois-là et le même budget couvre davantage de pages utiles.
Le lien avec « Détectée, actuellement non indexée »
Quand Google trouve des URL mais reporte leur exploration, la cause est souvent un serveur qu'il juge fragile. Si vous voyez le nombre de pages « Détectée, actuellement non indexée » grimper en même temps que des erreurs serveur dans les statistiques d'exploration, corrigez d'abord le serveur. Les deux rapports racontent la même histoire.
Les erreurs d'exploration des robots d'IA
Googlebot n'est plus le seul visiteur qui compte. GPTBot, OAI-SearchBot, ClaudeBot et PerplexityBot récupèrent des pages pour entraîner des modèles ou pour répondre à des questions en temps réel. Ils frappent le même serveur et souffrent des mêmes erreurs, à une différence près : vous n'avez pas de Search Console pour eux.
Ce qui change avec les robots d'IA
La plupart des robots d'IA n'exécutent pas le JavaScript : une page qui ne construit son contenu que dans le navigateur peut leur sembler vide, une sorte de soft 404 que vous ne verrez jamais dans les rapports de Google. Beaucoup sont bloqués par défaut par les services de protection anti-robots, souvent avec un 403. Et comme ils récupèrent les pages à la demande quand un utilisateur pose une question, un délai dépassé à ce moment-là signifie que la réponse cite quelqu'un d'autre. Notre guide sur le SEO JavaScript traite le rendu pour les moteurs comme pour les robots d'IA.
Comment les surveiller
Vos journaux serveur sont la seule source fiable. Filtrez par agent utilisateur et regardez les codes d'état :
Si les robots d'IA reçoivent des 403 que vous n'avez pas voulus, corrigez la règle. Vérifiez ensuite s'ils vous citent vraiment : le suivi des mentions IA de Sorank mesure la fréquence à laquelle ChatGPT, Gemini, Claude et Perplexity citent votre marque, pour voir si une correction d'exploration change quelque chose.
Votre checklist de santé d'exploration
Passez cette liste après chaque migration, refonte ou gros déploiement, et une fois par mois sur les gros sites.
Checklist de santé d'exploration
État de l'hôte au vert pour le DNS, la connexion au serveur et le robots.txt
Robots.txt servi comme fichier statique et qui répond 200
Aucun pic de 5xx ou de 429 dans les statistiques ou les journaux
Le vrai Googlebot et les robots d'IA souhaités ne sont pas bloqués par le pare-feu
Chaque redirection fait un seul saut, en 301 ou 308, vers une page 200
Les liens internes pointent vers les URL finales en 200
Les sitemaps ne listent que des URL canoniques, indexables et en 200
Les 404 avec backlinks ou trafic redirigées vers un équivalent proche
Les pages vides corrigées ou renvoyant une vraie 404
La maintenance renvoie un 503 avec Retry-After
Validation de la correction lancée pour chaque motif corrigé
Ce que vous pouvez faire aujourd'hui
Ouvrez Statistiques sur l'exploration et vérifiez les trois lignes d'état de l'hôte. Lancez ensuite le vérificateur d'indexabilité gratuit sur vos cinq pages les plus précieuses. Si tout est propre, exportez les erreurs du rapport Indexation des pages et regroupez-les par dossier : vous avez maintenant une courte liste de corrections classées au lieu d'un rapport effrayant.
Une fois l'exploration propre, la limite suivante, c'est le contenu lui-même. L'optimisation de contenu de Sorank réécrit et rafraîchit vos pages existantes en autopilote, pour que les pages que Google atteint désormais méritent d'être indexées et citées. Pour les pages que Google a explorées mais laissées de côté, lisez notre guide sur « Explorée, actuellement non indexée ».
Questions fréquentes
Que sont les erreurs d'exploration en SEO ?
Les erreurs d'exploration sont des requêtes d'un moteur de recherche ou d'un robot d'IA qui échouent : le DNS ne se résout pas, le serveur expire ou renvoie un 5xx, le robots.txt est inaccessible, une redirection boucle ou une page renvoie un code 4xx. Les erreurs de site peuvent suspendre l'exploration de tout le site, alors que les erreurs d'URL ne touchent que la page concernée.
Les erreurs 404 sont-elles mauvaises pour le SEO ?
Pas en elles-mêmes. Google indique qu'une 404 pour une page supprimée sans remplacement n'est pas forcément un problème. Elle le devient quand l'URL a encore des backlinks, du trafic ou des liens internes : une seule 301 vers un équivalent proche est alors la bonne correction.
Combien de temps faut-il à Google pour voir que les erreurs d'exploration sont corrigées ?
Après un clic sur Valider la correction dans le rapport Indexation des pages de la Search Console, la validation prend en général jusqu'à deux semaines environ. Google vérifie d'abord un échantillon d'URL, puis le reste, et s'arrête si une seule URL concernée échoue encore.
y!
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
Dominiqueflight-sensations-idf.comLoisirs et aviation
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne