La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Merci ! Vos choix ont bien été enregistrés.
Oups ! Une erreur s'est produite lors de l'envoi du formulaire.
Illustration bleue et blanche d'un bot qui envoie des requêtes vers un site, avec les codes de réponse marqués sur le trajet.
Outils
Sur cette page
En bref
Le rapport Statistiques sur l'exploration, dans la Search Console de Google, montre comment Googlebot demande vos URL : combien de requêtes il envoie, combien d'octets il télécharge, à quelle vitesse votre serveur répond et quels codes de statut il reçoit. Lisez d'abord l'état de l'hôte, puis les codes de réponse, puis les répartitions par objectif et par type de fichier. Le rapport est un résumé, pas un journal : utilisez-le pour repérer le problème, puis confirmez-le dans les journaux de votre serveur.
Qui doit corriger la partie technique de votre site ?
Question 1 sur 425%
Notre conseil pour vous
Vérifiez vous-même avec les outils gratuits de Google
Search Console liste les pages que Google n'arrive pas à lire, et PageSpeed Insights teste la vitesse. Beaucoup de petits problèmes se règlent dans les paramètres de votre outil de création de site.
Notre conseil pour vous
Un développeur web
Votre problème est dans le code ou le serveur : un développeur qui connaît le SEO est la bonne personne. Donnez-lui la liste des erreurs de Search Console.
Notre conseil pour vous
Un outil d'audit technique
Votre site a beaucoup de pages : un robot d'exploration les lit toutes comme Google et donne la liste complète des erreurs à corriger, page par page.
Notre conseil pour vous
Un audit automatique, puis du contenu
Votre site fonctionne mais attire peu de visiteurs : la technique est rarement en cause. Sorank audite le site, puis rédige les pages qui amènent du trafic.
Ce qu'est le rapport Statistiques sur l'exploration, et qui doit l'ouvrir
Statistiques sur l'exploration est une vue côté Google de l'activité de Googlebot sur votre site. Il vous dit ce que Googlebot a fait, pas pourquoi vos pages sont bien ou mal classées. Google décrit ce rapport comme destiné aux utilisateurs avancés, et un site de moins de mille pages n'en a peut-être pas besoin du tout. Si vous gérez un petit site vitrine, vous pouvez l'ignorer tant que rien ne change.
La page publique de la Search Console de Google, point de départ des outils d'exploration et d'indexation.
La Search Console regroupe de nombreux rapports. Sa page publique couvre l'exploration et l'indexation en général : sitemaps, Inspection d'URL, couverture de l'index. Statistiques sur l'exploration se trouve dans Paramètres et non dans le menu principal, ce qui explique que beaucoup de gens ne l'ouvrent jamais.
Seules les propriétés de niveau racine ont ce rapport
Le rapport n'est disponible que pour les propriétés de niveau racine : une propriété Domaine, ou une propriété Préfixe d'URL construite sur la racine du site. Une propriété pour un sous-dossier, comme example.com/blog/, ne l'a pas. Les données ne couvrent que le domaine sélectionné. Les requêtes vers des sous-domaines frères n'apparaissent pas dans le rapport d'un autre sous-domaine, mais une vue du domaine parent inclut tous ses sous-domaines. Http et https sont comptés dans la même vue.
Note
Si votre site utilise des sous-domaines par langue, comme en.example.com et de.example.com, ouvrez chacun séparément. Chacun a ses propres données, et un sous-domaine allemand cassé n'apparaît pas dans la vue anglaise.
Qui doit l'utiliser
Ouvrez le rapport quand l'une de ces situations est vraie : vous publiez beaucoup de pages, vous avez changé la structure de vos URL ou d'hébergement, Googlebot semble passer moins souvent qu'avant, ou des pages sont découvertes mais jamais indexées. Un site qui ajoute quelques articles par mois n'y apprend presque rien, sauf des erreurs, et ces erreurs se trouvent mieux avec une exploration classique du site.
Ouvrir le rapport et lire chaque graphique
Ouvrez votre propriété, allez dans Paramètres, trouvez Statistiques sur l'exploration et cliquez sur Ouvrir le rapport. En haut, vous avez trois graphiques : le total des requêtes d'exploration, le volume total téléchargé et le temps de réponse moyen. En dessous, vous avez l'état de l'hôte et quatre répartitions : réponses d'exploration, type de fichier, objectif de l'exploration et type de Googlebot. Chaque répartition est un pourcentage basé sur le nombre de requêtes.
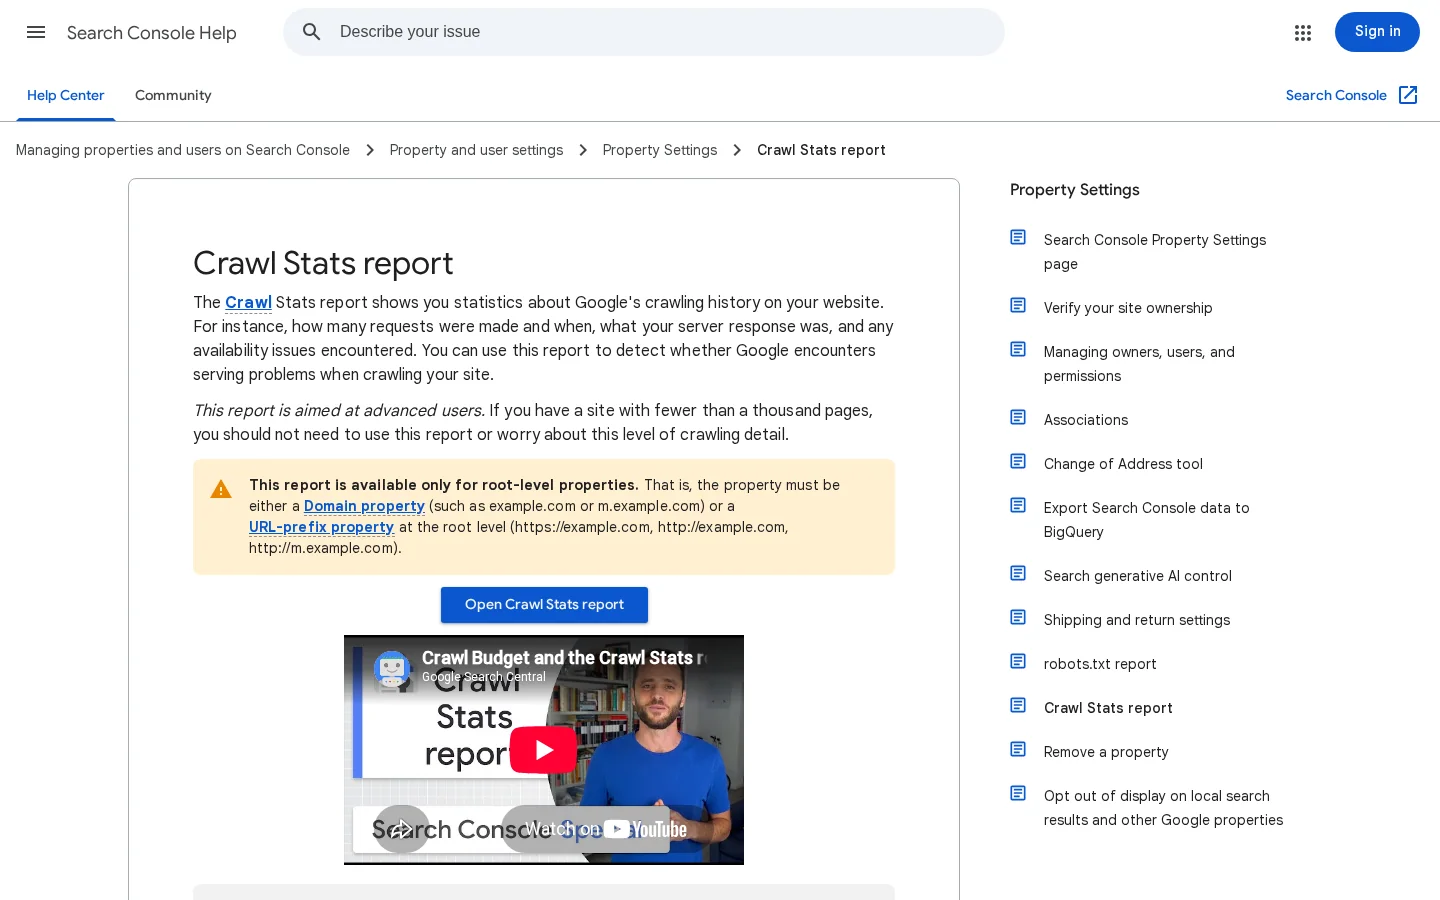
La page d'aide de Google pour le rapport Statistiques sur l'exploration.
Voici ce que compte chaque partie et comment la lire.
Partie du rapport
Ce qu'elle compte
Comment la lire
Total des requêtes d'exploration
Toutes les requêtes pour vos URL, réussies ou non, y compris les échecs DNS, les échecs de connexion et les boucles de redirection. Les tentatives bloquées par robots.txt sont comptées aussi.
Une chute ou une hausse brutale : vérifiez les modifications de robots.txt et de votre structure d'URL aux mêmes dates.
Volume total téléchargé
Les octets téléchargés pendant l'exploration. Une ressource en cache n'est comptée qu'à sa première requête.
Des octets qui augmentent alors que les requêtes restent stables signifient que vos pages sont devenues plus lourdes.
Temps de réponse moyen
Le temps moyen pour récupérer chaque ressource, chaque ressource liée étant comptée séparément.
Regardez la tendance, pas une valeur isolée. Surveillez-la après chaque mise en production.
État de l'hôte
La récupération de robots.txt, la résolution DNS et la connectivité du serveur. Vert signifie aucun problème important au cours des 90 derniers jours, jaune signifie des problèmes datant de plus d'une semaine, rouge signifie des problèmes de la dernière semaine.
Tout élément rouge ou jaune est d'abord un problème de serveur ou de réseau, avant d'être un problème de SEO.
Réponses d'exploration
La part des réponses par type, basée sur le nombre de requêtes.
Suivez dans le temps la part des mauvaises réponses. Le nombre brut compte moins.
Type de fichier
La part des réponses par type : HTML, image, JavaScript, CSS, PDF, JSON, vidéo. Basée sur le nombre de réponses, pas sur les octets.
Montre où Googlebot dépense ses requêtes. Une forte part de JavaScript et de CSS signifie que vos pages dépendent de nombreuses ressources.
Objectif de l'exploration
Découverte (une URL que Google n'avait jamais explorée) ou actualisation (une nouvelle exploration d'une URL connue).
Voir la section sur la découverte et l'actualisation ci-dessous.
Type de Googlebot
Smartphone, Ordinateur, Image, Vidéo, Chargement des ressources de page, AdsBot, StoreBot, autres.
Sur un site indexé en mobile first, Smartphone doit être le groupe le plus important. Un changement brutal mérite une vérification.
Les pourcentages comptent des requêtes, pas des URL
Chaque répartition compte des requêtes. Une URL que Googlebot récupère 50 fois compte 50 fois. Donc « 40 % des réponses sont des 301 » indique combien de requêtes tombent sur une redirection, pas combien d'URL redirigent. Pour savoir quelles URL sont concernées, il faut vos journaux. Les URL d'exemple affichées par Google sont un échantillon, et Google indique qu'elles ne sont pas exhaustives.
Ce que le rapport ne montre pas
La page d'aide de Google indique que le rapport couvre aujourd'hui la plupart des requêtes d'exploration, mais que certaines peuvent ne pas être comptées. Elle précise aussi que les requêtes en échec qui n'atteignent jamais votre serveur n'apparaissent pas dans vos journaux. C'est pourquoi le rapport montre des échecs DNS et de connexion que vos journaux ne peuvent pas montrer, et pourquoi il faut lire les deux sources. Google ne communique pas de durée de conservation pour les graphiques : si vous voulez un historique, gardez chaque mois votre propre copie, avec une capture d'écran ou une note des chiffres.
Chaque requête de Googlebot part de Google vers vos pages, et chaque réponse est enregistrée.
Lire les codes de réponse, étape par étape
La répartition des réponses est la partie du rapport qui mène le plus souvent à une correction. Lisez-la dans cet ordre, et arrêtez-vous à la première étape qui montre un vrai problème.
Trier les réponses d'exploration en cinq étapes
Vérifiez l'état de l'hôteRouge ou jaune sur robots.txt, DNS ou connectivité signifie que Googlebot n'a pas pu atteindre votre site du tout. Réglez ce point avant tout le reste.
Regardez les mauvaises réponses5XX, autres 4XX, robots.txt indisponible, délais d'attente et erreurs de redirection. Notez leur part et si elle varie d'une semaine à l'autre.
Vérifiez la part des redirectionsBeaucoup de réponses 301 et 302 signifient que Googlebot dépense ses requêtes sur des étapes intermédiaires au lieu de pages.
Confirmez les 404Une 404 est normale si la page a été supprimée volontairement. C'est un problème si vos liens internes ou votre sitemap pointent encore vers elle.
Extrayez les URL de vos journauxTransformez chaque catégorie d'erreur en liste d'URL, puis corrigez la source des liens, pas le rapport.
Bonnes, peut-être bonnes et mauvaises réponses
Google classe les réponses en trois groupes. Ce classement est un premier filtre, pas un verdict sur chaque URL.
Bonnes : 200, 301, 302, 304 et actualisation par meta refresh.
Peut-être bonnes : 404.
Mauvaises : robots.txt indisponible, 401 et 407, 5XX, autres 4XX, erreurs DNS, erreurs de récupération, délais d'attente et erreurs de redirection.
Une 401 compte comme mauvaise dans le rapport, mais elle est correcte si la page se trouve derrière une connexion qui doit rester fermée. Décidez URL par URL. Le rapport vous indique quel groupe examiner, et c'est à vous de décider ce que chaque réponse doit être.
Les redirections : le coût que vous ne voyez pas
Une 302 compte comme bonne réponse, donc une part de redirections peut paraître saine alors qu'elle gaspille encore de l'exploration. Dans une analyse d'un grand site, publiée en avril 2021 sur Search Engine Journal par Tomek Rudzki d'Onely, 16 % des requêtes allaient vers des pages redirigées, et l'auteur conseillait de vérifier chaque saut de redirection.
Voici comment une chaîne nuit. Supposons que /blog/seo-tips redirige vers /blog/seo-tips-2025, qui redirige vers /blog/seo-tips-guide. Googlebot a besoin de trois requêtes pour atteindre le contenu, et chaque lien interne qui pointe encore vers la première URL répète ce coût. Dirigez la première URL directement vers l'adresse finale, et mettez à jour les liens internes pour qu'ils n'utilisent plus les anciens chemins. Le vérificateur de redirections gratuit suit la chaîne de n'importe quelle URL saut par saut, pour que vous voyiez le parcours avant de le corriger. Si vous n'êtes pas sûr qu'une redirection doit être permanente, lisez notre guide sur les redirections 301 et 302 : une 301 signifie que le déplacement est permanent, une 302 qu'il est temporaire.
Astuce
Triez vos URL de redirection selon la fréquence à laquelle Googlebot les demande dans vos journaux. Corrigez d'abord les cinq chaînes les plus demandées. Elles représentent en général l'essentiel de la part de redirections.
5XX et 429 : le signal qui réduit le rythme d'exploration
Le guide de Google pour les grands sites indique que lorsqu'un site répond par des erreurs serveur (5XX) ou des signaux de limitation de débit comme le HTTP 429, Google réduit sa limite de débit d'exploration. Un pic de 5XX vous coûte donc plus que les URL cassées. Il peut aussi ralentir l'exploration de vos pages saines. Le budget d'exploration d'un site dépend en partie de la qualité des réponses du serveur, et les 5XX réduisent cette part.
Quand vous voyez un pic de 5XX, regardez à quelle heure il se produit. Des erreurs à la même heure chaque jour pointent vers une sauvegarde, un import programmé ou un pic de trafic. Des erreurs juste après une mise en production pointent vers cette mise en production. Des erreurs réparties sur toute la journée pointent vers un manque de capacité. Chaque schéma a une correction différente, et aucune ne se règle en modifiant une seule page.
Découverte, actualisation et type de fichier : ce que disent les ratios
La répartition par objectif d'exploration sépare les requêtes en découverte, quand Google voit une URL pour la première fois, et en actualisation, quand il réexplore une URL déjà connue. Le ratio entre les deux indique ce à quoi Google consacre son temps.
Une part élevée de découverte sur un site qui ajoute peu de pages signifie que Google continue de trouver de nouvelles URL. Cherchez les générateurs d'URL : paramètres de filtre et de tri, pages de résultats de recherche interne, archives de calendrier, identifiants de session. Chacun crée des URL qui paraissent nouvelles.
Une part élevée d'actualisation sur des pages qui ne changent jamais signifie que Google continue de les revisiter. Vérifiez si ces pages renvoient 304 Not Modified. Google indique qu'un 304 pour une page inchangée lui dit de réutiliser la copie qu'il a. Si les mêmes pages renvoient à chaque visite un 200 avec tous les octets, votre serveur envoie la page entière à chaque passage.
Un grand site, une journée d'exploration
7460pages explorées par jour en moyenne
35 %de ces explorations étaient des explorations de découverte, pour des URL que Google n'avait jamais récupérées
Source : Tomek Rudzki (Onely), Search Engine Journal, avril 2021. Un site d'environ 1 million de pages, avec un arriéré d'URL « Détectée, actuellement non indexée ».
La même analyse proposait une vérification rapide et utile. À ce rythme, elle estimait que l'arriéré prendrait environ un an à être exploré. Ce chiffre est le calcul d'un seul auteur, sur un seul site, et les captures datent de 2021 : ne le recopiez pas. La méthode reste valable sur vos propres données : divisez le nombre d'URL en attente de découverte par le nombre d'explorations de découverte par jour dans votre rapport. Si le résultat se compte en mois, vous avez un problème d'exploration à régler avant de publier davantage.
La répartition par type de fichier compte des réponses, pas des octets. Elle montre donc combien de requêtes vont vers chaque type de ressource, pas leur poids. Les redirections entrent dans « Autre type de fichier », et les requêtes échouées apparaissent comme « Inconnu (échec) ». Une part croissante d'« Inconnu (échec) » est un signal d'échec, pas un type de fichier : traitez-la avec les mauvaises réponses.
Statistiques sur l'exploration, journaux serveur et Inspection d'URL : trois regards sur Googlebot
Il existe trois façons de voir ce qu'a fait Googlebot sur votre site : le rapport Statistiques sur l'exploration, vos journaux serveur et l'outil Inspection d'URL de la Search Console. Chacun répond à une question différente, et chacun a des angles morts que les deux autres couvrent. Pour un vrai problème, utilisez les trois.
Le rapport Statistiques sur l'exploration
Principe : un résumé des requêtes de Googlebot pour une propriété entière, calculé par Google. Quand l'utiliser : pour les tendances, l'état de l'hôte et la première vue d'ensemble d'un problème. Avantages : il est gratuit, il couvre les échecs qui n'atteignent jamais votre serveur, et il ajoute l'objectif et le type de Googlebot, que les journaux ne donnent pas directement. Limites : c'est un résumé, certaines requêtes peuvent ne pas être comptées, et les URL d'exemple sont un échantillon. Exemple : la part de 5XX monte pendant trois jours sur un hôte. Le rapport vous indique les jours et l'hôte, vos journaux vous donnent les URL et les heures.
Journaux serveur
Principe : l'enregistrement brut que votre serveur web écrit pour chaque requête reçue. Quand l'utiliser : pour obtenir des listes d'URL exactes, les codes de statut par heure et les preuves derrière une tendance du rapport. Avantages : complets pour chaque requête arrivée à votre serveur, avec l'URL exacte et le code de statut. Limites : ils ne contiennent pas les requêtes échouées avant d'atteindre le serveur, la chaîne user agent peut être falsifiée, et la plupart des serveurs font tourner ou suppriment leurs journaux après une certaine durée. Voici une commande qui compte les codes de statut des requêtes identifiées comme Googlebot dans un journal au format combiné :
La commande repère la chaîne user agent, puis compte le code de statut, qui est le neuvième champ du format combiné. Si votre serveur écrit dans un autre format, changez le numéro du champ. Le résultat est un tableau de comptages par code de statut, le plus fréquent en premier.
Attention
N'importe qui peut envoyer une requête qui se dit Googlebot. Avant d'agir sur un pic suspect, vérifiez que les adresses IP appartiennent bien à Google. Google documente une vérification DNS inverse pour cela, et elle vaut la peine d'être faite avant de bloquer ou de rediriger quoi que ce soit en se fondant sur le user agent.
L'outil Inspection d'URL
Principe : une vérification d'une seule URL, qui montre quand Google l'a récupérée pour la dernière fois, ce qu'il a reçu et si elle est indexée. Quand l'utiliser : pour confirmer une correction, par exemple savoir si Google a récupéré une page corrigée après votre modification. Avantages : rapide, exact et facile à lire pour une URL. Limites : une URL à la fois, il ne peut donc pas montrer un schéma à l'échelle du site. Dans l'analyse citée plus haut, l'outil a montré qu'une page de catégorie principale n'avait pas été explorée depuis trois mois, et l'auteur s'en est servi à la place des journaux pour cette page.
Rapport Statistiques sur l'exploration contre journaux serveur
Rapport Statistiques sur l'exploration
Compte les échecs DNS et de connexion
Montre l'état de l'hôte et le type de Googlebot
Présente des URL d'exemple, pas toutes
Certaines requêtes peuvent ne pas être comptées
Journaux serveur
Chaque requête arrivée à votre serveur
URL exacte et code de statut pour chaque requête
Manquent les échecs DNS et de connexion
Le user agent peut être falsifié
Méthode
Question à laquelle elle répond
Périmètre
Angle mort
Rapport Statistiques sur l'exploration
Googlebot est-il en bonne santé, et comment se comporte-t-il dans l'ensemble ?
La propriété entière, résumée
URL d'exemple échantillonnées, et certaines requêtes peuvent ne pas être comptées
Journaux serveur
Quelles URL exactes ont reçu quelle réponse, et quand ?
Chaque requête arrivée à votre serveur
Échecs DNS et de connexion, et user agents qui peuvent être falsifiés
Inspection d'URL
Quand Google a-t-il récupéré cette page pour la dernière fois, et qu'a-t-il reçu ?
Une seule URL
Ne dit rien du reste du site
Un bilan mensuel, étape par étape
Un seul mois de données apprend peu de choses. Le rapport devient utile quand vous le comparez à votre situation habituelle : gardez un court historique et faites le point le même jour chaque mois. C'est la routine qui fonctionne pour la plupart des sites.
Le bilan mensuel en six étapes
Sauvegardez le moisCapture d'écran ou note des trois graphiques, de l'état de l'hôte et de la répartition des réponses.
Comparez avec votre référenceUne hausse des requêtes totales peut être normale après un gros mois de publication. Une nouvelle part de 5XX mérite toujours un regard.
Vérifiez dans l'ordreL'état de l'hôte d'abord, puis les mauvaises réponses, puis la part des redirections.
Extrayez les URLPour chaque catégorie d'erreur, prenez les principales URL de vos journaux sur la même période.
Corrigez la sourceLes liens internes, les règles de redirection, la capacité du serveur ou la règle de robots.txt. Pas le graphique.
Notez la modificationInscrivez la date de chaque correction, et lisez le mois suivant en gardant cette date en tête.
Signaux qui méritent une action ce mois-ci
L'état de l'hôte est jaune ou rouge sur l'un des trois contrôles
La part de 5XX monte pendant plusieurs jours de suite, ou pic à la même heure
Les réponses de redirection augmentent après une modification du site qui devait les supprimer
La part de découverte reste élevée sur un site qui publie peu
Une seule mauvaise journée sans changement dans les journaux : c'est du bruit tant que le phénomène ne se répète pas
Avant et après une migration
Supposons que vous déplaciez votre blog de /old-blog/ vers /blog/ avec des redirections 301. Juste après le déplacement, attendez-vous à une hausse de la part des redirections, car Googlebot demande encore les anciens chemins. Dans les semaines suivantes, la part doit baisser à mesure que Google apprend les nouvelles URL. Attendez-vous aussi à une hausse de la part de découverte, puisque les nouvelles URL sont nouvelles pour Google. Si la part de redirections reste élevée après plusieurs semaines, cherchez les chaînes, les anciens liens internes ou les redirections que vous avez oubliées. Notre guide sur la correction des liens cassés couvre le volet liens de ce même nettoyage.
Erreurs courantes, et comment les éviter
La plupart des erreurs viennent de la lecture d'un graphique comme un verdict. Chacune des cinq ci-dessous a un signe clair dans le rapport, et une correction que vous pouvez vérifier dans vos journaux.
Lire le total des requêtes d'exploration comme une note
Ce que c'est : supposer que plus de requêtes d'exploration signifie un meilleur SEO. Comment la repérer : les requêtes montent fortement après une mise en production qui a ajouté des options de filtre ou de tri, et les nouvelles URL portent des paramètres. Comment la corriger : vérifiez la part de découverte et les schémas d'URL dans vos journaux. Corrigez le générateur d'URL : arrêtez de faire des liens vers les URL avec paramètres, ou canonicalisez et bloquez celles qui n'ont aucune valeur pour la recherche. Un plus grand nombre de requêtes inutiles est un coût, pas un gain.
Faire confiance au temps de réponse moyen
Ce que c'est : regarder la moyenne et manquer les pics qu'elle cache. Comment la repérer : la moyenne paraît stable, mais vos journaux montrent des réponses lentes à la même heure chaque nuit. Comment la corriger : regroupez vos journaux par heure et par URL, puis comparez les heures lentes avec vos sauvegardes, imports et mises en production. Corrigez le traitement ou le modèle lent, puis vérifiez à nouveau la moyenne. La moyenne est une ligne de tendance, et une ligne de tendance ne vous dit pas où commence la lenteur.
Ignorer l'état de l'hôte alors que vos pages s'affichent bien
Ce que c'est : supposer que le site est en bonne santé parce qu'il s'ouvre dans votre navigateur. Comment la repérer : l'état de l'hôte affiche jaune ou rouge pour robots.txt, DNS ou connectivité, alors que vos pages fonctionnent pour vous. Googlebot passe par d'autres chemins réseau, et un pare-feu, une règle de CDN ou un enregistrement DNS peut le bloquer sans toucher à votre navigateur. Comment la corriger : vérifiez que votre fichier robots.txt se charge avec une réponse 200, à l'aide du vérificateur robots.txt, puis examinez vos règles de pare-feu et de CDN aux dates où l'état est passé au rouge.
Bloquer l'exploration, puis lire la baisse comme un progrès
Ce que c'est : une modification de robots.txt qui réduit les requêtes d'exploration, suivie d'un rapport qui paraît plus calme. Comment la repérer : les requêtes totales chutent fortement le jour d'une modification de robots.txt. Comment la corriger : une baisse peut être normale si vous avez bloqué des chemins inutiles, mais vérifiez que vos sections importantes sont toujours explorées. Regardez les journaux pour les sections qui comptent. Si une page dont vous avez besoin est bloquée, notre guide sur le statut bloqué par robots.txt explique comment trouver la règle et quoi modifier.
Confondre exploration et indexation
Ce que c'est : considérer qu'une page bien explorée est une page indexée. Comment la repérer : Googlebot demande une URL régulièrement, mais cette URL n'apparaît pas dans les résultats de Google. Un grand nombre d'explorations ne prouve pas que Google conserve la page. Comment la corriger : passez du rapport Statistiques sur l'exploration aux rapports d'indexation des pages et vérifiez le statut de l'URL. Notre guide sur explorée, actuellement non indexée explique les causes, et le guide sur l'indexation Google détaille les vérifications dans l'ordre.
Erreur
Comment la repérer
Comment la corriger
Total des requêtes lu comme une note
Requêtes en hausse après l'apparition de paramètres d'URL
Arrêter de générer les URL inutiles, puis recompter
Temps de réponse moyen seul
Heures lentes masquées par une moyenne stable
Regrouper les journaux par heure, relier les heures lentes aux tâches
État de l'hôte ignoré
Jaune ou rouge alors que les pages s'ouvrent dans un navigateur
Vérifier robots.txt, DNS, pare-feu et règles de CDN
Baisse de l'exploration lue comme un progrès
Requêtes en chute le jour d'une modification de robots.txt
Confirmer que les sections importantes sont toujours explorées
Exploration confondue avec indexation
Explorations régulières, URL absente des résultats
Vérifier le statut d'indexation de l'URL
Où se situe Sorank, et quoi faire ensuite
Le tableau de bord GEO / SEO de Sorank place vos clics, impressions, CTR et positions de la Search Console à côté des visites que les assistants IA vous envoient, lues dans Google Analytics. Il n'affiche pas les requêtes de Googlebot : gardez donc le rapport Statistiques sur l'exploration pour ce rôle. Les deux outils répondent à des questions différentes : le tableau de bord vous dit ce que Google vous envoie, et Statistiques sur l'exploration vous dit comment Google visite votre serveur.
Astuce
Avant de passer du temps dans vos journaux sur une seule page, vérifiez si Google peut l'indexer avec le vérificateur d'indexabilité gratuit. Il répond à cette première question en quelques secondes.
Le rapport Statistiques sur l'exploration est un bon premier écran. Il vous indique quel type de problème soupçonner et à quelles dates. La correction se trouve presque toujours dans une liste d'URL, et cette liste est dans vos journaux. Commencez par le rapport, puis passez aux URL.
Questions fréquentes
Où se trouve le rapport Statistiques sur l'exploration dans la Search Console ?
Ouvrez votre propriété, allez dans Paramètres, choisissez Statistiques sur l'exploration, puis cliquez sur Ouvrir le rapport. Le rapport n'existe que pour les propriétés Domaine et les propriétés Préfixe d'URL de niveau racine, donc une propriété de sous-dossier ne l'affichera pas.
Un grand nombre de requêtes d'exploration est-il un bon signe ?
Pas à lui seul. Le total compte chaque requête, y compris les échecs et les tentatives bloquées par robots.txt, il indique donc combien Googlebot vient, pas si ces visites sont saines. Lisez-le avec les codes de réponse et le temps de réponse moyen.
Puis-je me fier à Statistiques sur l'exploration plutôt qu'aux journaux serveur ?
Pas seul. Google indique que certaines requêtes peuvent ne pas être comptées et que ses URL d'exemple ne sont pas exhaustives. Utilisez le rapport pour les tendances et les catégories d'échec, et vos journaux pour les URL exactes.
y!
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
Dominiqueflight-sensations-idf.comLoisirs et aviation
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne


 Search Console