Confidențialitatea contează pentru noi, așa că ai opțiunea de a dezactiva anumite tipuri de stocare care nu sunt necesare pentru funcționarea de bază a site-ului. Blocarea categoriilor poate afecta experiența ta pe site. Mai multe informații (Politica privind cookie-urile)
Mulțumim! Trimiterea ta a fost primită!
Ups! A apărut o eroare la trimiterea formularului.
Crawl Stats: cum citiți raportul Google Search Console și remediați ce arată
Învățați să citiți fiecare grafic din raportul Crawl Stats din Google Search Console, ce omite față de jurnalele serverului și cum să remediați ce arată.
Ilustrație albastră și albă: cereri ale unor boți ajung la un site web, cu codurile de răspuns marcate pe traseu.
Instrumente
Pe această pagină
Pe scurt
Raportul Crawl Stats din Google Search Console arată cum solicită Googlebot URL-urile dvs.: câte cereri trimite, câți octeți descarcă, cât de repede răspunde serverul dvs. și ce coduri de stare primește. Citiți mai întâi starea gazdei, apoi codurile de răspuns, apoi defalcările pe scop și tip de fișier. Raportul este un rezumat, nu un jurnal, așa că folosiți-l ca să găsiți problema, apoi confirmați-o în jurnalele serverului.
Cine ar trebui să repare partea tehnică a site-ului tău?
Întrebarea 1 din 425%
Recomandarea noastră pentru tine
Verifică singur cu instrumentele gratuite Google
Search Console listează paginile pe care Google nu le poate citi, iar PageSpeed Insights testează viteza. Multe probleme mici se rezolvă din setările constructorului tău de site.
Recomandarea noastră pentru tine
Un dezvoltator web
Problema ta este în cod sau pe server: un dezvoltator care cunoaște SEO este persoana potrivită. Dă-i lista erorilor din Search Console.
Recomandarea noastră pentru tine
Un instrument de audit tehnic
Site-ul tău are multe pagini: un crawler le citește pe toate, așa cum face Google, și oferă o listă completă de erori de corectat, pagină cu pagină.
Recomandarea noastră pentru tine
Un audit automat, apoi conținut
Site-ul tău funcționează, dar aduce puțini vizitatori: problemele tehnice rareori sunt cauza. Sorank auditează site-ul, apoi scrie paginile care aduc trafic.
Ce este raportul Crawl Stats și cine ar trebui să-l deschidă
Crawl Stats este o vedere din partea Google asupra activității Googlebot pe site-ul dvs. Vă spune ce a făcut Googlebot, nu de ce paginile dvs. se clasează sau nu. Google descrie raportul ca fiind destinat utilizatorilor avansați, iar un site cu mai puțin de o mie de pagini s-ar putea să nu aibă nevoie deloc de el. Dacă administrați un site mic de prezentare, îl puteți sări până când se schimbă ceva.
Pagina publică Google Search Console, punctul de plecare pentru instrumentele de crawling și indexare.
Search Console este un produs cu multe rapoarte. Pagina sa publică acoperă crawlingul și indexarea în general: sitemap-uri, Inspecția URL-ului, acoperirea indexului. Crawl Stats se află sub Setări, nu în meniul principal, de aceea mulți oameni nu îl deschid niciodată.
Doar proprietățile de nivel rădăcină primesc raportul
Raportul este disponibil doar pentru proprietățile de nivel rădăcină: o proprietate de tip Domeniu sau o proprietate cu prefix URL construită pe rădăcina site-ului. O proprietate pentru un subfolder, de exemplu example.com/blog/, nu îl primește. Datele acoperă doar domeniul selectat. Cererile către subdomeniile surori nu apar în raportul altui subdomeniu, dar vizualizarea domeniului părinte include toate subdomeniile sale. Atât http, cât și https sunt numărate în aceeași vizualizare.
Notă
Dacă site-ul dvs. folosește subdomenii de limbă precum en.example.com și de.example.com, deschideți fiecare separat. Fiecare are datele sale, iar un subdomeniu german defect nu apare în vizualizarea în engleză.
Cine ar trebui să-l folosească
Deschideți raportul când este adevărată una dintre aceste situații: publicați multe pagini, ați schimbat structura URL-urilor sau găzduirea, Googlebot pare să viziteze mai puțin decât înainte sau paginile sunt descoperite, dar nu sunt indexate niciodată. Un site care adaugă câteva articole pe lună are puțin de învățat din el, în afara erorilor, iar acelea se găsesc mai bine printr-o scanare obișnuită a site-ului.
Deschideți raportul și citiți fiecare grafic
Deschideți proprietatea, mergeți la Setări, găsiți Crawl stats și faceți clic pe Deschide raportul. În partea de sus aveți trei grafice: totalul cererilor de crawling, dimensiunea totală a descărcărilor și timpul mediu de răspuns. Mai jos sunt starea gazdei și patru defalcări: răspunsuri de crawling, tip de fișier, scop de crawling și tip de Googlebot. Fiecare defalcare este un procent bazat pe numărul de cereri.
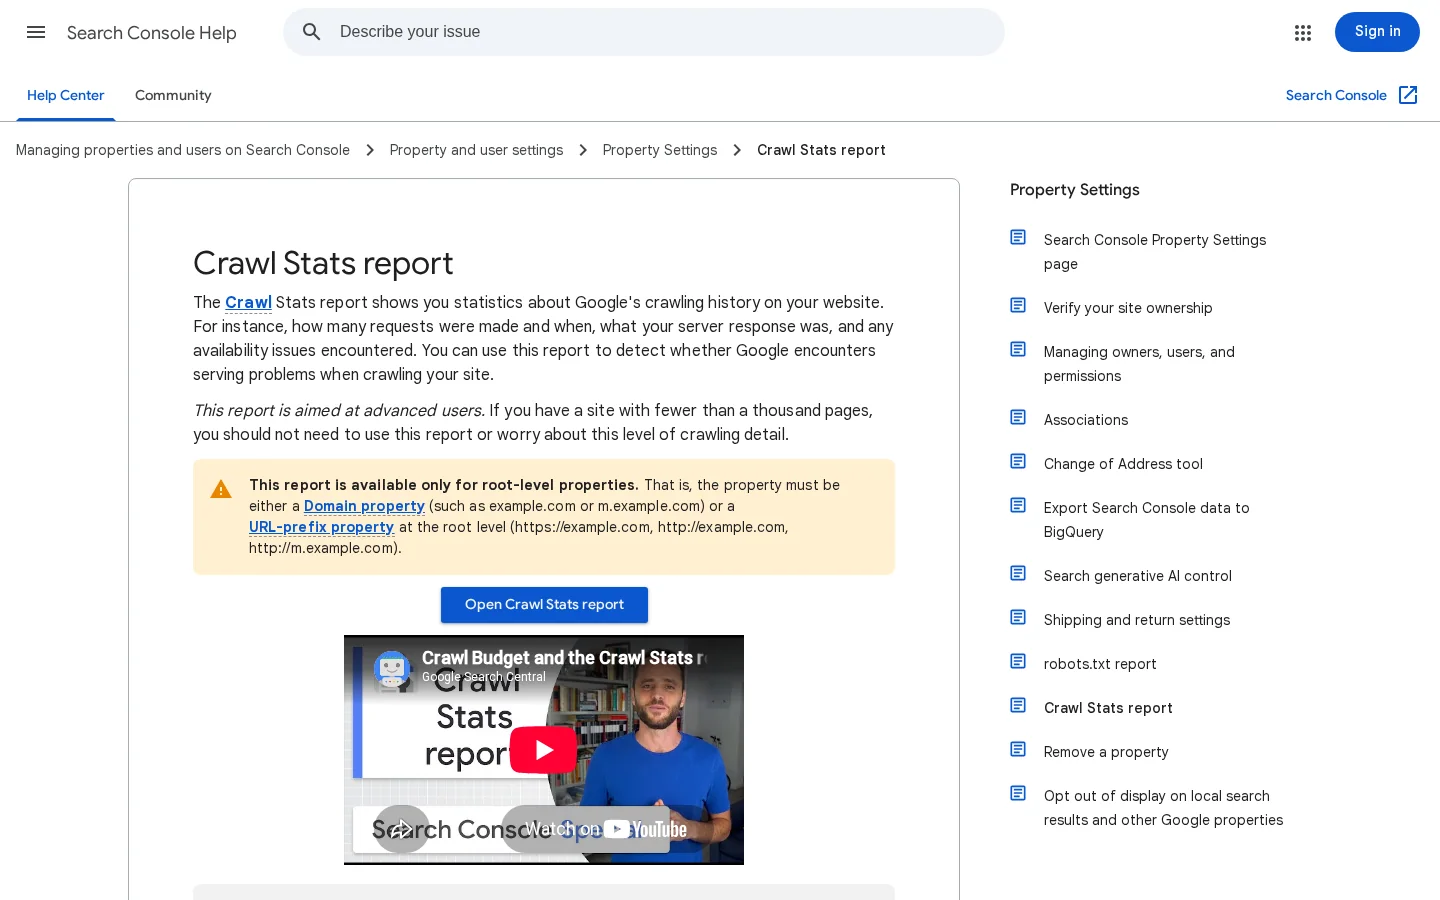
Pagina de ajutor Google pentru raportul Crawl Stats.
Iată ce numără fiecare parte și cum o citiți.
Partea raportului
Ce numără
Cum se citește
Totalul cererilor de crawling
Toate cererile pentru URL-urile dvs., reușite sau nu, inclusiv încercările eșuate de DNS, conexiune și bucle de redirecționare. Sunt numărate și încercările blocate de robots.txt.
O scădere sau o creștere bruscă: verificați modificările din robots.txt și structura URL-urilor pentru aceleași date.
Dimensiunea totală a descărcărilor
Octeții descărcați în timpul crawlingului. O resursă din cache se numără doar la prima cerere.
Octeții care cresc în timp ce cererile rămân constante înseamnă că paginile dvs. s-au îngreunat.
Timpul mediu de răspuns
Timpul mediu de preluare a fiecărei resurse, fiecare resursă legată fiind numărată separat.
Citiți tendința, nu o singură valoare. Urmăriți-o după fiecare implementare.
Starea gazdei
Preluarea robots.txt, rezolvarea DNS și conectivitatea serverului. Verde înseamnă nicio problemă semnificativă în ultimele 90 de zile, galben înseamnă probleme mai vechi de o săptămână, roșu înseamnă probleme din ultima săptămână.
Orice element galben sau roșu este mai întâi o problemă de server sau de rețea, apoi una de SEO.
Răspunsuri de crawling
Ponderea răspunsurilor pe tip, pe baza numărului de cereri.
Urmăriți ponderea răspunsurilor proaste în timp. Numărul brut contează mai puțin.
Tip de fișier
Ponderea răspunsurilor pe tip: HTML, imagine, JavaScript, CSS, PDF, JSON, video. Pe baza numărului de răspunsuri, nu a octeților.
Arată unde își cheltuie Googlebot cererile. Ponderi mari de JavaScript și CSS înseamnă că paginile dvs. depind de multe resurse.
Scop de crawling
Descoperire (un URL pe care Google nu l-a preluat niciodată) sau reîmprospătare (o nouă preluare a unui URL cunoscut).
Vedeți secțiunea despre descoperire și reîmprospătare de mai jos.
Pe un site indexat mobile-first, Smartphone ar trebui să fie cel mai mare grup. O schimbare bruscă merită verificată.
Procentele numără cereri, nu URL-uri
Fiecare defalcare numără cererile. Un URL pe care Googlebot îl preia de 50 de ori se numără de 50 de ori. Deci „40% din răspunsuri sunt 301” vă spune câte cereri au lovit o redirecționare, nu câte URL-uri sunt redirecționate. Pentru a afla ce URL-uri sunt implicate, aveți nevoie de jurnale. Exemplele de URL-uri pe care le arată Google sunt un eșantion, iar Google precizează că nu sunt complete.
Ce nu arată raportul
Pagina de ajutor a Google precizează că raportul acoperă în prezent majoritatea cererilor de crawling, dar unele cereri s-ar putea să nu fie numărate. Ea mai spune că cererile eșuate care nu ajung niciodată la serverul dvs. nu apar în jurnale. De aceea raportul arată erori de DNS și de conexiune pe care jurnalele dvs. nu le pot vedea și de ce ar trebui să citiți ambele surse. Google nu indică o perioadă de păstrare pentru grafice, așa că salvați-vă propria copie în fiecare lună, cu o captură de ecran sau o notă scurtă cu cifrele, dacă vreți istoric.
Fiecare cerere Googlebot pleacă de la Google spre paginile dvs., iar fiecare răspuns este înregistrat.
Citiți codurile de răspuns, pas cu pas
Defalcarea răspunsurilor este partea raportului care duce cel mai des la o remediere. Citiți-o în această ordine și opriți-vă la primul pas care arată o problemă reală.
Triajul răspunsurilor de crawling în cinci pași
Verificați starea gazdeiRoșu sau galben la robots.txt, DNS sau conectivitate înseamnă că Googlebot nu a putut ajunge deloc la site-ul dvs. Remediați asta înainte de orice altceva.
Uitați-vă la răspunsurile proaste5XX, alte 4XX, robots.txt indisponibil, timeout-uri și erori de redirecționare. Notați ponderea lor și dacă se schimbă de la o săptămână la alta.
Verificați ponderea redirecționărilorMulte răspunsuri 301 și 302 înseamnă că Googlebot cheltuie cereri pe salturi, nu pe pagini.
Confirmați erorile 404Un 404 este în regulă dacă pagina a fost eliminată intenționat. Este o problemă dacă linkurile interne sau sitemap-ul încă indică spre ea.
Extrageți URL-urile din jurnaleTransformați fiecare categorie proastă într-o listă de URL-uri, apoi remediați sursa linkurilor, nu raportul.
Răspunsuri bune, probabil bune și proaste
Google împarte răspunsurile în trei grupe. Gruparea este un prim filtru, nu un verdict asupra fiecărui URL.
Bune: 200, 301, 302, 304 și meta refresh.
Probabil bune: 404.
Proaste: robots.txt indisponibil, 401 și 407, 5XX, alte 4XX, erori DNS, erori de preluare, timeout-uri și erori de redirecționare.
Un 401 este numărat ca prost în raport, dar este corect dacă pagina se află în spatele unei autentificări care trebuie să rămână închisă. Decideți URL cu URL. Raportul vă spune ce grupă să priviți, iar voi decideți cum ar trebui să arate fiecare răspuns.
Redirecționările: costul pe care nu-l vedeți
Un 302 este numărat ca răspuns bun, deci ponderea redirecționărilor poate arăta sănătos, deși tot irosește crawlingul. Într-o analiză a unui site mare, publicată în aprilie 2021 pe Search Engine Journal de Tomek Rudzki de la Onely, 16% dintre cereri au ajuns pe pagini redirecționate, iar autorul recomanda verificarea fiecărui salt de redirecționare.
Iată cum face rău un lanț. Să presupunem că /blog/seo-tips redirecționează către /blog/seo-tips-2025, care redirecționează către /blog/seo-tips-guide. Googlebot are nevoie de trei cereri ca să ajungă la conținut, iar fiecare link intern care încă indică primul URL repetă acest cost. Trimiteți primul URL direct la adresa finală și actualizați linkurile interne, ca să nu mai folosească vechile căi. Verificatorul gratuit de redirecționări urmărește lanțul oricărui URL salt cu salt, ca să vedeți drumul înainte de a remedia. Dacă nu sunteți siguri că o redirecționare trebuie să fie permanentă, citiți ghidul nostru despre redirecționările 301 vs 302: 301 înseamnă o mutare permanentă, 302 una temporară.
Sfat
Sortați URL-urile de redirecționare după cât de des le cere Googlebot în jurnalele dvs. Remediați întâi cele cinci lanțuri cele mai solicitate. De obicei ele explică cea mai mare parte din ponderea redirecționărilor.
5XX și 429: semnalul care scade ritmul de crawling
Ghidul Google pentru site-uri mari precizează că atunci când un site răspunde cu erori de server (5XX) sau cu semnale de limitare a ratei, precum HTTP 429, Google își reduce limita ratei de crawling. Deci un vârf de 5XX vă costă mai mult decât URL-urile defecte. Poate încetini și crawlingul paginilor sănătoase. Bugetul de crawling al unui site depinde parțial de cât de bine răspunde serverul, iar răspunsurile 5XX îl micșorează.
Când vedeți un vârf de 5XX, uitați-vă la momentul în care apare. Erorile la aceeași oră în fiecare zi indică o copie de rezervă, un import programat sau un vârf de trafic. Erorile imediat după o lansare indică lansarea. Erorile împrăștiate pe toată ziua indică o problemă de capacitate. Fiecare tipar are o remediere diferită, iar niciunul nu se rezolvă editând o singură pagină.
Descoperire, reîmprospătare și tip de fișier: ce spun proporțiile
Defalcarea pe scop de crawling împarte cererile în descoperire, când Google vede un URL pentru prima dată, și reîmprospătare, când recrawlează un URL pe care îl cunoaște deja. Raportul dintre ele arată pe ce își cheltuie timpul Google.
O pondere mare de descoperire pe un site care adaugă puține pagini înseamnă că Google găsește mereu URL-uri noi. Căutați generatoarele de URL-uri: parametri de filtrare și sortare, pagini de rezultate ale căutării interne, arhive de calendar, ID-uri de sesiune. Fiecare creează URL-uri care par noi.
O pondere mare de reîmprospătare pe pagini care nu se schimbă niciodată înseamnă că Google le revizitează mereu. Verificați dacă aceste pagini returnează 304 Not Modified. Google spune că returnarea unui 304 pentru o pagină neschimbată îi transmite să reutilizeze copia pe care o are. Dacă aceleași pagini returnează mereu 200 cu octeți complecți, serverul dvs. trimite întreaga pagină la fiecare vizită.
Un site mare, o zi de crawling
7460pagini crawlate pe zi, în medie
35%dintre aceste crawlinguri au fost de descoperire, pentru URL-uri pe care Google nu le preluase niciodată
Sursa: Tomek Rudzki (Onely), Search Engine Journal, aprilie 2021. Un site de aproximativ 1 milion de pagini, cu un backlog de URL-uri „Discovered, currently not indexed”.
Aceeași analiză a făcut o verificare grosieră utilă. Din ritmul acela, a estimat că backlog-ul ar dura aproximativ un an să fie crawlat. Acest număr este calculul unui singur autor pentru un singur site, iar capturile de ecran datează din 2021, deci nu-l copiați. Metoda funcționează în continuare pe datele dvs.: împărțiți numărul de URL-uri care așteaptă să fie descoperite la numărul de crawlinguri de descoperire pe zi din raportul dvs. Dacă rezultatul se măsoară în luni, aveți o problemă de crawling de rezolvat înainte de a publica mai mult.
Defalcarea pe tip de fișier numără răspunsuri, nu octeți, deci arată câte cereri merg spre fiecare tip de resursă, nu cât de grele sunt. Redirecționările intră la „Other file type”, iar cererile eșuate apar ca „Unknown (Failed)”. O pondere crescândă de Unknown (Failed) este un semnal de eșec, nu un tip de fișier, și ar trebui tratată împreună cu răspunsurile proaste.
Crawl Stats, jurnalele serverului și Inspecția URL-ului: trei perspective asupra Googlebot
Există trei moduri de a vedea ce a făcut Googlebot pe site-ul dvs.: raportul Crawl Stats, jurnalele serverului și instrumentul Inspecția URL-ului din Search Console. Fiecare răspunde la o altă întrebare și are puncte oarbe pe care le acoperă celelalte două. Pentru o problemă reală, folosiți toate trei.
Raportul Crawl Stats
Principiu: un rezumat al cererilor Googlebot pentru întreaga proprietate, calculat de Google. Când să-l folosiți: pentru tendințe, starea gazdei și prima imagine de ansamblu a unei probleme. Avantaje: este gratuit, acoperă erorile care nu ajung niciodată la serverul dvs. și adaugă scopul și tipul de Googlebot, pe care jurnalele nu le oferă direct. Limite: este un rezumat, unele cereri s-ar putea să nu fie numărate, iar exemplele de URL-uri sunt un eșantion. Exemplu: ponderea 5XX crește timp de trei zile pe o gazdă. Raportul vă arată zilele și gazda, iar jurnalele vă arată URL-urile și orele.
Jurnalele serverului
Principiu: înregistrarea brută pe care serverul dvs. web o scrie pentru fiecare cerere primită. Când să-l folosiți: pentru liste exacte de URL-uri, coduri de stare pe oră și dovada din spatele unei tendințe din raport. Avantaje: complet pentru fiecare cerere care a ajuns la server, cu URL-ul exact și codul de stare. Limite: jurnalele nu conțin cererile care au eșuat înainte de a ajunge la server, user agent-ul poate fi falsificat, iar majoritatea serverelor rotesc sau șterg jurnalele după o perioadă. Iată o comandă care numără codurile de stare ale cererilor identificate ca Googlebot într-un jurnal în format combined:
Comanda potrivește șirul user agent, apoi numără codul de stare, care este al nouălea câmp din formatul combined. Dacă serverul dvs. scrie un alt format, schimbați numărul câmpului. Rezultatul este un tabel de numărători pe cod de stare, cu cel mai frecvent primul.
Atenție
Oricine poate trimite o cerere care pretinde că este Googlebot. Înainte să acționați pe baza unui vârf suspect, confirmați că adresele IP aparțin Google. Google documentează o verificare DNS inversă pentru aceasta și merită făcută înainte de a bloca sau redirecționa ceva pe baza user agent-ului.
Instrumentul Inspecția URL-ului
Principiu: o verificare a unui singur URL, care arată când l-a preluat ultima dată Google, ce a primit și dacă este indexat. Când să-l folosiți: pentru a confirma o singură remediere, de exemplu dacă Google a preluat pagina corectată după ce ați modificat-o. Avantaje: rapid, exact și ușor de citit pentru un URL. Limite: un URL pe rând, deci nu poate arăta un tipar pe întregul site. În analiza menționată mai sus, instrumentul a arătat că o pagină principală de categorie nu fusese crawlată timp de trei luni, iar autorul l-a folosit în locul jurnalelor pentru acea pagină.
Raportul Crawl Stats față de jurnalele serverului
Raportul Crawl Stats
Numără încercările eșuate de DNS și conexiune
Arată starea gazdei și tipul de Googlebot
Afișează URL-uri exemplu eșantionate, nu toate
Unele cereri s-ar putea să nu fie numărate
Jurnalele serverului
Fiecare cerere care a ajuns la server
URL-ul exact și codul de stare pentru fiecare cerere
Ratează încercările eșuate de DNS și conexiune
User agent-ul poate fi falsificat
Metodă
Ce întrebare răspunde
Domeniu
Punct orb
Raportul Crawl Stats
Este Googlebot sănătos și cum se comportă în general?
Întreaga proprietate, rezumată
URL-uri exemplu eșantionate și unele cereri s-ar putea să nu fie numărate
Jurnalele serverului
Ce URL-uri exacte au primit ce răspuns și când?
Fiecare cerere care a ajuns la server
Încercări eșuate de DNS și conexiune și user agent-uri care pot fi falsificate
Inspecția URL-ului
Când a preluat Google ultima dată această pagină și ce a primit?
Un URL
Nu spune nimic despre restul site-ului
Revizuire lunară, pas cu pas
O lună de date vă spune puțin. Raportul devine util când îl comparați cu normalul dvs., așa că păstrați o evidență scurtă și revizuiți-o în aceeași zi în fiecare lună. Aceasta este rutina care funcționează pentru majoritatea site-urilor.
Revizuirea lunară în șase pași
Salvați lunaFaceți o captură de ecran sau notați cele trei grafice, starea gazdei și defalcarea răspunsurilor.
Comparați cu valoarea de referințăO schimbare a totalului de cereri poate fi normală după o lună mare de publicare. O pondere nouă de 5XX merită mereu o privire.
Verificați în ordineMai întâi starea gazdei, apoi răspunsurile proaste, apoi ponderea redirecționărilor.
Extrageți URL-urilePentru fiecare categorie proastă, luați din jurnale URL-urile cele mai frecvente pentru aceeași perioadă.
Remediați sursaLinkurile interne, regulile de redirecționare, capacitatea serverului sau regula robots.txt. Nu graficul.
Notați schimbareaScrieți data fiecărei remedieri și citiți luna următoare având data aceea în minte.
Semnale care merită acțiune luna aceasta
Starea gazdei este galbenă sau roșie la oricare dintre cele trei verificări
Ponderea 5XX crește câteva zile la rând sau sare la aceeași oră
Răspunsurile de redirecționare cresc după o schimbare de site care trebuia să le elimine
Ponderea de descoperire rămâne mare pe un site care publică puțin
O singură zi proastă fără nicio schimbare în jurnale este zgomot până când se repetă
Înainte și după o migrare
Să presupunem că mutați blogul de la /old-blog/ la /blog/ cu redirecționări 301. Imediat după mutare, așteptați-vă ca ponderea redirecționărilor să crească, pentru că Googlebot încă cere vechile căi. În săptămânile următoare, ponderea ar trebui să scadă pe măsură ce Google învață URL-urile noi. Așteptați-vă și la creșterea ponderii descoperirii, pentru că URL-urile noi sunt noi pentru Google. Dacă ponderea redirecționărilor rămâne mare după câteva săptămâni, căutați lanțuri, linkuri interne vechi sau redirecționări pe care le-ați uitat. Ghidul nostru despre repararea linkurilor rupte acoperă partea de linkuri a aceleiași curățări.
Greșeli frecvente și cum să le evitați
Majoritatea greșelilor vin din citirea unui singur grafic drept verdict. Fiecare dintre cele cinci de mai jos are un semn clar în raport și o remediere pe care o puteți verifica în jurnale.
Citirea totalului cererilor de crawling ca pe un scor
Ce este: presupunerea că mai multe cereri de crawling înseamnă un SEO mai bun. Cum o recunoașteți: cererile cresc brusc după o lansare care a adăugat opțiuni de filtrare sau sortare, iar URL-urile noi poartă parametri. Cum o remediați: verificați ponderea descoperirii și tiparele de URL din jurnale. Remediați generatorul de URL-uri: nu mai faceți linkuri către URL-urile cu parametri sau folosiți canonical și blocați pe cele care nu au valoare de căutare. Un număr mai mare de cereri inutile este un cost, nu un câștig.
Încrederea în timpul mediu de răspuns
Ce este: uitatul la medie și ratarea vârfurilor pe care le ascunde. Cum o recunoașteți: media pare plată, dar jurnalele arată răspunsuri lente la aceeași oră în fiecare noapte. Cum o remediați: grupați jurnalele pe oră și pe URL, apoi comparați orele lente cu copiile de rezervă, importurile și implementările. Remediați jobul lent sau șablonul lent, apoi verificați din nou media. Media este o linie de tendință, iar o linie de tendință nu poate spune unde începe lentoarea.
Ignorarea stării gazdei când paginile se încarcă bine
Ce este: presupunerea că site-ul e sănătos pentru că se deschide în browserul dvs. Cum o recunoașteți: starea gazdei arată galben sau roșu pentru robots.txt, DNS sau conectivitate, în timp ce paginile dvs. funcționează pentru dvs. Googlebot ajunge la site-ul dvs. pe alte căi de rețea, iar un firewall, o regulă CDN sau o înregistrare DNS îl pot bloca fără să afecteze browserul dvs. Cum o remediați: verificați că fișierul robots.txt se încarcă cu un răspuns 200, folosind verificatorul robots.txt, apoi revizuiți regulile firewall-ului și ale CDN-ului pentru datele când starea a devenit roșie.
Blocarea crawlingului, apoi citirea scăderii ca progres
Ce este: o modificare robots.txt care taie cererile de crawling, urmată de un raport care arată mai liniștit. Cum o recunoașteți: cererile totale scad brusc în ziua modificării robots.txt. Cum o remediați: scăderea poate fi corectă dacă ați blocat căi inutile, dar verificați că secțiunile importante ale site-ului sunt încă crawlate. Uitați-vă în jurnale la secțiunile care contează. Dacă o pagină de care aveți nevoie este blocată, ghidul nostru despre statusul blocat de robots.txt explică cum găsiți regula și ce să schimbați.
Confundarea crawlingului cu indexarea
Ce este: tratarea unei pagini bine crawlate ca pe o pagină indexată. Cum o recunoașteți: Googlebot cere regulat un URL, dar URL-ul nu apare în rezultatele Google. Un număr mare de crawlinguri nu dovedește că Google păstrează pagina. Cum o remediați: treceți de la raportul Crawl Stats la rapoartele de indexare a paginilor și verificați statusul URL-ului. Ghidul nostru despre crawlat, în prezent neindexat explică cauzele, iar cel despre indexarea Google acoperă verificările în ordine.
Greșeală
Cum o recunoașteți
Cum o remediați
Cererile totale citite ca scor
Cererile cresc după apariția parametrilor URL
Opriți generarea URL-urilor inutile, apoi recalculați
Doar timpul mediu de răspuns
Orele lente ascunse de o medie plată
Grupați jurnalele pe oră, potriviți orele lente cu joburile
Starea gazdei ignorată
Galben sau roșu cât timp paginile se deschid în browser
Verificați robots.txt, DNS, firewall și regulile CDN
Scăderea crawlingului citită ca progres
Cererile scad în ziua modificării robots.txt
Confirmați că secțiunile importante sunt încă crawlate
Crawlingul confundat cu indexarea
Crawlinguri regulate, URL absent din rezultate
Verificați statusul de indexare al URL-ului
Unde se potrivește Sorank și ce urmează
Tabloul de bord GEO / SEO al Sorank pune clicurile, impresiile, CTR-ul și poziția dvs. din Search Console lângă vizitele pe care vi le trimit asistenții AI, citite din Google Analytics. Nu afișează cererile Googlebot, deci păstrați raportul Crawl Stats pentru acea treabă. Cele două instrumente răspund la întrebări diferite: tabloul de bord vă spune ce vă trimite Google, iar Crawl Stats vă spune cum vizitează Google serverul dvs.
Sfat
Înainte să petreceți timp în jurnale pentru o singură pagină, verificați dacă Google o poate indexa deloc, cu verificatorul gratuit de indexabilitate Google. Răspunde la prima întrebare în câteva secunde.
Raportul Crawl Stats este un bun prim ecran. Vă spune ce tip de problemă să bănuiți și în ce date. Remedierea se află aproape întotdeauna într-o listă de URL-uri, iar lista aceea este în jurnalele dvs. Începeți cu raportul, apoi mergeți la URL-uri.
Întrebări frecvente
Unde este raportul Crawl Stats în Google Search Console?
Deschideți proprietatea, mergeți la Setări, selectați Crawl stats, apoi faceți clic pe Deschide raportul. Raportul există doar pentru proprietățile de tip Domeniu și pentru proprietățile cu prefix URL de nivel rădăcină, deci o proprietate pe subfolder nu îl va afișa.
Un număr mare de cereri de crawling este un semn bun?
Nu de unul singur. Totalul numără fiecare cerere, inclusiv cele eșuate și încercările blocate de robots.txt, deci arată cât de des vizitează Googlebot, nu cât de sănătoase sunt vizitele. Citiți-l împreună cu codurile de răspuns și timpul mediu de răspuns.
Pot să mă bazez pe Crawl Stats în loc de jurnalele serverului?
Nu singur. Google spune că unele cereri s-ar putea să nu fie numărate, iar exemplele sale de URL-uri nu sunt complete. Folosiți raportul pentru tendințe și categorii de eșec, iar jurnalele pentru URL-uri exacte.
y!
Primește gratuit planul tău de conținut pe 30 de zile
Analizăm concurenții, site-ul tău și vizibilitatea ta în AI pentru a crea gratuit un plan de conținut personalizat.
“Am testat Sorank pe un site real de client și este incredibil. Face tot ce o agenție ți-ar factura 1500$ pe lună. Acum este deja în producție la acel client.”Guillaume Guersanguersanguillaume.com
“Suntem o agenție de publicitate și am vrut să punem în sfârșit SEO-ul pe picioare. Sorank ne-a oferit o viziune clară asupra site-ului nostru, ne-a ajutat să prioritizăm optimizările și să ne structurăm conținutul corect. Instrumentul este ușor de utilizat, bine gândit pentru o echipă și foarte practic pentru a centraliza urmărirea fără să jonglăm între mai multe platforme. O bază foarte solidă pentru a începe din nou cu SEO-ul nostru.”Gaspard MadouiAgenție de publicitate
Dominiqueflight-sensations-idf.comAgrement și aviație
“Am lăsat pur și simplu software-ul Sorank să își facă treaba, iar acum DR-ul meu este 25 și pagina mea se clasează mai sus.”Lucas Flandrefoundertrace.fr
“M-am specializat în GEO datorită Sorank. Clasamentul GEO îmi permite să îmi arăt clienții poziția față de concurenți în ChatGPT. Este un avantaj comercial real.”MélanieFreelancer SEO
“Serviciu excelent, funcționează bine pentru site-ul nostru și ne ajută să înțelegem cum să îl îmbunătățim pentru a ne clasa mai bine pe Google și în alte părți. Felicitări, continuați așa, vă recomand.”Hugo T.Comerciant e-commerce


 Google Search Console