Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Vielen Dank! Ihre Auswahl wurde gespeichert.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
Blau-weiße Illustration von Bot-Anfragen, die eine Website erreichen, mit Antwortcodes entlang des Wegs.
Werkzeuge
Auf dieser Seite
Kurz gesagt
Der Bericht Crawling-Statistiken in der Google Search Console zeigt, wie Googlebot Ihre URLs abruft: wie viele Anfragen er sendet, wie viele Bytes er herunterlädt, wie schnell Ihr Server antwortet und welche Statuscodes er zurückbekommt. Lesen Sie zuerst den Hoststatus, dann die Antwortcodes, dann die Aufschlüsselungen nach Zweck und Dateityp. Der Bericht ist eine Zusammenfassung, kein Protokoll. Nutzen Sie ihn, um das Problem zu finden, und bestätigen Sie es danach in Ihren Server-Logs.
Wer sollte die Technik Ihrer Website in Ordnung bringen?
Frage 1 von 425%
Unsere Empfehlung für Sie
Prüfen Sie es selbst mit den kostenlosen Google-Tools
Die Search Console listet die Seiten auf, die Google nicht lesen kann, und PageSpeed Insights testet die Geschwindigkeit. Viele kleine Probleme lassen sich in den Einstellungen Ihres Website-Baukastens beheben.
Unsere Empfehlung für Sie
Ein Webentwickler
Ihr Problem liegt im Code oder auf dem Server: Ein Entwickler mit SEO-Kenntnissen ist die richtige Person. Geben Sie ihm die Fehlerliste aus der Search Console.
Unsere Empfehlung für Sie
Ein Tool für technische Audits
Ihre Website hat viele Seiten: Ein Crawler liest alle wie Google und liefert eine vollständige Liste der Fehler, Seite für Seite.
Unsere Empfehlung für Sie
Ein automatisches Audit, dann Inhalte
Ihre Website funktioniert, bringt aber wenige Besucher: Technische Probleme sind selten die Ursache. Sorank prüft die Website und schreibt dann die Seiten, die Besucher bringen.
Was der Bericht Crawling-Statistiken ist und wer ihn öffnen sollte
Crawling-Statistiken ist die Sicht von Google auf die Aktivität von Googlebot auf Ihrer Website. Der Bericht zeigt, was Googlebot getan hat, nicht warum Ihre Seiten ranken oder nicht ranken. Google beschreibt den Bericht als Werkzeug für fortgeschrittene Nutzer, und eine Website mit weniger als tausend Seiten braucht ihn womöglich gar nicht. Wenn Sie eine kleine Visitenkarten-Website betreiben, können Sie ihn überspringen, bis sich etwas ändert.
Die öffentliche Seite der Search Console, der Ausgangspunkt für Crawling- und Indexierungswerkzeuge.
Die Search Console besteht aus vielen Berichten. Ihre öffentliche Seite behandelt Crawling und Indexierung allgemein: Sitemaps, URL-Prüfung, Indexabdeckung. Crawling-Statistiken liegt unter Einstellungen statt im Hauptmenü, weshalb viele Menschen es nie öffnen.
Nur Properties auf Root-Ebene erhalten den Bericht
Der Bericht ist nur für Properties auf Root-Ebene verfügbar: eine Domain-Property oder eine URL-Präfix-Property auf der Wurzel der Website. Eine Property für einen Unterordner, etwa example.com/blog/, erhält ihn nicht. Die Daten umfassen nur die gewählte Domain. Anfragen an Schwester-Subdomains erscheinen nicht im Bericht einer anderen Subdomain, aber eine Ansicht der übergeordneten Domain enthält alle untergeordneten Domains. Http und https werden in derselben Ansicht gezählt.
Hinweis
Wenn Ihre Website Sprach-Subdomains wie en.example.com und de.example.com nutzt, öffnen Sie jede einzeln. Jede hat eigene Daten, und eine kaputte deutsche Subdomain taucht in der englischen Ansicht nicht auf.
Wer den Bericht nutzen sollte
Öffnen Sie den Bericht, wenn eine dieser Situationen zutrifft: Sie veröffentlichen viele Seiten, Sie haben Ihre URL-Struktur oder Ihren Hosting-Anbieter gewechselt, Googlebot scheint seltener vorbeizukommen als früher, oder Seiten werden entdeckt, aber nie indexiert. Eine Website, die jeden Monat ein paar Artikel ergänzt, lernt daraus wenig außer Fehlern, und diese Fehler findet man besser bei einem normalen Crawl der Website.
Den Bericht öffnen und jede Grafik lesen
Öffnen Sie Ihre Property, gehen Sie zu Einstellungen, suchen Sie Crawling-Statistiken und klicken Sie auf Bericht öffnen. Oben finden Sie drei Grafiken: die Gesamtzahl der Crawling-Anfragen, die gesamte Download-Größe und die durchschnittliche Antwortzeit. Darunter stehen der Hoststatus und vier Aufschlüsselungen: Crawling-Antworten, Dateityp, Crawling-Zweck und Googlebot-Typ. Jede Aufschlüsselung ist ein Prozentwert auf Basis der Anfragenzahl.
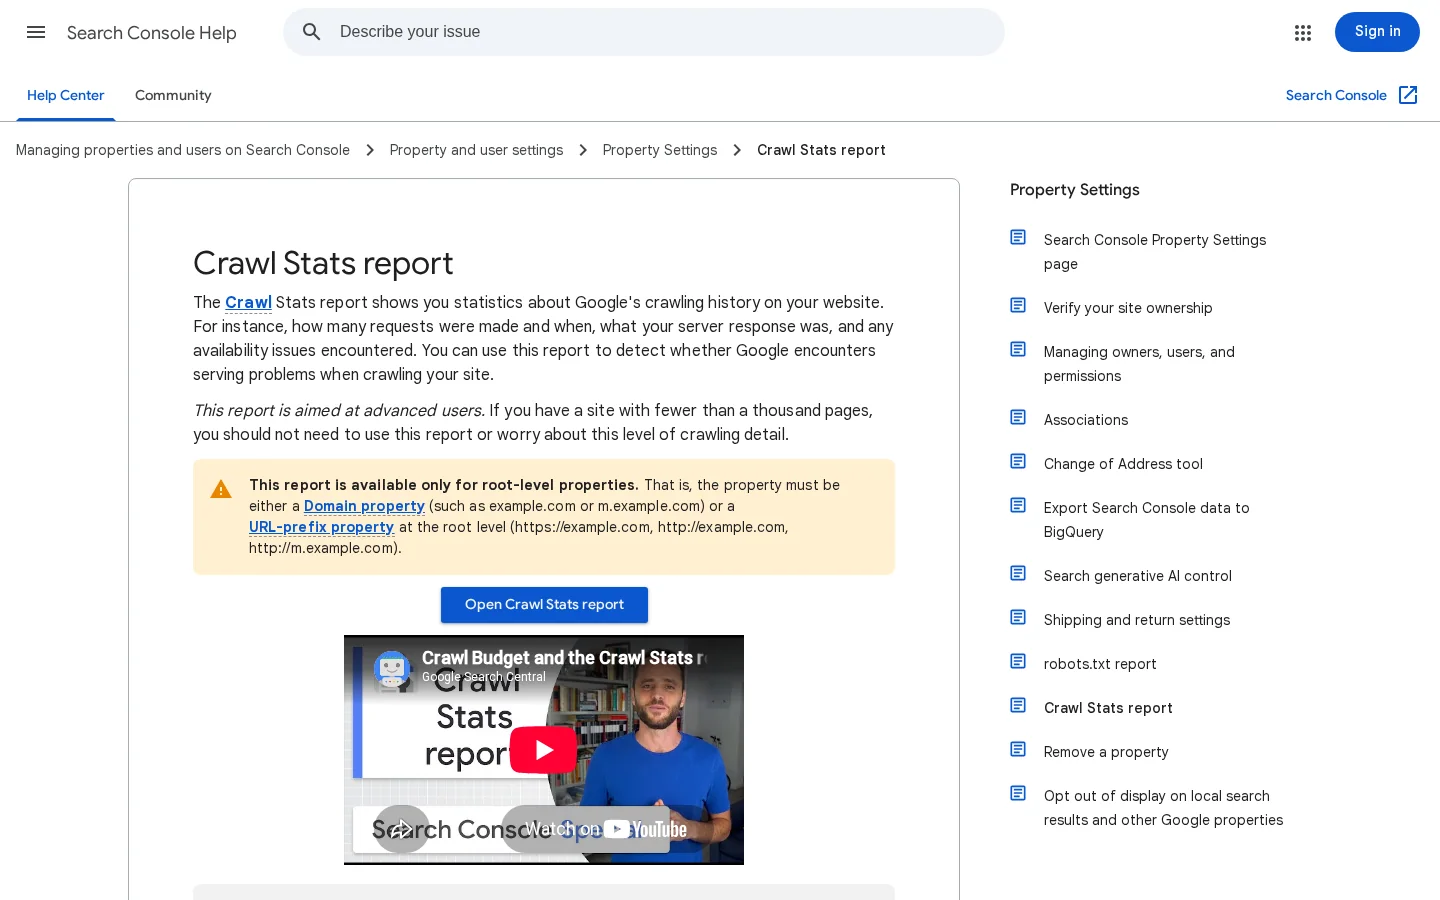
Die Hilfeseite von Google zum Bericht Crawling-Statistiken.
Hier steht, was jeder Teil zählt und wie Sie ihn lesen.
Teil des Berichts
Was er zählt
So lesen Sie ihn
Crawling-Anfragen gesamt
Alle Anfragen für Ihre URLs, erfolgreich oder nicht, einschließlich fehlgeschlagener DNS-Abfragen, Verbindungsversuche und Weiterleitungsschleifen. Auch durch robots.txt blockierte Versuche werden gezählt.
Ein plötzlicher Abfall oder Anstieg: Prüfen Sie Änderungen an robots.txt und Ihrer URL-Struktur für dieselben Daten.
Download-Größe gesamt
Die beim Crawling heruntergeladenen Bytes. Eine gecachte Ressource zählt nur bei der ersten Anfrage.
Steigen die Bytes, während die Anfragen gleich bleiben, sind Ihre Seiten schwerer geworden.
Durchschnittliche Antwortzeit
Die durchschnittliche Zeit zum Abrufen jeder Ressource, wobei jede verlinkte Ressource einzeln zählt.
Achten Sie auf den Trend, nicht auf einen einzelnen Wert. Beobachten Sie ihn nach jedem Deployment.
Hoststatus
Abruf von robots.txt, DNS-Auflösung und Erreichbarkeit des Servers. Grün bedeutet kein nennenswertes Problem in den letzten 90 Tagen, gelb bedeutet Probleme, die älter als eine Woche sind, rot bedeutet Probleme in der letzten Woche.
Jeder rote oder gelbe Punkt ist zuerst ein Server- oder Netzwerkproblem und erst danach ein SEO-Problem.
Crawling-Antworten
Der Anteil der Antworten nach Typ, auf Basis der Anfragenzahl.
Verfolgen Sie den Anteil schlechter Antworten über die Zeit. Die Rohzahl ist weniger wichtig.
Dateityp
Der Anteil der Antworten nach Typ: HTML, Bild, JavaScript, CSS, PDF, JSON, Video. Basiert auf der Anzahl der Antworten, nicht auf Bytes.
Zeigt, wofür Googlebot seine Anfragen einsetzt. Ein hoher Anteil an JavaScript und CSS bedeutet, dass Ihre Seiten von vielen Ressourcen abhängen.
Crawling-Zweck
Entdeckung (eine URL, die Google noch nie gecrawlt hat) oder Aktualisierung (ein erneuter Crawl einer bekannten URL).
Siehe den Abschnitt zu Entdeckung und Aktualisierung weiter unten.
Googlebot-Typ
Smartphone, Desktop, Bild, Video, Laden von Seitenressourcen, AdsBot, StoreBot, andere.
Bei einer mobile-first indexierten Website sollte Smartphone die größte Gruppe sein. Eine plötzliche Verschiebung lohnt eine Prüfung.
Prozentwerte zählen Anfragen, nicht URLs
Jede Aufschlüsselung zählt Anfragen. Eine URL, die Googlebot 50-mal abruft, zählt 50-mal. „40 % der Antworten sind 301“ sagt Ihnen also, wie viele Anfragen auf eine Weiterleitung treffen, nicht wie viele URLs weiterleiten. Um zu erfahren, welche URLs betroffen sind, brauchen Sie Ihre Logs. Die Beispiel-URLs, die Google anzeigt, sind eine Stichprobe, und Google sagt, dass sie nicht vollständig sind.
Was der Bericht nicht zeigt
Die Hilfeseite von Google sagt, dass der Bericht derzeit die meisten Crawling-Anfragen erfasst, aber einige Anfragen möglicherweise nicht gezählt werden. Außerdem heißt es, dass fehlgeschlagene Anfragen, die Ihren Server nie erreichen, nicht in Ihren Logs erscheinen. Deshalb zeigt der Bericht DNS- und Verbindungsfehler, die Ihre Logs nicht zeigen können, und deshalb sollten Sie beide Quellen lesen. Google nennt keine Aufbewahrungsdauer für die Grafiken. Wenn Sie einen Verlauf möchten, sichern Sie jeden Monat Ihre eigene Kopie, etwa mit einem Screenshot oder einer kurzen Notiz mit den Zahlen.
Jede Anfrage von Googlebot wandert von Google zu Ihren Seiten, und jede Antwort wird erfasst.
Die Antwortcodes Schritt für Schritt lesen
Der Antwort-Bericht ist der Teil, der am häufigsten zu einer Korrektur führt. Lesen Sie ihn in dieser Reihenfolge und halten Sie beim ersten Schritt an, der ein echtes Problem zeigt.
Die Crawling-Antworten in fünf Schritten prüfen
Hoststatus prüfenRot oder gelb bei robots.txt, DNS oder Erreichbarkeit bedeutet, dass Googlebot Ihre Website gar nicht erreichen konnte. Beheben Sie das vor allem anderen.
Schlechte Antworten ansehen5XX, andere 4XX, nicht verfügbare robots.txt, Timeouts und Weiterleitungsfehler. Notieren Sie ihren Anteil und ob er von Woche zu Woche schwankt.
Anteil der Weiterleitungen prüfenViele 301- und 302-Antworten bedeuten, dass Googlebot seine Anfragen für Zwischenstationen statt für Seiten ausgibt.
404 bestätigenEine 404 ist in Ordnung, wenn die Seite absichtlich entfernt wurde. Sie ist ein Problem, wenn interne Links oder Ihre Sitemap noch darauf zeigen.
URLs aus den Logs ziehenMachen Sie aus jeder schlechten Kategorie eine Liste von URLs und beheben Sie dann die Quelle der Links, nicht den Bericht.
Gute, möglicherweise gute und schlechte Antworten
Google sortiert die Antworten in drei Gruppen. Die Gruppierung ist ein erster Filter, kein Urteil über jede einzelne URL.
Gut: 200, 301, 302, 304 und Meta-Refresh.
Möglicherweise gut: 404.
Schlecht: robots.txt nicht verfügbar, 401 und 407, 5XX, andere 4XX, DNS-Fehler, Abruffehler, Timeouts und Weiterleitungsfehler.
Eine 401 zählt im Bericht als schlecht, ist aber korrekt, wenn die Seite hinter einem Login liegt, der geschlossen bleiben soll. Entscheiden Sie URL für URL. Der Bericht zeigt Ihnen, welche Gruppe Sie prüfen sollten, und Sie entscheiden, was jede Antwort sein soll.
Weiterleitungen: die Kosten, die Sie nicht sehen
Eine 302 zählt als gute Antwort. Ein Weiterleitungsanteil kann also gesund aussehen, obwohl er Crawling-Budget verschwendet. In einer Analyse einer großen Website, die im April 2021 auf Search Engine Journal von Tomek Rudzki von Onely veröffentlicht wurde, gingen 16 % der Anfragen an weitergeleitete Seiten, und der Autor riet, jeden Weiterleitungsschritt zu prüfen.
So schadet eine Kette. Angenommen, /blog/seo-tips leitet auf /blog/seo-tips-2025 weiter, das wiederum auf /blog/seo-tips-guide weiterleitet. Googlebot braucht drei Anfragen, um den Inhalt zu erreichen, und jeder interne Link, der noch auf die erste URL zeigt, wiederholt diese Kosten. Leiten Sie die erste URL direkt auf die endgültige Adresse weiter und aktualisieren Sie die internen Links, damit sie die alten Pfade nicht mehr verwenden. Der kostenlose Weiterleitungs-Checker verfolgt die Kette jeder URL Schritt für Schritt, damit Sie den Weg sehen, bevor Sie ihn korrigieren. Wenn Sie nicht sicher sind, ob eine Weiterleitung dauerhaft sein soll, lesen Sie unseren Leitfaden zu 301 vs. 302 Weiterleitungen: Eine 301 bedeutet, dass der Umzug dauerhaft ist, eine 302, dass er vorübergehend ist.
Tipp
Sortieren Sie Ihre Weiterleitungs-URLs nach der Häufigkeit, mit der Googlebot sie in Ihren Logs anfragt. Beheben Sie zuerst die fünf am häufigsten angefragten Ketten. Sie machen meist den größten Teil des Weiterleitungsanteils aus.
5XX und 429: das Signal, das die Crawling-Rate senkt
Der Leitfaden von Google für große Websites sagt, dass Google das Crawling-Limit senkt, wenn eine Website mit Serverfehlern (5XX) oder Signalen zur Ratenbegrenzung wie HTTP 429 antwortet. Ein Anstieg bei 5XX kostet Sie also mehr als die defekten URLs selbst. Er kann auch das Crawling Ihrer gesunden Seiten verlangsamen. Das Crawl-Budget einer Website hängt teilweise davon ab, wie gut der Server antwortet, und 5XX-Antworten verkleinern diesen Anteil.
Wenn Sie einen Anstieg bei 5XX sehen, achten Sie darauf, wann er auftritt. Fehler zur gleichen Stunde jeden Tag deuten auf einen Backup-Job, einen geplanten Import oder eine Verkehrsspitze hin. Fehler direkt nach einem Release deuten auf das Release. Über den ganzen Tag verteilte Fehler deuten auf zu wenig Kapazität. Jedes Muster hat eine andere Lösung, und keine davon lässt sich durch die Bearbeitung einer einzelnen Seite beheben.
Entdeckung, Aktualisierung und Dateityp: was die Verhältnisse zeigen
Die Aufschlüsselung nach Crawling-Zweck teilt die Anfragen in Entdeckung, wenn Google eine URL zum ersten Mal sieht, und Aktualisierung, wenn Google eine bereits bekannte URL erneut crawlt. Das Verhältnis zwischen beiden zeigt, wofür Google seine Zeit aufwendet.
Ein hoher Entdeckungsanteil auf einer Website, die wenige Seiten ergänzt bedeutet, dass Google ständig neue URLs findet. Suchen Sie nach URL-Generatoren: Filter- und Sortierparameter, interne Suchergebnisseiten, Kalenderarchive, Session-IDs. Jeder erzeugt URLs, die neu wirken.
Ein hoher Aktualisierungsanteil bei Seiten, die sich nie ändern bedeutet, dass Google sie immer wieder besucht. Prüfen Sie, ob diese Seiten mit 304 Not Modified antworten. Google sagt, dass eine 304-Antwort für eine unveränderte Seite bedeutet, dass die vorhandene Kopie wiederverwendet werden kann. Liefern die gleichen Seiten bei jedem Besuch ein 200 mit allen Bytes, sendet Ihr Server die komplette Seite bei jedem Besuch.
Eine große Website, ein Crawling-Tag
7460Seiten pro Tag im Durchschnitt gecrawlt
35 %dieser Crawls waren Entdeckungs-Crawls für URLs, die Google nie abgerufen hatte
Quelle: Tomek Rudzki (Onely), Search Engine Journal, April 2021. Eine Website mit rund 1 Million Seiten und einem Rückstau an URLs mit dem Status „Gefunden, zurzeit nicht indexiert“.
Dieselbe Analyse lieferte eine nützliche grobe Prüfung. Bei diesem Tempo schätzte sie, dass der Rückstau etwa ein Jahr zum Crawlen bräuchte. Diese Zahl ist die Rechnung eines einzelnen Autors für eine einzelne Website, und die Screenshots stammen aus dem Jahr 2021. Übernehmen Sie sie also nicht. Die Methode funktioniert aber mit Ihren eigenen Daten: Teilen Sie die Zahl der URLs, die auf Entdeckung warten, durch die Zahl der Entdeckungs-Crawls pro Tag in Ihrem Bericht. Liegt das Ergebnis im Bereich von Monaten, haben Sie ein Crawling-Problem, das Sie beheben sollten, bevor Sie mehr veröffentlichen.
Die Aufschlüsselung nach Dateityp zählt Antworten, nicht Bytes. Sie zeigt also, wie viele Anfragen auf jeden Ressourcentyp entfallen, nicht wie schwer sie sind. Weiterleitungen fallen unter „Anderer Dateityp“, und fehlgeschlagene Anfragen erscheinen als „Unbekannt (fehlgeschlagen)“. Ein wachsender Anteil an „Unbekannt (fehlgeschlagen)“ ist ein Fehlersignal und kein Dateityp. Behandeln Sie ihn zusammen mit den schlechten Antworten.
Crawling-Statistiken, Server-Logs und URL-Prüfung: drei Sichten auf Googlebot
Es gibt drei Wege, um zu sehen, was Googlebot auf Ihrer Website getan hat: den Bericht Crawling-Statistiken, Ihre Server-Logs und das Werkzeug URL-Prüfung der Search Console. Jedes beantwortet eine andere Frage, und jedes hat blinde Flecken, die die beiden anderen abdecken. Bei einem echten Problem sollten Sie alle drei nutzen.
Der Bericht Crawling-Statistiken
Prinzip: eine von Google berechnete Zusammenfassung der Anfragen von Googlebot für eine ganze Property. Wann verwenden: für Trends, den Hoststatus und den ersten Überblick über ein Problem. Vorteile: Er ist kostenlos, erfasst Fehler, die Ihren Server nie erreichen, und ergänzt Zweck und Googlebot-Typ, die Logs nicht direkt liefern. Grenzen: Er ist eine Zusammenfassung, einige Anfragen werden möglicherweise nicht gezählt, und die Beispiel-URLs sind eine Stichprobe. Beispiel: Der Anteil an 5XX steigt drei Tage lang auf einem Host. Der Bericht zeigt Ihnen die Tage und den Host, Ihre Logs zeigen Ihnen die URLs und die Uhrzeiten.
Server-Logs
Prinzip: das Rohprotokoll, das Ihr Webserver für jede eingehende Anfrage schreibt. Wann verwenden: für exakte URL-Listen, Statuscodes pro Stunde und die Belege hinter einem Trend im Bericht. Vorteile: vollständig für jede Anfrage, die Ihren Server erreicht hat, mit exakter URL und Statuscode. Grenzen: Sie enthalten keine Anfragen, die schon vor dem Server gescheitert sind, der User-Agent lässt sich fälschen, und die meisten Server rotieren oder löschen Logs nach einer festgelegten Zeit. Dieser Befehl zählt die Statuscodes von Anfragen, die als Googlebot erkannt wurden, in einem Log im Combined-Format:
Der Befehl sucht nach dem User-Agent-String und zählt dann den Statuscode, der im Combined-Log-Format das neunte Feld ist. Schreibt Ihr Server ein anderes Format, ändern Sie die Feldnummer. Das Ergebnis ist eine Tabelle mit Zählungen pro Statuscode, der häufigste zuerst.
Warnung
Jeder kann eine Anfrage senden, die sich als Googlebot ausgibt. Prüfen Sie, bevor Sie auf einen verdächtigen Anstieg reagieren, ob die IP-Adressen zu Google gehören. Google dokumentiert dafür eine Reverse-DNS-Prüfung, und sie lohnt sich, bevor Sie etwas anhand des User-Agents blockieren oder umleiten.
Das Werkzeug URL-Prüfung
Prinzip: eine Prüfung einer einzelnen URL, die zeigt, wann Google sie zuletzt abgerufen hat, was es erhalten hat und ob sie indexiert ist. Wann verwenden: um eine einzelne Korrektur zu bestätigen, etwa ob Google eine geänderte Seite nach Ihrer Änderung erneut abgerufen hat. Vorteile: schnell, exakt und für eine einzelne URL leicht lesbar. Grenzen: immer nur eine URL, deshalb kann es kein Muster über die ganze Website zeigen. In der oben genannten Analyse zeigte das Werkzeug, dass eine wichtige Kategorieseite drei Monate lang nicht gecrawlt worden war, und der Autor nutzte es für diese Seite als Ersatz für die Logs.
Bericht Crawling-Statistiken gegen Server-Logs
Bericht Crawling-Statistiken
Zählt fehlgeschlagene DNS- und Verbindungsversuche
Zeigt Hoststatus und Googlebot-Typ
Zeigt Beispiel-URLs, nicht alle
Einige Anfragen werden möglicherweise nicht gezählt
Server-Logs
Jede Anfrage, die Ihren Server erreicht hat
Exakte URL und Statuscode für jede Anfrage
Fehlen bei fehlgeschlagenen DNS- und Verbindungsversuchen
Der User-Agent lässt sich fälschen
Methode
Frage, die sie beantwortet
Umfang
Blinder Fleck
Bericht Crawling-Statistiken
Ist Googlebot gesund, und wie verhält er sich insgesamt?
Die gesamte Property, zusammengefasst
Stichprobenartige Beispiel-URLs, und einige Anfragen werden möglicherweise nicht gezählt
Server-Logs
Welche genauen URLs haben welche Antwort bekommen, und wann?
Jede Anfrage, die Ihren Server erreicht hat
Fehlgeschlagene DNS- und Verbindungsversuche, und User-Agents, die sich fälschen lassen
URL-Prüfung
Wann hat Google diese Seite zuletzt abgerufen, und was hat es erhalten?
Eine URL
Sagt nichts über den Rest der Website
Eine monatliche Prüfung, Schritt für Schritt
Ein Monat Daten sagt wenig. Der Bericht wird nützlich, wenn Sie ihn mit Ihrem normalen Zustand vergleichen. Führen Sie deshalb ein kurzes Protokoll und prüfen Sie es jeden Monat am gleichen Tag. Diese Routine funktioniert für die meisten Websites.
Die monatliche Prüfung in sechs Schritten
Den Monat sichernDrei Grafiken, den Hoststatus und die Antwort-Aufschlüsselung als Screenshot oder Notiz festhalten.
Mit Ihrer Basislinie vergleichenEine Änderung der Anfragen insgesamt kann nach einem großen Veröffentlichungsmonat normal sein. Ein neuer Anteil an 5XX lohnt immer einen Blick.
In dieser Reihenfolge prüfenZuerst der Hoststatus, dann die schlechten Antworten, dann der Anteil der Weiterleitungen.
URLs ziehenHolen Sie sich für jede schlechte Kategorie die wichtigsten URLs aus Ihren Logs für denselben Zeitraum.
Die Quelle behebenDie internen Links, die Weiterleitungsregeln, die Serverkapazität oder die robots.txt-Regel. Nicht die Grafik.
Die Änderung protokollierenNotieren Sie das Datum jeder Korrektur und lesen Sie den nächsten Monat mit diesem Datum im Kopf.
Signale, die diesen Monat eine Maßnahme verdienen
Der Hoststatus ist bei einer der drei Prüfungen gelb oder rot
Der Anteil an 5XX steigt mehrere Tage in Folge oder erreicht Spitzen zur gleichen Stunde
Weiterleitungsantworten nehmen nach einer Website-Änderung zu, die sie eigentlich entfernen sollte
Der Entdeckungsanteil bleibt hoch auf einer Website, die wenig veröffentlicht
Ein einzelner schlechter Tag ohne Änderung in den Logs: Das ist Rauschen, solange es sich nicht wiederholt
Vor und nach einer Migration
Angenommen, Sie verschieben Ihren Blog mit 301-Weiterleitungen von /old-blog/ nach /blog/. Direkt nach dem Umzug erwarten Sie einen Anstieg des Weiterleitungsanteils, weil Googlebot noch die alten Pfade anfragt. In den folgenden Wochen sollte der Anteil sinken, sobald Google die neuen URLs kennt. Erwarten Sie auch einen Anstieg des Entdeckungsanteils, weil die neuen URLs für Google neu sind. Bleibt der Weiterleitungsanteil nach mehreren Wochen hoch, suchen Sie nach Ketten, alten internen Links oder vergessenen Weiterleitungen. Unser Leitfaden zu defekten Links beheben behandelt die Linkseite derselben Aufräumarbeit.
Häufige Fehler und wie Sie sie vermeiden
Die meisten Fehler entstehen, wenn man eine Grafik als Urteil liest. Jeder der fünf folgenden Fehler hat ein klares Zeichen im Bericht und eine Korrektur, die Sie in Ihren Logs prüfen können.
Die Anfragen insgesamt als Punktzahl lesen
Was es ist: die Annahme, dass mehr Crawling-Anfragen besseres SEO bedeuten. Woran Sie es erkennen: die Anfragen steigen stark nach einem Release, das Filter- oder Sortieroptionen hinzugefügt hat, und die neuen URLs tragen Parameter. Wie Sie es beheben: Prüfen Sie den Entdeckungsanteil und die URL-Muster in Ihren Logs. Beheben Sie den URL-Generator: Verlinken Sie nicht mehr auf Parameter-URLs, oder setzen Sie Canonicals und blockieren Sie die, die keinen Suchwert haben. Eine höhere Zahl unnötiger Anfragen ist ein Kostenfaktor, kein Gewinn.
Der durchschnittlichen Antwortzeit vertrauen
Was es ist: nur den Durchschnitt anzusehen und die Spitzen zu übersehen, die er verbirgt. Woran Sie es erkennen: der Durchschnitt wirkt flach, aber Ihre Logs zeigen langsame Antworten jede Nacht zur gleichen Stunde. Wie Sie es beheben: Gruppieren Sie Ihre Logs nach Stunde und URL und vergleichen Sie die langsamen Stunden mit Ihren Backups, Importen und Deployments. Beheben Sie den langsamen Job oder das langsame Template und prüfen Sie den Durchschnitt danach erneut. Der Durchschnitt ist eine Trendlinie, und eine Trendlinie sagt Ihnen nicht, wo die Verlangsamung beginnt.
Den Hoststatus ignorieren, obwohl Ihre Seiten funktionieren
Was es ist: die Annahme, dass die Website gesund ist, weil sie in Ihrem Browser lädt. Woran Sie es erkennen: der Hoststatus zeigt gelb oder rot für robots.txt, DNS oder Erreichbarkeit, während Ihre Seiten für Sie funktionieren. Googlebot erreicht Ihre Website über andere Netzwerkwege, und eine Firewall, eine CDN-Regel oder ein DNS-Eintrag kann ihn blockieren, ohne Ihren Browser zu beeinflussen. Wie Sie es beheben: Prüfen Sie mit dem robots.txt-Checker, ob Ihre robots.txt mit einer 200-Antwort lädt, und prüfen Sie dann Ihre Firewall- und CDN-Regeln für die Daten, an denen der Status auf Rot gesprungen ist.
Die Crawling-Sperre, dann den Rückgang als Fortschritt lesen
Was es ist: eine robots.txt-Änderung, die die Crawling-Anfragen reduziert, gefolgt von einem Bericht, der ruhiger aussieht. Woran Sie es erkennen: die Anfragen insgesamt fallen am Tag einer robots.txt-Änderung deutlich. Wie Sie es beheben: Ein Rückgang kann richtig sein, wenn Sie unnötige Pfade blockiert haben. Prüfen Sie aber, ob Ihre wichtigen Bereiche weiterhin gecrawlt werden. Schauen Sie in die Logs für die Bereiche, die zählen. Wenn eine Seite, die Sie brauchen, blockiert ist, erklärt unser Leitfaden zum Status durch robots.txt blockiert, wie Sie die Regel finden und was Sie ändern müssen.
Crawling und Indexierung verwechseln
Was es ist: eine gut gecrawlte Seite für eine indexierte Seite zu halten. Woran Sie es erkennen: Googlebot fragt eine URL regelmäßig an, aber die URL taucht nicht in den Ergebnissen von Google auf. Eine hohe Crawling-Zahl beweist nicht, dass Google die Seite behält. Wie Sie es beheben: Wechseln Sie vom Bericht Crawling-Statistiken zu den Berichten zur Seitenindexierung und prüfen Sie den Status der URL. Unser Leitfaden zu gecrawlt, zurzeit nicht indexiert erklärt die Ursachen, und der Leitfaden zur Google-Indexierung beschreibt die Prüfungen in der richtigen Reihenfolge.
Fehler
Woran Sie ihn erkennen
Wie Sie ihn beheben
Anfragen insgesamt als Punktzahl gelesen
Anfragen steigen, nachdem URL-Parameter auftauchen
Die unnötigen URLs nicht mehr erzeugen, dann neu zählen
Nur die durchschnittliche Antwortzeit
Langsame Stunden, die ein flacher Durchschnitt verbirgt
Logs nach Stunde gruppieren, langsame Stunden Jobs zuordnen
Hoststatus ignoriert
Gelb oder rot, während Seiten im Browser laden
robots.txt, DNS, Firewall und CDN-Regeln prüfen
Crawling-Rückgang als Fortschritt gelesen
Anfragen fallen am Tag einer robots.txt-Änderung
Bestätigen, dass wichtige Bereiche weiter gecrawlt werden
Crawling mit Indexierung verwechselt
Regelmäßige Crawls, URL fehlt in den Ergebnissen
Den Indexierungsstatus der URL prüfen
Wo Sorank passt und was als Nächstes zu tun ist
Das GEO- / SEO-Dashboard von Sorank stellt Ihre Klicks, Impressionen, CTR und Positionen aus der Search Console neben die Besuche, die KI-Assistenten Ihnen schicken, gelesen aus Google Analytics. Es zeigt keine Anfragen von Googlebot. Behalten Sie dafür also den Bericht Crawling-Statistiken. Die beiden Werkzeuge beantworten unterschiedliche Fragen: Das Dashboard zeigt Ihnen, was Google Ihnen schickt, und Crawling-Statistiken zeigt Ihnen, wie Google Ihren Server besucht.
Tipp
Bevor Sie Zeit in Ihre Logs für eine einzelne Seite investieren, prüfen Sie mit dem kostenlosen Indexierbarkeits-Checker, ob Google die Seite überhaupt indexieren kann. Er beantwortet diese erste Frage in Sekunden.
Der Bericht Crawling-Statistiken ist ein guter erster Bildschirm. Er zeigt, welche Art von Problem Sie vermuten sollten und an welchen Daten. Die Lösung liegt fast immer in einer Liste von URLs, und diese Liste steht in Ihren Logs. Beginnen Sie mit dem Bericht und gehen Sie dann zu den URLs.
Häufig gestellte Fragen
Wo finde ich den Bericht Crawling-Statistiken in der Google Search Console?
Öffnen Sie Ihre Property, gehen Sie zu Einstellungen, wählen Sie Crawling-Statistiken und klicken Sie auf Bericht öffnen. Den Bericht gibt es nur für Domain-Properties und URL-Präfix-Properties auf Root-Ebene. Eine Property für einen Unterordner zeigt ihn nicht.
Ist eine hohe Zahl an Crawling-Anfragen ein gutes Zeichen?
Nicht von allein. Die Gesamtzahl zählt jede Anfrage, auch fehlgeschlagene und durch robots.txt blockierte Versuche. Sie zeigt also, wie oft Googlebot kommt, nicht wie gesund diese Besuche sind. Lesen Sie sie zusammen mit den Antwortcodes und der durchschnittlichen Antwortzeit.
Kann ich mich auf Crawling-Statistiken statt auf Server-Logs verlassen?
Nicht allein. Google sagt, dass einige Anfragen möglicherweise nicht gezählt werden und dass seine Beispiel-URLs nicht vollständig sind. Nutzen Sie den Bericht für Trends und Fehlerkategorien und Ihre Logs für die genauen URLs.
y!
Erhalten Sie kostenlos Ihren Content-Plan für 30 Tage
Wir analysieren Ihre Wettbewerber, Ihre Website und Ihre KI-Sichtbarkeit, um kostenlos einen maßgeschneiderten Content-Plan für Sie zu erstellen.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler


 Search Console