Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Bedankt! Je aanmelding is ontvangen!
Oeps! Er ging iets mis bij het versturen van het formulier.
Blauw-witte illustratie van botverzoeken die een website bereiken, met responscodes langs het pad aangegeven.
Tools
Op deze pagina
Kort samengevat
Het rapport Crawlstatistieken in Google Search Console laat zien hoe Googlebot je URL's opvraagt: hoeveel verzoeken hij stuurt, hoeveel bytes hij downloadt, hoe snel je server antwoordt en welke statuscodes hij terugkrijgt. Lees eerst de hoststatus, dan de responscodes en daarna de uitsplitsingen naar doel en bestandstype. Het rapport is een samenvatting, geen logboek. Gebruik het om het probleem te vinden en bevestig het daarna in de logbestanden van je server.
Controleer het zelf met de gratis tools van Google
Search Console toont de pagina's die Google niet kan lezen, en PageSpeed Insights test de snelheid. Veel kleine problemen los je op in de instellingen van je websitebouwer.
Ons advies voor jou
Een webontwikkelaar
Je probleem zit in de code of op de server: een ontwikkelaar die SEO kent is de juiste persoon. Geef hem de foutenlijst uit Search Console.
Ons advies voor jou
Een tool voor technische audits
Je website heeft veel pagina's: een crawler leest ze allemaal zoals Google en geeft een volledige lijst met fouten, pagina voor pagina.
Ons advies voor jou
Een automatische audit, daarna content
Je website werkt maar levert weinig bezoekers op: technische problemen zijn zelden de oorzaak. Sorank controleert de website en schrijft daarna de pagina's die verkeer opleveren.
Wat het rapport Crawlstatistieken is en wie het moet openen
Crawlstatistieken is het overzicht vanuit Google van de activiteit van Googlebot op je site. Het laat zien wat Googlebot heeft gedaan, niet waarom je pagina's wel of niet goed scoren. Google omschrijft het rapport als bedoeld voor gevorderde gebruikers, en een site met minder dan duizend pagina's heeft het misschien helemaal niet nodig. Heb je een kleine brochuresite, dan kun je het overslaan tot er iets verandert.
De openbare pagina van Search Console, het startpunt voor crawl- en indexeringstools.
Search Console bestaat uit veel rapporten. De openbare pagina behandelt crawlen en indexeren in het algemeen: sitemaps, URL-inspectie, indexdekking. Crawlstatistieken staat onder Instellingen en niet in het hoofdmenu, daarom opent veel mensen het nooit.
Alleen eigenschappen op hoofdniveau krijgen het rapport
Het rapport is alleen beschikbaar voor eigenschappen op hoofdniveau: een Domein-eigenschap of een URL-prefix-eigenschap die op de root van de site is gebouwd. Een eigenschap voor een submap, zoals example.com/blog/, krijgt het niet. De gegevens dekken alleen het geselecteerde domein. Verzoeken naar zusterssubdomeinen verschijnen niet in het rapport van een ander subdomein, maar een weergave van het bovenliggende domein omvat alle subdomeinen. Http en https tellen mee in dezelfde weergave.
Opmerking
Gebruikt je site taalsubdomeinen, zoals en.example.com en de.example.com, open er dan elk apart. Elk heeft eigen gegevens, en een kapot Duits subdomein komt niet voor in de Engelse weergave.
Wie het moet gebruiken
Open het rapport wanneer een van deze situaties speelt: je publiceert veel pagina's, je hebt je URL-structuur of hosting veranderd, Googlebot lijkt minder vaak langs te komen dan vroeger, of er zijn pagina's die wel worden ontdekt maar nooit worden geïndexeerd. Een site die elke maand een paar artikelen toevoegt, leert er weinig van behalve over fouten, en die fouten vind je beter met een gewone crawl van de site.
Het rapport openen en elke grafiek lezen
Open je eigenschap, ga naar Instellingen, zoek Crawlstatistieken en klik op Rapport openen. Bovenaan staan drie grafieken: het totaal aan crawlverzoeken, de totale downloadgrootte en de gemiddelde responstijd. Daaronder staan de hoststatus en vier uitsplitsingen: crawlreacties, bestandstype, crawldoel en Googlebot-type. Elke uitsplitsing is een percentage op basis van het aantal verzoeken.
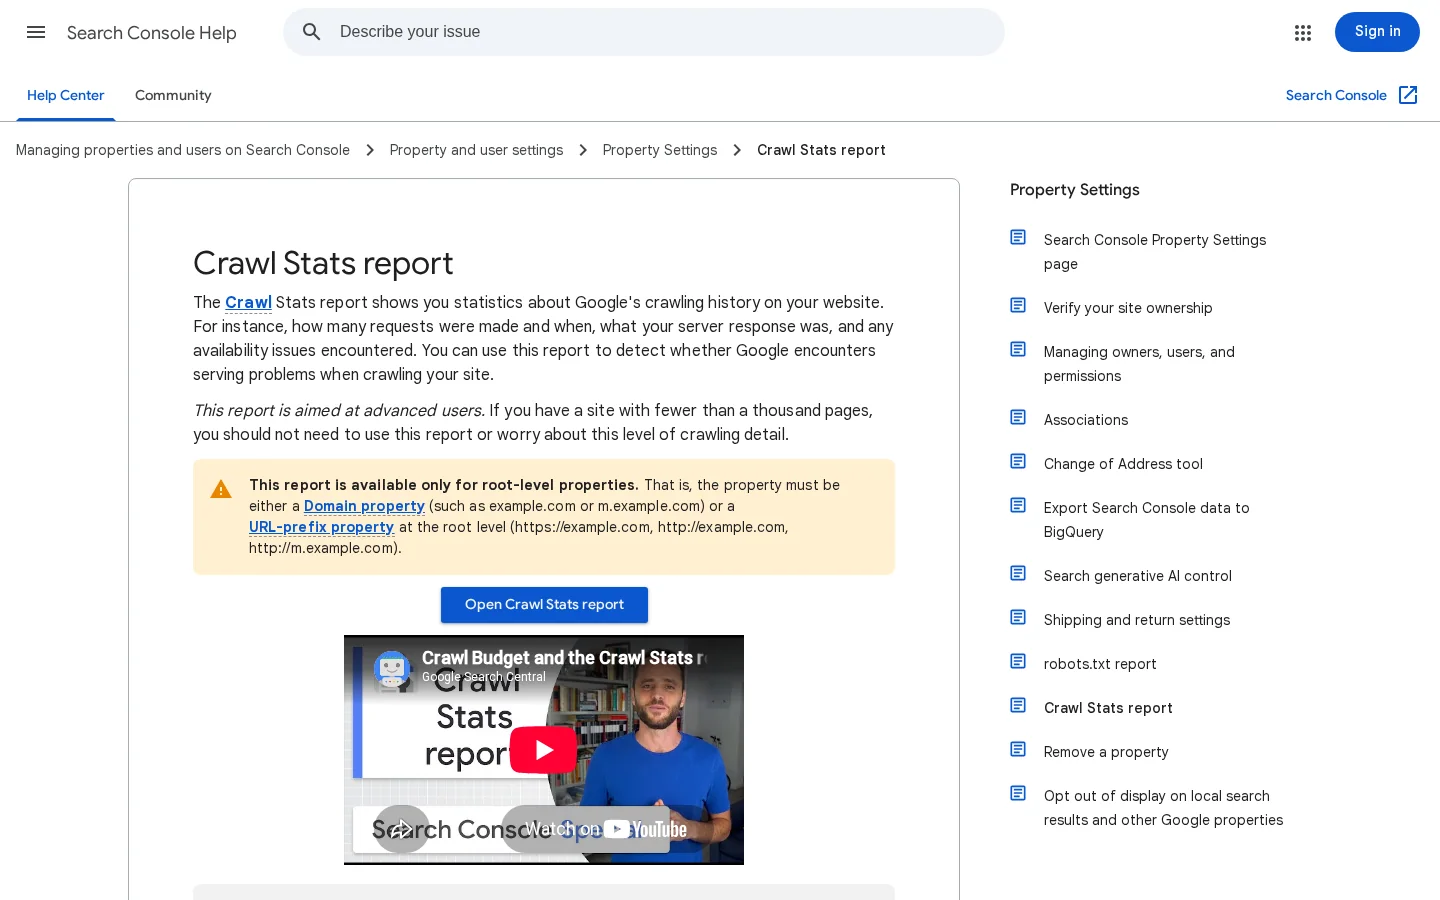
De helppagina van Google voor het rapport Crawlstatistieken.
Dit telt elk onderdeel en zo lees je het.
Onderdeel van het rapport
Wat het telt
Hoe je het leest
Totaal aan crawlverzoeken
Alle verzoeken voor je URL's, geslaagd of niet, inclusief mislukte DNS-verzoeken, verbindingspogingen en redirectlussen. Pogingen die door robots.txt zijn geblokkeerd tellen ook mee.
Een plotselinge daling of stijging: controleer wijzigingen in robots.txt en je URL-structuur op dezelfde data.
Totale downloadgrootte
De bytes die tijdens het crawlen zijn gedownload. Een gecachte bron telt alleen bij het eerste verzoek.
Stijgen de bytes terwijl de verzoeken gelijk blijven, dan zijn je pagina's zwaarder geworden.
Gemiddelde responstijd
De gemiddelde tijd om elke bron op te halen, waarbij elke gekoppelde bron apart telt.
Let op de trend, niet op één waarde. Houd het in de gaten na elke release.
Hoststatus
Ophalen van robots.txt, DNS-resolutie en bereikbaarheid van de server. Groen betekent geen noemenswaardig probleem in de afgelopen 90 dagen, geel betekent problemen van meer dan een week geleden, rood betekent problemen in de afgelopen week.
Elk rood of geel punt is eerst een server- of netwerkprobleem, pas daarna een SEO-probleem.
Crawlreacties
Het aandeel reacties per type, op basis van het aantal verzoeken.
Volg het aandeel slechte reacties in de tijd. Het ruwe aantal telt minder.
Bestandstype
Het aandeel reacties per type: HTML, afbeelding, JavaScript, CSS, PDF, JSON, video. Gebaseerd op het aantal reacties, niet op bytes.
Laat zien waar Googlebot zijn verzoeken aan besteedt. Een groot aandeel JavaScript en CSS betekent dat je pagina's van veel bronnen afhangen.
Crawldoel
Ontdekking (een URL die Google nog nooit had gecrawld) of vernieuwing (een nieuwe crawl van een bekende URL).
Zie de sectie over ontdekking en vernieuwing hieronder.
Googlebot-type
Smartphone, Desktop, Afbeelding, Video, Laden van paginabronnen, AdsBot, StoreBot, overig.
Bij een site die mobile-first is geïndexeerd, hoort Smartphone de grootste groep te zijn. Een plotselinge verschuiving verdient controle.
Percentages tellen verzoeken, geen URL's
Elke uitsplitsing telt verzoeken. Een URL die Googlebot 50 keer ophaalt, telt 50 keer. «40% van de reacties is 301» betekent dus dat zoveel verzoeken op een redirect uitkomen, niet hoeveel URL's doorverwijzen. Om te weten welke URL's erbij betrokken zijn, heb je je logs nodig. De voorbeeld-URL's die Google toont, zijn een steekproef, en Google zegt dat ze niet volledig zijn.
Wat het rapport niet laat zien
De helppagina van Google zegt dat het rapport momenteel de meeste crawlverzoeken meetelt, maar dat sommige verzoeken misschien niet worden geteld. Er staat ook dat mislukte verzoeken die je server nooit bereiken niet in je logs verschijnen. Daarom toont het rapport DNS- en verbindingsfouten die je logs niet kunnen tonen, en daarom is het verstandig beide bronnen te lezen. Google noemt geen bewaartermijn voor de grafieken, dus wil je een geschiedenis, bewaar dan elke maand zelf een kopie, met een screenshot of een notitie van de cijfers.
Elk verzoek van Googlebot reist van Google naar je pagina's, en elke reactie wordt vastgelegd.
De responscodes lezen, stap voor stap
De uitsplitsing van reacties is het deel van het rapport dat het vaakst tot een oplossing leidt. Lees het in deze volgorde en stop bij de eerste stap die een echt probleem laat zien.
De crawlreacties in vijf stappen sorteren
Controleer de hoststatusRood of geel bij robots.txt, DNS of bereikbaarheid betekent dat Googlebot je site helemaal niet kon bereiken. Los dit eerst op.
Kijk naar de slechte reacties5XX, overige 4XX, robots.txt niet beschikbaar, time-outs en redirectfouten. Noteer hun aandeel en of het van week tot week verandert.
Controleer het aandeel redirectsVeel 301- en 302-reacties betekenen dat Googlebot verzoeken besteedt aan tussenstappen in plaats van aan pagina's.
Bevestig de 404'sEen 404 is prima als de pagina bewust is verwijderd. Het is een probleem als je interne links of sitemap er nog naar verwijzen.
Haal de URL's uit de logsMaak van elke slechte categorie een lijst met URL's en los dan de bron van de links op, niet het rapport.
Goede, mogelijk goede en slechte reacties
Google verdeelt de reacties in drie groepen. De indeling is een eerste filter, geen oordeel over elke URL.
Goed: 200, 301, 302, 304 en meta refresh.
Mogelijk goed: 404.
Slecht: robots.txt niet beschikbaar, 401 en 407, 5XX, overige 4XX, DNS-fouten, ophaalfouten, time-outs en redirectfouten.
Een 401 telt in het rapport als slecht, maar het is correct als de pagina achter een login zit die gesloten moet blijven. Beslis per URL. Het rapport vertelt je welke groep je moet bekijken, en jij bepaalt wat elke reactie zou moeten zijn.
Redirects: de kosten die je niet ziet
Een 302 telt als goede reactie, dus een aandeel redirects kan gezond lijken terwijl het toch crawlcapaciteit verspilt. In een analyse van een grote site, gepubliceerd in april 2021 op Search Engine Journal door Tomek Rudzki van Onely, ging 16% van de verzoeken naar doorverwezen pagina's, en de auteur adviseerde elke redirectstap na te lopen.
Zo werkt een keten nadelig. Stel dat /blog/seo-tips doorverwijst naar /blog/seo-tips-2025, dat op zijn beurt doorverwijst naar /blog/seo-tips-guide. Googlebot heeft drie verzoeken nodig om bij de inhoud te komen, en elke interne link die nog naar de eerste URL wijst, herhaalt die kosten. Laat de eerste URL direct naar het eindadres wijzen en werk de interne links bij zodat ze de oude paden niet meer gebruiken. De gratis redirectchecker volgt de keten van elke URL stap voor stap, zodat je het pad ziet voordat je het oplost. Weet je niet zeker of een redirect permanent moet zijn, lees dan onze gids over 301- en 302-redirects: een 301 zegt dat de verhuizing permanent is, een 302 dat ze tijdelijk is.
Tip
Sorteer je redirect-URL's op hoe vaak Googlebot ze in je logs opvraagt. Los eerst de vijf meest opgevraagde ketens op. Die verklaren meestal het grootste deel van het aandeel redirects.
5XX en 429: het signaal dat de crawlsnelheid verlaagt
De gids van Google voor grote sites zegt dat Google zijn crawllimiet verlaagt wanneer een site reageert met serverfouten (5XX) of met signalen van snelheidsbeperking, zoals HTTP 429. Een piek in 5XX kost je dus meer dan de kapotte URL's. Het kan ook de crawl van je gezonde pagina's vertragen. Het crawlbudget van een site hangt deels af van hoe goed de server antwoordt, en 5XX-reacties verkleinen dat deel.
Zie je een piek in 5XX, let dan op het moment waarop die optreedt. Fouten op hetzelfde uur elke dag wijzen naar een back-up, een geplande import of een verkeerspiek. Fouten direct na een release wijzen naar die release. Fouten die over de hele dag verspreid zijn, wijzen naar een capaciteitsprobleem. Elk patroon heeft een andere oplossing, en geen daarvan los je op door één pagina te bewerken.
Ontdekking, vernieuwing en bestandstype: wat de verhoudingen zeggen
De uitsplitsing naar crawldoel verdeelt de verzoeken in ontdekking, wanneer Google een URL voor het eerst ziet, en vernieuwing, wanneer Google een URL opnieuw crawlt die het al kende. De verhouding tussen die twee laat zien waar Google zijn tijd aan besteedt.
Een hoog aandeel ontdekking op een site die weinig pagina's toevoegt betekent dat Google steeds nieuwe URL's blijft vinden. Zoek naar URL-generatoren: filter- en sorteerparameters, interne zoekresultaatpagina's, kalenderarchieven, sessie-ID's. Elk maakt URL's die nieuw lijken.
Een hoog aandeel vernieuwing op pagina's die nooit veranderen betekent dat Google ze steeds opnieuw bezoekt. Controleer of die pagina's 304 Not Modified teruggeven. Google zegt dat een 304 voor een ongewijzigde pagina betekent dat het de kopie die het al heeft mag hergebruiken. Geven dezelfde pagina's bij elk bezoek een 200 met alle bytes terug, dan stuurt je server bij elk bezoek de hele pagina.
Een grote site, een crawldag
7460pagina's per dag gecrawld gemiddeld
35%van die crawls waren ontdekkingscrawls, voor URL's die Google nog nooit had opgehaald
Bron: Tomek Rudzki (Onely), Search Engine Journal, april 2021. Een site van ongeveer 1 miljoen pagina's, met een achterstand aan URL's «Ontdekt, momenteel niet geïndexeerd».
Dezelfde analyse maakte een bruikbare ruwe schatting. In dat tempo berekende ze dat de achterstand ongeveer een jaar zou kosten om te crawlen. Dat getal is de berekening van één auteur voor één site, en de screenshots dateren uit 2021, dus neem het niet over. De methode werkt nog steeds met je eigen gegevens: deel het aantal URL's dat op ontdekking wacht door het aantal ontdekkingscrawls per dag in je rapport. Komt het resultaat in maanden uit, dan heb je een crawlprobleem dat je moet oplossen voordat je meer publiceert.
De uitsplitsing naar bestandstype telt reacties, geen bytes. Ze laat dus zien hoeveel verzoeken naar elk type bron gaan, niet hoe zwaar ze zijn. Redirects vallen onder «Overig bestandstype», en mislukte verzoeken verschijnen als «Onbekend (mislukt)». Een groeiend aandeel «Onbekend (mislukt)» is een foutsignaal, geen bestandstype, en hoort bij de slechte reacties.
Crawlstatistieken, serverlogs en URL-inspectie: drie blikken op Googlebot
Er zijn drie manieren om te zien wat Googlebot op je site heeft gedaan: het rapport Crawlstatistieken, je serverlogs en het hulpmiddel URL-inspectie van Search Console. Elk beantwoordt een andere vraag, en elk heeft blinde vlekken die de andere twee dekken. Gebruik voor een echt probleem alle drie.
Het rapport Crawlstatistieken
Principe: een samenvatting van de verzoeken van Googlebot voor een hele eigenschap, berekend door Google. Wanneer gebruiken: voor trends, de hoststatus en het eerste overzicht van een probleem. Voordelen: het is gratis, het dekt fouten die je server nooit bereiken, en het voegt doel en Googlebot-type toe, wat logs niet direct geven. Beperkingen: het is een samenvatting, sommige verzoeken worden misschien niet geteld en de voorbeeld-URL's zijn een steekproef. Voorbeeld: het aandeel 5XX stijgt drie dagen lang op één host. Het rapport vertelt je de dagen en de host, je logs vertellen je de URL's en de uren.
Serverlogs
Principe: het ruwe logboek dat je webserver schrijft voor elk verzoek dat hij ontvangt. Wanneer gebruiken: om exacte URL-lijsten, statuscodes per uur en het bewijs achter een trend in het rapport te krijgen. Voordelen: volledig voor elk verzoek dat je server heeft bereikt, met de exacte URL en statuscode. Beperkingen: ze bevatten geen verzoeken die al vóór de server zijn mislukt, de user-agent-string kan vervalst zijn, en de meeste servers roteren of wissen logs na een vaste periode. Dit commando telt de statuscodes van verzoeken die als Googlebot zijn herkend, in een log in het combined-formaat:
Het commando zoekt de user-agent-string en telt daarna de statuscode, het negende veld in het combined-formaat. Schrijft je server een ander formaat, pas dan het veldnummer aan. Het resultaat is een tabel met aantallen per statuscode, de meest voorkomende bovenaan.
Let op
Iedereen kan een verzoek sturen dat zegt Googlebot te zijn. Controleer voordat je reageert op een verdachte piek of de IP-adressen bij Google horen. Google documenteert hiervoor een reverse DNS-controle, en die is het waard om te doen voordat je iets op basis van de user-agent blokkeert of doorverwijst.
Het hulpmiddel URL-inspectie
Principe: een controle van één URL, die laat zien wanneer Google die voor het laatst heeft opgehaald, wat het heeft ontvangen en of hij geïndexeerd is. Wanneer gebruiken: om één oplossing te bevestigen, bijvoorbeeld of Google een gecorrigeerde pagina heeft opgehaald nadat je die hebt aangepast. Voordelen: snel, exact en makkelijk te lezen voor één URL. Beperkingen: één URL tegelijk, dus het kan geen patroon over de hele site tonen. In de eerder genoemde analyse liet het hulpmiddel zien dat een belangrijke categoriepagina drie maanden niet was gecrawld, en de auteur gebruikte het voor die pagina in plaats van de logs.
Rapport Crawlstatistieken tegenover serverlogs
Rapport Crawlstatistieken
Telt mislukte DNS- en verbindingspogingen
Toont hoststatus en Googlebot-type
Toont voorbeeld-URL's, niet alle
Sommige verzoeken worden misschien niet geteld
Serverlogs
Elk verzoek dat je server heeft bereikt
Exacte URL en statuscode per verzoek
Missen mislukte DNS- en verbindingspogingen
User-agent kan vervalst zijn
Methode
Vraag die het beantwoordt
Bereik
Blinde vlek
Rapport Crawlstatistieken
Is Googlebot gezond, en hoe gedraagt hij zich in het algemeen?
De hele eigenschap, samengevat
Steekproef van voorbeeld-URL's, en sommige verzoeken worden misschien niet geteld
Serverlogs
Welke exacte URL's kregen welke reactie, en wanneer?
Elk verzoek dat je server heeft bereikt
Mislukte DNS- en verbindingspogingen, en user-agents die vervalst kunnen zijn
URL-inspectie
Wanneer heeft Google deze pagina voor het laatst opgehaald, en wat kreeg het?
Eén URL
Zegt niets over de rest van de site
Een maandelijkse controle, stap voor stap
Eén maand gegevens zegt weinig. Het rapport wordt pas nuttig als je het vergelijkt met je normale situatie. Houd daarom een korte notitie bij en bekijk die elke maand op dezelfde dag. Dit is de routine die voor de meeste sites werkt.
De maandelijkse controle in zes stappen
Bewaar de maandMaak een screenshot of noteer de drie grafieken, de hoststatus en de uitsplitsing van reacties.
Vergelijk met je uitgangspuntEen verandering in het totaal aan verzoeken kan normaal zijn na een maand met veel publicaties. Een nieuw aandeel 5XX verdient altijd aandacht.
Controleer in volgordeEerst de hoststatus, dan de slechte reacties, dan het aandeel redirects.
Haal de URL's opHaal voor elke slechte categorie de belangrijkste URL's uit je logs voor dezelfde periode.
Los de bron opDe interne links, de redirectregels, de servercapaciteit of de robots.txt-regel. Niet de grafiek.
Noteer de wijzigingSchrijf de datum van elke oplossing op en lees de volgende maand met die datum in gedachten.
Signalen die deze maand actie verdienen
De hoststatus is geel of rood bij een van de drie controles
Het aandeel 5XX stijgt meerdere dagen achter elkaar, of piekt op hetzelfde uur
Redirectreacties nemen toe na een siteverandering die ze juist had moeten verwijderen
Het aandeel ontdekking blijft hoog op een site die weinig publiceert
Eén slechte dag zonder verandering in de logs: dat is ruis tot het zich herhaalt
Voor en na een migratie
Stel dat je je blog met 301-redirects verhuist van /old-blog/ naar /blog/. Direct na de verhuizing mag je een stijging van het aandeel redirects verwachten, omdat Googlebot nog steeds de oude paden opvraagt. In de weken daarna zou het aandeel moeten dalen naarmate Google de nieuwe URL's leert. Verwacht ook een stijging van het aandeel ontdekking, omdat de nieuwe URL's nieuw zijn voor Google. Blijft het aandeel redirects na meerdere weken hoog, zoek dan naar ketens, oude interne links of redirects die je bent vergeten toe te voegen. Onze gids over het repareren van gebroken links behandelt de linkkant van dezelfde opruiming.
Veelgemaakte fouten en hoe je ze voorkomt
De meeste fouten ontstaan doordat je één grafiek als oordeel leest. Elk van de vijf hieronder heeft een duidelijk teken in het rapport en een oplossing die je in je logs kunt controleren.
Het totaal aan crawlverzoeken lezen als score
Wat het is: aannemen dat meer crawlverzoeken betekenen dat de SEO beter is. Hoe je het herkent: de verzoeken stijgen sterk na een release die filter- of sorteeropties heeft toegevoegd, en de nieuwe URL's hebben parameters. Hoe je het oplost: controleer het aandeel ontdekking en de URL-patronen in je logs. Los de URL-generator op: stop met linken naar URL's met parameters, of zet canonicals en blokkeer de URL's die geen zoekwaarde hebben. Meer verzoeken met rommel is een kostenpost, geen winst.
Vertrouwen op de gemiddelde responstijd
Wat het is: naar het gemiddelde kijken en de pieken missen die het verbergt. Hoe je het herkent: het gemiddelde ziet er vlak uit, maar je logs tonen elke nacht trage reacties op hetzelfde uur. Hoe je het oplost: groepeer je logs per uur en per URL, en vergelijk daarna de trage uren met je back-ups, imports en releases. Los de trage taak of de trage template op en controleer daarna het gemiddelde opnieuw. Het gemiddelde is een trendlijn, en een trendlijn vertelt je niet waar de vertraging begint.
De hoststatus negeren terwijl je pagina's goed laden
Wat het is: aannemen dat de site gezond is omdat hij in je browser opent. Hoe je het herkent: de hoststatus staat op geel of rood voor robots.txt, DNS of bereikbaarheid, terwijl je pagina's voor jou werken. Googlebot bereikt je site via andere netwerkroutes, en een firewall, een CDN-regel of een DNS-record kan hem blokkeren zonder je browser te raken. Hoe je het oplost: controleer met de robots.txt-checker of je robots.txt laadt met een 200-reactie, en bekijk daarna je firewall- en CDN-regels op de data waarop de status op rood sprong.
De crawl blokkeren en de daling lezen als vooruitgang
Wat het is: een wijziging in robots.txt die crawlverzoeken verlaagt, gevolgd door een rapport dat rustiger lijkt. Hoe je het herkent: het totaal aan verzoeken valt sterk op de dag van een wijziging in robots.txt. Hoe je het oplost: een daling kan goed zijn als je nutteloze paden hebt geblokkeerd, maar controleer of je belangrijke secties nog steeds worden gecrawld. Kijk in de logs naar de secties die ertoe doen. Is een pagina die je nodig hebt geblokkeerd, dan legt onze gids over de status geblokkeerd door robots.txt uit hoe je de regel vindt en wat je moet wijzigen.
Crawlen en indexeren door elkaar halen
Wat het is: een goed gecrawlde pagina behandelen als een geïndexeerde pagina. Hoe je het herkent: Googlebot vraagt een URL regelmatig op, maar de URL verschijnt niet in de resultaten van Google. Een hoog aantal crawls bewijst niet dat Google de pagina bewaart. Hoe je het oplost: ga van het rapport Crawlstatistieken naar de rapporten over paginaindexering en controleer de status van de URL. Onze gids over gecrawld, momenteel niet geïndexeerd legt de oorzaken uit, en de gids over indexering door Google behandelt de controles in volgorde.
Fout
Hoe je het herkent
Hoe je het oplost
Totaal aan verzoeken gelezen als score
Verzoeken stijgen nadat er URL-parameters verschijnen
Stop met het maken van de rommel-URL's en tel opnieuw
Alleen de gemiddelde responstijd
Trage uren verborgen door een vlak gemiddelde
Groepeer logs per uur, koppel trage uren aan taken
Hoststatus genegeerd
Geel of rood terwijl pagina's in de browser openen
Controleer robots.txt, DNS, firewall en CDN-regels
Daling van de crawl gelezen als vooruitgang
Verzoeken dalen op de dag van een wijziging in robots.txt
Bevestig dat belangrijke secties nog steeds worden gecrawld
Crawlen verward met indexeren
Regelmatige crawls, URL ontbreekt in de resultaten
Controleer de indexeringsstatus van de URL
Waar Sorank past en wat je daarna doet
Het GEO / SEO-dashboard van Sorank zet je clicks, vertoningen, CTR en posities uit Search Console naast de bezoeken die AI-assistenten je sturen, gelezen uit Google Analytics. Het toont geen verzoeken van Googlebot, dus voor die taak houd je het rapport Crawlstatistieken. De twee tools beantwoorden verschillende vragen: het dashboard laat zien wat Google je stuurt, en Crawlstatistieken laat zien hoe Google je server bezoekt.
Tip
Voordat je tijd in je logs steekt voor één pagina, controleer dan of Google haar kan indexeren met de gratis indexeerbaarheidschecker. Die beantwoordt die eerste vraag in seconden.
Het rapport Crawlstatistieken is een goed eerste scherm. Het laat zien welk soort probleem je moet vermoeden en op welke data. De oplossing zit bijna altijd in een lijst met URL's, en die lijst staat in je logs. Begin met het rapport en ga daarna naar de URL's.
Veelgestelde vragen
Waar vind ik het rapport Crawlstatistieken in Google Search Console?
Open je eigenschap, ga naar Instellingen, selecteer Crawlstatistieken en klik op Rapport openen. Het rapport bestaat alleen voor Domein-eigenschappen en URL-prefix-eigenschappen op hoofdniveau, dus een eigenschap voor een submap toont het niet.
Is een groot aantal crawlverzoeken een goed teken?
Niet op zichzelf. Het totaal telt elk verzoek, ook mislukte en door robots.txt geblokkeerde pogingen, dus het laat zien hoe vaak Googlebot langskomt, niet hoe gezond die bezoeken zijn. Lees het samen met de responscodes en de gemiddelde responstijd.
Kan ik op Crawlstatistieken vertrouwen in plaats van op serverlogs?
Niet alleen. Google zegt dat sommige verzoeken misschien niet worden geteld en dat de voorbeeld-URL's niet volledig zijn. Gebruik het rapport voor trends en foutcategorieën, en je logs voor de exacte URL's.
y!
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je $1500 per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer


 Search Console