Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Lær at læse hvert diagram i rapporten Crawlstatistik i  Google Search Console, hvad den misser i forhold til serverlogs, og hvordan du retter det, den viser.

Værktøjer

Kort fortalt
Rapporten Crawlstatistik i Google Search Console viser, hvordan Googlebot henter dine URL'er: hvor mange anmodninger den sender, hvor mange bytes den henter, hvor hurtigt din server svarer, og hvilke statuskoder den får tilbage. Læs først værtsstatus, derefter svarkoderne og til sidst fordelingen efter formål og filtype. Rapporten er et resumé, ikke en log, så brug den til at finde problemet og bekræft det derefter i dine serverlogs.
Vil du vide mere? Spørg
Hurtig quiz
Hvem skal rette den tekniske side af dit site?
Vores anbefaling til dig
Tjek det selv med gratis Google-værktøjer
Search Console lister de sider, Google ikke kan læse, og PageSpeed Insights tester hastigheden. Mange små problemer rettes fra indstillingerne i dit website-værktøj.
Vores anbefaling til dig
En webudvikler
Dit problem sidder i koden eller serveren: en udvikler, der kender SEO, er den rette person. Giv dem listen over fejl fra Search Console.
Vores anbefaling til dig
Et værktøj til teknisk revision
Dit site har mange sider: en crawler læser dem alle, ligesom Google gør, og giver en komplet liste over fejl at rette, side for side.
Vores anbefaling til dig
En automatisk revision, derefter indhold
Dit site virker, men bringer få besøgende: tekniske problemer er sjældent årsagen. Sorank reviderer sitet og skriver derefter de sider, der giver trafik.
Crawlstatistik er et Google-perspektiv på Googlebots aktivitet på din side. Den viser, hvad Googlebot gjorde, ikke hvorfor dine sider rangerer eller ikke rangerer. Google beskriver rapporten som rettet mod avancerede brugere, og en side med under tusind sider har måske slet ikke brug for den. Hvis du driver en lille brochureside, kan du springe den over, indtil noget ændrer sig.
Search Console er ét produkt med mange rapporter. Den offentlige side dækker crawling og indeksering generelt: sitemaps, URL-inspektion og indekseringsdækning. Crawlstatistik ligger under Indstillinger i stedet for i hovedmenuen, og det er grunden til, at mange aldrig åbner den.
Rapporten findes kun for ejendomme på rodniveau: en domæneejendom eller en URL-præfiksejendom bygget på sidens rod. En ejendom for en undermappe, fx example.com/blog/, får den ikke. Dataene dækker kun det domæne, du vælger. Anmodninger til søskende-subdomæner vises ikke i et andet subdomænes rapport, men en visning af et overordnet domæne inkluderer alle underdomæner. Både http og https tælles med i samme visning.
Note
Hvis din side bruger sprogsubdomæner, fx en.example.com og de.example.com, så åbn hver enkelt for sig. Hver har sine egne data, og et ødelagt tysk subdomæne vises ikke i den engelske visning.
Åbn rapporten, når en af disse er sand: du udgiver mange sider, du har ændret din URL-struktur eller din hosting, Googlebot ser ud til at besøge mindre end før, eller sider opdages, men indekseres aldrig. En side, der tilføjer nogle få artikler om måneden, har lidt at lære af den, bortset fra fejl, og de fejl findes bedre i et almindeligt crawl af siden.
Åbn din ejendom, gå til Indstillinger, find Crawlstatistik og klik på Åbn rapport. Øverst får du tre diagrammer: samlede crawl-anmodninger, samlet downloadstørrelse og gennemsnitlig svartid. Nedenunder får du værtsstatus og fire fordelinger: crawl-svar, filtype, crawl-formål og Googlebot-type. Hver fordeling er en procentdel baseret på antal anmodninger.
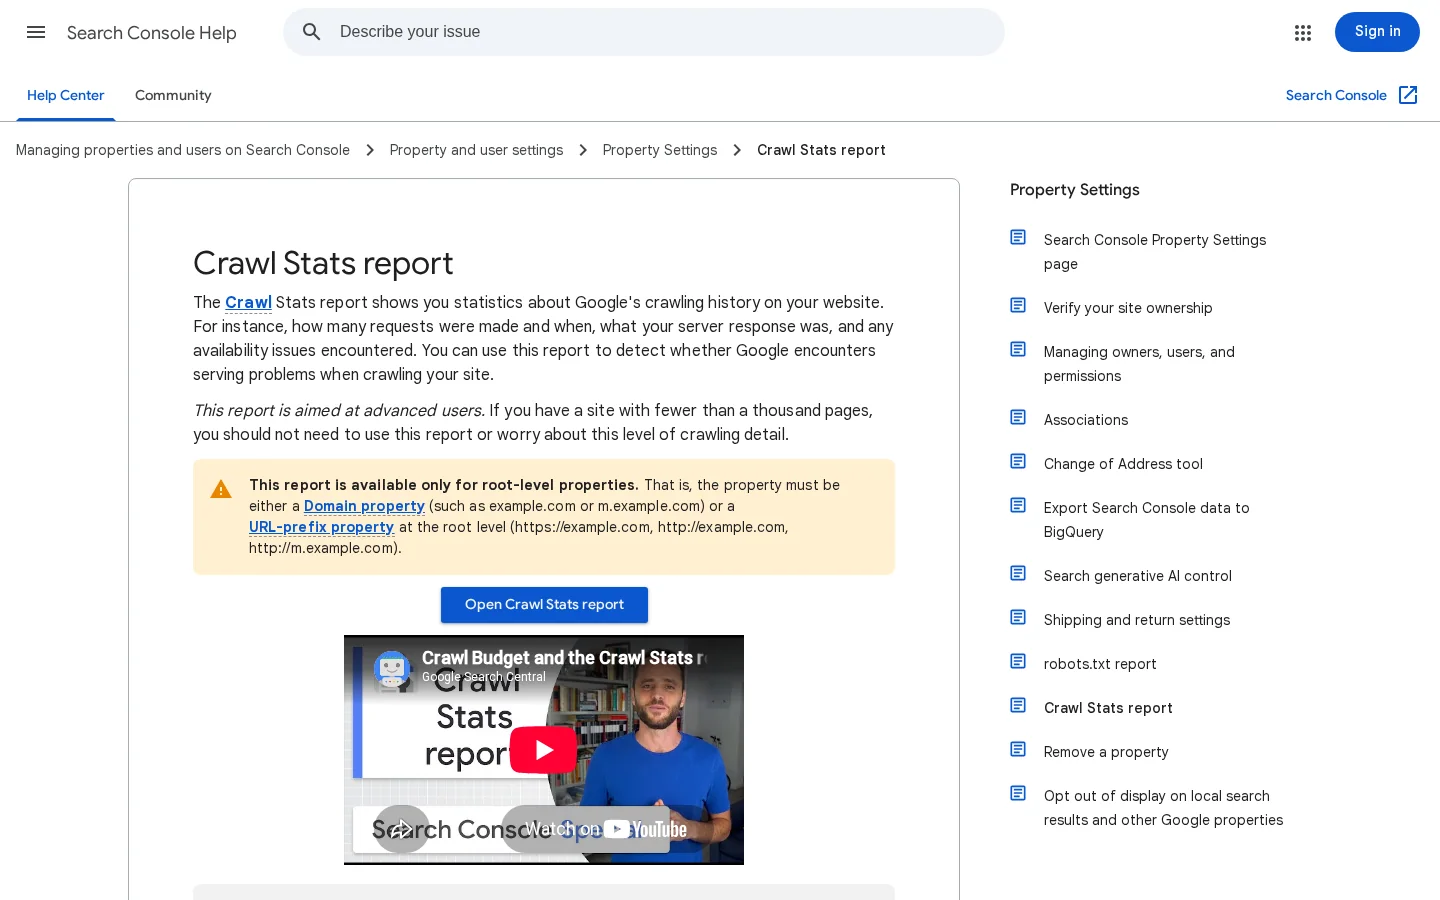
Sådan læser du hver del, og hvad den tæller.
| Del af rapporten | Hvad den tæller | Sådan læser du den |
|---|---|---|
| Samlede crawl-anmodninger | Alle anmodninger om dine URL'er, lykkedes eller ej, inklusive mislykkede DNS-, forbindelses- og omdirigeringsløkkeforsøg. Forsøg blokeret af robots.txt tælles også med. | En pludselig stigning eller fald: tjek dine robots.txt-ændringer og din URL-struktur for de samme datoer. |
| Samlet downloadstørrelse | Bytes downloadet under crawling. En cachet ressource tæller kun ved første anmodning. | Stigende bytes, mens anmodningerne er stabile, betyder at dine sider er blevet tungere. |
| Gennemsnitlig svartid | Gennemsnitlig tid til at hente hver ressource, hvor hver linket ressource tælles separat. | Læs tendensen, ikke én værdi. Følg den efter hver udrulning. |
| Værtsstatus | Hentning af robots.txt, DNS-opløsning og serverforbindelse. Grøn betyder ingen væsentlige problemer de seneste 90 dage, gul betyder problemer ældre end en uge, og rød betyder problemer inden for den seneste uge. | Ethvert rødt eller gult punkt er et server- eller netværksproblem, før det er et SEO-problem. |
| Crawl-svar | Andelen af svar pr. type, baseret på antal anmodninger. | Følg andelen af dårlige svar over tid. Det rå antal betyder mindre. |
| Filtype | Andelen af svar pr. type: HTML, billede, JavaScript, CSS, PDF, JSON og video. Baseret på antal svar, ikke bytes. | Viser, hvor Googlebot bruger sine anmodninger. Store andele af JavaScript og CSS betyder, at dine sider afhænger af mange ressourcer. |
| Crawl-formål | Opdagelse (en URL Google aldrig havde crawlet) eller genopfriskning (en gencrawl af en kendt URL). | Se afsnittet om opdagelse og genopfriskning nedenfor. |
| Googlebot-type | Smartphone, Desktop, Image, Video, Page resource load, AdsBot, StoreBot og andet. | På en side, der indekseres mobile-first, bør Smartphone være den største gruppe. Et pludseligt skift er værd at tjekke. |
Hver fordeling tæller anmodninger. En URL, som Googlebot henter 50 gange, tælles 50 gange. Så "40% af svarene er 301" fortæller dig, hvor mange anmodninger der rammer en omdirigering, ikke hvor mange URL'er der omdirigerer. For at finde ud af hvilke URL'er det drejer sig om, har du brug for dine logs. Eksempel-URL'erne, som Google viser, er en stikprøve, og Google siger, at de ikke er udtømmende.
Googles hjælpeside siger, at rapporten i øjeblikket viser de fleste crawl-anmodninger, men at nogle anmodninger muligvis ikke tælles med. Den siger også, at mislykkede anmodninger, som aldrig når din server, ikke vises i dine logs. Derfor viser rapporten DNS- og forbindelsesfejl, som dine logs ikke kan vise, og derfor bør du læse begge kilder. Google oplyser ingen opbevaringsperiode for diagrammerne, så gem selv en kopi hver måned, med et skærmbillede eller en kort note med tallene, hvis du vil have historik.
Svarfordelingen er den del af rapporten, der oftest fører til en rettelse. Læs den i denne rækkefølge, og stop ved det første trin, der viser et reelt problem.
Sortér crawl-svarene i fem trin
Google sorterer svarene i tre grupper. Inddelingen er et første filter, ikke en dom over hver enkelt URL.
Et 401 tæller som dårligt i rapporten, men det er korrekt, hvis siden ligger bag et login, der skal være lukket. Afgør det URL for URL. Rapporten fortæller dig, hvilken gruppe du skal kigge på, og du bestemmer, hvad hvert svar skal være.
Et 302 tæller som et godt svar, så en andel omdirigeringer kan se sund ud, mens den stadig spilder crawling. I en analyse af en stor side, udgivet i april 2021 på Search Engine Journal af Tomek Rudzki fra Onely, gik 16% af anmodningerne til omdirigerede sider, og forfatteren anbefalede at tjekke hvert omdirigeringsled.
Sådan skader en kæde. Antag at /blog/seo-tips omdirigerer til /blog/seo-tips-2025, som omdirigerer til /blog/seo-tips-guide. Googlebot skal bruge tre anmodninger for at nå indholdet, og hvert internt link, der stadig peger på den første URL, gentager omkostningen. Peg den første URL direkte på den endelige adresse, og opdater de interne links, så de holder op med at bruge de gamle stier. Værktøjet til tjek af omdirigeringer følger en URL's kæde trin for trin, så du kan se vejen, før du retter den. Hvis du er usikker på, om en omdirigering skal være permanent, så læs vores guide om 301 vs. 302-omdirigeringer: en 301 siger, at flytningen er permanent, en 302 siger, at den er midlertidig.
Tip
Sortér dine omdirigerings-URL'er efter, hvor ofte Googlebot anmoder om dem i dine logs. Ret de fem mest anmodede kæder først. De står typisk for det meste af andelen af omdirigeringer.
Googles guide til store sider siger, at når en side svarer med serverfejl (5XX) eller signaler om hastighedsbegrænsning, såsom HTTP 429, sænker Google sin crawl-hastighedsgrænse. En stigning i 5XX koster dig altså mere end de ødelagte URL'er. Den kan også bremse crawlingen af dine sunde sider. Crawl-budgettet for en side afhænger delvist af, hvor godt serveren svarer, og 5XX-svar gør den del mindre.
Når du ser en stigning i 5XX, så kig på hvornår den sker. Fejl på samme klokkeslæt hver dag peger på et backup-job, en planlagt import eller en trafiktop. Fejl lige efter en udrulning peger på udrulningen. Fejl spredt over hele dagen peger på kapacitet. Hvert mønster har en anden løsning, og ingen af dem løses ved at redigere en enkelt side.
Fordelingen efter crawl-formål opdeler anmodningerne i opdagelse, når Google ser en URL for første gang, og genopfriskning, når den genbesøger en URL, den allerede kender. Forholdet mellem dem fortæller dig, hvad Google bruger sin tid på.
En stor side, en crawl-dag
Kilde: Tomek Rudzki (Onely), Search Engine Journal, april 2021. En side med cirka en million sider og en baglog af URL'er med status "Discovered, currently not indexed".
Den samme analyse lavede et nyttigt groft tjek. I det tempo vurderede den, at bagloggen ville tage cirka et år at crawle. Tallet er én forfatters beregning fra én side, og skærmbillederne er fra 2021, så kopiér det ikke. Metoden virker stadig på dine egne data: divider antallet af URL'er, der venter på opdagelse, med antallet af opdagelses-crawls pr. dag i din rapport. Hvis svaret måles i måneder, har du et crawl-problem at løse, før du udgiver mere.
Fordelingen af filtyper tæller svar, ikke bytes, så den viser, hvor mange anmodninger der går til hver ressourcetype, ikke hvor tunge de er. Omdirigeringer havner under "Other file type", og mislykkede anmodninger vises som "Unknown (Failed)". En voksende andel Unknown (Failed) er et fejlsignal, ikke en filtype, og den bør behandles sammen med de dårlige svar.
Der er tre måder at se, hvad Googlebot gjorde på din side: rapporten Crawlstatistik, dine serverlogs og URL-inspektionsværktøjet i Search Console. Hver besvarer et andet spørgsmål, og hver har blinde vinkler, som de to andre dækker. Til et reelt problem bør du bruge alle tre.
Princip: et resumé af Googlebots anmodninger for en hel ejendom, beregnet af Google. Hvornår du bruger den: til tendenser, værtsstatus og det første overblik over et problem. Fordele: den er gratis, den dækker fejl, der aldrig når din server, og den tilføjer formål og Googlebot-type, som logs ikke giver dig direkte. Begrænsninger: den er et resumé, nogle anmodninger tælles muligvis ikke med, og eksempel-URL'erne er en stikprøve. Eksempel: andelen af 5XX stiger i tre dage på én vært. Rapporten viser dagene og værten, og dine logs viser URL'erne og timerne.
Princip: den rå registrering, din webserver skriver for hver anmodning, den modtager. Hvornår du bruger dem: til præcise URL-lister, statuskoder pr. time og det grundlag, der ligger bag en tendens i rapporten. Fordele: fuldstændige for hver anmodning, der nåede din server, med præcis URL og statuskode. Begrænsninger: de indeholder ikke anmodninger, der fejlede, før de nåede serveren, user agent kan forfalskes, og de fleste servere roterer eller sletter logs efter en bestemt periode. Her er en kommando, der tæller statuskoderne for anmodninger, der identificeres som Googlebot, i en log i combined-format:
grep "Googlebot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnKommandoen matcher user agent-strengen og tæller derefter statuskoden, som er det niende felt i combined-loggformatet. Hvis din server skriver et andet format, så ændr feltnummeret. Resultatet er en tabel med antal pr. statuskode, med den hyppigste kode først.
Advarsel
Hvem som helst kan sende en anmodning, der udgiver sig for at være Googlebot. Før du handler på en mistænkelig stigning, så bekræft at IP-adresserne tilhører Google. Google dokumenterer et tjek med omvendt DNS til dette, og det er værd at gøre, før du blokerer eller omdirigerer noget ud fra user agent'en.
Princip: et tjek af én URL, der viser, hvornår Google sidst hentede den, hvad den fik, og om den er indekseret. Hvornår du bruger den: til at bekræfte én rettelse, fx om Google hentede en rettet side, efter du ændrede den. Fordele: hurtig, præcis og let at læse for én URL. Begrænsninger: én URL ad gangen, så den kan ikke vise et mønster på tværs af siden. I analysen nævnt ovenfor viste værktøjet, at en hovedkategoriside ikke var crawlet i tre måneder, og forfatteren brugte det som erstatning for logs på den side.
Rapporten Crawlstatistik mod serverlogs
| Metode | Spørgsmål den besvarer | Omfang | Blind vinkel |
|---|---|---|---|
| Rapporten Crawlstatistik | Er Googlebot sund, og hvordan opfører den sig samlet set? | Hele ejendommen, sammenfattet | Stikprøver af eksempel-URL'er, og nogle anmodninger tælles muligvis ikke med |
| Serverlogs | Hvilke præcise URL'er fik hvilket svar, og hvornår? | Hver anmodning, der nåede din server | Mislykkede DNS- og forbindelsesforsøg, og user agents, der kan forfalskes |
| URL-inspektion | Hvornår hentede Google denne side sidst, og hvad fik den? | Én URL | Siger intet om resten af siden |
En måned med data fortæller dig lidt. Rapporten bliver nyttig, når du sammenligner den med din egen normal, så gem en kort registrering og gennemgå den samme dag hver måned. Det er rutinen, der virker for de fleste sider.
Den månedlige gennemgang i seks trin
Signaler, der bør følges op denne måned
Antag at du flytter din blog fra /old-blog/ til /blog/ med 301-omdirigeringer. Lige efter flytningen skal du forvente, at andelen af omdirigeringer stiger, fordi Googlebot stadig spørger efter de gamle stier. I de følgende uger bør andelen falde, efterhånden som Google lærer de nye URL'er. Forvent også, at andelen af opdagelse stiger, da de nye URL'er er nye for Google. Hvis andelen af omdirigeringer forbliver høj efter flere uger, så led efter kæder, gamle interne links eller omdirigeringer, du glemte at tilføje. Vores guide til rettelse af ødelagte links dækker linkdelen af den samme oprydning.
De fleste fejl opstår, når man læser ét diagram som en dom. Hver af de fem nedenfor har et tydeligt tegn i rapporten og en rettelse, du kan tjekke i dine logs.
Hvad det er: at antage, at flere crawl-anmodninger betyder bedre SEO. Sådan opdager du det: anmodningerne stiger kraftigt efter en udgivelse, der tilføjede filter- eller sorteringsmuligheder, og de nye URL'er indeholder parametre. Sådan retter du det: tjek andelen af opdagelse og URL-mønstrene i dine logs. Ret URL-generatoren: stop med at linke til parameter-URL'er, eller sæt canonical og bloker dem, der ingen søgeværdi har. Et højere antal skraldeanmodninger er en omkostning, ikke en gevinst.
Hvad det er: at kigge på gennemsnittet og overse de toppe, det skjuler. Sådan opdager du det: gennemsnittet ser fladt ud, men dine logs viser langsomme svar på samme time hver nat. Sådan retter du det: gruppér dine logs efter time og URL, og sammenlign de langsomme timer med dine backups, importer og udrulninger. Ret det langsomme job eller den langsomme skabelon, og tjek derefter gennemsnittet igen. Gennemsnittet er en tendenslinje, og en tendenslinje kan ikke vise, hvor langsomheden begynder.
Hvad det er: at antage, at siden er sund, fordi den åbner i din browser. Sådan opdager du det: værtsstatus viser gul eller rød for robots.txt, DNS eller forbindelse, mens dine sider virker for dig. Googlebot når din side via andre netværksveje, og en firewall, en CDN-regel eller en DNS-post kan blokere den uden at påvirke din browser. Sådan retter du det: tjek, at din robots.txt-fil indlæses med et 200-svar, ved hjælp af robots.txt-tjekkeren, og gennemgå derefter dine firewall- og CDN-regler for de datoer, hvor statussen blev rød.
Hvad det er: en robots.txt-ændring, der skærer ned på crawl-anmodningerne, efterfulgt af en rapport, der ser roligere ud. Sådan opdager du det: de samlede anmodninger falder kraftigt på dagen for en robots.txt-ændring. Sådan retter du det: et fald kan være korrekt, hvis du blokerede skraldestier, men tjek, at de vigtige sektioner stadig crawles. Kig i logs for de sektioner, der betyder noget. Hvis en side, du har brug for, er blokeret, forklarer vores guide til statussen blokeret af robots.txt, hvordan du finder reglen, og hvad du skal ændre.
Hvad det er: at behandle en veloverkrawlet side som en indekseret side. Sådan opdager du det: Googlebot anmoder regelmæssigt om en URL, men URL'en vises ikke i Googles resultater. Et højt antal crawls beviser ikke, at Google beholder siden. Sådan retter du det: gå fra rapporten Crawlstatistik til rapporterne om sideindeksering, og tjek URL'ens status. Vores guide til crawlet, men ikke indekseret forklarer årsagerne, og guiden til Google-indeksering dækker tjekkene i rækkefølge.
| Fejl | Sådan opdager du den | Sådan retter du den |
|---|---|---|
| Samlede anmodninger læst som en score | Anmodningerne stiger, efter at URL-parametre dukker op | Stop med at generere skrald-URL'erne, og tæl derefter igen |
| Kun gennemsnitlig svartid | Langsomme timer skjult af et fladt gennemsnit | Gruppér logs efter time, og match langsomme timer med jobs |
| Værtsstatus ignoreret | Gul eller rød, mens siderne åbner i browseren | Tjek robots.txt, DNS, firewall og CDN-regler |
| Fald i crawl læst som fremskridt | Anmodningerne falder på en robots.txt-ændringsdag | Bekræft, at vigtige sektioner stadig crawles |
| Crawling forvekslet med indeksering | Regelmæssige crawls, URL mangler i resultaterne | Tjek URL'ens indekseringsstatus |
Soranks GEO/SEO-dashboard placerer dine klik, visninger, CTR og position fra Search Console ved siden af de besøg, AI-assistenter sender dig, læst fra Google Analytics. Det viser ikke Googlebots anmodninger, så behold rapporten Crawlstatistik til det job. De to værktøjer besvarer forskellige spørgsmål: dashboardet fortæller dig, hvad Google sender dig, og Crawlstatistik fortæller dig, hvordan Google besøger din server.
Tip
Før du bruger tid i dine logs på en enkelt side, så tjek om Google overhovedet kan indeksere den med det gratis tjek for indekserbarhed. Det svarer på det første spørgsmål på få sekunder.
| Du ser | Start med | Åbn derefter |
|---|---|---|
| Værtsstatus rød eller gul | robots.txt-tjekkeren, derefter din DNS- og hostingstatus | Serverlogs for de samme datoer |
| Andelen af 5XX stiger | Dine logs grupperet efter time og URL | Serverkapacitet, eller skabelonen der fejler |
| Høj andel af omdirigeringer | Tjekkeren for omdirigeringer på de vigtigste URL'er | Omdirigeringskæder og gamle interne links |
| Mange URL'er opdaget, få indekseret | Tjekkeren for indekserbarhed på stikprøver | Vores guide til analyse af logfiler |
Rapporten Crawlstatistik er en god første skærm. Den fortæller dig, hvilken type problem du skal mistænke, og på hvilke datoer. Rettelsen ligger næsten altid i en liste over URL'er, og den liste findes i dine logs. Start med rapporten, og gå derefter til URL'erne.
Åbn din ejendom, gå til Indstillinger, vælg Crawlstatistik, og klik på Åbn rapport. Rapporten findes kun for domæneejendomme og URL-præfiksejendomme på rodniveau, så en ejendom for en undermappe viser den ikke.
Ikke i sig selv. Totalen tæller hver anmodning, også mislykkede og forsøg blokeret af robots.txt, så den viser, hvor meget Googlebot besøger, ikke hvor sunde besøgene er. Læs den sammen med svarkoderne og den gennemsnitlige svartid.
Ikke alene. Google siger, at nogle anmodninger muligvis ikke tælles med, og at dets eksempel-URL'er ikke er udtømmende. Brug rapporten til tendenser og fejlkategorier, og dine logs til præcise URL'er.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer