A privacidade é importante para nós, então você tem a opção de desativar certos tipos de armazenamento que podem não ser necessários para o funcionamento básico do site. O bloqueio de categorias pode afetar sua experiência no site. Mais informações (Política de cookies)
Estatísticas de rastreamento: como ler o relatório do Search Console e corrigir o que ele mostra
Aprenda a ler cada gráfico do relatório Estatísticas de rastreamento, o que ele deixa de fora em relação aos logs do servidor e como corrigir o que mostra.
Ilustração azul e branca de requisições de bots chegando a um site, com códigos de resposta marcados no caminho.
Ferramentas
Nesta página
Em resumo
O relatório Estatísticas de rastreamento, no Google Search Console, mostra como o Googlebot solicita as suas URLs: quantas requisições envia, quantos bytes baixa, quão rápido o seu servidor responde e quais códigos de status recebe. Leia primeiro o status do host, depois os códigos de resposta e, por último, as divisões por finalidade e por tipo de arquivo. O relatório é um resumo, não um log, então use-o para encontrar o problema e depois confirme-o nos logs do seu servidor.
Verifique você mesmo com as ferramentas gratuitas do Google
O Search Console lista as páginas que o Google não consegue ler, e o PageSpeed Insights mede a velocidade. Muitos problemas pequenos se resolvem nas configurações da sua plataforma de criação de sites.
Nossa recomendação para você
Um desenvolvedor web
Seu problema está no código ou no servidor: um desenvolvedor que entende de SEO é a pessoa certa. Passe a ele a lista de erros do Search Console.
Nossa recomendação para você
Uma ferramenta de auditoria técnica
Seu site tem muitas páginas: um rastreador lê todas como o Google e entrega a lista completa de erros a corrigir, página por página.
Nossa recomendação para você
Uma auditoria automática, depois conteúdo
Seu site funciona, mas traz poucos visitantes: problemas técnicos raramente são a causa. O Sorank audita o site e depois escreve as páginas que trazem tráfego.
O que é o relatório Estatísticas de rastreamento e quem deve abri-lo
Estatísticas de rastreamento é a visão, do lado do Google, da atividade do Googlebot no seu site. Ele mostra o que o Googlebot fez, não por que as suas páginas ranqueiam ou deixam de ranquear. O Google descreve o relatório como voltado a usuários avançados, e um site com menos de mil páginas pode não precisar dele. Se você mantém um site pequeno, de apresentação, pode pulá-lo até que algo mude.
A página pública do Search Console, ponto de partida das ferramentas de rastreamento e indexação.
O Search Console tem muitos relatórios. A página pública dele trata de rastreamento e indexação em geral: sitemaps, Inspeção de URL, cobertura do índice. Estatísticas de rastreamento fica em Configurações e não no menu principal, por isso muita gente nunca o abre.
Só propriedades de nível raiz têm o relatório
O relatório está disponível apenas para propriedades de nível raiz: uma propriedade de Domínio ou uma propriedade de Prefixo de URL construída na raiz do site. Uma propriedade para uma subpasta, como example.com/blog/, não o recebe. Os dados cobrem somente o domínio selecionado. As requisições para subdomínios irmãos não aparecem no relatório de outro subdomínio, mas uma visão do domínio pai inclui todos os seus subdomínios. Http e https são contados na mesma visão.
Nota
Se o seu site usa subdomínios por idioma, como en.example.com e de.example.com, abra cada um separadamente. Cada um tem os seus próprios dados, e um subdomínio alemão quebrado não aparece na visão em inglês.
Quem deve usá-lo
Abra o relatório quando uma destas situações for verdadeira: você publica muitas páginas, mudou a estrutura de URLs ou a hospedagem, o Googlebot parece visitar menos do que antes ou há páginas descobertas que nunca são indexadas. Um site que acrescenta alguns artigos por mês aprende pouco com ele além de erros, e esses erros são melhor encontrados em um rastreamento normal do site.
Abrir o relatório e ler cada gráfico
Abra a sua propriedade, vá em Configurações, encontre Estatísticas de rastreamento e clique em Abrir relatório. No topo você tem três gráficos: total de requisições de rastreamento, tamanho total do download e tempo médio de resposta. Abaixo estão o status do host e quatro divisões: respostas de rastreamento, tipo de arquivo, finalidade do rastreamento e tipo de Googlebot. Cada divisão é uma porcentagem baseada no número de requisições.
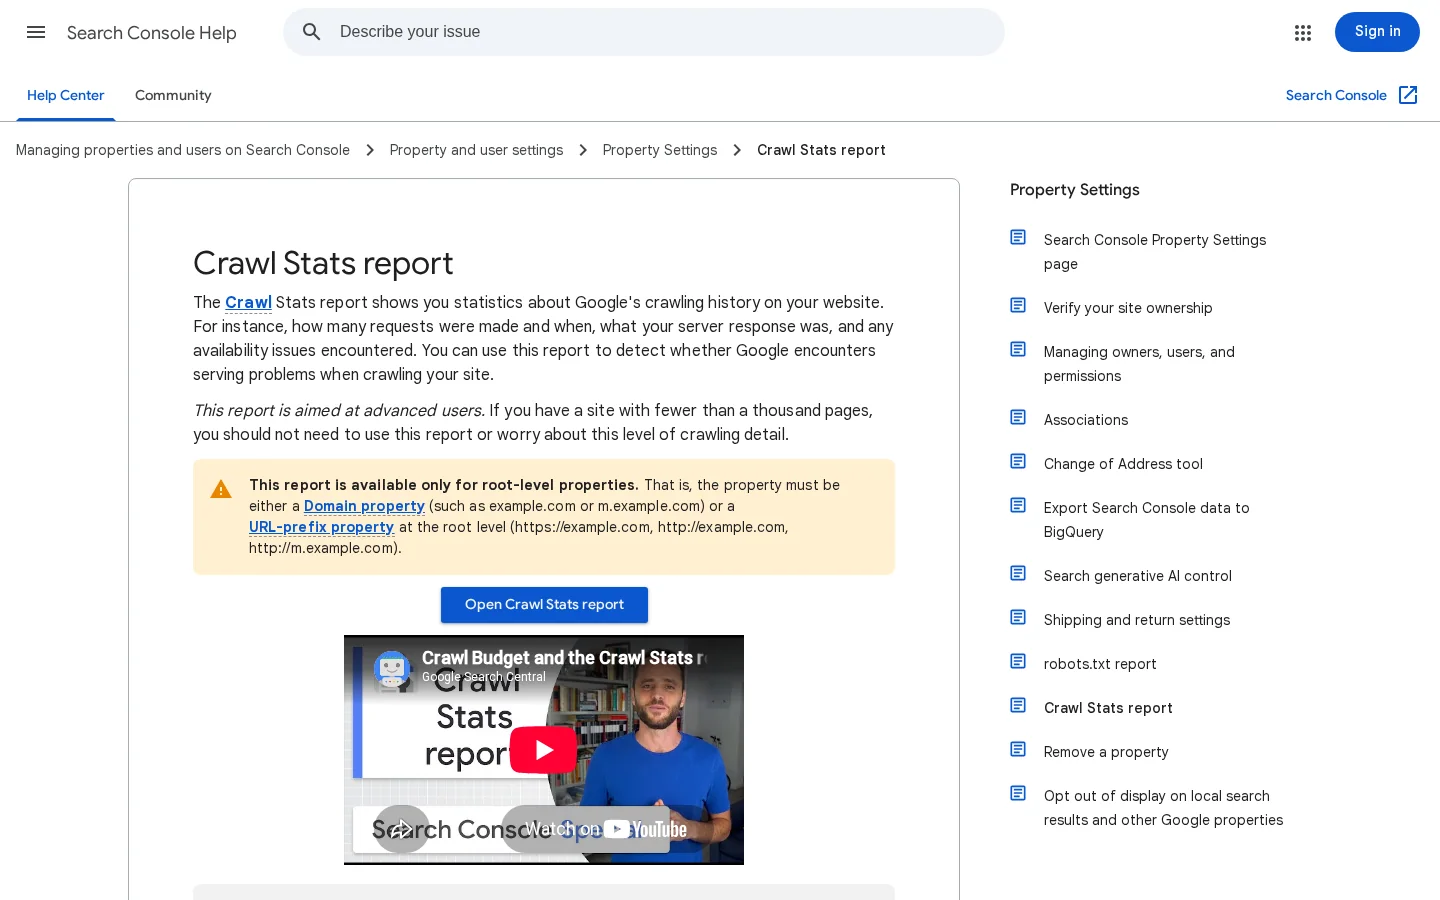
A página de ajuda do Google sobre o relatório Estatísticas de rastreamento.
Veja o que cada parte conta e como lê-la.
Parte do relatório
O que conta
Como ler
Total de requisições de rastreamento
Todas as requisições para as suas URLs, bem-sucedidas ou não, incluindo falhas de DNS, tentativas de conexão e loops de redirecionamento. Tentativas bloqueadas pelo robots.txt também são contadas.
Uma queda ou um salto repentino: verifique as mudanças no robots.txt e na estrutura de URLs nas mesmas datas.
Tamanho total baixado
Os bytes baixados durante o rastreamento. Um recurso em cache conta só na primeira requisição.
Se os bytes sobem enquanto as requisições ficam estáveis, as suas páginas ficaram mais pesadas.
Tempo médio de resposta
O tempo médio para buscar cada recurso, contando cada recurso vinculado separadamente.
Leia a tendência, não um valor isolado. Acompanhe depois de cada publicação.
Status do host
Busca do robots.txt, resolução de DNS e conectividade do servidor. Verde significa nenhum problema relevante nos últimos 90 dias, amarelo significa problemas com mais de uma semana, vermelho significa problemas na última semana.
Qualquer item vermelho ou amarelo é, antes de tudo, um problema de servidor ou de rede, e só depois um problema de SEO.
Respostas de rastreamento
A proporção de respostas por tipo, baseada no número de requisições.
Acompanhe a proporção de respostas ruins ao longo do tempo. O número bruto importa menos.
Tipo de arquivo
A proporção de respostas por tipo: HTML, imagem, JavaScript, CSS, PDF, JSON, vídeo. Baseada no número de respostas, não em bytes.
Mostra onde o Googlebot gasta suas requisições. Uma proporção alta de JavaScript e CSS significa que as suas páginas dependem de muitos recursos.
Finalidade do rastreamento
Descoberta (uma URL que o Google nunca tinha rastreado) ou atualização (um novo rastreamento de uma URL conhecida).
Veja a seção sobre descoberta e atualização mais abaixo.
Tipo de Googlebot
Smartphone, Computador, Imagem, Vídeo, Carregamento de recursos da página, AdsBot, StoreBot, outros.
Em um site indexado com prioridade para dispositivos móveis, Smartphone deve ser o maior grupo. Uma mudança brusca merece verificação.
As porcentagens contam requisições, não URLs
Cada divisão conta requisições. Uma URL que o Googlebot busca 50 vezes conta 50 vezes. Então «40% das respostas são 301» diz quantas requisições caem em um redirecionamento, não quantas URLs redirecionam. Para saber quais URLs estão envolvidas, você precisa dos seus logs. As URLs de exemplo que o Google mostra são uma amostra, e o Google diz que elas não são completas.
O que o relatório não mostra
A página de ajuda do Google diz que o relatório atualmente registra a maioria das requisições de rastreamento, mas que algumas podem não ser contadas. Ela também diz que as requisições que falham antes de chegar ao seu servidor não aparecem nos seus logs. É por isso que o relatório mostra falhas de DNS e de conexão que os seus logs não conseguem mostrar, e por que vale ler as duas fontes. O Google não informa um prazo de retenção dos gráficos, então, se quiser histórico, guarde mensalmente uma cópia própria, com uma captura de tela ou uma nota com os números.
Cada requisição do Googlebot viaja do Google até as suas páginas, e cada resposta é registrada.
Ler os códigos de resposta, passo a passo
A divisão de respostas é a parte do relatório que mais costuma levar a uma correção. Leia-a nesta ordem e pare no primeiro passo que mostrar um problema real.
Triar as respostas de rastreamento em cinco passos
Verifique o status do hostVermelho ou amarelo em robots.txt, DNS ou conectividade significa que o Googlebot não conseguiu alcançar o seu site de forma alguma. Resolva isso antes de tudo.
Veja as respostas ruins5XX, outros 4XX, robots.txt indisponível, tempos limite e erros de redirecionamento. Anote a proporção e se ela muda de uma semana para outra.
Verifique a proporção de redirecionamentosMuitas respostas 301 e 302 significam que o Googlebot gasta requisições em saltos intermediários em vez de em páginas.
Confirme os 404Um 404 está bem se a página foi removida de propósito. É um problema se os seus links internos ou o seu sitemap ainda apontam para ela.
Extraia as URLs dos logsTransforme cada categoria ruim em uma lista de URLs e corrija a origem dos links, não o relatório.
Respostas boas, possivelmente boas e ruins
O Google agrupa as respostas em três grupos. O agrupamento é um primeiro filtro, não um veredito sobre cada URL.
Boas: 200, 301, 302, 304 e meta refresh.
Possivelmente boas: 404.
Ruins: robots.txt indisponível, 401 e 407, 5XX, outros 4XX, erros de DNS, erros de busca, tempos limite e erros de redirecionamento.
Um 401 conta como ruim no relatório, mas está correto se a página fica atrás de um login que deve permanecer fechado. Decida URL por URL. O relatório indica qual grupo olhar, e você decide o que cada resposta deve ser.
Redirecionamentos: o custo que você não vê
Um 302 conta como resposta boa, então uma proporção de redirecionamentos pode parecer saudável mesmo desperdiçando rastreamento. Em uma análise de um site grande, publicada em abril de 2021 no Search Engine Journal por Tomek Rudzki, da Onely, 16% das requisições iam para páginas redirecionadas, e o autor recomendava verificar cada salto de redirecionamento.
Veja como uma cadeia prejudica. Suponha que /blog/seo-tips redirecione para /blog/seo-tips-2025, que por sua vez redireciona para /blog/seo-tips-guide. O Googlebot precisa de três requisições para chegar ao conteúdo, e cada link interno que ainda aponta para a primeira URL repete esse custo. Aponte a primeira URL diretamente para o endereço final e atualize os links internos para que parem de usar os caminhos antigos. O verificador de redirecionamentos gratuito segue a cadeia de qualquer URL salto a salto, para que você veja o caminho antes de corrigir. Se você não tem certeza de que um redirecionamento deve ser permanente, leia o nosso guia sobre redirecionamentos 301 e 302: um 301 indica que a mudança é permanente, um 302 que é temporária.
Dica
Ordene as suas URLs de redirecionamento pela frequência com que o Googlebot as solicita nos logs. Corrija primeiro as cinco cadeias mais solicitadas. Elas costumam responder pela maior parte da proporção de redirecionamentos.
5XX e 429: o sinal que reduz o ritmo de rastreamento
O guia do Google para sites grandes diz que, quando um site responde com erros de servidor (5XX) ou sinais de limitação de taxa como HTTP 429, o Google reduz o seu limite de rastreamento. Então um pico de 5XX custa mais do que as URLs quebradas. Ele também pode desacelerar o rastreamento das suas páginas saudáveis. O orçamento de rastreamento de um site depende em parte de quão bem o servidor responde, e as respostas 5XX reduzem essa parte.
Quando você vir um pico de 5XX, observe quando ele acontece. Erros no mesmo horário todos os dias apontam para um backup, uma importação agendada ou um pico de tráfego. Erros logo após uma publicação apontam para a publicação. Erros espalhados pelo dia inteiro apontam para falta de capacidade. Cada padrão tem uma correção diferente, e nenhuma se resolve editando uma única página.
Descoberta, atualização e tipo de arquivo: o que as proporções dizem
A divisão por finalidade do rastreamento separa as requisições em descoberta, quando o Google vê uma URL pela primeira vez, e atualização, quando ele rastreia de novo uma URL que já conhecia. A proporção entre as duas mostra em que o Google está gastando o seu tempo.
Uma proporção alta de descoberta em um site que acrescenta poucas páginas significa que o Google continua encontrando URLs novas. Procure geradores de URL: parâmetros de filtro e de ordenação, páginas de resultados de busca interna, arquivos de calendário, IDs de sessão. Cada um cria URLs que parecem novas.
Uma proporção alta de atualização em páginas que nunca mudam significa que o Google continua revisitando-as. Verifique se essas páginas respondem com 304 Not Modified. O Google diz que retornar 304 para uma página inalterada indica que ele pode reutilizar a cópia que já tem. Se as mesmas páginas retornam sempre um 200 com todos os bytes, o seu servidor envia a página inteira a cada visita.
Um site grande, um dia de rastreamento
7460páginas rastreadas por dia, em média
35%desses rastreamentos foram de descoberta, para URLs que o Google nunca tinha buscado
Fonte: Tomek Rudzki (Onely), Search Engine Journal, abril de 2021. Um site com cerca de 1 milhão de páginas, com um acúmulo de URLs «Descoberta, atualmente não indexada».
A mesma análise fazia uma verificação aproximada e útil. Nesse ritmo, estimava que o acúmulo levaria cerca de um ano para ser rastreado. Esse número é o cálculo de um único autor sobre um único site, e as capturas são de 2021, então não o copie. O método ainda funciona com os seus próprios dados: divida o número de URLs que aguardam descoberta pelo número de rastreamentos de descoberta por dia no seu relatório. Se o resultado for medido em meses, você tem um problema de rastreamento para resolver antes de publicar mais.
A divisão por tipo de arquivo conta respostas, não bytes, então mostra quantas requisições vão para cada tipo de recurso, não quão pesadas elas são. Redirecionamentos entram em «Outro tipo de arquivo», e as requisições que falharam aparecem como «Desconhecido (falha)». Uma proporção crescente de «Desconhecido (falha)» é um sinal de falha, não um tipo de arquivo, e deve ser tratada junto com as respostas ruins.
Estatísticas de rastreamento, logs do servidor e Inspeção de URL: três visões do Googlebot
Há três formas de ver o que o Googlebot fez no seu site: o relatório Estatísticas de rastreamento, os logs do seu servidor e a ferramenta Inspeção de URL do Search Console. Cada uma responde a uma pergunta diferente, e cada uma tem pontos cegos que as outras duas cobrem. Para um problema real, use as três.
O relatório Estatísticas de rastreamento
Princípio: um resumo das requisições do Googlebot para uma propriedade inteira, calculado pelo Google. Quando usar: para tendências, status do host e a primeira visão geral de um problema. Vantagens: é gratuito, cobre falhas que nunca chegam ao seu servidor e acrescenta finalidade e tipo de Googlebot, que os logs não dão diretamente. Limites: é um resumo, algumas requisições podem não ser contadas e as URLs de exemplo são uma amostra. Exemplo: a proporção de 5XX sobe por três dias em um host. O relatório mostra os dias e o host, e os seus logs mostram as URLs e os horários.
Logs do servidor
Princípio: o registro bruto que o seu servidor web escreve para cada requisição que recebe. Quando usar: para obter listas exatas de URLs, códigos de status por hora e as provas por trás de uma tendência do relatório. Vantagens: completos para cada requisição que chegou ao seu servidor, com a URL exata e o código de status. Limites: não contêm as requisições que falharam antes de chegar ao servidor, a string de user agent pode ser falsificada e a maioria dos servidores rotaciona ou apaga os logs após um prazo. Este comando conta os códigos de status das requisições identificadas como Googlebot em um log no formato combinado:
O comando procura a string de user agent e depois conta o código de status, que é o nono campo do formato combinado. Se o seu servidor escreve outro formato, mude o número do campo. O resultado é uma tabela de contagens por código de status, com o mais frequente primeiro.
Atenção
Qualquer um pode enviar uma requisição que diz ser Googlebot. Antes de agir diante de um pico suspeito, confirme que os endereços IP pertencem ao Google. O Google documenta uma verificação de DNS reverso para isso, e vale a pena fazê-la antes de bloquear ou redirecionar algo com base no user agent.
A ferramenta Inspeção de URL
Princípio: uma verificação de uma única URL, que mostra quando o Google a buscou pela última vez, o que recebeu e se ela está indexada. Quando usar: para confirmar uma correção, por exemplo se o Google buscou uma página corrigida depois que você a alterou. Vantagens: rápida, exata e fácil de ler para uma URL. Limites: uma URL por vez, então não pode mostrar um padrão em todo o site. Na análise citada acima, a ferramenta mostrou que uma página de categoria principal não tinha sido rastreada por três meses, e o autor a usou no lugar dos logs para essa página.
Relatório Estatísticas de rastreamento contra logs do servidor
Relatório Estatísticas de rastreamento
Conta falhas de DNS e de conexão
Mostra o status do host e o tipo de Googlebot
Mostra URLs de exemplo, não todas
Algumas requisições podem não ser contadas
Logs do servidor
Cada requisição que chegou ao seu servidor
URL exata e código de status de cada requisição
Deixam de fora falhas de DNS e de conexão
O user agent pode ser falsificado
Método
Pergunta que responde
Escopo
Ponto cego
Relatório Estatísticas de rastreamento
O Googlebot está saudável e como se comporta no conjunto?
A propriedade inteira, resumida
URLs de exemplo amostradas, e algumas requisições podem não ser contadas
Logs do servidor
Quais URLs exatas receberam qual resposta, e quando?
Cada requisição que chegou ao seu servidor
Falhas de DNS e de conexão, e user agents que podem ser falsificados
Inspeção de URL
Quando o Google buscou esta página pela última vez, e o que recebeu?
Uma URL
Não diz nada sobre o resto do site
Uma revisão mensal, passo a passo
Um único mês de dados ensina pouco. O relatório se torna útil quando você o compara com o seu normal, então mantenha um registro curto e revise-o no mesmo dia de cada mês. É a rotina que funciona para a maioria dos sites.
A revisão mensal em seis passos
Salve o mêsFaça uma captura de tela ou anote os três gráficos, o status do host e a divisão de respostas.
Compare com a sua referênciaUma mudança no total de requisições pode ser normal depois de um mês de muitas publicações. Uma nova proporção de 5XX sempre merece atenção.
Verifique na ordemPrimeiro o status do host, depois as respostas ruins, depois a proporção de redirecionamentos.
Extraia as URLsPara cada categoria ruim, pegue as principais URLs dos seus logs no mesmo período.
Corrija a origemOs links internos, as regras de redirecionamento, a capacidade do servidor ou a regra do robots.txt. Não o gráfico.
Registre a mudançaAnote a data de cada correção e leia o mês seguinte com essa data em mente.
Sinais que merecem ação neste mês
O status do host está amarelo ou vermelho em qualquer uma das três verificações
A proporção de 5XX sobe por vários dias seguidos, ou tem picos no mesmo horário
As respostas de redirecionamento aumentam depois de uma mudança no site que deveria removê-las
A proporção de descoberta continua alta em um site que publica pouco
Um único dia ruim sem mudança nos logs: é ruído até que se repita
Antes e depois de uma migração
Suponha que você mova o seu blog de /old-blog/ para /blog/ com redirecionamentos 301. Logo após a mudança, espere que a proporção de redirecionamentos suba, porque o Googlebot ainda pede os caminhos antigos. Nas semanas seguintes, a proporção deve cair à medida que o Google aprende as novas URLs. Espere também que a proporção de descoberta suba, já que as novas URLs são novas para o Google. Se a proporção de redirecionamentos continuar alta depois de várias semanas, procure cadeias, links internos antigos ou redirecionamentos que você esqueceu de adicionar. O nosso guia sobre como corrigir links quebrados cobre o lado dos links dessa mesma limpeza.
Erros comuns e como evitá-los
A maioria dos erros vem de ler um gráfico como um veredito. Cada um dos cinco abaixo tem um sinal claro no relatório e uma correção que você pode verificar nos seus logs.
Ler o total de requisições como uma nota
O que é: supor que mais requisições de rastreamento significam um SEO melhor. Como identificar: as requisições sobem fortemente depois de uma publicação que acrescentou opções de filtro ou ordenação, e as novas URLs trazem parâmetros. Como corrigir: verifique nos seus logs a proporção de descoberta e os padrões de URL. Corrija o gerador de URLs: pare de linkar URLs com parâmetros, ou use canonical e bloqueie as que não têm valor de busca. Um número maior de requisições inúteis é um custo, não um ganho.
Confiar no tempo médio de resposta
O que é: olhar a média e não ver os picos que ela esconde. Como identificar: a média parece estável, mas os seus logs mostram respostas lentas no mesmo horário todas as noites. Como corrigir: agrupe os seus logs por hora e por URL, depois compare as horas lentas com os seus backups, importações e publicações. Corrija o processo lento ou o template lento e verifique a média de novo. A média é uma linha de tendência, e uma linha de tendência não diz onde a lentidão começa.
Ignorar o status do host quando as páginas carregam bem
O que é: supor que o site está saudável porque abre no seu navegador. Como identificar: o status do host mostra amarelo ou vermelho para robots.txt, DNS ou conectividade, enquanto as suas páginas funcionam para você. O Googlebot alcança o seu site por outros caminhos de rede, e um firewall, uma regra de CDN ou um registro de DNS pode bloqueá-lo sem afetar o seu navegador. Como corrigir: verifique com o verificador de robots.txt se o seu arquivo carrega com resposta 200, depois revise as regras de firewall e de CDN nas datas em que o status ficou vermelho.
Bloquear o rastreamento e ler a queda como progresso
O que é: uma mudança no robots.txt que reduz as requisições de rastreamento, seguida de um relatório que parece mais calmo. Como identificar: o total de requisições cai bruscamente no dia de uma mudança no robots.txt. Como corrigir: uma queda pode estar correta se você bloqueou caminhos inúteis, mas confirme que as seções importantes continuam sendo rastreadas. Veja os logs das seções que importam. Se uma página de que você precisa está bloqueada, o nosso guia sobre o status bloqueado pelo robots.txt explica como encontrar a regra e o que mudar.
Confundir rastreamento com indexação
O que é: tratar uma página bem rastreada como uma página indexada. Como identificar: o Googlebot solicita uma URL regularmente, mas a URL não aparece nos resultados do Google. Uma contagem alta de rastreamentos não prova que o Google mantém a página. Como corrigir: passe do relatório Estatísticas de rastreamento para os relatórios de indexação de páginas e verifique o status da URL. O nosso guia sobre rastreada, atualmente não indexada explica as causas, e o guia sobre indexação no Google reúne as verificações na ordem certa.
Erro
Como identificar
Como corrigir
Total de requisições lido como nota
Requisições sobem depois que parâmetros aparecem nas URLs
Parar de gerar as URLs inúteis e recontar
Só o tempo médio de resposta
Horas lentas escondidas por uma média estável
Agrupar os logs por hora e relacionar as horas lentas a processos
Status do host ignorado
Amarelo ou vermelho enquanto as páginas abrem no navegador
Verificar robots.txt, DNS, firewall e regras de CDN
Queda do rastreamento lida como progresso
Requisições caem no dia de uma mudança no robots.txt
Confirmar que as seções importantes continuam sendo rastreadas
Rastreamento confundido com indexação
Rastreamentos regulares, URL ausente dos resultados
Verificar o status de indexação da URL
Onde a Sorank se encaixa e o que fazer depois
O painel GEO / SEO da Sorank coloca os seus cliques, impressões, CTR e posições do Search Console ao lado das visitas que os assistentes de IA enviam para você, lidas do Google Analytics. Ele não mostra as requisições do Googlebot, então mantenha o relatório Estatísticas de rastreamento para essa tarefa. As duas ferramentas respondem perguntas diferentes: o painel mostra o que o Google envia para você, e Estatísticas de rastreamento mostra como o Google visita o seu servidor.
Dica
Antes de gastar tempo nos seus logs com uma única página, verifique se o Google consegue indexá-la com o verificador de indexabilidade gratuito. Ele responde a essa primeira pergunta em segundos.
O relatório Estatísticas de rastreamento é uma boa primeira tela. Ele indica que tipo de problema suspeitar e em quais datas. A solução quase sempre está em uma lista de URLs, e essa lista está nos seus logs. Comece pelo relatório e depois passe às URLs.
Perguntas frequentes
Onde fica o relatório Estatísticas de rastreamento no Google Search Console?
Abra a sua propriedade, vá em Configurações, selecione Estatísticas de rastreamento e clique em Abrir relatório. O relatório existe apenas para propriedades de Domínio e propriedades de Prefixo de URL de nível raiz, então uma propriedade de subpasta não o mostrará.
Um número alto de requisições de rastreamento é um bom sinal?
Não por si só. O total conta cada requisição, inclusive as que falharam e as tentativas bloqueadas pelo robots.txt, então mostra quanto o Googlebot visita, não quão saudáveis são essas visitas. Leia junto com os códigos de resposta e o tempo médio de resposta.
Posso confiar em Estatísticas de rastreamento em vez dos logs do servidor?
Não sozinho. O Google diz que algumas requisições podem não ser contadas e que as suas URLs de exemplo não são completas. Use o relatório para tendências e categorias de falha, e os seus logs para as URLs exatas.
y!
Receba gratuitamente o seu plano de conteúdo para 30 dias
Analisamos seus concorrentes, seu site e sua visibilidade nas IA para criar, gratuitamente, um plano de conteúdo sob medida.
“Testei o Sorank no site real de um cliente e é uma loucura. Faz tudo aquilo que uma agência cobra 1.500 € por mês. Agora vai para produção nesse cliente.”Guillaume Guersanguersanguillaume.com
“Somos uma agência de publicidade e queríamos colocar nosso SEO nos trilhos de uma vez por todas. A Sorank nos deu uma visão clara do nosso site, ajudou-nos a priorizar as otimizações e estruturar corretamente nosso conteúdo. A ferramenta é fácil de usar, bem projetada para uma equipe e muito prática para centralizar o acompanhamento sem ter que fazer malabarismos entre várias plataformas. Uma base muito sólida para recomeçar do zero com nosso SEO.”Gaspard MadouiAgência de Publicidade
“Me especializei em GEO graças à Sorank. O GEO Leaderboard me permite mostrar aos meus clientes o seu posicionamento em relação aos concorrentes no ChatGPT. É um verdadeiro diferencial comercial.”MélanieFreelancer SEO
“Excelente serviço, funciona bem para o nosso site e nos ajuda a entender como melhorá-lo para nos posicionarmos melhor no Google e em outros lugares. Parabéns, continuem assim, eu recomendo.”Hugo T.Comerciante de e-commerce


 Search Console