Resumo
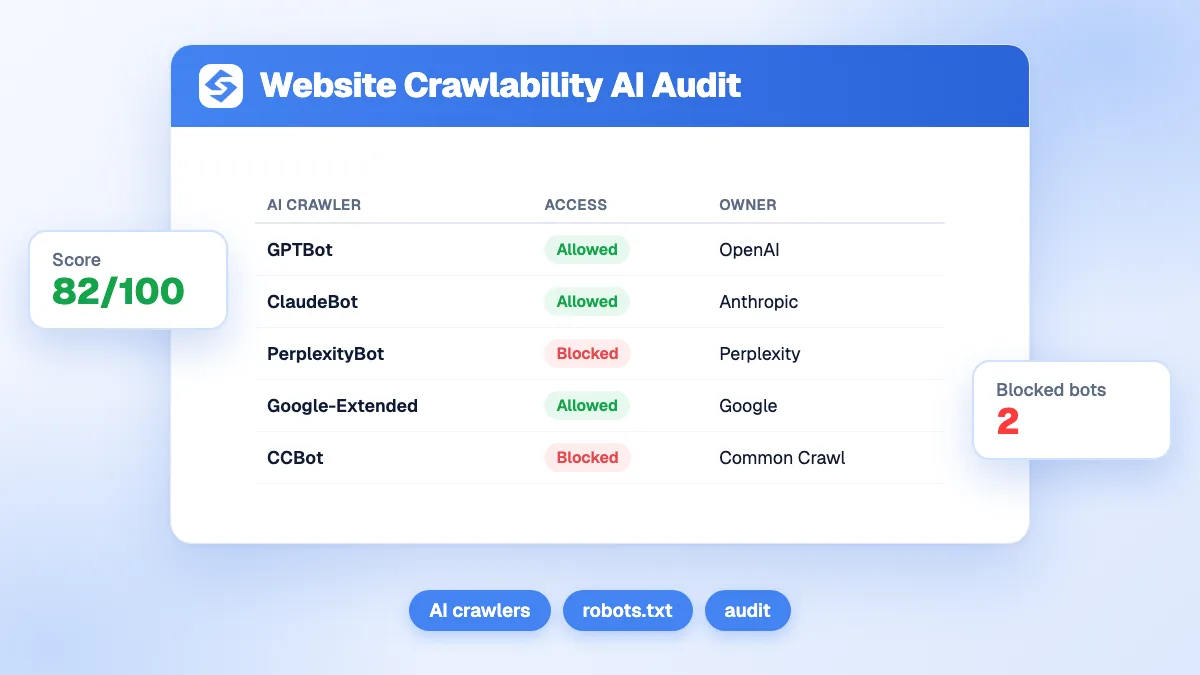
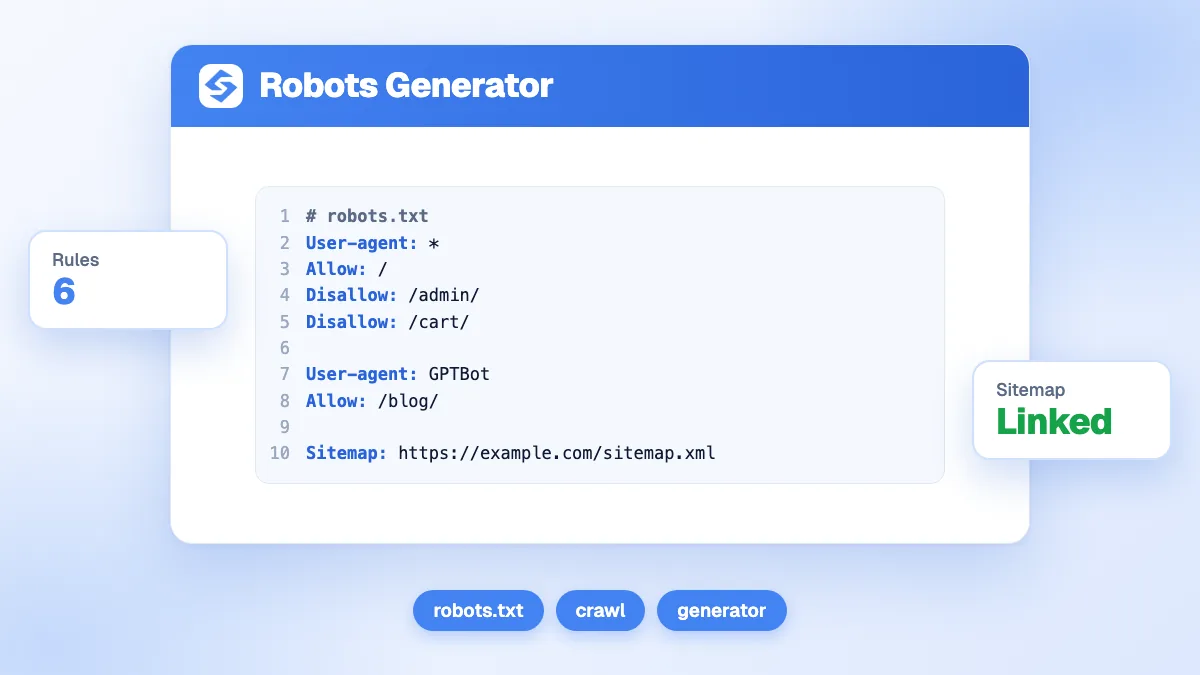
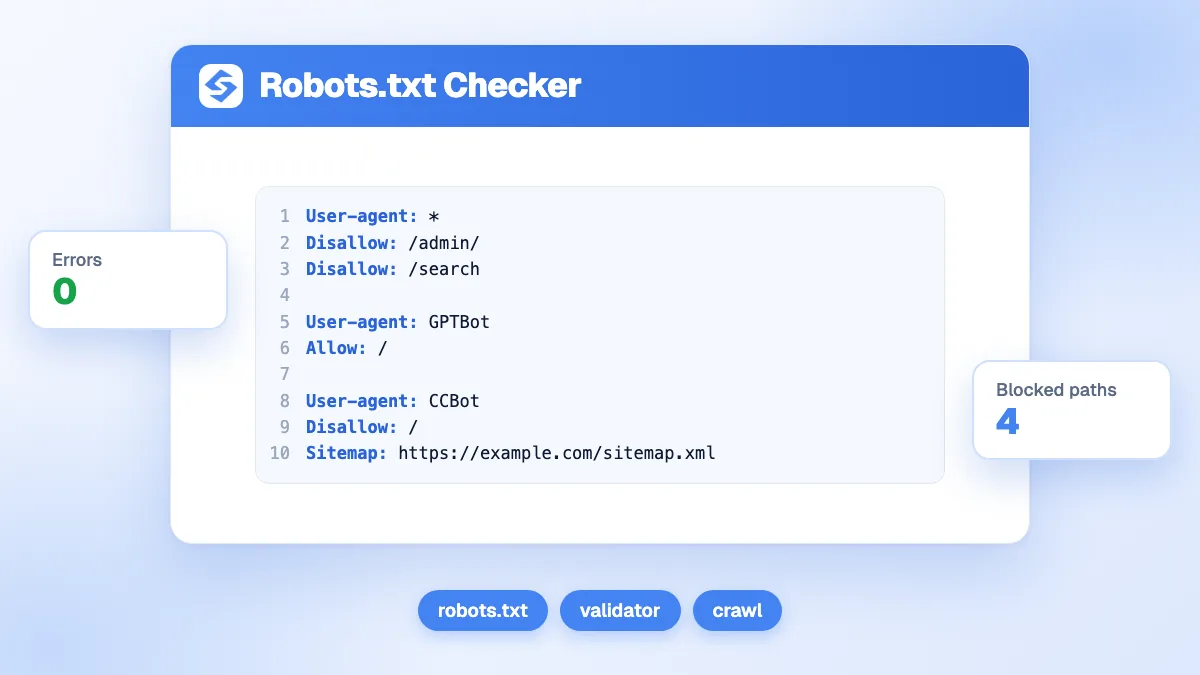
Este verificador baixa e analisa o robots.txt de um domínio, valida a sintaxe e mostra se crawlers de IA como GPTBot, OAI-SearchBot ou Google-Extended estão permitidos ou bloqueados. Um Disallow: / geral para User-agent: * bloqueia todos os crawlers de IA, por isso confirme que cada bloqueio é intencional.
Quer ir mais longe? Pergunte ao


O Verificador de robots.txt baixa e analisa o arquivo robots.txt de qualquer domínio, valida sua sintaxe e destaca as diretivas que afetam crawlers de IA como GPTBot, PerplexityBot e Google-Extended. Insira seu domínio na ferramenta acima para obter uma análise imediata.
Fundamentos do robots.txt e por que os crawlers de IA mudam o cenário
Robots.txt é um arquivo de texto simples na raiz do seu domínio que instrui os crawlers sobre quais caminhos podem ou não acessar. Por anos, webmasters escreviam principalmente regras para o Googlebot e o Bingbot. A ascensão das IAs introduziu uma nova classe de bots, cada um com seu próprio user-agent, que devem ser explicitamente permitidos ou bloqueados.
Os principais user-agents de crawlers de IA incluem: GPTBot (OpenAI/ChatGPT), PerplexityBot (Perplexity), Google-Extended (treinamento de IA do Google e recursos do Gemini), ClaudeBot (Anthropic) e OAI-SearchBot (pesquisa web da OpenAI). Se seu robots.txt usa um Disallow: / geral para User-agent: *, ele bloqueia todos esses crawlers de IA junto com os bots de pesquisa tradicionais - um erro comum que elimina completamente a visibilidade de IA.
O que a ferramenta acima verifica
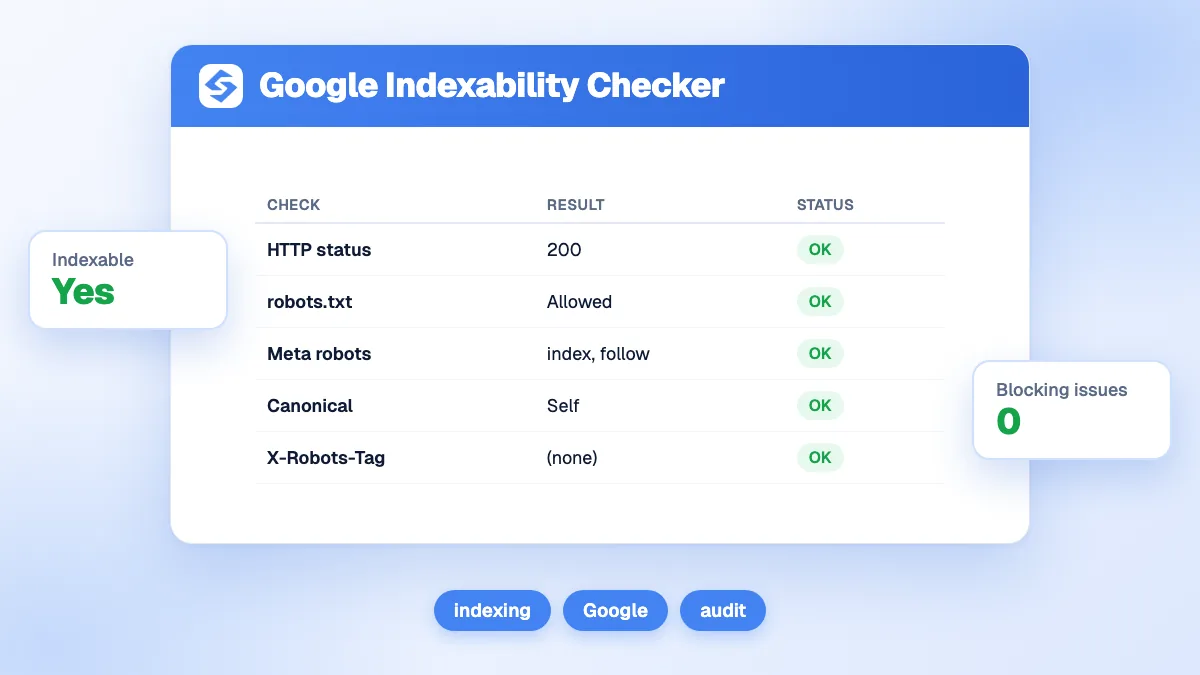
- Presença e acessibilidade do arquivo: o robots.txt está no caminho correto e retorna um código de status 200?
- Validade de sintaxe: o arquivo segue o protocolo de exclusão de robots? Pares user-agent/diretiva incorretos, valores allow/disallow mal formados e codificação incorreta são sinalizados.
- Cobertura de crawlers de IA: cada user-agent de IA principal está explicitamente permitido, bloqueado ou herdando de uma regra curinga? A ferramenta mostra o status efetivo para GPTBot, OAI-SearchBot, PerplexityBot, Google-Extended e ClaudeBot.
- Conflitos de regras: regras allow e disallow sobrepostas que poderiam bloquear ou permitir inadvertidamente caminhos importantes.
- Declaração do sitemap: o arquivo inclui uma diretiva Sitemap apontando para um sitemap XML válido?
Como interpretar os resultados e agir
- Se um crawler de IA estiver bloqueado acidentalmente por uma regra curinga, adicione uma regra
Allow: /explícita para o user-agent específico acima da regra curinga. - Se você pretende bloquear crawlers de IA por razões de licenciamento, confirme que cada user-agent relevante está explicitamente listado - não confie apenas em curingas.
- Se a ferramenta sinalizar erros de sintaxe, corrija-os imediatamente: um robots.txt malformado pode ser ignorado pelos crawlers, expondo caminhos que você pretendia proteger.
- Use a ferramenta de teste de robots.txt do Google Search Console para confirmar que cada URL crítico é rastravel após fazer alterações.
Benchmark: por que isso importa para a visibilidade de IA
Os AI Overviews aparecem em aproximadamente 31% das pesquisas do Google (2025). Bloquear os crawlers de IA mesmo que acidentalmente significa ser invisível nessa fatia crescente da busca. Verificar e corrigir seu robots.txt é uma das ações técnicas com maior retorno para qualquer estratégia GEO.
Para monitoramento contínuo da sua visibilidade nas buscas de IA, o Sorank rastreia automaticamente citações e acesso ao crawl.