Riepilogo
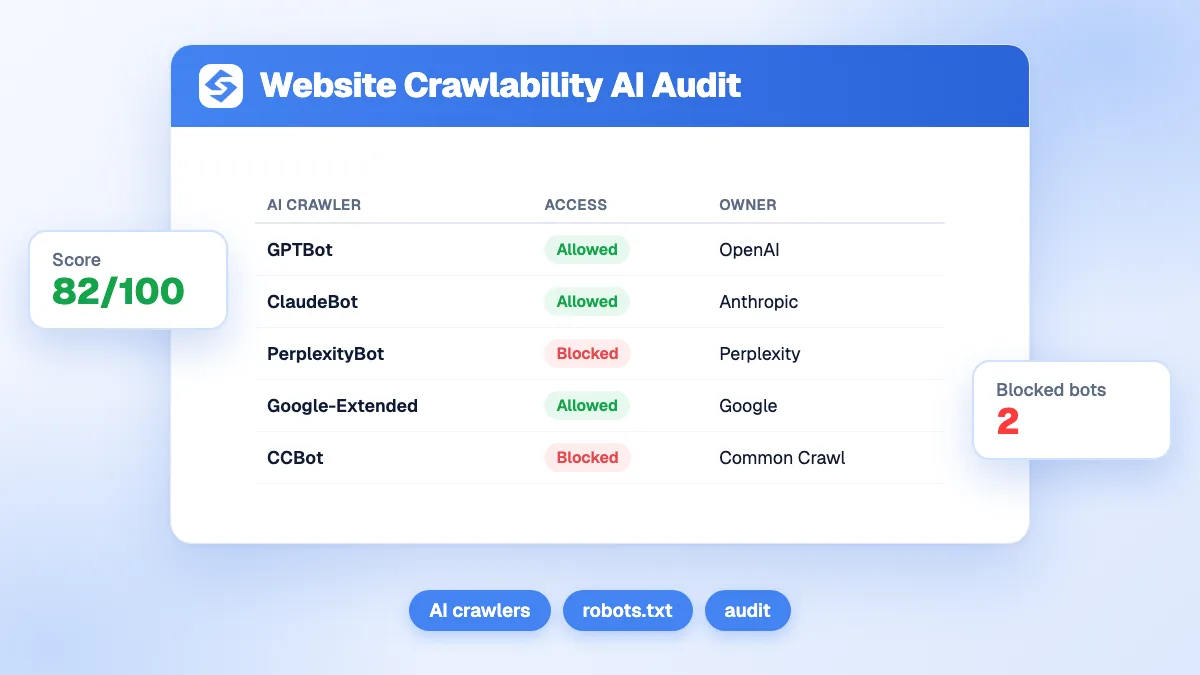
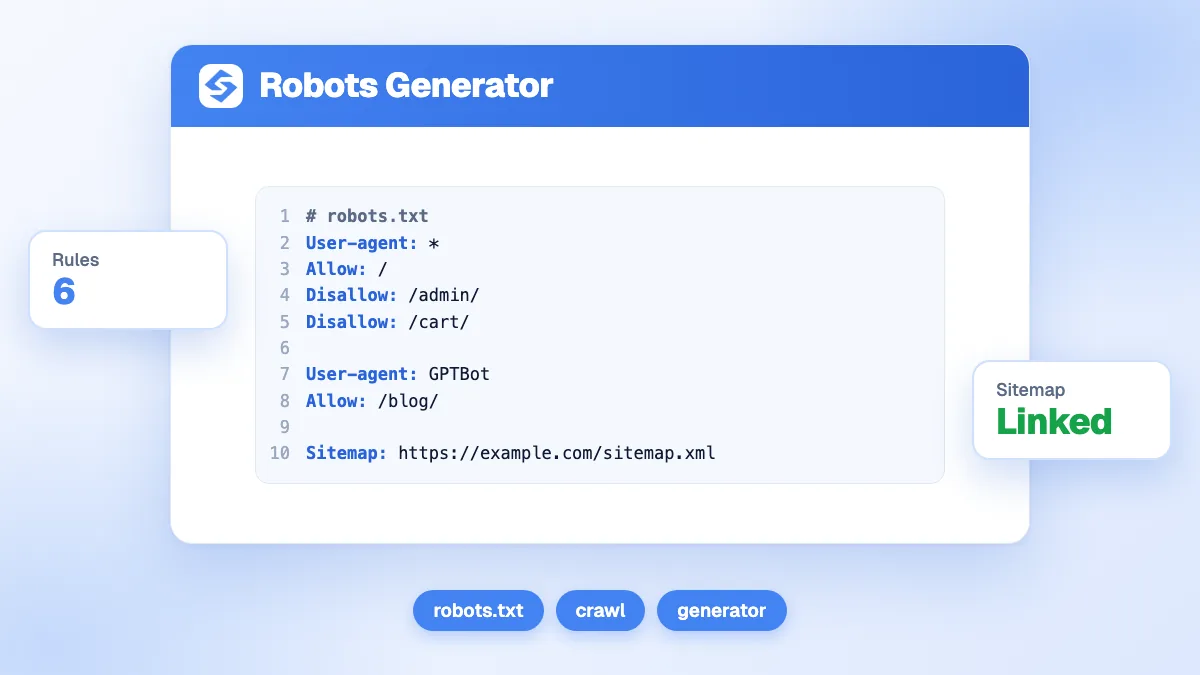
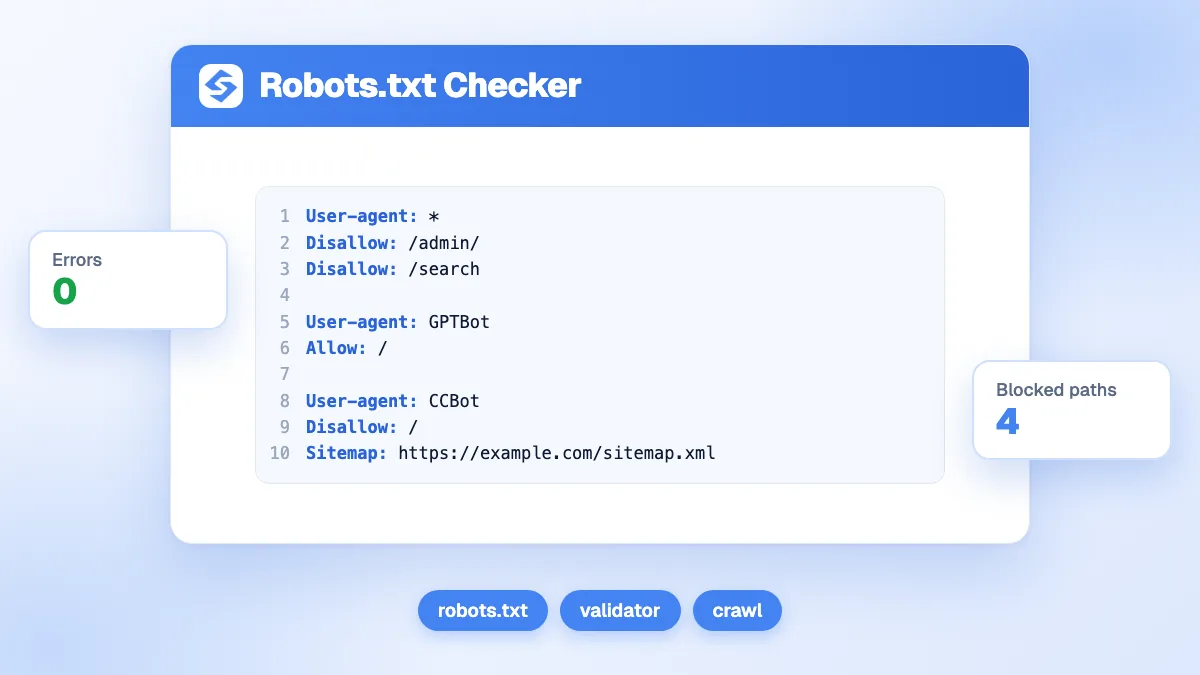
Questo verificatore analizza il robots.txt di un dominio, ne convalida la sintassi e indica se i crawler IA come GPTBot, PerplexityBot e Google-Extended sono autorizzati o bloccati. Una sola riga errata può nascondere le sue pagine a un'intera piattaforma IA, quindi verifichi che ogni blocco sia voluto e blocchi bot o percorsi specifici.
Vuoi approfondire? Chiedi a


Il Robots.txt Checker recupera e analizza il file robots.txt di qualsiasi dominio, ne convalida la sintassi ed evidenzia le direttive che influiscono sui crawler IA come GPTBot, PerplexityBot e Google-Extended. Inserisca il suo dominio nello strumento qui sopra per ottenere un'analisi immediata.
Le basi del robots.txt e perché i crawler IA cambiano lo scenario
Il robots.txt è un file di testo semplice posizionato nella radice del suo dominio che indica ai crawler quali percorsi possono o non possono visitare. Per anni i webmaster hanno scritto regole principalmente per Googlebot e Bingbot. L'ascesa delle IA ha introdotto una nuova categoria di bot, ciascuno con il proprio user-agent, che deve essere autorizzato o bloccato in modo esplicito.
Tra gli user-agent dei crawler IA più comuni figurano: GPTBot (OpenAI/ChatGPT), PerplexityBot (Perplexity), Google-Extended (addestramento IA di Google e funzionalità di Gemini), ClaudeBot (Anthropic) e OAI-SearchBot (ricerca web di OpenAI). Se il suo robots.txt utilizza un Disallow: / generico per User-agent: *, blocca tutti questi bot a meno che non vengano nuovamente autorizzati singolarmente.
Cosa controlla lo strumento qui sopra
- Validità della sintassi: rileva direttive malformate, righe vuote mancanti tra i blocchi degli agent e campi non supportati.
- Accesso dei bot IA: per ciascun crawler IA principale, lo strumento segnala se è autorizzato, parzialmente autorizzato o completamente bloccato.
- Direttive Crawl-delay: ritardi eccessivi rallentano l'indicizzazione IA; lo strumento segnala i valori superiori alle soglie consigliate.
- Dichiarazioni Sitemap: verifica che sia presente una riga Sitemap che rimanda a una sitemap XML valida.
- Pattern con wildcard: convalida l'uso delle wildcard
*e$che alcuni parser interpretano in modo diverso. - Regole in conflitto: quando una regola più specifica contraddice una più generica, lo strumento spiega quale direttiva ha la precedenza.
Come interpretare i risultati e agire
- Se GPTBot o PerplexityBot è bloccato: valuti se si tratta di una scelta intenzionale. Se desidera visibilità nella ricerca IA, aggiunga un
Allow: /esplicito sotto il loro blocco user-agent oppure rimuova il divieto generico. - Se Google-Extended è bloccato: le sue pagine potrebbero essere escluse dalla conoscenza di Gemini e dalle funzionalità che attingono al corpus di addestramento IA di Google. Valuti con attenzione il compromesso.
- Non rimuova tutte le restrizioni alla cieca. Bloccare scraper e ladri di contenuti è legittimo. Miri le sue restrizioni: blocchi bot o percorsi specifici, non tutti i crawler.
- Dopo ogni modifica, esegua di nuovo lo strumento qui sopra per verificare che la modifica sia applicata correttamente prima della messa online.
- Combini il robots.txt con un llms.txt ben formato per offrire ai crawler IA sia il permesso sia una mappa di navigazione.
Benchmark: un solo bot bloccato, invisibile a un'intera piattaforma
Le AI Overview compaiono ormai in circa il 31% delle query su Google. Una singola riga Disallow errata che prende di mira Google-Extended può rimuovere completamente le sue pagine dal bacino di risposte di Gemini. Allo stesso modo, bloccare GPTBot significa che la funzione di navigazione web di ChatGPT non può leggere i suoi contenuti al momento della scansione. Il costo è asimmetrico: correggere una regola del robots.txt richiede minuti; recuperare la visibilità IA persa richiede settimane.
Per un monitoraggio continuo della presenza del suo marchio nelle risposte di tutte le principali IA, Sorank traccia citazioni e visibilità in modo automatico.