A privacidade é importante para nós, então você tem a opção de desativar certos tipos de armazenamento que podem não ser necessários para o funcionamento básico do site. O bloqueio de categorias pode afetar sua experiência no site. Mais informações (Política de cookies)
Um mapa de site em que algumas páginas aparecem marcadas com sinais de erro enquanto um rastreador segue os links entre elas.
Ferramentas
Nesta página
Em resumo
erros de rastreamento são as solicitações que um buscador ou um rastreador de IA faz ao seu site e que falham: o servidor não responde a tempo, o DNS não responde, o robots.txt não pode ser buscado, um redirecionamento entra em loop ou uma página retorna um código 4xx ou 5xx. Os erros no nível do site (DNS, servidor, robots.txt) podem impedir o Google de rastrear o site inteiro, então corrija-os primeiro; os erros no nível da URL (404, soft 404, erros de redirecionamento) só importam quando atingem páginas que você quer indexar. Você os encontra nos relatórios Estatísticas de rastreamento e Indexação de páginas do Search Console, confirma com um rastreador e com os logs do servidor, depois corrige a causa e valida.
Verifique você mesmo com as ferramentas gratuitas do Google
O Search Console lista as páginas que o Google não consegue ler, e o PageSpeed Insights mede a velocidade. Muitos problemas pequenos se resolvem nas configurações da sua plataforma de criação de sites.
Nossa recomendação para você
Um desenvolvedor web
Seu problema está no código ou no servidor: um desenvolvedor que entende de SEO é a pessoa certa. Passe a ele a lista de erros do Search Console.
Nossa recomendação para você
Uma ferramenta de auditoria técnica
Seu site tem muitas páginas: um rastreador lê todas como o Google e entrega a lista completa de erros a corrigir, página por página.
Nossa recomendação para você
Uma auditoria automática, depois conteúdo
Seu site funciona, mas traz poucos visitantes: problemas técnicos raramente são a causa. O Sorank audita o site e depois escreve as páginas que trazem tráfego.
O que são erros de rastreamento, e o que não são
Um rastreador funciona como um visitante muito paciente. Ele pede uma URL ao seu servidor, espera a resposta, lê o código de status e o conteúdo, e então segue os links que encontrou. Um erro de rastreamento é qualquer etapa dessa cadeia que falha. O visitante nunca recebe uma página utilizável.
Essa definição é importante porque muitos relatórios misturam erros de rastreamento com decisões de indexação. «Rastreada, mas não indexada no momento» não é um erro de rastreamento: o Google buscou a página sem problemas e escolheu não mantê-la. «Excluída pela tag noindex» também não é: foi você que pediu ao Google para retirar a página. Um erro de rastreamento significa que a própria busca deu errado.
As duas famílias: erros de site e erros de URL
O Google divide os problemas em dois níveis, e você deveria fazer o mesmo.
Erros de site (o Google chama de problemas de status do host): falhas de resolução de DNS, falhas de conexão com o servidor e falhas ao buscar o robots.txt. Afetam todas as URLs do host. Um dia ruim nesse nível pode congelar o rastreamento do site inteiro.
Erros de URL: uma página retorna 404, 410, 401, 403, 5xx, um soft 404 ou um redirecionamento quebrado. Afetam só aquela URL, e muitos são inofensivos.
Erros de site e erros de URL
Erros de site (corrigir hoje)
O DNS não resolve
O servidor excede o tempo ou derruba a conexão
O robots.txt retorna 5xx ou 429
Visíveis em Estatísticas de rastreamento, Status do host
Podem pausar o rastreamento de todas as páginas
Erros de URL (triar)
404, 410, soft 404
401, 403, outros 4xx
Loop de redirecionamento ou cadeia longa demais
Visíveis no relatório Indexação de páginas
Só importam nas páginas que você quer indexar
Por que essa distinção muda suas prioridades
Uma loja com 4000 URLs antigas de produtos retornando 404 pode estar perfeitamente saudável se esses produtos sumiram de vez. A mesma loja com um robots.txt que retorna 503 por seis horas tem uma emergência de verdade, mesmo que todas as páginas de produto funcionem. Comece pelo host, depois pelas URLs que geram receita, depois pelo resto.
Como o Googlebot reage a cada falha
Para corrigir bem os erros de rastreamento, você precisa saber o que o Google realmente faz quando encontra um. A documentação do Google sobre como os códigos de status HTTP e os erros de rede afetam a Pesquisa Google (Google Search Central) traz as regras. Veja o que elas significam na prática.
Os códigos de status, família por família
Resposta
O que o Google faz
É um problema?
2xx
Envia o conteúdo para indexação. A indexação não é garantida.
Não, a menos que a página esteja vazia (soft 404).
301, 308
Sinal forte de que o destino é a nova URL.
Não, se for um único salto até uma página 200.
302, 303, 307
Sinal fraco: a URL original tende a continuar como canônica.
Sim, se a mudança for permanente.
Cadeias de 3xx
Segue até 10 saltos por padrão e depois desiste.
Sim: cada salto desperdiça uma solicitação, e os loops nunca se resolvem.
404, 410, outros 4xx (exceto 429)
Trata o conteúdo como inexistente, remove aos poucos as URLs indexadas e as rastreia com menos frequência.
Só se a página deveria existir.
401, 403
Igual aos outros 4xx. Não desaceleram o rastreamento.
Sim, se bloqueiam o Googlebot em páginas públicas.
429
Tratado como sinal de sobrecarga do servidor, como um 5xx.
Sim: o rastreamento desacelera.
5xx
Desacelera o rastreamento em proporção aos erros. URLs que continuam falhando são removidas do índice.
Sim, sempre.
Dois detalhes confundem muitas equipes. Primeiro, 401 e 403 não reduzem a frequência de rastreamento. Se o seu servidor está sofrendo, retornar 403 ao Googlebot não ajuda; o Google pede que você retorne 503 ou 429 temporariamente. Segundo, um 404 não é uma penalidade. É a resposta certa para uma página que não existe mais.
As falhas do robots.txt são as mais perigosas
A documentação do relatório Estatísticas de rastreamento (Ajuda do Search Console) explica a regra. Um robots.txt que responde 200 (mesmo vazio) ou 403, 404 ou 410 (sem arquivo) está ok. Um robots.txt que responde 429 ou 5xx é uma falha, e o Google então joga pelo seguro.
O que o Google faz quando o robots.txt continua falhando
Primeiras 12 horasO Google para de rastrear o site por completo.
Até 30 diasO Google usa o último robots.txt buscado com sucesso.
Depois de 30 diasO comportamento depende de a página inicial estar acessível.
Fonte: Ajuda do Google Search Console, relatório Estatísticas de rastreamento
Ou seja, uma regra de CDN ou um firewall que entrega 503 em /robots.txt pode congelar o site inteiro por meio dia, mesmo que todas as outras URLs funcionem. Verifique esse arquivo primeiro em qualquer investigação de erros de rastreamento. Nosso guia sobre o status «Bloqueada pelo robots.txt» trata do problema oposto, quando o arquivo funciona mas bloqueia demais.
Limites de rastreamento do Google para guardar
10saltos de redirecionamento no máximo seguidos pelos rastreadores do Google
12 hde parada do rastreamento quando o robots.txt retorna 5xx ou 429
30 diasem que o Google continua usando o último robots.txt válido
5%de falhas de DNS por dia, citado como exemplo de problema no host
Fontes: Google Search Central, códigos de status HTTP e erros de rede; Ajuda do Search Console, relatório Estatísticas de rastreamento
Os erros de rastreamento são os pontos em que o caminho de um rastreador pelo seu site se quebra.
Cada tipo de erro de rastreamento, explicado com sua correção
Esta é a lista completa que você vai encontrar no Search Console e nos rastreadores, com a causa e a correção de cada um. Os nomes seguem a documentação do relatório Indexação de páginas (Ajuda do Search Console).
Erros de DNS
O Google não conseguiu transformar seu nome de domínio em um endereço IP, ou o servidor DNS não respondeu. Causas comuns: um domínio expirado, uma pane no provedor de DNS, um registro errado depois de uma migração ou uma configuração DNSSEC incorreta. Verifique com uma consulta feita de fora da sua rede:
Correção: ajuste os registros, reduza o TTL antes de qualquer migração e use um provedor de DNS com redundância. Se example.com e www.example.com existem, os dois precisam resolver, mesmo que um apenas redirecione.
Erros de conexão com o servidor e 5xx
O servidor não respondeu a tempo, fechou a conexão ou respondeu 500, 502, 503 ou 504. Causas típicas: um banco de dados sobrecarregado, um processo PHP ou Node que cai sob carga, um tempo limite no proxy reverso, uma atualização de plugin ou um firewall que limita bots. Observe o padrão no tempo: erros no mesmo horário toda noite costumam apontar para um backup ou uma tarefa agendada.
Correção: leia o log de erros do servidor nos horários informados pelo Google, aumente os tempos limite ou o número de workers, coloque em cache as páginas pesadas e garanta que sua proteção contra bots deixe passar o Googlebot verificado. Para uma manutenção planejada, retorne 503 com um cabeçalho Retry-After em vez de uma página 200 dizendo «voltamos em breve»:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 e 410 (não encontrada)
A página não existe. Tudo bem se ela foi apagada de propósito e nada mais aponta para ela. É um problema quando a URL ainda tem backlinks, tráfego ou links internos, ou quando a página deveria existir e um deploy a quebrou.
Correção: se o conteúdo mudou de lugar, adicione um único 301 para o equivalente mais próximo. Se sumiu de vez, mantenha o 404 ou use 410, e remova os links internos e as entradas do sitemap que apontam para ele. Nunca redirecione todos os 404 para a página inicial: o Google costuma tratá-los como soft 404.
Soft 404
O servidor diz 200, mas a página parece vazia ou diz «não encontrada»: uma categoria vazia, uma página de busca sem resultados, um produto esgotado sem conteúdo. O Google gasta uma solicitação e não recebe nada. Tratamos esse caso a fundo no nosso guia sobre erros soft 404.
401, 403 e outros 4xx
O Googlebot nunca envia credenciais, então um 401 ou 403 em uma página pública significa que seu servidor ou uma camada de segurança está bloqueando o robô. Culpados habituais: uma senha de homologação esquecida em produção, uma regra de WAF, um bloqueio por país ou uma proteção contra hotlink aplicada ao HTML. Corrija a regra, não o sintoma, e teste com a ferramenta Inspeção de URL do Search Console.
Erros de redirecionamento
O Google informa um erro de redirecionamento quando encontra um loop, uma cadeia longa demais, uma URL que passa do tamanho máximo ou uma URL inválida ou vazia na cadeia. O caso clássico depois de uma migração: http para https, depois para www, depois para uma barra final, depois para um novo caminho. Quatro saltos onde um bastaria. Nosso guia completo de redirecionamentos para SEO explica como reduzi-los.
Tempos limite, respostas truncadas e páginas pesadas demais
Alguns erros nunca mostram um código de status. A página começa a carregar e para, ou é tão pesada que o rastreador lê só uma parte. Os rastreadores do Google leem um número limitado de bytes por arquivo, então uma página inchada com scripts inline ou imagens em base64 pode perder o conteúdo do final. Verifique os templates pesados com o verificador de tamanho de página.
Todas as formas de encontrar erros de rastreamento, comparadas
Nenhuma ferramenta sozinha mostra todos os erros de rastreamento. Cada método vê o problema de um ângulo diferente, e uma auditoria séria combina pelo menos dois.
Método 1: Search Console, relatório Estatísticas de rastreamento
Princípio: o Google mostra as próprias solicitações de rastreamento dos últimos 90 dias, agrupadas por resposta, tipo de arquivo, finalidade e tipo de Googlebot, além do status do host para DNS, servidor e robots.txt. Quando usar: sempre, e primeiro, para os erros de site. Vantagens: são os dados reais do próprio Google. Limites: só para propriedades no nível raiz, exemplos por amostragem, e o Google diz que sites com menos de mil páginas raramente precisam dele. Exemplo: um pico de respostas «tempo limite da página» todo domingo às 3h, que coincide com um backup do banco de dados.
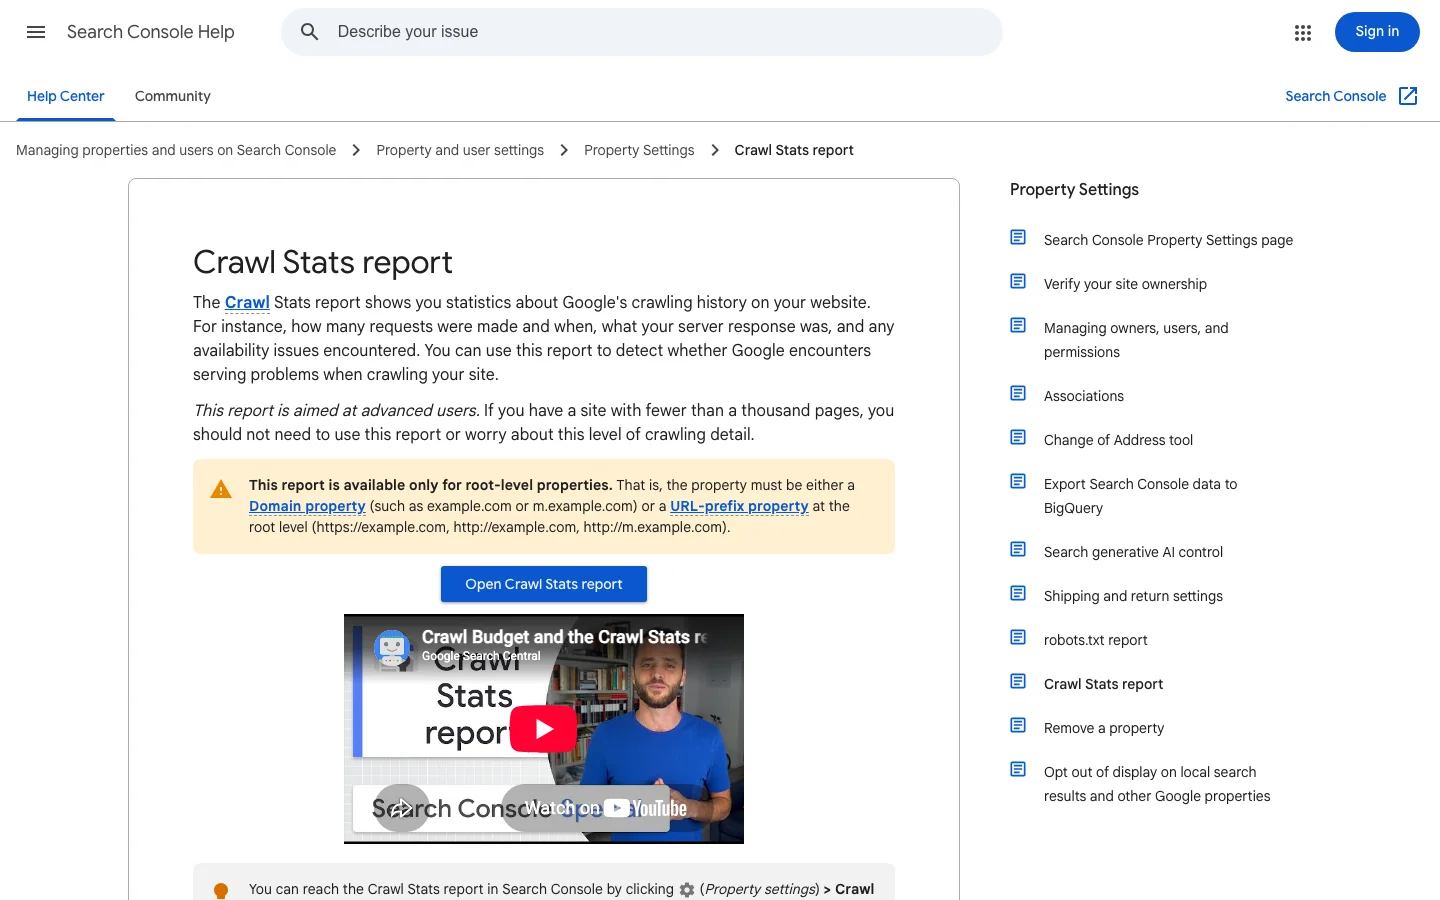
A documentação do Google sobre o relatório Estatísticas de rastreamento, que explica o status do host para DNS, servidor e robots.txt.
Método 2: Search Console, relatório Indexação de páginas e Inspeção de URL
Princípio: lista as URLs que o Google conhece e por que não estão indexadas, com motivos como Erro de servidor (5xx), Erro de redirecionamento, Não encontrada (404) ou Soft 404. Quando usar: para triar erros de URL e validar correções. Vantagens: ligado às páginas que o Google realmente tentou. Limites: os relatórios têm dias de atraso, as listas de exemplos são limitadas e o relatório mistura erros de rastreamento com escolhas de indexação. Exemplo: 300 URLs em «Erro de redirecionamento», todas com o antigo prefixo /blog/.
Método 3: um rastreador desktop ou na nuvem
Princípio: uma ferramenta como o Screaming Frog rastreia seu site como um robô faria, seguindo os links a partir da página inicial, e registra cada código de status, cada cadeia de redirecionamentos e cada link quebrado. Quando usar: antes e depois de uma migração, um redesign ou um grande deploy, e todo mês em sites grandes. Vantagens: imediato, completo para as páginas linkadas, mostra onde está cada link quebrado. Limites: não sabe o que o Google realmente pediu, não vê páginas órfãs e seu servidor pode tratá-lo de forma diferente do Googlebot. Nosso guia de configuração do Screaming Frog mostra uma auditoria completa.
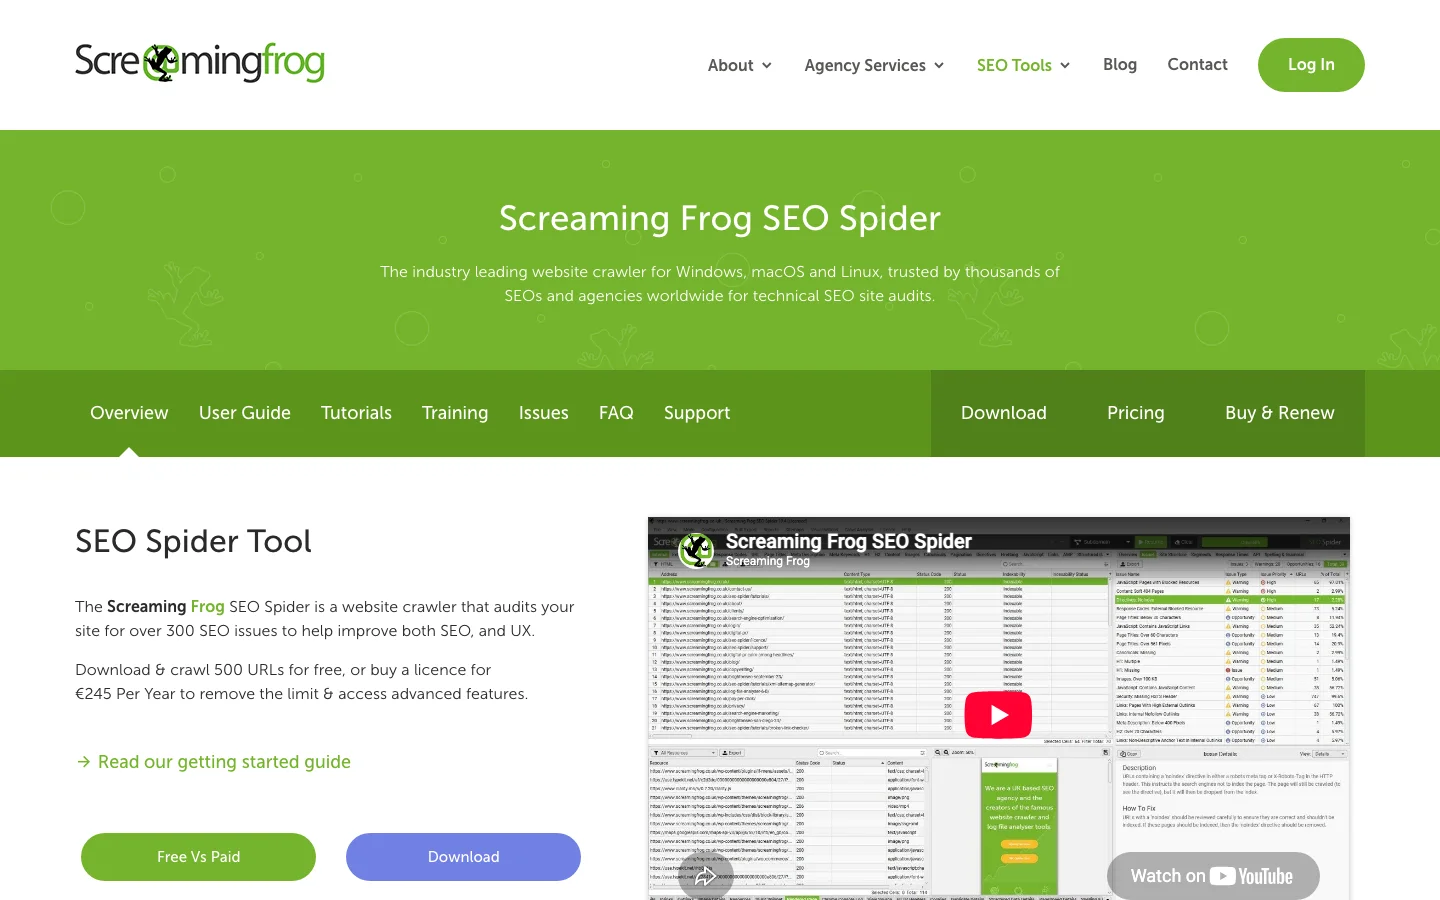
O Screaming Frog SEO Spider rastreia seu site como um robô e lista cada código de status, cadeia de redirecionamentos e link quebrado.
Método 4: análise dos logs do servidor
Princípio: seus logs de acesso registram cada solicitação, incluindo as do Googlebot, Bingbot, GPTBot, ClaudeBot e PerplexityBot, com o código de status exato e o tempo de resposta. Quando usar: em sites grandes, depois de quedas de tráfego sem explicação e para ver o que os rastreadores de IA acessam. Vantagens: solicitações reais, códigos reais, sem amostragem, todos os robôs. Limites: exige acesso aos logs e um pouco de script; é preciso verificar se o «Googlebot» é mesmo o Google. Nosso guia de análise de logs para SEO vai passo a passo. Uma primeira olhada rápida:
# Solicitações do Googlebot que não retornaram 200, 301 ou 304, as mais frequentes primeiro
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Método 5: verificações pontuais de uma URL
Princípio: testar uma URL de cada vez com curl ou com um verificador online gratuito. Quando usar: para confirmar uma correção ou conferir uma página importante depois de um deploy. Vantagens: instantâneo e preciso. Limites: não escala. Use um user agent do Googlebot para pegar regras que tratam robôs de forma diferente:
Erros 5xx: leia o código de status para encontrar a camada que falhou
Um status 5xx significa que o servidor não conseguiu processar uma requisição que parecia válida. O Google reduz o rastreamento em resposta, e reduz mais quando mais das suas URLs devolvem erros. Ele mantém por um tempo as URLs já indexadas, mas remove as que devolvem erro de servidor de forma persistente. Uma rajada curta se recupera, porque o Google volta a aumentar gradualmente a taxa de rastreamento assim que o seu servidor responde com códigos 2xx. O que prejudica o seu índice é uma longa sequência de erros.
O código indica qual camada quebrou
Cada código 5xx aponta para uma parte diferente da infraestrutura. A tabela oferece um primeiro lugar para olhar em cada caso.
Código
O que geralmente significa
Onde olhar primeiro
500
A aplicação falhou ao processar a requisição
O log de erros da aplicação no horário exato da requisição
502
O proxy ou a CDN recebeu uma resposta inválida da aplicação, muitas vezes porque ela travou ou reiniciou
Reinicializações e disponibilidade do processo da aplicação
503
O serviço está sobrecarregado, com limite de requisições ou em manutenção
Gráficos de carga, histórico de deploys e janelas de manutenção
504
O proxy desistiu de esperar pela aplicação
Consultas lentas ao banco de dados e configurações de tempo limite do proxy
429
Um limitador de requisições indica muitas requisições
Regras de limite de requisições e se elas valem para o Googlebot verificado
Cruze os horários do Google com os seus logs
O relatório Estatísticas de rastreamento mostra os dias e horários em que o Google encontrou erros (nosso guia de Estatísticas de rastreamento explica cada gráfico). O log do servidor mostra o que aconteceu nesses momentos exatos. Filtre as requisições do Googlebot e conte as respostas 5xx por hora:
Cada linha da saída é uma hora, um código e uma contagem. Um agrupamento na mesma hora todas as noites geralmente indica um backup, uma tarefa agendada ou uma importação programada. Erros espalhados pelo dia inteiro costumam indicar carga, então a correção é capacidade ou cache, e não um bug isolado. Para um método mais aprofundado, consulte nosso guia de análise de arquivos de log.
Meça o custo de um 5xx antes de entrar em pânico
O Google reduz o rastreamento na proporção do número de URLs que devolvem erros. Um modelo quebrado que afeta poucas URLs custa pouco tempo de rastreamento. Uma queda do banco de dados que quebra todas as páginas custa muito, e é essa que deve ser corrigida primeiro.
Um 429 tem o mesmo efeito de um 5xx, porque o Google o lê como um servidor sobrecarregado. Se o seu limitador de requisições ou a proteção contra bots devolve um 429 ao Googlebot, você paga por isso em tempo de rastreamento. A documentação do Google não menciona o cabeçalho Retry-After. Continue enviando-o a visitantes humanos e clientes de API, mas não conte com o Googlebot para esperar o tempo que você definiu.
Erros 4xx: descubra de onde eles vêm antes de corrigi-los
Um status 4xx significa que o servidor recusou a requisição por causa de algo do lado do cliente: a URL não existe, o acesso é proibido ou o endereço está malformado. O Google trata todos os 4xx da mesma forma, exceto o 429. Ele deixa de usar o conteúdo por trás dessa URL e a remove do índice, se ela estava indexada. Antes de mexer em um 4xx, descubra de onde vem a requisição, porque a correção muitas vezes está em um único lugar: um link, um modelo ou uma regra de redirecionamento.
Encontre a origem de cada 4xx nos seus logs
O log de acesso registra o referrer de cada requisição, ou seja, qual página enviou o visitante ou o robô até aquela URL. Conte as respostas 4xx por caminho e por referrer:
Um referrer do seu próprio domínio significa que uma das suas páginas aponta para uma URL morta. Corrija o link ou o modelo que a gera. É a correção mais valiosa, porque depende de você. Nosso guia sobre como corrigir links quebrados cobre o método completo.
Um referrer de outro site significa que um backlink aponta para uma URL que não funciona mais. Se o link vale a pena, adicione um único 301 para a página ativa mais próxima. Se não vale, deixe o 404 como está.
Um referrer vazio, ou um caminho que você nunca publicou, como uma página de login em um site estático, geralmente indica que um bot ou um scanner testou o endereço. Deixe que ele responda 404 e não perca tempo com isso.
Observe os picos de 4xx logo após cada publicação
Uma publicação que renomeia uma rota, altera um slug ou reconstrói um modelo costuma gerar uma onda de 404 no mesmo dia. Exporte o número de respostas 4xx por dia para a semana anterior ao deploy e para a semana seguinte. Um aumento concentrado em uma pasta aponta diretamente para a mudança. Adicione o redirecionamento da URL antiga para a nova na mesma publicação, e não em um chamado posterior. Para uma mudança completa, consulte nossa checklist de migração de SEO.
Dica
Não substitua uma página ausente por uma resposta 200 que mostra uma mensagem curta ou uma lista vazia. O Google pode tratá-la como um soft 404, o que custa um rastreamento completo e não rende nada em troca.
Passo a passo: corrija os erros de rastreamento na ordem certa
Este é o método que usamos. Ele vai dos erros que podem parar o site inteiro até os que só desperdiçam um pouco de rastreamento.
O método em 6 etapas contra erros de rastreamento
Verificar o status do hostAbra Estatísticas de rastreamento e olhe DNS, conexão com o servidor e robots.txt dos últimos 90 dias.
Exportar e agrupar os erros de URLExporte cada motivo da Indexação de páginas e agrupe as URLs por pasta ou template.
Ordenar por valorFique com as URLs que têm tráfego, backlinks, links internos ou entrada no sitemap.
Corrigir a causa no templateUma regra, um mapa de redirecionamentos ou um ajuste no servidor corrige centenas de URLs.
Limpar os sinaisAtualize links internos e sitemaps para apontarem para as URLs finais em 200.
Validar e monitorarClique em Validar correção e acompanhe as estatísticas de rastreamento e os logs toda semana.
Etapa 1: verifique o host primeiro
No Search Console, abra Configurações, depois Estatísticas de rastreamento, depois Status do host. Verde significa nenhum problema relevante em 90 dias. «Problema recente» significa um problema relevante na última semana: deixe todo o resto de lado. Clique em cada categoria para ver a taxa de falhas por dia e compare os dias ruins com o histórico de hospedagem, CDN e deploys.
Etapa 2: exporte e agrupe por padrão
Abra Indexação, depois Páginas, e exporte cada motivo de erro. Não corrija URLs uma a uma. Coloque-as numa planilha e extraia a primeira pasta:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
Uma tabela dinâmica nessa coluna costuma mostrar que a maioria dos erros vem de dois ou três templates: uma categoria de blog desativada, um parâmetro de filtro, um feed de produtos antigo.
Etapa 3: ordene por valor de negócio
Para cada padrão, faça quatro perguntas. Recebe cliques orgânicos? Tem backlinks? Tem links internos? Está no sitemap? Um 404 sem nenhuma das quatro pode esperar para sempre. Um 404 com backlinks precisa de um 301 hoje. O verificador de links quebrados gratuito mostra quais páginas do seu site ainda apontam para URLs mortas.
Etapa 4: corrija a causa de fundo
Corrija regras, não URLs. Um mapa de redirecionamentos na configuração do servidor é melhor do que 400 redirecionamentos adicionados à mão num plugin. Por exemplo, no nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Para os 5xx, corrija a capacidade ou o bug. Para 401 e 403, corrija a regra de segurança. Para soft 404, adicione conteúdo de verdade ou retorne um 404 de verdade.
Etapa 5: limpe links internos e sitemaps
Todo link interno deve apontar direto para uma URL que retorna 200. Toda entrada do sitemap deve ser uma URL canônica, indexável e em 200. Um sitemap cheio de redirecionamentos e 404 ensina o Google a confiar menos nele. Nosso guia sobre como criar um sitemap explica o que deve entrar nele.
Etapa 6: valide e monitore
No relatório Indexação de páginas, abra o motivo corrigido e clique em Validar correção. O Google confere primeiro uma amostra, depois o resto; isso costuma levar até cerca de duas semanas, e a validação para se uma única URL ainda falhar. Não clique de novo enquanto ela roda. Depois, crie uma rotina semanal: Estatísticas de rastreamento para o host, logs para os picos, um rastreamento depois de cada deploy.
Uma cadeia de redirecionamentos antes e depois da correção
Antes
http://site.com/page
301 para https://site.com/page
301 para https://www.site.com/page
301 para https://www.site.com/page/
Os links internos ainda apontam para a primeira URL
Depois
Um único 301 direto para https://www.site.com/page/
Links internos atualizados para a URL final
O sitemap lista só a URL final
Uma solicitação em vez de quatro
Erros comuns: como identificar e corrigir
Erro 1: redirecionar todo 404 para a página inicial
O que é: um plugin ou uma regra que manda qualquer URL inexistente para /. Como identificar: muitas URLs em «Soft 404» ou «Página com redirecionamento» que caem todas na página inicial; um rastreador mostra centenas de 301 para o mesmo destino. Como corrigir: redirecione só para um equivalente próximo e deixe o resto retornar 404 ou 410.
Erro 2: bloquear o Googlebot com ferramentas de segurança
O que é: um WAF, um gerenciador de bots ou um limitador de taxa que entrega ao Google um 403, um 429 ou uma página de desafio. Como identificar: 403 ou 429 nas Estatísticas de rastreamento enquanto a página carrega normalmente no seu navegador; os logs mostram os bloqueios por IP. Como corrigir: libere o Googlebot verificado, por DNS reverso ou pelas faixas de IP publicadas pelo Google, em vez de confiar no user agent.
Erro 3: um robots.txt frágil
O que é: um robots.txt gerado pela aplicação, que cai toda vez que a aplicação cai, ou servido por uma regra de CDN que guarda um 5xx em cache. Como identificar: a categoria busca do robots.txt em Status do host não está verde. Como corrigir: sirva-o como arquivo estático, fora da aplicação, e teste-o com o verificador de robots.txt.
Erro 4: páginas de manutenção que retornam 200
O que é: uma página «Voltamos em breve» servida com status 200 em todas as URLs. Como identificar: depois da manutenção, uma onda de soft 404 ou de títulos duplicados. Como corrigir: retorne 503 com Retry-After durante a manutenção, e mantenha-a curta.
Erro 5: usar 403 para desacelerar o Google
O que é: responder 403 ao Googlebot quando o servidor está sobrecarregado. Como identificar: picos de 403 que coincidem com picos de carga. Como corrigir: o Google diz que códigos 4xx diferentes de 429 não têm efeito na frequência de rastreamento. Retorne 503 ou 429 por pouco tempo e corrija a capacidade.
Erro 6: corrigir erros um por um
O que é: percorrer a lista do Search Console e editar cada URL. Como identificar: o mesmo motivo volta todo mês. Como corrigir: agrupe por padrão, corrija o template ou a regra e valide uma única vez.
Erro 7: entrar em pânico com 404 inofensivos
O que é: passar dias com 404 de URLs de spam ou de páginas apagadas há muito tempo e sem links. Como identificar: as URLs não têm cliques, nem backlinks, nem links internos. Como corrigir: deixe-as. O Google diz que um 404 de uma página removida não é necessariamente um problema.
Atenção
Nunca bloqueie uma URL no robots.txt para «esconder» um erro de rastreamento. O Google deixa de ver o 404 ou o redirecionamento, a URL pode continuar indexada e você perde o sinal que queria enviar.
Erros de rastreamento e orçamento de rastreamento
Num site com algumas centenas de páginas, o Google tem tempo para tudo, e os erros de rastreamento importam sobretudo pelas páginas que quebram. Em sites grandes (lojas com filtros, marketplaces, portais de notícias), cada solicitação que falha ou é desperdiçada tira tempo das suas páginas reais. Essa é a ideia por trás do orçamento de rastreamento.
Como os erros consomem a capacidade de rastreamento
5xx e 429 fazem o Google desacelerar no host inteiro, então alguns templates quebrados podem atrasar o rastreamento das suas novas páginas de produto. Cadeias de redirecionamentos custam uma solicitação por salto. Soft 404 custam uma busca completa e não entregam nada. Corrija esses três e o mesmo orçamento cobre mais páginas úteis.
O que «Detectada, mas não indexada no momento» tem a ver com isso
Quando o Google encontra URLs mas adia o rastreamento, a causa costuma ser um servidor que ele considera frágil. Se você vê crescer o número de «Detectada, mas não indexada no momento» junto com erros de servidor nas Estatísticas de rastreamento, corrija o servidor primeiro. Os dois relatórios contam a mesma história.
Erros de rastreamento dos rastreadores de IA
O Googlebot não é mais o único visitante que importa. GPTBot, OAI-SearchBot, ClaudeBot e PerplexityBot buscam páginas para treinar modelos ou responder perguntas em tempo real. Eles acessam o mesmo servidor e sofrem com os mesmos erros, com uma diferença: você não tem um Search Console para eles.
O que muda com os robôs de IA
A maioria dos rastreadores de IA não executa JavaScript, então uma página que só monta o conteúdo no navegador pode parecer vazia para eles, uma espécie de soft 404 que você nunca vai ver nos relatórios do Google. Muitos são bloqueados por padrão pelos serviços de proteção contra bots, muitas vezes com um 403. E como buscam as páginas sob demanda quando um usuário faz uma pergunta, um tempo limite nesse momento significa que a resposta cita outra pessoa. Nosso guia de SEO para JavaScript trata da renderização para buscadores e rastreadores de IA.
Como monitorá-los
Os logs do servidor são a única fonte confiável. Filtre por user agent e observe os códigos de status:
Se os robôs de IA recebem 403 que você não queria, corrija a regra. Depois, confira se eles realmente citam você: o monitoramento de menções em IA da Sorank acompanha com que frequência ChatGPT, Gemini, Claude e Perplexity mencionam sua marca, para você ver se uma correção de rastreamento muda alguma coisa.
Seu checklist de saúde do rastreamento
Passe por esta lista depois de cada migração, redesign ou grande deploy, e uma vez por mês em sites grandes.
Checklist de saúde do rastreamento
Status do host verde para DNS, conexão com o servidor e robots.txt
robots.txt servido como arquivo estático e retornando 200
Nenhum pico de 5xx ou 429 nas Estatísticas de rastreamento ou nos logs
Googlebot verificado e robôs de IA desejados não bloqueados pelo firewall
Cada redirecionamento é um único salto, 301 ou 308, para uma página 200
Links internos apontam para as URLs finais em 200
Sitemaps listam só URLs canônicas, indexáveis e em 200
404 com backlinks ou tráfego redirecionados para um equivalente próximo
Páginas vazias corrigidas ou retornando um 404 de verdade
A manutenção retorna 503 com Retry-After
Validar correção iniciado para cada motivo corrigido
O que fazer hoje
Abra Estatísticas de rastreamento e confira as três linhas do status do host. Depois, rode o verificador de indexabilidade gratuito nas suas cinco páginas mais valiosas. Se tudo estiver limpo, exporte os erros da Indexação de páginas e agrupe-os por pasta: agora você tem uma lista curta e priorizada de correções em vez de um relatório assustador.
Com o rastreamento limpo, o próximo limite é o próprio conteúdo. A otimização de conteúdo da Sorank reescreve e atualiza suas páginas existentes em autopilot, para que as páginas que o Google agora alcança mereçam ser indexadas e citadas. Para as páginas que o Google rastreou mas deixou de fora, leia nosso guia sobre «Rastreada, mas não indexada no momento».
Perguntas frequentes
O que são erros de rastreamento em SEO?
Erros de rastreamento são solicitações de um buscador ou de um rastreador de IA que falham: o DNS não resolve, o servidor excede o tempo ou retorna 5xx, o robots.txt não pode ser buscado, um redirecionamento entra em loop ou uma página retorna um código 4xx. Erros de site podem pausar o rastreamento do site inteiro, enquanto erros de URL afetam só a página em questão.
Erros 404 são ruins para o SEO?
Não por si só. O Google diz que um 404 de uma página removida sem substituta não é necessariamente um problema. Passa a ser quando a URL ainda tem backlinks, tráfego ou links internos; nesse caso, a correção certa é um único 301 para um equivalente próximo.
Quanto tempo o Google leva para ver que os erros de rastreamento foram corrigidos?
Depois de clicar em Validar correção no relatório Indexação de páginas do Search Console, a validação costuma levar até cerca de duas semanas. O Google confere primeiro uma amostra de URLs, depois o resto, e para se uma única URL afetada ainda falhar.
y!
Receba gratuitamente o seu plano de conteúdo para 30 dias
Analisamos seus concorrentes, seu site e sua visibilidade nas IA para criar, gratuitamente, um plano de conteúdo sob medida.
“Testei o Sorank no site real de um cliente e é uma loucura. Faz tudo aquilo que uma agência cobra 1.500 € por mês. Agora vai para produção nesse cliente.”Guillaume Guersanguersanguillaume.com
“Somos uma agência de publicidade e queríamos colocar nosso SEO nos trilhos de uma vez por todas. A Sorank nos deu uma visão clara do nosso site, ajudou-nos a priorizar as otimizações e estruturar corretamente nosso conteúdo. A ferramenta é fácil de usar, bem projetada para uma equipe e muito prática para centralizar o acompanhamento sem ter que fazer malabarismos entre várias plataformas. Uma base muito sólida para recomeçar do zero com nosso SEO.”Gaspard MadouiAgência de Publicidade
“Me especializei em GEO graças à Sorank. O GEO Leaderboard me permite mostrar aos meus clientes o seu posicionamento em relação aos concorrentes no ChatGPT. É um verdadeiro diferencial comercial.”MélanieFreelancer SEO
“Excelente serviço, funciona bem para o nosso site e nos ajuda a entender como melhorá-lo para nos posicionarmos melhor no Google e em outros lugares. Parabéns, continuem assim, eu recomendo.”Hugo T.Comerciante de e-commerce