Předvolby
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

Najděte a opravte chyby procházení: DNS, server, robots.txt, 404, soft 404 a přesměrování. Jak na každou reaguje Googlebot a metoda v 6 krocích pro opravu v pořadí.

Nástroje

Ve zkratce
chyby procházení (crawl errors) jsou požadavky vyhledávače nebo AI crawleru na váš web, které selžou: server nestihne odpovědět, DNS neodpovídá, soubor robots.txt nejde načíst, přesměrování se zacyklí nebo stránka vrátí kód 4xx či 5xx. Chyby na úrovni webu (DNS, server, robots.txt) mohou Googlu zastavit procházení celého webu, proto je opravte jako první; chyby na úrovni URL (404, soft 404, chyby přesměrování) jsou důležité jen tehdy, když zasáhnou stránky, které chcete mít v indexu. Najdete je v přehledech Statistiky procházení a Indexování stránek v Search Console, ověříte je crawlerem a logy serveru, pak odstraníte příčinu a opravu ověříte.
Chcete jít dál? Zeptejte se
Rychlý kvíz
Kdo má opravit technickou stránku vašeho webu?
Naše doporučení pro vás
Zkontrolujte to sami pomocí bezplatných nástrojů Googlu
Search Console vypíše stránky, které Google nedokáže přečíst, a PageSpeed Insights testuje rychlost. Mnoho drobných problémů se opraví v nastavení tvorby webu.
Naše doporučení pro vás
Webový vývojář
Problém je v kódu nebo na serveru: správný člověk je vývojář, který zná SEO. Dejte mu seznam chyb ze Search Console.
Naše doporučení pro vás
Nástroj pro technický audit
Váš web má mnoho stránek: crawler je přečte všechny stejně jako Google a vypíše úplný seznam chyb k opravě, stránku po stránce.
Naše doporučení pro vás
Automatický audit, pak obsah
Váš web funguje, ale přináší málo návštěvníků: technické problémy bývají jen zřídka příčinou. Sorank web auditne a poté napíše stránky, které přivedou návštěvnost.
Crawler funguje jako velmi trpělivý návštěvník. Požádá váš server o URL, počká na odpověď, přečte stavový kód a obsah a pak pokračuje na nalezené odkazy. Chyba procházení je jakýkoli krok tohoto řetězce, který selže. Návštěvník nikdy nedostane použitelnou stránku.
Tato definice je důležitá, protože mnoho přehledů míchá chyby procházení s rozhodnutími o indexaci. „Procházeno, momentálně neindexováno“ není chyba procházení: Google stránku bez problému načetl a rozhodl se ji neponechat. „Vyloučeno značkou noindex“ také ne: sami jste Googlu řekli, ať stránku vyřadí. Chyba procházení znamená, že selhalo samotné načtení.
Google dělí problémy do dvou úrovní a vy byste měli také.
Chyby webu a chyby URL
E-shop se 4000 starými URL produktů, které vracejí 404, může být naprosto v pořádku, pokud tyto produkty skončily natrvalo. Tentýž e-shop se souborem robots.txt, který šest hodin vrací 503, má skutečný poplach, i když každá produktová stránka funguje. Začněte hostitelem, pak URL, které vydělávají, a nakonec zbytkem.
Abyste chyby procházení opravovali dobře, musíte vědět, co Google skutečně dělá, když na ně narazí. Dokumentace Googlu o tom, jak stavové kódy HTTP a chyby sítě a DNS ovlivňují Vyhledávání Google (Google Search Central), uvádí pravidla. V praxi znamenají toto.
| Odpověď | Co Google udělá | Je to problém? |
|---|---|---|
| 2xx | Předá obsah k indexaci. Indexace není zaručena. | Ne, pokud stránka není prázdná (soft 404). |
| 301, 308 | Silný signál, že cíl je nová URL. | Ne, pokud jde o jeden skok na 200. |
| 302, 303, 307 | Slabý signál: původní URL obvykle zůstává kanonická. | Ano, pokud je přesun trvalý. |
| Řetězce 3xx | Ve výchozím stavu sleduje nejvýše 10 skoků, pak to vzdá. | Ano: každý skok plýtvá požadavkem a smyčky se nikdy nevyřeší. |
| 404, 410, další 4xx (kromě 429) | Považuje obsah za neexistující, postupně vyřazuje indexované URL, prochází je méně často. | Jen pokud by stránka měla existovat. |
| 401, 403 | Stejně jako ostatní 4xx. Procházení nezpomalují. | Ano, pokud blokují Googlebot na veřejných stránkách. |
| 429 | Bere se jako signál přetížení serveru, stejně jako 5xx. | Ano: procházení se zpomalí. |
| 5xx | Zpomaluje procházení úměrně počtu chyb. URL, které trvale selhávají, jsou z indexu odstraněny. | Ano, vždy. |
Na dvou detailech se spálí mnoho týmů. Zaprvé, 401 a 403 nesnižují rychlost procházení. Pokud má server potíže, vracet Googlebotu 403 nepomůže; Google žádá, abyste dočasně vraceli 503 nebo 429. Zadruhé, 404 není trest. Je to správná odpověď pro stránku, která už neexistuje.
Dokumentace přehledu Statistiky procházení (Nápověda Search Console) pravidlo vysvětluje. robots.txt, který odpoví 200 (i prázdný) nebo 403, 404 či 410 (soubor neexistuje), je v pořádku. robots.txt, který odpoví 429 nebo 5xx, je selhání a Google pak postupuje opatrně.
Co Google dělá, když robots.txt opakovaně selhává
Zdroj: Nápověda Google Search Console, přehled Statistiky procházení
Pravidlo CDN nebo firewall, které na /robots.txt vrací 503, tak může zmrazit celý web na půl dne, i když všechny ostatní URL fungují. Při každém zkoumání chyb procházení kontrolujte tento soubor jako první. Náš průvodce stavem „Blokováno souborem robots.txt“ řeší opačný problém: soubor funguje, ale blokuje příliš mnoho.
Limity procházení Googlu, které stojí za zapamatování
Zdroje: Google Search Central, stavové kódy HTTP a chyby sítě; Nápověda Search Console, přehled Statistiky procházení
Zde je úplný seznam, se kterým se setkáte v Search Console a v crawlerech, s příčinou a opravou každého typu. Názvy odpovídají dokumentaci přehledu Indexování stránek (Nápověda Search Console).
Google nedokázal přeložit název domény na IP adresu nebo DNS server neodpověděl. Časté příčiny: vypršelá doména, výpadek poskytovatele DNS, chybný záznam po migraci nebo špatně nastavený DNSSEC. Ověřte dotazem mimo vlastní síť:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
Oprava: opravte záznamy, před každou migrací snižte TTL a používejte poskytovatele DNS s redundancí. Pokud existuje example.com i www.example.com, musí se překládat obě, i když jedna jen přesměrovává.
Server neodpověděl včas, ukončil spojení nebo odpověděl 500, 502, 503 či 504. Typické příčiny: přetížená databáze, proces PHP nebo Node, který pod zátěží spadne, timeout reverzní proxy, aktualizace pluginu nebo firewall, který omezuje boty. Sledujte časový vzorec: chyby každou noc ve stejnou hodinu často ukazují na zálohu nebo úlohu cron.
Oprava: přečtěte chybový log serveru v časech, které Google uvádí, zvyšte timeouty nebo počet workerů, kešujte těžké stránky a ověřte, že ochrana proti botům propouští ověřený Googlebot. Při plánované údržbě vracejte 503 s hlavičkou Retry-After místo stránky 200 s nápisem „brzy jsme zpět“:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600Stránka neexistuje. To je v pořádku, když byla smazána záměrně a nic na ni neodkazuje. Problém je, když URL stále má zpětné odkazy, návštěvnost nebo interní odkazy, nebo když by stránka existovat měla a nasazení ji rozbilo.
Oprava: pokud se obsah přesunul, přidejte jediné přesměrování 301 na nejbližší ekvivalent. Pokud zmizel natrvalo, ponechte 404 nebo použijte 410 a odstraňte interní odkazy a položky v sitemapě, které na něj vedou. Nikdy nepřesměrovávejte všechny 404 na domovskou stránku: Google je obvykle považuje za soft 404.
Server hlásí 200, ale stránka vypadá prázdná nebo píše „nenalezeno“: prázdná kategorie, vyhledávání bez výsledků, nedostupný produkt bez obsahu. Google utratí požadavek a nic nezíská. Podrobně se tomu věnujeme v průvodci chybami soft 404.
Googlebot nikdy neposílá přihlašovací údaje, takže 401 nebo 403 na veřejné stránce znamená, že ho blokuje server nebo bezpečnostní vrstva. Častí viníci: heslo z testovacího prostředí zapomenuté na produkci, pravidlo WAF, blokace zemí nebo ochrana proti hotlinkingu použitá na HTML. Opravte pravidlo, ne symptom, a otestujte nástrojem Kontrola adresy URL v Search Console.
Google hlásí chybu přesměrování, když narazí na smyčku, příliš dlouhý řetězec, URL delší než maximální délka nebo chybnou či prázdnou URL v řetězci. Klasický případ po migraci: http na https, pak na www, pak na koncové lomítko, pak na novou cestu. Čtyři skoky tam, kde stačí jeden. Náš kompletní průvodce SEO přesměrováními vysvětluje, jak je zkrátit.
Tip
Vložte podezřelou URL do bezplatného nástroje Sorank pro kontrolu přesměrování: projde celý řetězec, ukáže každý skok a jeho stavový kód a řekne vám, kde je smyčka nebo nadbytečný skok.
Některé chyby nikdy neukážou stavový kód. Stránka se začne načítat a zastaví se, nebo je tak těžká, že crawler přečte jen část. Crawlery Googlu čtou z každého souboru omezený počet bajtů, takže stránka nafouknutá inline skripty nebo obrázky v base64 může přijít o obsah na konci. Těžké šablony zkontrolujte nástrojem pro kontrolu velikosti stránky.
Žádný nástroj sám neukáže všechny chyby procházení. Každá metoda vidí problém z jiného úhlu a důkladný audit kombinuje alespoň dvě.
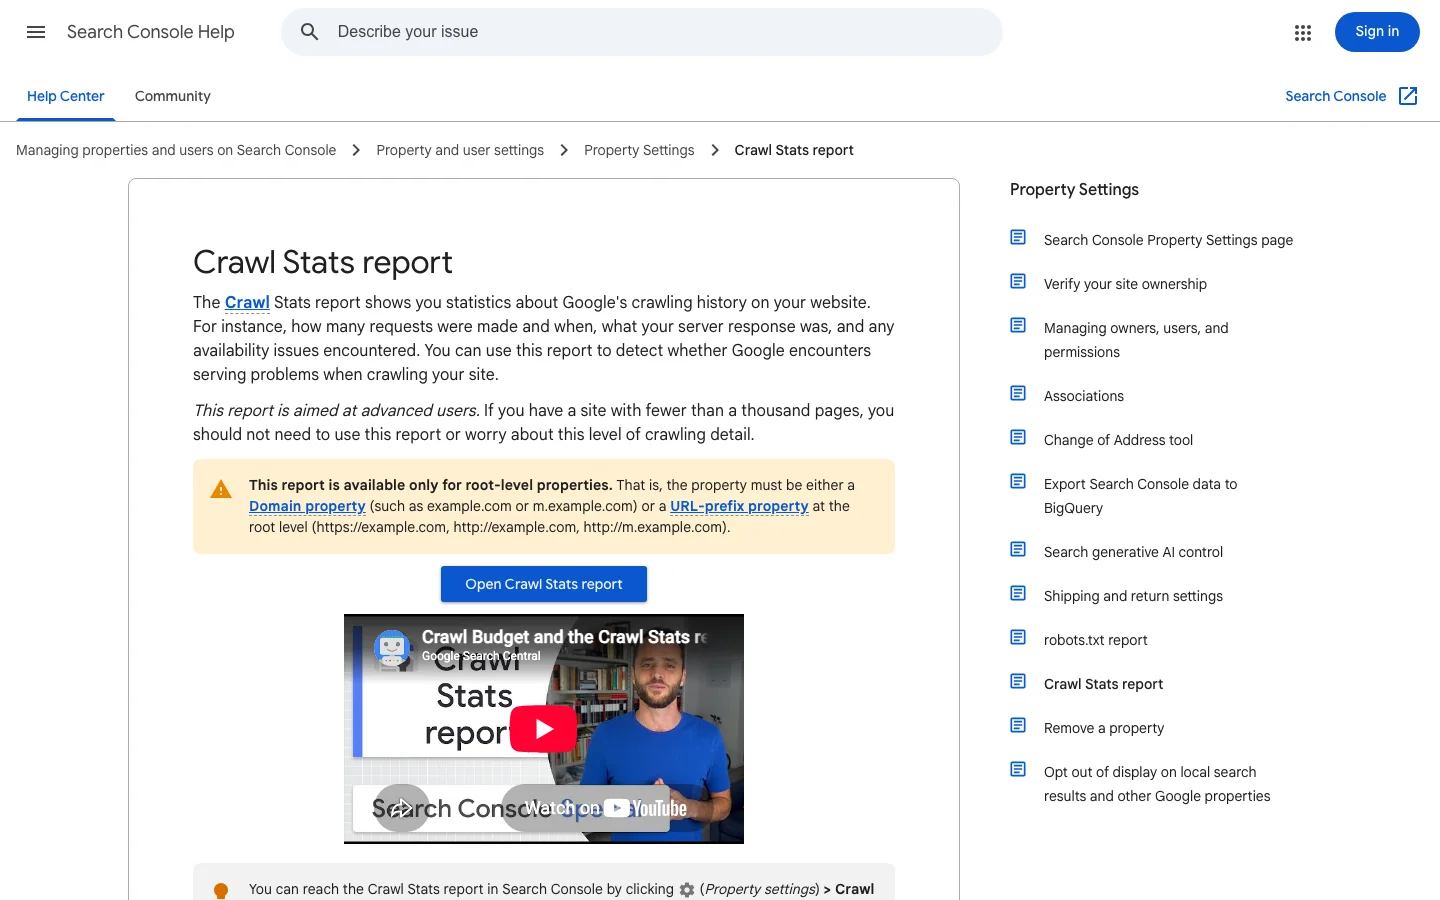
Princip: Google ukazuje vlastní požadavky za posledních 90 dní seskupené podle odpovědi, typu souboru, účelu a typu Googlebotu, plus stav hostitele pro DNS, server a robots.txt. Kdy použít: vždy a jako první, pro chyby webu. Výhody: jsou to data přímo od Googlu. Omezení: jen pro služby na úrovni kořenové domény, příklady jsou vzorkované a Google uvádí, že weby pod tisíc stránek ho potřebují zřídka. Příklad: nárůst odpovědí „vypršel časový limit stránky“ každou neděli ve 3 ráno, shodný se zálohou databáze.
Princip: vypisuje URL, které Google zná, a důvody, proč nejsou indexované, například Chyba serveru (5xx), Chyba přesměrování, Nenalezeno (404) nebo Soft 404. Kdy použít: k roztřídění chyb URL a ověření oprav. Výhody: vázané na stránky, které Google skutečně zkusil. Omezení: přehledy mají několikadenní zpoždění, seznamy příkladů jsou omezené a míchají chyby procházení s rozhodnutími o indexaci. Příklad: 300 URL v „Chyba přesměrování“ se stejnou starou předponou /blog/.
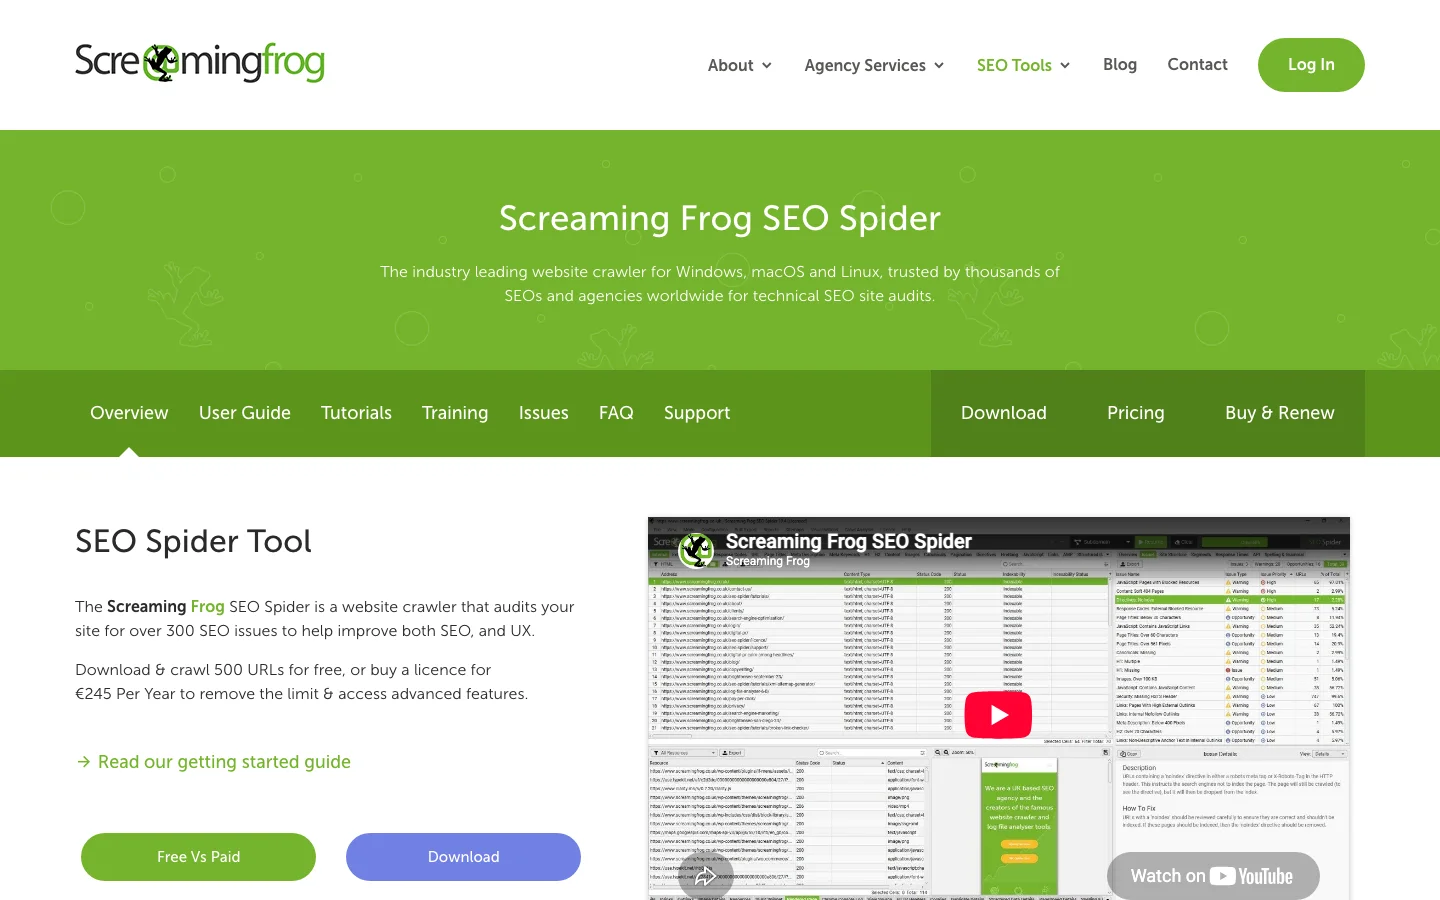
Princip: nástroj jako Screaming Frog prochází web jako bot, sleduje odkazy z domovské stránky a zaznamenává každý stavový kód, řetězec přesměrování a nefunkční odkaz. Kdy použít: před migrací, redesignem nebo velkým nasazením a po nich, na velkých webech každý měsíc. Výhody: okamžitý, úplný pro odkazované stránky, ukáže, kde přesně je každý nefunkční odkaz. Omezení: neví, co Google skutečně požadoval, vynechá osiřelé stránky a server s ním může zacházet jinak než s Googlebotem. Náš průvodce nastavením Screaming Frog provede kompletním auditem.
Princip: přístupové logy zaznamenávají každý požadavek, včetně Googlebotu, Bingbotu, GPTBotu, ClaudeBotu a PerplexityBotu, s přesným stavovým kódem a dobou odezvy. Kdy použít: na velkých webech, po nevysvětlených poklesech návštěvnosti a pro přehled o tom, co navštěvují AI crawlery. Výhody: skutečné požadavky, skutečné kódy, bez vzorkování, všichni boti. Omezení: vyžaduje přístup k logům a trochu skriptování; musíte ověřit, že „Googlebot“ je opravdu Google. Náš průvodce analýzou logů pro SEO jde krok za krokem. Rychlý první pohled:
# Požadavky Googlebotu, které nevrátily 200, 301 ani 304, nejčastější nahoře
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50Princip: testujte jednu URL po druhé přes curl nebo bezplatný online nástroj. Kdy použít: k potvrzení opravy nebo kontrole klíčové stránky po nasazení. Výhody: okamžité a přesné. Omezení: neškáluje. Použijte user agent Googlebotu, abyste odhalili pravidla, která s boty zacházejí jinak:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| Metoda | Vidí chyby webu | Vidí chyby URL | Skutečná data Googlebotu | Vidí AI crawlery | Nejlepší pro |
|---|---|---|---|---|---|
| Statistiky procházení | Ano | Vzorkově | Ano | Ne | Zdraví hostitele |
| Indexování stránek | Částečně | Ano | Ano | Ne | Třídění a ověření |
| Crawler (Screaming Frog...) | Ne | Ano, odkazované stránky | Ne | Ne | Hledání nefunkčních odkazů u zdroje |
| Logy serveru | Částečně | Ano | Ano | Ano | Velké weby, kořenové příčiny |
| Kontroly jednotlivých URL | Ne | Po jedné | Ne | Ne | Potvrzení oprav |
Stav 5xx znamená, že server nedokázal zpracovat požadavek, který vypadal jako správný. Google na to reaguje zpomalením procházení a zpomaluje tím víc, čím více vašich URL vrací chyby. Už zaindexované URL si Google nějakou dobu drží, ale URL, které trvale vracejí chybu serveru, odstraní. Krátká vlna chyb se dá zvládnout, protože Google postupně zvyšuje rychlost procházení, jakmile server začne znovu odpovídat kódy 2xx. Index poškozuje až dlouhá řada chyb.
Každý kód 5xx ukazuje na jinou část technologického zásobníku. Tabulka vám u každého z nich napoví, kde začít hledat.
| Kód | Obvykle znamená | Nejdřív se podívejte na |
|---|---|---|
| 500 | Aplikace selhala při zpracování požadavku | Chybový log aplikace přesně v čase požadavku |
| 502 | Proxy nebo CDN dostalo od aplikace neplatnou odpověď, často proto, že aplikace spadla nebo se restartovala | Restarty a dostupnost procesu aplikace |
| 503 | Služba je přetížená, omezená limitem nebo v údržbě | Grafy zátěže, historie nasazení a časy údržby |
| 504 | Proxy přestalo čekat na aplikaci | Pomalé databázové dotazy a nastavení časového limitu proxy |
| 429 | Omezovač požadavků hlásí příliš mnoho požadavků | Pravidla omezení a to, zda se vztahují na ověřeného Googlebota |
Statistiky procházení ukazují dny a hodiny, kdy Google narazil na chyby (náš průvodce Statistikami procházení vysvětluje každý graf). Log serveru ukazuje, co se přesně v těch chvílích dělo. Vyfiltrujte požadavky Googlebota a spočítejte odpovědi 5xx za hodinu:
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
Každý řádek výstupu je hodina, stavový kód a počet. Shluk v téže hodině každou noc obvykle ukazuje na zálohu, cron úlohu nebo naplánovaný import. Chyby rozprostřené přes celý den obvykle ukazují na zátěž, takže řešením je kapacita nebo cache, a ne jediná chyba. Hlubší postup najdete v našem průvodci analýzou logů serveru.
Google snižuje procházení úměrně počtu URL, které vrací chyby. Rozbitá šablona, která postihuje několik URL, vás stojí málo času procházení. Výpadek databáze, který rozbije každou stránku, vás stojí hodně a opravit ho je třeba jako první.
Kód 429 má stejný dopad jako 5xx, protože ho Google čte jako přetížený server. Pokud váš omezovač nebo ochrana proti botům vrací Googlebotovi 429, platíte za to časem procházení. Dokumentace Googlu hlavičku Retry-After nezmiňuje. Posílejte ji dál lidským návštěvníkům a klientům API, ale nespoléhejte na to, že Googlebot počká tak dlouho, jak jste nastavili.
Stav 4xx znamená, že server požadavek odmítl kvůli něčemu na straně klienta: URL neexistuje, přístup je zakázán nebo je adresa chybně zapsaná. Google zachází se všemi kódy 4xx kromě 429 stejně. Přestane používat obsah za touto URL a pokud byla URL zaindexovaná, vyřadí ji z indexu. Než na 4xx sáhnete, zjistěte, odkud požadavek přichází, protože oprava je často na jednom místě: v odkazu, v šabloně nebo v pravidle přesměrování.
Přístupový log zaznamenává referrer každého požadavku, takže víte, která stránka poslala návštěvníka nebo bota na danou URL. Spočítejte odpovědi 4xx podle cesty a podle referreru:
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
Sloupec referreru čtěte takto:
Vydání, které přejmenuje trasu, změní slug nebo přestaví šablonu, často způsobí během jednoho dne vlnu 404. Exportujte počet odpovědí 4xx za den za týden před nasazením a za týden po něm. Nárůst soustředěný v jedné složce ukazuje přímo na změnu. Přesměrování ze staré URL na novou přidejte ve stejném vydání, ne až v pozdějším úkolu. Při úplném přesunu viz náš kontrolní seznam migrace SEO.
Tip
Chybějící stránku nenahrazujte odpovědí 200, která zobrazuje krátkou zprávu nebo prázdný seznam. Google to může považovat za soft 404, což stojí celé stažení a nic to nepřinese.
Tuto metodu používáme sami. Postupuje od chyb, které mohou zastavit celý web, k těm, které plýtvají jen trochou procházení.
Metoda chyb procházení v 6 krocích
V Search Console otevřete Nastavení, pak Statistiky procházení a pak Stav hostitele. Zelená znamená žádný významný problém za 90 dní. „Nedávný problém“ znamená vážnou potíž v posledním týdnu: nechte všeho ostatního. Klikněte na každou kategorii a podívejte se na podíl selhání po dnech, pak špatné dny porovnejte s historií hostingu, CDN a nasazení.
Otevřete Indexování, pak Stránky, a exportujte každý důvod chyby. Neopravujte URL jednu po druhé. Dejte je do tabulky a vytáhněte první složku:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")Kontingenční tabulka nad tímto sloupcem obvykle ukáže, že většina chyb pochází ze dvou nebo tří šablon: zrušené kategorie blogu, parametru filtru, starého produktového feedu.
U každého vzoru si položte čtyři otázky. Má organická kliknutí? Má zpětné odkazy? Odkazuje se na něj interně? Je v sitemapě? 404 bez jediné z těchto čtyř věcí může čekat navždy. 404 se zpětnými odkazy potřebuje 301 dnes. Bezplatný nástroj pro kontrolu nefunkčních odkazů ukáže, které vaše stránky stále odkazují na mrtvé URL.
Opravujte pravidla, ne URL. Mapa přesměrování v konfiguraci serveru je lepší než 400 přesměrování ručně přidaných v pluginu. Například v nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
U 5xx opravte kapacitu nebo chybu. U 401 a 403 opravte bezpečnostní pravidlo. U soft 404 buď doplňte skutečný obsah, nebo vraťte skutečnou 404.
Každý interní odkaz by měl vést přímo na URL, která vrací 200. Každá položka sitemapy by měla být kanonická, indexovatelná URL s kódem 200. Sitemapa plná přesměrování a 404 učí Google, aby jí věřil méně. Náš průvodce jak vytvořit sitemapu vysvětluje, co do ní patří.
V přehledu Indexování stránek otevřete opravený důvod a klikněte na Ověřit opravu. Google nejprve zkontroluje vzorek, pak zbytek; obvykle to trvá zhruba až dva týdny a zastaví se, pokud byť jediná URL stále selhává. Během běhu znovu neklikejte. Pak si nastavte týdenní rutinu: Statistiky procházení pro hostitele, logy pro nárůsty, procházení po každém nasazení.
Řetězec přesměrování před opravou a po ní
Co to je: plugin nebo pravidlo, které pošle každou chybějící URL na /. Jak ji odhalit: mnoho URL v „Soft 404“ nebo „Stránka s přesměrováním“, které všechny končí na domovské stránce; crawler ukáže stovky 301 se stejným cílem. Jak ji opravit: přesměrovávejte jen na blízký ekvivalent a zbytek nechte vracet 404 nebo 410.
Co to je: WAF, správce botů nebo omezovač rychlosti, který Googlu vrací 403, 429 nebo stránku s výzvou. Jak ji odhalit: 403 nebo 429 ve Statistikách procházení, přestože se stránka v prohlížeči načte bez problémů; logy ukazují blokace podle IP. Jak ji opravit: povolte ověřený Googlebot přes reverzní DNS nebo zveřejněné rozsahy IP Googlu, místo abyste věřili řetězci user agentu.
Co to je: robots.txt generovaný aplikací, takže selže pokaždé, když selže aplikace, nebo servírovaný pravidlem CDN, které kešuje 5xx. Jak ji odhalit: kategorie načtení robots.txt ve Stavu hostitele není zelená. Jak ji opravit: servírujte ho jako statický soubor mimo aplikaci a testujte nástrojem pro kontrolu robots.txt.
Co to je: stránka „Brzy jsme zpět“ servírovaná s kódem 200 na každé URL. Jak ji odhalit: po údržbě vlna soft 404 nebo duplicitních titulků. Jak ji opravit: během údržby vracejte 503 s Retry-After a držte ji krátkou.
Co to je: odpovídání Googlebotu kódem 403, když je server přetížený. Jak ji odhalit: nárůsty 403, které se shodují s nárůsty zátěže. Jak ji opravit: Google uvádí, že kódy 4xx kromě 429 nemají na rychlost procházení vliv. Krátce vracejte 503 nebo 429 a navyšte kapacitu.
Co to je: proklikávání seznamu v Search Console a úprava každé URL zvlášť. Jak ji odhalit: stejný důvod se vrací každý měsíc. Jak ji opravit: seskupte podle vzoru, opravte šablonu nebo pravidlo a pak jednou ověřte.
Co to je: trávení dnů nad 404 u spamových URL nebo dávno smazaných stránek bez odkazů. Jak ji odhalit: URL nemají kliknutí, zpětné ani interní odkazy. Jak ji opravit: nechte je být. Google uvádí, že 404 u odstraněné stránky nemusí být problém.
Upozornění
Nikdy neblokujte URL v robots.txt, abyste „skryli“ chybu procházení. Google už neuvidí 404 ani přesměrování, URL může zůstat v indexu a vy přijdete o signál, který jste chtěli poslat.
Na webu s několika stovkami stránek má Google čas na všechno a chyby procházení jsou důležité hlavně pro stránky, které rozbijí. Na velkých webech (e-shopy s filtry, tržiště, zpravodajství) každý neúspěšný nebo zbytečný požadavek bere čas vašim skutečným stránkám. Na tom stojí myšlenka crawl budgetu.
5xx a 429 způsobí, že Google zpomalí na celém hostiteli, takže pár rozbitých šablon může zdržet procházení nových produktových stránek. Řetězce přesměrování stojí jeden požadavek za skok. Soft 404 stojí celé načtení a nic nepřinesou. Opravte tyto tři věci a stejný budget pokryje více užitečných stránek.
Když Google URL najde, ale procházení odloží, příčinou je často server, který považuje za křehký. Pokud vidíte rostoucí počet „Objeveno, momentálně neindexováno“ a zároveň chyby serveru ve Statistikách procházení, opravte nejdřív server. Oba přehledy vyprávějí stejný příběh.
Googlebot už není jediný návštěvník, na kterém záleží. GPTBot, OAI-SearchBot, ClaudeBot a PerplexityBot načítají stránky, aby trénovaly modely nebo odpovídaly na otázky v reálném čase. Chodí na stejný server a trpí stejnými chybami, s jedním rozdílem: pro ně žádnou Search Console nemáte.
Většina AI crawlerů nespouští JavaScript, takže stránka, která sestaví obsah jen v prohlížeči, pro ně může vypadat prázdná, což je druh soft 404, který v přehledech Googlu nikdy neuvidíte. Mnohé ve výchozím stavu blokují služby ochrany proti botům, často kódem 403. A protože stránky načítají na vyžádání, když uživatel položí otázku, timeout v tu chvíli znamená, že odpověď bude citovat někoho jiného. Náš průvodce JavaScript SEO pokrývá vykreslování pro vyhledávače i AI crawlery.
Logy serveru jsou jediný spolehlivý zdroj. Filtrujte podle user agentu a dívejte se na stavové kódy:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnPokud AI boti dostávají 403, které jste nezamýšleli, opravte pravidlo. Pak ověřte, zda vás skutečně citují: sledování zmínek v AI od Sorank sleduje, jak často ChatGPT, Gemini, Claude a Perplexity zmiňují vaši značku, takže uvidíte, jestli oprava procházení něco změnila.
Projděte tento seznam po každé migraci, redesignu nebo velkém nasazení a na velkých webech jednou měsíčně.
Kontrolní seznam zdraví procházení
Otevřete Statistiky procházení a zkontrolujte tři řádky stavu hostitele. Pak spusťte bezplatný nástroj pro kontrolu indexovatelnosti na pěti nejcennějších stránkách. Pokud je obojí čisté, exportujte chyby z Indexování stránek a seskupte je podle složky: místo děsivého přehledu máte krátký seřazený seznam oprav.
Jakmile je procházení čisté, dalším limitem je samotný obsah. Optimalizace obsahu od Sorank přepisuje a aktualizuje vaše stávající stránky na autopilot, takže stránky, na které se Google nyní dostane, stojí za indexaci i citaci. O stránkách, které Google prošel, ale vynechal, si přečtěte náš průvodce stavem „Procházeno, momentálně neindexováno“.
Chyby procházení jsou požadavky vyhledávače nebo AI crawleru, které selžou: DNS se nepřeloží, server nestihne odpovědět nebo vrátí 5xx, robots.txt nejde načíst, přesměrování se zacyklí nebo stránka vrátí kód 4xx. Chyby na úrovni webu mohou pozastavit procházení celého webu, chyby URL se týkají jen dané stránky.
Samy o sobě ne. Google uvádí, že 404 u stránky odstraněné bez náhrady nemusí být problém. Problémem se stává, když URL stále má zpětné odkazy, návštěvnost nebo interní odkazy; pak je správnou opravou jediné přesměrování 301 na blízký ekvivalent.
Po kliknutí na Ověřit opravu v přehledu Indexování stránek v Search Console trvá ověření obvykle zhruba až dva týdny. Google nejprve zkontroluje vzorek URL, pak zbytek, a zastaví se, pokud byť jediná dotčená URL stále selhává.
Analyzujeme vaši konkurenci, váš web a vaši viditelnost v AI, abychom pro vás zdarma připravili obsahový plán na míru.
 Generátor zadání článku s AI
 Generátor schématu FAQ
 Generátor nápadů na blogové články s AI
 Validátor strukturovaných dat (validátor schématu)
 Kontrola alternativních textů
 Analyzátor interních odkazů
 Výzva zpětných odkazů
 Generátor meta popisů s AI
 Generátor titulků blogu s AI
 Kontrola indexovatelnosti pro Google
 Generátor osnovy článku s AI
 Tvůrce UTM odkazů
 Nástroj pro clustering klíčových slov
 Kontrola kanonické značky
 Generátor XML sitemap
 Kontrola nefunkčních odkazů
 Generátor SEO titulků s AI
 Analyzátor nadpisů
 Nástroj pro náhled SERP
 Kontrola přesměrování
 Generátor značek hreflang
 Analyzátor struktury nadpisů
 Kontrola HTTP hlaviček
 Extraktor favicon
 Kalkulačka CTR v SERP
 Kalkulačka úspor SEO oproti placenému vyhledávání
 Kalkulačka podílu hlasu v SEO
 Kalkulačka ROI SEO
 Kalkulačka předpovědi návštěvnosti a tržeb SEO
 Kalkulačka rozpočtu SEO
 Kalkulačka bodu zvratu SEO
 Kalkulačka ROI SEO pro SaaS
 Kalkulačka ROAS
 Kalkulačka doby čtení
 Simulátor zisku pozic
 Kalkulátor hodnoty organické návštěvnosti
 Odhad organické návštěvnosti a kontrola návštěvnosti webu
 Kalkulátor poměru LTV a CAC
 Kalkulátor ROI lokálního SEO
 Kalkulátor nákladů na budování zpětných odkazů
 Kalkulátor hodnoty klíčových slov
 Kalkulačka skóre příležitosti klíčových slov
 Kalkulačka hustoty klíčových slov
 Kalkulačka ROI GEO
 Kalkulačka investice do obsahu GEO
 Kalkulačka návratnosti SEO pro e-shop
 Kalkulačka celoživotní hodnoty zákazníka
 Kalkulačka nákladů na získání zákazníka
 Kalkulátor CTR
 Kalkulátor ceny za článek
 Kalkulátor míry konverze
 Kalkulátor ROI obsahového marketingu
 Odhad návštěvnosti z ChatGPT
 Kalkulátor míry odchodů
 Kalkulátor ROI zpětných odkazů
 Kalkulátor skóre viditelnosti v AI
 Kalkulačka hodnoty návštěvnosti z AI
 Kalkulačka podílu hlasů v AI
 Kalkulačka ceny neviditelnosti v AI
 Kalkulačka míry citování v AI
 Validátor llms.txt
 Kontrola AI Overviews a kontrola pozic v AI Overviews
 Kontrola robots.txt
 Audit AI SEO
 Kontrola čitelnosti pro LLM
 Kontrola připravenosti pro SearchGPT
 Audit strukturovaných dat pro LLM
 Audit procházení webu pro AI
 Proč ChatGPT nedoporučuje můj web
 Nástroj pro kontrolu pozic v Gemini
 Kontrola pořadí v Perplexity
 Kontrola citací v LLM
 Audit optimalizace pro odpovědní enginy
 Audit GEO
 Test viditelnosti ve vyhledávání AI
 Kontrola viditelnosti v ChatGPT
 Generátor llms.txt
 Extraktor URL
 Převod stránky do Markdownu
 Kontrola sitemapy
 Senzor volatility SERP
 Kontrola velikosti stránky
 Počítadlo slov
 Generátor slugů
 Generátor schema
 Generátor robots
 Náhled OG
 Generátor meta značek
 Kompresor obrázků
 Generátor favicon
 Audit on-page SEO: kontrola a analýza SEO
 Nástroj pro analýzu zpětných odkazů
 Nástroj pro výzkum klíčových slov
 Kontrola autority domény
 “Sorank jsem otestoval na skutečném webu klienta a je to neuvěřitelné. Dělá všechno, za co by vám agentura účtovala 1500 $ měsíčně. Právě ho nasazujeme do provozu na tomto klientovi.”

 Guillaume Guersanguersanguillaume.com“Jsme reklamní agentura a chtěli jsme konečně dostat naše SEO na pravou míru. Sorank nám poskytl jasný pohled na náš web, pomohl nám určit priority optimalizací a správně strukturovat náš obsah. Nástroj se snadno používá, je dobře navržený pro tým a velmi praktický, protože centralizuje sledování bez nutnosti žonglovat s více platformami. Velmi pevný základ pro nový start našeho SEO.”
 Gaspard MadouiReklamní agentura
 “Nechal jsem software Sorank dělat svou práci a teď je moje DR 25 a moje stránka se umisťuje výš.”
 Lucas Flandrefoundertrace.fr“Díky Sorank se specializuji na GEO. Žebříček GEO mi umožňuje ukázat klientům jejich postavení oproti konkurenci v ChatGPT. Je to skutečná obchodní výhoda.”
 MélanieSEO freelancer“Skvělá služba, dobře funguje pro náš web a pomáhá nám pochopit, jak ho zlepšit, aby se lépe umisťoval ve výsledcích Google a jinde. Gratulujeme, pokračujte, doporučuji.”
 Hugo T.Majitel e-shopu