La privacidad es importante para nosotros, por lo que tiene la opción de desactivar ciertos tipos de almacenamiento que pueden no ser necesarios para el funcionamiento básico del sitio web. Bloquear categorías puede afectar a su experiencia en el sitio web. Más información (Política de cookies)
Un mapa de sitio web en el que algunas páginas aparecen marcadas con señales de error mientras un rastreador sigue los enlaces entre ellas.
Herramientas
En esta página
En resumen
los errores de rastreo son las solicitudes que un buscador o un rastreador de IA hace a tu sitio y que fallan: el servidor no responde a tiempo, el DNS no contesta, el robots.txt no se puede obtener, una redirección entra en bucle o una página devuelve un código 4xx o 5xx. Los errores a nivel de sitio (DNS, servidor, robots.txt) pueden impedir que Google rastree todo tu sitio, así que corrígelos primero; los errores a nivel de URL (404, soft 404, errores de redirección) solo importan cuando afectan a páginas que quieres indexar. Los encuentras en los informes Estadísticas de rastreo e Indexación de páginas de Search Console, los confirmas con un rastreador y tus registros del servidor, y luego corriges la causa y validas.
¿Quién debería arreglar la parte técnica de tu web?
Pregunta 1 de 425%
Nuestro consejo para ti
Revísalo tú con las herramientas gratuitas de Google
Search Console lista las páginas que Google no puede leer y PageSpeed Insights mide la velocidad. Muchos problemas pequeños se arreglan desde los ajustes de tu creador de webs.
Nuestro consejo para ti
Un desarrollador web
Tu problema está en el código o en el servidor: un desarrollador que sepa de SEO es la persona adecuada. Dale la lista de errores de Search Console.
Nuestro consejo para ti
Una herramienta de auditoría técnica
Tu web tiene muchas páginas: un rastreador las lee todas como Google y te da la lista completa de errores, página por página.
Nuestro consejo para ti
Una auditoría automática y luego contenido
Tu web funciona pero trae pocas visitas: los problemas técnicos rara vez son la causa. Sorank audita la web y luego redacta las páginas que traen tráfico.
Qué son los errores de rastreo y qué no son
Un rastreador funciona como un visitante muy paciente. Pide una URL a tu servidor, espera la respuesta, lee el código de estado y el contenido, y luego sigue los enlaces que ha encontrado. Un error de rastreo es cualquier paso de esa cadena que falla. El visitante nunca recibe una página utilizable.
Esta definición importa porque muchos informes mezclan errores de rastreo con decisiones de indexación. «Rastreada: actualmente sin indexar» no es un error de rastreo: Google obtuvo la página sin problemas y decidió no guardarla. «Excluida por la etiqueta noindex» tampoco lo es: tú le pediste a Google que la quitara. Un error de rastreo significa que la propia obtención salió mal.
Las dos familias: errores de sitio y errores de URL
Google divide los problemas en dos niveles, y tú también deberías hacerlo.
Errores de sitio (Google los llama problemas de estado del host): fallos de resolución DNS, fallos de conexión con el servidor y fallos al obtener el robots.txt. Afectan a todas las URL del host. Un mal día en este nivel puede congelar el rastreo de todo el sitio.
Errores de URL: una página devuelve 404, 410, 401, 403, 5xx, un soft 404 o una redirección rota. Solo afectan a esa URL, y muchos son inofensivos.
Errores de sitio y errores de URL
Errores de sitio (corregir hoy)
El DNS no se resuelve
El servidor agota el tiempo o corta la conexión
El robots.txt devuelve 5xx o 429
Visibles en Estadísticas de rastreo, Estado del host
Pueden pausar el rastreo de todas las páginas
Errores de URL (clasificar)
404, 410, soft 404
401, 403, otros 4xx
Bucle de redirección o cadena demasiado larga
Visibles en el informe Indexación de páginas
Solo importan en páginas que quieres indexar
Por qué esta distinción cambia tus prioridades
Una tienda con 4000 URL antiguas de productos que devuelven 404 puede estar perfectamente sana si esos productos han desaparecido para siempre. La misma tienda con un robots.txt que devuelve 503 durante seis horas tiene una urgencia real, aunque todas sus fichas de producto funcionen. Empieza por el host, luego por las URL que generan dinero y después por el resto.
Pasa el contenido a la indexación. La indexación no está garantizada.
No, salvo que la página esté vacía (soft 404).
301, 308
Señal fuerte de que el destino es la nueva URL.
No, si es un solo salto hacia una página 200.
302, 303, 307
Señal débil: la URL original suele seguir siendo la canónica.
Sí, si el cambio es permanente.
Cadenas de 3xx
Sigue hasta 10 saltos por defecto y luego abandona.
Sí: cada salto gasta una solicitud, y los bucles nunca se resuelven.
404, 410, otros 4xx (salvo 429)
Considera que el contenido no existe, retira con el tiempo las URL indexadas y las rastrea menos.
Solo si la página debería existir.
401, 403
Igual que otros 4xx. No ralentizan el rastreo.
Sí, si bloquean a Googlebot en páginas públicas.
429
Se trata como señal de sobrecarga del servidor, igual que un 5xx.
Sí: el rastreo se ralentiza.
5xx
Ralentiza el rastreo en proporción a los errores. Las URL que siguen fallando se retiran del índice.
Sí, siempre.
Hay dos detalles que confunden a muchos equipos. Primero, 401 y 403 no reducen la frecuencia de rastreo. Si tu servidor va justo, devolver 403 a Googlebot no ayuda; Google pide devolver temporalmente 503 o 429. Segundo, un 404 no es una penalización. Es la respuesta correcta para una página que ya no existe.
Los fallos del robots.txt son los más peligrosos
La documentación del informe Estadísticas de rastreo (Ayuda de Search Console) explica la regla. Un robots.txt que responde 200 (aunque esté vacío) o 403, 404 o 410 (sin archivo) está bien. Un robots.txt que responde 429 o 5xx es un fallo, y entonces Google juega sobre seguro.
Qué hace Google cuando el robots.txt sigue fallando
Primeras 12 horasGoogle deja de rastrear el sitio por completo.
Hasta 30 díasGoogle usa el último robots.txt obtenido con éxito.
Después de 30 díasEl comportamiento depende de si la página de inicio es accesible.
Fuente: Ayuda de Google Search Console, informe Estadísticas de rastreo
Así que una regla de CDN o un cortafuegos que sirve un 503 en /robots.txt puede congelar todo tu sitio durante medio día, aunque todas las demás URL funcionen. Revisa este archivo primero en cualquier investigación de errores de rastreo. Nuestra guía sobre el estado «Bloqueada por robots.txt» trata el problema contrario, cuando el archivo funciona pero bloquea demasiado.
Límites de rastreo de Google que conviene recordar
10saltos de redirección como máximo siguen los rastreadores de Google
12 hde parada del rastreo cuando el robots.txt devuelve 5xx o 429
30 díassigue usando Google el último robots.txt válido
5%de fallos DNS diarios citado como ejemplo de problema del host
Fuentes: Google Search Central, códigos de estado HTTP y errores de red; Ayuda de Search Console, informe Estadísticas de rastreo
Los errores de rastreo son los puntos en los que se rompe el recorrido de un rastreador por tu sitio.
Cada tipo de error de rastreo, explicado con su solución
Esta es la lista completa que verás en Search Console y en los rastreadores, con la causa y la solución de cada uno. Los nombres siguen la documentación del informe Indexación de páginas (Ayuda de Search Console).
Errores de DNS
Google no pudo convertir tu nombre de dominio en una dirección IP, o el servidor DNS no respondió. Causas habituales: un dominio caducado, una caída del proveedor de DNS, un registro erróneo tras una migración o una mala configuración de DNSSEC. Compruébalo con una consulta desde fuera de tu red:
Solución: corrige los registros, baja el TTL antes de cualquier migración y usa un proveedor de DNS con redundancia. Si existen example.com y www.example.com, los dos deben resolverse, aunque uno solo redirija.
Errores de conexión con el servidor y 5xx
El servidor no respondió a tiempo, cerró la conexión o respondió con 500, 502, 503 o 504. Causas típicas: una base de datos sobrecargada, un proceso PHP o Node que se cae bajo carga, un tiempo de espera del proxy inverso, una actualización de un plugin o un cortafuegos que limita a los bots. Fíjate en el patrón temporal: errores a la misma hora cada noche suelen apuntar a una copia de seguridad o a una tarea programada.
Solución: lee el registro de errores del servidor en las horas que indica Google, aumenta los tiempos de espera o el número de procesos, pon en caché las páginas pesadas y asegúrate de que tu protección contra bots deja pasar al Googlebot verificado. Para un mantenimiento planificado, devuelve un 503 con una cabecera Retry-After en lugar de una página 200 que diga «volvemos pronto»:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 y 410 (no encontrada)
La página no existe. No pasa nada si se eliminó a propósito y ya nada enlaza a ella. Es un problema cuando la URL aún tiene backlinks, tráfico o enlaces internos, o cuando la página debería existir y un despliegue la rompió.
Solución: si el contenido se ha movido, añade una única 301 hacia el equivalente más cercano. Si ha desaparecido para siempre, mantén el 404 o usa 410, y quita los enlaces internos y las entradas del sitemap que apuntan a él. Nunca redirijas todos los 404 a la página de inicio: Google suele tratarlos como soft 404.
Soft 404
El servidor dice 200 pero la página parece vacía o dice «no encontrada»: una categoría vacía, una página de búsqueda sin resultados, un producto agotado sin contenido. Google gasta una solicitud y no obtiene nada. Lo tratamos a fondo en nuestra guía sobre los errores soft 404.
401, 403 y otros 4xx
Googlebot nunca envía credenciales, así que un 401 o un 403 en una página pública significa que tu servidor o una capa de seguridad lo está bloqueando. Culpables habituales: una contraseña de preproducción olvidada en producción, una regla del WAF, un bloqueo por país o una protección contra hotlinking aplicada al HTML. Corrige la regla, no el síntoma, y prueba con la herramienta Inspección de URLs de Search Console.
Errores de redirección
Google informa de un error de redirección cuando encuentra un bucle, una cadena demasiado larga, una URL que supera la longitud máxima o una URL no válida o vacía en la cadena. El caso clásico tras una migración: http a https, luego a www, luego a una barra final y luego a una nueva ruta. Cuatro saltos donde bastaría uno. Nuestra guía completa de redirecciones SEO explica cómo reducirlos.
Consejo
Pega cualquier URL sospechosa en el comprobador de redirecciones gratuito de Sorank: sigue toda la cadena, muestra cada salto con su código de estado y te dice dónde está el bucle o el salto de más.
Tiempos de espera, respuestas truncadas y páginas demasiado pesadas
Algunos errores nunca muestran un código de estado. La página empieza a cargar y se detiene, o pesa tanto que el rastreador solo lee una parte. Los rastreadores de Google leen un número limitado de bytes por archivo, así que una página inflada con scripts en línea o imágenes en base64 puede perder el contenido del final. Revisa las plantillas pesadas con el comprobador de peso de página.
Todas las formas de encontrar errores de rastreo, comparadas
Ninguna herramienta muestra por sí sola todos los errores de rastreo. Cada método ve el problema desde un ángulo distinto, y una auditoría seria combina al menos dos.
Método 1: Search Console, informe Estadísticas de rastreo
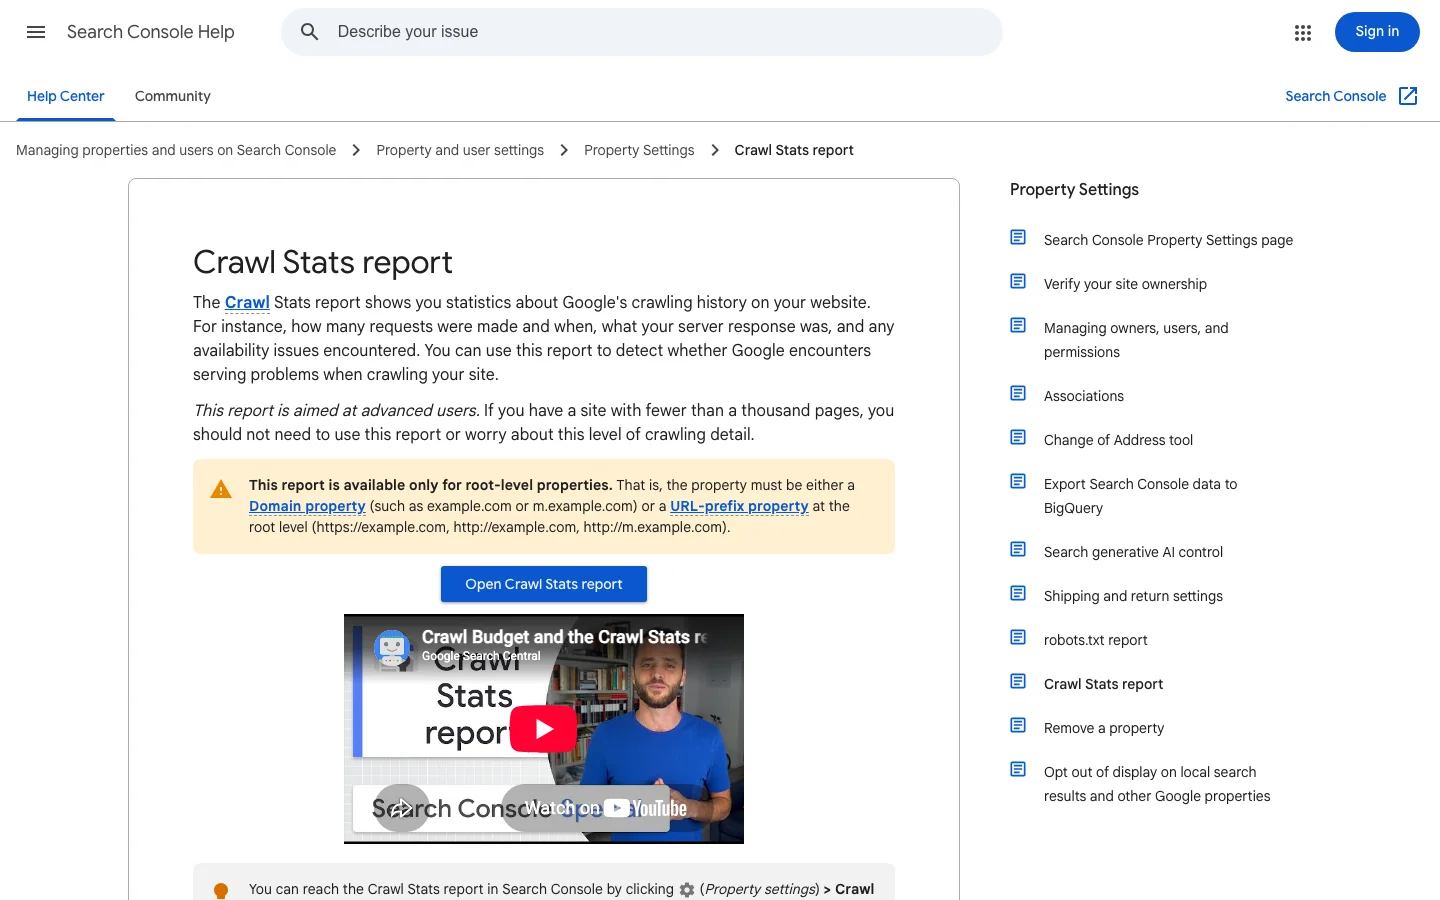
Principio: Google muestra sus propias solicitudes de rastreo de los últimos 90 días, agrupadas por respuesta, tipo de archivo, finalidad y tipo de Googlebot, además del estado del host para DNS, servidor y robots.txt. Cuándo usarlo: siempre, y primero, para los errores de sitio. Ventajas: son los datos reales del propio Google. Límites: solo para propiedades de nivel raíz, ejemplos muestreados, y Google indica que los sitios de menos de mil páginas rara vez lo necesitan. Ejemplo: un pico de respuestas «tiempo de espera de la página agotado» cada domingo a las 3 de la madrugada que coincide con una copia de seguridad de la base de datos.
La documentación de Google sobre el informe Estadísticas de rastreo, donde se explica el estado del host para DNS, servidor y robots.txt.
Método 2: Search Console, informe Indexación de páginas e Inspección de URLs
Principio: enumera las URL que Google conoce y por qué no están indexadas, con motivos como Error de servidor (5xx), Error de redirección, No encontrada (404) o Soft 404. Cuándo usarlo: para clasificar errores de URL y validar correcciones. Ventajas: ligado a las páginas que Google intentó de verdad. Límites: los informes llevan días de retraso, las listas de ejemplos tienen tope y mezcla errores de rastreo con decisiones de indexación. Ejemplo: 300 URL en «Error de redirección» que comparten el antiguo prefijo /blog/.
Método 3: un rastreador de escritorio o en la nube
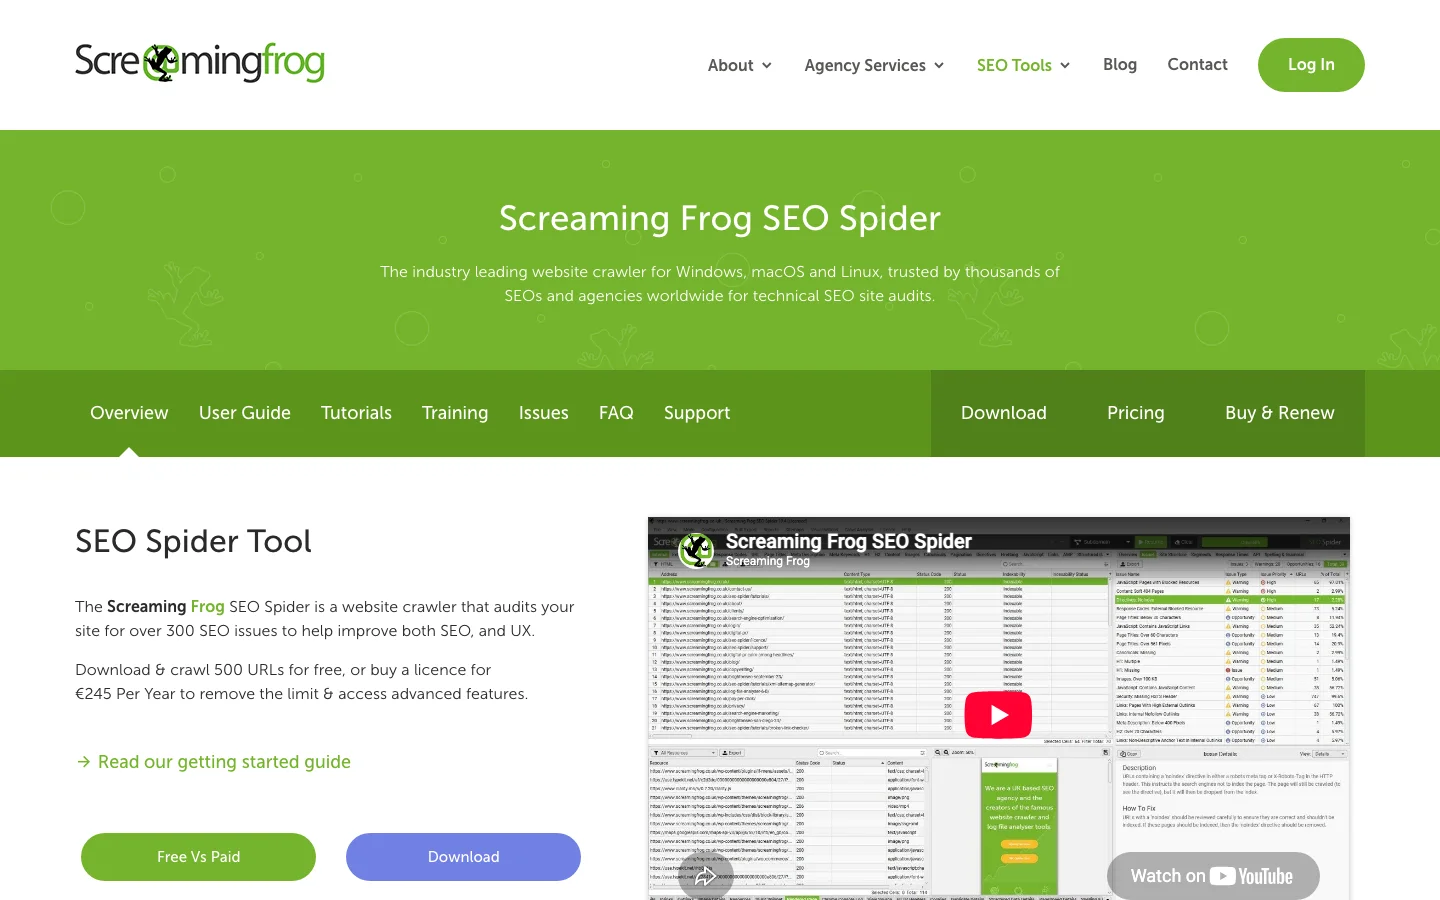
Principio: una herramienta como Screaming Frog rastrea tu sitio como lo haría un bot, siguiendo los enlaces desde la página de inicio, y registra cada código de estado, cada cadena de redirecciones y cada enlace roto. Cuándo usarlo: antes y después de una migración, un rediseño o un gran despliegue, y cada mes en sitios grandes. Ventajas: inmediato, completo para las páginas enlazadas, muestra dónde está cada enlace roto. Límites: no sabe qué pidió Google realmente, no ve las páginas huérfanas y tu servidor puede tratarlo de forma distinta a Googlebot. Nuestra guía de configuración de Screaming Frog recorre una auditoría completa.
Screaming Frog SEO Spider rastrea tu sitio como un bot y enumera cada código de estado, cadena de redirecciones y enlace roto.
Método 4: análisis de los registros del servidor
Principio: tus registros de acceso guardan cada solicitud, incluidas las de Googlebot, Bingbot, GPTBot, ClaudeBot y PerplexityBot, con el código de estado exacto y el tiempo de respuesta. Cuándo usarlo: en sitios grandes, tras caídas de tráfico inexplicables y para ver qué visitan los rastreadores de IA. Ventajas: solicitudes reales, códigos reales, sin muestreo, todos los bots. Límites: necesita acceso a los registros y algo de programación; tienes que verificar que «Googlebot» es realmente Google. Nuestra guía de análisis de logs para SEO va paso a paso. Un primer vistazo rápido:
# Solicitudes de Googlebot que no devolvieron 200, 301 o 304, las más frecuentes primero
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Método 5: comprobaciones puntuales de una URL
Principio: probar una URL cada vez con curl o con un comprobador en línea gratuito. Cuándo usarlo: para confirmar una corrección o revisar una página clave tras un despliegue. Ventajas: instantáneo y preciso. Límites: no escala. Usa un user agent de Googlebot para detectar reglas que tratan a los bots de otra forma:
Errores 5xx: lee el código de estado para encontrar la capa que falló
Un estado 5xx significa que el servidor no pudo gestionar una solicitud que parecía válida. Google ralentiza su rastreo como respuesta, y lo ralentiza más cuando más de tus URL devuelven errores. Google conserva durante un tiempo las URL ya indexadas, pero elimina las que devuelven un error de servidor de forma persistente. Una ráfaga corta se recupera, porque Google vuelve a subir el ritmo de rastreo de forma gradual cuando tu servidor responde con códigos 2xx. Lo que daña tu índice es una larga racha de errores.
El código te indica qué capa falló
Cada código 5xx apunta a una parte distinta de la pila. La tabla te da un primer lugar donde mirar para cada uno.
Código
Qué suele significar
Qué mirar primero
500
La aplicación falló al gestionar la solicitud
El registro de errores de la aplicación en el momento exacto de la solicitud
502
El proxy o la CDN recibió una respuesta no válida de la aplicación, a menudo porque se bloqueó o se reinició
Reinicios y disponibilidad del proceso de la aplicación
503
El servicio está sobrecargado, limitado en frecuencia o en mantenimiento
Gráficos de carga, historial de despliegues y ventanas de mantenimiento
504
El proxy dejó de esperar a la aplicación
Consultas lentas a la base de datos y configuración de tiempo de espera del proxy
429
Un limitador de frecuencia indica que hay demasiadas solicitudes
Reglas de límite de frecuencia y si se aplican al Googlebot verificado
Cruza las marcas de tiempo de Google con tus registros
El informe Estadísticas de rastreo muestra los días y las horas en que Google encontró errores (nuestra guía de Estadísticas de rastreo explica cada gráfico). Tu registro del servidor muestra lo que pasó en esos momentos exactos. Filtra las solicitudes de Googlebot y cuenta las respuestas 5xx por hora:
Cada línea de salida es una hora, un código y un recuento. Un grupo de errores a la misma hora cada noche suele apuntar a una copia de seguridad, una tarea programada o una importación. Los errores repartidos a lo largo del día suelen indicar carga, así que la solución es capacidad o caché y no un error puntual. Para un método más avanzado, consulta nuestra guía de análisis de registros.
Mide lo que cuesta un 5xx antes de alarmarte
Google reduce el rastreo en proporción al número de URL que devuelven errores. Una plantilla rota que afecta a unas pocas URL cuesta poco tiempo de rastreo. Una caída de la base de datos que rompe todas las páginas cuesta mucho, y es la que hay que arreglar primero.
Un 429 tiene el mismo efecto que un 5xx, porque Google lo interpreta como un servidor sobrecargado. Si tu limitador de frecuencia o tu protección contra bots devuelve un 429 a Googlebot, lo pagas en tiempo de rastreo. La documentación de Google no menciona la cabecera Retry-After. Sigue enviándola a los visitantes humanos y a los clientes de API, pero no cuentes con que Googlebot espere el tiempo que hayas indicado.
Errores 4xx: averigua de dónde vienen antes de corregirlos
Un estado 4xx significa que el servidor rechazó la solicitud por algo del lado del cliente: la URL no existe, el acceso está prohibido o la dirección está mal formada. Google trata igual a todos los 4xx excepto el 429. Deja de usar el contenido de esa URL y la elimina del índice si estaba indexada. Antes de tocar un 4xx, averigua de dónde procede la solicitud, porque la solución suele estar en un solo sitio: un enlace, una plantilla o una regla de redirección.
Encuentra el origen de cada 4xx en tus registros
Tu registro de acceso guarda el referrer de cada solicitud, es decir, qué página envió al visitante o al bot a esa URL. Cuenta las respuestas 4xx por ruta y por referrer:
Un referrer de tu propio dominio significa que una de tus páginas enlaza a una URL muerta. Corrige el enlace o la plantilla que lo genera. Es la corrección más valiosa, porque depende de ti. Nuestra guía sobre cómo arreglar enlaces rotos explica el método completo.
Un referrer de otro sitio significa que un backlink apunta a una URL que ya no funciona. Si el enlace merece la pena, añade una única 301 a la página activa más cercana. Si no, deja el 404 como está.
Un referrer vacío, o una ruta que nunca publicaste, como una página de login en un sitio estático, suele indicar que un bot o un escáner probó la dirección. Deja que devuelva 404 y no pierdas tiempo con ello.
Detecta los picos de 4xx justo después de cada publicación
Una publicación que renombra una ruta, cambia un slug o reconstruye una plantilla suele provocar una oleada de 404 el mismo día. Exporta el número de respuestas 4xx por día de la semana anterior al despliegue y de la semana posterior. Un aumento concentrado en una carpeta apunta directamente al cambio. Añade la redirección de la URL antigua a la nueva en la misma publicación, no en un ticket posterior. Para una migración completa, consulta nuestra lista de comprobación para migraciones SEO.
Consejo
No sustituyas una página que falta por una respuesta 200 que muestre un mensaje corto o una lista vacía. Google puede tratarla como un soft 404, lo que supone un rastreo completo sin ningún beneficio.
Paso a paso: corrige los errores de rastreo en el orden correcto
Este es el método que usamos. Va de los errores que pueden detener todo tu sitio a los que solo gastan un poco de rastreo.
El método de 6 pasos contra los errores de rastreo
Revisar el estado del hostAbre Estadísticas de rastreo y mira DNS, conexión con el servidor y robots.txt de los últimos 90 días.
Exportar y agrupar los errores de URLExporta cada motivo de Indexación de páginas y agrupa las URL por carpeta o plantilla.
Ordenar por valorQuédate con las URL que tienen tráfico, backlinks, enlaces internos o entrada en el sitemap.
Corregir la causa en la plantillaUna regla, una tabla de redirecciones o un ajuste del servidor corrige cientos de URL.
Limpiar las señalesActualiza enlaces internos y sitemaps para que apunten a URL finales con 200.
Validar y vigilarPulsa Validar corrección y revisa cada semana las estadísticas de rastreo y tus registros.
Paso 1: revisa primero el host
En Search Console, abre Ajustes, luego Estadísticas de rastreo y luego Estado del host. El verde significa que no hay ningún problema importante en 90 días. «Problema reciente» significa un problema importante en la última semana: deja todo lo demás. Haz clic en cada categoría para ver la tasa de fallos por día y compara los días malos con el historial de tu alojamiento, tu CDN y tus despliegues.
Paso 2: exporta y agrupa por patrón
Abre Indexación, luego Páginas, y exporta cada motivo de error. No corrijas las URL una a una. Ponlas en una hoja de cálculo y extrae la primera carpeta:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
Una tabla dinámica sobre esa columna suele mostrar que la mayoría de los errores vienen de dos o tres plantillas: una categoría de blog retirada, un parámetro de filtro, un feed de productos antiguo.
Paso 3: ordena por valor de negocio
Para cada patrón, hazte cuatro preguntas. ¿Recibe clics orgánicos? ¿Tiene backlinks? ¿Está enlazado internamente? ¿Está en el sitemap? Un 404 sin ninguna de las cuatro puede esperar para siempre. Un 404 con backlinks necesita una 301 hoy. El comprobador de enlaces rotos gratuito muestra qué páginas de tu sitio siguen enlazando a URL muertas.
Paso 4: corrige la causa de fondo
Corrige reglas, no URL. Una tabla de redirecciones en la configuración del servidor es mejor que 400 redirecciones añadidas a mano en un plugin. Por ejemplo, en nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Para los 5xx, corrige la capacidad o el fallo. Para los 401 y 403, corrige la regla de seguridad. Para los soft 404, añade contenido real o devuelve un 404 real.
Paso 5: limpia los enlaces internos y los sitemaps
Cada enlace interno debe apuntar directamente a una URL que devuelva 200. Cada entrada del sitemap debe ser una URL canónica, indexable y con 200. Un sitemap lleno de redirecciones y 404 enseña a Google a fiarse menos de él. Nuestra guía sobre cómo crear un sitemap explica qué debe incluir.
Paso 6: valida y vigila
En el informe Indexación de páginas, abre el motivo corregido y pulsa Validar corrección. Google revisa primero una muestra y luego el resto; suele tardar hasta unas dos semanas, y se detiene si una sola URL sigue fallando. No vuelvas a pulsar mientras se ejecuta. Después, establece una rutina semanal: Estadísticas de rastreo para el host, registros para los picos y un rastreo tras cada despliegue.
Una cadena de redirecciones antes y después de corregirla
Antes
http://site.com/page
301 a https://site.com/page
301 a https://www.site.com/page
301 a https://www.site.com/page/
Los enlaces internos siguen apuntando a la primera URL
Después
Una sola 301 directa a https://www.site.com/page/
Enlaces internos actualizados a la URL final
El sitemap solo incluye la URL final
Una solicitud en lugar de cuatro
Errores comunes: cómo detectarlos y corregirlos
Error 1: redirigir todos los 404 a la página de inicio
Qué es: un plugin o una regla que envía cualquier URL inexistente a /. Cómo detectarlo: muchas URL en «Soft 404» o «Página con redirección» que acaban todas en la página de inicio; un rastreador muestra cientos de 301 hacia el mismo destino. Cómo corregirlo: redirige solo a un equivalente cercano y deja que el resto devuelva 404 o 410.
Error 2: bloquear a Googlebot con herramientas de seguridad
Qué es: un WAF, un gestor de bots o un limitador de peticiones que sirve a Google un 403, un 429 o una página de verificación. Cómo detectarlo: 403 o 429 en Estadísticas de rastreo mientras la página carga bien en tu navegador; los registros muestran los bloqueos por IP. Cómo corregirlo: permite el Googlebot verificado, mediante DNS inverso o los rangos de IP publicados por Google, en lugar de fiarte del user agent.
Error 3: un robots.txt frágil
Qué es: un robots.txt generado por la aplicación, que falla cada vez que falla la aplicación, o servido mediante una regla de CDN que guarda en caché un 5xx. Cómo detectarlo: la categoría de obtención del robots.txt en Estado del host no está en verde. Cómo corregirlo: sírvelo como archivo estático, fuera de la aplicación, y pruébalo con el comprobador de robots.txt.
Error 4: páginas de mantenimiento que devuelven 200
Qué es: una página «Volvemos pronto» servida con estado 200 en todas las URL. Cómo detectarlo: tras el mantenimiento, una oleada de soft 404 o de títulos duplicados. Cómo corregirlo: devuelve un 503 con Retry-After durante el mantenimiento y que sea breve.
Error 5: usar el 403 para frenar a Google
Qué es: responder 403 a Googlebot cuando el servidor está sobrecargado. Cómo detectarlo: picos de 403 que coinciden con picos de carga. Cómo corregirlo: Google indica que los códigos 4xx distintos de 429 no influyen en la frecuencia de rastreo. Devuelve 503 o 429 durante poco tiempo y corrige la capacidad.
Error 6: corregir los errores uno a uno
Qué es: recorrer la lista de Search Console y editar cada URL. Cómo detectarlo: el mismo motivo vuelve cada mes. Cómo corregirlo: agrupa por patrón, corrige la plantilla o la regla y valida una sola vez.
Error 7: entrar en pánico por 404 inofensivos
Qué es: dedicar días a 404 de URL de spam o de páginas borradas hace tiempo y sin enlaces. Cómo detectarlo: las URL no tienen clics, ni backlinks, ni enlaces internos. Cómo corregirlo: déjalas. Google indica que un 404 de una página eliminada no es necesariamente un problema.
Atención
Nunca bloquees una URL en el robots.txt para «ocultar» un error de rastreo. Google deja de ver el 404 o la redirección, la URL puede seguir indexada y pierdes la señal que querías enviar.
Errores de rastreo y presupuesto de rastreo
En un sitio con unos cientos de páginas, Google tiene tiempo para todo, y los errores de rastreo importan sobre todo por las páginas que rompen. En sitios grandes (tiendas con filtros, marketplaces, medios), cada solicitud fallida o desperdiciada quita tiempo a tus páginas reales. Esa es la idea del presupuesto de rastreo.
Cómo los errores consumen capacidad de rastreo
Los 5xx y 429 hacen que Google frene en todo el host, así que unas pocas plantillas rotas pueden retrasar el rastreo de tus nuevas fichas de producto. Las cadenas de redirecciones cuestan una solicitud por salto. Los soft 404 cuestan una obtención completa y no devuelven nada. Corrige esos tres y el mismo presupuesto cubrirá más páginas útiles.
Qué tiene que ver «Descubierta: actualmente sin indexar»
Cuando Google encuentra URL pero aplaza su rastreo, la causa suele ser un servidor que considera frágil. Si ves crecer el número de «Descubierta: actualmente sin indexar» junto con errores de servidor en Estadísticas de rastreo, corrige primero el servidor. Los dos informes cuentan la misma historia.
Errores de rastreo de los rastreadores de IA
Googlebot ya no es el único visitante que importa. GPTBot, OAI-SearchBot, ClaudeBot y PerplexityBot obtienen páginas para entrenar modelos o para responder preguntas en tiempo real. Visitan el mismo servidor y sufren los mismos errores, con una diferencia: no tienes Search Console para ellos.
Qué cambia con los bots de IA
La mayoría de los rastreadores de IA no ejecutan JavaScript, así que una página que solo construye su contenido en el navegador puede parecerles vacía, una especie de soft 404 que nunca verás en los informes de Google. Muchos están bloqueados por defecto por los servicios de protección contra bots, a menudo con un 403. Y como obtienen las páginas bajo demanda cuando un usuario hace una pregunta, un tiempo de espera agotado en ese momento significa que la respuesta cita a otro. Nuestra guía de SEO para JavaScript trata el renderizado para buscadores y rastreadores de IA.
Cómo vigilarlos
Tus registros del servidor son la única fuente fiable. Filtra por user agent y mira los códigos de estado:
Si los bots de IA reciben 403 que no querías, corrige la regla. Luego comprueba si realmente te citan: el seguimiento de menciones en IA de Sorank mide con qué frecuencia ChatGPT, Gemini, Claude y Perplexity mencionan tu marca, para que veas si una corrección de rastreo cambia algo.
Tu checklist de salud del rastreo
Repasa esta lista tras cada migración, rediseño o gran despliegue, y una vez al mes en sitios grandes.
Checklist de salud del rastreo
Estado del host en verde para DNS, conexión con el servidor y robots.txt
robots.txt servido como archivo estático y que devuelve 200
Sin picos de 5xx o 429 en Estadísticas de rastreo ni en los registros
Googlebot verificado y bots de IA deseados no bloqueados por el cortafuegos
Cada redirección es un solo salto, 301 o 308, hacia una página 200
Los enlaces internos apuntan a URL finales con 200
Los sitemaps solo incluyen URL canónicas, indexables y con 200
Los 404 con backlinks o tráfico redirigidos a un equivalente cercano
Páginas vacías corregidas o devolviendo un 404 real
El mantenimiento devuelve 503 con Retry-After
Validar corrección iniciado para cada motivo corregido
Qué hacer hoy
Abre Estadísticas de rastreo y revisa las tres líneas del estado del host. Luego pasa el comprobador de indexabilidad gratuito por tus cinco páginas más valiosas. Si todo está limpio, exporta los errores de Indexación de páginas y agrúpalos por carpeta: ahora tienes una lista de correcciones corta y priorizada en lugar de un informe que asusta.
Con el rastreo limpio, el siguiente límite es el propio contenido. La optimización de contenido de Sorank reescribe y actualiza tus páginas existentes en autopilot, para que las páginas a las que Google ya llega merezcan ser indexadas y citadas. Para las páginas que Google rastreó pero dejó fuera, lee nuestra guía sobre «Rastreada: actualmente sin indexar».
Preguntas frecuentes
¿Qué son los errores de rastreo en SEO?
Los errores de rastreo son solicitudes de un buscador o de un rastreador de IA que fallan: el DNS no se resuelve, el servidor agota el tiempo o devuelve 5xx, el robots.txt no se puede obtener, una redirección entra en bucle o una página devuelve un código 4xx. Los errores de sitio pueden pausar el rastreo de todo el sitio, mientras que los errores de URL solo afectan a la página en cuestión.
¿Los errores 404 son malos para el SEO?
No por sí mismos. Google indica que un 404 de una página eliminada sin sustituto no es necesariamente un problema. Lo es cuando la URL todavía tiene backlinks, tráfico o enlaces internos; en ese caso, la solución correcta es una sola 301 hacia un equivalente cercano.
¿Cuánto tarda Google en ver que los errores de rastreo están corregidos?
Después de pulsar Validar corrección en el informe Indexación de páginas de Search Console, la validación suele tardar hasta unas dos semanas. Google revisa primero una muestra de URL y luego el resto, y se detiene si una sola URL afectada sigue fallando.
y!
Consiga gratis su plan de contenidos para 30 días
Analizamos a sus competidores, su sitio web y su visibilidad en las IA para crear gratis un plan de contenidos a medida.
“He probado Sorank en el sitio real de un cliente y es una locura. Hace todo aquello por lo que una agencia cobra 1.500 € al mes. Ahora se pone en producción en ese cliente.”Guillaume Guersanguersanguillaume.com
“Somos una agencia de publicidad y queríamos poner en marcha nuestro SEO de una vez por todas. Sorank nos dio una visión clara de nuestro sitio, nos ayudó a priorizar las optimizaciones y a estructurar correctamente nuestro contenido. La herramienta es fácil de usar, bien diseñada para un equipo y muy práctica para centralizar el seguimiento sin tener que hacer malabares entre varias plataformas. Una base muy sólida para empezar de nuevo con nuestro SEO.”Gaspard MadouiAgencia de Publicidad
“Me especialicé en GEO gracias a Sorank. El GEO Leaderboard me permite mostrar a mis clientes su posicionamiento frente a sus competidores en ChatGPT. Es un verdadero diferenciador comercial.”MélanieFreelancer SEO
“Excelente servicio, funciona bien para nuestro sitio web y nos ayuda a entender cómo mejorarlo para posicionarnos mejor en Google y en otros lugares. Felicitaciones, continúen así, se lo recomiendo.”Hugo T.Comerciante e-commerce