Tùy chọn
Quyền riêng tư rất quan trọng với chúng tôi, vì vậy bạn có thể tắt một số loại lưu trữ không cần thiết cho hoạt động cơ bản của website. Việc chặn các nhóm này có thể ảnh hưởng đến trải nghiệm của bạn trên website. Thông tin thêm
Quyền riêng tư rất quan trọng với chúng tôi, vì vậy bạn có thể tắt một số loại lưu trữ không cần thiết cho hoạt động cơ bản của website. Việc chặn các nhóm này có thể ảnh hưởng đến trải nghiệm của bạn trên website. Thông tin thêm

Tìm và sửa lỗi thu thập dữ liệu: DNS, máy chủ, robots.txt, 404, soft 404 và chuyển hướng. Cách Googlebot phản ứng và phương pháp 6 bước để sửa theo đúng thứ tự.

Công cụ

Tóm lại
lỗi thu thập dữ liệu (crawl error) là những yêu cầu mà công cụ tìm kiếm hoặc trình thu thập dữ liệu AI gửi tới trang web của bạn nhưng thất bại: máy chủ hết thời gian chờ, DNS không phản hồi, không tải được robots.txt, chuyển hướng bị lặp, hoặc trang trả về mã 4xx hay 5xx. Lỗi cấp trang web (DNS, máy chủ, robots.txt) có thể khiến Google ngừng thu thập dữ liệu toàn bộ trang web, nên hãy sửa chúng trước; lỗi cấp URL (404, soft 404, lỗi chuyển hướng) chỉ quan trọng khi chúng ảnh hưởng tới những trang bạn muốn được lập chỉ mục. Bạn tìm thấy chúng trong báo cáo Thống kê thu thập dữ liệu và Lập chỉ mục trang của Search Console, xác nhận bằng công cụ thu thập dữ liệu và nhật ký máy chủ, rồi sửa nguyên nhân và xác thực.
Muốn tìm hiểu sâu hơn? Hãy hỏi
Bài trắc nghiệm nhanh
Ai nên sửa phần kỹ thuật của website?
Lời khuyên dành cho bạn
Tự kiểm tra bằng các công cụ miễn phí của Google
Search Console liệt kê các trang Google không đọc được, còn PageSpeed Insights kiểm tra tốc độ. Nhiều lỗi nhỏ có thể sửa ngay trong phần cài đặt của trình tạo website.
Lời khuyên dành cho bạn
Một lập trình viên web
Vấn đề nằm ở mã nguồn hoặc máy chủ: lập trình viên hiểu SEO là người phù hợp. Hãy đưa cho họ danh sách lỗi từ Search Console.
Lời khuyên dành cho bạn
Công cụ kiểm tra kỹ thuật
Website của bạn có nhiều trang: một công cụ thu thập dữ liệu sẽ đọc tất cả giống Google và đưa danh sách đầy đủ các lỗi cần sửa, từng trang một.
Lời khuyên dành cho bạn
Kiểm tra tự động, rồi đến nội dung
Website hoạt động bình thường nhưng ít khách truy cập: lỗi kỹ thuật hiếm khi là nguyên nhân. Sorank kiểm tra website, rồi viết các trang đưa lượng truy cập về.
Trình thu thập dữ liệu hoạt động như một vị khách rất kiên nhẫn. Nó yêu cầu máy chủ của bạn một URL, chờ phản hồi, đọc mã trạng thái và nội dung, rồi chuyển sang các liên kết tìm thấy. Lỗi thu thập dữ liệu là bất kỳ bước nào trong chuỗi đó bị thất bại. Vị khách không bao giờ nhận được một trang dùng được.
Định nghĩa này quan trọng vì nhiều báo cáo trộn lẫn lỗi thu thập dữ liệu với quyết định lập chỉ mục. "Đã thu thập dữ liệu, hiện chưa được lập chỉ mục" không phải lỗi thu thập dữ liệu: Google đã tải trang bình thường và chọn không giữ lại. "Bị loại trừ bởi thẻ noindex" cũng vậy: chính bạn đã bảo Google bỏ trang đó. Lỗi thu thập dữ liệu nghĩa là bản thân việc tải trang đã gặp sự cố.
Google chia vấn đề thành hai cấp, và bạn cũng nên làm vậy.
Lỗi trang web và lỗi URL
Một cửa hàng có 4000 URL sản phẩm cũ trả về 404 vẫn có thể hoàn toàn khỏe mạnh nếu các sản phẩm đó đã ngừng bán vĩnh viễn. Cũng cửa hàng đó mà có tệp robots.txt trả về 503 trong sáu giờ thì đang gặp tình huống khẩn cấp thật sự, dù mọi trang sản phẩm đều hoạt động. Hãy bắt đầu từ máy chủ, rồi tới các URL tạo ra doanh thu, sau cùng là phần còn lại.
Để sửa lỗi thu thập dữ liệu tốt, bạn cần biết Google thực sự làm gì khi gặp chúng. Tài liệu của Google về cách mã trạng thái HTTP cùng lỗi mạng và DNS ảnh hưởng tới Google Tìm kiếm (Google Search Central) đưa ra các quy tắc. Dưới đây là ý nghĩa thực tế của chúng.
| Phản hồi | Google làm gì | Có phải vấn đề không? |
|---|---|---|
| 2xx | Chuyển nội dung sang bước lập chỉ mục. Việc lập chỉ mục không được đảm bảo. | Không, trừ khi trang trống (soft 404). |
| 301, 308 | Tín hiệu mạnh rằng đích là URL mới. | Không, nếu chỉ một bước tới trang 200. |
| 302, 303, 307 | Tín hiệu yếu: URL gốc thường vẫn là URL chính tắc. | Có, nếu việc chuyển là vĩnh viễn. |
| Chuỗi 3xx | Mặc định theo tối đa 10 bước, sau đó bỏ cuộc. | Có: mỗi bước tốn một yêu cầu, và vòng lặp không bao giờ kết thúc. |
| 404, 410, 4xx khác (trừ 429) | Coi nội dung là không tồn tại, dần loại URL đã lập chỉ mục, thu thập chúng thưa hơn. | Chỉ khi trang lẽ ra phải tồn tại. |
| 401, 403 | Giống các mã 4xx khác. Không làm chậm việc thu thập dữ liệu. | Có, nếu chúng chặn Googlebot khỏi trang công khai. |
| 429 | Được xem là tín hiệu máy chủ quá tải, giống 5xx. | Có: thu thập dữ liệu chậm lại. |
| 5xx | Làm chậm thu thập dữ liệu tương ứng với số lỗi. URL liên tục lỗi sẽ bị loại khỏi chỉ mục. | Có, luôn luôn. |
Hai chi tiết khiến nhiều đội ngũ nhầm lẫn. Thứ nhất, 401 và 403 không làm giảm tốc độ thu thập dữ liệu. Nếu máy chủ đang quá tải, trả 403 cho Googlebot không giúp gì; Google khuyên tạm thời trả 503 hoặc 429. Thứ hai, 404 không phải là hình phạt. Đó là câu trả lời đúng cho một trang không còn tồn tại.
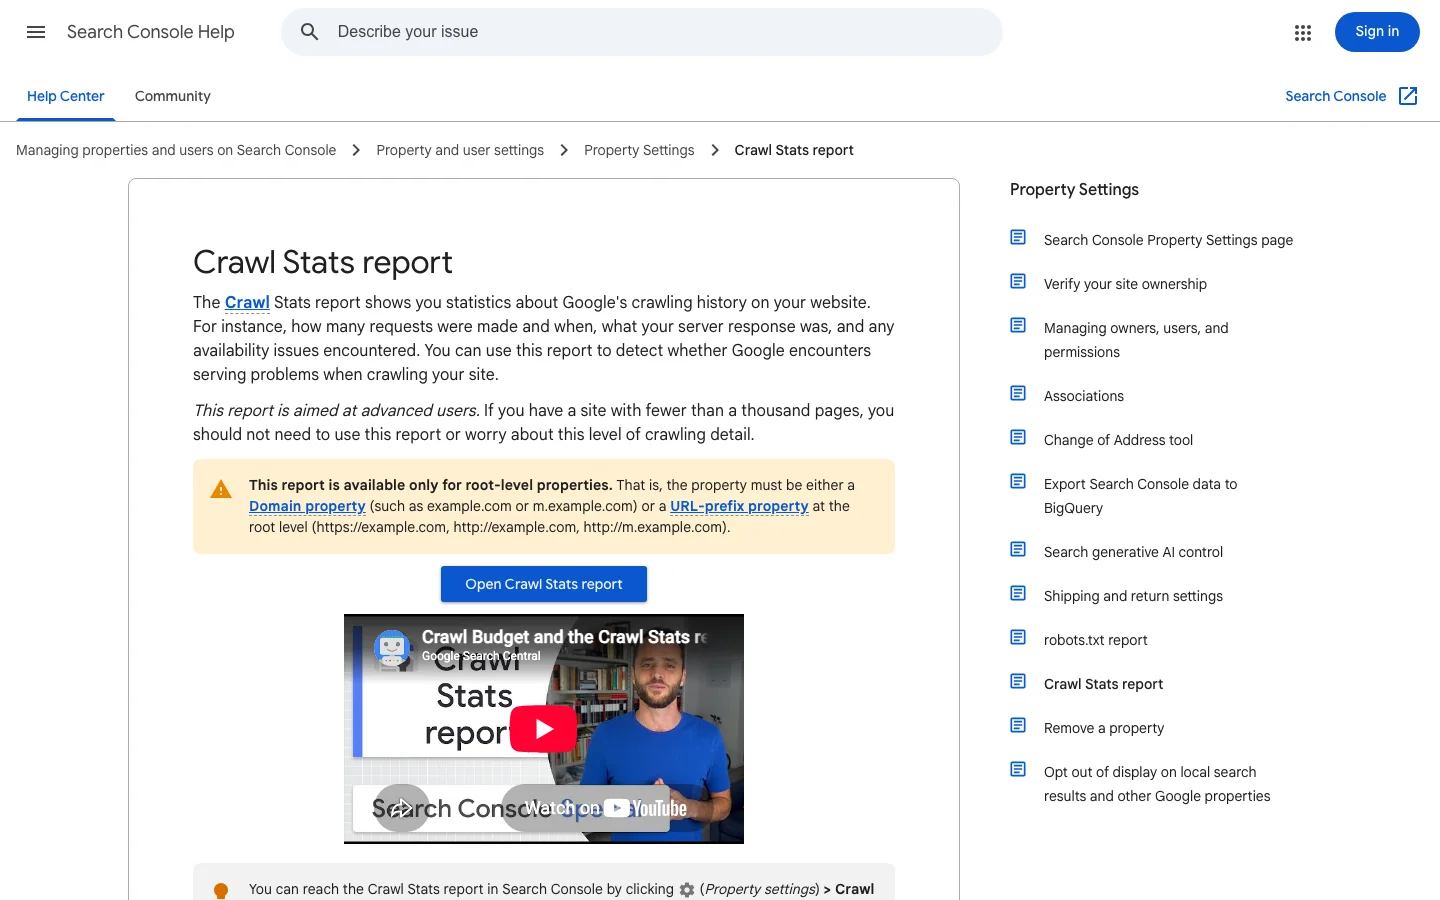
Tài liệu báo cáo Thống kê thu thập dữ liệu của Google (Trợ giúp Search Console) giải thích quy tắc này. robots.txt trả về 200 (kể cả trống) hoặc 403, 404, 410 (không có tệp) đều ổn. robots.txt trả về 429 hoặc 5xx là lỗi, và khi đó Google sẽ hành xử thận trọng.
Google làm gì khi robots.txt liên tục lỗi
Nguồn: Trợ giúp Google Search Console, báo cáo Thống kê thu thập dữ liệu
Vì vậy, một quy tắc CDN hoặc tường lửa trả 503 cho /robots.txt có thể đóng băng toàn bộ trang web trong nửa ngày, dù mọi URL khác vẫn ổn. Hãy kiểm tra tệp này đầu tiên trong mọi cuộc điều tra lỗi thu thập dữ liệu. Hướng dẫn của chúng tôi về trạng thái "Bị chặn bởi robots.txt" đề cập vấn đề ngược lại: tệp hoạt động nhưng chặn quá nhiều.
Các giới hạn thu thập dữ liệu của Google cần nhớ
Nguồn: Google Search Central, mã trạng thái HTTP và lỗi mạng; Trợ giúp Search Console, báo cáo Thống kê thu thập dữ liệu
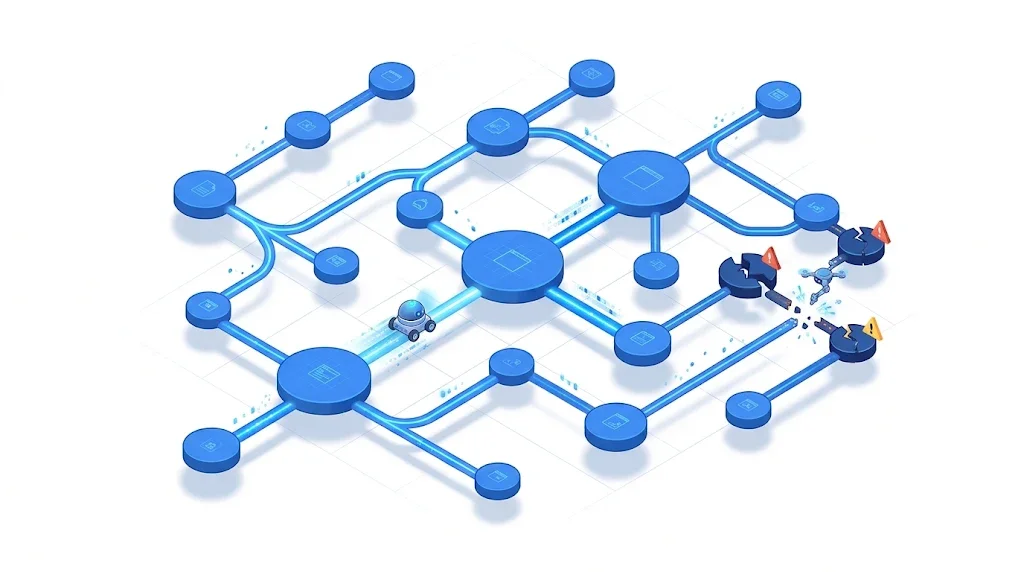
Đây là danh sách đầy đủ bạn sẽ gặp trong Search Console và trong công cụ thu thập dữ liệu, với nguyên nhân và cách sửa cho từng loại. Tên gọi theo tài liệu báo cáo Lập chỉ mục trang của Google (Trợ giúp Search Console).
Google không thể chuyển tên miền của bạn thành địa chỉ IP, hoặc máy chủ DNS không phản hồi. Nguyên nhân thường gặp: tên miền hết hạn, nhà cung cấp DNS gặp sự cố, bản ghi sai sau khi chuyển đổi, hoặc DNSSEC cấu hình sai. Kiểm tra bằng truy vấn từ bên ngoài mạng của bạn:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
Cách sửa: chỉnh lại bản ghi, giảm TTL trước mỗi lần chuyển đổi và dùng nhà cung cấp DNS có dự phòng. Nếu cả example.com và www.example.com đều tồn tại, cả hai phải phân giải được, kể cả khi một trong hai chỉ chuyển hướng.
Máy chủ không phản hồi kịp, đóng kết nối, hoặc trả về 500, 502, 503 hay 504. Nguyên nhân điển hình: cơ sở dữ liệu quá tải, tiến trình PHP hoặc Node bị sập khi tải cao, reverse proxy hết thời gian chờ, cập nhật plugin, hoặc tường lửa giới hạn bot. Hãy xem quy luật thời gian: lỗi xảy ra cùng giờ mỗi đêm thường chỉ ra một bản sao lưu hoặc tác vụ cron.
Cách sửa: đọc nhật ký lỗi máy chủ tại các thời điểm Google báo cáo, tăng thời gian chờ hoặc số worker, lưu bộ nhớ đệm các trang nặng, và đảm bảo lớp bảo vệ bot cho Googlebot đã xác minh đi qua. Khi bảo trì theo kế hoạch, hãy trả 503 kèm tiêu đề Retry-After thay vì trang 200 ghi "sắp quay lại":
HTTP/1.1 503 Service Unavailable
Retry-After: 3600Trang không tồn tại. Điều đó ổn khi trang bị xóa có chủ đích và không có gì liên kết tới nó. Đó là vấn đề khi URL vẫn còn backlink, lưu lượng hoặc liên kết nội bộ, hoặc khi trang lẽ ra phải tồn tại nhưng một lần triển khai đã làm hỏng nó.
Cách sửa: nếu nội dung đã chuyển, thêm một chuyển hướng 301 duy nhất tới trang tương đương gần nhất. Nếu đã mất vĩnh viễn, giữ 404 hoặc dùng 410, và gỡ các liên kết nội bộ cùng mục sơ đồ trang web trỏ tới nó. Đừng bao giờ chuyển hướng mọi 404 về trang chủ: Google có xu hướng coi chúng là soft 404.
Máy chủ trả 200 nhưng trang trông trống hoặc ghi "không tìm thấy": danh mục trống, trang tìm kiếm không có kết quả, sản phẩm hết hàng không có nội dung. Google tốn một yêu cầu mà không nhận được gì. Chúng tôi phân tích sâu trong hướng dẫn về lỗi soft 404.
Googlebot không bao giờ gửi thông tin đăng nhập, nên 401 hoặc 403 trên trang công khai nghĩa là máy chủ hoặc một lớp bảo mật đang chặn nó. Thủ phạm thường gặp: mật khẩu môi trường thử nghiệm bị để lại trên bản chính thức, quy tắc WAF, chặn theo quốc gia, hoặc chống hotlink áp dụng cho HTML. Hãy sửa quy tắc chứ không sửa triệu chứng, và kiểm tra bằng công cụ Kiểm tra URL trong Search Console.
Google báo lỗi chuyển hướng khi gặp vòng lặp, chuỗi quá dài, URL vượt độ dài tối đa, hoặc URL sai hay trống trong chuỗi. Trường hợp kinh điển sau khi chuyển đổi: http sang https, rồi sang www, rồi thêm dấu gạch chéo cuối, rồi sang đường dẫn mới. Bốn bước trong khi một bước là đủ. Hướng dẫn đầy đủ của chúng tôi về chuyển hướng SEO giải thích cách rút gọn chúng.
Mẹo
Dán URL đáng ngờ vào công cụ kiểm tra chuyển hướng Sorank miễn phí: nó theo toàn bộ chuỗi, hiển thị từng bước và mã trạng thái, và cho bạn biết vòng lặp hoặc bước thừa nằm ở đâu.
Một số lỗi không bao giờ hiện mã trạng thái. Trang bắt đầu tải rồi dừng, hoặc nặng tới mức trình thu thập chỉ đọc được một phần. Trình thu thập của Google chỉ đọc một số byte giới hạn cho mỗi tệp, nên trang phình to vì script nội tuyến hoặc ảnh base64 có thể mất phần nội dung ở cuối. Kiểm tra các mẫu trang nặng bằng công cụ kiểm tra kích thước trang.
Không có công cụ nào tự mình hiển thị mọi lỗi thu thập dữ liệu. Mỗi phương pháp nhìn vấn đề từ một góc khác, và một cuộc kiểm tra nghiêm túc kết hợp ít nhất hai phương pháp.
Nguyên lý: Google hiển thị các yêu cầu thu thập của chính mình trong 90 ngày qua, nhóm theo phản hồi, loại tệp, mục đích và loại Googlebot, kèm trạng thái máy chủ cho DNS, máy chủ và robots.txt. Khi nào dùng: luôn luôn, và đầu tiên, cho lỗi trang web. Ưu điểm: đây là dữ liệu gốc từ chính Google. Hạn chế: chỉ cho tài sản cấp gốc, ví dụ được lấy mẫu, và Google cho biết trang dưới một nghìn trang hiếm khi cần tới. Ví dụ: phản hồi "hết thời gian chờ trang" tăng vọt mỗi Chủ nhật lúc 3 giờ sáng, trùng với bản sao lưu cơ sở dữ liệu.
Nguyên lý: liệt kê các URL Google biết và lý do chúng chưa được lập chỉ mục, như Lỗi máy chủ (5xx), Lỗi chuyển hướng, Không tìm thấy (404) hoặc Soft 404. Khi nào dùng: để phân loại lỗi URL và xác thực bản sửa. Ưu điểm: gắn với những trang Google thực sự đã thử. Hạn chế: báo cáo trễ vài ngày, danh sách ví dụ bị giới hạn, và trộn lỗi thu thập dữ liệu với lựa chọn lập chỉ mục. Ví dụ: 300 URL dưới "Lỗi chuyển hướng" cùng chung tiền tố /blog/ cũ.
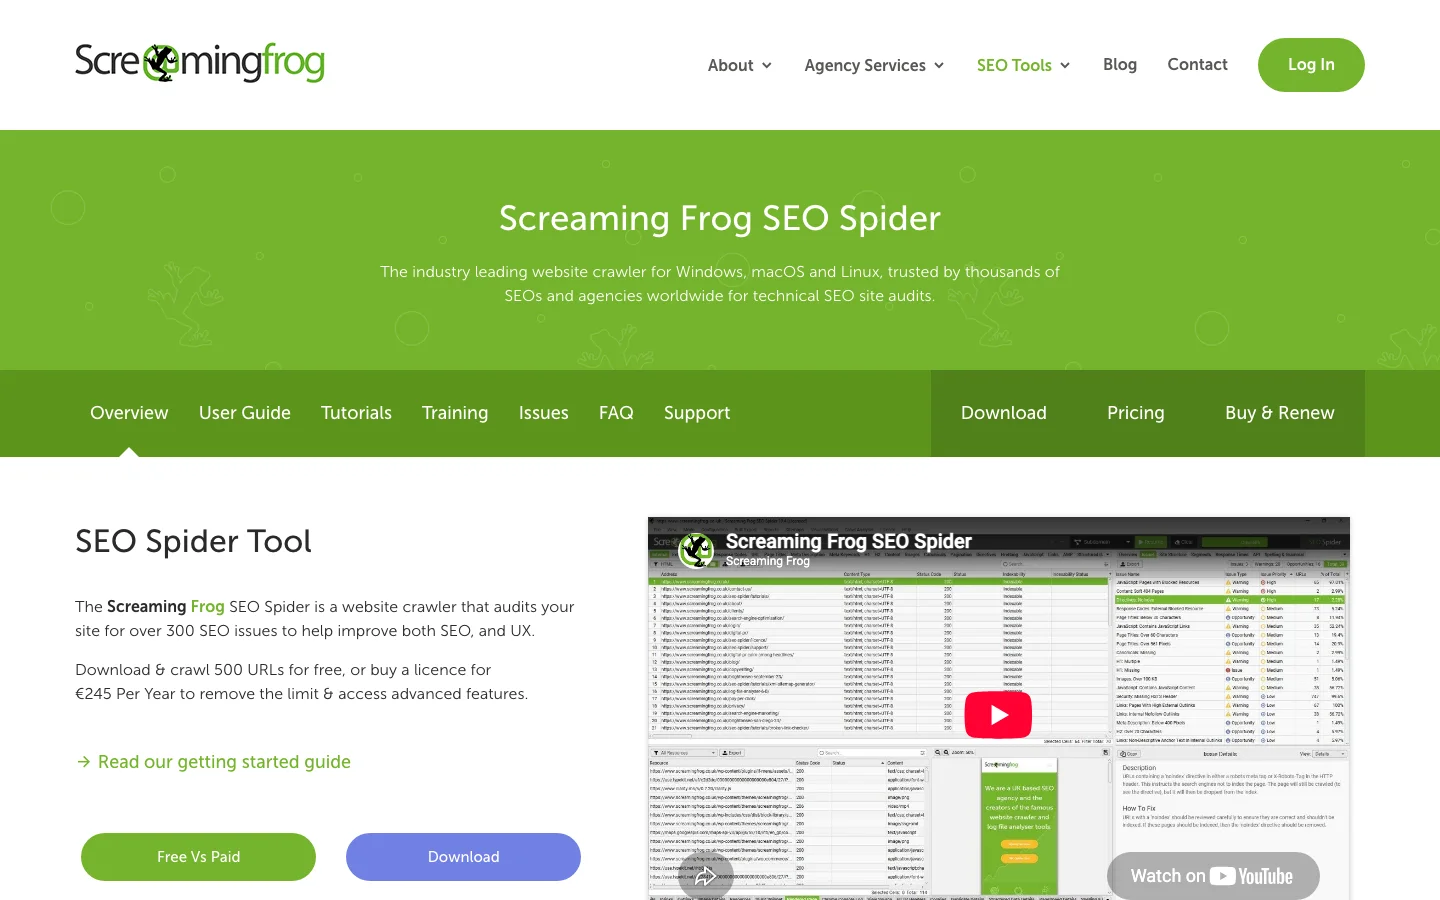
Nguyên lý: một công cụ như Screaming Frog thu thập dữ liệu trang của bạn như một bot, theo liên kết từ trang chủ, và ghi lại mọi mã trạng thái, chuỗi chuyển hướng và liên kết hỏng. Khi nào dùng: trước và sau khi chuyển đổi, thiết kế lại hoặc triển khai lớn, và hằng tháng với trang lớn. Ưu điểm: có ngay, đầy đủ cho các trang được liên kết, chỉ rõ vị trí từng liên kết hỏng. Hạn chế: không biết Google thực sự đã yêu cầu gì, bỏ sót trang mồ côi, và máy chủ có thể đối xử với nó khác với Googlebot. Hướng dẫn cài đặt Screaming Frog của chúng tôi đi qua một cuộc kiểm tra đầy đủ.
Nguyên lý: nhật ký truy cập ghi lại mọi yêu cầu, kể cả từ Googlebot, Bingbot, GPTBot, ClaudeBot và PerplexityBot, với mã trạng thái và thời gian phản hồi chính xác. Khi nào dùng: với trang lớn, sau khi lưu lượng giảm không rõ lý do, và để xem trình thu thập AI truy cập những gì. Ưu điểm: yêu cầu thật, mã thật, không lấy mẫu, mọi bot. Hạn chế: cần quyền truy cập nhật ký và một chút script; bạn phải xác minh rằng "Googlebot" đúng là Google. Hướng dẫn của chúng tôi về phân tích tệp nhật ký cho SEO đi từng bước. Một cái nhìn nhanh đầu tiên:
# Các yêu cầu của Googlebot không trả về 200, 301 hoặc 304, thường gặp nhất xếp trước
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50Nguyên lý: kiểm tra mỗi lần một URL bằng curl hoặc công cụ trực tuyến miễn phí. Khi nào dùng: để xác nhận bản sửa, hoặc kiểm tra trang quan trọng sau khi triển khai. Ưu điểm: tức thì và chính xác. Hạn chế: không mở rộng được. Hãy dùng user agent của Googlebot để phát hiện quy tắc đối xử khác với bot:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| Phương pháp | Thấy lỗi trang web | Thấy lỗi URL | Dữ liệu Googlebot thật | Thấy trình thu thập AI | Phù hợp nhất cho |
|---|---|---|---|---|---|
| Báo cáo Thống kê thu thập dữ liệu | Có | Lấy mẫu | Có | Không | Sức khỏe máy chủ |
| Báo cáo Lập chỉ mục trang | Một phần | Có | Có | Không | Phân loại và xác thực |
| Công cụ thu thập (Screaming Frog...) | Không | Có, các trang được liên kết | Không | Không | Tìm liên kết hỏng tại nguồn |
| Nhật ký máy chủ | Một phần | Có | Có | Có | Trang lớn, nguyên nhân gốc |
| Kiểm tra từng URL | Không | Từng cái một | Không | Không | Xác nhận bản sửa |
Mã trạng thái 5xx nghĩa là máy chủ không xử lý được một yêu cầu trông hợp lệ. Google sẽ giảm tốc độ thu thập dữ liệu để phản ứng, và giảm mạnh hơn khi có nhiều URL của bạn trả về lỗi. Google giữ các URL đã lập chỉ mục trong một thời gian, nhưng sẽ gỡ những URL liên tục trả về lỗi máy chủ. Một đợt lỗi ngắn còn có thể khôi phục, vì Google dần tăng lại tốc độ thu thập khi máy chủ của bạn trả về mã 2xx. Thứ làm hại chỉ mục của bạn là chuỗi lỗi kéo dài.
Mỗi mã 5xx trỏ tới một phần khác nhau của hệ thống. Bảng dưới đây cho bạn điểm đầu tiên nên kiểm tra với từng mã.
| Mã | Thường có nghĩa là | Xem trước tiên |
|---|---|---|
| 500 | Ứng dụng bị lỗi khi xử lý yêu cầu | Nhật ký lỗi ứng dụng đúng vào thời điểm yêu cầu |
| 502 | Proxy hoặc CDN nhận được phản hồi không hợp lệ từ ứng dụng, thường vì ứng dụng bị sập hoặc khởi động lại | Các lần khởi động lại và thời gian hoạt động của tiến trình ứng dụng |
| 503 | Dịch vụ quá tải, bị giới hạn tốc độ hoặc đang bảo trì | Biểu đồ tải, lịch sử triển khai và khung giờ bảo trì |
| 504 | Proxy đã ngừng chờ ứng dụng | Truy vấn cơ sở dữ liệu chậm và cài đặt thời gian chờ của proxy |
| 429 | Bộ giới hạn tốc độ báo có quá nhiều yêu cầu | Quy tắc giới hạn tốc độ, và liệu chúng có áp dụng cho Googlebot đã xác minh hay không |
Thống kê thu thập dữ liệu cho thấy những ngày và giờ Google gặp lỗi (hướng dẫn Thống kê thu thập dữ liệu của chúng tôi giải thích từng biểu đồ). Nhật ký máy chủ cho bạn biết chính xác điều gì đã xảy ra vào những thời điểm đó. Lọc các yêu cầu của Googlebot và đếm phản hồi 5xx theo giờ:
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
Mỗi dòng kết quả là một giờ, một mã trạng thái và một số đếm. Lỗi tập trung vào cùng một giờ mỗi đêm thường trỏ tới một bản sao lưu, một tác vụ cron hoặc một lần nhập dữ liệu theo lịch. Lỗi rải rác suốt ngày thường cho thấy quá tải, nên cách sửa là tăng năng lực hoặc bộ nhớ đệm, chứ không phải một lỗi đơn lẻ. Với phương pháp sâu hơn, xem hướng dẫn phân tích nhật ký tệp của chúng tôi.
Google giảm việc thu thập dữ liệu tương ứng với số URL trả về lỗi. Một mẫu giao diện hỏng ảnh hưởng đến vài URL chỉ tốn ít thời gian thu thập. Sự cố cơ sở dữ liệu làm hỏng mọi trang thì tốn rất nhiều, và đó là thứ cần sửa trước.
Mã 429 có tác động giống như 5xx, vì Google đọc nó như một máy chủ quá tải. Nếu bộ giới hạn tốc độ hoặc lớp bảo vệ chống bot của bạn trả về 429 cho Googlebot, bạn sẽ phải trả giá bằng thời gian thu thập. Tài liệu của Google không đề cập đến tiêu đề Retry-After. Hãy tiếp tục gửi nó cho khách truy cập thật và máy khách API, nhưng đừng trông cậy vào việc Googlebot sẽ chờ đúng khoảng thời gian bạn đặt.
Mã trạng thái 4xx nghĩa là máy chủ từ chối yêu cầu vì một điều gì đó phía máy khách: URL không tồn tại, quyền truy cập bị cấm hoặc địa chỉ sai định dạng. Google xử lý mọi mã 4xx, trừ 429, theo cùng một cách. Google ngừng sử dụng nội dung phía sau URL đó và gỡ URL khỏi chỉ mục nếu trước đó URL đã được lập chỉ mục. Trước khi đụng vào một lỗi 4xx, hãy tìm xem yêu cầu đến từ đâu, vì cách sửa thường nằm ở một chỗ: một liên kết, một mẫu giao diện hoặc một quy tắc chuyển hướng.
Nhật ký truy cập ghi lại nguồn giới thiệu (referrer) của mỗi yêu cầu, cho bạn biết trang nào đã đưa khách truy cập hoặc bot đến URL đó. Đếm các phản hồi 4xx theo đường dẫn và theo referrer:
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
Đọc cột referrer theo cách sau:
Một bản phát hành đổi tên tuyến đường, đổi slug hoặc dựng lại mẫu giao diện thường tạo ra một làn sóng lỗi 404 trong cùng ngày. Xuất số phản hồi 4xx theo ngày cho tuần trước khi triển khai và tuần sau đó. Mức tăng tập trung trong một thư mục sẽ chỉ thẳng vào thay đổi đó. Thêm chuyển hướng từ URL cũ sang URL mới ngay trong bản phát hành đó, đừng để sang một yêu cầu sau. Với một đợt chuyển trang đầy đủ, xem danh sách kiểm tra chuyển đổi SEO của chúng tôi.
Mẹo
Đừng thay một trang bị thiếu bằng phản hồi 200 hiển thị thông báo ngắn hoặc danh sách rỗng. Google có thể coi đó là một soft 404, khiến Google phải tải toàn bộ trang mà không nhận lại được gì.
Đây là phương pháp chúng tôi sử dụng. Nó đi từ những lỗi có thể dừng toàn bộ trang web tới những lỗi chỉ lãng phí một chút thu thập dữ liệu.
Phương pháp 6 bước xử lý lỗi thu thập dữ liệu
Trong Search Console, mở Cài đặt, rồi Thống kê thu thập dữ liệu, rồi Trạng thái máy chủ. Màu xanh nghĩa là không có vấn đề đáng kể trong 90 ngày. "Gần đây có vấn đề" nghĩa là có sự cố nghiêm trọng trong tuần qua: gác mọi việc khác lại. Nhấn vào từng mục để xem tỷ lệ lỗi theo ngày, rồi đối chiếu những ngày xấu với lịch sử hosting, CDN và triển khai.
Mở Lập chỉ mục, rồi Trang, và xuất từng lý do lỗi. Đừng sửa từng URL một. Đưa chúng vào bảng tính và tách thư mục đầu tiên:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")Một bảng tổng hợp (pivot) trên cột đó thường cho thấy phần lớn lỗi đến từ hai hoặc ba mẫu trang: một danh mục blog đã ngừng, một tham số bộ lọc, một nguồn cấp sản phẩm cũ.
Với mỗi mẫu, hãy đặt bốn câu hỏi. Nó có lượt nhấp tự nhiên không? Có backlink không? Có được liên kết nội bộ không? Có trong sơ đồ trang web không? Một 404 không có điều nào trong bốn điều đó có thể chờ mãi. Một 404 có backlink cần một 301 ngay hôm nay. Công cụ kiểm tra liên kết hỏng miễn phí cho biết trang nào của bạn vẫn liên kết tới URL chết.
Sửa quy tắc, không sửa từng URL. Một bản đồ chuyển hướng trong cấu hình máy chủ tốt hơn 400 chuyển hướng thêm thủ công trong plugin. Ví dụ với nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Với 5xx, hãy sửa năng lực máy chủ hoặc lỗi phần mềm. Với 401 và 403, hãy sửa quy tắc bảo mật. Với soft 404, hãy thêm nội dung thật hoặc trả về một 404 thật.
Mọi liên kết nội bộ nên trỏ thẳng tới URL trả về 200. Mọi mục trong sơ đồ trang web nên là URL chính tắc, có thể lập chỉ mục và trả về 200. Sơ đồ trang web đầy chuyển hướng và 404 sẽ dạy Google tin nó ít hơn. Hướng dẫn của chúng tôi về cách tạo sơ đồ trang web giải thích những gì nên có trong đó.
Trong báo cáo Lập chỉ mục trang, mở lý do đã sửa và nhấn Xác thực bản sửa lỗi. Google kiểm tra một mẫu trước, rồi phần còn lại; quá trình thường mất tối đa khoảng hai tuần và dừng lại nếu dù chỉ một URL vẫn lỗi. Đừng nhấn lại khi quá trình đang chạy. Sau đó lập thói quen hằng tuần: Thống kê thu thập dữ liệu cho máy chủ, nhật ký cho các đợt tăng vọt, một lần thu thập sau mỗi lần triển khai.
Một chuỗi chuyển hướng trước và sau khi sửa
Đó là gì: một plugin hoặc quy tắc gửi mọi URL bị thiếu về /. Cách phát hiện: nhiều URL trong "Soft 404" hoặc "Trang có chuyển hướng" đều dẫn về trang chủ; công cụ thu thập hiển thị hàng trăm 301 cùng một đích. Cách khắc phục: chỉ chuyển hướng tới trang tương đương gần, và để phần còn lại trả về 404 hoặc 410.
Đó là gì: WAF, trình quản lý bot hoặc bộ giới hạn tốc độ trả về 403, 429 hoặc trang thử thách cho Google. Cách phát hiện: 403 hoặc 429 trong Thống kê thu thập dữ liệu, trong khi trang tải bình thường trên trình duyệt của bạn; nhật ký cho thấy các lần chặn theo IP. Cách khắc phục: cho phép Googlebot đã xác minh bằng DNS ngược hoặc dải IP Google công bố, thay vì tin vào chuỗi user agent.
Đó là gì: robots.txt do ứng dụng tạo ra, nên lỗi mỗi khi ứng dụng lỗi, hoặc được phục vụ qua quy tắc CDN lưu đệm một mã 5xx. Cách phát hiện: mục tải robots.txt trong Trạng thái máy chủ không có màu xanh. Cách khắc phục: phục vụ nó dưới dạng tệp tĩnh, bên ngoài ứng dụng, và kiểm tra bằng công cụ kiểm tra robots.txt.
Đó là gì: trang "Chúng tôi sẽ sớm quay lại" được phục vụ với mã 200 trên mọi URL. Cách phát hiện: sau bảo trì, xuất hiện một loạt soft 404 hoặc tiêu đề trùng lặp. Cách khắc phục: trả 503 kèm Retry-After trong lúc bảo trì, và giữ thời gian ngắn.
Đó là gì: trả 403 cho Googlebot khi máy chủ quá tải. Cách phát hiện: các đợt tăng 403 trùng với các đợt tăng tải. Cách khắc phục: Google cho biết các mã 4xx khác 429 không ảnh hưởng tới tốc độ thu thập dữ liệu. Hãy trả 503 hoặc 429 trong thời gian ngắn và nâng năng lực máy chủ.
Đó là gì: bấm qua danh sách trong Search Console và chỉnh từng URL. Cách phát hiện: cùng một lý do quay lại mỗi tháng. Cách khắc phục: nhóm theo mẫu, sửa mẫu trang hoặc quy tắc, rồi xác thực một lần.
Đó là gì: mất nhiều ngày cho 404 của URL rác hoặc trang đã xóa từ lâu không có liên kết. Cách phát hiện: URL không có lượt nhấp, backlink hay liên kết nội bộ. Cách khắc phục: cứ để đó. Google cho biết 404 cho một trang đã bị gỡ không nhất thiết là vấn đề.
Cảnh báo
Đừng bao giờ chặn một URL trong robots.txt để "giấu" lỗi thu thập dữ liệu. Google không còn thấy 404 hay chuyển hướng, URL có thể vẫn nằm trong chỉ mục, và bạn mất đi tín hiệu mình muốn gửi.
Với trang web vài trăm trang, Google có thời gian cho mọi thứ, và lỗi thu thập dữ liệu chủ yếu quan trọng với những trang bị chúng làm hỏng. Với trang lớn (cửa hàng có bộ lọc, sàn thương mại, trang tin tức), mỗi yêu cầu thất bại hoặc lãng phí đều lấy đi thời gian của các trang thật. Đó là ý tưởng đằng sau ngân sách thu thập dữ liệu.
5xx và 429 khiến Google chậm lại trên toàn máy chủ, nên vài mẫu trang hỏng có thể làm chậm việc thu thập các trang sản phẩm mới. Chuỗi chuyển hướng tốn một yêu cầu cho mỗi bước. Soft 404 tốn trọn một lần tải mà không trả lại gì. Sửa ba thứ này, cùng một ngân sách sẽ bao phủ được nhiều trang hữu ích hơn.
Khi Google tìm thấy URL nhưng hoãn việc thu thập, nguyên nhân thường là một máy chủ mà Google coi là mong manh. Nếu bạn thấy số "Đã phát hiện, hiện chưa được lập chỉ mục" tăng dần cùng với lỗi máy chủ trong Thống kê thu thập dữ liệu, hãy sửa máy chủ trước. Hai báo cáo kể cùng một câu chuyện.
Googlebot không còn là vị khách quan trọng duy nhất. GPTBot, OAI-SearchBot, ClaudeBot và PerplexityBot tải trang để huấn luyện mô hình hoặc trả lời câu hỏi theo thời gian thực. Chúng truy cập cùng máy chủ và chịu cùng các lỗi, với một khác biệt: bạn không có Search Console cho chúng.
Hầu hết trình thu thập AI không chạy JavaScript, nên một trang chỉ dựng nội dung trong trình duyệt có thể trông trống với chúng, một kiểu soft 404 bạn sẽ không bao giờ thấy trong báo cáo của Google. Nhiều bot bị dịch vụ chống bot chặn mặc định, thường bằng 403. Và vì chúng tải trang theo yêu cầu khi người dùng đặt câu hỏi, một lần hết thời gian chờ đúng lúc đó nghĩa là câu trả lời sẽ trích dẫn người khác. Hướng dẫn của chúng tôi về SEO JavaScript đề cập việc hiển thị cho cả công cụ tìm kiếm lẫn trình thu thập AI.
Nhật ký máy chủ là nguồn đáng tin cậy duy nhất. Lọc theo user agent và xem mã trạng thái:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnNếu bot AI nhận 403 ngoài ý muốn, hãy sửa quy tắc. Sau đó kiểm tra xem chúng có thực sự trích dẫn bạn không: tính năng theo dõi lượt nhắc tới trên AI của Sorank theo dõi tần suất ChatGPT, Gemini, Claude và Perplexity nhắc tới thương hiệu của bạn, để bạn thấy một bản sửa lỗi thu thập dữ liệu có thay đổi được gì không.
Chạy danh sách này sau mỗi lần chuyển đổi, thiết kế lại hoặc triển khai lớn, và mỗi tháng một lần với trang lớn.
Danh sách kiểm tra sức khỏe thu thập dữ liệu
Mở Thống kê thu thập dữ liệu và kiểm tra ba dòng trạng thái máy chủ. Sau đó chạy công cụ kiểm tra khả năng lập chỉ mục miễn phí trên năm trang giá trị nhất của bạn. Nếu cả hai đều sạch, hãy xuất các lỗi trong Lập chỉ mục trang và nhóm theo thư mục: giờ bạn có một danh sách sửa lỗi ngắn, đã xếp hạng, thay vì một báo cáo đáng sợ.
Khi việc thu thập dữ liệu đã sạch, giới hạn tiếp theo là chính nội dung. Tính năng tối ưu hóa nội dung của Sorank viết lại và làm mới các trang hiện có ở chế độ autopilot, để những trang Google giờ đã tiếp cận được xứng đáng được lập chỉ mục và trích dẫn. Với những trang Google đã thu thập nhưng bỏ qua, hãy đọc hướng dẫn của chúng tôi về "Đã thu thập dữ liệu, hiện chưa được lập chỉ mục".
Lỗi thu thập dữ liệu là những yêu cầu của công cụ tìm kiếm hoặc trình thu thập AI bị thất bại: DNS không phân giải được, máy chủ hết thời gian chờ hoặc trả về 5xx, không tải được robots.txt, chuyển hướng bị lặp, hoặc trang trả về mã 4xx. Lỗi cấp trang web có thể dừng việc thu thập toàn trang, còn lỗi URL chỉ ảnh hưởng tới trang liên quan.
Bản thân chúng thì không. Google cho biết 404 cho một trang bị gỡ mà không có trang thay thế không nhất thiết là vấn đề. Nó trở thành vấn đề khi URL vẫn còn backlink, lưu lượng hoặc liên kết nội bộ; khi đó cách sửa đúng là một chuyển hướng 301 duy nhất tới trang tương đương gần nhất.
Sau khi bạn nhấn Xác thực bản sửa lỗi trong báo cáo Lập chỉ mục trang của Search Console, việc xác thực thường mất tối đa khoảng hai tuần. Google kiểm tra một mẫu URL trước, rồi phần còn lại, và dừng lại nếu dù chỉ một URL bị ảnh hưởng vẫn lỗi.
Chúng tôi phân tích đối thủ, website và mức độ hiển thị trên AI của bạn để lập kế hoạch nội dung phù hợp, hoàn toàn miễn phí.
 Trình tạo brief nội dung AI
 Công cụ tạo schema FAQ
 Công cụ tạo ý tưởng bài blog bằng AI
 Công cụ kiểm tra dữ liệu có cấu trúc
 Công cụ kiểm tra văn bản thay thế
 Công cụ phân tích liên kết nội bộ
 Thử thách backlink
 Trình tạo mô tả meta
 Trình tạo tiêu đề blog AI
 Công cụ kiểm tra khả năng lập chỉ mục Google
 Trình tạo dàn ý blog AI
 Công cụ tạo liên kết UTM
 Công cụ phân cụm từ khóa
 Công cụ kiểm tra thẻ canonical
 Công cụ tạo sitemap XML
 Công cụ kiểm tra liên kết hỏng
 Công cụ tạo tiêu đề SEO bằng AI
 Công cụ phân tích tiêu đề
 Công cụ xem trước kết quả tìm kiếm
 Công cụ kiểm tra chuyển hướng
 Công cụ tạo thẻ hreflang
 Công cụ phân tích cấu trúc tiêu đề
 Công cụ kiểm tra HTTP header
 Công cụ trích xuất favicon
 Công cụ tính CTR SERP
 Công cụ tính tiết kiệm SEO so với quảng cáo tìm kiếm
 Máy tính tỷ lệ hiển thị SEO
 Máy tính ROI SEO
 Máy tính dự báo lưu lượng và doanh thu SEO
 Máy tính ngân sách SEO
 Máy tính điểm hòa vốn SEO
 Máy tính ROI SEO cho SaaS
 Máy tính ROAS
 Máy tính thời gian đọc
 Mô phỏng mức tăng thứ hạng
 Máy tính giá trị lưu lượng truy cập tự nhiên
 Máy ước tính lưu lượng tự nhiên và công cụ kiểm tra lưu lượng website
 Máy tính tỷ lệ LTV trên CAC
 Máy tính ROI SEO địa phương
 Máy tính chi phí xây dựng liên kết
 Máy tính giá trị từ khóa
 Máy tính điểm cơ hội từ khóa
 Máy tính mật độ từ khóa
 Máy tính ROI GEO
 Máy tính đầu tư nội dung GEO
 Máy tính ROI SEO thương mại điện tử
 Máy tính giá trị trọn đời của khách hàng
 Máy tính chi phí thu hút khách hàng
 Công cụ tính CTR
 Công cụ tính chi phí mỗi bài viết
 Công cụ tính tỷ lệ chuyển đổi
 Công cụ tính ROI marketing nội dung
 Công cụ ước tính lưu lượng giới thiệu từ ChatGPT
 Công cụ tính tỷ lệ thoát
 Công cụ tính ROI backlink
 Công cụ tính điểm hiển thị AI
 Công cụ tính giá trị lưu lượng AI
 Công cụ tính share of voice AI
 Công cụ tính chi phí vắng mặt trên AI
 Công cụ tính tỷ lệ trích dẫn AI
 Trình kiểm tra llms.txt
 Trình kiểm tra AI Overview và trình kiểm tra thứ hạng AI Overviews
 Trình kiểm tra robots.txt
 Kiểm tra SEO AI
 Công cụ kiểm tra độ dễ đọc cho LLM
 Công cụ kiểm tra mức sẵn sàng SearchGPT
 Kiểm tra LLM cho dữ liệu có cấu trúc
 Kiểm tra khả năng thu thập dữ liệu của website cho AI
 Vì sao ChatGPT không giới thiệu website của tôi
 Công cụ đo thứ hạng Gemini
 Kiểm tra thứ hạng Perplexity
 Kiểm tra trích dẫn LLM
 Kiểm tra tối ưu hóa công cụ trả lời
 Kiểm tra GEO
 Bài kiểm tra độ hiển thị trên tìm kiếm AI
 Công cụ kiểm tra độ hiển thị trên ChatGPT
 Trình tạo llms.txt
 Trích xuất URL
 Chuyển trang web sang Markdown
 Công cụ kiểm tra sitemap
 Cảm biến biến động SERP
 Công cụ kiểm tra kích thước trang
 Bộ đếm từ
 Trình tạo slug
 Trình tạo schema
 Trình tạo robots.txt
 Xem trước OG
 Trình tạo thẻ meta
 Trình nén ảnh
 Trình tạo favicon
 Kiểm tra OnPage: công cụ kiểm tra và phân tích SEO
 Công cụ phân tích backlink
 Công cụ nghiên cứu từ khóa
 Công cụ kiểm tra Domain Authority
 “Tôi đã thử Sorank trên website thật của một khách hàng và nó quá tuyệt. Nó làm được mọi thứ mà một agency sẽ tính bạn $1500 mỗi tháng để làm. Giờ nó đang được đưa vào vận hành cho khách hàng đó.”

 Guillaume Guersanguersanguillaume.com“Chúng tôi là một agency quảng cáo và muốn đưa SEO của mình đi đúng hướng một lần cho xong. Sorank cho chúng tôi cái nhìn rõ ràng về website, giúp sắp xếp thứ tự ưu tiên các tối ưu, và cấu trúc nội dung một cách đúng đắn. Công cụ dễ dùng, được thiết kế tốt cho cả nhóm, và rất thiết thực để tập trung theo dõi mà không phải xoay xở qua nhiều nền tảng. Một nền tảng rất vững chắc để bắt đầu lại từ đầu với SEO của chúng tôi.”
 Gaspard MadouiAgency quảng cáo
 “Tôi chỉ để phần mềm Sorank làm việc của nó, và giờ DR của tôi là 25 và trang của tôi đang lên hạng cao hơn.”
 Lucas Flandrefoundertrace.fr“Tôi đã chuyên sâu về GEO nhờ Sorank. Bảng xếp hạng GEO giúp tôi cho khách hàng thấy vị trí của họ so với đối thủ trên ChatGPT. Đây là một điểm khác biệt thực sự về mặt thương mại.”
 MélanieSEO freelance“Dịch vụ rất tốt, hoạt động hiệu quả với website của chúng tôi và giúp hiểu cách cải thiện để xếp hạng cao hơn trên Google và các nơi khác. Chúc mừng, cứ tiếp tục nhé, tôi giới thiệu.”
 Hugo T.Chủ cửa hàng thương mại điện tử