Preferensi
Privasi penting bagi kami, sehingga Anda dapat menonaktifkan jenis penyimpanan tertentu yang tidak diperlukan untuk fungsi dasar situs web. Memblokir kategori tertentu dapat memengaruhi pengalaman Anda di situs web. Informasi lebih lanjut
Privasi penting bagi kami, sehingga Anda dapat menonaktifkan jenis penyimpanan tertentu yang tidak diperlukan untuk fungsi dasar situs web. Memblokir kategori tertentu dapat memengaruhi pengalaman Anda di situs web. Informasi lebih lanjut

Temukan dan perbaiki kesalahan crawl: DNS, server, robots.txt, 404, soft 404, dan pengalihan. Reaksi Googlebot pada tiap error dan metode 6 langkah memperbaikinya.

Alat

Singkatnya
kesalahan crawl (crawl error) adalah permintaan mesin pencari atau crawler AI ke situs Anda yang gagal: server kehabisan waktu, DNS tidak menjawab, robots.txt tidak bisa diambil, pengalihan berputar tanpa akhir, atau halaman mengembalikan kode 4xx atau 5xx. Kesalahan tingkat situs (DNS, server, robots.txt) bisa menghentikan Google meng-crawl seluruh situs Anda, jadi perbaiki itu lebih dulu; kesalahan tingkat URL (404, soft 404, kesalahan pengalihan) hanya penting jika mengenai halaman yang ingin Anda indeks. Anda menemukannya di laporan Statistik Crawling dan Pengindeksan halaman di Search Console, memastikannya dengan crawler dan log server, lalu memperbaiki penyebabnya dan memvalidasi.
Ingin tahu lebih banyak? Tanyakan kepada
Kuis singkat
Siapa yang sebaiknya memperbaiki sisi teknis situs Anda?
Saran kami untuk Anda
Periksa sendiri dengan alat gratis Google
Search Console mendaftar halaman yang tidak bisa dibaca Google, dan PageSpeed Insights menguji kecepatan. Banyak masalah kecil bisa diperbaiki dari pengaturan pembuat situs Anda.
Saran kami untuk Anda
Developer web
Masalahnya ada di kode atau server: developer yang paham SEO adalah orang yang tepat. Berikan daftar error dari Search Console kepadanya.
Saran kami untuk Anda
Alat audit teknis
Situs Anda punya banyak halaman: crawler membaca semuanya seperti Google dan memberi daftar lengkap error yang perlu diperbaiki, halaman demi halaman.
Saran kami untuk Anda
Audit otomatis, lalu konten
Situs Anda berjalan baik tapi pengunjungnya sedikit: masalah teknis jarang menjadi penyebabnya. Sorank mengaudit situs, lalu menulis halaman yang mendatangkan trafik.
Crawler bekerja seperti pengunjung yang sangat sabar. Ia meminta sebuah URL ke server Anda, menunggu jawaban, membaca kode status dan kontennya, lalu beralih ke tautan yang ditemukannya. Kesalahan crawl adalah setiap langkah dalam rantai itu yang gagal. Pengunjung tidak pernah mendapat halaman yang bisa dipakai.
Definisi ini penting karena banyak laporan mencampur kesalahan crawl dengan keputusan pengindeksan. "Di-crawl, saat ini tidak diindeks" bukan kesalahan crawl: Google mengambil halaman dengan baik lalu memilih untuk tidak menyimpannya. "Dikecualikan oleh tag noindex" juga bukan: Anda sendiri yang menyuruh Google membuang halaman itu. Kesalahan crawl berarti proses pengambilannya sendiri yang bermasalah.
Google membagi masalah menjadi dua tingkat, dan Anda juga sebaiknya begitu.
Kesalahan situs vs kesalahan URL
Toko dengan 4000 URL produk lama yang mengembalikan 404 bisa saja sehat jika produk itu memang sudah dihapus permanen. Toko yang sama dengan file robots.txt yang mengembalikan 503 selama enam jam mengalami keadaan darurat nyata, walaupun semua halaman produk berfungsi. Mulailah dari host, lalu URL yang menghasilkan uang, baru sisanya.
Untuk memperbaiki kesalahan crawl dengan baik, Anda perlu tahu apa yang sebenarnya dilakukan Google saat menemuinya. Dokumentasi Google tentang bagaimana kode status HTTP serta error jaringan dan DNS memengaruhi Google Penelusuran (Google Search Central) memberikan aturannya. Berikut artinya dalam praktik.
| Respons | Yang dilakukan Google | Apakah masalah? |
|---|---|---|
| 2xx | Meneruskan konten ke pengindeksan. Pengindeksan tidak dijamin. | Tidak, kecuali halamannya kosong (soft 404). |
| 301, 308 | Sinyal kuat bahwa target adalah URL baru. | Tidak, jika satu lompatan ke 200. |
| 302, 303, 307 | Sinyal lemah: URL asli cenderung tetap menjadi kanonis. | Ya, jika perpindahannya permanen. |
| Rantai 3xx | Secara default mengikuti hingga 10 lompatan, lalu menyerah. | Ya: setiap lompatan membuang satu permintaan, dan putaran tidak pernah selesai. |
| 404, 410, 4xx lain (kecuali 429) | Menganggap konten tidak ada, menghapus URL terindeks seiring waktu, lebih jarang meng-crawl-nya. | Hanya jika halaman seharusnya ada. |
| 401, 403 | Sama seperti 4xx lain. Tidak memperlambat crawl. | Ya, jika memblokir Googlebot dari halaman publik. |
| 429 | Dianggap sinyal server kelebihan beban, seperti 5xx. | Ya: crawl melambat. |
| 5xx | Memperlambat crawl sebanding dengan jumlah error. URL yang terus gagal dihapus dari indeks. | Ya, selalu. |
Dua detail sering menjebak tim. Pertama, 401 dan 403 tidak menurunkan laju crawl. Jika server Anda kewalahan, mengembalikan 403 ke Googlebot tidak membantu; Google meminta Anda mengembalikan 503 atau 429 untuk sementara. Kedua, 404 bukan penalti. Itu jawaban yang benar untuk halaman yang sudah tidak ada.
Dokumentasi laporan Statistik Crawling Google (Bantuan Search Console) menjelaskan aturannya. robots.txt yang menjawab 200 (meski kosong) atau 403, 404, atau 410 (tidak ada file) tidak masalah. robots.txt yang menjawab 429 atau 5xx adalah kegagalan, dan Google lalu bermain aman.
Yang dilakukan Google saat robots.txt terus gagal
Sumber: Bantuan Google Search Console, laporan Statistik Crawling
Jadi aturan CDN atau firewall yang menyajikan 503 pada /robots.txt bisa membekukan seluruh situs selama setengah hari, walaupun semua URL lain baik-baik saja. Periksa file ini pertama kali di setiap penyelidikan kesalahan crawl. Panduan kami tentang status "Diblokir oleh robots.txt" membahas masalah sebaliknya, saat file berfungsi tetapi memblokir terlalu banyak.
Batas crawl Google yang perlu diingat
Sumber: Google Search Central, kode status HTTP dan error jaringan; Bantuan Search Console, laporan Statistik Crawling
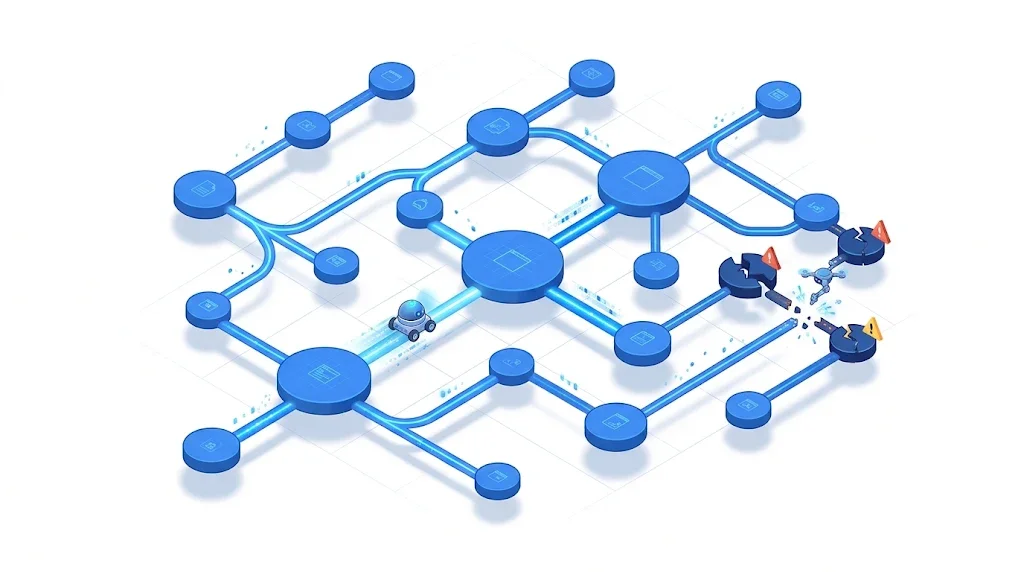
Berikut daftar lengkap yang akan Anda temui di Search Console dan di crawler, dengan penyebab dan perbaikan masing-masing. Nama-namanya mengikuti dokumentasi laporan Pengindeksan halaman Google (Bantuan Search Console).
Google tidak bisa mengubah nama domain Anda menjadi alamat IP, atau server DNS tidak menjawab. Penyebab umum: domain kedaluwarsa, gangguan penyedia DNS, record yang salah setelah migrasi, atau konfigurasi DNSSEC yang keliru. Periksa dengan kueri dari luar jaringan Anda:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
Perbaikan: koreksi record, turunkan TTL sebelum setiap migrasi, dan gunakan penyedia DNS dengan redundansi. Jika example.com dan www.example.com sama-sama ada, keduanya harus bisa di-resolve, walaupun salah satunya hanya mengalihkan.
Server tidak menjawab tepat waktu, menutup koneksi, atau menjawab dengan 500, 502, 503, atau 504. Penyebab umum: database kelebihan beban, proses PHP atau Node yang mogok saat beban tinggi, timeout reverse proxy, pembaruan plugin, atau firewall yang membatasi bot. Lihat pola waktunya: error pada jam yang sama setiap malam sering menunjuk ke backup atau cron job.
Perbaikan: baca log error server pada waktu yang dilaporkan Google, naikkan timeout atau jumlah worker, cache halaman berat, dan pastikan perlindungan bot Anda meloloskan Googlebot yang terverifikasi. Untuk pemeliharaan terjadwal, kembalikan 503 dengan header Retry-After alih-alih halaman 200 bertuliskan "segera kembali":
HTTP/1.1 503 Service Unavailable
Retry-After: 3600Halamannya tidak ada. Itu wajar jika dihapus dengan sengaja dan tidak ada yang menautkannya. Menjadi masalah jika URL masih punya backlink, trafik, atau tautan internal, atau jika halaman seharusnya ada dan sebuah deploy merusaknya.
Perbaikan: jika konten pindah, tambahkan satu 301 ke padanan terdekat. Jika hilang permanen, biarkan 404 atau gunakan 410, lalu hapus tautan internal dan entri sitemap yang mengarah ke sana. Jangan pernah mengalihkan semua 404 ke beranda: Google cenderung menganggapnya soft 404.
Server berkata 200 tetapi halaman terlihat kosong atau bertuliskan "tidak ditemukan": kategori kosong, halaman pencarian tanpa hasil, produk habis tanpa konten. Google menghabiskan satu permintaan dan tidak mendapat apa pun. Kami membahasnya secara mendalam dalam panduan tentang error soft 404.
Googlebot tidak pernah mengirim kredensial, jadi 401 atau 403 di halaman publik berarti server atau lapisan keamanan Anda memblokirnya. Biang yang umum: kata sandi staging yang tertinggal di produksi, aturan WAF, blokir negara, atau perlindungan hotlink yang diterapkan ke HTML. Perbaiki aturannya, bukan gejalanya, dan uji dengan alat Inspeksi URL di Search Console.
Google melaporkan kesalahan pengalihan saat menemui putaran, rantai yang terlalu panjang, URL yang melebihi panjang maksimum, atau URL buruk atau kosong di dalam rantai. Kasus klasik setelah migrasi: http ke https, lalu ke www, lalu ke garis miring akhir, lalu ke path baru. Empat lompatan padahal cukup satu. Panduan lengkap kami tentang pengalihan SEO menjelaskan cara meringkasnya.
Tips
Tempel URL yang mencurigakan ke pemeriksa pengalihan Sorank yang gratis: alat ini mengikuti seluruh rantai, menunjukkan setiap lompatan dan kode statusnya, serta memberi tahu di mana putaran atau lompatan berlebih berada.
Sebagian error tidak pernah menampilkan kode status. Halaman mulai dimuat lalu berhenti, atau terlalu berat sehingga crawler hanya membaca sebagian. Crawler Google membaca jumlah byte terbatas per file, jadi halaman yang membengkak karena skrip inline atau gambar base64 bisa kehilangan konten di bagian bawah. Periksa template berat dengan pemeriksa ukuran halaman.
Tidak ada satu alat pun yang menampilkan semua kesalahan crawl. Setiap metode melihat masalah dari sudut berbeda, dan audit yang serius menggabungkan setidaknya dua.
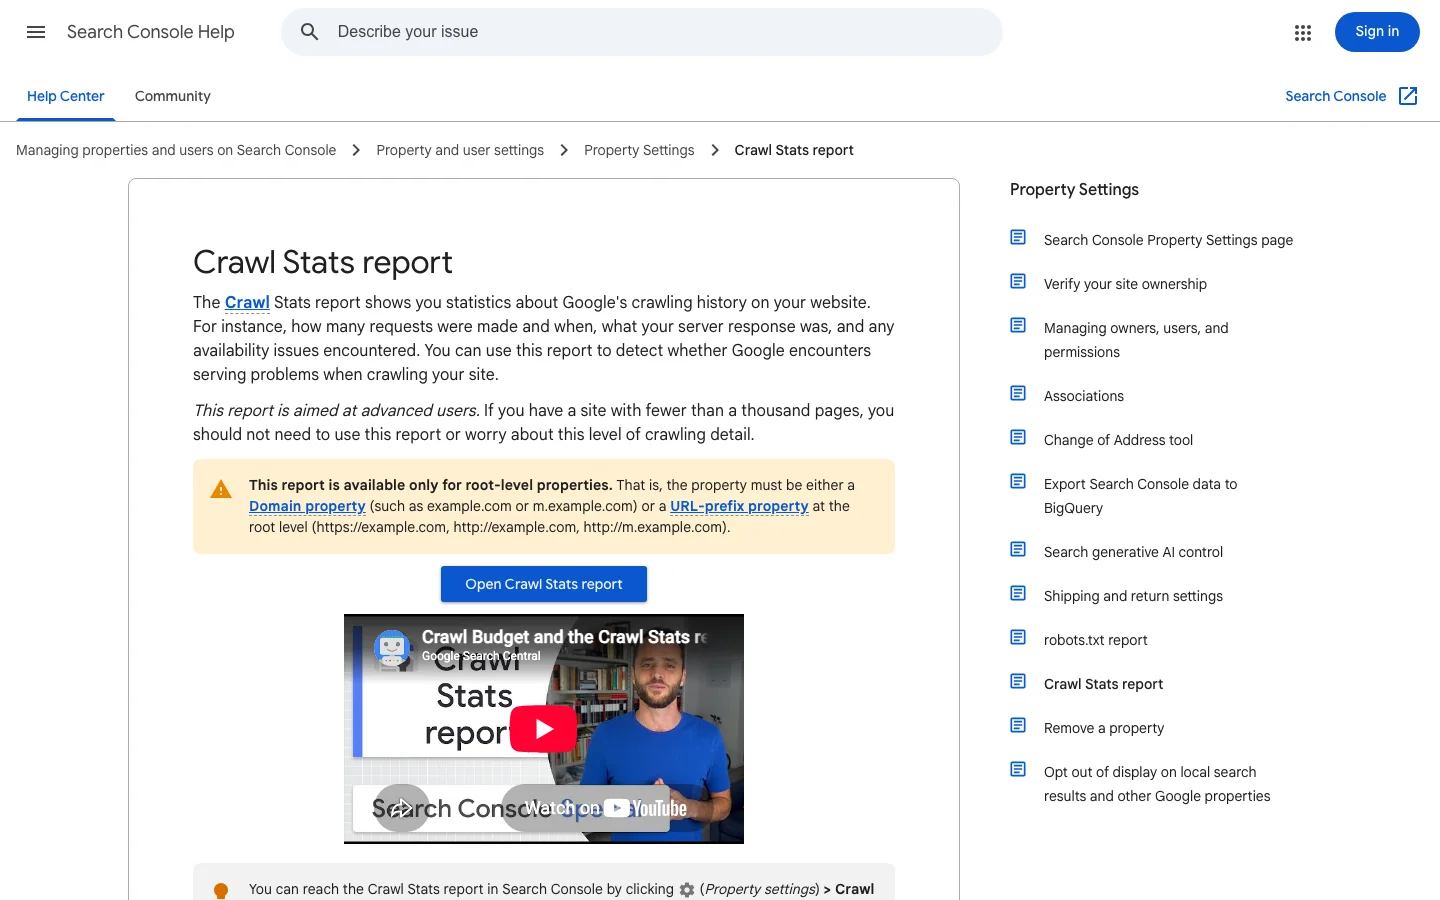
Prinsip: Google menampilkan permintaan crawl-nya sendiri selama 90 hari terakhir, dikelompokkan menurut respons, jenis file, tujuan, dan jenis Googlebot, ditambah status host untuk DNS, server, dan robots.txt. Kapan digunakan: selalu, dan pertama kali, untuk kesalahan situs. Kelebihan: ini data langsung dari Google sendiri. Batasan: hanya untuk properti tingkat root, contohnya berupa sampel, dan Google menyebut situs di bawah seribu halaman jarang membutuhkannya. Contoh: lonjakan respons "waktu tunggu halaman habis" setiap Minggu pukul 03.00 yang bertepatan dengan backup database.
Prinsip: mencantumkan URL yang diketahui Google dan alasan tidak diindeks, seperti Error server (5xx), Error pengalihan, Tidak ditemukan (404), atau Soft 404. Kapan digunakan: untuk memilah kesalahan URL dan memvalidasi perbaikan. Kelebihan: terkait dengan halaman yang benar-benar dicoba Google. Batasan: laporan terlambat beberapa hari, daftar contoh dibatasi, dan mencampur kesalahan crawl dengan pilihan pengindeksan. Contoh: 300 URL di bawah "Error pengalihan" yang semuanya berawalan /blog/ lama yang sama.
Prinsip: alat seperti Screaming Frog meng-crawl situs Anda seperti bot, mengikuti tautan dari beranda, dan mencatat setiap kode status, rantai pengalihan, dan tautan rusak. Kapan digunakan: sebelum dan sesudah migrasi, desain ulang, atau deploy besar, dan setiap bulan di situs besar. Kelebihan: langsung, lengkap untuk halaman yang ditautkan, menunjukkan di mana setiap tautan rusak berada. Batasan: tidak tahu apa yang benar-benar diminta Google, melewatkan halaman yatim, dan server Anda bisa memperlakukannya berbeda dari Googlebot. Panduan pengaturan Screaming Frog kami memandu audit lengkap.
Prinsip: log akses Anda mencatat setiap permintaan, termasuk dari Googlebot, Bingbot, GPTBot, ClaudeBot, dan PerplexityBot, dengan kode status dan waktu respons yang tepat. Kapan digunakan: di situs besar, setelah penurunan trafik yang tidak jelas, dan untuk melihat apa yang dikunjungi crawler AI. Kelebihan: permintaan nyata, kode nyata, tanpa sampel, semua bot. Batasan: butuh akses ke log dan sedikit skrip; Anda harus memverifikasi bahwa "Googlebot" benar-benar Google. Panduan kami tentang analisis file log untuk SEO berjalan langkah demi langkah. Sekilas pandang pertama:
# Permintaan Googlebot yang tidak mengembalikan 200, 301, atau 304, yang paling sering lebih dulu
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50Prinsip: uji satu URL per kali dengan curl atau pemeriksa online gratis. Kapan digunakan: untuk memastikan perbaikan, atau memeriksa halaman penting setelah deploy. Kelebihan: instan dan presisi. Batasan: tidak bisa diskalakan. Gunakan user agent Googlebot untuk menangkap aturan yang memperlakukan bot secara berbeda:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| Metode | Melihat kesalahan situs | Melihat kesalahan URL | Data Googlebot nyata | Melihat crawler AI | Paling cocok untuk |
|---|---|---|---|---|---|
| Laporan Statistik Crawling | Ya | Sampel | Ya | Tidak | Kesehatan host |
| Laporan Pengindeksan halaman | Sebagian | Ya | Ya | Tidak | Pemilahan dan validasi |
| Crawler (Screaming Frog...) | Tidak | Ya, halaman yang ditautkan | Tidak | Tidak | Menemukan tautan rusak di sumbernya |
| Log server | Sebagian | Ya | Ya | Ya | Situs besar, akar masalah |
| Pemeriksaan URL tunggal | Tidak | Satu per satu | Tidak | Tidak | Memastikan perbaikan |
Status 5xx berarti server tidak dapat menangani permintaan yang sebenarnya valid. Google memperlambat crawling sebagai respons, dan memperlambatnya lebih jauh ketika makin banyak URL Anda mengembalikan error. Google menyimpan URL yang sudah terindeks untuk sementara, tetapi menghapus URL yang terus-menerus mengembalikan error server. Lonjakan error yang singkat masih bisa dipulihkan, karena Google perlahan menaikkan laju crawling lagi begitu server Anda merespons dengan kode 2xx. Yang merusak indeks Anda adalah rangkaian error yang panjang.
Setiap kode 5xx mengarah ke bagian berbeda dari tumpukan teknologi Anda. Tabel berikut memberi tahu tempat pertama untuk diperiksa pada masing-masing kode.
| Kode | Biasanya berarti | Periksa lebih dulu |
|---|---|---|
| 500 | Aplikasi gagal saat memproses permintaan | Log error aplikasi tepat pada waktu permintaan |
| 502 | Proxy atau CDN menerima jawaban tidak valid dari aplikasi, sering kali karena aplikasi crash atau restart | Restart dan uptime proses aplikasi |
| 503 | Layanan kelebihan beban, dibatasi laju, atau sedang dalam pemeliharaan | Grafik beban, riwayat deploy, dan jendela pemeliharaan |
| 504 | Proxy berhenti menunggu aplikasi | Kueri database yang lambat dan pengaturan timeout proxy |
| 429 | Pembatas laju menyatakan permintaan terlalu banyak | Aturan batas laju, dan apakah aturan itu berlaku untuk Googlebot yang terverifikasi |
Crawl Stats menampilkan hari dan jam ketika Google menemui error (panduan Crawl Stats kami menjelaskan setiap grafik). Log server Anda menunjukkan apa yang terjadi pada momen persis itu. Saring permintaan Googlebot dan hitung respons 5xx per jam:
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
Setiap baris keluaran adalah satu jam, satu kode status, dan satu jumlah. Kumpulan error di jam yang sama setiap malam biasanya mengarah ke backup, cron job, atau impor terjadwal. Error yang tersebar sepanjang hari biasanya mengarah ke beban, jadi solusinya adalah kapasitas atau caching, bukan satu bug. Untuk metode yang lebih dalam, lihat panduan analisis log file kami.
Google mengurangi crawling sebanding dengan jumlah URL yang mengembalikan error. Templat rusak yang memengaruhi beberapa URL hanya memakan sedikit waktu crawling. Gangguan database yang merusak setiap halaman memakan banyak waktu, dan itulah yang harus diperbaiki lebih dulu.
429 memberi dampak yang sama dengan 5xx, karena Google membacanya sebagai server yang kelebihan beban. Jika pembatas laju atau proteksi bot Anda mengembalikan 429 ke Googlebot, Anda membayarnya dengan waktu crawling. Dokumentasi Google tidak menyebut header Retry-After. Tetap kirimkan header itu ke pengunjung manusia dan klien API, tetapi jangan berharap Googlebot menunggu selama waktu yang Anda tetapkan.
Status 4xx berarti server menolak permintaan karena sesuatu di sisi klien: URL tidak ada, akses dilarang, atau alamatnya salah format. Google memperlakukan semua 4xx kecuali 429 dengan cara yang sama. Google berhenti memakai konten di balik URL tersebut dan mengeluarkan URL dari indeks jika sebelumnya sudah terindeks. Sebelum menyentuh 4xx, cari tahu dari mana permintaannya berasal, karena perbaikannya sering ada di satu tempat: tautan, templat, atau aturan redirect.
Log akses mencatat referrer setiap permintaan, yang memberi tahu halaman mana yang mengirim pengunjung atau bot ke URL itu. Hitung respons 4xx menurut path dan menurut referrer:
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
Baca kolom referrer dengan cara berikut:
Rilis yang mengganti nama rute, mengubah slug, atau membangun ulang templat sering memunculkan gelombang 404 di hari yang sama. Ekspor jumlah respons 4xx per hari untuk seminggu sebelum deploy dan seminggu sesudahnya. Lonjakan yang terkonsentrasi di satu folder langsung menunjuk ke perubahan tersebut. Tambahkan redirect dari URL lama ke URL baru di rilis yang sama, bukan di tiket berikutnya. Untuk pemindahan penuh, lihat daftar periksa migrasi SEO kami.
Tips
Jangan mengganti halaman yang hilang dengan respons 200 yang menampilkan pesan singkat atau daftar kosong. Google dapat menganggapnya sebagai soft 404, yang memakan pengambilan penuh dan tidak memberi imbalan apa pun.
Inilah metode yang kami gunakan. Dimulai dari error yang bisa menghentikan seluruh situs hingga yang hanya membuang sedikit crawl.
Metode 6 langkah untuk kesalahan crawl
Di Search Console, buka Setelan, lalu Statistik crawling, lalu Status host. Hijau berarti tidak ada masalah berarti dalam 90 hari. "Masalah terbaru" berarti ada masalah serius dalam seminggu terakhir: tinggalkan yang lain. Klik setiap kategori untuk melihat tingkat kegagalan per hari, lalu cocokkan hari buruk dengan riwayat hosting, CDN, dan deploy Anda.
Buka Pengindeksan, lalu Halaman, dan ekspor setiap alasan error. Jangan perbaiki URL satu per satu. Masukkan ke spreadsheet dan ambil folder pertamanya:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")Tabel pivot pada kolom itu biasanya menunjukkan bahwa sebagian besar error berasal dari dua atau tiga template: kategori blog yang sudah dihentikan, parameter filter, feed produk lama.
Untuk setiap pola, ajukan empat pertanyaan. Apakah mendapat klik organik? Apakah punya backlink? Apakah ditautkan secara internal? Apakah ada di sitemap? 404 tanpa satu pun dari keempatnya bisa menunggu selamanya. 404 dengan backlink butuh 301 hari ini. Pemeriksa tautan rusak gratis menunjukkan halaman Anda mana yang masih menautkan ke URL mati.
Perbaiki aturan, bukan URL. Peta pengalihan di konfigurasi server lebih baik daripada 400 pengalihan yang ditambahkan manual di plugin. Contohnya di nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Untuk 5xx, perbaiki kapasitas atau bug-nya. Untuk 401 dan 403, perbaiki aturan keamanannya. Untuk soft 404, tambahkan konten nyata atau kembalikan 404 yang sebenarnya.
Setiap tautan internal sebaiknya mengarah langsung ke URL yang mengembalikan 200. Setiap entri sitemap sebaiknya URL kanonis, dapat diindeks, dan mengembalikan 200. Sitemap penuh pengalihan dan 404 mengajari Google untuk kurang memercayainya. Panduan kami tentang cara membuat sitemap menjelaskan apa yang seharusnya ada di dalamnya.
Di laporan Pengindeksan halaman, buka alasan yang sudah diperbaiki dan klik Validasi perbaikan. Google memeriksa sampel dulu, lalu sisanya; biasanya memakan waktu hingga sekitar dua minggu, dan berhenti jika satu URL saja masih gagal. Jangan klik lagi selama prosesnya berjalan. Lalu tetapkan rutinitas mingguan: Statistik Crawling untuk host, log untuk lonjakan, crawl setelah setiap deploy.
Rantai pengalihan sebelum dan sesudah perbaikan
Apa itu: plugin atau aturan yang mengirim setiap URL yang hilang ke /. Cara mendeteksi: banyak URL di "Soft 404" atau "Halaman dengan pengalihan" yang semuanya mendarat di beranda; crawler menampilkan ratusan 301 dengan target yang sama. Cara memperbaiki: alihkan hanya ke padanan yang dekat, dan biarkan sisanya mengembalikan 404 atau 410.
Apa itu: WAF, bot manager, atau rate limiter yang menyajikan 403, 429, atau halaman tantangan ke Google. Cara mendeteksi: 403 atau 429 di Statistik Crawling, sementara halaman terbuka normal di browser Anda; log menunjukkan blokir per IP. Cara memperbaiki: izinkan Googlebot terverifikasi melalui reverse DNS atau rentang IP yang dipublikasikan Google, alih-alih memercayai string user agent.
Apa itu: robots.txt yang dibuat oleh aplikasi, sehingga gagal setiap kali aplikasi gagal, atau disajikan melalui aturan CDN yang meng-cache 5xx. Cara mendeteksi: kategori pengambilan robots.txt di Status host tidak hijau. Cara memperbaiki: sajikan sebagai file statis, di luar aplikasi, dan uji dengan pemeriksa robots.txt.
Apa itu: halaman "Kami akan segera kembali" yang disajikan dengan status 200 di setiap URL. Cara mendeteksi: setelah pemeliharaan, muncul gelombang soft 404 atau judul duplikat. Cara memperbaiki: kembalikan 503 dengan Retry-After selama pemeliharaan, dan buat singkat.
Apa itu: menjawab 403 ke Googlebot saat server kelebihan beban. Cara mendeteksi: lonjakan 403 yang bertepatan dengan lonjakan beban. Cara memperbaiki: Google menyatakan kode 4xx selain 429 tidak berpengaruh pada laju crawl. Kembalikan 503 atau 429 untuk waktu singkat, dan perbaiki kapasitasnya.
Apa itu: menelusuri daftar Search Console dan mengedit setiap URL. Cara mendeteksi: alasan yang sama muncul lagi setiap bulan. Cara memperbaiki: kelompokkan menurut pola, perbaiki template atau aturannya, lalu validasi sekali.
Apa itu: menghabiskan berhari-hari untuk 404 dari URL spam atau halaman yang lama dihapus tanpa tautan. Cara mendeteksi: URL-nya tidak punya klik, backlink, maupun tautan internal. Cara memperbaiki: biarkan saja. Google menyatakan 404 untuk halaman yang dihapus belum tentu masalah.
Peringatan
Jangan pernah memblokir URL di robots.txt untuk "menyembunyikan" kesalahan crawl. Google tidak lagi bisa melihat 404 atau pengalihannya, URL bisa tetap terindeks, dan Anda kehilangan sinyal yang ingin Anda kirim.
Di situs dengan beberapa ratus halaman, Google punya waktu untuk semuanya, dan kesalahan crawl terutama penting bagi halaman yang dirusaknya. Di situs besar (toko dengan filter, marketplace, situs berita), setiap permintaan yang gagal atau terbuang mengambil waktu dari halaman Anda yang sebenarnya. Itulah gagasan di balik crawl budget.
5xx dan 429 membuat Google melambat di seluruh host, jadi beberapa template rusak bisa menunda crawl halaman produk baru Anda. Rantai pengalihan memakan satu permintaan per lompatan. Soft 404 memakan satu pengambilan penuh dan tidak memberi apa pun. Perbaiki ketiganya dan budget yang sama mencakup lebih banyak halaman berguna.
Ketika Google menemukan URL tetapi menunda crawl-nya, penyebabnya sering server yang dianggapnya rapuh. Jika Anda melihat jumlah "Ditemukan, saat ini tidak diindeks" yang terus naik bersamaan dengan error server di Statistik Crawling, perbaiki server terlebih dahulu. Kedua laporan menceritakan kisah yang sama.
Googlebot bukan lagi satu-satunya pengunjung yang penting. GPTBot, OAI-SearchBot, ClaudeBot, dan PerplexityBot mengambil halaman untuk melatih model atau menjawab pertanyaan secara real time. Mereka mengakses server yang sama dan mengalami error yang sama, dengan satu perbedaan: tidak ada Search Console untuk mereka.
Sebagian besar crawler AI tidak menjalankan JavaScript, jadi halaman yang hanya membangun kontennya di browser bisa terlihat kosong bagi mereka, semacam soft 404 yang tidak akan pernah Anda lihat di laporan Google. Banyak yang diblokir secara default oleh layanan perlindungan bot, sering dengan 403. Dan karena mereka mengambil halaman sesuai permintaan saat pengguna bertanya, timeout pada saat itu berarti jawabannya mengutip pihak lain. Panduan kami tentang SEO JavaScript membahas rendering untuk mesin pencari maupun crawler AI.
Log server Anda adalah satu-satunya sumber yang andal. Filter menurut user agent dan lihat kode statusnya:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnJika bot AI mendapat 403 yang tidak Anda inginkan, perbaiki aturannya. Lalu periksa apakah mereka benar-benar mengutip Anda: pelacakan sebutan di AI dari Sorank memantau seberapa sering ChatGPT, Gemini, Claude, dan Perplexity menyebut merek Anda, sehingga Anda bisa melihat apakah perbaikan crawl mengubah sesuatu.
Jalankan daftar ini setelah setiap migrasi, desain ulang, atau deploy besar, dan sebulan sekali di situs besar.
Daftar periksa kesehatan crawl
Buka Statistik Crawling dan periksa tiga baris status host. Lalu jalankan pemeriksa kemampuan indeks gratis pada lima halaman paling berharga Anda. Jika keduanya bersih, ekspor error Pengindeksan halaman dan kelompokkan menurut folder: sekarang Anda punya daftar perbaikan yang pendek dan berurutan, bukan laporan yang menakutkan.
Setelah crawl bersih, batas berikutnya adalah kontennya sendiri. Optimasi konten dari Sorank menulis ulang dan memperbarui halaman Anda yang ada secara autopilot, sehingga halaman yang kini bisa dijangkau Google layak diindeks dan dikutip. Untuk halaman yang di-crawl Google tetapi ditinggalkan, baca panduan kami tentang "Di-crawl, saat ini tidak diindeks".
Kesalahan crawl adalah permintaan mesin pencari atau crawler AI yang gagal: DNS tidak bisa di-resolve, server kehabisan waktu atau mengembalikan 5xx, robots.txt tidak bisa diambil, pengalihan berputar, atau halaman mengembalikan kode 4xx. Kesalahan tingkat situs bisa menghentikan crawl seluruh situs, sedangkan kesalahan URL hanya memengaruhi halaman terkait.
Tidak dengan sendirinya. Google menyatakan 404 untuk halaman yang dihapus tanpa pengganti belum tentu masalah. Menjadi masalah jika URL masih punya backlink, trafik, atau tautan internal; dalam hal itu, satu pengalihan 301 ke padanan terdekat adalah perbaikan yang tepat.
Setelah Anda mengklik Validasi perbaikan di laporan Pengindeksan halaman Search Console, validasi biasanya memakan waktu hingga sekitar dua minggu. Google memeriksa sampel URL lebih dulu, lalu sisanya, dan berhenti jika satu URL yang terdampak masih gagal.
Kami menganalisis pesaing, website, dan visibilitas AI Anda untuk membuat rencana konten yang disesuaikan secara gratis.
 Generator Brief Konten AI
 Generator FAQ Schema
 Generator Ide Artikel Blog AI
 Validator Data Terstruktur (Validator Schema)
 Pemeriksa Teks Alt
 Penganalisis Tautan Internal
 Tantangan Backlink
 Generator Meta Description AI
 Generator Judul Blog AI
 Pemeriksa Indexability Google
 Generator Kerangka Blog AI
 Pembuat Tautan UTM
 Alat Pengelompokan Kata Kunci
 Pemeriksa Tag Canonical
 Generator Sitemap XML
 Pemeriksa Tautan Rusak
 Generator Judul SEO AI
 Penganalisis Headline
 Alat Pratinjau SERP
 Pemeriksa Pengalihan
 Generator Tag Hreflang
 Penganalisis Struktur Heading
 Pemeriksa HTTP Header
 Ekstraktor Favicon
 Kalkulator CTR SERP
 Kalkulator Penghematan SEO vs Pencarian Berbayar
 Kalkulator Share of Voice SEO
 Kalkulator ROI SEO
 Kalkulator Prakiraan Trafik dan Pendapatan SEO
 Kalkulator Anggaran SEO
 Kalkulator Titik Impas SEO
 Kalkulator ROI SEO untuk SaaS
 Kalkulator ROAS
 Kalkulator Waktu Baca
 Simulator Kenaikan Peringkat
 Kalkulator Nilai Trafik Organik
 Estimator Trafik Organik dan Pengecek Trafik Website
 Kalkulator Rasio LTV terhadap CAC
 Kalkulator ROI SEO Lokal
 Kalkulator Biaya Link Building
 Kalkulator Nilai Kata Kunci
 Kalkulator Skor Peluang Kata Kunci
 Kalkulator Kepadatan Kata Kunci
 Kalkulator ROI GEO
 Kalkulator Investasi Konten GEO
 Kalkulator ROI SEO E-commerce
 Kalkulator Nilai Seumur Hidup Pelanggan
 Kalkulator Biaya Akuisisi Pelanggan
 Kalkulator CTR
 Kalkulator Biaya per Artikel
 Kalkulator Tingkat Konversi
 Kalkulator ROI Content Marketing
 Estimator Trafik Rujukan ChatGPT
 Kalkulator Bounce Rate
 Kalkulator ROI Backlink
 Kalkulator Skor Visibilitas AI
 Kalkulator Nilai Trafik AI
 Kalkulator Pangsa Suara AI
 Kalkulator Biaya Ketidakterlihatan di AI
 Kalkulator Tingkat Sitasi AI
 Validator llms.txt
 Pengecek AI Overview dan Pengecek Peringkat AI Overviews
 Pengecek Robots.txt
 Audit SEO AI
 Pengecek Keterbacaan LLM
 Pengecek Kesiapan SearchGPT
 Audit LLM untuk Data Terstruktur
 Audit Crawlability Situs untuk AI
 Mengapa ChatGPT Tidak Merekomendasikan Situs Web Saya
 Alat Peringkat Gemini
 Pengecek Peringkat Perplexity
 Pengecek Sitasi LLM
 Audit Answer Engine Optimization
 Audit GEO
 Tes Visibilitas Pencarian AI
 Pengecek Visibilitas ChatGPT
 Generator llms.txt
 Pengekstrak URL
 Halaman Web ke Markdown
 Pemeriksa Sitemap
 Sensor Volatilitas SERP
 Pemeriksa Ukuran Halaman
 Penghitung Kata
 Generator Slug
 Generator Schema
 Generator Robots
 Pratinjau OG
 Generator Meta Tag
 Kompresor Gambar
 Generator Favicon
 Audit SEO On-Page: SEO Checker dan SEO Analyzer
 Alat Analisis Backlink
 Alat Riset Kata Kunci
 Pengecek Domain Authority
 “Saya menguji Sorank pada situs klien sungguhan dan hasilnya luar biasa. Sorank mengerjakan semua yang akan ditagihkan agensi kepada Anda sebesar $1500 per bulan. Kini Sorank mulai dipakai secara produksi untuk klien tersebut.”

 Guillaume Guersanguersanguillaume.com“Kami adalah agensi iklan dan kami ingin SEO kami kembali ke jalur yang benar untuk selamanya. Sorank memberi kami gambaran yang jelas tentang situs kami, membantu kami memprioritaskan optimasi, dan menyusun konten kami dengan benar. Alatnya mudah digunakan, dirancang dengan baik untuk tim, dan sangat praktis untuk memusatkan pemantauan tanpa harus berpindah-pindah banyak platform. Fondasi yang sangat kokoh untuk memulai SEO kami dari awal.”
 Gaspard MadouiAgensi Iklan
 “Saya hanya membiarkan software Sorank bekerja, dan kini DR saya mencapai 25 dan halaman saya berada di peringkat yang lebih tinggi.”
 Lucas Flandrefoundertrace.fr“Saya berspesialisasi di GEO berkat Sorank. Papan Peringkat GEO memungkinkan saya menunjukkan kepada klien posisi mereka dibandingkan pesaing di ChatGPT. Ini benar-benar pembeda secara komersial.”
 MélanieFreelancer SEO“Layanan yang bagus, berjalan baik untuk website kami dan membantu kami memahami cara memperbaikinya agar peringkat lebih baik di Google dan platform lain. Selamat, teruskan, saya merekomendasikannya.”
 Hugo T.Pemilik toko e-commerce