Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Rett crawlefeil: DNS, server, robots.txt, 404, soft 404 og viderekoblingsfeil. Slik reagerer Googlebot på hver feil, og en metode i 6 trinn for å rette dem.

Verktøy

Kort sagt
crawlefeil er forespørslene en søkemotor eller AI-crawler sender til nettstedet ditt, og som mislykkes: serveren svarer ikke i tide, DNS svarer ikke, robots.txt kan ikke hentes, en viderekobling går i sløyfe, eller en side returnerer en 4xx- eller 5xx-kode. Feil på nettstedsnivå (DNS, server, robots.txt) kan stoppe Googles gjennomsøking av hele nettstedet, så rett dem først; feil på URL-nivå (404, soft 404, viderekoblingsfeil) betyr bare noe når de rammer sider du vil ha indeksert. Du finner dem i Search Console-rapportene Gjennomsøkingsstatistikk og Sideindeksering, bekrefter dem med en crawler og serverloggene dine, retter årsaken og validerer.
Vil du vite mer? Spør
Rask quiz
Hvem bør fikse den tekniske siden av nettstedet ditt?
Vårt råd til deg
Sjekk selv med gratis Google-verktøy
Search Console lister opp sidene Google ikke kan lese, og PageSpeed Insights tester hastigheten. Mange små problemer fikses i innstillingene til nettstedbyggeren din.
Vårt råd til deg
En webutvikler
Problemet ditt ligger i koden eller serveren: en utvikler som kan SEO er rett person. Gi dem listen over feil fra Search Console.
Vårt råd til deg
Et verktøy for teknisk revisjon
Nettstedet ditt har mange sider: et program leser dem alle slik Google gjør, og gir en full liste over feil å fikse, side for side.
Vårt råd til deg
En automatisk revisjon, deretter innhold
Nettstedet fungerer, men gir få besøkende: tekniske problemer er sjelden årsaken. Sorank reviderer nettstedet, og skriver deretter sidene som gir trafikk.
En crawler fungerer som en svært tålmodig besøkende. Den ber serveren din om en URL, venter på svar, leser statuskoden og innholdet og går så videre til lenkene den fant. En crawlefeil er ethvert trinn i den kjeden som mislykkes. Den besøkende får aldri en brukbar side.
Definisjonen er viktig fordi mange rapporter blander crawlefeil med indekseringsbeslutninger. "Gjennomsøkt, for øyeblikket ikke indeksert" er ikke en crawlefeil: Google hentet siden uten problemer og valgte å ikke beholde den. "Ekskludert av noindex" er heller ikke en crawlefeil: du ba Google fjerne siden. En crawlefeil betyr at selve hentingen gikk galt.
Google deler problemene inn i to nivåer, og det bør du også gjøre.
Nettstedsfeil mot URL-feil
En nettbutikk med 4000 gamle produkt-URL-er som returnerer 404, kan være helt frisk hvis produktene er borte for godt. Den samme butikken med en robots.txt som returnerer 503 i seks timer, har en reell nødsituasjon, selv om alle produktsidene fungerer. Start med verten, deretter URL-ene som tjener penger, og så resten.
For å rette crawlefeil skikkelig må du vite hva Google faktisk gjør når den møter en. Googles dokumentasjon om hvordan HTTP-statuskoder og nettverksfeil påvirker Google Søk (Google Search Central) gir reglene. Her er hva de betyr i praksis.
| Svar | Hva Google gjør | Er det et problem? |
|---|---|---|
| 2xx | Sender innholdet videre til indeksering. Indeksering er ikke garantert. | Nei, med mindre siden er tom (soft 404). |
| 301, 308 | Sterkt signal om at målet er den nye URL-en. | Nei, hvis det er ett hopp til en 200. |
| 302, 303, 307 | Svakt signal: den opprinnelige URL-en har en tendens til å forbli kanonisk. | Ja, hvis flyttingen er permanent. |
| 3xx-kjeder | Følger opptil 10 hopp som standard og gir så opp. | Ja: hvert hopp sløser en forespørsel, og sløyfer blir aldri løst. |
| 404, 410, andre 4xx (unntatt 429) | Behandler innholdet som ikke-eksisterende, fjerner indekserte URL-er over tid og gjennomsøker dem sjeldnere. | Bare hvis siden burde finnes. |
| 401, 403 | Samme som andre 4xx. De bremser ikke gjennomsøkingen. | Ja, hvis de blokkerer Googlebot fra offentlige sider. |
| 429 | Behandles som et signal om overbelastet server, som en 5xx. | Ja: gjennomsøkingen bremses. |
| 5xx | Bremser gjennomsøkingen i forhold til antall feil. URL-er som fortsetter å feile, fjernes fra indeksen. | Ja, alltid. |
To detaljer lurer mange team. For det første reduserer ikke 401 og 403 gjennomsøkingsfrekvensen. Hvis serveren din sliter, hjelper det ikke å returnere 403 til Googlebot; Google ber deg i stedet midlertidig returnere 503 eller 429. For det andre er en 404 ingen straff. Det er riktig svar for en side som er borte.
Googles dokumentasjon om rapporten Gjennomsøkingsstatistikk (Search Console-hjelp) forklarer regelen. En robots.txt som svarer 200 (selv tom) eller 403, 404 eller 410 (ingen fil), er i orden. En robots.txt som svarer 429 eller 5xx, er en feil, og da spiller Google trygt.
Hva Google gjør når robots.txt fortsetter å feile
Kilde: Search Console-hjelp, rapporten Gjennomsøkingsstatistikk
En CDN-regel eller en brannmur som leverer 503 på /robots.txt, kan altså fryse hele nettstedet ditt i et halvt døgn, selv om alle andre URL-er fungerer. Sjekk denne filen først i enhver undersøkelse av crawlefeil. Guiden vår om statusen "Blokkert av robots.txt" dekker det motsatte problemet, når filen fungerer, men blokkerer for mye.
Googles gjennomsøkingsgrenser som er verdt å huske
Kilder: Google Search Central, HTTP-statuskoder og nettverksfeil; Search Console-hjelp, rapporten Gjennomsøkingsstatistikk
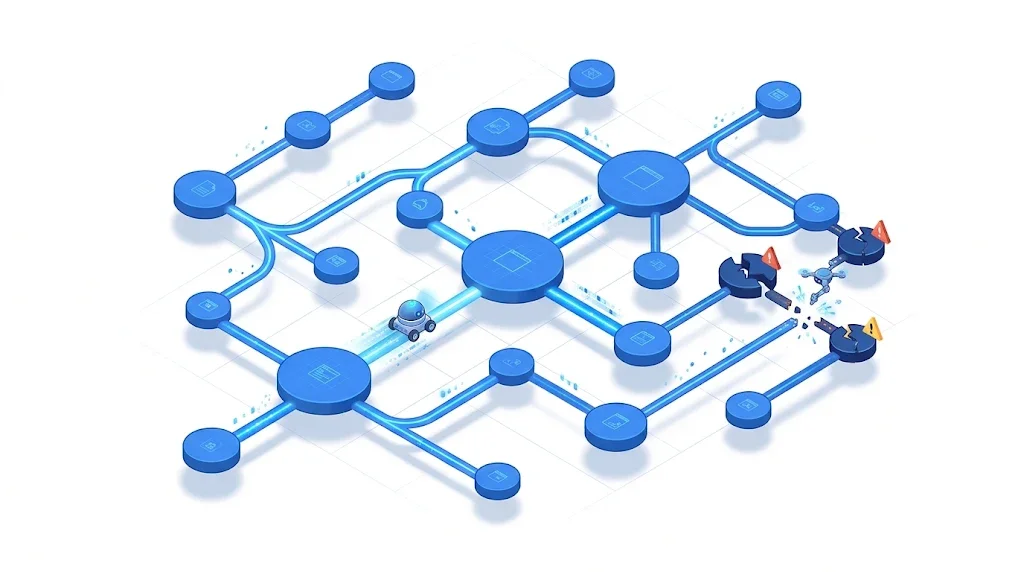
Her er hele listen du møter i Search Console og i crawlere, med årsak og løsning for hver. Navnene følger Googles dokumentasjon om rapporten Sideindeksering (Search Console-hjelp).
Google kunne ikke oversette domenenavnet ditt til en IP-adresse, eller DNS-serveren svarte ikke. Vanlige årsaker: et utløpt domene, et driftsavbrudd hos DNS-leverandøren, en feil oppføring etter en migrering eller en feilkonfigurert DNSSEC. Sjekk med et oppslag utenfor nettverket ditt:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
Løsning: rett oppføringene, senk TTL før enhver migrering, og bruk en DNS-leverandør med redundans. Hvis både example.com og www.example.com finnes, må begge kunne slås opp, selv om den ene bare viderekobler.
Serveren svarte ikke i tide, lukket tilkoblingen eller svarte med 500, 502, 503 eller 504. Typiske årsaker: en overbelastet database, en PHP- eller Node-prosess som krasjer under last, et tidsavbrudd i en omvendt proxy, en programtilleggsoppdatering eller en brannmur som begrenser roboter. Se på tidsmønsteret: feil på samme tidspunkt hver natt peker ofte mot en sikkerhetskopi eller en cron-jobb.
Løsning: les serverens feillogg på tidspunktene Google oppgir, øk tidsavbrudd eller antall arbeidsprosesser, mellomlagre tunge sider, og sørg for at robotbeskyttelsen slipper gjennom verifisert Googlebot. Ved planlagt vedlikehold returnerer du 503 med en Retry-After-header i stedet for en 200-side som sier "tilbake snart":
HTTP/1.1 503 Service Unavailable
Retry-After: 3600Siden finnes ikke. Det er i orden når den ble slettet med vilje og ingenting lenker til den. Det er et problem når URL-en fortsatt har tilbakekoblinger, trafikk eller interne lenker, eller når siden burde finnes og en utrulling ødela den.
Løsning: hvis innholdet er flyttet, legger du til én 301 til den nærmeste tilsvarende siden. Hvis det er borte for godt, beholder du 404 eller bruker 410, og fjerner de interne lenkene og sitemap-oppføringene som peker dit. Viderekoble aldri alle 404 til forsiden: Google har en tendens til å behandle dem som soft 404.
Serveren sier 200, men siden ser tom ut eller sier "ikke funnet": en tom kategori, en søkeside uten resultater, et utsolgt produkt uten innhold. Google bruker en forespørsel på den og får ingenting. Vi går i dybden på dette i guiden vår om soft 404-feil.
Googlebot sender aldri påloggingsinformasjon, så en 401 eller 403 på en offentlig side betyr at serveren din eller et sikkerhetslag blokkerer den. Vanlige syndere: et passord fra testmiljøet som er glemt i produksjon, en WAF-regel, en landsblokkering eller en hotlink-beskyttelse som brukes på HTML. Rett regelen, ikke symptomet, og test med verktøyet for URL-inspeksjon i Search Console.
Google rapporterer en viderekoblingsfeil når den møter en sløyfe, en for lang kjede, en URL som overskrider makslengden, eller en ugyldig eller tom URL i kjeden. Det klassiske tilfellet etter en migrering: http til https, så til www, så til en avsluttende skråstrek, så til en ny bane. Fire hopp der ett hadde holdt. Den komplette guiden vår om viderekoblinger for SEO forklarer hvordan du slår dem sammen.
Tips
Lim inn en mistenkelig URL i den gratis viderekoblingssjekken fra Sorank: den følger hele kjeden, viser hvert hopp og statuskoden og forteller deg hvor sløyfen eller det ekstra hoppet er.
Noen feil viser aldri en statuskode. Siden begynner å laste og stopper, eller den er så tung at crawleren bare leser en del av den. Googles crawlere leser et begrenset antall byte per fil, så en side som er oppblåst av innebygde skript eller base64-bilder, kan miste innholdet nederst. Sjekk tunge maler med verktøyet for sidestørrelse.
Ikke noe enkelt verktøy viser alle crawlefeil. Hver metode ser problemet fra en annen vinkel, og en seriøs revisjon kombinerer minst to.
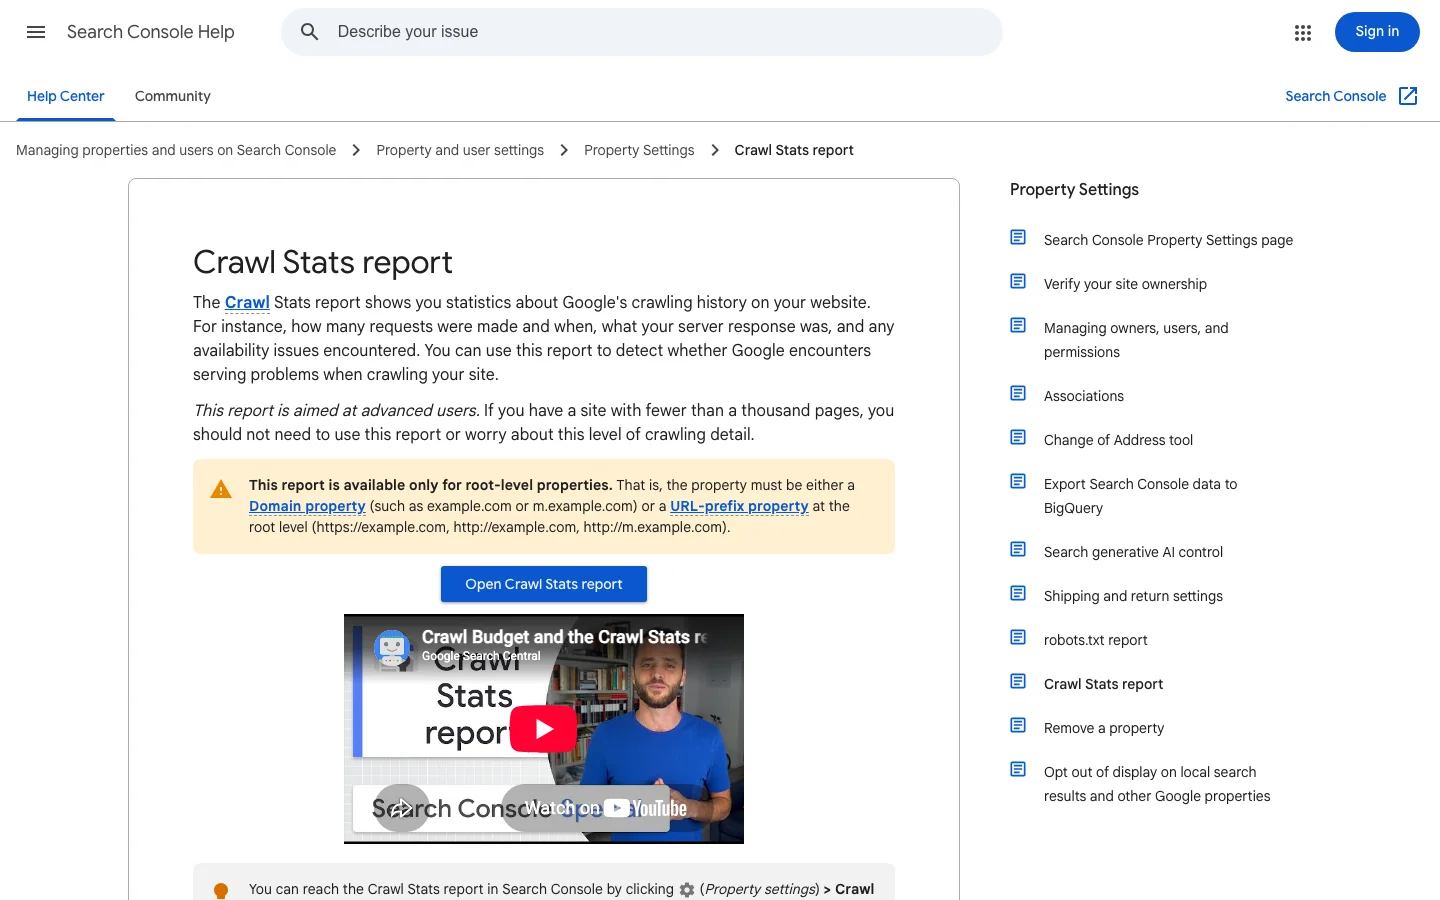
Prinsipp: Google viser sine egne gjennomsøkingsforespørsler fra de siste 90 dagene, gruppert etter svar, filtype, formål og type Googlebot, pluss vertsstatus for DNS, server og robots.txt. Når den brukes: alltid, og først, for nettstedsfeil. Fordeler: det er sannheten direkte fra Google. Begrensninger: bare for eiendommer på rotnivå, eksempler i utvalg, og Google sier at nettsteder under tusen sider sjelden trenger den. Eksempel: en topp av svar med "tidsavbrudd for side" hver søndag kl. 3 som faller sammen med en databasesikkerhetskopi.
Prinsipp: viser URL-ene Google kjenner til og hvorfor de ikke er indeksert, med årsaker som Serverfeil (5xx), Viderekoblingsfeil, Ikke funnet (404) eller Soft 404. Når den brukes: til å sortere URL-feil og validere rettelser. Fordeler: knyttet til sidene Google faktisk prøvde. Begrensninger: rapportene er flere dager forsinket, eksempellistene er begrenset, og den blander crawlefeil med indekseringsvalg. Eksempel: 300 URL-er under "Viderekoblingsfeil" som alle deler det samme gamle prefikset /blog/.
Prinsipp: et verktøy som Screaming Frog gjennomsøker nettstedet ditt slik en robot ville gjort, følger lenker fra forsiden og logger hver statuskode, viderekoblingskjede og ødelagt lenke. Når den brukes: før og etter en migrering, et redesign eller en stor utrulling, og hver måned på store nettsteder. Fordeler: umiddelbar, komplett for lenkede sider, viser hvor hver ødelagt lenke sitter. Begrensninger: den vet ikke hva Google faktisk ba om, overser foreldreløse sider, og serveren din kan behandle den annerledes enn Googlebot. Guiden vår til oppsett av Screaming Frog går gjennom en komplett revisjon.
Prinsipp: tilgangsloggene dine registrerer hver forespørsel, også dem fra Googlebot, Bingbot, GPTBot, ClaudeBot og PerplexityBot, med nøyaktig statuskode og svartid. Når den brukes: på store nettsteder, etter uforklarlige trafikkfall og for å se hva AI-crawlere besøker. Fordeler: ekte forespørsler, ekte koder, ikke noe utvalg, alle roboter. Begrensninger: krever tilgang til loggene og litt skripting; du må verifisere at "Googlebot" virkelig er Google. Guiden vår om logganalyse for SEO går trinn for trinn. En rask første titt:
# Googlebot-forespørsler som ikke returnerte 200, 301 eller 304, hyppigste først
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50Prinsipp: test én URL om gangen med curl eller en gratis nettbasert sjekk. Når den brukes: for å bekrefte en rettelse eller sjekke en viktig side etter en utrulling. Fordeler: umiddelbar og presis. Begrensninger: skalerer ikke. Bruk en Googlebot-brukeragent for å fange regler som behandler roboter annerledes:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| Metode | Ser nettstedsfeil | Ser URL-feil | Ekte Googlebot-data | Ser AI-crawlere | Best til |
|---|---|---|---|---|---|
| Gjennomsøkingsstatistikk | Ja | I utvalg | Ja | Nei | Vertens helse |
| Sideindeksering | Delvis | Ja | Ja | Nei | Sortering og validering |
| Crawler (Screaming Frog...) | Nei | Ja, lenkede sider | Nei | Nei | Finne ødelagte lenker ved kilden |
| Serverlogger | Delvis | Ja | Ja | Ja | Store nettsteder, grunnårsaker |
| Sjekk av enkelt-URL | Nei | Én om gangen | Nei | Nei | Bekrefte rettelser |
En 5xx-status betyr at serveren ikke kunne håndtere en forespørsel som så gyldig ut. Google bremser gjennomsøkingen som svar, og bremser mer når flere av URL-ene dine returnerer feil. Google beholder allerede indekserte URL-er en stund, men fjerner URL-er som vedvarende returnerer en serverfeil. Et kort utbrudd er mulig å komme seg etter, fordi Google gradvis øker gjennomsøkingen igjen når serveren svarer med 2xx-koder. En lang rekke feil er det som skader indeksen.
Hver 5xx-kode peker på en annen del av stacken. Tabellen gir deg et første sted å se etter for hver av dem.
| Kode | Hva det vanligvis betyr | Se på først |
|---|---|---|
| 500 | Applikasjonen feilet mens den behandlet forespørselen | Applikasjonens feillogg på nøyaktig tidspunkt for forespørselen |
| 502 | Proxyen eller CDN-en fikk et ugyldig svar fra applikasjonen, ofte fordi den krasjet eller startet på nytt | Omstarter og oppetid for applikasjonsprosessen |
| 503 | Tjenesten er overbelastet, hastighetsbegrenset eller under vedlikehold | Belastningsgrafer, utrullingshistorikk og vedlikeholdsvinduer |
| 504 | Proxyen ga opp å vente på applikasjonen | Trege databasespørringer og tidsavbruddsinnstillinger i proxyen |
| 429 | En hastighetsbegrenser sier at det er for mange forespørsler | Regler for hastighetsbegrensning, og om de gjelder verifisert Googlebot |
Gjennomsøkingsstatistikk viser dagene og timene da Google møtte feil (vår guide til gjennomsøkingsstatistikk forklarer hver graf). Serverloggen din viser hva som skjedde i nettopp de øyeblikkene. Filtrer forespørslene fra Googlebot og tell 5xx-svarene per time:
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
Hver linje i utdataene er en time, en statuskode og et antall. En klynge i samme time hver natt peker vanligvis på en sikkerhetskopi, en cron-jobb eller en planlagt import. Feil som spres utover hele dagen peker vanligvis på belastning, så løsningen er kapasitet eller hurtigbufring snarere enn én enkelt feil. For en dypere metode, se vår guide til loggfilanalyse for SEO.
Google reduserer gjennomsøkingen i forhold til antall URL-er som returnerer feil. En ødelagt mal som rammer noen få URL-er koster lite gjennomsøkingstid. Et databasenedbrudd som ødelegger alle sider koster mye, og det er det du skal rette først.
En 429 har samme effekt som en 5xx, fordi Google leser den som en overbelastet server. Hvis hastighetsbegrenseren eller botbeskyttelsen din returnerer 429 til Googlebot, betaler du for det i gjennomsøkingstid. Googles dokumentasjon nevner ikke Retry-After-headeren. Fortsett å sende den til menneskelige besøkende og API-klienter, men regn ikke med at Googlebot venter den tiden du har satt.
En 4xx-status betyr at serveren avviste forespørselen på grunn av noe på klientsiden: URL-en finnes ikke, tilgang er forbudt, eller adressen er feil utformet. Google behandler alle 4xx-koder unntatt 429 på samme måte. Google slutter å bruke innholdet bak URL-en og fjerner URL-en fra indeksen hvis den var indeksert. Før du rører en 4xx, finn ut hvor forespørselen kommer fra, fordi rettelsen ofte ligger på ett sted: en lenke, en mal eller en omdirigeringsregel.
Tilgangsloggen din registrerer henvisningen for hver forespørsel, og den forteller hvilken side som sendte besøkeren eller boten til URL-en. Tell 4xx-svarene etter sti og etter henvisning:
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
Les henvisningskolonnen slik:
En utgivelse som gir en rute nytt navn, endrer en slug eller bygger om en mal, gir ofte en bølge av 404-feil samme dag. Eksporter antall 4xx-svar per dag for uken før utrullingen og uken etter. En økning som samler seg i én mappe peker rett på endringen. Legg til omdirigeringen fra den gamle URL-en til den nye i samme utgivelse, ikke i en senere oppgave. For en full flytting, se vår sjekkliste for SEO-migrering.
Tips
Erstatt ikke en manglende side med et 200-svar som viser en kort melding eller en tom liste. Google kan behandle den som en soft 404, noe som koster en full henting og ikke gir noe tilbake.
Dette er metoden vi bruker. Den går fra feilene som kan stoppe hele nettstedet, til dem som bare sløser litt gjennomsøking.
Metoden i 6 trinn for crawlefeil
I Search Console åpner du Innstillinger, deretter Gjennomsøkingsstatistikk og så Vertsstatus. Grønt betyr ingen vesentlige problemer på 90 dager. "Nylig problem" betyr et vesentlig problem den siste uken: legg alt annet til side. Klikk på hver kategori for å se feilraten per dag, og sammenlign så de dårlige dagene med historikken for hosting, CDN og utrullinger.
Åpne Indeksering, deretter Sider, og eksporter hver feilårsak. Ikke rett URL-er én og én. Legg dem i et regneark og trekk ut den første mappen:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")En pivottabell på den kolonnen viser som regel at de fleste feilene kommer fra to eller tre maler: en nedlagt bloggkategori, en filterparameter, en gammel produktfeed.
Still fire spørsmål for hvert mønster. Får den organiske klikk? Har den tilbakekoblinger? Lenkes den internt? Står den i sitemap? En 404 uten noen av de fire kan vente for alltid. En 404 med tilbakekoblinger trenger en 301 i dag. Den gratis sjekken for ødelagte lenker viser hvilke av dine egne sider som fortsatt lenker til døde URL-er.
Rett regler, ikke URL-er. Et viderekoblingskart i serverkonfigurasjonen slår 400 viderekoblinger lagt inn for hånd i et programtillegg. For eksempel i nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
For 5xx retter du kapasiteten eller feilen. For 401 og 403 retter du sikkerhetsregelen. For soft 404 legger du enten til ekte innhold eller returnerer en ekte 404.
Hver interne lenke bør peke direkte på en URL som returnerer 200. Hver oppføring i sitemap bør være en kanonisk, indekserbar 200-URL. Et sitemap fullt av viderekoblinger og 404 lærer Google å stole mindre på det. Guiden vår om hvordan du lager et sitemap forklarer hva som hører hjemme der.
I rapporten Sideindeksering åpner du den rettede årsaken og klikker på Valider rettelsen. Google sjekker først et utvalg og deretter resten; det tar vanligvis opptil rundt to uker, og valideringen stopper hvis bare én URL fortsatt feiler. Ikke klikk på nytt mens den pågår. Innfør deretter en ukentlig rutine: Gjennomsøkingsstatistikk for verten, logger for topper, en gjennomsøking etter hver utrulling.
En viderekoblingskjede før og etter rettelsen
Hva det er: et programtillegg eller en regel som sender enhver manglende URL til /. Slik oppdager du det: mange URL-er under "Soft 404" eller "Side med viderekobling" som alle havner på forsiden; en crawler viser hundrevis av 301 med samme mål. Slik retter du det: viderekoble bare til en nær tilsvarende side, og la resten returnere 404 eller 410.
Hva det er: en WAF, robotbehandler eller hastighetsbegrenser som leverer 403, 429 eller en utfordringsside til Google. Slik oppdager du det: 403 eller 429 i Gjennomsøkingsstatistikk, mens siden lastes fint i nettleseren din; loggene viser blokkeringene per IP. Slik retter du det: tillat verifisert Googlebot via omvendt DNS eller Googles publiserte IP-områder i stedet for å stole på brukeragent-strengen.
Hva det er: robots.txt genereres av applikasjonen, så den feiler hver gang applikasjonen feiler, eller leveres via en CDN-regel som mellomlagrer en 5xx. Slik oppdager du det: kategorien for henting av robots.txt i Vertsstatus er ikke grønn. Slik retter du det: lever den som en statisk fil utenfor applikasjonen, og test den med robots.txt-sjekken.
Hva det er: en side med "Vi er snart tilbake" som leveres med status 200 på alle URL-er. Slik oppdager du det: etter vedlikeholdet en bølge av soft 404 eller dupliserte titler. Slik retter du det: returner 503 med Retry-After under vedlikeholdet, og hold det kort.
Hva det er: svare 403 til Googlebot når serveren er overbelastet. Slik oppdager du det: topper av 403 som faller sammen med lasttopper. Slik retter du det: Google sier at andre 4xx-koder enn 429 ikke påvirker gjennomsøkingsfrekvensen. Returner 503 eller 429 en kort stund, og rett kapasiteten.
Hva det er: klikke seg gjennom listen i Search Console og redigere hver URL. Slik oppdager du det: den samme årsaken kommer tilbake hver måned. Slik retter du det: grupper etter mønster, rett malen eller regelen, og valider så én gang.
Hva det er: bruke dager på 404 for søppel-URL-er eller sider som ble slettet for lenge siden og ikke har lenker. Slik oppdager du det: URL-ene har ingen klikk, ingen tilbakekoblinger og ingen interne lenker. Slik retter du det: la dem være. Google sier at en 404 for en fjernet side ikke nødvendigvis er et problem.
Advarsel
Blokker aldri en URL i robots.txt for å "skjule" en crawlefeil. Google kan ikke lenger se 404-en eller viderekoblingen, URL-en kan forbli indeksert, og du mister signalet du prøvde å sende.
På et nettsted med noen hundre sider har Google tid til alt, og crawlefeil betyr mest for sidene de ødelegger. På store nettsteder (nettbutikker med filtre, markedsplasser, nyhetssider) tar hver mislykket eller bortkastet forespørsel tid fra de ekte sidene dine. Det er ideen bak gjennomsøkingsbudsjett.
5xx og 429 får Google til å senke farten på hele verten, så noen få ødelagte maler kan forsinke gjennomsøkingen av de nye produktsidene dine. Viderekoblingskjeder koster én forespørsel per hopp. Soft 404 koster en hel henting og gir ingenting tilbake. Rett de tre, så rekker det samme budsjettet til flere nyttige sider.
Når Google finner URL-er, men utsetter gjennomsøkingen, er årsaken ofte en server Google anser som skjør. Hvis du ser et økende antall "Oppdaget, for øyeblikket ikke indeksert" sammen med serverfeil i Gjennomsøkingsstatistikk, retter du serveren først. De to rapportene forteller den samme historien.
Googlebot er ikke lenger den eneste besøkende som betyr noe. GPTBot, OAI-SearchBot, ClaudeBot og PerplexityBot henter sider for å trene modeller eller svare på spørsmål i sanntid. De treffer den samme serveren og lider av de samme feilene, med én forskjell: du har ingen Search Console for dem.
De fleste AI-crawlere kjører ikke JavaScript, så en side som bare bygger innholdet sitt i nettleseren, kan se tom ut for dem, en slags soft 404 du aldri vil se i Googles rapporter. Mange blokkeres som standard av tjenester for robotbeskyttelse, ofte med en 403. Og fordi de henter ved behov når en bruker stiller et spørsmål, betyr et tidsavbrudd i det øyeblikket at svaret siterer noen andre. Guiden vår om JavaScript og SEO dekker gjengivelse for både søke- og AI-crawlere.
Serverloggene dine er den eneste pålitelige kilden. Filtrer på brukeragent og se på statuskodene:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnHvis AI-roboter får 403 som du ikke mente, retter du regelen. Sjekk deretter om de faktisk siterer deg: Soranks sporing av AI-omtaler følger hvor ofte ChatGPT, Gemini, Claude og Perplexity nevner merkevaren din, så du ser om en rettelse av gjennomsøkingen endrer noe.
Gå gjennom listen etter hver migrering, hvert redesign eller hver større utrulling, og én gang i måneden på store nettsteder.
Sjekkliste for gjennomsøkingshelse
Åpne Gjennomsøkingsstatistikk og sjekk de tre linjene for vertsstatus. Kjør deretter den gratis sjekken for indekserbarhet på de fem mest verdifulle sidene dine. Hvis begge er rene, eksporterer du feilene i Sideindeksering og grupperer dem etter mappe: da har du en kort, prioritert liste over rettelser i stedet for en skremmende rapport.
Når gjennomsøkingen er ren, er neste grense selve innholdet. Soranks innholdsoptimalisering skriver om og oppdaterer de eksisterende sidene dine på autopilot, slik at sidene Google nå kan nå, er verdt å indeksere og sitere. For sidene Google gjennomsøkte, men lot ligge, kan du lese guiden vår om "Gjennomsøkt, for øyeblikket ikke indeksert".
Crawlefeil er forespørsler fra en søkemotor eller AI-crawler som mislykkes: DNS kan ikke slås opp, serveren får tidsavbrudd eller returnerer 5xx, robots.txt kan ikke hentes, en viderekobling går i sløyfe, eller en side returnerer en 4xx-kode. Feil på nettstedsnivå kan sette gjennomsøkingen av hele nettstedet på pause, mens URL-feil bare påvirker den aktuelle siden.
Ikke i seg selv. Google sier at en 404 for en side som er fjernet uten erstatning, ikke nødvendigvis er et problem. Det blir et når URL-en fortsatt har tilbakekoblinger, trafikk eller interne lenker, og da er én 301 til en nær tilsvarende side riktig løsning.
Etter at du har klikket på Valider rettelsen i rapporten Sideindeksering i Search Console, tar valideringen vanligvis opptil rundt to uker. Google sjekker først et utvalg av URL-er og deretter resten, og valideringen stopper hvis bare én berørt URL fortsatt feiler.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler