आपकी गोपनीयता हमारे लिए महत्वपूर्ण है, इसलिए आपके पास कुछ प्रकार के स्टोरेज को बंद करने का विकल्प है जो वेबसाइट के बुनियादी कामकाज के लिए ज़रूरी नहीं हो सकते। कुछ श्रेणियों को बंद करने से वेबसाइट पर आपके अनुभव पर असर पड़ सकता है। अधिक जानकारी (कुकी नीति)
धन्यवाद! आपका फ़ॉर्म सफलतापूर्वक प्राप्त हो गया है!
क्रॉल एरर: हर प्रकार को कैसे खोजें, प्राथमिकता दें और ठीक करें
क्रॉल एरर खोजें और ठीक करें: DNS, सर्वर, robots.txt, 404, सॉफ्ट 404 और रीडायरेक्ट एरर। Googlebot हर एरर पर कैसे प्रतिक्रिया देता है, और उन्हें क्रम से ठीक करने का 6 कदम वाला तरीका।
Search Console उन पेजों की सूची देता है जिन्हें Google पढ़ नहीं पाता, और PageSpeed Insights गति जांचता है। कई छोटी समस्याएं आपके वेबसाइट बिल्डर की सेटिंग से ठीक हो जाती हैं।
आपके लिए हमारी सलाह
एक वेब डेवलपर
आपकी समस्या कोड या सर्वर में है: SEO जानने वाला डेवलपर सही व्यक्ति है। उसे Search Console की गलतियों की सूची दें।
आपके लिए हमारी सलाह
तकनीकी ऑडिट टूल
आपकी साइट पर कई पेज हैं: एक क्रॉलर उन सबको Google की तरह पढ़ता है और हर पेज के हिसाब से ठीक करने वाली गलतियों की पूरी सूची देता है।
आपके लिए हमारी सलाह
स्वचालित ऑडिट, फिर कंटेंट
आपकी साइट चलती है, लेकिन कम विज़िटर लाती है: तकनीकी समस्याएं शायद ही कभी कारण होती हैं। Sorank साइट का ऑडिट करता है, फिर वे पेज लिखता है जो ट्रैफ़िक लाते हैं।
संक्षेप में: क्रॉल एरर वे अनुरोध हैं जो कोई सर्च इंजन या AI क्रॉलर आपकी साइट पर भेजता है और जो विफल हो जाते हैं: सर्वर टाइमआउट हो जाता है, DNS जवाब नहीं देता, robots.txt नहीं मिल पाता, रीडायरेक्ट लूप में फंस जाता है, या पेज 4xx या 5xx कोड लौटाता है। साइट स्तर के एरर (DNS, सर्वर, robots.txt) Google को आपकी पूरी साइट क्रॉल करने से रोक सकते हैं, इसलिए इन्हें सबसे पहले ठीक करें; URL स्तर के एरर (404, सॉफ्ट 404, रीडायरेक्ट एरर) तभी मायने रखते हैं जब वे उन पेजों पर हों जिन्हें आप इंडेक्स करवाना चाहते हैं। इन्हें Search Console की Crawl Stats और Page indexing रिपोर्ट में खोजें, फिर क्रॉलर टूल और सर्वर लॉग से पुष्टि करें, फिर कारण ठीक करें और पुष्टि करें।
क्रॉल एरर क्या हैं, और क्या नहीं हैं
क्रॉलर एक बहुत धैर्यवान आगंतुक की तरह काम करता है। वह आपके सर्वर से एक URL मांगता है, जवाब का इंतज़ार करता है, स्टेटस कोड और कंटेंट पढ़ता है, फिर मिले हुए लिंक पर आगे बढ़ता है। क्रॉल एरर इस श्रृंखला का कोई भी ऐसा कदम है जो विफल हो जाए। आगंतुक को कभी इस्तेमाल लायक पेज नहीं मिलता।
यह परिभाषा ज़रूरी है क्योंकि कई रिपोर्ट क्रॉल एरर को इंडेक्सिंग के फ़ैसलों के साथ मिला देती हैं। "Crawled, currently not indexed" क्रॉल एरर नहीं है: Google ने पेज ठीक से प्राप्त किया और उसे न रखने का फ़ैसला किया। "Excluded by noindex" भी क्रॉल एरर नहीं है: आपने ही Google को पेज हटाने के लिए कहा। क्रॉल एरर का मतलब है कि पेज प्राप्त करने की प्रक्रिया ही गड़बड़ हो गई।
दो परिवार: साइट एरर और URL एरर
Google समस्याओं को दो स्तरों में बांटता है, और आपको भी ऐसा ही करना चाहिए।
साइट एरर (Google इन्हें होस्ट स्टेटस की समस्याएं कहता है): DNS रिज़ॉल्यूशन की विफलता, सर्वर कनेक्शन की विफलता और robots.txt प्राप्त करने की विफलता। ये होस्ट के हर URL को प्रभावित करते हैं। यहां एक खराब दिन पूरी साइट की क्रॉलिंग रोक सकता है।
URL एरर: एक पेज 404, 410, 401, 403, 5xx, सॉफ्ट 404 या टूटा हुआ रीडायरेक्ट लौटाता है। ये केवल उसी URL को प्रभावित करते हैं, और इनमें से कई हानिरहित होते हैं।
साइट एरर बनाम URL एरर
साइट एरर (आज ठीक करें)
DNS डोमेन रिज़ॉल्व नहीं करता
सर्वर टाइमआउट होता है या कनेक्शन तोड़ देता है
robots.txt 5xx या 429 लौटाता है
Crawl Stats के Host status में दिखते हैं
हर पेज की क्रॉलिंग रोक सकते हैं
URL एरर (छंटाई करें)
404, 410, सॉफ्ट 404
401, 403 और अन्य 4xx
रीडायरेक्ट लूप या बहुत लंबी चेन
Page indexing रिपोर्ट में दिखते हैं
केवल उन पेजों पर मायने रखते हैं जिन्हें आप इंडेक्स करवाना चाहते हैं
यह अंतर आपकी प्राथमिकताएं क्यों बदलता है
4000 पुराने प्रोडक्ट URL वाला एक ऑनलाइन स्टोर, जो 404 लौटाते हैं, पूरी तरह स्वस्थ हो सकता है अगर वे प्रोडक्ट हमेशा के लिए बंद हो गए हैं। वही स्टोर अगर छह घंटे तक robots.txt पर 503 लौटाता है, तो यह असली आपातकाल है, भले ही हर प्रोडक्ट पेज ठीक चल रहा हो। पहले होस्ट, फिर पैसा कमाने वाले URL, फिर बाकी सब।
कंटेंट को इंडेक्सिंग के लिए भेजता है। इंडेक्स होना तय नहीं है।
नहीं, जब तक पेज खाली न हो (सॉफ्ट 404)।
301, 308
मज़बूत संकेत कि लक्ष्य ही नया URL है।
नहीं, अगर एक ही बार में 200 तक पहुंचे।
302, 303, 307
कमज़ोर संकेत: मूल URL ही कैनोनिकल बना रहता है।
हां, अगर बदलाव स्थायी है।
3xx चेन
डिफ़ॉल्ट रूप से अधिकतम 10 हॉप तक जाता है, फिर छोड़ देता है।
हां: हर हॉप एक अनुरोध बर्बाद करता है, और लूप कभी खत्म नहीं होते।
404, 410, अन्य 4xx (429 को छोड़कर)
कंटेंट को मौजूद नहीं मानता, इंडेक्स हुए URL समय के साथ हटाता है, उन्हें कम क्रॉल करता है।
केवल तभी जब पेज मौजूद होना चाहिए।
401, 403
अन्य 4xx की तरह। ये क्रॉलिंग धीमी नहीं करते।
हां, अगर ये Googlebot को सार्वजनिक पेजों से रोकते हैं।
429
5xx की तरह सर्वर ओवरलोड का संकेत माना जाता है।
हां: क्रॉलिंग धीमी हो जाती है।
5xx
एरर के अनुपात में क्रॉलिंग धीमी करता है। लगातार विफल होने वाले URL इंडेक्स से हटा दिए जाते हैं।
हां, हमेशा।
दो बातें कई टीमों को उलझा देती हैं। पहली, 401 और 403 क्रॉल रेट कम नहीं करते। अगर आपका सर्वर दबाव में है, तो Googlebot को 403 लौटाने से मदद नहीं मिलती; Google इसके बजाय अस्थायी रूप से 503 या 429 लौटाने को कहता है। दूसरी, 404 कोई दंड नहीं है। जो पेज अब नहीं है, उसके लिए यही सही जवाब है।
robots.txt की विफलता सबसे खतरनाक है
Google का Crawl Stats रिपोर्ट दस्तावेज़ (Search Console Help) यह नियम समझाता है। robots.txt जो 200 (खाली होने पर भी) या 403, 404 या 410 (कोई फ़ाइल नहीं) लौटाता है, ठीक है। जो 429 या 5xx लौटाता है, वह विफलता है, और तब Google सावधानी बरतता है।
robots.txt लगातार विफल होने पर Google क्या करता है
पहले 12 घंटेGoogle साइट की क्रॉलिंग पूरी तरह रोक देता है।
30 दिन तकGoogle आखिरी बार सफलतापूर्वक प्राप्त robots.txt इस्तेमाल करता है।
30 दिन के बादव्यवहार इस पर निर्भर करता है कि होमपेज पहुंच में है या नहीं।
स्रोत: Google Search Console Help, Crawl Stats रिपोर्ट
इसलिए /robots.txt पर 503 देने वाला कोई CDN नियम या फ़ायरवॉल आपकी पूरी साइट को आधे दिन के लिए रोक सकता है, भले ही बाकी हर URL ठीक हो। किसी भी क्रॉल एरर जांच में सबसे पहले यही फ़ाइल जांचें। "Blocked by robots.txt" स्टेटस पर हमारी गाइड उलटी समस्या पर बात करती है, जब फ़ाइल काम करती है पर बहुत ज़्यादा ब्लॉक करती है।
याद रखने लायक Google की क्रॉल सीमाएं
10Google के क्रॉलर अधिकतम इतने रीडायरेक्ट हॉप फ़ॉलो करते हैं
12 घंटेrobots.txt के 5xx या 429 लौटाने पर क्रॉलिंग रुकने का समय
30 दिनGoogle आखिरी सही robots.txt इतने समय तक इस्तेमाल करता है
5%होस्ट समस्या के उदाहरण के रूप में दी गई दैनिक DNS विफलता दर
स्रोत: Google Search Central, HTTP स्टेटस कोड और नेटवर्क एरर; Search Console Help, Crawl Stats रिपोर्ट
क्रॉल एरर वे बिंदु हैं जहां आपकी साइट से गुज़रते क्रॉलर का रास्ता टूट जाता है।
हर प्रकार का क्रॉल एरर, उसके समाधान के साथ
यह वह पूरी सूची है जो आपको Search Console और क्रॉलर टूल में मिलेगी, हर एरर के कारण और समाधान के साथ। नाम Google के Page indexing रिपोर्ट दस्तावेज़ (Search Console Help) से लिए गए हैं।
DNS एरर
Google आपके डोमेन नाम को IP पते में नहीं बदल सका, या DNS सर्वर ने जवाब नहीं दिया। आम कारण: डोमेन की अवधि खत्म होना, DNS प्रदाता की खराबी, माइग्रेशन के बाद गलत रिकॉर्ड, या DNSSEC की गलत सेटिंग। अपने नेटवर्क के बाहर से जांच करें:
समाधान: रिकॉर्ड ठीक करें, किसी भी माइग्रेशन से पहले TTL कम करें, और बैकअप वाले DNS प्रदाता का इस्तेमाल करें। अगर example.com और www.example.com दोनों मौजूद हैं, तो दोनों रिज़ॉल्व होने चाहिए, भले ही एक केवल रीडायरेक्ट करता हो।
सर्वर कनेक्शन एरर और 5xx
सर्वर ने समय पर जवाब नहीं दिया, कनेक्शन बंद कर दिया, या 500, 502, 503 या 504 लौटाया। सामान्य कारण: ओवरलोड डेटाबेस, लोड में क्रैश होने वाली PHP या Node प्रक्रिया, रिवर्स प्रॉक्सी टाइमआउट, प्लगइन अपडेट, या बॉट की गति सीमित करने वाला फ़ायरवॉल। समय का पैटर्न देखें: हर रात एक ही समय पर एरर अक्सर बैकअप या cron जॉब की ओर इशारा करते हैं।
समाधान: Google द्वारा बताए गए समय पर सर्वर एरर लॉग पढ़ें, टाइमआउट या वर्कर की संख्या बढ़ाएं, भारी पेज कैश करें, और सुनिश्चित करें कि बॉट सुरक्षा सत्यापित Googlebot को आने दे। नियोजित मेंटेनेंस के लिए "जल्द लौटेंगे" वाला 200 पेज नहीं, बल्कि Retry-After हेडर के साथ 503 लौटाएं:
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 और 410 (नहीं मिला)
पेज मौजूद नहीं है। यह तब ठीक है जब इसे जानबूझकर हटाया गया हो और कोई उससे लिंक न करता हो। समस्या तब है जब उस URL के अभी भी बैकलिंक, ट्रैफ़िक या आंतरिक लिंक हों, या जब पेज होना चाहिए था और किसी डिप्लॉय ने उसे तोड़ दिया।
समाधान: अगर कंटेंट कहीं और गया है, तो सबसे नज़दीकी समकक्ष पर एक 301 लगाएं। अगर हमेशा के लिए चला गया है, तो 404 रहने दें या 410 इस्तेमाल करें, और उसकी ओर इशारा करने वाले आंतरिक लिंक और साइटमैप एंट्री हटा दें। हर 404 को होमपेज पर कभी रीडायरेक्ट न करें: Google उन्हें सॉफ्ट 404 मानता है।
सॉफ्ट 404
सर्वर 200 कहता है पर पेज खाली दिखता है या "नहीं मिला" कहता है: खाली कैटेगरी, बिना नतीजों वाला सर्च पेज, बिना कंटेंट का आउट-ऑफ़-स्टॉक प्रोडक्ट। Google एक अनुरोध खर्च करता है और कुछ नहीं पाता। हम इसे सॉफ्ट 404 एरर पर अपनी गाइड में विस्तार से कवर करते हैं।
401, 403 और अन्य 4xx
Googlebot कभी लॉगिन जानकारी नहीं भेजता, इसलिए सार्वजनिक पेज पर 401 या 403 का मतलब है कि आपका सर्वर या कोई सुरक्षा परत उसे रोक रही है। आम दोषी: प्रोडक्शन पर छूटा स्टेजिंग पासवर्ड, WAF नियम, देश के आधार पर ब्लॉक, या HTML पर लगा हॉटलिंक सुरक्षा नियम। लक्षण नहीं, नियम ठीक करें, और Search Console के URL Inspection टूल से जांचें।
रीडायरेक्ट एरर
Google रीडायरेक्ट एरर तब बताता है जब उसे लूप, बहुत लंबी चेन, अधिकतम लंबाई से बड़ा URL, या चेन में गलत या खाली URL मिलता है। माइग्रेशन के बाद का क्लासिक मामला: http से https, फिर www, फिर आखिरी स्लैश, फिर नया पाथ। जहां एक हॉप काफ़ी था, वहां चार। SEO रीडायरेक्ट पर हमारी पूरी गाइड बताती है कि इन्हें कैसे छोटा करें।
सुझाव
किसी भी संदिग्ध URL को मुफ़्त Sorank रीडायरेक्ट चेकर में पेस्ट करें: यह पूरी चेन फ़ॉलो करता है, हर हॉप और उसका स्टेटस कोड दिखाता है, और बताता है कि लूप या अतिरिक्त हॉप कहां है।
टाइमआउट, अधूरे रिस्पॉन्स और बहुत बड़े पेज
कुछ एरर कोई स्टेटस कोड नहीं दिखाते। पेज लोड होना शुरू होता है और रुक जाता है, या इतना भारी होता है कि क्रॉलर उसका केवल हिस्सा पढ़ता है। Google के क्रॉलर हर फ़ाइल के सीमित बाइट पढ़ते हैं, इसलिए इनलाइन स्क्रिप्ट या base64 इमेज से भरा पेज नीचे का कंटेंट खो सकता है। भारी टेम्पलेट को पेज साइज़ चेकर से जांचें।
क्रॉल एरर खोजने के सभी तरीके, तुलना के साथ
कोई एक टूल हर क्रॉल एरर नहीं दिखाता। हर तरीका समस्या को अलग कोण से देखता है, और एक गंभीर ऑडिट कम से कम दो को मिलाता है।
तरीका 1: Search Console, Crawl Stats रिपोर्ट
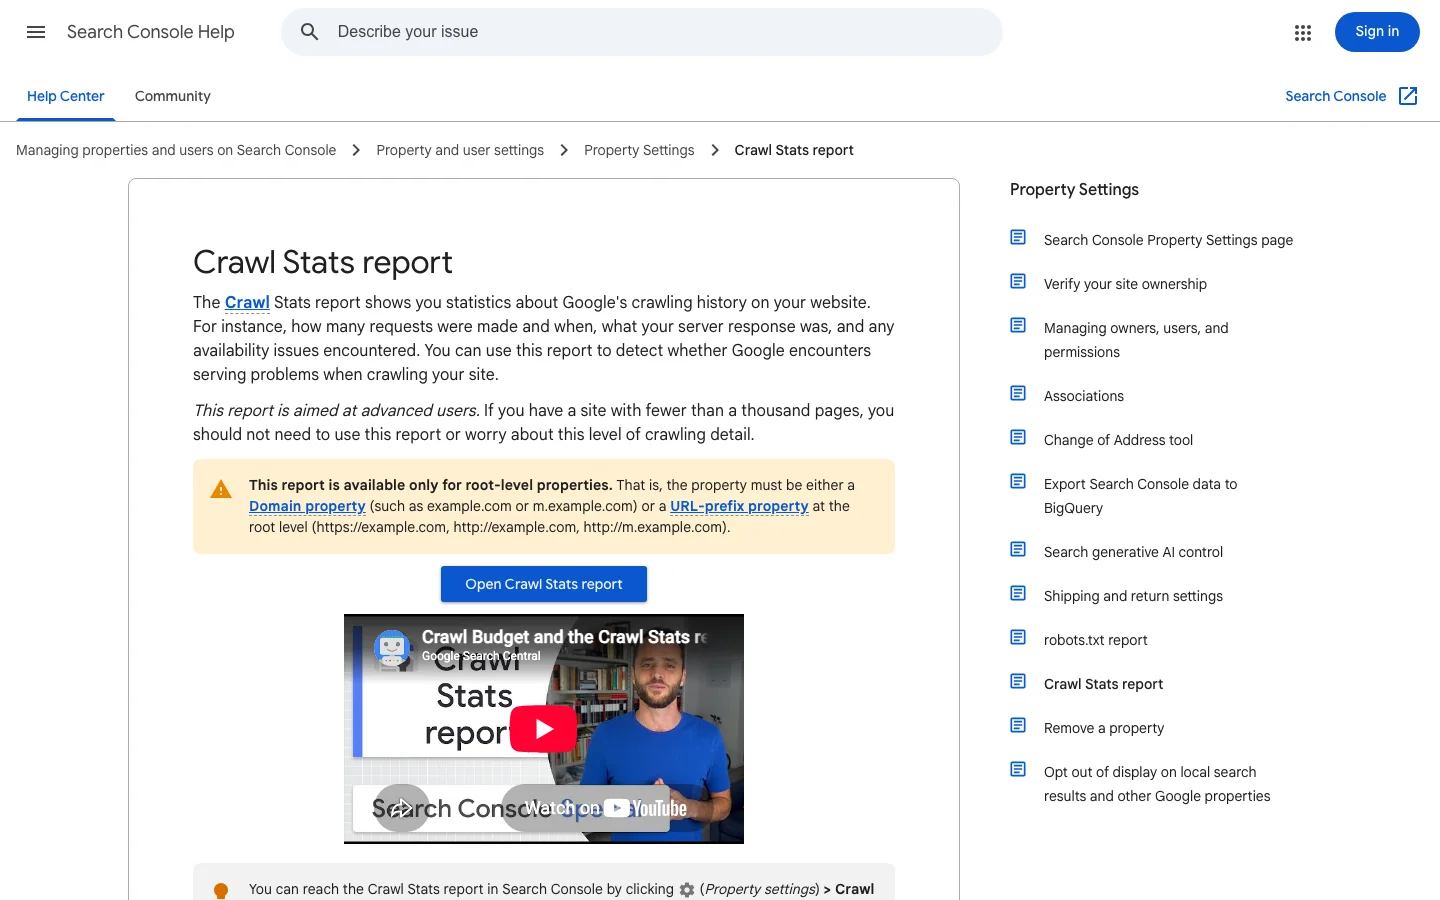
सिद्धांत: Google पिछले 90 दिनों के अपने क्रॉल अनुरोध दिखाता है, रिस्पॉन्स, फ़ाइल प्रकार, उद्देश्य और Googlebot प्रकार के अनुसार समूहित, साथ ही DNS, सर्वर और robots.txt का होस्ट स्टेटस। कब इस्तेमाल करें: हमेशा, और साइट एरर के लिए सबसे पहले। फ़ायदे: यह खुद Google का सच्चा डेटा है। सीमाएं: केवल रूट स्तर की प्रॉपर्टी के लिए, उदाहरण नमूने भर होते हैं, और Google कहता है कि एक हज़ार से कम पेज वाली साइटों को इसकी शायद ही ज़रूरत पड़ती है। उदाहरण: हर रविवार सुबह 3 बजे "page timeout" रिस्पॉन्स में उछाल, जो डेटाबेस बैकअप के समय से मेल खाता है।
Crawl Stats रिपोर्ट पर Google का दस्तावेज़, जिसमें DNS, सर्वर और robots.txt का होस्ट स्टेटस समझाया गया है।
तरीका 2: Search Console, Page indexing रिपोर्ट और URL Inspection
सिद्धांत: Google को ज्ञात URL और उनके इंडेक्स न होने के कारण बताती है, जैसे Server error (5xx), Redirect error, Not found (404) या Soft 404। कब इस्तेमाल करें: URL एरर की छंटाई और समाधान की पुष्टि के लिए। फ़ायदे: उन पेजों से जुड़ी है जिन्हें Google ने वास्तव में आज़माया। सीमाएं: रिपोर्ट कुछ दिन पीछे रहती है, उदाहरण सूचियां सीमित होती हैं, और यह क्रॉल एरर को इंडेक्सिंग के फ़ैसलों से मिला देती है। उदाहरण: "Redirect error" में 300 URL, सभी एक ही पुराने /blog/ प्रीफ़िक्स वाले।
तरीका 3: डेस्कटॉप या क्लाउड क्रॉलर
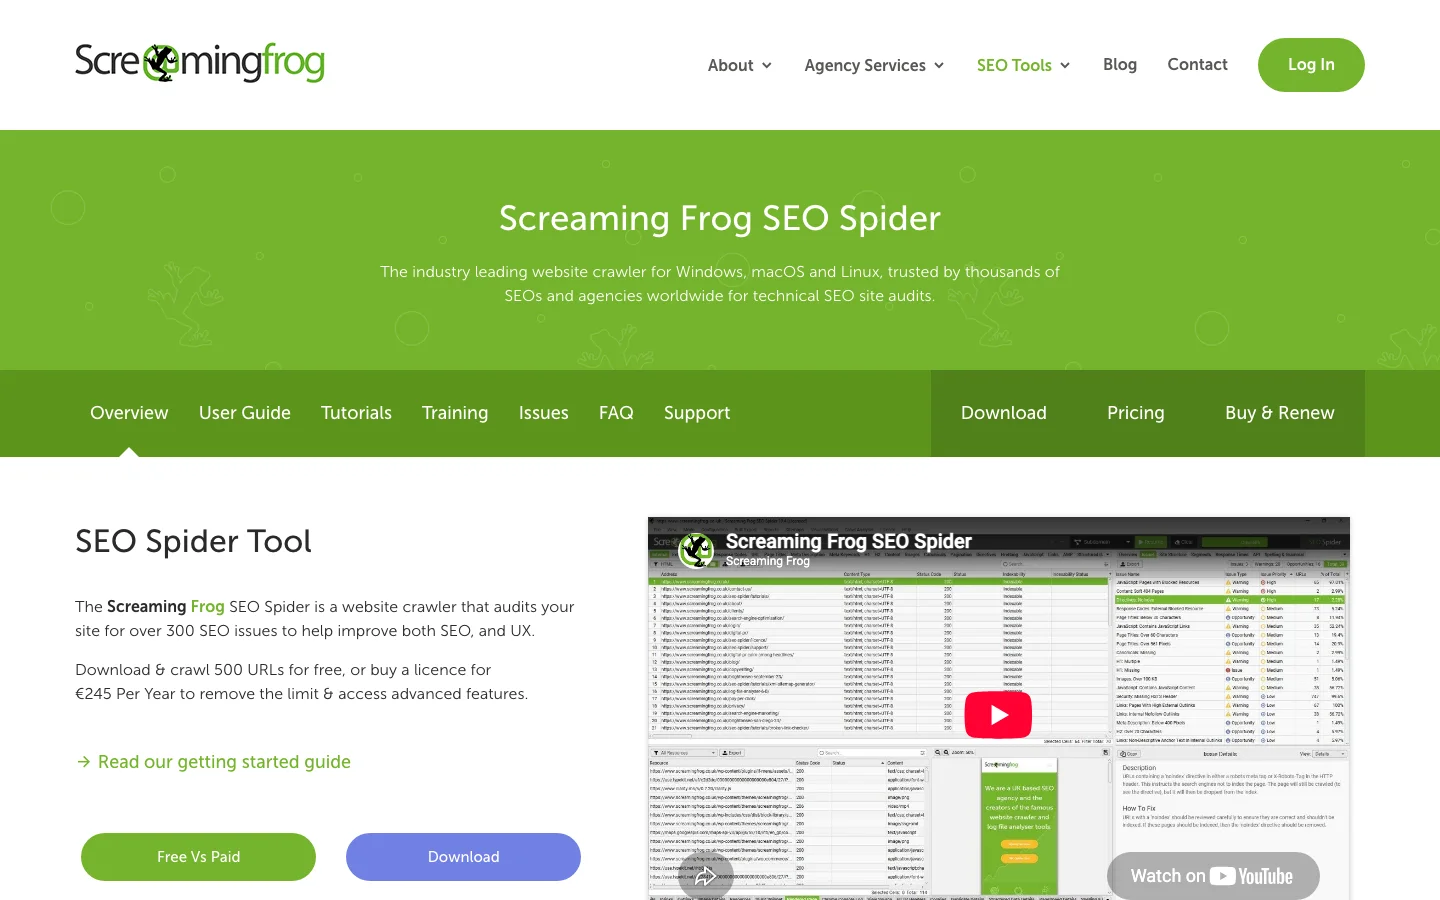
सिद्धांत: Screaming Frog जैसा टूल आपकी साइट को एक बॉट की तरह क्रॉल करता है, होमपेज से लिंक फ़ॉलो करते हुए, और हर स्टेटस कोड, रीडायरेक्ट चेन और टूटा लिंक दर्ज करता है। कब इस्तेमाल करें: माइग्रेशन, रीडिज़ाइन या बड़े डिप्लॉय से पहले और बाद में, और बड़ी साइटों पर हर महीने। फ़ायदे: तुरंत, लिंक किए गए पेजों के लिए पूरा, और दिखाता है कि हर टूटा लिंक कहां है। सीमाएं: यह नहीं जानता कि Google ने वास्तव में क्या मांगा, अनाथ पेज छूट जाते हैं, और आपका सर्वर इसके साथ Googlebot से अलग व्यवहार कर सकता है। हमारी Screaming Frog सेटअप गाइड एक पूरा ऑडिट करवाती है।
Screaming Frog SEO Spider आपकी साइट को एक बॉट की तरह क्रॉल करता है और हर स्टेटस कोड, रीडायरेक्ट चेन और टूटा लिंक दिखाता है।
तरीका 4: सर्वर लॉग विश्लेषण
सिद्धांत: आपके एक्सेस लॉग हर अनुरोध दर्ज करते हैं, जिनमें Googlebot, Bingbot, GPTBot, ClaudeBot और PerplexityBot के अनुरोध भी शामिल हैं, सटीक स्टेटस कोड और रिस्पॉन्स समय के साथ। कब इस्तेमाल करें: बड़ी साइटों पर, बिना कारण ट्रैफ़िक गिरने के बाद, और यह देखने के लिए कि AI क्रॉलर क्या देखते हैं। फ़ायदे: असली अनुरोध, असली कोड, कोई सैंपलिंग नहीं, हर बॉट। सीमाएं: लॉग तक पहुंच और थोड़ी स्क्रिप्टिंग चाहिए; आपको पुष्टि करनी होगी कि "Googlebot" सच में Google है। SEO के लिए लॉग फ़ाइल विश्लेषण पर हमारी गाइड कदम दर कदम बताती है। एक तेज़ पहली नज़र:
# Googlebot requests that did not return 200, 301 or 304, most frequent first
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
तरीका 5: एक-एक URL की जांच
सिद्धांत: curl या किसी मुफ़्त ऑनलाइन चेकर से एक बार में एक URL जांचें। कब इस्तेमाल करें: किसी समाधान की पुष्टि के लिए, या डिप्लॉय के बाद किसी अहम पेज को जांचने के लिए। फ़ायदे: तुरंत और सटीक। सीमाएं: बड़े पैमाने पर काम नहीं करता। बॉट के साथ अलग व्यवहार करने वाले नियम पकड़ने के लिए Googlebot यूज़र एजेंट इस्तेमाल करें:
5xx एरर: स्टेटस कोड पढ़ें और वह परत खोजें जो टूटी है
5xx स्टेटस का मतलब है कि सर्वर एक वैध दिखने वाले अनुरोध को संभाल नहीं सका। Google इसके जवाब में क्रॉलिंग धीमी कर देता है, और जितने ज़्यादा आपके URL एरर लौटाते हैं, उतनी ज़्यादा धीमी करता है। Google कुछ समय तक पहले से इंडेक्स किए गए URL रखता है, लेकिन लगातार सर्वर एरर लौटाने वाले URL हटा देता है। थोड़ी देर की गड़बड़ी से वापसी संभव है, क्योंकि आपका सर्वर 2xx कोड लौटाने लगे तो Google धीरे-धीरे क्रॉल रेट फिर बढ़ा देता है। लंबा एरर का दौर ही आपके इंडेक्स को नुकसान पहुंचाता है।
कोड बताता है कि कौन सी परत टूटी
हर 5xx कोड स्टैक के अलग हिस्से की ओर इशारा करता है। नीचे की तालिका हर कोड के लिए पहली जगह बताती है जहां देखें।
कोड
आम तौर पर इसका मतलब
पहले यहां देखें
500
एप्लिकेशन अनुरोध संभालते समय विफल हुआ
अनुरोध के सटीक समय पर एप्लिकेशन एरर लॉग
502
प्रॉक्सी या CDN को एप्लिकेशन से अमान्य जवाब मिला, अक्सर इसलिए कि वह क्रैश हुआ या रीस्टार्ट हुआ
एप्लिकेशन प्रोसेस के रीस्टार्ट और अपटाइम
503
सेवा ओवरलोड है, रेट-लिमिट है या मेंटेनेंस में है
लोड ग्राफ़, डिप्लॉय इतिहास और मेंटेनेंस विंडो
504
प्रॉक्सी ने एप्लिकेशन का इंतज़ार छोड़ दिया
धीमी डेटाबेस क्वेरी और प्रॉक्सी टाइमआउट सेटिंग
429
रेट लिमिटर कहता है कि अनुरोध बहुत ज़्यादा हैं
रेट-लिमिट नियम, और क्या वे सत्यापित Googlebot पर लागू होते हैं
Google के टाइमस्टैम्प को अपने लॉग से मिलाएं
Crawl Stats दिखाता है कि Google को किन दिनों और घंटों में एरर मिले (हमारी Crawl Stats गाइड हर ग्राफ़ समझाती है)। आपका सर्वर लॉग ठीक उन पलों में क्या हुआ, वह दिखाता है। Googlebot के अनुरोध छांटें और हर घंटे के 5xx जवाब गिनें:
आउटपुट की हर पंक्ति एक घंटा, एक स्टेटस कोड और एक गिनती है। हर रात एक ही घंटे में जमाव आम तौर पर बैकअप, cron जॉब या निर्धारित इम्पोर्ट की ओर इशारा करता है। पूरे दिन बिखरी एरर आम तौर पर लोड की ओर इशारा करती हैं, तो समाधान एक बग ठीक करना नहीं बल्कि क्षमता या कैशिंग बढ़ाना होता है। गहरी विधि के लिए हमारी लॉग फ़ाइल विश्लेषण गाइड देखें।
घबराने से पहले मापें कि 5xx की कीमत कितनी है
Google क्रॉलिंग उस अनुपात में घटाता है जितने URL एरर लौटाते हैं। कुछ URL पर असर डालने वाला टूटा टेम्पलेट आपके क्रॉल समय में थोड़ा खर्च करता है। हर पेज तोड़ने वाला डेटाबेस आउटेज बहुत खर्च करता है, और उसे पहले ठीक करना होगा।
429 का असर वही होता है जो 5xx का, क्योंकि Google इसे ओवरलोड सर्वर के रूप में पढ़ता है। अगर आपका रेट लिमिटर या बॉट सुरक्षा Googlebot को 429 लौटाती है, तो उसकी कीमत आपके क्रॉल समय में चुकानी पड़ती है। Google के दस्तावेज़ में Retry-After हेडर का ज़िक्र नहीं है। इसे इंसानी विज़िटर और API क्लाइंट के लिए भेजते रहें, लेकिन इस पर भरोसा न करें कि Googlebot उतना इंतज़ार करेगा जितना आपने तय किया।
4xx एरर: ठीक करने से पहले पता करें कि वे कहां से आ रहे हैं
4xx स्टेटस का मतलब है कि सर्वर ने अनुरोध को क्लाइंट की ओर की किसी वजह से ठुकरा दिया: URL मौजूद नहीं है, एक्सेस वर्जित है, या पता गलत बना है। Google 429 को छोड़कर हर 4xx को एक ही तरह से लेता है। वह उस URL के पीछे की सामग्री का उपयोग बंद कर देता है, और अगर वह इंडेक्स में था तो उसे इंडेक्स से हटा देता है। किसी 4xx को छूने से पहले पता करें कि अनुरोध कहां से आ रहा है, क्योंकि समाधान अक्सर एक ही जगह पर होता है: एक लिंक, एक टेम्पलेट या एक रीडायरेक्ट नियम।
अपने लॉग में हर 4xx का स्रोत खोजें
आपका एक्सेस लॉग हर अनुरोध का रेफरर दर्ज करता है, यानी कौन सा पेज विज़िटर या बॉट को उस URL पर लाया। 4xx प्रतिक्रियाओं को पाथ और रेफरर के हिसाब से गिनें:
आपके अपने डोमेन का रेफरर मतलब है कि आपका कोई पेज एक मृत URL से लिंक करता है। लिंक या उस टेम्पलेट को ठीक करें जो उसे बनाता है। यह सबसे कीमती सुधार है, क्योंकि यह आपके नियंत्रण में है। हमारी गाइड टूटे लिंक ठीक करना पूरा तरीका बताती है।
किसी दूसरी साइट का रेफरर मतलब है कि कोई बैकलिंक ऐसे URL की ओर इशारा करता है जो अब काम नहीं करता। अगर लिंक रखने लायक है, तो सबसे नज़दीकी लाइव पेज पर एक 301 जोड़ें। अगर नहीं है, तो 404 को वैसे ही रहने दें।
खाली रेफरर, या ऐसा पाथ जो आपने कभी प्रकाशित नहीं किया, जैसे स्टैटिक साइट पर लॉगिन पेज, आम तौर पर किसी बॉट या स्कैनर की कोशिश होती है। उसे 404 लौटाने दें और इस पर समय न लगाएं।
हर रिलीज़ के बाद 4xx के उछाल पर नज़र रखें
एक रिलीज़ जो रूट का नाम बदलती है, slug बदलती है या टेम्पलेट फिर से बनाती है, अक्सर उसी दिन 404 की लहर लाती है। डिप्लॉय से पहले के हफ़्ते और बाद के हफ़्ते के लिए हर दिन की 4xx संख्या निकालें। एक फ़ोल्डर में केंद्रित उछाल सीधे बदलाव की ओर इशारा करता है। पुराने URL से नए पर रीडायरेक्ट उसी रिलीज़ में जोड़ें, बाद के टिकट में नहीं। पूरे माइग्रेशन के लिए हमारी SEO माइग्रेशन चेकलिस्ट देखें।
सुझाव
गायब पेज की जगह छोटा संदेश या खाली सूची दिखाने वाला 200 रिस्पॉन्स न दें। Google उसे सॉफ्ट 404 मान सकता है, जिसमें पूरा फ़ेच खर्च होता है और कुछ नहीं मिलता।
कदम दर कदम: क्रॉल एरर सही क्रम में ठीक करें
यह वह तरीका है जो हम इस्तेमाल करते हैं। यह उन एरर से शुरू होता है जो आपकी पूरी साइट रोक सकते हैं, और उन पर खत्म होता है जो बस थोड़ी क्रॉलिंग बर्बाद करते हैं।
क्रॉल एरर का 6 कदम वाला तरीका
होस्ट स्टेटस जांचेंCrawl Stats खोलें और पिछले 90 दिनों के DNS, सर्वर कनेक्शन और robots.txt देखें।
URL एरर एक्सपोर्ट करें और समूह बनाएंहर Page indexing कारण एक्सपोर्ट करें और URL को फ़ोल्डर या टेम्पलेट के अनुसार समूहित करें।
मूल्य के अनुसार क्रम देंट्रैफ़िक, बैकलिंक, आंतरिक लिंक या साइटमैप एंट्री वाले URL रखें।
टेम्पलेट स्तर पर कारण ठीक करेंएक नियम, एक रीडायरेक्ट मैप या एक सर्वर सेटिंग सैकड़ों URL ठीक कर देती है।
संकेत साफ़ करेंआंतरिक लिंक और साइटमैप अपडेट करें ताकि वे अंतिम 200 URL की ओर इशारा करें।
पुष्टि करें और निगरानी रखेंValidate fix पर क्लिक करें, फिर हर हफ़्ते Crawl Stats और अपने लॉग देखें।
कदम 1: पहले होस्ट जांचें
Search Console में Settings, फिर Crawl stats, फिर Host status खोलें। हरे रंग का मतलब है 90 दिनों में कोई गंभीर समस्या नहीं। "Recent issue" का मतलब है पिछले हफ़्ते कोई गंभीर समस्या: बाकी सब छोड़ दें। हर श्रेणी पर क्लिक करके रोज़ की विफलता दर देखें, फिर खराब दिनों को अपनी होस्टिंग, CDN और डिप्लॉय के इतिहास से मिलाएं।
कदम 2: एक्सपोर्ट करें और पैटर्न के अनुसार समूह बनाएं
Indexing, फिर Pages खोलें, और हर एरर कारण एक्सपोर्ट करें। URL एक-एक करके ठीक न करें। उन्हें स्प्रेडशीट में डालें और पहला फ़ोल्डर निकालें:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
इस कॉलम पर पिवट टेबल आमतौर पर दिखाती है कि ज़्यादातर एरर दो या तीन टेम्पलेट से आते हैं: बंद की गई ब्लॉग कैटेगरी, कोई फ़िल्टर पैरामीटर, पुराना प्रोडक्ट फ़ीड।
कदम 3: व्यावसायिक मूल्य के अनुसार क्रम दें
हर पैटर्न के लिए चार सवाल पूछें। क्या इसे ऑर्गेनिक क्लिक मिलते हैं? क्या इसके बैकलिंक हैं? क्या यह आंतरिक रूप से लिंक है? क्या यह साइटमैप में है? चारों में से कुछ न होने वाला 404 हमेशा इंतज़ार कर सकता है। बैकलिंक वाले 404 को आज ही 301 चाहिए। मुफ़्त ब्रोकन लिंक चेकर दिखाता है कि आपके कौन से पेज अब भी मृत URL से लिंक करते हैं।
कदम 4: मूल कारण ठीक करें
URL नहीं, नियम ठीक करें। सर्वर कॉन्फ़िगरेशन में एक रीडायरेक्ट मैप, किसी प्लगइन में हाथ से जोड़े गए 400 रीडायरेक्ट से बेहतर है। उदाहरण के लिए nginx में:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
5xx के लिए क्षमता या बग ठीक करें। 401 और 403 के लिए सुरक्षा नियम ठीक करें। सॉफ्ट 404 के लिए या तो असली कंटेंट जोड़ें या असली 404 लौटाएं।
कदम 5: आंतरिक लिंक और साइटमैप साफ़ करें
हर आंतरिक लिंक को सीधे 200 लौटाने वाले URL की ओर इशारा करना चाहिए। हर साइटमैप एंट्री कैनोनिकल, इंडेक्स योग्य और 200 लौटाने वाला URL होनी चाहिए। रीडायरेक्ट और 404 से भरा साइटमैप Google को उस पर कम भरोसा करना सिखाता है। साइटमैप कैसे बनाएं पर हमारी गाइड बताती है कि उसमें क्या होना चाहिए।
कदम 6: पुष्टि करें और निगरानी रखें
Page indexing रिपोर्ट में ठीक किया गया कारण खोलें और Validate fix पर क्लिक करें। Google पहले एक नमूना जांचता है, फिर बाकी; इसमें आमतौर पर लगभग दो हफ़्ते तक लगते हैं, और अगर एक भी URL अब भी विफल हो तो यह रुक जाता है। चलते समय दोबारा क्लिक न करें। फिर एक साप्ताहिक दिनचर्या बनाएं: होस्ट के लिए Crawl Stats, उछाल के लिए लॉग, हर डिप्लॉय के बाद एक क्रॉल।
सुधार से पहले और बाद की रीडायरेक्ट चेन
पहले
http://site.com/page
301 से https://site.com/page
301 से https://www.site.com/page
301 से https://www.site.com/page/
आंतरिक लिंक अब भी पहले URL की ओर इशारा करते हैं
बाद में
एक 301 सीधे https://www.site.com/page/ पर
आंतरिक लिंक अंतिम URL पर अपडेट
साइटमैप में केवल अंतिम URL
चार की जगह एक अनुरोध
आम गलतियां, और उन्हें कैसे पहचानें और ठीक करें
गलती 1: हर 404 को होमपेज पर रीडायरेक्ट करना
यह क्या है: एक प्लगइन या नियम जो हर गायब URL को / पर भेजता है। कैसे पहचानें: "Soft 404" या "Page with redirect" में कई URL जो सब होमपेज पर पहुंचते हैं; क्रॉलर एक ही लक्ष्य वाले सैकड़ों 301 दिखाता है। कैसे ठीक करें: केवल नज़दीकी समकक्ष पर रीडायरेक्ट करें, और बाकी को 404 या 410 लौटाने दें।
गलती 2: सुरक्षा टूल से Googlebot को ब्लॉक करना
यह क्या है: WAF, बॉट मैनेजर या रेट लिमिटर जो Google को 403, 429 या चैलेंज पेज देता है। कैसे पहचानें: Crawl Stats में 403 या 429, जबकि पेज आपके ब्राउज़र में ठीक लोड होता है; लॉग IP के अनुसार ब्लॉक दिखाते हैं। कैसे ठीक करें: यूज़र एजेंट स्ट्रिंग पर भरोसा करने के बजाय, रिवर्स DNS या Google द्वारा प्रकाशित IP रेंज से सत्यापित Googlebot को अनुमति दें।
गलती 3: कमज़ोर robots.txt
यह क्या है: ऐप द्वारा बनाया गया robots.txt, जो ऐप के विफल होते ही विफल हो जाता है, या ऐसे CDN नियम से दिया जाता है जो 5xx को कैश कर लेता है। कैसे पहचानें: Host status में robots.txt प्राप्त करने की श्रेणी हरी नहीं है। कैसे ठीक करें: इसे ऐप के बाहर एक स्टैटिक फ़ाइल के रूप में दें, और robots.txt चेकर से जांचें।
गलती 4: 200 लौटाने वाले मेंटेनेंस पेज
यह क्या है: हर URL पर स्टेटस 200 के साथ "जल्द लौटेंगे" पेज दिखाना। कैसे पहचानें: मेंटेनेंस के बाद सॉफ्ट 404 या डुप्लिकेट टाइटल की लहर। कैसे ठीक करें: मेंटेनेंस के दौरान Retry-After के साथ 503 लौटाएं, और इसे छोटा रखें।
गलती 5: Google को धीमा करने के लिए 403 इस्तेमाल करना
यह क्या है: सर्वर ओवरलोड होने पर Googlebot को 403 देना। कैसे पहचानें: 403 में उछाल जो लोड के उछाल से मेल खाता है। कैसे ठीक करें: Google कहता है कि 429 के अलावा 4xx कोड का क्रॉल रेट पर कोई असर नहीं होता। थोड़े समय के लिए 503 या 429 लौटाएं, और क्षमता ठीक करें।
गलती 6: एरर एक-एक करके ठीक करना
यह क्या है: Search Console की सूची में क्लिक करते हुए हर URL अलग से बदलना। कैसे पहचानें: वही कारण हर महीने लौट आता है। कैसे ठीक करें: पैटर्न के अनुसार समूह बनाएं, टेम्पलेट या नियम ठीक करें, फिर एक बार पुष्टि करें।
गलती 7: हानिरहित 404 से घबराना
यह क्या है: स्पैम URL या बहुत पहले हटाए गए बिना लिंक वाले पेजों के 404 पर दिन बिताना। कैसे पहचानें: इन URL पर कोई क्लिक, बैकलिंक या आंतरिक लिंक नहीं है। कैसे ठीक करें: इन्हें छोड़ दें। Google कहता है कि हटाए गए पेज का 404 ज़रूरी नहीं कि समस्या हो।
चेतावनी
किसी क्रॉल एरर को "छिपाने" के लिए robots.txt में URL कभी ब्लॉक न करें। Google फिर 404 या रीडायरेक्ट नहीं देख पाएगा, URL इंडेक्स में बना रह सकता है, और आप वह संकेत खो देते हैं जो भेजना चाहते थे।
क्रॉल एरर और क्रॉल बजट
कुछ सौ पेज वाली साइट पर Google के पास सब कुछ देखने का समय होता है, और क्रॉल एरर मुख्य रूप से उन्हीं पेजों के लिए मायने रखते हैं जिन्हें वे तोड़ते हैं। बड़ी साइटों (फ़िल्टर वाले स्टोर, मार्केटप्लेस, न्यूज़) पर हर विफल या बर्बाद अनुरोध आपके असली पेजों का समय छीनता है। यही क्रॉल बजट का विचार है।
एरर क्रॉल क्षमता को कैसे खा जाते हैं
5xx और 429 Google को पूरे होस्ट पर धीमा कर देते हैं, इसलिए कुछ टूटे टेम्पलेट आपके नए प्रोडक्ट पेजों की क्रॉलिंग में देरी कर सकते हैं। रीडायरेक्ट चेन हर हॉप पर एक अनुरोध खर्च करती है। सॉफ्ट 404 पूरा अनुरोध खर्च करता है और कुछ नहीं देता। इन तीनों को ठीक करें और वही बजट ज़्यादा उपयोगी पेज कवर करेगा।
"Discovered, not indexed" का इससे क्या संबंध है
जब Google URL खोज लेता है पर उनकी क्रॉलिंग टाल देता है, तो कारण अक्सर ऐसा सर्वर होता है जिसे वह कमज़ोर मानता है। अगर आप "Discovered, currently not indexed" की बढ़ती संख्या के साथ Crawl Stats में सर्वर एरर देखते हैं, तो पहले सर्वर ठीक करें। दोनों रिपोर्ट एक ही कहानी कहती हैं।
AI क्रॉलर के लिए क्रॉल एरर
अब केवल Googlebot ही अहम आगंतुक नहीं है। GPTBot, OAI-SearchBot, ClaudeBot और PerplexityBot मॉडल को प्रशिक्षित करने या वास्तविक समय में सवालों के जवाब देने के लिए पेज लेते हैं। वे उसी सर्वर पर आते हैं, और उन्हीं एरर से जूझते हैं, एक अंतर के साथ: उनके लिए कोई Search Console नहीं है।
AI बॉट के साथ क्या बदलता है
ज़्यादातर AI क्रॉलर JavaScript नहीं चलाते, इसलिए जो पेज अपना कंटेंट केवल ब्राउज़र में बनाता है, वह उन्हें खाली दिख सकता है, एक तरह का सॉफ्ट 404 जो आप Google की रिपोर्ट में कभी नहीं देखेंगे। कई AI क्रॉलर बॉट सुरक्षा सेवाओं द्वारा डिफ़ॉल्ट रूप से ब्लॉक होते हैं, अक्सर 403 के साथ। और क्योंकि वे उपयोगकर्ता के सवाल पूछते ही पेज लेते हैं, उस पल टाइमआउट का मतलब है कि जवाब किसी और का हवाला देगा। JavaScript SEO पर हमारी गाइड सर्च और AI दोनों क्रॉलर के लिए रेंडरिंग कवर करती है।
उनकी निगरानी कैसे करें
आपके सर्वर लॉग ही एकमात्र भरोसेमंद स्रोत हैं। यूज़र एजेंट से फ़िल्टर करें और स्टेटस कोड देखें:
अगर AI बॉट को ऐसे 403 मिल रहे हैं जो आप नहीं चाहते थे, तो नियम ठीक करें। फिर जांचें कि क्या वे सच में आपका हवाला देते हैं: Sorank का AI मेंशन ट्रैकिंग ट्रैक करता है कि ChatGPT, Gemini, Claude और Perplexity आपके ब्रांड का कितनी बार ज़िक्र करते हैं, ताकि आप देख सकें कि क्रॉल सुधार से कुछ बदला या नहीं।
क्रॉल हेल्थ चेकलिस्ट
हर माइग्रेशन, रीडिज़ाइन या बड़े डिप्लॉय के बाद यह सूची चलाएं, और बड़ी साइटों पर महीने में एक बार।
क्रॉल हेल्थ चेकलिस्ट
DNS, सर्वर कनेक्शन और robots.txt का होस्ट स्टेटस हरा
robots.txt स्टैटिक फ़ाइल के रूप में दिया जाता है और 200 लौटाता है
Crawl Stats या लॉग में 5xx या 429 का कोई उछाल नहीं
सत्यापित Googlebot और चाहे गए AI बॉट फ़ायरवॉल से ब्लॉक नहीं
हर रीडायरेक्ट एक हॉप, 301 या 308, एक 200 पेज तक
आंतरिक लिंक अंतिम 200 URL की ओर इशारा करते हैं
साइटमैप में केवल कैनोनिकल, इंडेक्स योग्य, 200 URL
बैकलिंक या ट्रैफ़िक वाले 404 नज़दीकी समकक्ष पर रीडायरेक्ट
खाली पेज ठीक किए गए या असली 404 लौटाते हैं
मेंटेनेंस में Retry-After के साथ 503
हर ठीक किए गए कारण के लिए Validate fix शुरू
आज क्या करें
Crawl Stats खोलें और होस्ट स्टेटस की तीनों पंक्तियां जांचें। फिर अपने पांच सबसे मूल्यवान पेजों पर मुफ़्त इंडेक्सेबिलिटी चेकर चलाएं। अगर दोनों साफ़ हैं, तो Page indexing एरर एक्सपोर्ट करें और फ़ोल्डर के अनुसार समूह बनाएं: अब आपके पास डराने वाली रिपोर्ट की जगह एक छोटी, क्रमबद्ध सुधार सूची है।
क्रॉल साफ़ होने के बाद अगली सीमा खुद कंटेंट है। Sorank का कंटेंट ऑप्टिमाइज़ेशन आपके मौजूदा पेजों को autopilot पर दोबारा लिखता और ताज़ा करता है, ताकि जिन पेजों तक Google अब पहुंच सकता है वे इंडेक्स और उद्धृत होने लायक हों। जिन पेजों को Google ने क्रॉल किया पर छोड़ दिया, उनके लिए "Crawled, currently not indexed" पर हमारी गाइड पढ़ें।
अक्सर पूछे जाने वाले सवाल
SEO में क्रॉल एरर क्या हैं?
क्रॉल एरर किसी सर्च इंजन या AI क्रॉलर के वे अनुरोध हैं जो विफल हो जाते हैं: DNS रिज़ॉल्व नहीं होता, सर्वर टाइमआउट होता है या 5xx लौटाता है, robots.txt नहीं मिलता, रीडायरेक्ट लूप में फंसता है, या पेज 4xx कोड लौटाता है। साइट स्तर के एरर पूरी साइट की क्रॉलिंग रोक सकते हैं, जबकि URL एरर केवल संबंधित पेज को प्रभावित करते हैं।
क्या 404 एरर SEO के लिए बुरे हैं?
अपने आप में नहीं। Google कहता है कि बिना विकल्प के हटाए गए पेज का 404 ज़रूरी नहीं कि समस्या हो। यह तब समस्या बनता है जब उस URL के अब भी बैकलिंक, ट्रैफ़िक या आंतरिक लिंक हों, और तब सही समाधान नज़दीकी समकक्ष पर एक 301 है।
Google को यह देखने में कितना समय लगता है कि क्रॉल एरर ठीक हो गए?
Search Console की Page indexing रिपोर्ट में Validate fix पर क्लिक करने के बाद पुष्टि में आमतौर पर लगभग दो हफ़्ते तक लगते हैं। Google पहले URL का एक नमूना जांचता है, फिर बाकी, और अगर एक भी संबंधित URL अब भी विफल हो तो यह रुक जाता है।
y!
30 दिनों का अपना कंटेंट प्लान मुफ़्त में पाएँ
हम आपके प्रतिस्पर्धियों, आपकी वेबसाइट और आपकी AI दृश्यता का विश्लेषण करते हैं, ताकि मुफ़्त में आपके लिए एक अनुकूल कंटेंट योजना बनाई जा सके।
“मैंने Sorank को एक असली क्लाइंट की साइट पर आज़माया और यह कमाल का है। यह वह सब कुछ करता है जिसके लिए एक एजेंसी आपसे हर महीने $1500 वसूलती है। अब उस क्लाइंट के लिए इसे प्रोडक्शन में डाला जा रहा है।”Guillaume Guersanguersanguillaume.com
“हम एक Ads एजेंसी हैं और हम अपने SEO को एक बार और हमेशा के लिए सही रास्ते पर लाना चाहते थे। Sorank ने हमें हमारी साइट की साफ तस्वीर दी, ऑप्टिमाइज़ेशन को प्राथमिकता देने में मदद की, और हमारे कंटेंट को सही तरीके से व्यवस्थित किया। टूल इस्तेमाल में आसान है, टीम के लिए अच्छी तरह डिज़ाइन किया गया है, और कई प्लेटफ़ॉर्म के बीच भागदौड़ किए बिना ट्रैकिंग को एक जगह रखने के लिए बहुत व्यावहारिक है। नए सिरे से SEO शुरू करने के लिए एक बहुत मज़बूत आधार।”Gaspard MadouiAds एजेंसी
“Sorank की बदौलत मैं GEO में विशेषज्ञ बन गई। GEO रैंकिंग मुझे ChatGPT पर क्लाइंट्स को उनकी प्रतियोगियों के मुकाबले उनकी पोज़िशन दिखाने देती है। यह एक असली व्यावसायिक अंतर है।”Mélanieफ्रीलांस SEO
“बेहतरीन सेवा है, हमारी वेबसाइट के लिए अच्छा काम करती है, और यह समझने में मदद करती है कि इसे कैसे सुधारें ताकि Google और दूसरी जगहों पर बेहतर रैंक हो। बधाई, ऐसे ही आगे बढ़ते रहिए। इसकी सिफ़ारिश है।”Hugo T.E-commerce व्यापारी