Integritet är viktigt för oss, så du kan välja att inaktivera vissa typer av lagring som kanske inte är nödvändig för webbplatsens grundläggande funktioner. Om du blockerar kategorier kan det påverka din upplevelse av webbplatsen. Mer information (Cookiepolicy)
En karta över en webbplats där några sidor är markerade med felsignaler medan en crawler följer länkarna mellan dem.
Verktyg
På den här sidan
Kort sagt
genomsökningsfel är de förfrågningar som en sökmotor eller AI-crawler gör mot din webbplats och som misslyckas: servern svarar inte i tid, DNS svarar inte, robots.txt kan inte hämtas, en omdirigering går i loop eller en sida returnerar en 4xx- eller 5xx-kod. Fel på webbplatsnivå (DNS, server, robots.txt) kan stoppa Googles genomsökning av hela webbplatsen, så åtgärda dem först; fel på URL-nivå (404, soft 404, omdirigeringsfel) spelar bara roll när de drabbar sidor som du vill ha indexerade. Du hittar dem i Search Consoles rapporter Genomsökningsstatistik och Sidindexering, bekräftar dem med en crawler och dina serverloggar, och åtgärdar sedan orsaken och validerar.
Vem ska åtgärda den tekniska sidan av din webbplats?
Fråga 1 av 425%
Våra råd till dig
Kontrollera själv med gratis Google-verktyg
Search Console listar sidorna som Google inte kan läsa, och PageSpeed Insights testar hastigheten. Många små problem åtgärdas i inställningarna för din webbyggare.
Våra råd till dig
En webbutvecklare
Ditt problem finns i koden eller på servern: en utvecklare som kan SEO är rätt person. Ge dem listan över fel från Search Console.
Våra råd till dig
Ett verktyg för teknisk granskning
Din webbplats har många sidor: en crawler läser alla som Google gör och ger en fullständig lista över fel att åtgärda, sida för sida.
Våra råd till dig
En automatisk granskning, sedan innehåll
Din webbplats fungerar men ger få besökare: tekniska problem är sällan orsaken. Sorank granskar webbplatsen och skriver sedan sidorna som ger trafik.
Vad genomsökningsfel är, och vad de inte är
En crawler fungerar som en mycket tålmodig besökare. Den ber din server om en URL, väntar på svar, läser statuskoden och innehållet och går sedan vidare till länkarna den hittade. Ett genomsökningsfel är varje steg i den kedjan som misslyckas. Besökaren får aldrig en användbar sida.
Definitionen är viktig eftersom många rapporter blandar ihop genomsökningsfel med indexeringsbeslut. "Genomsökt, för närvarande inte indexerad" är inte ett genomsökningsfel: Google hämtade sidan utan problem och valde att inte behålla den. "Utesluten av noindex" är inte heller ett genomsökningsfel: du bad Google att ta bort sidan. Ett genomsökningsfel betyder att själva hämtningen gick fel.
De två familjerna: webbplatsfel och URL-fel
Google delar upp problemen på två nivåer, och det bör du också göra.
Webbplatsfel (Google kallar dem problem med värdstatus): DNS-uppslagningsfel, fel vid serveranslutning och fel vid hämtning av robots.txt. De påverkar varje URL på värden. En dålig dag här kan frysa genomsökningen av hela webbplatsen.
URL-fel: en sida returnerar 404, 410, 401, 403, 5xx, en soft 404 eller en trasig omdirigering. De påverkar bara den URL:en, och många av dem är ofarliga.
Webbplatsfel kontra URL-fel
Webbplatsfel (åtgärda i dag)
DNS löses inte upp
Servern får timeout eller bryter anslutningen
robots.txt returnerar 5xx eller 429
Visas i Genomsökningsstatistik, Värdstatus
Kan pausa genomsökningen av alla sidor
URL-fel (sortera)
404, 410, soft 404
401, 403, andra 4xx
Omdirigeringsloop eller för lång kedja
Visas i rapporten Sidindexering
Spelar bara roll för sidor du vill indexera
Varför skillnaden ändrar dina prioriteringar
En butik med 4000 gamla produkt-URL:er som returnerar 404 kan vara helt frisk om produkterna är borta för gott. Samma butik med en robots.txt som returnerar 503 i sex timmar har en verklig nödsituation, även om varje produktsida fungerar. Börja med värden, sedan URL:erna som drar in pengar, sedan resten.
Hur Googlebot reagerar på varje fel
För att åtgärda genomsökningsfel på rätt sätt behöver du veta vad Google faktiskt gör när den stöter på ett. Googles dokumentation om hur HTTP-statuskoder och nätverksfel påverkar Google Sök (Google Search Central) anger reglerna. Så här betyder de i praktiken.
Statuskoder, en familj i taget
Svar
Vad Google gör
Är det ett problem?
2xx
Skickar innehållet vidare till indexering. Indexering är inte garanterad.
Nej, om inte sidan är tom (soft 404).
301, 308
Stark signal om att målet är den nya URL:en.
Nej, om det är ett hopp till en 200.
302, 303, 307
Svag signal: den ursprungliga URL:en tenderar att förbli kanonisk.
Ja, om flytten är permanent.
3xx-kedjor
Följer upp till 10 hopp som standard och ger sedan upp.
Ja: varje hopp slösar en förfrågan, och loopar löses aldrig.
404, 410, andra 4xx (utom 429)
Behandlar innehållet som obefintligt, tar bort indexerade URL:er med tiden och genomsöker dem mer sällan.
Bara om sidan borde finnas.
401, 403
Samma som andra 4xx. De saktar inte ner genomsökningen.
Ja, om de blockerar Googlebot från offentliga sidor.
429
Behandlas som en signal om överbelastad server, som en 5xx.
Ja: genomsökningen saktas ner.
5xx
Saktar ner genomsökningen i proportion till felen. URL:er som fortsätter att misslyckas tas bort från indexet.
Ja, alltid.
Två detaljer får många team att snubbla. För det första minskar 401 och 403 inte genomsökningstakten. Om din server har det tungt hjälper det inte att returnera 403 till Googlebot; Google ber dig i stället att tillfälligt returnera 503 eller 429. För det andra är en 404 inget straff. Det är rätt svar för en sida som är borta.
Fel på robots.txt är de farligaste
Googles dokumentation om rapporten Genomsökningsstatistik (Search Console-hjälpen) förklarar regeln. En robots.txt som svarar 200 (även tom) eller 403, 404 eller 410 (ingen fil) är okej. En robots.txt som svarar 429 eller 5xx är ett fel, och då spelar Google säkert.
Vad Google gör när robots.txt fortsätter att misslyckas
Första 12 timmarnaGoogle slutar genomsöka webbplatsen helt.
Upp till 30 dagarGoogle använder den senaste robots.txt som hämtades utan fel.
Efter 30 dagarBeteendet beror på om startsidan går att nå.
En CDN-regel eller brandvägg som serverar 503 på /robots.txt kan alltså frysa hela din webbplats i ett halvt dygn, även om alla andra URL:er fungerar. Kontrollera den här filen först i varje utredning av genomsökningsfel. Vår guide om statusen "Blockerad av robots.txt" tar upp det motsatta problemet, när filen fungerar men blockerar för mycket.
Googles genomsökningsgränser att komma ihåg
10omdirigeringshopp som Googles crawlers följer som mest
12 hgenomsökningsstopp när robots.txt returnerar 5xx eller 429
30 dagarGoogle fortsätter att använda den senaste fungerande robots.txt
5%daglig andel DNS-fel som ges som exempel på ett värdproblem
Källor: Google Search Central, HTTP-statuskoder och nätverksfel; Search Console-hjälpen, rapporten Genomsökningsstatistik
Genomsökningsfel är de punkter där en crawlers väg genom din webbplats bryts.
Alla typer av genomsökningsfel, förklarade med åtgärd
Här är hela listan du möter i Search Console och i crawlers, med orsak och åtgärd för var och en. Namnen följer Googles dokumentation om rapporten Sidindexering (Search Console-hjälpen).
DNS-fel
Google kunde inte översätta ditt domännamn till en IP-adress, eller så svarade inte DNS-servern. Vanliga orsaker: en utgången domän, ett avbrott hos DNS-leverantören, en felaktig post efter en migrering eller en felkonfigurerad DNSSEC. Kontrollera med en uppslagning utanför ditt nätverk:
Åtgärd: rätta posterna, sänk TTL före varje migrering och använd en DNS-leverantör med redundans. Om både example.com och www.example.com finns måste båda lösas upp, även om den ena bara omdirigerar.
Serveranslutningsfel och 5xx
Servern svarade inte i tid, stängde anslutningen eller svarade med 500, 502, 503 eller 504. Typiska orsaker: en överbelastad databas, en PHP- eller Node-process som kraschar under last, en timeout i en omvänd proxy, en pluginuppdatering eller en brandvägg som begränsar botar. Titta på tidsmönstret: fel vid samma klockslag varje natt pekar ofta på en säkerhetskopiering eller ett cron-jobb.
Åtgärd: läs serverns fellogg vid de tidpunkter Google rapporterar, höj timeouts eller antalet arbetsprocesser, cacha tunga sidor och se till att ditt botskydd släpper igenom verifierad Googlebot. Vid planerat underhåll, returnera 503 med en Retry-After-header i stället för en 200-sida som säger "tillbaka snart":
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 och 410 (Hittades inte)
Sidan finns inte. Det är okej när den raderades med avsikt och inget länkar till den. Det är ett problem när URL:en fortfarande har bakåtlänkar, trafik eller interna länkar, eller när sidan borde finnas och en driftsättning förstörde den.
Åtgärd: om innehållet flyttades, lägg till en enda 301 till den närmaste motsvarigheten. Om det är borta för gott, behåll 404 eller använd 410, och ta bort de interna länkar och sitemapposter som pekar dit. Omdirigera aldrig alla 404 till startsidan: Google tenderar att behandla dem som soft 404.
Soft 404
Servern säger 200 men sidan ser tom ut eller säger "hittades inte": en tom kategori, en söksida utan resultat, en slutsåld produkt utan innehåll. Google lägger en förfrågan på den och får ingenting. Vi går igenom detta på djupet i vår guide om soft 404-fel.
401, 403 och andra 4xx
Googlebot skickar aldrig inloggningsuppgifter, så en 401 eller 403 på en offentlig sida betyder att din server eller ett säkerhetslager blockerar den. Vanliga bovar: ett lösenord från testmiljön som lämnats kvar i produktion, en WAF-regel, en landsblockering eller ett hotlink-skydd som tillämpas på HTML. Åtgärda regeln, inte symptomet, och testa med verktyget för URL-inspektion i Search Console.
Omdirigeringsfel
Google rapporterar ett omdirigeringsfel när den stöter på en loop, en för lång kedja, en URL som överskrider maxlängden eller en felaktig eller tom URL i kedjan. Det klassiska fallet efter en migrering: http till https, sedan till www, sedan till ett avslutande snedstreck, sedan till en ny sökväg. Fyra hopp där ett hade räckt. Vår kompletta guide om omdirigeringar för SEO förklarar hur du slår ihop dem.
Tips
Klistra in en misstänkt URL i den kostnadsfria omdirigeringskontrollen från Sorank: den följer hela kedjan, visar varje hopp och dess statuskod och berättar var loopen eller det extra hoppet finns.
Timeouts, avbrutna svar och för stora sidor
Vissa fel visar aldrig någon statuskod. Sidan börjar laddas och stannar, eller så är den så tung att crawlern bara läser en del av den. Googles crawlers läser ett begränsat antal byte per fil, så en sida som är uppblåst av inbäddade skript eller base64-bilder kan förlora innehållet längst ner. Kontrollera tunga mallar med verktyget för sidstorlek.
Alla sätt att hitta genomsökningsfel, jämförda
Inget enskilt verktyg visar alla genomsökningsfel. Varje metod ser problemet från en annan vinkel, och en seriös granskning kombinerar minst två.
Metod 1: Search Console, rapporten Genomsökningsstatistik
Princip: Google visar sina egna genomsökningsförfrågningar under de senaste 90 dagarna, grupperade efter svar, filtyp, syfte och typ av Googlebot, samt värdstatus för DNS, server och robots.txt. När den ska användas: alltid, och först, för webbplatsfel. Fördelar: det är sanningen direkt från Google. Begränsningar: bara för egendomar på rotnivå, exempel i urval, och Google säger att webbplatser under tusen sidor sällan behöver den. Exempel: en topp av svar med "sidtimeout" varje söndag kl. 3 som sammanfaller med en databassäkerhetskopiering.
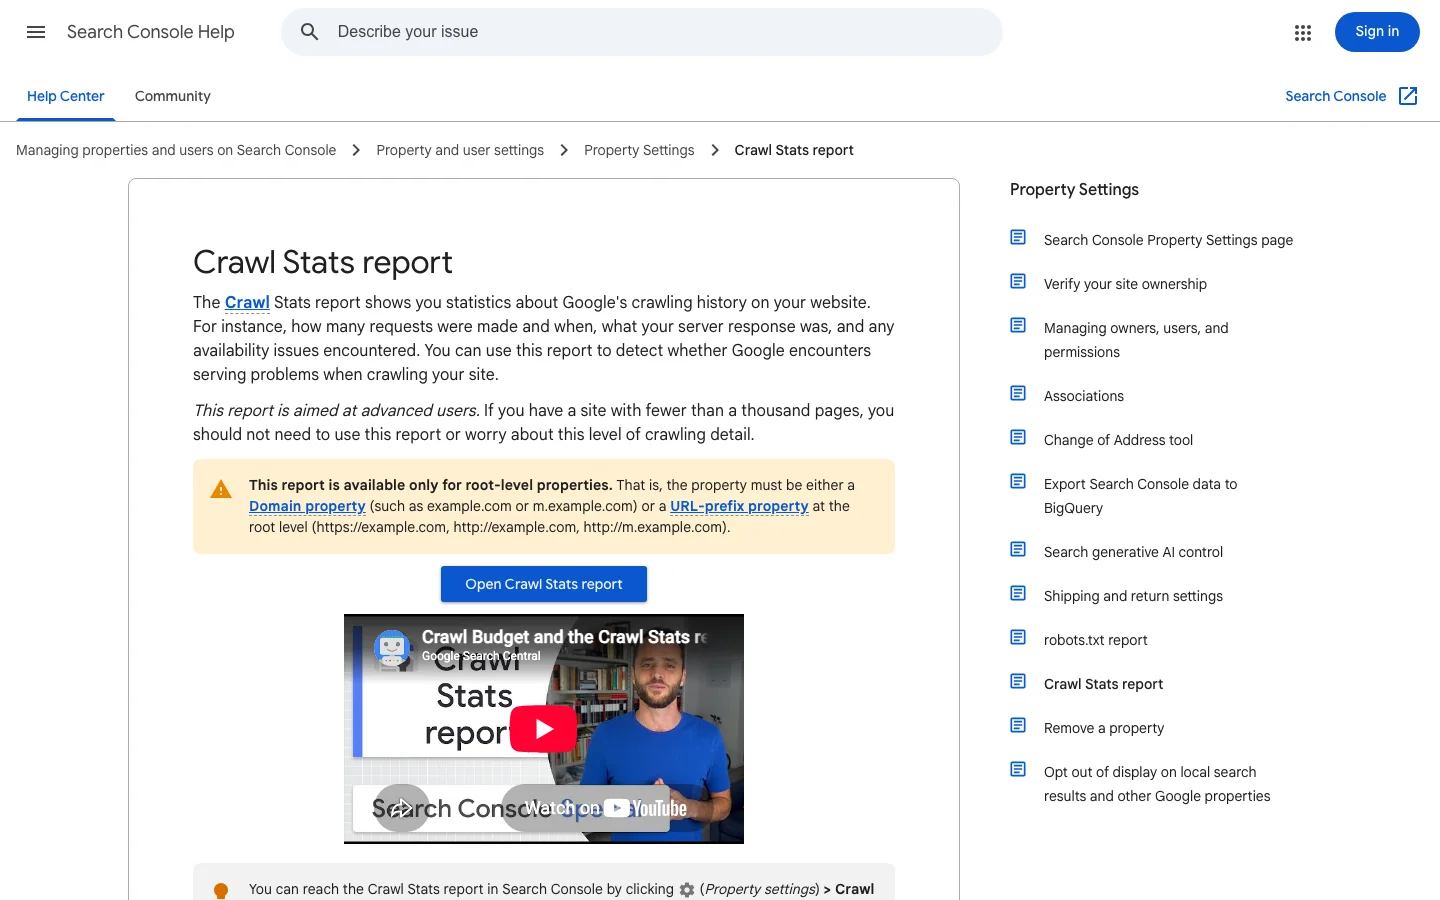
Googles dokumentation om rapporten Genomsökningsstatistik, där värdstatus för DNS, server och robots.txt förklaras.
Metod 2: Search Console, rapporten Sidindexering och URL-inspektion
Princip: listar URL:er som Google känner till och varför de inte är indexerade, med orsaker som Serverfel (5xx), Omdirigeringsfel, Hittades inte (404) eller Soft 404. När den ska användas: för att sortera URL-fel och validera åtgärder. Fördelar: kopplad till de sidor Google faktiskt försökte hämta. Begränsningar: rapporterna släpar efter med flera dagar, exempellistorna är begränsade och den blandar genomsökningsfel med indexeringsval. Exempel: 300 URL:er under "Omdirigeringsfel" som alla delar samma gamla prefix /blog/.
Metod 3: En crawler på datorn eller i molnet
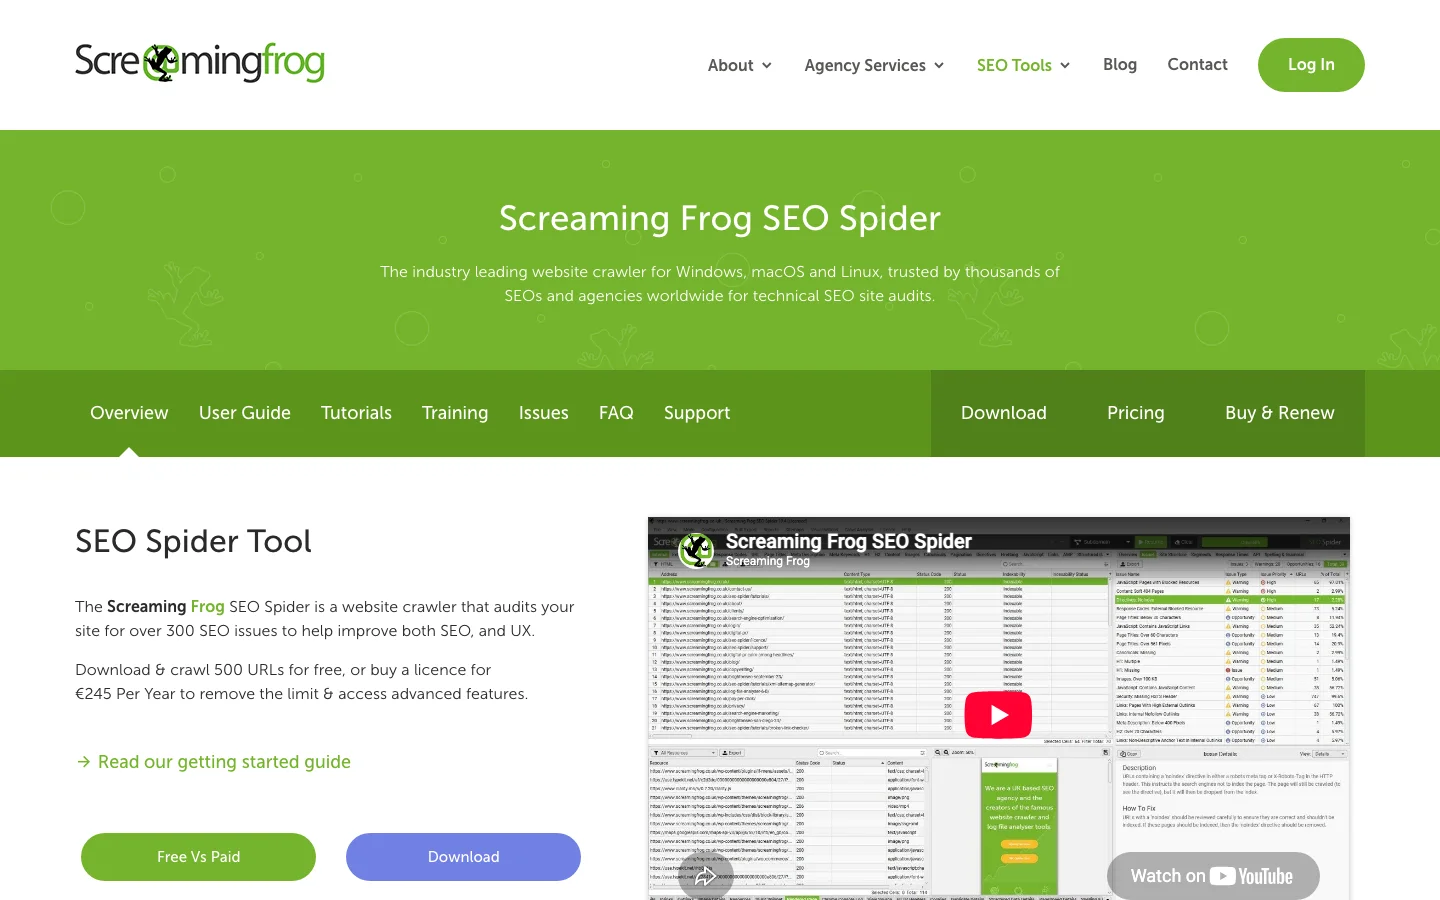
Princip: ett verktyg som Screaming Frog genomsöker din webbplats som en bot skulle göra, följer länkar från startsidan och loggar varje statuskod, omdirigeringskedja och trasig länk. När den ska användas: före och efter en migrering, en omdesign eller en stor driftsättning, och varje månad på stora webbplatser. Fördelar: omedelbar, komplett för länkade sidor, visar var varje trasig länk sitter. Begränsningar: den vet inte vad Google faktiskt begärde, missar föräldralösa sidor och din server kan behandla den annorlunda än Googlebot. Vår guide för att konfigurera Screaming Frog går igenom en fullständig granskning.
Screaming Frog SEO Spider genomsöker din webbplats som en bot och listar varje statuskod, omdirigeringskedja och trasig länk.
Metod 4: Analys av serverloggar
Princip: dina åtkomstloggar registrerar varje förfrågan, även de från Googlebot, Bingbot, GPTBot, ClaudeBot och PerplexityBot, med exakt statuskod och svarstid. När den ska användas: på stora webbplatser, efter oförklarade trafikfall och för att se vad AI-crawlers besöker. Fördelar: riktiga förfrågningar, riktiga koder, inget urval, alla botar. Begränsningar: kräver åtkomst till loggarna och lite skriptande; du måste verifiera att "Googlebot" verkligen är Google. Vår guide om logganalys för SEO går steg för steg. En snabb första titt:
# Googlebot-förfrågningar som inte returnerade 200, 301 eller 304, vanligast först
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Metod 5: Stickprov på enskilda URL:er
Princip: testa en URL i taget med curl eller en kostnadsfri onlinekontroll. När den ska användas: för att bekräfta en åtgärd eller kontrollera en viktig sida efter en driftsättning. Fördelar: omedelbar och exakt. Begränsningar: skalar inte. Använd en Googlebot-användaragent för att fånga regler som behandlar botar annorlunda:
5xx-fel: läs statuskoden för att hitta lagret som havererade
En 5xx-status betyder att servern inte kunde hantera en förfrågan som såg giltig ut. Google sänker sin genomsökning som svar, och sänker den mer när fler av dina URL:er ger fel. Google behåller redan indexerade URL:er en tid, men tar bort de som ger ett serverfel under lång tid. Ett kort utbrott går att återhämta sig från, eftersom Google gradvis höjer genomsökningstakten igen när din server svarar med 2xx-koder. Ett långt sammanhängande fel är det som skadar ditt index.
Koden visar vilket lager som gick sönder
Varje 5xx-kod pekar på en annan del av stacken. Tabellen ger dig ett första ställe att titta på för var och en.
Kod
Vad det oftast betyder
Titta på först
500
Applikationen föll när den hanterade förfrågan
Applikationens felogg vid exakt den tidpunkt då förfrågan kom
502
Proxyn eller CDN:en fick ett ogiltigt svar från applikationen, ofta för att den kraschade eller startade om
Omstarter och drifttid för applikationsprocessen
503
Tjänsten är överbelastad, begränsad av hastighetsgränser eller under underhåll
Belastningsgrafer, driftsättningshistorik och underhållsfönster
504
Proxyn gav upp och väntade inte längre på applikationen
Långsamma databasfrågor och timeout-inställningar i proxyn
429
En hastighetsbegränsare säger att det kommer för många förfrågningar
Regler för hastighetsbegränsning, och om de gäller verifierad Googlebot
Matcha Googles tidsstämplar med dina loggar
Genomsökningsstatistiken visar de dagar och timmar när Google stötte på fel (vår guide till genomsökningsstatistik förklarar varje graf). Din serverlogg visar vad som hände just då. Filtrera förfrågningarna från Googlebot och räkna 5xx-svaren per timme:
Varje rad i utdatan är en timme, en statuskod och ett antal. Ett kluster under samma timme varje natt pekar oftast på en backup, ett cron-jobb eller en schemalagd import. Fel som sprids över hela dygnet pekar oftare på belastning, så lösningen är kapacitet eller cachning snarare än en enskild bugg. För en djupare metod, se vår guide till analys av serverloggar.
Mät vad ett 5xx kostar innan du panikar
Google minskar genomsökningen i proportion till antalet URL:er som ger fel. En trasig mall som påverkar några få URL:er kostar lite genomsökningstid. Ett databasavbrott som slår ut varje sida kostar mycket, och det är den du ska åtgärda först.
Ett 429-svar har samma effekt som ett 5xx, eftersom Google läser det som en överbelastad server. Om din hastighetsbegränsare eller ditt botskydd returnerar 429 till Googlebot betalar du för det i genomsökningstid. Googles dokumentation nämner inte rubriken Retry-After. Fortsätt skicka den till mänskliga besökare och API-klienter, men förlita dig inte på att Googlebot väntar så länge som du angett.
4xx-fel: ta reda på var de kommer ifrån innan du åtgärdar dem
En 4xx-status betyder att servern avvisade förfrågan på grund av något på klientsidan: URL:en finns inte, åtkomst är förbjuden eller adressen är felaktigt utformad. Google behandlar alla 4xx-koder utom 429 likadant. Google slutar använda innehållet bakom URL:en och tar bort URL:en från indexet om den var indexerad. Innan du rör en 4xx-kod, ta reda på varifrån förfrågan kommer, eftersom åtgärden ofta sitter på ett enda ställe: en länk, en mall eller en omdirigeringsregel.
Hitta källan till varje 4xx-fel i dina loggar
Din åtkomstlogg registrerar hänvisaren för varje förfrågan, vilket visar vilken sida som skickade besökaren eller boten till den URL:en. Räkna 4xx-svaren per sökväg och per hänvisare:
En hänvisare på din egen domän betyder att en av dina sidor länkar till en död URL. Åtgärda länken eller mallen som skriver ut den. Det här är den mest värdefulla åtgärden, eftersom du själv styr den. Vår guide om hur du åtgärdar trasiga länkar tar upp hela metoden.
En hänvisare från en annan webbplats betyder att en bakåtlänk pekar på en URL som inte längre fungerar. Om länken är värd att behålla, lägg till en enda 301 till närmaste fungerande sida. Om den inte är det, låt 404-felet vara kvar.
En tom hänvisare, eller en sökväg du aldrig publicerat, till exempel en inloggningssida på en statisk webbplats, betyder oftast att en bot eller en skanner har provat adressen. Låt den svara med 404 och lägg inte tid på den.
Upptäck 4xx-toppar direkt efter varje release
En release som byter namn på en rutt, ändrar en slug eller bygger om en mall ger ofta en våg av 404-fel samma dag. Exportera antalet 4xx-svar per dag för veckan före driftsättningen och veckan efter. Ett hopp som samlas i en enda mapp pekar rakt på ändringen. Lägg till omdirigeringen från den gamla URL:en till den nya i samma release, inte i ett senare ärende. För en fullständig flytt, se vår checklista för SEO-migrering.
Tips
Ersätt inte en saknad sida med ett 200-svar som visar ett kort meddelande eller en tom lista. Google kan behandla den som en soft 404, vilket kostar en full hämtning och inte ger något tillbaka.
Steg för steg: åtgärda genomsökningsfel i rätt ordning
Det här är metoden vi använder. Den går från felen som kan stoppa hela webbplatsen till dem som bara slösar lite genomsökning.
Metoden i 6 steg för genomsökningsfel
Kontrollera värdstatusÖppna Genomsökningsstatistik och titta på DNS, serveranslutning och robots.txt för de senaste 90 dagarna.
Exportera och gruppera URL-felExportera varje orsak i Sidindexering och gruppera URL:erna efter mapp eller mall.
Sortera efter värdeBehåll URL:erna med trafik, bakåtlänkar, interna länkar eller poster i sitemapen.
Åtgärda orsaken på mallnivåEn regel, en omdirigeringskarta eller en serverinställning åtgärdar hundratals URL:er.
Städa signalernaUppdatera interna länkar och sitemaps så att de pekar på slutliga 200-URL:er.
Validera och övervakaKlicka på Validera åtgärd och följ sedan Genomsökningsstatistik och dina loggar varje vecka.
Steg 1: kontrollera värden först
I Search Console, öppna Inställningar, sedan Genomsökningsstatistik, sedan Värdstatus. Grönt betyder inget betydande problem på 90 dagar. "Nyligt problem" betyder ett betydande problem den senaste veckan: släpp allt annat. Klicka på varje kategori för att se felfrekvensen per dag och matcha sedan de dåliga dagarna med din hosting-, CDN- och driftsättningshistorik.
Steg 2: exportera och gruppera efter mönster
Öppna Indexering, sedan Sidor, och exportera varje felorsak. Åtgärda inte URL:er en och en. Lägg dem i ett kalkylark och extrahera den första mappen:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
En pivottabell på den kolumnen visar oftast att de flesta fel kommer från två eller tre mallar: en nedlagd bloggkategori, en filterparameter, ett gammalt produktflöde.
Steg 3: sortera efter affärsvärde
Ställ fyra frågor för varje mönster. Får den organiska klick? Har den bakåtlänkar? Länkas den internt? Finns den i sitemapen? En 404 utan något av de fyra kan vänta för evigt. En 404 med bakåtlänkar behöver en 301 i dag. Den kostnadsfria kontrollen av trasiga länkar visar vilka av dina egna sidor som fortfarande länkar till döda URL:er.
Steg 4: åtgärda grundorsaken
Åtgärda regler, inte URL:er. En omdirigeringskarta i serverkonfigurationen slår 400 omdirigeringar som lagts in för hand i ett plugin. Till exempel i nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
För 5xx, åtgärda kapaciteten eller buggen. För 401 och 403, åtgärda säkerhetsregeln. För soft 404, lägg antingen till riktigt innehåll eller returnera en riktig 404.
Steg 5: städa interna länkar och sitemaps
Varje intern länk bör peka direkt på en URL som returnerar 200. Varje post i sitemapen bör vara en kanonisk, indexerbar 200-URL. En sitemap full av omdirigeringar och 404 lär Google att lita mindre på den. Vår guide om hur du skapar en sitemap förklarar vad som hör hemma där.
Steg 6: validera och övervaka
I rapporten Sidindexering, öppna den åtgärdade orsaken och klicka på Validera åtgärd. Google kontrollerar först ett urval och sedan resten; det tar vanligtvis upp till ungefär två veckor, och valideringen stoppas om en enda URL fortfarande misslyckas. Klicka inte igen medan den pågår. Inför sedan en veckorutin: Genomsökningsstatistik för värden, loggar för toppar, en genomsökning efter varje driftsättning.
En omdirigeringskedja före och efter åtgärden
Före
http://site.com/page
301 till https://site.com/page
301 till https://www.site.com/page
301 till https://www.site.com/page/
Interna länkar pekar fortfarande på den första URL:en
Efter
En 301 direkt till https://www.site.com/page/
Interna länkar uppdaterade till den slutliga URL:en
Sitemapen listar bara den slutliga URL:en
En förfrågan i stället för fyra
Vanliga misstag, och hur du upptäcker och rättar dem
Misstag 1: omdirigera alla 404 till startsidan
Vad det är: ett plugin eller en regel som skickar varje saknad URL till /. Hur du upptäcker det: många URL:er under "Soft 404" eller "Sida med omdirigering" som alla hamnar på startsidan; en crawler visar hundratals 301 med samma mål. Hur du rättar det: omdirigera bara till en nära motsvarighet och låt resten returnera 404 eller 410.
Misstag 2: blockera Googlebot med säkerhetsverktyg
Vad det är: en WAF, bothanterare eller hastighetsbegränsare som serverar 403, 429 eller en utmaningssida till Google. Hur du upptäcker det: 403 eller 429 i Genomsökningsstatistik, medan sidan laddas fint i din webbläsare; loggarna visar blockeringarna per IP. Hur du rättar det: tillåt verifierad Googlebot via omvänd DNS eller Googles publicerade IP-intervall, i stället för att lita på användaragentsträngen.
Misstag 3: en ömtålig robots.txt
Vad det är: robots.txt genereras av applikationen, så den misslyckas varje gång applikationen gör det, eller serveras via en CDN-regel som cachar en 5xx. Hur du upptäcker det: kategorin för hämtning av robots.txt i Värdstatus är inte grön. Hur du rättar det: servera den som en statisk fil, utanför applikationen, och testa den med robots.txt-kontrollen.
Misstag 4: underhållssidor som returnerar 200
Vad det är: en sida "Vi är snart tillbaka" som serveras med status 200 på alla URL:er. Hur du upptäcker det: efter underhållet, en våg av soft 404 eller dubblerade titlar. Hur du rättar det: returnera 503 med Retry-After under underhållet, och håll det kort.
Misstag 5: använda 403 för att bromsa Google
Vad det är: svara 403 till Googlebot när servern är överbelastad. Hur du upptäcker det: toppar av 403 som sammanfaller med lasttoppar. Hur du rättar det: Google säger att andra 4xx-koder än 429 inte påverkar genomsökningstakten. Returnera 503 eller 429 en kort stund och åtgärda kapaciteten.
Misstag 6: åtgärda fel ett i taget
Vad det är: klicka igenom listan i Search Console och redigera varje URL. Hur du upptäcker det: samma orsak kommer tillbaka varje månad. Hur du rättar det: gruppera efter mönster, åtgärda mallen eller regeln och validera sedan en gång.
Misstag 7: få panik över ofarliga 404
Vad det är: lägga dagar på 404 för skräp-URL:er eller sidor som raderades för länge sedan och saknar länkar. Hur du upptäcker det: URL:erna har inga klick, inga bakåtlänkar och inga interna länkar. Hur du rättar det: låt dem vara. Google säger att en 404 för en borttagen sida inte nödvändigtvis är ett problem.
Varning
Blockera aldrig en URL i robots.txt för att "dölja" ett genomsökningsfel. Google kan inte längre se 404:an eller omdirigeringen, URL:en kan förbli indexerad och du förlorar den signal du försökte skicka.
Genomsökningsfel och genomsökningsbudget
På en webbplats med några hundra sidor har Google tid för allt, och genomsökningsfel spelar främst roll för de sidor de förstör. På stora webbplatser (butiker med filter, marknadsplatser, nyhetssajter) tar varje misslyckad eller slösad förfrågan tid från dina riktiga sidor. Det är idén bakom genomsökningsbudget.
Hur fel äter upp genomsökningskapacitet
5xx och 429 får Google att sakta ner på hela värden, så några trasiga mallar kan fördröja genomsökningen av dina nya produktsidor. Omdirigeringskedjor kostar en förfrågan per hopp. Soft 404 kostar en hel hämtning och ger ingenting tillbaka. Åtgärda de tre så räcker samma budget till fler användbara sidor.
Vad "Upptäckt, inte indexerad" har med saken att göra
När Google hittar URL:er men skjuter upp genomsökningen är orsaken ofta en server som Google anser vara ömtålig. Om du ser ett växande antal "Upptäckt, för närvarande inte indexerad" samtidigt som serverfel i Genomsökningsstatistik, åtgärda servern först. De två rapporterna berättar samma historia.
Genomsökningsfel för AI-crawlers
Googlebot är inte längre den enda besökaren som spelar roll. GPTBot, OAI-SearchBot, ClaudeBot och PerplexityBot hämtar sidor för att träna modeller eller svara på frågor i realtid. De träffar samma server och lider av samma fel, med en skillnad: du har ingen Search Console för dem.
Vad som ändras med AI-botar
De flesta AI-crawlers kör inte JavaScript, så en sida som bara bygger sitt innehåll i webbläsaren kan se tom ut för dem, en sorts soft 404 som du aldrig kommer att se i Googles rapporter. Många blockeras som standard av botskyddstjänster, ofta med en 403. Och eftersom de hämtar på begäran när en användare ställer en fråga betyder en timeout i det ögonblicket att svaret citerar någon annan. Vår guide om JavaScript och SEO tar upp rendering för både sök- och AI-crawlers.
Hur du övervakar dem
Dina serverloggar är den enda pålitliga källan. Filtrera på användaragent och titta på statuskoderna:
Om AI-botar får 403 som du inte avsåg, åtgärda regeln. Kontrollera sedan om de faktiskt citerar dig: Soranks bevakning av AI-omnämnanden följer hur ofta ChatGPT, Gemini, Claude och Perplexity nämner ditt varumärke, så att du ser om en genomsökningsåtgärd ändrar något.
Din checklista för genomsökningshälsa
Gå igenom listan efter varje migrering, omdesign eller större driftsättning, och en gång i månaden på stora webbplatser.
Checklista för genomsökningshälsa
Värdstatus grön för DNS, serveranslutning och robots.txt
robots.txt serveras som statisk fil och returnerar 200
Inga toppar av 5xx eller 429 i Genomsökningsstatistik eller loggar
Verifierad Googlebot och önskade AI-botar blockeras inte av brandväggen
Varje omdirigering är ett hopp, 301 eller 308, till en 200-sida
Interna länkar pekar på slutliga 200-URL:er
Sitemaps listar bara kanoniska, indexerbara 200-URL:er
404 med bakåtlänkar eller trafik omdirigeras till en nära motsvarighet
Tomma sidor åtgärdade eller returnerar en riktig 404
Underhåll returnerar 503 med Retry-After
Validera åtgärd startad för varje rättad orsak
Vad du kan göra i dag
Öppna Genomsökningsstatistik och kontrollera de tre raderna för värdstatus. Kör sedan den kostnadsfria indexerbarhetskontrollen på dina fem mest värdefulla sidor. Om båda är rena, exportera felen i Sidindexering och gruppera dem efter mapp: då har du en kort, rangordnad åtgärdslista i stället för en skrämmande rapport.
När genomsökningen är ren är nästa gräns själva innehållet. Soranks innehållsoptimering skriver om och uppdaterar dina befintliga sidor på autopilot, så att de sidor Google nu kan nå är värda att indexera och citera. För de sidor Google genomsökte men lämnade utanför, läs vår guide om "Genomsökt, för närvarande inte indexerad".
Vanliga frågor
Vad är genomsökningsfel inom SEO?
Genomsökningsfel är förfrågningar från en sökmotor eller AI-crawler som misslyckas: DNS löses inte upp, servern får timeout eller returnerar 5xx, robots.txt kan inte hämtas, en omdirigering går i loop eller en sida returnerar en 4xx-kod. Fel på webbplatsnivå kan pausa genomsökningen av hela webbplatsen, medan URL-fel bara påverkar den berörda sidan.
Är 404-fel dåliga för SEO?
Inte i sig. Google säger att en 404 för en sida som tagits bort utan ersättning inte nödvändigtvis är ett problem. Det blir ett när URL:en fortfarande har bakåtlänkar, trafik eller interna länkar, och då är en enda 301 till en nära motsvarighet rätt åtgärd.
Hur lång tid tar det innan Google ser att genomsökningsfelen är åtgärdade?
När du har klickat på Validera åtgärd i rapporten Sidindexering i Search Console tar valideringen vanligtvis upp till ungefär två veckor. Google kontrollerar först ett urval av URL:er och sedan resten, och valideringen stoppas om en enda berörd URL fortfarande misslyckas.
y!
Få din innehållsplan för 30 dagar gratis
Vi analyserar dina konkurrenter, din webbplats och din synlighet i AI för att skapa en skräddarsydd innehållsplan, gratis.
“Jag testade Sorank på en riktig kundsajt och det är helt otroligt. Det gör allt som en byrå skulle ta 1500 dollar i månaden för. Den används nu i produktion för den kunden.”Guillaume Guersanguersanguillaume.com
“Vi är en annonsbyrå och ville få igång vår SEO på rätt spår en gång för alla. Sorank gav oss en tydlig bild av vår webbplats, hjälpte oss att prioritera optimeringarna och att strukturera vårt innehåll på rätt sätt. Verktyget är lätt att använda, väl genomtänkt för ett team och mycket praktiskt för att samla uppföljningen på ett ställe utan att jonglera med flera plattformar. En mycket stabil grund för att börja om från början med vår SEO.”Gaspard MadouiAnnonsbyrå
“Jag specialiserade mig på GEO tack vare Sorank. GEO-rankningen gör det möjligt för mig att visa mina kunder deras position jämfört med konkurrenterna i ChatGPT. Det är en verklig konkurrensfördel.”MélanieFrilans SEO-konsult
“Bra service, den fungerar bra för vår webbplats och hjälper oss att förstå hur vi kan förbättra den för att rankas bättre på Google och på andra ställen. Grattis, fortsätt så, jag rekommenderar det.”Hugo T.Handlare inom e-handel