Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Ret crawlfejl: DNS, server, robots.txt, 404, soft 404 og omdirigeringsfejl. Sådan reagerer Googlebot på hver fejl, og en metode i 6 trin til at rette dem.

Værktøjer

Kort sagt
crawlfejl er de forespørgsler, som en søgemaskine eller AI-crawler sender til dit website, og som mislykkes: serveren svarer ikke i tide, DNS svarer ikke, robots.txt kan ikke hentes, en omdirigering kører i ring, eller en side returnerer en 4xx- eller 5xx-kode. Fejl på websiteniveau (DNS, server, robots.txt) kan stoppe Googles crawling af hele dit website, så ret dem først; fejl på URL-niveau (404, soft 404, omdirigeringsfejl) betyder kun noget, når de rammer sider, du vil have indekseret. Du finder dem i Search Consoles rapporter Crawlstatistik og Sideindeksering, bekræfter dem med en crawler og dine serverlogs, retter årsagen og validerer.
Vil du vide mere? Spørg
Hurtig quiz
Hvem skal rette den tekniske side af dit site?
Vores anbefaling til dig
Tjek det selv med gratis Google-værktøjer
Search Console lister de sider, Google ikke kan læse, og PageSpeed Insights tester hastigheden. Mange små problemer rettes fra indstillingerne i dit website-værktøj.
Vores anbefaling til dig
En webudvikler
Dit problem sidder i koden eller serveren: en udvikler, der kender SEO, er den rette person. Giv dem listen over fejl fra Search Console.
Vores anbefaling til dig
Et værktøj til teknisk revision
Dit site har mange sider: en crawler læser dem alle, ligesom Google gør, og giver en komplet liste over fejl at rette, side for side.
Vores anbefaling til dig
En automatisk revision, derefter indhold
Dit site virker, men bringer få besøgende: tekniske problemer er sjældent årsagen. Sorank reviderer sitet og skriver derefter de sider, der giver trafik.
En crawler fungerer som en meget tålmodig besøgende. Den beder din server om en URL, venter på svar, læser statuskoden og indholdet og går så videre til de links, den fandt. En crawlfejl er ethvert trin i den kæde, der mislykkes. Den besøgende får aldrig en brugbar side.
Definitionen er vigtig, fordi mange rapporter blander crawlfejl sammen med indekseringsbeslutninger. "Crawlet, ikke indekseret i øjeblikket" er ikke en crawlfejl: Google hentede siden fint og valgte ikke at beholde den. "Udelukket af noindex" er heller ikke en crawlfejl: du bad Google om at fjerne siden. En crawlfejl betyder, at selve hentningen gik galt.
Google deler problemerne op i to niveauer, og det bør du også gøre.
Websitefejl over for URL-fejl
En webshop med 4000 gamle produkt-URL'er, der returnerer 404, kan være helt sund, hvis produkterne er væk for altid. Den samme webshop med en robots.txt, der returnerer 503 i seks timer, har en reel nødsituation, selv om alle produktsider virker. Start med værten, derefter de URL'er, der tjener penge, og så resten.
For at rette crawlfejl ordentligt skal du vide, hvad Google faktisk gør, når den støder på en. Googles dokumentation om hvordan HTTP-statuskoder og netværksfejl påvirker Google Søgning (Google Search Central) giver reglerne. Her er, hvad de betyder i praksis.
| Svar | Hvad Google gør | Er det et problem? |
|---|---|---|
| 2xx | Sender indholdet videre til indeksering. Indeksering er ikke garanteret. | Nej, medmindre siden er tom (soft 404). |
| 301, 308 | Stærkt signal om, at målet er den nye URL. | Nej, hvis det er ét hop til en 200. |
| 302, 303, 307 | Svagt signal: den oprindelige URL har tendens til at forblive den kanoniske. | Ja, hvis flytningen er permanent. |
| 3xx-kæder | Følger op til 10 hop som standard og giver så op. | Ja: hvert hop spilder en forespørgsel, og løkker bliver aldrig løst. |
| 404, 410, andre 4xx (undtagen 429) | Behandler indholdet som ikke-eksisterende, fjerner indekserede URL'er over tid og crawler dem sjældnere. | Kun hvis siden burde findes. |
| 401, 403 | Samme som andre 4xx. De sænker ikke crawlingen. | Ja, hvis de blokerer Googlebot fra offentlige sider. |
| 429 | Behandles som et signal om overbelastet server, ligesom en 5xx. | Ja: crawlingen sænkes. |
| 5xx | Sænker crawlingen i forhold til antallet af fejl. URL'er, der bliver ved med at fejle, fjernes fra indekset. | Ja, altid. |
To detaljer snyder mange teams. For det første sænker 401 og 403 ikke crawlhastigheden. Hvis din server har det svært, hjælper det ikke at returnere 403 til Googlebot; Google beder dig i stedet midlertidigt returnere 503 eller 429. For det andet er en 404 ikke en straf. Det er det rigtige svar for en side, der er væk.
Googles dokumentation om rapporten Crawlstatistik (Search Console Hjælp) forklarer reglen. En robots.txt, der svarer 200 (selv tom) eller 403, 404 eller 410 (ingen fil), er i orden. En robots.txt, der svarer 429 eller 5xx, er en fejl, og så spiller Google sikkert.
Hvad Google gør, når robots.txt bliver ved med at fejle
Kilde: Search Console Hjælp, rapporten Crawlstatistik
En CDN-regel eller en firewall, der leverer 503 på /robots.txt, kan altså fryse hele dit website i et halvt døgn, selv om alle andre URL'er virker. Tjek denne fil først i enhver undersøgelse af crawlfejl. Vores guide til statussen "Blokeret af robots.txt" dækker det modsatte problem, når filen virker, men blokerer for meget.
Googles crawlgrænser, der er værd at huske
Kilder: Google Search Central, HTTP-statuskoder og netværksfejl; Search Console Hjælp, rapporten Crawlstatistik
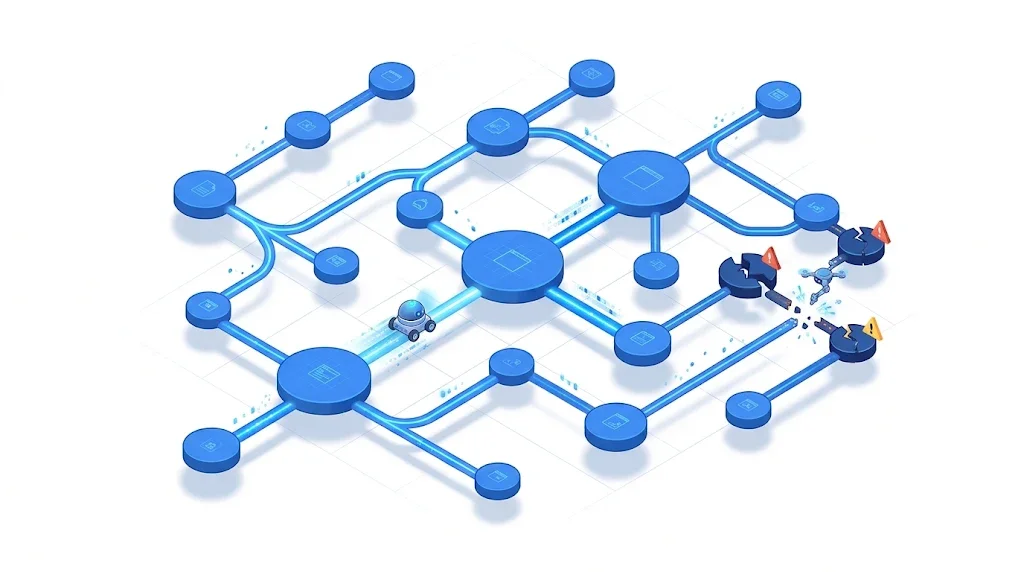
Her er den fulde liste, du møder i Search Console og i crawlere, med årsag og løsning for hver. Navnene følger Googles dokumentation om rapporten Sideindeksering (Search Console Hjælp).
Google kunne ikke oversætte dit domænenavn til en IP-adresse, eller DNS-serveren svarede ikke. Typiske årsager: et udløbet domæne, et nedbrud hos DNS-udbyderen, en forkert post efter en migrering eller en fejlkonfigureret DNSSEC. Tjek med et opslag uden for dit netværk:
dig +short example.com A
dig +short www.example.com CNAME
dig example.com +dnssec
Løsning: ret posterne, sænk TTL før enhver migrering, og brug en DNS-udbyder med redundans. Hvis både example.com og www.example.com findes, skal begge kunne slås op, selv om den ene kun omdirigerer.
Serveren svarede ikke i tide, lukkede forbindelsen eller svarede med 500, 502, 503 eller 504. Typiske årsager: en overbelastet database, en PHP- eller Node-proces, der går ned under belastning, en timeout i en reverse proxy, en pluginopdatering eller en firewall, der begrænser bots. Se på tidsmønstret: fejl på samme tidspunkt hver nat peger ofte på en backup eller et cron-job.
Løsning: læs serverens fejllog på de tidspunkter, Google angiver, hæv timeouts eller antallet af workers, cache tunge sider, og sørg for, at din botbeskyttelse lukker verificeret Googlebot igennem. Ved planlagt vedligeholdelse skal du returnere 503 med en Retry-After-header i stedet for en 200-side, der siger "tilbage snart":
HTTP/1.1 503 Service Unavailable
Retry-After: 3600Siden findes ikke. Det er i orden, når den blev slettet med vilje, og intet linker til den. Det er et problem, når URL'en stadig har backlinks, trafik eller interne links, eller når siden burde findes, og en udrulning ødelagde den.
Løsning: hvis indholdet er flyttet, så tilføj én 301 til det nærmeste tilsvarende. Hvis det er væk for altid, så behold 404 eller brug 410, og fjern de interne links og sitemap-poster, der peger på det. Omdirigér aldrig alle 404 til forsiden: Google har tendens til at behandle dem som soft 404.
Serveren siger 200, men siden ser tom ud eller siger "ikke fundet": en tom kategori, en søgeside uden resultater, et udsolgt produkt uden indhold. Google bruger en forespørgsel på den og får intet. Vi gennemgår den i dybden i vores guide til soft 404-fejl.
Googlebot sender aldrig loginoplysninger, så en 401 eller 403 på en offentlig side betyder, at din server eller et sikkerhedslag blokerer den. Typiske syndere: en adgangskode fra testmiljøet, der er glemt i produktion, en WAF-regel, en landeblokering eller en hotlink-beskyttelse, der rammer HTML. Ret reglen, ikke symptomet, og test med værktøjet til URL-inspektion i Search Console.
Google rapporterer en omdirigeringsfejl, når den møder en løkke, en for lang kæde, en URL, der overskrider maksimallængden, eller en forkert eller tom URL i kæden. Det klassiske tilfælde efter en migrering: http til https, så til www, så til en afsluttende skråstreg, så til en ny sti. Fire hop, hvor ét ville være nok. Vores komplette guide til omdirigeringer til SEO forklarer, hvordan du samler dem.
Tip
Indsæt en mistænkelig URL i den gratis omdirigeringstjekker fra Sorank: den følger hele kæden, viser hvert hop og dets statuskode og fortæller dig, hvor løkken eller det ekstra hop sidder.
Nogle fejl viser aldrig en statuskode. Siden begynder at indlæse og stopper, eller den er så tung, at crawleren kun læser en del af den. Googles crawlere læser et begrænset antal byte pr. fil, så en side, der er pustet op af indlejrede scripts eller base64-billeder, kan miste indholdet i bunden. Tjek tunge skabeloner med værktøjet til sidestørrelse.
Intet enkelt værktøj viser alle crawlfejl. Hver metode ser problemet fra en anden vinkel, og en seriøs gennemgang kombinerer mindst to.
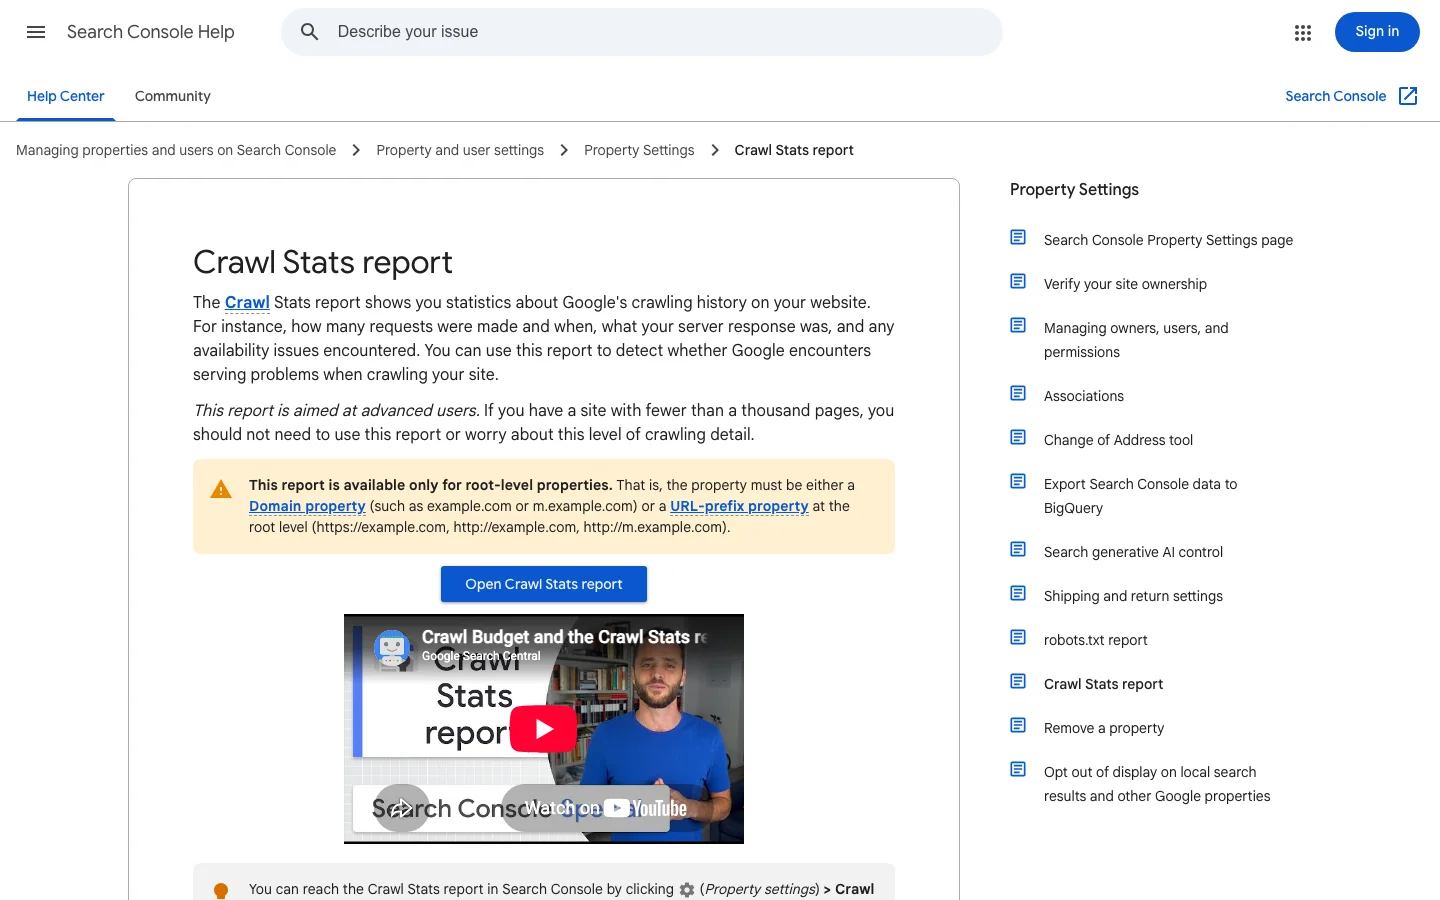
Princip: Google viser sine egne crawlforespørgsler fra de seneste 90 dage, grupperet efter svar, filtype, formål og type af Googlebot, plus værtsstatus for DNS, server og robots.txt. Hvornår den bruges: altid, og først, til websitefejl. Fordele: det er sandheden direkte fra Google. Begrænsninger: kun for ejendomme på rodniveau, eksempler i udvalg, og Google siger, at websites under tusind sider sjældent har brug for den. Eksempel: en top af svar med "sidetimeout" hver søndag kl. 3, der falder sammen med en databasebackup.
Princip: viser de URL'er, Google kender, og hvorfor de ikke er indekseret, med årsager som Serverfejl (5xx), Omdirigeringsfejl, Ikke fundet (404) eller Soft 404. Hvornår den bruges: til at sortere URL-fejl og validere rettelser. Fordele: knyttet til de sider, Google faktisk forsøgte. Begrænsninger: rapporterne er flere dage forsinkede, eksempellisterne er begrænsede, og den blander crawlfejl med indekseringsvalg. Eksempel: 300 URL'er under "Omdirigeringsfejl", der alle deler det samme gamle præfiks /blog/.
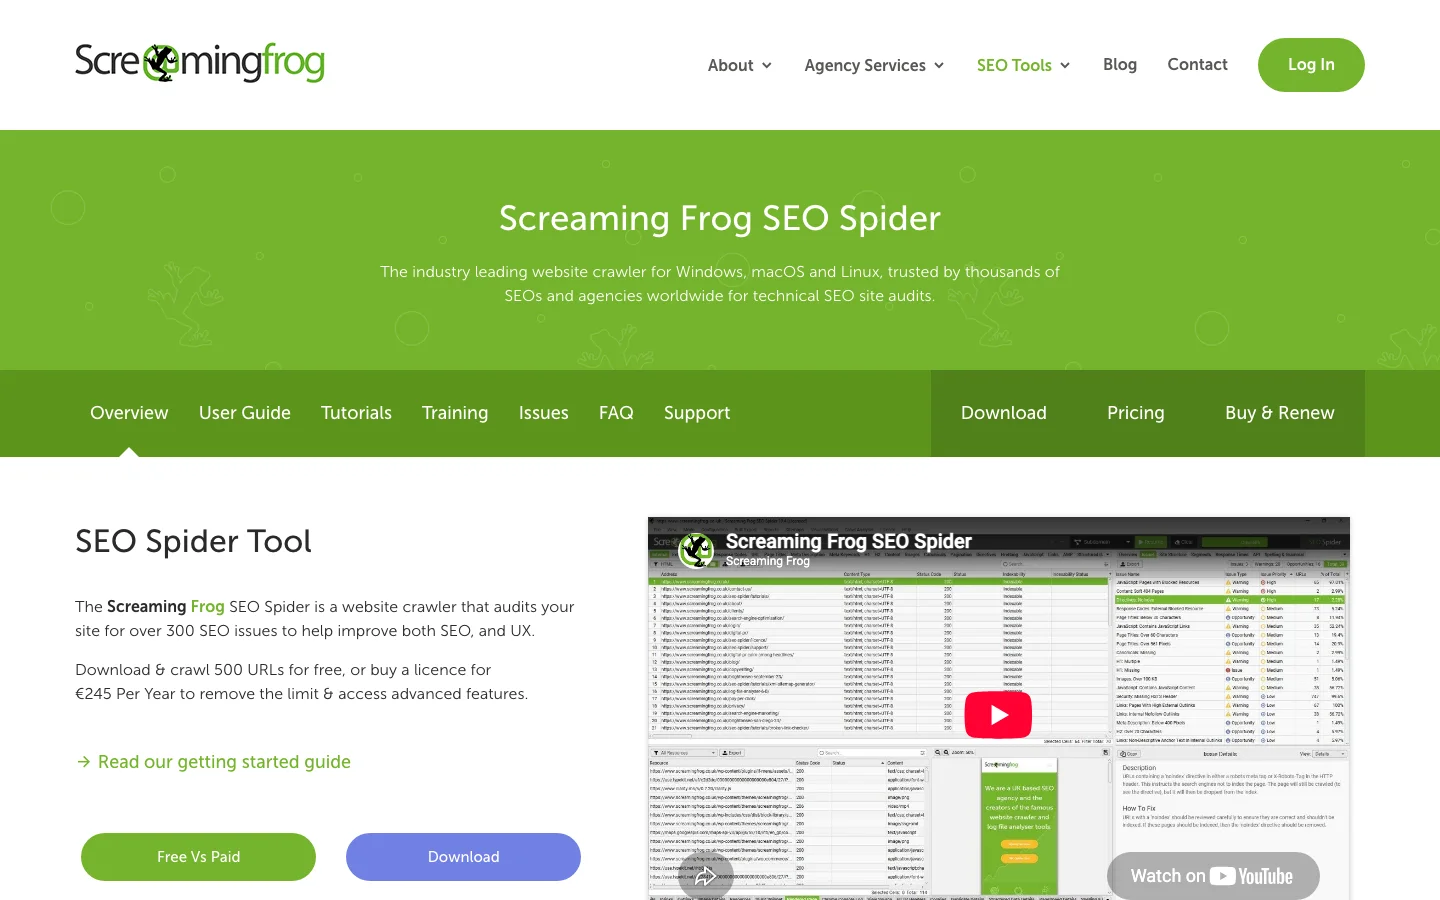
Princip: et værktøj som Screaming Frog crawler dit website, som en bot ville gøre, følger links fra forsiden og logger hver statuskode, omdirigeringskæde og ødelagt link. Hvornår den bruges: før og efter en migrering, et redesign eller en stor udrulning, og hver måned på store websites. Fordele: øjeblikkelig, komplet for linkede sider, viser hvor hvert ødelagt link sidder. Begrænsninger: den ved ikke, hvad Google faktisk forespurgte, overser forældreløse sider, og din server kan behandle den anderledes end Googlebot. Vores guide til opsætning af Screaming Frog gennemgår en komplet audit.
Princip: dine adgangslogs registrerer hver forespørgsel, også dem fra Googlebot, Bingbot, GPTBot, ClaudeBot og PerplexityBot, med præcis statuskode og svartid. Hvornår den bruges: på store websites, efter uforklarlige trafikfald og for at se, hvad AI-crawlere besøger. Fordele: rigtige forespørgsler, rigtige koder, intet udvalg, alle bots. Begrænsninger: kræver adgang til logs og lidt scripting; du skal verificere, at "Googlebot" virkelig er Google. Vores guide til loganalyse til SEO går trin for trin. Et hurtigt første kig:
# Googlebot-forespørgsler, der ikke returnerede 200, 301 eller 304, hyppigste først
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50Princip: test én URL ad gangen med curl eller en gratis onlinetjekker. Hvornår den bruges: til at bekræfte en rettelse eller tjekke en vigtig side efter en udrulning. Fordele: øjeblikkelig og præcis. Begrænsninger: skalerer ikke. Brug en Googlebot-brugeragent for at fange regler, der behandler bots anderledes:
curl -sI -A "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)" https://example.com/page/
curl -sIL https://example.com/old-page/ | grep -iE "^(HTTP|location)"| Metode | Ser websitefejl | Ser URL-fejl | Rigtige Googlebot-data | Ser AI-crawlere | Bedst til |
|---|---|---|---|---|---|
| Crawlstatistik | Ja | I udvalg | Ja | Nej | Værtens sundhed |
| Sideindeksering | Delvist | Ja | Ja | Nej | Sortering og validering |
| Crawler (Screaming Frog...) | Nej | Ja, linkede sider | Nej | Nej | Finde ødelagte links ved kilden |
| Serverlogs | Delvist | Ja | Ja | Ja | Store websites, grundårsager |
| Tjek af enkelt URL | Nej | Én ad gangen | Nej | Nej | Bekræfte rettelser |
En 5xx-status betyder, at serveren ikke kunne håndtere en anmodning, der så gyldig ud. Google sænker sin crawling som reaktion, og den sænker mere, når flere af dine URL'er returnerer fejl. Google beholder allerede indekserede URL'er i et stykke tid, men fjerner URL'er, der vedvarende returnerer en serverfejl. Et kort udbrud er til at komme sig efter, fordi Google gradvist hæver crawlhastigheden igen, når din server svarer med 2xx-koder. Et langt forløb med fejl er det, der skader dit indeks.
Hver 5xx-kode peger på en anden del af stakken. Tabellen giver dig et første sted at kigge for hver af dem.
| Kode | Hvad det typisk betyder | Kig først på |
|---|---|---|
| 500 | Applikationen fejlede, mens den behandlede anmodningen | Applikationens fejllog på det præcise tidspunkt for anmodningen |
| 502 | Proxyen eller CDN'et fik et ugyldigt svar fra applikationen, ofte fordi den gik ned eller genstartede | Genstarter og oppetid for applikationsprocessen |
| 503 | Tjenesten er overbelastet, hastighedsbegrænset eller under vedligeholdelse | Belastningsgrafer, udrulningshistorik og vedligeholdelsesvinduer |
| 504 | Proxyen opgav at vente på applikationen | Langsomme databaseforespørgsler og timeout-indstillinger i proxyen |
| 429 | En hastighedsbegrænser siger, at der er for mange anmodninger | Regler for hastighedsbegrænsning, og om de gælder for verificeret Googlebot |
Crawlstatistik viser de dage og timer, hvor Google stødte på fejl (vores guide til Crawlstatistik forklarer hver graf). Din serverlog viser, hvad der skete i netop de øjeblikke. Filtrér Googlebot-anmodningerne og tæl 5xx-svarene pr. time:
grep -i 'googlebot' access.log | awk '$9 ~ /^5/ {print substr($4,2,14), $9}' | sort | uniq -c
Hver linje i outputtet er en time, en statuskode og et antal. En klump i samme time hver nat peger typisk på en backup, et cron-job eller en planlagt import. Fejl, der spreder sig over hele dagen, peger typisk på belastning, så løsningen er kapacitet eller caching frem for en enkelt fejl. For en dybere metode, se vores guide til logfilanalyse for SEO.
Google reducerer crawlingen i forhold til antallet af URL'er, der returnerer fejl. En ødelagt skabelon, der rammer få URL'er, koster dig lidt crawltid. Et databasenedbrud, der ødelægger hver side, koster dig meget, og det er det, du skal rette først.
En 429 har samme effekt som en 5xx, fordi Google læser den som en overbelastet server. Hvis din hastighedsbegrænser eller botbeskyttelse returnerer 429 til Googlebot, betaler du for det i crawltid. Googles dokumentation nævner ikke Retry-After-headeren. Bliv ved med at sende den til menneskelige besøgende og API-klienter, men regn ikke med, at Googlebot venter den tid, du har angivet.
En 4xx-status betyder, at serveren afviste anmodningen på grund af noget på klientsiden: URL'en findes ikke, adgang er forbudt, eller adressen er forkert opbygget. Google behandler alle 4xx-koder undtagen 429 på samme måde. Google holder op med at bruge indholdet bag URL'en og fjerner URL'en fra indekset, hvis den var indekseret. Før du rører ved en 4xx, skal du finde ud af, hvor anmodningen kommer fra, for rettelsen sidder ofte ét sted: et link, en skabelon eller en omdirigeringsregel.
Din adgangslog registrerer henvisningen for hver anmodning, og den viser, hvilken side der sendte den besøgende eller botten til URL'en. Tæl 4xx-svarene pr. sti og pr. henvisning:
awk '$9 ~ /^4/ {print $9, $7}' access.log | sort | uniq -c | sort -rn | head -20
awk '$9 ~ /^4/ {print $11, $7}' access.log | sort | uniq -c | sort -rn | head -20
Læs henvisningskolonnen sådan her:
En udgivelse, der omdøber en rute, ændrer et slug eller genbygger en skabelon, giver ofte en bølge af 404-fejl samme dag. Eksportér antallet af 4xx-svar pr. dag for ugen før udrulningen og ugen efter. En stigning, der samler sig i én mappe, peger direkte på ændringen. Tilføj omdirigeringen fra den gamle URL til den nye i samme udgivelse, ikke i en senere opgave. Ved en fuld flytning, se vores tjekliste for SEO-migrering.
Tip
Erstat ikke en manglende side med et 200-svar, der viser en kort besked eller en tom liste. Google kan behandle den som en soft 404, hvilket koster en fuld hentning og ikke giver noget tilbage.
Det er den metode, vi bruger. Den går fra de fejl, der kan stoppe hele dit website, til dem, der kun spilder lidt crawling.
Metoden i 6 trin til crawlfejl
I Search Console skal du åbne Indstillinger, derefter Crawlstatistik og derefter Værtsstatus. Grøn betyder intet væsentligt problem i 90 dage. "Nyligt problem" betyder et væsentligt problem inden for den seneste uge: drop alt andet. Klik på hver kategori for at se fejlraten pr. dag, og match så de dårlige dage med din hosting-, CDN- og udrulningshistorik.
Åbn Indeksering, derefter Sider, og eksportér hver fejlårsag. Ret ikke URL'er én ad gangen. Læg dem i et regneark, og udtræk den første mappe:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")En pivottabel på den kolonne viser som regel, at de fleste fejl kommer fra to eller tre skabeloner: en nedlagt blogkategori, en filterparameter, et gammelt produktfeed.
Stil fire spørgsmål for hvert mønster. Får den organiske klik? Har den backlinks? Linkes den internt? Er den i sitemap? En 404 uden nogen af de fire kan vente for evigt. En 404 med backlinks skal have en 301 i dag. Den gratis tjekker til ødelagte links viser, hvilke af dine egne sider der stadig linker til døde URL'er.
Ret regler, ikke URL'er. Et omdirigeringskort i serverkonfigurationen slår 400 omdirigeringer, der er tilføjet i hånden i et plugin. For eksempel i nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Ved 5xx skal du rette kapaciteten eller fejlen. Ved 401 og 403 skal du rette sikkerhedsreglen. Ved soft 404 skal du enten tilføje rigtigt indhold eller returnere en rigtig 404.
Hvert internt link bør pege direkte på en URL, der returnerer 200. Hver post i sitemap bør være en kanonisk, indekserbar 200-URL. Et sitemap fyldt med omdirigeringer og 404 lærer Google at stole mindre på det. Vores guide til hvordan du opretter et sitemap forklarer, hvad der hører hjemme i det.
I rapporten Sideindeksering skal du åbne den rettede årsag og klikke på Validér rettelse. Google tjekker først et udvalg og derefter resten; det tager som regel op til cirka to uger, og valideringen stopper, hvis blot én URL stadig fejler. Klik ikke igen, mens den kører. Indfør derefter en ugentlig rutine: Crawlstatistik for værten, logs for toppe, en crawl efter hver udrulning.
En omdirigeringskæde før og efter rettelsen
Hvad det er: et plugin eller en regel, der sender enhver manglende URL til /. Sådan opdager du det: mange URL'er under "Soft 404" eller "Side med omdirigering", der alle lander på forsiden; en crawler viser hundredvis af 301 med samme mål. Sådan retter du det: omdirigér kun til et nært tilsvarende, og lad resten returnere 404 eller 410.
Hvad det er: en WAF, botmanager eller hastighedsbegrænser, der leverer 403, 429 eller en udfordringsside til Google. Sådan opdager du det: 403 eller 429 i Crawlstatistik, mens siden indlæses fint i din browser; logs viser blokeringerne pr. IP. Sådan retter du det: tillad verificeret Googlebot via omvendt DNS eller Googles offentliggjorte IP-intervaller i stedet for at stole på brugeragent-strengen.
Hvad det er: robots.txt genereres af applikationen, så den fejler, hver gang applikationen fejler, eller leveres via en CDN-regel, der cacher en 5xx. Sådan opdager du det: kategorien for hentning af robots.txt i Værtsstatus er ikke grøn. Sådan retter du det: lever den som en statisk fil uden for applikationen, og test den med robots.txt-tjekkeren.
Hvad det er: en side med "Vi er snart tilbage", der leveres med status 200 på alle URL'er. Sådan opdager du det: efter vedligeholdelsen en bølge af soft 404 eller dublerede titler. Sådan retter du det: returnér 503 med Retry-After under vedligeholdelsen, og hold den kort.
Hvad det er: svare 403 til Googlebot, når serveren er overbelastet. Sådan opdager du det: toppe af 403, der falder sammen med belastningstoppe. Sådan retter du det: Google siger, at andre 4xx-koder end 429 ikke har nogen effekt på crawlhastigheden. Returnér 503 eller 429 i kort tid, og ret kapaciteten.
Hvad det er: klikke sig gennem listen i Search Console og redigere hver URL. Sådan opdager du det: den samme årsag kommer igen hver måned. Sådan retter du det: gruppér efter mønster, ret skabelonen eller reglen, og validér så én gang.
Hvad det er: bruge dage på 404 for spam-URL'er eller sider, der blev slettet for længe siden og ikke har links. Sådan opdager du det: URL'erne har ingen klik, ingen backlinks og ingen interne links. Sådan retter du det: lad dem være. Google siger, at en 404 for en fjernet side ikke nødvendigvis er et problem.
Advarsel
Blokér aldrig en URL i robots.txt for at "skjule" en crawlfejl. Google kan ikke længere se 404'en eller omdirigeringen, URL'en kan forblive indekseret, og du mister det signal, du prøvede at sende.
På et website med nogle hundrede sider har Google tid til det hele, og crawlfejl betyder mest for de sider, de ødelægger. På store websites (webshops med filtre, markedspladser, nyhedssites) tager hver mislykket eller spildt forespørgsel tid fra dine rigtige sider. Det er idéen bag crawlbudget.
5xx og 429 får Google til at sænke farten på hele værten, så nogle få ødelagte skabeloner kan forsinke crawlingen af dine nye produktsider. Omdirigeringskæder koster én forespørgsel pr. hop. Soft 404 koster en fuld hentning og giver intet tilbage. Ret de tre, så rækker det samme budget til flere nyttige sider.
Når Google finder URL'er, men udskyder crawlingen, er årsagen ofte en server, som Google anser for skrøbelig. Hvis du ser et stigende antal "Fundet, ikke indekseret i øjeblikket" sammen med serverfejl i Crawlstatistik, så ret serveren først. De to rapporter fortæller den samme historie.
Googlebot er ikke længere den eneste besøgende, der betyder noget. GPTBot, OAI-SearchBot, ClaudeBot og PerplexityBot henter sider for at træne modeller eller besvare spørgsmål i realtid. De rammer den samme server og lider under de samme fejl, med én forskel: du har ingen Search Console til dem.
De fleste AI-crawlere kører ikke JavaScript, så en side, der kun bygger sit indhold i browseren, kan se tom ud for dem, en slags soft 404, du aldrig vil se i Googles rapporter. Mange blokeres som standard af botbeskyttelsestjenester, ofte med en 403. Og fordi de henter efter behov, når en bruger stiller et spørgsmål, betyder en timeout i det øjeblik, at svaret citerer en anden. Vores guide til JavaScript og SEO dækker rendering for både søge- og AI-crawlere.
Dine serverlogs er den eneste pålidelige kilde. Filtrér på brugeragent, og se på statuskoderne:
grep -iE "GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|PerplexityBot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnHvis AI-bots får 403, som du ikke havde tænkt, så ret reglen. Tjek derefter, om de faktisk citerer dig: Soranks overvågning af AI-omtaler følger, hvor ofte ChatGPT, Gemini, Claude og Perplexity nævner dit brand, så du kan se, om en crawlrettelse ændrer noget.
Gennemgå listen efter hver migrering, hvert redesign eller hver større udrulning, og én gang om måneden på store websites.
Tjekliste til crawlsundhed
Åbn Crawlstatistik, og tjek de tre linjer for værtsstatus. Kør derefter den gratis tjekker til indekserbarhed på dine fem mest værdifulde sider. Hvis begge er rene, så eksportér fejlene i Sideindeksering, og gruppér dem efter mappe: så har du en kort, prioriteret liste over rettelser i stedet for en skræmmende rapport.
Når crawlingen er ren, er den næste grænse selve indholdet. Soranks indholdsoptimering omskriver og opdaterer dine eksisterende sider på autopilot, så de sider, Google nu kan nå, er værd at indeksere og citere. For de sider, Google crawlede, men lod ligge, kan du læse vores guide til "Crawlet, ikke indekseret i øjeblikket".
Crawlfejl er forespørgsler fra en søgemaskine eller AI-crawler, der mislykkes: DNS kan ikke slås op, serveren får timeout eller returnerer 5xx, robots.txt kan ikke hentes, en omdirigering kører i ring, eller en side returnerer en 4xx-kode. Fejl på websiteniveau kan sætte crawlingen af hele websitet på pause, mens URL-fejl kun påvirker den pågældende side.
Ikke i sig selv. Google siger, at en 404 for en side, der er fjernet uden erstatning, ikke nødvendigvis er et problem. Det bliver et, når URL'en stadig har backlinks, trafik eller interne links, og så er én 301 til et nært tilsvarende den rigtige løsning.
Når du har klikket på Validér rettelse i rapporten Sideindeksering i Search Console, tager valideringen som regel op til cirka to uger. Google tjekker først et udvalg af URL'er og derefter resten, og valideringen stopper, hvis blot én berørt URL stadig fejler.
Vi analyserer dine konkurrenter, dit website og din synlighed i AI for at lave en skræddersyet indholdsplan gratis.
 AI-generator til indholdsbrief
 FAQ-schemagenerator
 AI-generator til blogidéer
 Validator for struktureret data (schema-validator)
 Tjek af alt-tekst
 Analyse af interne links
 Backlink-udfordringen
 AI-generator til metabeskrivelser
 AI-generator til blogtitler
 Tjek af indekserbarhed
 AI-generator til blogdispositioner
 UTM-linkgenerator
 Værktøj til søgeordsclustering
 Tjek af canonical-tag
 XML-sitemap-generator
 Tjek af ødelagte links
 AI-generator til SEO-titler
 Overskriftsanalysator
 SERP-forhåndsvisning
 Redirect-tjekker
 Hreflang-generator
 Overskriftsanalysator
 HTTP-headertjekker
 Favicon-udtrækker
 SERP CTR-beregner
 Beregner for besparelse ved SEO vs. betalt søgning
 Beregner af SEO-synlighedsandel
 Beregner af SEO-afkast
 Beregner af SEO-trafik- og omsætningsprognose
 Beregner af SEO-budget
 Beregner af SEO-break-even
 Beregner af SaaS-SEO-afkast
 Beregner af ROAS
 Beregner af læsetid
 Simulator for placeringsgevinst
 Beregner for værdi af organisk trafik
 Estimator for organisk trafik og tjek af webstedstrafik
 Beregner for LTV/CAC-forhold
 Beregner for lokal SEO-afkast
 Beregner for linkbuilding-omkostninger
 Beregner for søgeordsværdi
 Beregner for søgeordsmulighed
 Beregner for nøgleordstæthed
 Beregner for GEO-ROI
 Beregner for investering i GEO-indhold
 Ecommerce SEO-ROI-beregner
 Beregner for kundens levetidsværdi
 CAC-beregner
 Beregner for CTR
 Beregner for omkostning pr. artikel
 Beregner for konverteringsrate
 Beregner for ROI på content marketing
 Estimator for henvisningstrafik fra ChatGPT
 Beregner for bounce rate
 Beregner for backlinks ROI
 Beregner for AI-synlighedsscore
 AI-trafikværdi-beregner
 AI-share of voice-beregner
 Beregner for omkostningen ved AI-usynlighed
 AI-citationsrate-beregner
 llms.txt-validator
 AI Overview-tjekker og rangeringstjekker for AI Overviews
 Robots.txt-tjekker
 AI-SEO-audit
 LLM-læsbarhedstjek
 SearchGPT-klartjek
 LLM-audit af strukturerede data
 AI-crawlbarhedsaudit for websites
 Hvorfor anbefaler ChatGPT ikke mit website?
 Gemini-rangeringsværktøj
 Perplexity-placeringstjek
 LLM-citeringstjek
 AEO-audit
 GEO-audit
 Test af synlighed i AI-søgning
 Tjek af ChatGPT-synlighed
 llms.txt-generator
 URL-udtrækker
 Webside til Markdown
 Sitemap-tjek
 SERP-volatilitetsmåler
 Sidestørrelsestjek
 Ordtæller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Metatag-generator
 Billedkompressor
 Favicon-generator
 On-page SEO-audit: SEO-tjek og SEO-analyse
 Backlinkanalyseværktøj
 Værktøj til søgeordsanalyse
 Domain Authority-tjek
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer