Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Vielen Dank! Ihre Auswahl wurde gespeichert.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
Eine Website-Karte, auf der einige Seiten mit Fehlersignalen markiert sind, während ein Crawler den Links zwischen ihnen folgt.
Werkzeuge
Auf dieser Seite
Kurz gesagt
Crawling-Fehler sind Anfragen einer Suchmaschine oder eines KI-Crawlers an Ihre Website, die scheitern: Der Server antwortet nicht rechtzeitig, das DNS reagiert nicht, die robots.txt ist nicht abrufbar, eine Weiterleitung läuft im Kreis oder eine Seite liefert einen 4xx- oder 5xx-Code. Fehler auf Website-Ebene (DNS, Server, robots.txt) können Google daran hindern, Ihre gesamte Website zu crawlen, also beheben Sie diese zuerst. Fehler auf URL-Ebene (404, Soft 404, Weiterleitungsfehler) zählen nur, wenn sie Seiten treffen, die indexiert werden sollen. Sie finden sie in den Berichten Crawling-Statistiken und Seitenindexierung der Search Console, bestätigen sie mit einem Crawler und Ihren Server-Logs, beheben dann die Ursache und validieren.
Wer sollte die Technik Ihrer Website in Ordnung bringen?
Frage 1 von 425%
Unsere Empfehlung für Sie
Prüfen Sie es selbst mit den kostenlosen Google-Tools
Die Search Console listet die Seiten auf, die Google nicht lesen kann, und PageSpeed Insights testet die Geschwindigkeit. Viele kleine Probleme lassen sich in den Einstellungen Ihres Website-Baukastens beheben.
Unsere Empfehlung für Sie
Ein Webentwickler
Ihr Problem liegt im Code oder auf dem Server: Ein Entwickler mit SEO-Kenntnissen ist die richtige Person. Geben Sie ihm die Fehlerliste aus der Search Console.
Unsere Empfehlung für Sie
Ein Tool für technische Audits
Ihre Website hat viele Seiten: Ein Crawler liest alle wie Google und liefert eine vollständige Liste der Fehler, Seite für Seite.
Unsere Empfehlung für Sie
Ein automatisches Audit, dann Inhalte
Ihre Website funktioniert, bringt aber wenige Besucher: Technische Probleme sind selten die Ursache. Sorank prüft die Website und schreibt dann die Seiten, die Besucher bringen.
Was Crawling-Fehler sind und was nicht
Ein Crawler verhält sich wie ein sehr geduldiger Besucher. Er fragt Ihren Server nach einer URL, wartet auf die Antwort, liest Statuscode und Inhalt und folgt dann den gefundenen Links. Ein Crawling-Fehler ist jeder Schritt in dieser Kette, der scheitert. Der Besucher bekommt nie eine brauchbare Seite.
Diese Definition ist wichtig, weil viele Berichte Crawling-Fehler mit Indexierungsentscheidungen vermischen. „Gecrawlt, zurzeit nicht indexiert" ist kein Crawling-Fehler: Google hat die Seite problemlos abgerufen und sich entschieden, sie nicht aufzunehmen. „Durch noindex-Tag ausgeschlossen" ist ebenfalls keiner: Sie haben Google gesagt, die Seite zu entfernen. Ein Crawling-Fehler bedeutet, dass schon der Abruf selbst schiefging.
Die zwei Familien: Website-Fehler und URL-Fehler
Google teilt Probleme in zwei Ebenen auf, und das sollten Sie auch tun.
Website-Fehler (bei Google Probleme mit dem Hoststatus): fehlgeschlagene DNS-Auflösung, fehlgeschlagene Serververbindung und fehlgeschlagener Abruf der robots.txt. Sie betreffen jede URL des Hosts. Ein schlechter Tag auf dieser Ebene kann das Crawling der gesamten Website einfrieren.
URL-Fehler: Eine Seite liefert 404, 410, 401, 403, 5xx, eine Soft 404 oder eine defekte Weiterleitung. Sie betreffen nur diese URL, und viele davon sind harmlos.
Website-Fehler und URL-Fehler
Website-Fehler (heute beheben)
DNS lässt sich nicht auflösen
Server läuft in ein Timeout oder bricht die Verbindung ab
robots.txt liefert 5xx oder 429
Sichtbar in Crawling-Statistiken, Hoststatus
Können das Crawling aller Seiten pausieren
URL-Fehler (sortieren)
404, 410, Soft 404
401, 403, andere 4xx
Weiterleitungsschleife oder zu lange Kette
Sichtbar im Bericht Seitenindexierung
Zählen nur bei Seiten, die indexiert werden sollen
Warum diese Unterscheidung Ihre Prioritäten ändert
Ein Shop mit 4000 alten Produkt-URLs, die 404 liefern, kann völlig gesund sein, wenn diese Produkte endgültig weg sind. Derselbe Shop mit einer robots.txt, die sechs Stunden lang 503 liefert, hat einen echten Notfall, auch wenn jede Produktseite funktioniert. Beginnen Sie beim Host, dann bei den URLs, die Umsatz bringen, dann beim Rest.
Gibt den Inhalt an die Indexierung weiter. Die Indexierung ist nicht garantiert.
Nein, außer die Seite ist leer (Soft 404).
301, 308
Starkes Signal, dass das Ziel die neue URL ist.
Nein, wenn es ein einziger Sprung zu einer 200 ist.
302, 303, 307
Schwaches Signal: Die ursprüngliche URL bleibt meist die kanonische.
Ja, wenn der Umzug dauerhaft ist.
3xx-Ketten
Folgt standardmäßig bis zu 10 Sprüngen und gibt dann auf.
Ja: Jeder Sprung verschwendet eine Anfrage, und Schleifen lösen sich nie auf.
404, 410, andere 4xx (außer 429)
Behandelt den Inhalt als nicht vorhanden, entfernt indexierte URLs nach und nach und crawlt sie seltener.
Nur wenn die Seite existieren sollte.
401, 403
Wie andere 4xx. Sie verlangsamen das Crawling nicht.
Ja, wenn sie den Googlebot von öffentlichen Seiten aussperren.
429
Wird wie ein 5xx als Signal für Serverüberlastung behandelt.
Ja: Das Crawling wird langsamer.
5xx
Verlangsamt das Crawling proportional zu den Fehlern. Dauerhaft fehlerhafte URLs werden aus dem Index entfernt.
Ja, immer.
Zwei Details bringen viele Teams ins Stolpern. Erstens senken 401 und 403 die Crawling-Frequenz nicht. Wenn Ihr Server kämpft, hilft ein 403 an den Googlebot nicht; Google empfiehlt stattdessen vorübergehend 503 oder 429. Zweitens ist ein 404 keine Abstrafung. Es ist die richtige Antwort für eine Seite, die nicht mehr existiert.
Fehler bei der robots.txt sind am gefährlichsten
Die Dokumentation zum Bericht Crawling-Statistiken (Search Console-Hilfe) erklärt die Regel. Eine robots.txt, die 200 (auch leer) oder 403, 404 oder 410 (keine Datei) liefert, ist in Ordnung. Eine robots.txt, die 429 oder 5xx liefert, ist ein Fehler, und Google geht dann auf Nummer sicher.
Was Google tut, wenn die robots.txt dauerhaft fehlschlägt
Erste 12 StundenGoogle stellt das Crawling der Website komplett ein.
Bis zu 30 TageGoogle verwendet die letzte erfolgreich abgerufene robots.txt.
Nach 30 TagenDas Verhalten hängt davon ab, ob die Startseite erreichbar ist.
Quelle: Google Search Console-Hilfe, Bericht Crawling-Statistiken
Eine CDN-Regel oder eine Firewall, die auf /robots.txt ein 503 ausliefert, kann Ihre gesamte Website also einen halben Tag lang einfrieren, selbst wenn jede andere URL funktioniert. Prüfen Sie diese Datei bei jeder Untersuchung von Crawling-Fehlern zuerst. Unser Leitfaden zum Status „Durch robots.txt-Datei blockiert" behandelt das umgekehrte Problem, wenn die Datei funktioniert, aber zu viel blockiert.
Googles Crawling-Grenzen, die Sie kennen sollten
10Weiterleitungssprünge folgen die Google-Crawler höchstens
12 hCrawling-Stopp, wenn die robots.txt 5xx oder 429 liefert
30 Tagenutzt Google weiter die letzte gültige robots.txt
5%tägliche DNS-Fehlerrate als Beispiel für ein Hostproblem
Quellen: Google Search Central, HTTP-Statuscodes und Netzwerkfehler; Search Console-Hilfe, Bericht Crawling-Statistiken
Crawling-Fehler sind die Stellen, an denen der Weg eines Crawlers durch Ihre Website abbricht.
Jeder Crawling-Fehlertyp, erklärt mit seiner Lösung
Hier die vollständige Liste, die Ihnen in der Search Console und in Crawlern begegnet, mit Ursache und Lösung für jeden Fall. Die Bezeichnungen folgen der Dokumentation zum Bericht Seitenindexierung (Search Console-Hilfe).
DNS-Fehler
Google konnte Ihren Domainnamen nicht in eine IP-Adresse auflösen, oder der DNS-Server hat nicht geantwortet. Häufige Ursachen: eine abgelaufene Domain, ein Ausfall beim DNS-Anbieter, ein falscher Eintrag nach einer Migration oder eine fehlerhafte DNSSEC-Konfiguration. Prüfen Sie mit einer Abfrage von außerhalb Ihres Netzwerks:
Lösung: Korrigieren Sie die Einträge, senken Sie die TTL vor jeder Migration und nutzen Sie einen DNS-Anbieter mit Redundanz. Wenn example.com und www.example.com beide existieren, müssen beide auflösbar sein, auch wenn einer nur weiterleitet.
Serververbindungsfehler und 5xx
Der Server hat nicht rechtzeitig geantwortet, die Verbindung geschlossen oder mit 500, 502, 503 oder 504 geantwortet. Typische Ursachen: eine überlastete Datenbank, ein PHP- oder Node-Prozess, der unter Last abstürzt, ein Timeout am Reverse Proxy, ein Plugin-Update oder eine Firewall, die Bots drosselt. Achten Sie auf das zeitliche Muster: Fehler jede Nacht zur selben Uhrzeit deuten oft auf ein Backup oder einen Cronjob hin.
Lösung: Lesen Sie das Server-Fehlerlog zu den Zeitpunkten, die Google meldet, erhöhen Sie Timeouts oder die Zahl der Worker, cachen Sie schwere Seiten und stellen Sie sicher, dass Ihr Bot-Schutz den verifizierten Googlebot durchlässt. Für geplante Wartung liefern Sie ein 503 mit einem Retry-After-Header statt einer 200-Seite mit „Bald wieder da":
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 und 410 (nicht gefunden)
Die Seite existiert nicht. Das ist in Ordnung, wenn sie absichtlich gelöscht wurde und nichts mehr darauf verlinkt. Es ist ein Problem, wenn die URL noch Backlinks, Traffic oder interne Links hat oder wenn die Seite existieren sollte und ein Deployment sie kaputt gemacht hat.
Lösung: Ist der Inhalt umgezogen, setzen Sie eine einzige 301 auf das nächstliegende Gegenstück. Ist er endgültig weg, behalten Sie das 404 oder nutzen Sie 410 und entfernen Sie die internen Links und Sitemap-Einträge, die darauf zeigen. Leiten Sie niemals alle 404 auf die Startseite um: Google behandelt solche Weiterleitungen meist als Soft 404.
Soft 404
Der Server sagt 200, aber die Seite wirkt leer oder zeigt „nicht gefunden": eine leere Kategorie, eine Suchseite ohne Ergebnisse, ein ausverkauftes Produkt ohne Inhalt. Google verbraucht eine Anfrage und bekommt nichts. Wir behandeln diesen Fall ausführlich in unserem Leitfaden zu Soft-404-Fehlern.
401, 403 und andere 4xx
Der Googlebot sendet nie Zugangsdaten, ein 401 oder 403 auf einer öffentlichen Seite bedeutet also, dass Ihr Server oder eine Sicherheitsschicht ihn blockiert. Übliche Verdächtige: ein Staging-Passwort, das in der Produktion vergessen wurde, eine WAF-Regel, eine Ländersperre oder ein Hotlink-Schutz, der auf HTML angewendet wird. Beheben Sie die Regel, nicht das Symptom, und testen Sie mit dem Tool URL-Prüfung in der Search Console.
Weiterleitungsfehler
Google meldet einen Weiterleitungsfehler bei einer Schleife, einer zu langen Kette, einer URL über der maximalen Länge oder einer ungültigen oder leeren URL in der Kette. Der Klassiker nach einer Migration: http auf https, dann auf www, dann auf einen abschließenden Schrägstrich, dann auf einen neuen Pfad. Vier Sprünge, wo einer reichen würde. Unser vollständiger Leitfaden zu SEO-Weiterleitungen erklärt, wie Sie sie zusammenfassen.
Tipp
Fügen Sie jede verdächtige URL in den kostenlosen Weiterleitungs-Checker von Sorank ein: Er folgt der ganzen Kette, zeigt jeden Sprung mit Statuscode und sagt Ihnen, wo die Schleife oder der überflüssige Sprung liegt.
Timeouts, abgeschnittene Antworten und zu große Seiten
Manche Fehler zeigen nie einen Statuscode. Die Seite beginnt zu laden und bricht ab, oder sie ist so schwer, dass der Crawler nur einen Teil liest. Die Google-Crawler lesen pro Datei eine begrenzte Zahl an Bytes, eine mit Inline-Skripten oder Base64-Bildern aufgeblähte Seite kann also den Inhalt am Ende verlieren. Prüfen Sie schwere Templates mit dem Seitengrößen-Checker.
Alle Methoden, Crawling-Fehler zu finden, im Vergleich
Kein einzelnes Tool zeigt alle Crawling-Fehler. Jede Methode sieht das Problem aus einem anderen Blickwinkel, und ein ernsthaftes Audit kombiniert mindestens zwei.
Prinzip: Google zeigt seine eigenen Crawling-Anfragen der letzten 90 Tage, gruppiert nach Antwort, Dateityp, Zweck und Googlebot-Typ, dazu den Hoststatus für DNS, Server und robots.txt. Wann einsetzen: immer, und zuerst, für Website-Fehler. Vorteile: Es sind die echten Daten von Google selbst. Grenzen: nur für Properties auf Stammebene, Beispiele als Stichprobe, und laut Google brauchen Websites mit weniger als tausend Seiten ihn selten. Beispiel: eine Spitze bei „Seiten-Timeout" jeden Sonntag um 3 Uhr, passend zu einem Datenbank-Backup.
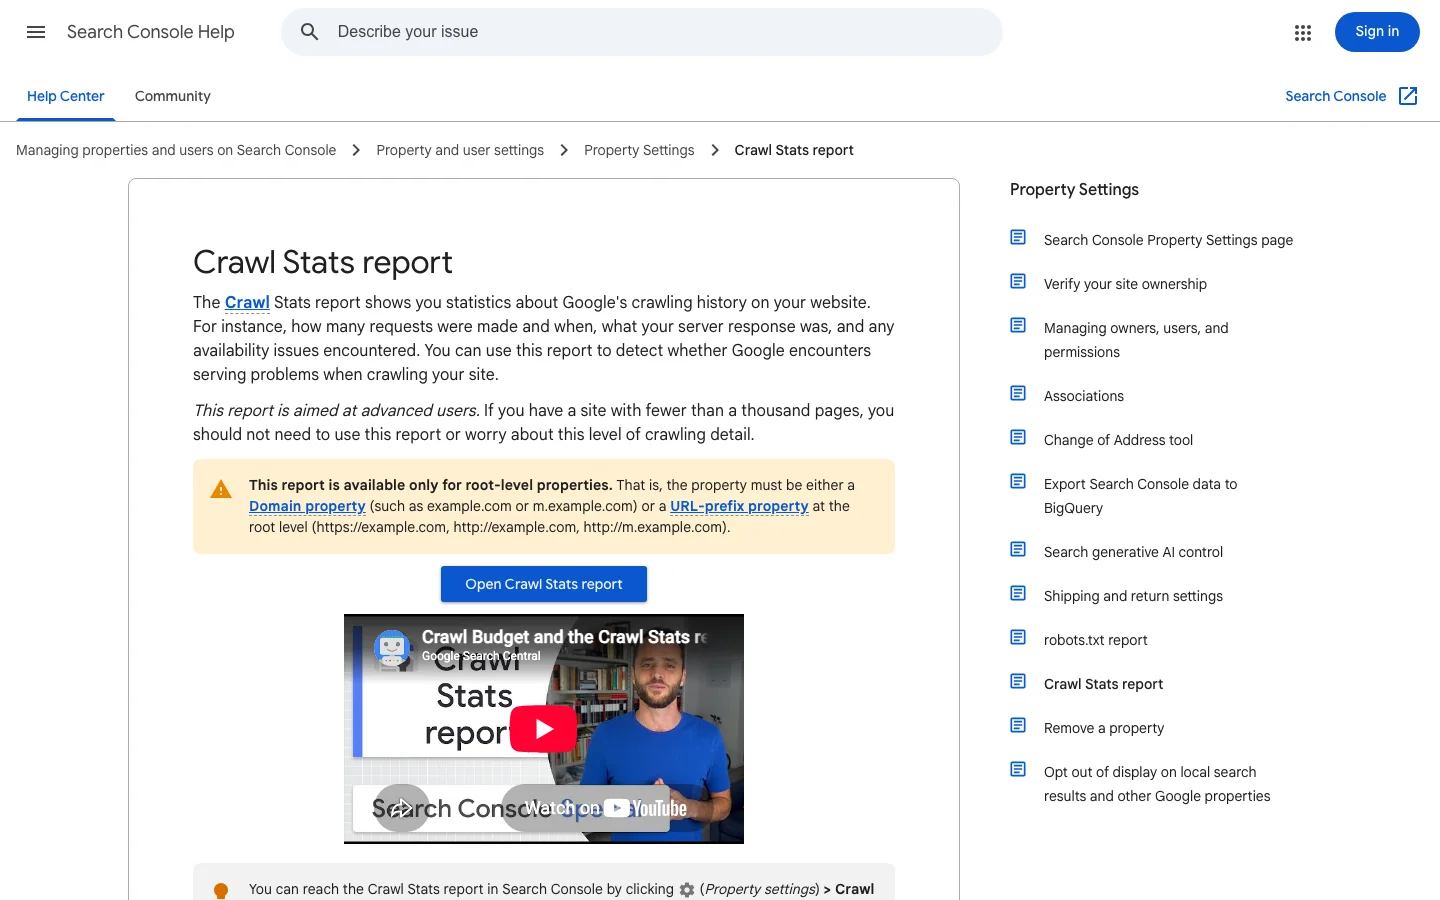
Googles Dokumentation zum Bericht Crawling-Statistiken, in der der Hoststatus für DNS, Server und robots.txt erklärt wird.
Methode 2: Search Console, Bericht Seitenindexierung und URL-Prüfung
Prinzip: listet die URLs auf, die Google kennt, und warum sie nicht indexiert sind, mit Gründen wie Serverfehler (5xx), Weiterleitungsfehler, Nicht gefunden (404) oder Soft 404. Wann einsetzen: zum Sortieren von URL-Fehlern und zum Validieren von Korrekturen. Vorteile: an die Seiten gebunden, die Google tatsächlich versucht hat. Grenzen: Berichte hinken Tage hinterher, Beispiellisten sind begrenzt, und Crawling-Fehler werden mit Indexierungsentscheidungen vermischt. Beispiel: 300 URLs unter „Weiterleitungsfehler", die alle das alte Präfix /blog/ teilen.
Methode 3: ein Desktop- oder Cloud-Crawler
Prinzip: Ein Tool wie Screaming Frog crawlt Ihre Website wie ein Bot, folgt den Links ab der Startseite und protokolliert jeden Statuscode, jede Weiterleitungskette und jeden defekten Link. Wann einsetzen: vor und nach einer Migration, einem Relaunch oder einem großen Deployment, und monatlich bei großen Websites. Vorteile: sofort, vollständig für verlinkte Seiten, zeigt, wo jeder defekte Link sitzt. Grenzen: Er weiß nicht, was Google wirklich angefragt hat, übersieht verwaiste Seiten, und Ihr Server behandelt ihn eventuell anders als den Googlebot. Unser Leitfaden zur Einrichtung von Screaming Frog führt durch ein komplettes Audit.
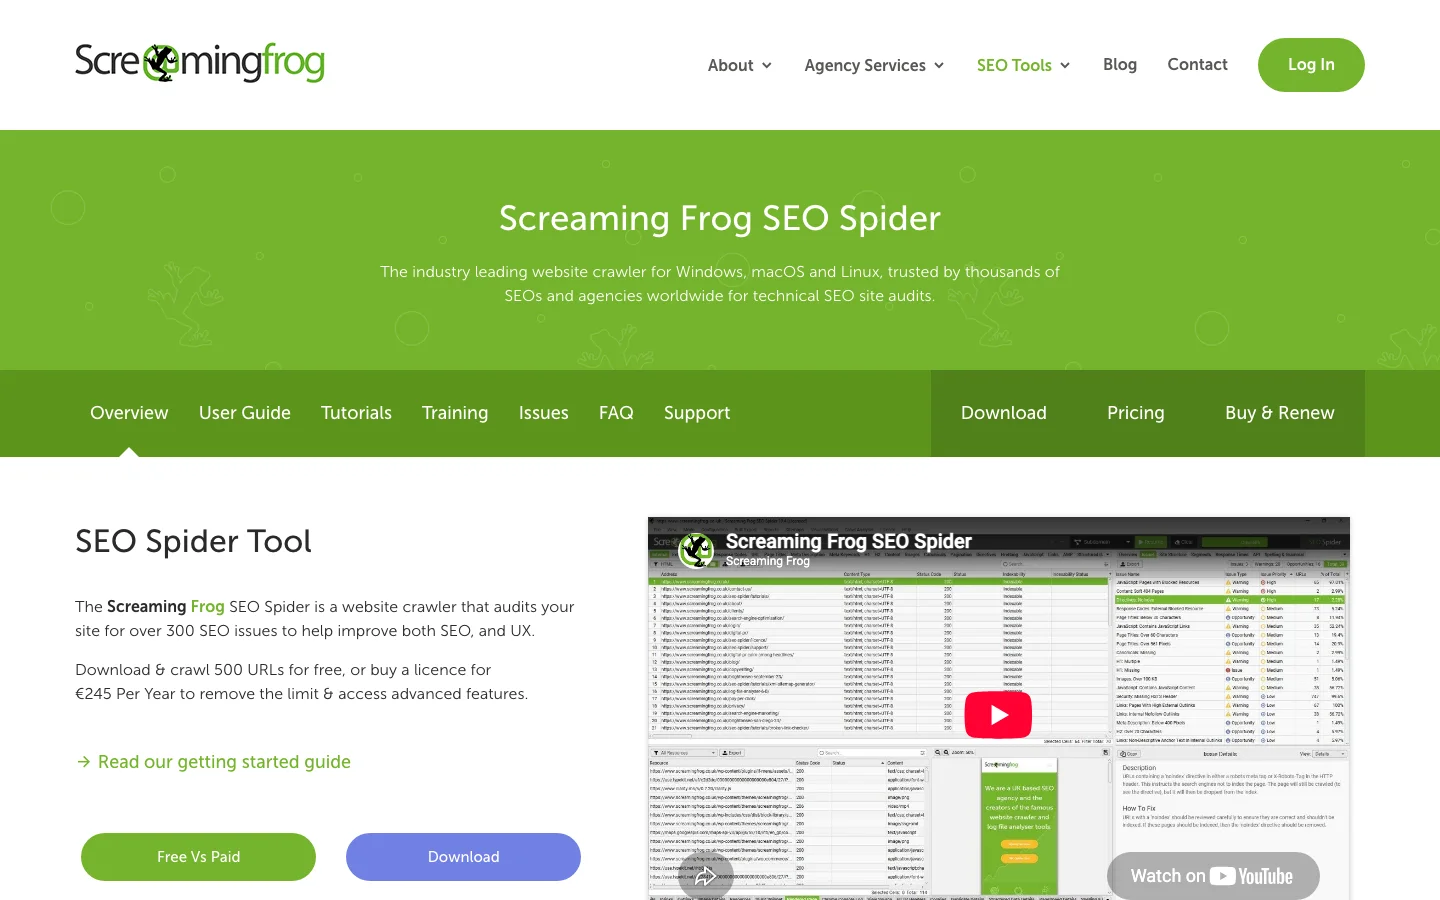
Screaming Frog SEO Spider crawlt Ihre Website wie ein Bot und listet jeden Statuscode, jede Weiterleitungskette und jeden defekten Link auf.
Methode 4: Analyse der Server-Logs
Prinzip: Ihre Access-Logs speichern jede Anfrage, auch die von Googlebot, Bingbot, GPTBot, ClaudeBot und PerplexityBot, mit exaktem Statuscode und Antwortzeit. Wann einsetzen: bei großen Websites, nach unerklärlichen Traffic-Einbrüchen und um zu sehen, was KI-Crawler abrufen. Vorteile: echte Anfragen, echte Codes, keine Stichprobe, alle Bots. Grenzen: erfordert Zugriff auf die Logs und etwas Skripting; Sie müssen prüfen, ob „Googlebot" wirklich Google ist. Unser Leitfaden zur Logfile-Analyse für SEO geht Schritt für Schritt vor. Ein schneller erster Blick:
# Googlebot-Anfragen, die nicht 200, 301 oder 304 geliefert haben, häufigste zuerst
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Methode 5: Stichproben einzelner URLs
Prinzip: eine URL nach der anderen mit curl oder einem kostenlosen Online-Checker testen. Wann einsetzen: um eine Korrektur zu bestätigen oder eine wichtige Seite nach einem Deployment zu prüfen. Vorteile: sofort und präzise. Grenzen: skaliert nicht. Verwenden Sie einen Googlebot-User-Agent, um Regeln zu erwischen, die Bots anders behandeln:
5xx-Fehler: Lesen Sie den Statuscode, um die fehlerhafte Schicht zu finden
Ein 5xx-Status bedeutet, dass der Server eine gültig aussehende Anfrage nicht verarbeiten konnte. Google drosselt daraufhin das Crawling, und stärker, wenn mehr Ihrer URLs Fehler liefern. Google behält bereits indexierte URLs eine Zeit lang, entfernt aber URLs, die dauerhaft einen Serverfehler zurückgeben. Ein kurzer Ausreißer ist verkraftbar, denn Google erhöht die Crawling-Rate wieder schrittweise, sobald Ihr Server mit 2xx-Codes antwortet. Ein langer Zeitraum mit Fehlern ist es, der Ihren Index schädigt.
Der Code zeigt an, welche Schicht ausgefallen ist
Jeder 5xx-Code verweist auf einen anderen Teil des Stacks. Die Tabelle nennt Ihnen für jeden Code einen ersten Ansatzpunkt.
Code
Was er meist bedeutet
Zuerst prüfen
500
Die Anwendung ist bei der Verarbeitung der Anfrage fehlgeschlagen
Das Anwendungs-Fehlerlog zum genauen Zeitpunkt der Anfrage
502
Proxy oder CDN haben eine ungültige Antwort der Anwendung erhalten, oft weil sie abgestürzt oder neu gestartet ist
Neustarts und Verfügbarkeit des Anwendungsprozesses
503
Der Dienst ist überlastet, gedrosselt oder in Wartung
Lastkurven, Deployment-Historie und Wartungsfenster
504
Der Proxy hat nicht länger auf die Anwendung gewartet
Langsame Datenbankabfragen und Timeout-Einstellungen des Proxys
429
Ein Rate-Limiter meldet zu viele Anfragen
Rate-Limit-Regeln und die Frage, ob sie für den verifizierten Googlebot gelten
Gleichen Sie die Zeitstempel von Google mit Ihren Logs ab
Der Bericht Crawling-Statistiken zeigt die Tage und Stunden, in denen Google auf Fehler gestoßen ist (unser Leitfaden zu den Crawling-Statistiken erklärt jede Grafik). Ihr Serverlog zeigt, was in genau diesen Momenten passiert ist. Filtern Sie die Googlebot-Anfragen und zählen Sie die 5xx-Antworten pro Stunde:
Jede Ausgabezeile steht für eine Stunde, einen Statuscode und eine Anzahl. Eine Häufung in derselben Stunde jede Nacht deutet meist auf ein Backup, einen Cron-Job oder einen geplanten Import hin. Über den ganzen Tag verteilte Fehler deuten eher auf Last hin. Dann liegt die Lösung in Kapazität oder Caching statt in einem einzelnen Bug. Eine tiefergehende Methode finden Sie in unserem Leitfaden zur Analyse von Logdateien.
Messen Sie, was ein 5xx kostet, bevor Sie in Panik geraten
Google reduziert das Crawling im Verhältnis zur Anzahl der URLs mit Fehlern. Eine defekte Vorlage, die wenige URLs betrifft, kostet wenig Crawling-Zeit. Ein Datenbankausfall, der jede Seite lahmlegt, kostet viel, und den sollten Sie zuerst beheben.
Ein 429 hat dieselbe Wirkung wie ein 5xx, weil Google es als überlasteten Server liest. Wenn Ihr Rate-Limiter oder Ihr Bot-Schutz Googlebot ein 429 zurückgibt, bezahlen Sie das mit Crawling-Zeit. Die Dokumentation von Google erwähnt den Retry-After-Header nicht. Behalten Sie ihn für menschliche Besucher und API-Clients bei, verlassen Sie sich aber nicht darauf, dass Googlebot die Wartezeit einhält, die Sie angegeben haben.
4xx-Fehler: Finden Sie heraus, woher sie kommen, bevor Sie sie beheben
Ein 4xx-Status bedeutet, dass der Server die Anfrage wegen etwas auf Client-Seite abgelehnt hat: Die URL existiert nicht, der Zugriff ist verboten oder die Adresse ist fehlerhaft. Google behandelt jeden 4xx-Code außer 429 gleich. Google hört auf, den Inhalt hinter dieser URL zu nutzen, und entfernt die URL aus dem Index, falls sie dort war. Bevor Sie einen 4xx angehen, finden Sie heraus, woher die Anfrage kommt, denn die Lösung liegt oft an einer einzigen Stelle: einem Link, einer Vorlage oder einer Weiterleitungsregel.
Finden Sie die Quelle jedes 4xx in Ihren Logs
Ihr Zugriffslog speichert den Referrer jeder Anfrage, also welche Seite den Besucher oder Bot zu dieser URL geschickt hat. Zählen Sie die 4xx-Antworten nach Pfad und nach Referrer:
Ein Referrer aus Ihrer eigenen Domain bedeutet, dass eine Ihrer Seiten auf eine tote URL verlinkt. Korrigieren Sie den Link oder die Vorlage, die ihn ausgibt. Das ist die wertvollste Korrektur, weil Sie sie selbst in der Hand haben. Unser Leitfaden zum Reparieren defekter Links beschreibt das vollständige Vorgehen.
Ein Referrer von einer anderen Website bedeutet, dass ein Backlink auf eine URL zeigt, die nicht mehr funktioniert. Wenn der Link es wert ist, richten Sie eine einzelne 301 auf die nächstgelegene aktive Seite ein. Wenn nicht, lassen Sie den 404 bestehen.
Ein leerer Referrer oder ein Pfad, den Sie nie veröffentlicht haben, etwa eine Login-Seite auf einer statischen Website, bedeutet meist, dass ein Bot oder Scanner die Adresse probiert hat. Lassen Sie ihn 404 zurückgeben und verschwenden Sie keine Zeit damit.
Achten Sie auf 4xx-Spitzen direkt nach jedem Release
Ein Release, das eine Route umbenennt, einen Slug ändert oder eine Vorlage neu baut, erzeugt oft am selben Tag eine Welle von 404-Fehlern. Exportieren Sie die Zahl der 4xx-Antworten pro Tag für die Woche vor dem Deployment und die Woche danach. Ein Anstieg, der sich auf einen Ordner konzentriert, weist direkt auf die Änderung hin. Richten Sie die Weiterleitung von der alten auf die neue URL im selben Release ein, nicht in einem späteren Ticket. Für einen vollständigen Umzug lesen Sie unsere Checkliste für SEO-Migrationen.
Tipp
Ersetzen Sie eine fehlende Seite nicht durch eine 200-Antwort mit einer kurzen Meldung oder einer leeren Liste. Google kann sie als Soft 404 behandeln, was einen vollen Abruf kostet und nichts zurückbringt.
Schritt für Schritt: Crawling-Fehler in der richtigen Reihenfolge beheben
Das ist die Methode, die wir anwenden. Sie geht von den Fehlern, die Ihre ganze Website stoppen können, bis zu denen, die nur etwas Crawling verschwenden.
Die 6-Schritte-Methode gegen Crawling-Fehler
Hoststatus prüfenÖffnen Sie die Crawling-Statistiken und prüfen Sie DNS, Serververbindung und robots.txt der letzten 90 Tage.
URL-Fehler exportieren und gruppierenExportieren Sie jeden Grund aus der Seitenindexierung und gruppieren Sie die URLs nach Ordner oder Template.
Nach Wert sortierenBehalten Sie die URLs mit Traffic, Backlinks, internen Links oder Sitemap-Einträgen.
Ursache auf Template-Ebene behebenEine Regel, eine Weiterleitungstabelle oder eine Servereinstellung behebt Hunderte URLs.
Signale bereinigenAktualisieren Sie interne Links und Sitemaps, damit sie auf finale 200-URLs zeigen.
Validieren und überwachenKlicken Sie auf Fehlerbehebung überprüfen und beobachten Sie dann wöchentlich Crawling-Statistiken und Logs.
Schritt 1: zuerst den Host prüfen
Öffnen Sie in der Search Console Einstellungen, dann Crawling-Statistiken, dann Hoststatus. Grün bedeutet kein nennenswertes Problem in 90 Tagen. „Kürzliches Problem" bedeutet ein ernstes Problem in der letzten Woche: Lassen Sie alles andere liegen. Klicken Sie jede Kategorie an, um die Fehlerrate pro Tag zu sehen, und gleichen Sie die schlechten Tage mit der Historie von Hosting, CDN und Deployments ab.
Schritt 2: exportieren und nach Muster gruppieren
Öffnen Sie Indexierung, dann Seiten, und exportieren Sie jeden Fehlergrund. Beheben Sie URLs nicht einzeln. Legen Sie sie in eine Tabelle und extrahieren Sie den ersten Ordner:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
Eine Pivot-Tabelle auf dieser Spalte zeigt meist, dass die meisten Fehler aus zwei oder drei Templates stammen: eine eingestellte Blog-Kategorie, ein Filterparameter, ein alter Produktfeed.
Schritt 3: nach geschäftlichem Wert sortieren
Stellen Sie für jedes Muster vier Fragen. Bekommt es organische Klicks? Hat es Backlinks? Ist es intern verlinkt? Steht es in der Sitemap? Ein 404 ohne eines dieser Merkmale kann ewig warten. Ein 404 mit Backlinks braucht heute eine 301. Der kostenlose Broken-Link-Checker zeigt, welche Ihrer Seiten noch auf tote URLs verlinken.
Schritt 4: die eigentliche Ursache beheben
Korrigieren Sie Regeln, nicht URLs. Eine Weiterleitungstabelle in der Serverkonfiguration ist besser als 400 von Hand in einem Plugin angelegte Weiterleitungen. Zum Beispiel in nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Bei 5xx beheben Sie Kapazität oder Bug. Bei 401 und 403 korrigieren Sie die Sicherheitsregel. Bei Soft 404 ergänzen Sie echten Inhalt oder liefern ein echtes 404.
Schritt 5: interne Links und Sitemaps bereinigen
Jeder interne Link sollte direkt auf eine URL zeigen, die 200 liefert. Jeder Sitemap-Eintrag sollte eine kanonische, indexierbare 200-URL sein. Eine Sitemap voller Weiterleitungen und 404 bringt Google bei, ihr weniger zu vertrauen. Unser Leitfaden zum Erstellen einer Sitemap erklärt, was hineingehört.
Schritt 6: validieren und überwachen
Öffnen Sie im Bericht Seitenindexierung den behobenen Grund und klicken Sie auf Fehlerbehebung überprüfen. Google prüft zuerst eine Stichprobe, dann den Rest; das dauert meist bis zu etwa zwei Wochen und bricht ab, wenn auch nur eine URL noch fehlschlägt. Klicken Sie nicht erneut, solange die Prüfung läuft. Richten Sie dann eine wöchentliche Routine ein: Crawling-Statistiken für den Host, Logs für Spitzen, ein Crawl nach jedem Deployment.
Eine Weiterleitungskette vor und nach der Korrektur
Vorher
http://site.com/page
301 auf https://site.com/page
301 auf https://www.site.com/page
301 auf https://www.site.com/page/
Interne Links zeigen noch auf die erste URL
Nachher
Eine einzige 301 direkt auf https://www.site.com/page/
Interne Links auf die finale URL aktualisiert
Die Sitemap listet nur die finale URL
Eine Anfrage statt vier
Häufige Fehler: wie Sie sie erkennen und beheben
Fehler 1: jedes 404 auf die Startseite umleiten
Was es ist: ein Plugin oder eine Regel, die jede fehlende URL auf / schickt. Wie Sie es erkennen: viele URLs unter „Soft 404" oder „Seite mit Weiterleitung", die alle auf der Startseite landen; ein Crawler zeigt Hunderte 301 mit demselben Ziel. Wie Sie es beheben: Leiten Sie nur auf ein nahes Gegenstück um und lassen Sie den Rest 404 oder 410 liefern.
Fehler 2: den Googlebot mit Sicherheitstools blockieren
Was es ist: eine WAF, ein Bot-Manager oder ein Rate-Limiter, der Google ein 403, ein 429 oder eine Challenge-Seite ausliefert. Wie Sie es erkennen: 403 oder 429 in den Crawling-Statistiken, während die Seite im Browser normal lädt; die Logs zeigen die Sperren nach IP. Wie Sie es beheben: Lassen Sie den verifizierten Googlebot zu, per Reverse-DNS oder über die von Google veröffentlichten IP-Bereiche, statt dem User-Agent zu vertrauen.
Fehler 3: eine anfällige robots.txt
Was es ist: eine von der Anwendung erzeugte robots.txt, die also jedes Mal ausfällt, wenn die Anwendung ausfällt, oder die über eine CDN-Regel ausgeliefert wird, die ein 5xx cacht. Wie Sie es erkennen: Die Kategorie robots.txt-Abruf im Hoststatus ist nicht grün. Wie Sie es beheben: Liefern Sie sie als statische Datei außerhalb der Anwendung aus und testen Sie sie mit dem robots.txt-Checker.
Fehler 4: Wartungsseiten, die 200 liefern
Was es ist: eine Seite „Wir sind bald zurück", die auf jeder URL mit Status 200 ausgeliefert wird. Wie Sie es erkennen: nach der Wartung eine Welle von Soft 404 oder doppelten Titeln. Wie Sie es beheben: Liefern Sie während der Wartung ein 503 mit Retry-After und halten Sie sie kurz.
Fehler 5: 403 nutzen, um Google auszubremsen
Was es ist: dem Googlebot 403 antworten, wenn der Server überlastet ist. Wie Sie es erkennen: 403-Spitzen, die mit Lastspitzen zusammenfallen. Wie Sie es beheben: Laut Google haben 4xx-Codes außer 429 keinen Einfluss auf die Crawling-Frequenz. Liefern Sie kurzzeitig 503 oder 429 und beheben Sie die Kapazität.
Fehler 6: Fehler einzeln beheben
Was es ist: sich durch die Liste der Search Console klicken und jede URL einzeln bearbeiten. Wie Sie es erkennen: Derselbe Grund taucht jeden Monat wieder auf. Wie Sie es beheben: Nach Muster gruppieren, das Template oder die Regel korrigieren, dann einmal validieren.
Fehler 7: bei harmlosen 404 in Panik geraten
Was es ist: Tage mit 404 für Spam-URLs oder längst gelöschte Seiten ohne Links verbringen. Wie Sie es erkennen: Die URLs haben keine Klicks, keine Backlinks und keine internen Links. Wie Sie es beheben: Lassen Sie sie. Laut Google ist ein 404 für eine entfernte Seite nicht unbedingt ein Problem.
Achtung
Sperren Sie niemals eine URL in der robots.txt, um einen Crawling-Fehler zu „verstecken". Google sieht dann weder das 404 noch die Weiterleitung, die URL kann indexiert bleiben, und Sie verlieren genau das Signal, das Sie senden wollten.
Crawling-Fehler und Crawl-Budget
Bei einer Website mit ein paar hundert Seiten hat Google Zeit für alles, und Crawling-Fehler zählen vor allem für die Seiten, die sie kaputt machen. Bei großen Websites (Shops mit Filtern, Marktplätze, Nachrichtenseiten) nimmt jede fehlgeschlagene oder verschwendete Anfrage Ihren echten Seiten Zeit weg. Das ist die Idee hinter dem Crawl-Budget.
Wie Fehler Crawling-Kapazität fressen
5xx und 429 lassen Google auf dem gesamten Host langsamer werden, ein paar defekte Templates können also das Crawling Ihrer neuen Produktseiten verzögern. Weiterleitungsketten kosten eine Anfrage pro Sprung. Soft 404 kosten einen vollständigen Abruf und bringen nichts. Beheben Sie diese drei, und dasselbe Budget deckt mehr nützliche Seiten ab.
Was „Gefunden, zurzeit nicht indexiert" damit zu tun hat
Wenn Google URLs findet, ihr Crawling aber aufschiebt, ist die Ursache oft ein Server, den Google für anfällig hält. Wenn die Zahl unter „Gefunden, zurzeit nicht indexiert" wächst und gleichzeitig Serverfehler in den Crawling-Statistiken auftauchen, beheben Sie zuerst den Server. Beide Berichte erzählen dieselbe Geschichte.
Crawling-Fehler bei KI-Crawlern
Der Googlebot ist nicht mehr der einzige Besucher, der zählt. GPTBot, OAI-SearchBot, ClaudeBot und PerplexityBot rufen Seiten ab, um Modelle zu trainieren oder Fragen in Echtzeit zu beantworten. Sie treffen denselben Server und leiden unter denselben Fehlern, mit einem Unterschied: Für sie gibt es keine Search Console.
Was sich bei KI-Bots ändert
Die meisten KI-Crawler führen kein JavaScript aus, eine Seite, die ihren Inhalt nur im Browser aufbaut, kann für sie also leer wirken, eine Art Soft 404, die Sie in Googles Berichten nie sehen. Viele werden von Bot-Schutzdiensten standardmäßig blockiert, oft mit einem 403. Und weil sie Seiten bei Bedarf abrufen, wenn ein Nutzer eine Frage stellt, bedeutet ein Timeout in diesem Moment, dass die Antwort jemand anderen zitiert. Unser Leitfaden zu JavaScript-SEO behandelt das Rendering für Suchmaschinen und KI-Crawler.
Wie Sie sie überwachen
Ihre Server-Logs sind die einzige verlässliche Quelle. Filtern Sie nach User-Agent und sehen Sie sich die Statuscodes an:
Bekommen KI-Bots 403, die Sie nicht beabsichtigt haben, korrigieren Sie die Regel. Prüfen Sie dann, ob sie Sie tatsächlich zitieren: Das KI-Mention-Tracking von Sorank verfolgt, wie oft ChatGPT, Gemini, Claude und Perplexity Ihre Marke erwähnen, damit Sie sehen, ob eine Crawling-Korrektur etwas verändert.
Ihre Checkliste für gesundes Crawling
Gehen Sie diese Liste nach jeder Migration, jedem Relaunch oder großen Deployment durch, und bei großen Websites einmal im Monat.
Checkliste für gesundes Crawling
Hoststatus grün für DNS, Serververbindung und robots.txt
robots.txt als statische Datei ausgeliefert, liefert 200
Keine 5xx- oder 429-Spitzen in Crawling-Statistiken oder Logs
Verifizierter Googlebot und gewünschte KI-Bots nicht von der Firewall blockiert
Jede Weiterleitung ist ein einziger Sprung, 301 oder 308, auf eine 200-Seite
Interne Links zeigen auf finale 200-URLs
Sitemaps listen nur kanonische, indexierbare 200-URLs
404 mit Backlinks oder Traffic auf ein nahes Gegenstück umgeleitet
Leere Seiten behoben oder mit echtem 404
Wartung liefert 503 mit Retry-After
Fehlerbehebung überprüfen für jeden behobenen Grund gestartet
Was Sie heute tun können
Öffnen Sie die Crawling-Statistiken und prüfen Sie die drei Zeilen des Hoststatus. Lassen Sie dann den kostenlosen Indexierbarkeits-Checker über Ihre fünf wertvollsten Seiten laufen. Ist beides sauber, exportieren Sie die Fehler der Seitenindexierung und gruppieren Sie sie nach Ordner: Sie haben jetzt eine kurze, priorisierte Liste statt eines beängstigenden Berichts.
Ist das Crawling sauber, ist die nächste Grenze der Inhalt selbst. Die Content-Optimierung von Sorank überarbeitet und aktualisiert Ihre bestehenden Seiten per Autopilot, damit die Seiten, die Google jetzt erreicht, es wert sind, indexiert und zitiert zu werden. Für Seiten, die Google gecrawlt, aber nicht aufgenommen hat, lesen Sie unseren Leitfaden zu „Gecrawlt, zurzeit nicht indexiert".
Häufig gestellte Fragen
Was sind Crawling-Fehler im SEO?
Crawling-Fehler sind Anfragen einer Suchmaschine oder eines KI-Crawlers, die scheitern: Das DNS lässt sich nicht auflösen, der Server läuft in ein Timeout oder liefert 5xx, die robots.txt ist nicht abrufbar, eine Weiterleitung läuft im Kreis oder eine Seite liefert einen 4xx-Code. Website-Fehler können das Crawling der gesamten Website pausieren, URL-Fehler betreffen nur die jeweilige Seite.
Sind 404-Fehler schlecht für SEO?
Nicht an sich. Laut Google ist ein 404 für eine ohne Ersatz entfernte Seite nicht unbedingt ein Problem. Zum Problem wird es, wenn die URL noch Backlinks, Traffic oder interne Links hat; dann ist eine einzige 301 auf ein nahes Gegenstück die richtige Lösung.
Wie lange dauert es, bis Google behobene Crawling-Fehler erkennt?
Nach einem Klick auf Fehlerbehebung überprüfen im Bericht Seitenindexierung der Search Console dauert die Validierung meist bis zu etwa zwei Wochen. Google prüft zuerst eine Stichprobe von URLs, dann den Rest, und bricht ab, wenn auch nur eine betroffene URL noch fehlschlägt.
y!
Erhalten Sie kostenlos Ihren Content-Plan für 30 Tage
Wir analysieren Ihre Wettbewerber, Ihre Website und Ihre KI-Sichtbarkeit, um kostenlos einen maßgeschneiderten Content-Plan für Sie zu erstellen.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler