Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Bedankt! Je aanmelding is ontvangen!
Oeps! Er ging iets mis bij het versturen van het formulier.
Een sitekaart waarop enkele pagina's met foutsignalen zijn gemarkeerd terwijl een crawler de links ertussen volgt.
Tools
Op deze pagina
In het kort
crawlfouten zijn verzoeken van een zoekmachine of AI-crawler aan je site die mislukken: de server reageert niet op tijd, de DNS antwoordt niet, robots.txt is niet op te halen, een redirect blijft rondjes draaien of een pagina geeft een 4xx- of 5xx-code. Fouten op siteniveau (DNS, server, robots.txt) kunnen voorkomen dat Google je hele site crawlt, dus los die eerst op; fouten op URL-niveau (404, soft 404, redirectfouten) tellen alleen als ze pagina's raken die je geïndexeerd wilt hebben. Je vindt ze in de rapporten Crawlstatistieken en Pagina-indexering van Search Console, bevestigt ze met een crawler en je serverlogs, lost daarna de oorzaak op en valideert.
Controleer het zelf met de gratis tools van Google
Search Console toont de pagina's die Google niet kan lezen, en PageSpeed Insights test de snelheid. Veel kleine problemen los je op in de instellingen van je websitebouwer.
Ons advies voor jou
Een webontwikkelaar
Je probleem zit in de code of op de server: een ontwikkelaar die SEO kent is de juiste persoon. Geef hem de foutenlijst uit Search Console.
Ons advies voor jou
Een tool voor technische audits
Je website heeft veel pagina's: een crawler leest ze allemaal zoals Google en geeft een volledige lijst met fouten, pagina voor pagina.
Ons advies voor jou
Een automatische audit, daarna content
Je website werkt maar levert weinig bezoekers op: technische problemen zijn zelden de oorzaak. Sorank controleert de website en schrijft daarna de pagina's die verkeer opleveren.
Wat crawlfouten zijn, en wat niet
Een crawler gedraagt zich als een heel geduldige bezoeker. Hij vraagt je server om een URL, wacht op het antwoord, leest de statuscode en de inhoud en gaat dan verder met de links die hij heeft gevonden. Een crawlfout is elke stap in die keten die mislukt. De bezoeker krijgt nooit een bruikbare pagina.
Die definitie is belangrijk, omdat veel rapporten crawlfouten mengen met indexeringsbeslissingen. „Gecrawld, momenteel niet geïndexeerd" is geen crawlfout: Google heeft de pagina prima opgehaald en besloten haar niet op te nemen. „Uitgesloten door noindex-tag" is er ook geen: jij hebt Google gevraagd de pagina te laten vallen. Een crawlfout betekent dat het ophalen zelf misging.
De twee families: sitefouten en URL-fouten
Google verdeelt problemen in twee niveaus, en dat zou jij ook moeten doen.
Sitefouten (Google noemt ze problemen met de hoststatus): mislukte DNS-resolutie, mislukte serververbinding en mislukt ophalen van robots.txt. Ze raken elke URL op de host. Een slechte dag op dit niveau kan het crawlen van de hele site bevriezen.
URL-fouten: een pagina geeft 404, 410, 401, 403, 5xx, een soft 404 of een kapotte redirect. Ze raken alleen die URL, en veel ervan zijn onschuldig.
Sitefouten en URL-fouten
Sitefouten (vandaag oplossen)
DNS wordt niet opgelost
Server krijgt een time-out of verbreekt de verbinding
robots.txt geeft 5xx of 429
Zichtbaar in Crawlstatistieken, Hoststatus
Kunnen het crawlen van alle pagina's pauzeren
URL-fouten (sorteren)
404, 410, soft 404
401, 403, andere 4xx
Redirectlus of te lange keten
Zichtbaar in het rapport Pagina-indexering
Tellen alleen op pagina's die geïndexeerd moeten worden
Waarom dit onderscheid je prioriteiten verandert
Een webwinkel met 4000 oude product-URL's die 404 geven, kan kerngezond zijn als die producten definitief weg zijn. Dezelfde winkel met een robots.txt die zes uur lang 503 geeft, heeft een echt noodgeval, ook al werkt elke productpagina. Begin bij de host, dan de URL's die omzet opleveren, dan de rest.
Hoe Googlebot op elke fout reageert
Om crawlfouten goed op te lossen, moet je weten wat Google echt doet als het er een tegenkomt. De documentatie van Google over hoe HTTP-statuscodes en netwerkfouten Google Zoeken beïnvloeden (Google Search Central) geeft de regels. Dit betekenen ze in de praktijk.
Statuscodes, familie per familie
Antwoord
Wat Google doet
Is het een probleem?
2xx
Geeft de inhoud door aan de indexering. Indexering is niet gegarandeerd.
Nee, tenzij de pagina leeg is (soft 404).
301, 308
Sterk signaal dat het doel de nieuwe URL is.
Nee, als het één sprong naar een 200 is.
302, 303, 307
Zwak signaal: de oorspronkelijke URL blijft meestal de canonieke.
Ja, als de verhuizing definitief is.
3xx-ketens
Volgt standaard tot 10 sprongen en geeft dan op.
Ja: elke sprong verspilt een verzoek, en lussen lossen nooit op.
404, 410, andere 4xx (behalve 429)
Behandelt de inhoud als niet-bestaand, verwijdert geïndexeerde URL's na verloop van tijd en crawlt ze minder vaak.
Alleen als de pagina zou moeten bestaan.
401, 403
Zoals andere 4xx. Ze vertragen het crawlen niet.
Ja, als ze Googlebot van openbare pagina's weren.
429
Behandeld als signaal van serveroverbelasting, net als een 5xx.
Ja: het crawlen vertraagt.
5xx
Vertraagt het crawlen in verhouding tot de fouten. URL's die blijven falen, worden uit de index gehaald.
Ja, altijd.
Twee details laten veel teams struikelen. Ten eerste verlagen 401 en 403 de crawlsnelheid niet. Als je server het zwaar heeft, helpt een 403 naar Googlebot niet; Google vraagt je tijdelijk 503 of 429 terug te geven. Ten tweede is een 404 geen straf. Het is het juiste antwoord voor een pagina die niet meer bestaat.
Fouten met robots.txt zijn het gevaarlijkst
De documentatie van het rapport Crawlstatistieken (Search Console Help) legt de regel uit. Een robots.txt die 200 geeft (ook als hij leeg is) of 403, 404 of 410 (geen bestand), is in orde. Een robots.txt die 429 of 5xx geeft, is een fout, en dan speelt Google op safe.
Wat Google doet als robots.txt blijft falen
Eerste 12 uurGoogle stopt volledig met het crawlen van de site.
Tot 30 dagenGoogle gebruikt de laatste robots.txt die wel lukte.
Na 30 dagenHet gedrag hangt af van of de homepage bereikbaar is.
Bron: Google Search Console Help, rapport Crawlstatistieken
Een CDN-regel of firewall die een 503 serveert op /robots.txt, kan je hele site dus een halve dag bevriezen, ook als elke andere URL werkt. Controleer dit bestand als eerste bij elk onderzoek naar crawlfouten. Onze gids over de status „Geblokkeerd door robots.txt" behandelt het omgekeerde probleem, als het bestand werkt maar te veel blokkeert.
Crawllimieten van Google om te onthouden
10redirectsprongen volgen de crawlers van Google maximaal
12 ucrawlstop als robots.txt 5xx of 429 geeft
30 dagenblijft Google de laatste goede robots.txt gebruiken
5%DNS-fouten per dag, genoemd als voorbeeld van een hostprobleem
Bronnen: Google Search Central, HTTP-statuscodes en netwerkfouten; Search Console Help, rapport Crawlstatistieken
Crawlfouten zijn de plekken waar de route van een crawler door je site breekt.
Elk type crawlfout, uitgelegd met de oplossing
Hier is de volledige lijst die je in Search Console en in crawlers tegenkomt, met oorzaak en oplossing per type. De namen volgen de documentatie van het rapport Pagina-indexering (Search Console Help).
DNS-fouten
Google kon je domeinnaam niet omzetten in een IP-adres, of de DNS-server antwoordde niet. Veelvoorkomende oorzaken: een verlopen domein, een storing bij de DNS-provider, een fout record na een migratie of een verkeerde DNSSEC-configuratie. Controleer het met een opzoeking van buiten je netwerk:
Oplossing: corrigeer de records, verlaag de TTL vóór elke migratie en gebruik een DNS-provider met redundantie. Als zowel example.com als www.example.com bestaan, moeten ze allebei worden opgelost, ook als er één alleen doorstuurt.
Serververbindingsfouten en 5xx
De server reageerde niet op tijd, sloot de verbinding of antwoordde met 500, 502, 503 of 504. Typische oorzaken: een overbelaste database, een PHP- of Node-proces dat onder belasting crasht, een time-out van de reverse proxy, een plugin-update of een firewall die bots afremt. Kijk naar het patroon in de tijd: fouten elke nacht op hetzelfde uur wijzen vaak op een back-up of een cronjob.
Oplossing: lees het foutenlog van de server op de tijdstippen die Google meldt, verhoog time-outs of het aantal workers, cache zware pagina's en zorg dat je botbescherming de geverifieerde Googlebot doorlaat. Geef bij gepland onderhoud een 503 met een Retry-After-header in plaats van een 200-pagina met „zo terug":
HTTP/1.1 503 Service Unavailable
Retry-After: 3600
404 en 410 (niet gevonden)
De pagina bestaat niet. Dat is prima als ze bewust is verwijderd en niets er meer naar linkt. Het is een probleem als de URL nog backlinks, verkeer of interne links heeft, of als de pagina zou moeten bestaan en een deploy haar heeft gebroken.
Oplossing: is de inhoud verhuisd, voeg dan één 301 toe naar het dichtstbijzijnde equivalent. Is ze definitief weg, houd dan de 404 of gebruik 410, en verwijder de interne links en sitemap-items die ernaar verwijzen. Stuur nooit alle 404's door naar de homepage: Google behandelt die meestal als soft 404.
Soft 404
De server zegt 200, maar de pagina lijkt leeg of meldt „niet gevonden": een lege categorie, een zoekpagina zonder resultaten, een uitverkocht product zonder inhoud. Google besteedt een verzoek en krijgt niets. We gaan hier uitgebreid op in in onze gids over soft-404-fouten.
401, 403 en andere 4xx
Googlebot stuurt nooit inloggegevens mee, dus een 401 of 403 op een openbare pagina betekent dat je server of een beveiligingslaag hem blokkeert. Gebruikelijke boosdoeners: een stagingwachtwoord dat op productie is blijven staan, een WAF-regel, een landblokkade of hotlinkbescherming die op HTML wordt toegepast. Los de regel op, niet het symptoom, en test met de tool URL-inspectie in Search Console.
Redirectfouten
Google meldt een redirectfout bij een lus, een te lange keten, een URL die de maximale lengte overschrijdt of een ongeldige of lege URL in de keten. Het klassieke geval na een migratie: http naar https, dan naar www, dan naar een slash aan het eind, dan naar een nieuw pad. Vier sprongen waar één genoeg is. Onze volledige gids over SEO-redirects legt uit hoe je ze samenvoegt.
Tip
Plak elke verdachte URL in de gratis redirectchecker van Sorank: hij volgt de hele keten, toont elke sprong met zijn statuscode en vertelt je waar de lus of de overbodige sprong zit.
Time-outs, afgekapte antwoorden en te grote pagina's
Sommige fouten tonen nooit een statuscode. De pagina begint te laden en stopt, of ze is zo zwaar dat de crawler maar een deel leest. De crawlers van Google lezen een beperkt aantal bytes per bestand, dus een pagina vol inline scripts of base64-afbeeldingen kan de inhoud onderaan kwijtraken. Controleer zware templates met de paginagroottechecker.
Alle manieren om crawlfouten te vinden, vergeleken
Geen enkele tool toont in zijn eentje alle crawlfouten. Elke methode bekijkt het probleem vanuit een andere hoek, en een serieuze audit combineert er minstens twee.
Methode 1: Search Console, rapport Crawlstatistieken
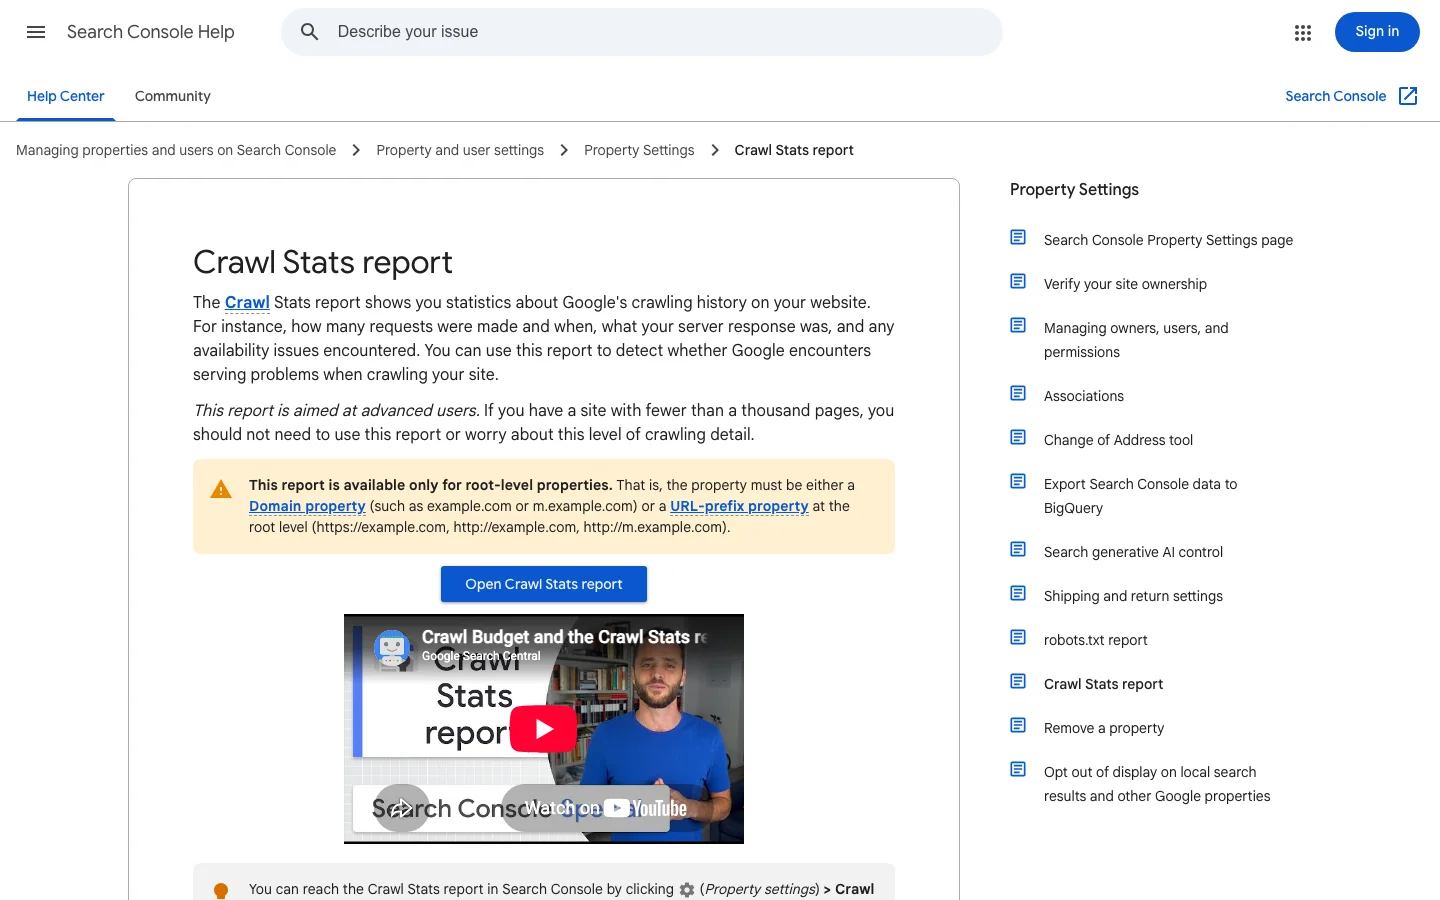
Principe: Google toont zijn eigen crawlverzoeken van de laatste 90 dagen, gegroepeerd per antwoord, bestandstype, doel en type Googlebot, plus de hoststatus voor DNS, server en robots.txt. Wanneer gebruiken: altijd, en als eerste, voor sitefouten. Voordelen: het zijn de echte gegevens van Google zelf. Beperkingen: alleen voor property's op hoofdniveau, voorbeelden als steekproef, en volgens Google hebben sites met minder dan duizend pagina's het zelden nodig. Voorbeeld: een piek in „time-out van pagina" elke zondag om 3 uur 's nachts, gelijk met een databaseback-up.
De documentatie van Google over het rapport Crawlstatistieken, waarin de hoststatus voor DNS, server en robots.txt wordt uitgelegd.
Methode 2: Search Console, rapport Pagina-indexering en URL-inspectie
Principe: toont de URL's die Google kent en waarom ze niet geïndexeerd zijn, met redenen zoals Serverfout (5xx), Redirectfout, Niet gevonden (404) of Soft 404. Wanneer gebruiken: om URL-fouten te sorteren en oplossingen te valideren. Voordelen: gekoppeld aan de pagina's die Google echt heeft geprobeerd. Beperkingen: rapporten lopen dagen achter, voorbeeldlijsten zijn begrensd, en crawlfouten worden gemengd met indexeringskeuzes. Voorbeeld: 300 URL's onder „Redirectfout" die allemaal het oude voorvoegsel /blog/ delen.
Methode 3: een desktop- of cloudcrawler
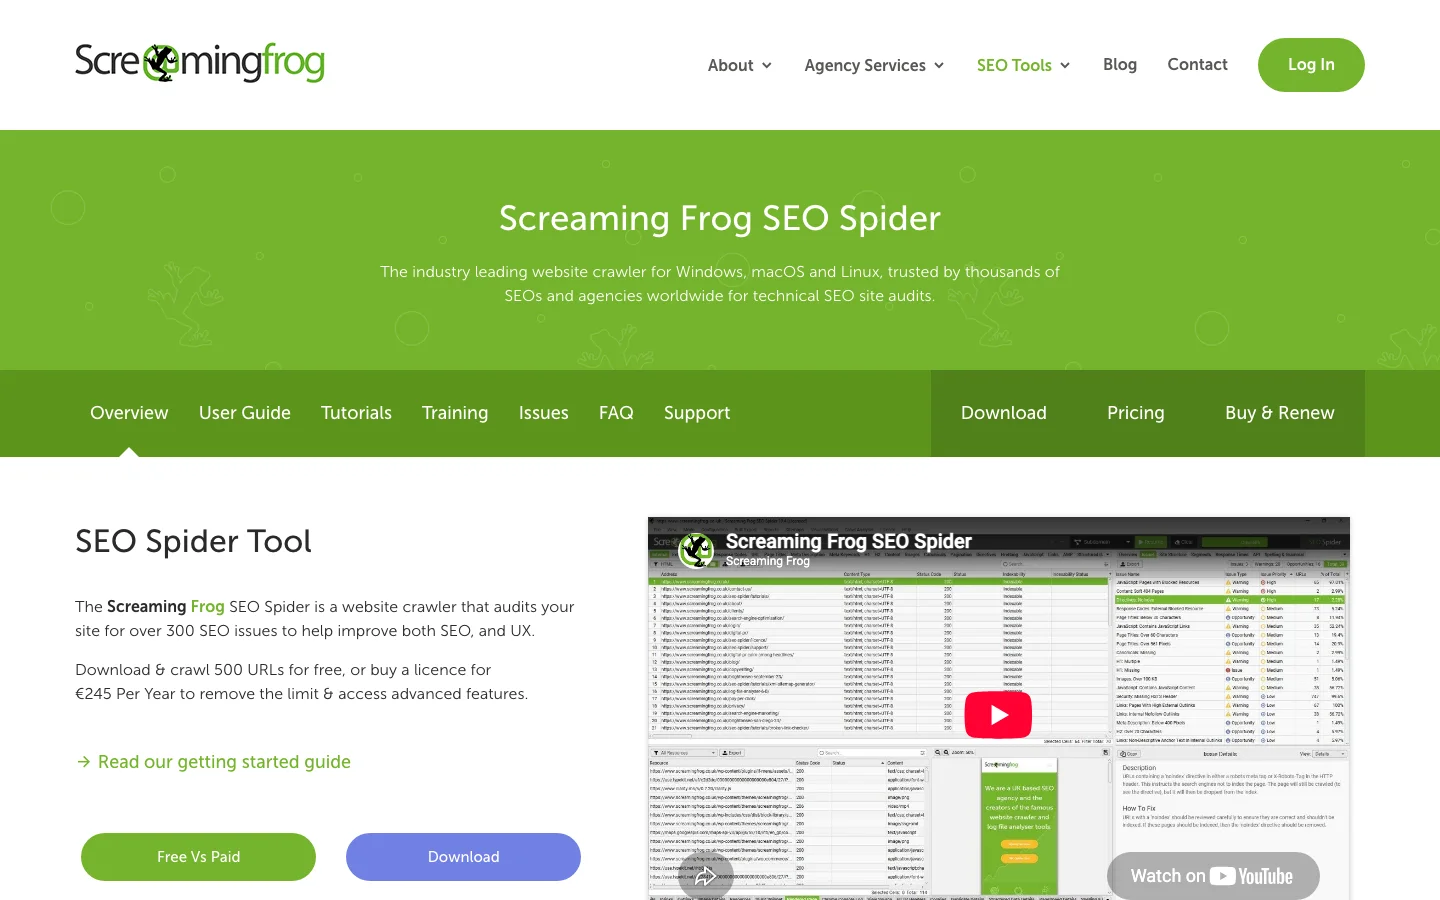
Principe: een tool als Screaming Frog crawlt je site zoals een bot dat zou doen, volgt de links vanaf de homepage en legt elke statuscode, elke redirectketen en elke kapotte link vast. Wanneer gebruiken: voor en na een migratie, redesign of grote deploy, en maandelijks bij grote sites. Voordelen: direct, volledig voor gelinkte pagina's, toont waar elke kapotte link staat. Beperkingen: hij weet niet wat Google echt heeft opgevraagd, mist weespagina's, en je server behandelt hem misschien anders dan Googlebot. Onze gids voor het instellen van Screaming Frog loopt een volledige audit door.
Screaming Frog SEO Spider crawlt je site zoals een bot en toont elke statuscode, redirectketen en kapotte link.
Methode 4: analyse van serverlogs
Principe: je toegangslogs registreren elk verzoek, ook die van Googlebot, Bingbot, GPTBot, ClaudeBot en PerplexityBot, met de exacte statuscode en responstijd. Wanneer gebruiken: bij grote sites, na onverklaarde verkeersdalingen en om te zien wat AI-crawlers ophalen. Voordelen: echte verzoeken, echte codes, geen steekproef, alle bots. Beperkingen: je hebt toegang tot de logs en wat scripting nodig; je moet controleren of „Googlebot" echt Google is. Onze gids over logbestandsanalyse voor SEO gaat stap voor stap. Een snelle eerste blik:
# Googlebot-verzoeken die geen 200, 301 of 304 gaven, meest voorkomende eerst
grep -i "googlebot" access.log | awk '$9 !~ /^(200|301|304)$/ {print $9, $7}' | sort | uniq -c | sort -rn | head -50
Methode 5: steekproeven op losse URL's
Principe: test één URL tegelijk met curl of een gratis online checker. Wanneer gebruiken: om een oplossing te bevestigen of een belangrijke pagina na een deploy te controleren. Voordelen: direct en precies. Beperkingen: schaalt niet. Gebruik een Googlebot-user-agent om regels te betrappen die bots anders behandelen:
5xx-fouten: lees de statuscode om de laag te vinden die faalde
Een 5xx-status betekent dat de server een verzoek dat geldig lijkt niet kon verwerken. Google vertraagt het crawlen als reactie, en vertraagt meer naarmate meer van je URL's fouten teruggeven. Google houdt al geïndexeerde URL's een tijdje vast, maar verwijdert URL's die aanhoudend een serverfout geven. Een korte piek is herstelbaar, want Google verhoogt de crawlsnelheid geleidelijk weer zodra je server met 2xx-codes antwoordt. Een lange reeks fouten is wat je index beschadigt.
De code vertelt welke laag kapot is
Elke 5xx-code wijst naar een ander deel van de stack. De tabel geeft je per code een eerste plek om te kijken.
Code
Wat het meestal betekent
Kijk eerst naar
500
De applicatie is mislukt bij het verwerken van het verzoek
Het applicatiefoutenlog op het exacte moment van het verzoek
502
De proxy of CDN kreeg een ongeldig antwoord van de applicatie, vaak omdat die is gecrasht of opnieuw is gestart
Herstarts en de uptime van het applicatieproces
503
De service is overbelast, rate limited of in onderhoud
Belastingsgrafieken, deploygeschiedenis en onderhoudsvensters
504
De proxy heeft het wachten op de applicatie opgegeven
Trage databasequery's en timeoutinstellingen van de proxy
429
Een rate limiter meldt te veel verzoeken
Rate limitregels, en of ze gelden voor de geverifieerde Googlebot
Vergelijk de tijdstippen van Google met je logs
Crawlstatistieken toont de dagen en uren waarop Google fouten tegenkwam (onze gids over Crawlstatistieken legt elke grafiek uit). Je serverlog toont wat er op die exacte momenten gebeurde. Filter de Googlebot-verzoeken en tel de 5xx-antwoorden per uur:
Elke uitvoerregel is een uur, een statuscode en een aantal. Een cluster in hetzelfde uur elke nacht wijst meestal op een back-up, een cronjob of een geplande import. Fouten die over de hele dag verspreid zijn, wijzen meestal op belasting, dus de oplossing is capaciteit of caching en niet één bug. Voor een diepgaandere aanpak lees je onze gids over logbestandsanalyse.
Meet wat een 5xx kost voordat je in paniek raakt
Google verlaagt het crawlen in verhouding tot het aantal URL's dat fouten geeft. Een kapot sjabloon dat een paar URL's raakt, kost weinig crawltijd. Een databasestoring die elke pagina breekt, kost veel, en die moet je als eerste oplossen.
Een 429 heeft hetzelfde effect als een 5xx, omdat Google het leest als een overbelaste server. Als je rate limiter of botbescherming een 429 aan Googlebot geeft, betaal je dat met crawltijd. De documentatie van Google vermeldt de Retry-After-header niet. Blijf die naar menselijke bezoekers en API-clients sturen, maar reken er niet op dat Googlebot de wachttijd respecteert die je hebt ingesteld.
4xx-fouten: zoek uit waar ze vandaan komen voordat je ze oplost
Een 4xx-status betekent dat de server het verzoek heeft geweigerd vanwege iets aan de clientkant: de URL bestaat niet, de toegang is verboden of het adres is onjuist opgebouwd. Google behandelt elke 4xx behalve de 429 hetzelfde. Google stopt met het gebruik van de inhoud achter die URL en haalt de URL uit de index als die erin stond. Voordat je aan een 4xx begint, zoek je uit waar het verzoek vandaan komt, want de oplossing zit vaak op één plek: een link, een sjabloon of een redirectregel.
Zoek de bron van elke 4xx in je logs
Je toegangslog registreert de referrer van elk verzoek, dus welke pagina de bezoeker of bot naar die URL heeft gestuurd. Tel de 4xx-antwoorden per pad en per referrer:
Een referrer op je eigen domein betekent dat een van je pagina's linkt naar een dode URL. Repareer de link of de sjabloon die hem uitvoert. Dit is de meest waardevolle oplossing, omdat jij die in handen hebt. Onze gids over het repareren van kapotte links behandelt de volledige aanpak.
Een referrer op een andere site betekent dat een backlink naar een URL wijst die niet meer werkt. Als de link het waard is om te houden, voeg je één 301 toe naar de dichtstbijzijnde live pagina. Als dat niet zo is, laat je de 404 staan.
Een lege referrer, of een pad dat je nooit hebt gepubliceerd, zoals een inlogpagina op een statische site, betekent meestal dat een bot of scanner het adres heeft geprobeerd. Laat hem een 404 teruggeven en besteed er geen tijd aan.
Let op 4xx-pieken direct na elke release
Een release die een route hernoemt, een slug wijzigt of een sjabloon opnieuw bouwt, geeft vaak op dezelfde dag een golf van 404's. Exporteer het aantal 4xx-antwoorden per dag voor de week vóór de deploy en de week erna. Een stijging die zich in één map concentreert, wijst rechtstreeks naar de wijziging. Voeg de redirect van de oude naar de nieuwe URL toe in dezelfde release, niet in een latere ticket. Voor een volledige verhuizing lees je onze SEO-migratiechecklist.
Tip
Vervang een ontbrekende pagina niet door een 200-antwoord dat een korte melding of een lege lijst toont. Google kan dat behandelen als een soft 404, wat een volledige fetch kost en niets oplevert.
Stap voor stap: crawlfouten in de juiste volgorde oplossen
Dit is de methode die wij gebruiken. Ze gaat van de fouten die je hele site kunnen stilleggen naar de fouten die alleen wat crawltijd verspillen.
De methode in 6 stappen tegen crawlfouten
Hoststatus controlerenOpen Crawlstatistieken en bekijk DNS, serververbinding en robots.txt over de laatste 90 dagen.
URL-fouten exporteren en groeperenExporteer elke reden uit Pagina-indexering en groepeer de URL's per map of template.
Sorteren op waardeHoud de URL's met verkeer, backlinks, interne links of sitemap-items.
De oorzaak op templateniveau oplossenEén regel, één redirecttabel of één serverinstelling lost honderden URL's op.
Signalen opschonenWerk interne links en sitemaps bij zodat ze naar de uiteindelijke 200-URL's wijzen.
Valideren en bewakenKlik op Oplossing valideren en volg daarna elke week de crawlstatistieken en je logs.
Stap 1: controleer eerst de host
Open in Search Console Instellingen, dan Crawlstatistieken, dan Hoststatus. Groen betekent geen belangrijk probleem in 90 dagen. „Recent probleem" betekent een belangrijk probleem in de afgelopen week: laat dan al het andere liggen. Klik op elke categorie om het foutpercentage per dag te zien en leg de slechte dagen naast de geschiedenis van je hosting, CDN en deploys.
Stap 2: exporteren en groeperen per patroon
Open Indexering, dan Pagina's, en exporteer elke foutreden. Los URL's niet één voor één op. Zet ze in een spreadsheet en haal de eerste map eruit:
=REGEXEXTRACT(A2, "^https?://[^/]+(/[^/]*/?)")
Een draaitabel op die kolom laat meestal zien dat de meeste fouten uit twee of drie templates komen: een opgeheven blogcategorie, een filterparameter, een oude productfeed.
Stap 3: sorteren op zakelijke waarde
Stel bij elk patroon vier vragen. Krijgt het organische klikken? Heeft het backlinks? Wordt het intern gelinkt? Staat het in de sitemap? Een 404 zonder een van de vier kan eeuwig wachten. Een 404 met backlinks heeft vandaag een 301 nodig. De gratis checker voor kapotte links toont welke van je eigen pagina's nog naar dode URL's linken.
Stap 4: de grondoorzaak oplossen
Repareer regels, geen URL's. Een redirecttabel in je serverconfiguratie is beter dan 400 redirects die je met de hand in een plugin toevoegt. Bijvoorbeeld in nginx:
map $request_uri $new_uri {
    /old-blog/seo-tips/    /blog-geo-seo/seo-best-practices/;
    /old-blog/sitemaps/    /blog-geo-seo/how-to-create-a-sitemap/;
}
server {
    if ($new_uri) { return 301 $new_uri; }
}
Los bij 5xx de capaciteit of de bug op. Corrigeer bij 401 en 403 de beveiligingsregel. Voeg bij soft 404 echte inhoud toe of geef een echte 404 terug.
Stap 5: interne links en sitemaps opschonen
Elke interne link moet rechtstreeks naar een URL wijzen die 200 geeft. Elk sitemap-item moet een canonieke, indexeerbare 200-URL zijn. Een sitemap vol redirects en 404's leert Google hem minder te vertrouwen. Onze gids over een sitemap maken legt uit wat erin hoort.
Stap 6: valideren en bewaken
Open in het rapport Pagina-indexering de opgeloste reden en klik op Oplossing valideren. Google controleert eerst een steekproef en daarna de rest; dat duurt meestal tot ongeveer twee weken, en het stopt als ook maar één URL nog faalt. Klik niet opnieuw terwijl het loopt. Stel daarna een wekelijkse routine in: Crawlstatistieken voor de host, logs voor pieken, een crawl na elke deploy.
Een redirectketen voor en na de oplossing
Voor
http://site.com/page
301 naar https://site.com/page
301 naar https://www.site.com/page
301 naar https://www.site.com/page/
Interne links wijzen nog naar de eerste URL
Na
Eén 301 rechtstreeks naar https://www.site.com/page/
Interne links bijgewerkt naar de uiteindelijke URL
De sitemap bevat alleen de uiteindelijke URL
Eén verzoek in plaats van vier
Veelgemaakte fouten: zo herken en herstel je ze
Fout 1: elke 404 doorsturen naar de homepage
Wat het is: een plugin of regel die elke ontbrekende URL naar / stuurt. Hoe je het herkent: veel URL's onder „Soft 404" of „Pagina met omleiding" die allemaal op de homepage uitkomen; een crawler toont honderden 301's met hetzelfde doel. Hoe je het oplost: stuur alleen door naar een nauw verwant equivalent en laat de rest 404 of 410 geven.
Fout 2: Googlebot blokkeren met beveiligingstools
Wat het is: een WAF, botmanager of rate limiter die Google een 403, een 429 of een uitdagingspagina serveert. Hoe je het herkent: 403 of 429 in Crawlstatistieken terwijl de pagina in je browser gewoon laadt; de logs tonen de blokkades per IP. Hoe je het oplost: laat de geverifieerde Googlebot toe, via reverse DNS of de IP-reeksen die Google publiceert, in plaats van op de user-agent te vertrouwen.
Fout 3: een kwetsbare robots.txt
Wat het is: een robots.txt die door de applicatie wordt gegenereerd en dus uitvalt zodra de applicatie uitvalt, of die via een CDN-regel wordt geserveerd die een 5xx cachet. Hoe je het herkent: de categorie robots.txt ophalen in Hoststatus is niet groen. Hoe je het oplost: serveer hem als statisch bestand, buiten de applicatie, en test hem met de robots.txt-checker.
Fout 4: onderhoudspagina's die 200 geven
Wat het is: een pagina „We zijn zo terug" die met status 200 op elke URL wordt geserveerd. Hoe je het herkent: na het onderhoud een golf van soft 404's of dubbele titels. Hoe je het oplost: geef tijdens het onderhoud een 503 met Retry-After en houd het kort.
Fout 5: 403 gebruiken om Google af te remmen
Wat het is: 403 teruggeven aan Googlebot als de server overbelast is. Hoe je het herkent: 403-pieken die samenvallen met belastingspieken. Hoe je het oplost: volgens Google hebben 4xx-codes behalve 429 geen effect op de crawlsnelheid. Geef kort 503 of 429 terug en los de capaciteit op.
Fout 6: fouten één voor één oplossen
Wat het is: door de lijst in Search Console klikken en elke URL apart bewerken. Hoe je het herkent: dezelfde reden komt elke maand terug. Hoe je het oplost: groepeer per patroon, repareer de template of de regel en valideer één keer.
Fout 7: in paniek raken over onschuldige 404's
Wat het is: dagen besteden aan 404's voor spam-URL's of lang geleden verwijderde pagina's zonder links. Hoe je het herkent: de URL's hebben geen klikken, geen backlinks en geen interne links. Hoe je het oplost: laat ze staan. Google zegt dat een 404 voor een verwijderde pagina niet per se een probleem is.
Let op
Blokkeer nooit een URL in robots.txt om een crawlfout te „verbergen". Google ziet de 404 of de redirect dan niet meer, de URL kan geïndexeerd blijven en je verliest precies het signaal dat je wilde geven.
Crawlfouten en crawlbudget
Op een site met een paar honderd pagina's heeft Google tijd voor alles, en tellen crawlfouten vooral voor de pagina's die ze breken. Op grote sites (webwinkels met filters, marktplaatsen, nieuwssites) kost elk mislukt of verspild verzoek tijd die je echte pagina's nodig hebben. Dat is het idee achter het crawlbudget.
Hoe fouten crawlcapaciteit opslokken
5xx en 429 laten Google op de hele host vertragen, dus een paar kapotte templates kunnen het crawlen van je nieuwe productpagina's uitstellen. Redirectketens kosten één verzoek per sprong. Soft 404's kosten een volledige ophaalactie en leveren niets op. Los die drie op en hetzelfde budget dekt meer nuttige pagina's.
Wat „Gevonden, momenteel niet geïndexeerd" ermee te maken heeft
Als Google URL's vindt maar het crawlen uitstelt, is de oorzaak vaak een server die het als kwetsbaar beschouwt. Zie je het aantal „Gevonden, momenteel niet geïndexeerd" groeien samen met serverfouten in Crawlstatistieken, los dan eerst de server op. Beide rapporten vertellen hetzelfde verhaal.
Crawlfouten bij AI-crawlers
Googlebot is niet meer de enige bezoeker die telt. GPTBot, OAI-SearchBot, ClaudeBot en PerplexityBot halen pagina's op om modellen te trainen of om vragen in realtime te beantwoorden. Ze komen op dezelfde server en hebben last van dezelfde fouten, met één verschil: voor hen heb je geen Search Console.
Wat er verandert met AI-bots
De meeste AI-crawlers voeren geen JavaScript uit, dus een pagina die haar inhoud alleen in de browser opbouwt, kan voor hen leeg lijken, een soort soft 404 die je nooit in de rapporten van Google ziet. Veel ervan worden standaard geblokkeerd door botbeschermingsdiensten, vaak met een 403. En omdat ze pagina's op aanvraag ophalen wanneer een gebruiker een vraag stelt, betekent een time-out op dat moment dat het antwoord iemand anders citeert. Onze gids over JavaScript-SEO behandelt rendering voor zoekmachines en AI-crawlers.
Hoe je ze bewaakt
Je serverlogs zijn de enige betrouwbare bron. Filter op user-agent en bekijk de statuscodes:
Krijgen AI-bots 403's die je niet bedoelde, corrigeer dan de regel. Controleer daarna of ze je echt citeren: de AI-vermeldingstracking van Sorank volgt hoe vaak ChatGPT, Gemini, Claude en Perplexity je merk noemen, zodat je ziet of een crawlfix iets verandert.
Je checklist voor gezond crawlen
Loop deze lijst na bij elke migratie, redesign of grote deploy, en maandelijks bij grote sites.
Checklist voor gezond crawlen
Hoststatus groen voor DNS, serververbinding en robots.txt
robots.txt geserveerd als statisch bestand dat 200 geeft
Geen 5xx- of 429-pieken in Crawlstatistieken of logs
Geverifieerde Googlebot en gewenste AI-bots niet geblokkeerd door de firewall
Elke redirect is één sprong, 301 of 308, naar een 200-pagina
Interne links wijzen naar de uiteindelijke 200-URL's
Sitemaps bevatten alleen canonieke, indexeerbare 200-URL's
404's met backlinks of verkeer doorgestuurd naar een verwant equivalent
Lege pagina's opgelost of met een echte 404
Onderhoud geeft 503 met Retry-After
Oplossing valideren gestart voor elke opgeloste reden
Wat je vandaag kunt doen
Open Crawlstatistieken en controleer de drie regels van de hoststatus. Laat daarna de gratis indexeerbaarheidschecker los op je vijf waardevolste pagina's. Is alles schoon, exporteer dan de fouten uit Pagina-indexering en groepeer ze per map: je hebt nu een korte, geprioriteerde lijst met oplossingen in plaats van een eng rapport.
Is het crawlen eenmaal schoon, dan is de volgende grens de inhoud zelf. De contentoptimalisatie van Sorank herschrijft en vernieuwt je bestaande pagina's op autopilot, zodat de pagina's die Google nu bereikt het waard zijn om geïndexeerd en geciteerd te worden. Voor pagina's die Google heeft gecrawld maar heeft laten liggen, lees je onze gids over „Gecrawld, momenteel niet geïndexeerd".
Veelgestelde vragen
Wat zijn crawlfouten in SEO?
Crawlfouten zijn verzoeken van een zoekmachine of AI-crawler die mislukken: de DNS wordt niet opgelost, de server krijgt een time-out of geeft 5xx, robots.txt is niet op te halen, een redirect blijft rondjes draaien of een pagina geeft een 4xx-code. Sitefouten kunnen het crawlen van de hele site pauzeren, terwijl URL-fouten alleen de betreffende pagina raken.
Zijn 404-fouten slecht voor SEO?
Niet op zich. Google zegt dat een 404 voor een pagina die zonder vervanging is verwijderd niet per se een probleem is. Het wordt er een als de URL nog backlinks, verkeer of interne links heeft; dan is één 301 naar een verwant equivalent de juiste oplossing.
Hoe lang duurt het voordat Google ziet dat crawlfouten zijn opgelost?
Nadat je in het rapport Pagina-indexering van Search Console op Oplossing valideren hebt geklikt, duurt de validatie meestal tot ongeveer twee weken. Google controleert eerst een steekproef van URL's en daarna de rest, en stopt als ook maar één betrokken URL nog faalt.
y!
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je $1500 per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer