Předvolby
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací
Na soukromí nám záleží, proto můžete vypnout některé typy úložišť, které nejsou nezbytné pro základní fungování webu. Blokování kategorií může ovlivnit váš zážitek z webu. Více informací

 Google Search Console a opravit, co ukazuje
Naučte se přesně číst každý graf přehledu Crawl Stats v Google Search Console, zjistěte, co oproti logům serveru přehlíží, a opravte, co ukazuje.

Nástroje

Stručně
Přehled Crawl Stats v Google Search Console ukazuje, jak Googlebot žádá vaše URL: kolik požadavků odešle, kolik bajtů stáhne, jak rychle váš server odpovídá a jaké stavové kódy dostává zpět. Nejdřív si přečtěte stav hostitele, pak kódy odpovědí, a nakonec rozdělení podle účelu a typu souboru. Přehled je souhrn, ne log, takže ho použijte k nalezení problému a potvrďte ho v logách serveru.
Chcete jít dál? Zeptejte se
Rychlý kvíz
Kdo má opravit technickou stránku vašeho webu?
Naše doporučení pro vás
Zkontrolujte to sami pomocí bezplatných nástrojů Googlu
Search Console vypíše stránky, které Google nedokáže přečíst, a PageSpeed Insights testuje rychlost. Mnoho drobných problémů se opraví v nastavení tvorby webu.
Naše doporučení pro vás
Webový vývojář
Problém je v kódu nebo na serveru: správný člověk je vývojář, který zná SEO. Dejte mu seznam chyb ze Search Console.
Naše doporučení pro vás
Nástroj pro technický audit
Váš web má mnoho stránek: crawler je přečte všechny stejně jako Google a vypíše úplný seznam chyb k opravě, stránku po stránce.
Naše doporučení pro vás
Automatický audit, pak obsah
Váš web funguje, ale přináší málo návštěvníků: technické problémy bývají jen zřídka příčinou. Sorank web auditne a poté napíše stránky, které přivedou návštěvnost.
Crawl Stats je pohled ze strany Google na aktivitu Googlebota na vašem webu. Říká, co Googlebot udělal, ne proč vaše stránky ve výsledcích jsou nebo nejsou. Google přehled popisuje jako určený pro pokročilé uživatele a web s méně než tisícem stránek ho možná vůbec nepotřebuje. Pokud provozujete malý prezentační web, můžete ho přeskočit, dokud se něco nezmění.
Search Console je jeden produkt s mnoha přehledy. Jeho veřejná stránka pokrývá procházení a indexaci obecně: mapy stránek, Kontrola URL, pokrytí indexu. Crawl Stats je v Nastavení, ne v hlavním menu, proto ho mnoho lidí nikdy neotevře.
Přehled je dostupný jen pro vlastnosti na kořenové úrovni: vlastnost Doména nebo vlastnost s předponou URL postavenou na kořeni webu. Vlastnost pro podsložku, například example.com/blog/, ho nedostane. Data pokrývají jen doménu, kterou vyberete. Požadavky na sesterské subdomény se neobjeví v přehledu jiné subdomény, ale pohled na nadřazenou doménu zahrnuje všechny její subdomény. Http i https se počítají ve stejném pohledu.
Poznámka
Pokud váš web používá jazykové subdomény jako en.example.com a de.example.com, otevřete každou zvlášť. Každá má vlastní data a rozbitá německá subdoména se v anglickém pohledu neukáže.
Přehled otevřete, když platí aspoň jedna z těchto možností: publikujete mnoho stránek, změnili jste strukturu URL nebo hosting, Googlebot jako by navštěvoval méně než dřív, nebo se stránky objevují, ale nikdy se neindexují. Web, který přidá několik článků měsíčně, se z něj moc nenaučí kromě chyb, a ty se lépe najdou běžným procházením webu.
Otevřete svou vlastnost, přejděte do Nastavení, najděte Crawl stats a klikněte na Otevřít přehled. Nahoře jsou tři grafy: celkový počet požadavků na procházení, celková velikost stahování a průměrná doba odezvy. Pod nimi je stav hostitele a čtyři rozdělení: odpovědi procházení, typ souboru, účel procházení a typ Googlebota. Každé rozdělení je procento založené na počtu požadavků.
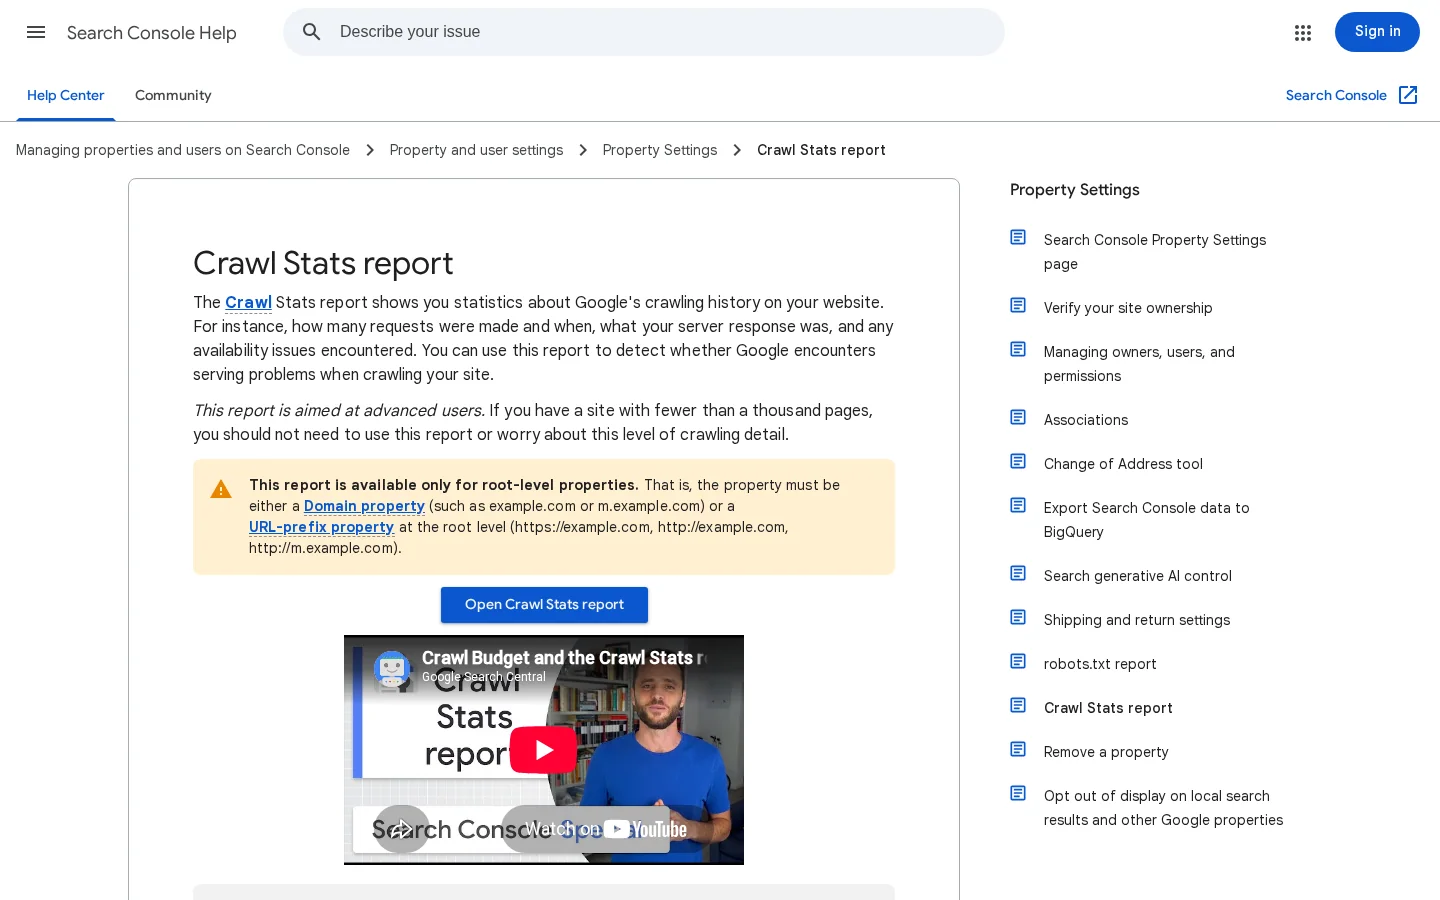
Takto počítá každá část a jak ji číst.
| Část přehledu | Co počítá | Jak číst |
|---|---|---|
| Celkové požadavky na procházení | Všechny požadavky na vaše URL, úspěšné či ne, včetně neúspěšných pokusů o DNS, připojení a smyček přesměrování. Počítají se i pokusy blokované robots.txt. | Náhlý pokles nebo skok: zkontrolujte změny v robots.txt a struktuře URL ke stejným datům. |
| Celková velikost stahování | Bajty stažené při procházení. Zdroj v mezipaměti se počítá jen při prvním požadavku. | Bajty rostoucí, zatímco požadavky stojí, znamenají, že vaše stránky ztěžkly. |
| Průměrná doba odezvy | Průměrný čas načtení každého zdroje, přičemž každý propojený zdroj se počítá zvlášť. | Sledujte trend, ne jednu hodnotu. Sledujte ji po každém nasazení. |
| Stav hostitele | Načtení robots.txt, překlad DNS a dostupnost serveru. Zelená znamená žádný závažný problém za 90 dní, žlutá problémy starší než týden, červená problémy za poslední týden. | Každá žlutá nebo červená položka je nejdřív problém serveru nebo sítě, až potom problém SEO. |
| Odpovědi procházení | Podíl odpovědí podle typu, na základě počtu požadavků. | Sledujte podíl špatných odpovědí v čase. Samotný počet je méně důležitý. |
| Typ souboru | Podíl odpovědí podle typu: HTML, obrázek, JavaScript, CSS, PDF, JSON, video. Počítá se podle počtu odpovědí, ne bajtů. | Ukazuje, kam Googlebot posílá své požadavky. Velký podíl JavaScriptu a CSS znamená, že stránky závisí na mnoha zdrojích. |
| Účel procházení | Objevení (URL, kterou Google nikdy nenačetl) nebo obnovení (opětovné procházení známé URL). | Viz část o objevení a obnovení níže. |
| Typ Googlebota | Smartphone, Desktop, Obrázky, Video, Načtení zdrojů stránky, AdsBot, StoreBot, ostatní. | U webu indexovaného primárně pro mobily by měl být největší skupinou Smartphone. Náhlá změna si zaslouží kontrolu. |
Každé rozdělení počítá požadavky. URL, kterou Googlebot načte 50krát, se počítá 50krát. Věta „40 % odpovědí je 301“ tedy říká, kolik požadavků narazilo na přesměrování, ne kolik URL se přesměrovává. Abyste zjistili, o která URL jde, potřebujete logy. Příklady URL, které Google ukazuje, jsou vzorek a Google uvádí, že nejsou úplné.
Nápověda Google uvádí, že přehled nyní zachycuje většinu požadavků na procházení, ale některé se nemusí počítat. Také uvádí, že neúspěšné požadavky, které se nikdy nedostanou na váš server, se v logách neobjeví. Proto přehled ukazuje chyby DNS a připojení, které vaše logy nevidí, a proto byste měli číst oba zdroje. Google neuvádí dobu uchovávání grafů, takže pokud chcete historii, ukládejte si každý měsíc vlastní kopii, snímek obrazovky nebo krátkou poznámku s čísly.
Rozdělení odpovědí je část přehledu, která nejčastěji vede k opravě. Čtěte ji v tomto pořadí a zastavte se u prvního kroku, který ukazuje skutečný problém.
Pět kroků třídění odpovědí procházení
Google dělí odpovědi do tří skupin. Toto rozdělení je první filtr, ne verdikt o každé URL.
401 se v přehledu počítá jako špatné, ale je správně, pokud stránka leží za přihlášením, které má zůstat zavřené. Rozhodujte URL po URL. Přehled vám řekne, na kterou skupinu se podívat, a rozhodnete vy, jaká má být každá odpověď.
302 se počítá jako dobrá odpověď, takže podíl přesměrování může vypadat zdravě, a přitom plýtvá procházením. V jedné analýze velkého webu, zveřejněné v dubnu 2021 na Search Engine Journal od Tomka Rudzkiho z Onely, šlo 16 % požadavků na přesměrované stránky a autor doporučoval kontrolovat každý krok přesměrování.
Takhle řetězec škodí. Předpokládejme, že /blog/seo-tips přesměrovává na /blog/seo-tips-2025, který přesměrovává na /blog/seo-tips-guide. Googlebot potřebuje tři požadavky, aby se dostal k obsahu, a každý interní odkaz, který stále ukazuje na první URL, opakuje tento náklad. Nasměrujte první URL přímo na konečnou adresu a aktualizujte interní odkazy, aby přestaly používat staré cesty. Bezplatná kontrola přesměrování sleduje řetězec libovolné URL krok za krokem, takže vidíte cestu dřív, než opravíte. Pokud si nejste jisti, zda má být přesměrování trvalé, přečtěte si náš průvodce přesměrováním 301 vs 302: 301 znamená trvalé přesunutí, 302 dočasné.
Tip
Seřaďte URL přesměrování podle toho, jak často je Googlebot ve vašich logách žádá. Opravte nejdřív pět řetězců, o které je největší zájem. Obvykle tvoří většinu podílu přesměrování.
Průvodce Google pro velké weby uvádí, že když web odpovídá chybami serveru (5XX) nebo signály omezení rychlosti, jako je HTTP 429, Google snižuje svůj limit rychlosti procházení. Nárůst 5XX vás tedy stojí víc než rozbité URL. Může zpomalit i procházení vašich zdravých stránek. Rozpočet procházení webu závisí částečně na tom, jak dobře server odpovídá, a odpovědi 5XX ho zmenšují.
Když vidíte nárůst 5XX, podívejte se, kdy nastává. Chyby ve stejnou hodinu každý den ukazují na zálohovací úlohu, plánovaný import nebo špičku provozu. Chyby hned po vydání ukazují na to vydání. Chyby rozložené přes celý den ukazují na kapacitu. Každý vzorec má jinou opravu a žádný se neřeší úpravou jedné stránky.
Rozdělení podle účelu procházení dělí požadavky na objevení, kdy Google vidí URL poprvé, a obnovení, kdy znovu prochází URL, kterou už zná. Poměr mezi nimi ukazuje, na co Google čas utrácí.
Jeden velký web, jeden den procházení
Zdroj: Tomek Rudzki (Onely), Search Engine Journal, duben 2021. Jeden web s přibližně 1 milionem stránek a zásobníkem URL se stavem „Discovered, currently not indexed“.
Stejná analýza udělala užitečný hrubý odhad. Při tomto tempu odhadla, že zpracování zásobníku by trvalo zhruba rok. Toto číslo je výpočet jednoho autora pro jeden web a snímky pochází z roku 2021, takže ho nekopírujte. Metoda funguje i na vašich datech: vydělte počet URL čekajících na objevení počtem objevovacích procházení za den ve vašem přehledu. Pokud výsledek vychází v měsících, máte problém s procházením, který je třeba opravit, než publikujete víc.
Rozdělení typů souborů počítá odpovědi, ne bajty, takže ukazuje, kolik požadavků jde na každý typ zdroje, ne jak jsou těžké. Přesměrování spadají pod „Other file type“ a neúspěšné požadavky se objevují jako „Unknown (Failed)“. Rostoucí podíl Unknown (Failed) je signál selhání, ne typ souboru, a měli byste ho řešit spolu se špatnými odpověďmi.
Existují tři způsoby, jak vidět, co Googlebot na vašem webu dělal: přehled Crawl Stats, logy vašeho serveru a nástroj Kontrola URL v Search Console. Každý odpovídá na jinou otázku a každý má slepá místa, která pokrývají ostatní dva. Pro skutečný problém použijte všechny tři.
Princip: souhrn požadavků Googlebota pro celou vlastnost, počítaný Googlem. Kdy použít: pro trendy, stav hostitele a první přehled problému. Výhody: je zdarma, pokrývá selhání, která se nikdy nedostanou na váš server, a přidává účel a typ Googlebota, což logy přímo nedávají. Omezení: je to souhrn, některé požadavky se nemusí počítat a příkladové URL jsou vzorek. Příklad: podíl 5XX tři dny roste na jednom hostiteli. Přehled ukazuje dny a hostitele, logy ukazují URL a hodiny.
Princip: surový záznam, který váš webový server zapisuje pro každý přijatý požadavek. Kdy použít: pro přesné seznamy URL, stavové kódy podle hodin a důkazy za trendem v přehledu. Výhody: úplné pro každý požadavek, který dorazil na server, s přesnou URL a stavovým kódem. Omezení: logy neobsahují požadavky, které selhaly dřív, než dorazily na server, user agent lze padělat a většina serverů logy po čase rotuje nebo maže. Zde je příkaz, který počítá stavové kódy požadavků označených jako Googlebot v logu ve formátu combined:
grep "Googlebot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnPříkaz hledá řetězec user agenta a pak počítá stavový kód, který je v combined formátu logu devátým polem. Pokud váš server zapisuje jiný formát, změňte číslo pole. Výsledkem je tabulka počtů podle stavového kódu, s nejčastějším nahoře.
Varování
Kdokoli může poslat požadavek, který se tváří jako Googlebot. Než podle podezřelého nárůstu něco uděláte, ověřte, že IP adresy patří Googlu. Google pro to dokumentuje kontrolu zpětného DNS a stojí za to ji udělat, než cokoli blokujete nebo přesměrujete podle user agenta.
Princip: kontrola jedné URL, ukazuje, kdy ji Google naposledy načetl, co dostal a zda je indexovaná. Kdy použít: k potvrzení jedné opravy, například zda Google načetl opravenou stránku poté, co jste ji změnili. Výhody: rychlý, přesný a snadno čitelný pro jednu URL. Omezení: jedna URL najednou, takže nemůže ukázat vzorec napříč webem. V analýze zmíněné výše nástroj ukázal, že hlavní stránka kategorie nebyla tři měsíce procházena, a autor ho pro tu stránku použil místo logů.
Přehled Crawl Stats versus logy serveru
| Metoda | Na jakou otázku odpovídá | Rozsah | Slepé místo |
|---|---|---|---|
| Přehled Crawl Stats | Je Googlebot zdravý a jak se chová celkově? | Celá vlastnost, shrnutá | Vzorkové příkladové URL a některé požadavky se nemusí počítat |
| Logy serveru | Které konkrétní URL dostaly jakou odpověď a kdy? | Každý požadavek, který dorazil na server | Neúspěšné pokusy o DNS a připojení a user agenti, které lze padělat |
| Kontrola URL | Kdy Google tuto stránku naposledy načetl a co dostal? | Jedna URL | Neříká nic o zbytku webu |
Jeden měsíc dat vám toho moc neřekne. Přehled se stane užitečným, když ho porovnáte se svým normálem, takže veďte krátký záznam a kontrolujte ho každý měsíc ve stejný den. Tato rutina funguje pro většinu webů.
Měsíční kontrola v šesti krocích
Signály, které tento měsíc stojí za akci
Předpokládejme, že přesouváte blog z /old-blog/ do /blog/ s přesměrováními 301. Hned po přesunu očekávejte růst podílu přesměrování, protože Googlebot se stále ptá na staré cesty. Během následujících týdnů by měl podíl klesat, jak Google poznává nové URL. Očekávejte i růst podílu objevení, protože nové URL jsou pro Google nová. Pokud podíl přesměrování zůstává vysoký i po několika týdnech, hledejte řetězce, staré interní odkazy nebo přesměrování, na která jste zapomněli. Náš průvodce opravou rozbitých odkazů pokrývá odkazovou stránku stejného úklidu.
Většina chyb pramení z toho, že se jeden graf čte jako verdikt. Každá z pěti níže uvedených chyb má v přehledu jasný příznak a opravu, kterou můžete zkontrolovat v logách.
Co to je: předpoklad, že více požadavků na procházení znamená lepší SEO. Jak to poznat: požadavky prudce rostou po vydání, které přidalo možnosti filtrování nebo řazení, a nová URL nesou parametry. Jak to opravit: zkontrolujte podíl objevení a vzorce URL ve svých logách. Opravte generátor URL: přestaňte odkazovat na URL s parametry, nebo použijte canonical a zablokujte ty, které nemají vyhledávací hodnotu. Vyšší počet nevyžádaných požadavků je náklad, ne zisk.
Co to je: dívat se na průměr a přehlédnout špičky, které skrývá. Jak to poznat: průměr vypadá rovně, ale vaše logy ukazují pomalé odezvy ve stejnou hodinu každou noc. Jak to opravit: seskupte logy podle hodiny a podle URL, pak porovnejte pomalé hodiny se zálohami, importy a nasazeními. Opravte pomalou úlohu nebo pomalou šablonu a pak průměr zkontrolujte znovu. Průměr je čára trendu a čára trendu nemůže říct, kde zpomalení začíná.
Co to je: předpoklad, že web je zdravý, protože se otevírá ve vašem prohlížeči. Jak to poznat: stav hostitele ukazuje žlutou nebo červenou u robots.txt, DNS nebo připojení, zatímco vaše stránky fungují. Googlebot se k webu dostává jinými síťovými cestami a firewall, pravidlo CDN nebo záznam DNS ho mohou blokovat, aniž by ovlivnily váš prohlížeč. Jak to opravit: zkontrolujte, že se soubor robots.txt načte s odpovědí 200, pomocí kontroly robots.txt, a pak projděte pravidla firewallu a CDN k datu, kdy stav zčervenal.
Co to je: změna robots.txt, která omezí požadavky na procházení, následovaná přehledem, který vypadá klidněji. Jak to poznat: celkové požadavky v den změny robots.txt prudce klesnou. Jak to opravit: pokles může být správný, pokud jste zablokovali nevyžádané cesty, ale zkontrolujte, zda důležité sekce webu se stále procházejí. Podívejte se do logů na sekce, na kterých záleží. Pokud je zablokovaná stránka, kterou potřebujete, náš průvodce stavem blokováno robots.txt vysvětluje, jak najít pravidlo a co změnit.
Co to je: považovat dobře procházenou stránku za indexovanou. Jak to poznat: Googlebot URL pravidelně žádá, ale URL se neobjevuje ve výsledcích Google. Vysoký počet procházení neprokazuje, že ji Google drží. Jak to opravit: přejděte z přehledu Crawl Stats na přehledy indexace stránek a zkontrolujte stav URL. Náš průvodce procházeno, zatím neindexováno vysvětluje příčiny a průvodce indexací Google pokrývá kontroly v pořadí.
| Chyba | Jak ji poznat | Jak ji opravit |
|---|---|---|
| Celkové požadavky jako skóre | Požadavky rostou poté, co se objeví parametry URL | Zastavte generování nevyžádaných URL, pak přepočítejte |
| Jen průměrná doba odezvy | Pomalé hodiny skryté plochým průměrem | Seskupte logy podle hodiny, spárujte pomalé hodiny s úlohami |
| Ignorovaný stav hostitele | Žlutý nebo červený, zatímco stránky se otevírají v prohlížeči | Zkontrolujte robots.txt, DNS, firewall a pravidla CDN |
| Pokles procházení čten jako pokrok | Požadavky klesnou v den změny robots.txt | Potvrďte, že důležité sekce se stále procházejí |
| Záměna procházení s indexací | Pravidelné procházení, URL chybí ve výsledcích | Zkontrolujte stav indexace URL |
Dashboard GEO / SEO od Sorank vedle sebe ukazuje kliknutí, zobrazení, CTR a pozici z Search Console a návštěvy, které vám posílají asistenti AI, načtené z Google Analytics. Nezobrazuje požadavky Googlebota, takže pro tu práci si ponechte přehled Crawl Stats. Oba nástroje odpovídají na jiné otázky: dashboard říká, co vám Google posílá, Crawl Stats říká, jak Google navštěvuje váš server.
Tip
Než strávíte čas v logách nad jednou stránkou, zkontrolujte, zda ji Google vůbec může indexovat, pomocí bezplatné kontroly indexovatelnosti Google. Na první otázku odpoví během několika sekund.
| Co vidíte | Začněte s | Potom otevřete |
|---|---|---|
| Stav hostitele červený nebo žlutý | Kontrola robots.txt, pak DNS a stav hostingu | Logy serveru ke stejným datům |
| Podíl 5XX roste | Vaše logy seskupené podle hodiny a URL | Kapacita serveru nebo šablona, která selhává |
| Vysoký podíl přesměrování | Kontrola přesměrování na nejčastějších URL | Řetězce přesměrování a staré interní odkazy |
| Mnoho objevených URL, málo indexovaných | Kontrola indexovatelnosti na vzorcích | Náš průvodce analýzou logových souborů |
Přehled Crawl Stats je dobrá první obrazovka. Říká, jaký druh problému tušit a ve kterých datech. Oprava skoro vždy leží v seznamu URL a ten seznam je ve vašich logách. Začněte přehledem, pak přejděte k URL.
Otevřete svou vlastnost, přejděte do Nastavení, vyberte Crawl stats a klikněte na Otevřít přehled. Přehled existuje jen pro vlastnosti typu Doména a pro vlastnosti s předponou URL na kořenové úrovni, takže vlastnost podsložky ho nezobrazí.
Samo o sobě ne. Součet počítá každý požadavek, včetně neúspěšných a pokusů blokovaných robots.txt, takže ukazuje, jak často Googlebot navštěvuje, ne jak zdravé jsou tyto návštěvy. Čtěte ho spolu s kódy odpovědí a průměrnou dobou odezvy.
Ne samostatně. Google uvádí, že některé požadavky se nemusí počítat a jeho příkladové URL nejsou úplné. Přehled používejte pro trendy a kategorie chyb, logy pro přesné URL.
Analyzujeme vaši konkurenci, váš web a vaši viditelnost v AI, abychom pro vás zdarma připravili obsahový plán na míru.
 Generátor zadání článku s AI
 Generátor schématu FAQ
 Generátor nápadů na blogové články s AI
 Validátor strukturovaných dat (validátor schématu)
 Kontrola alternativních textů
 Analyzátor interních odkazů
 Výzva zpětných odkazů
 Generátor meta popisů s AI
 Generátor titulků blogu s AI
 Kontrola indexovatelnosti pro Google
 Generátor osnovy článku s AI
 Tvůrce UTM odkazů
 Nástroj pro clustering klíčových slov
 Kontrola kanonické značky
 Generátor XML sitemap
 Kontrola nefunkčních odkazů
 Generátor SEO titulků s AI
 Analyzátor nadpisů
 Nástroj pro náhled SERP
 Kontrola přesměrování
 Generátor značek hreflang
 Analyzátor struktury nadpisů
 Kontrola HTTP hlaviček
 Extraktor favicon
 Kalkulačka CTR v SERP
 Kalkulačka úspor SEO oproti placenému vyhledávání
 Kalkulačka podílu hlasu v SEO
 Kalkulačka ROI SEO
 Kalkulačka předpovědi návštěvnosti a tržeb SEO
 Kalkulačka rozpočtu SEO
 Kalkulačka bodu zvratu SEO
 Kalkulačka ROI SEO pro SaaS
 Kalkulačka ROAS
 Kalkulačka doby čtení
 Simulátor zisku pozic
 Kalkulátor hodnoty organické návštěvnosti
 Odhad organické návštěvnosti a kontrola návštěvnosti webu
 Kalkulátor poměru LTV a CAC
 Kalkulátor ROI lokálního SEO
 Kalkulátor nákladů na budování zpětných odkazů
 Kalkulátor hodnoty klíčových slov
 Kalkulačka skóre příležitosti klíčových slov
 Kalkulačka hustoty klíčových slov
 Kalkulačka ROI GEO
 Kalkulačka investice do obsahu GEO
 Kalkulačka návratnosti SEO pro e-shop
 Kalkulačka celoživotní hodnoty zákazníka
 Kalkulačka nákladů na získání zákazníka
 Kalkulátor CTR
 Kalkulátor ceny za článek
 Kalkulátor míry konverze
 Kalkulátor ROI obsahového marketingu
 Odhad návštěvnosti z ChatGPT
 Kalkulátor míry odchodů
 Kalkulátor ROI zpětných odkazů
 Kalkulátor skóre viditelnosti v AI
 Kalkulačka hodnoty návštěvnosti z AI
 Kalkulačka podílu hlasů v AI
 Kalkulačka ceny neviditelnosti v AI
 Kalkulačka míry citování v AI
 Validátor llms.txt
 Kontrola AI Overviews a kontrola pozic v AI Overviews
 Kontrola robots.txt
 Audit AI SEO
 Kontrola čitelnosti pro LLM
 Kontrola připravenosti pro SearchGPT
 Audit strukturovaných dat pro LLM
 Audit procházení webu pro AI
 Proč ChatGPT nedoporučuje můj web
 Nástroj pro kontrolu pozic v Gemini
 Kontrola pořadí v Perplexity
 Kontrola citací v LLM
 Audit optimalizace pro odpovědní enginy
 Audit GEO
 Test viditelnosti ve vyhledávání AI
 Kontrola viditelnosti v ChatGPT
 Generátor llms.txt
 Extraktor URL
 Převod stránky do Markdownu
 Kontrola sitemapy
 Senzor volatility SERP
 Kontrola velikosti stránky
 Počítadlo slov
 Generátor slugů
 Generátor schema
 Generátor robots
 Náhled OG
 Generátor meta značek
 Kompresor obrázků
 Generátor favicon
 Audit on-page SEO: kontrola a analýza SEO
 Nástroj pro analýzu zpětných odkazů
 Nástroj pro výzkum klíčových slov
 Kontrola autority domény
 “Sorank jsem otestoval na skutečném webu klienta a je to neuvěřitelné. Dělá všechno, za co by vám agentura účtovala 1500 $ měsíčně. Právě ho nasazujeme do provozu na tomto klientovi.”

 Guillaume Guersanguersanguillaume.com“Jsme reklamní agentura a chtěli jsme konečně dostat naše SEO na pravou míru. Sorank nám poskytl jasný pohled na náš web, pomohl nám určit priority optimalizací a správně strukturovat náš obsah. Nástroj se snadno používá, je dobře navržený pro tým a velmi praktický, protože centralizuje sledování bez nutnosti žonglovat s více platformami. Velmi pevný základ pro nový start našeho SEO.”
 Gaspard MadouiReklamní agentura
 “Nechal jsem software Sorank dělat svou práci a teď je moje DR 25 a moje stránka se umisťuje výš.”
 Lucas Flandrefoundertrace.fr“Díky Sorank se specializuji na GEO. Žebříček GEO mi umožňuje ukázat klientům jejich postavení oproti konkurenci v ChatGPT. Je to skutečná obchodní výhoda.”
 MélanieSEO freelancer“Skvělá služba, dobře funguje pro náš web a pomáhá nám pochopit, jak ho zlepšit, aby se lépe umisťoval ve výsledcích Google a jinde. Gratulujeme, pokračujte, doporučuji.”
 Hugo T.Majitel e-shopu