Налаштування
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше
Ми цінуємо вашу приватність, тому ви можете вимкнути певні типи зберігання даних, які не потрібні для базової роботи вебсайту. Блокування категорій може вплинути на ваш досвід користування сайтом. Докладніше

 Google Search Console і виправляти те, що він показує
Вчимося читати кожен графік звіту «Статистика сканування» в Google Search Console, що він пропускає порівняно з серверними логами і як виправляти показане.

Інструменти

Коротко
звіт «Статистика сканування» у Google Search Console показує, як Googlebot запитує URL вашого сайту: скільки запитів надсилає, скільки байтів завантажує, як швидко відповідає ваш сервер і які коди статусу повертаються. Спочатку перегляньте статус хоста, потім коди відповідей, а потім розбивку за призначенням і типом файлів. Звіт є зведенням, а не журналом, тож використовуйте його, щоб знайти проблему, а потім підтвердіть її в серверних логах.
Хочете дізнатися більше? Запитайте
Швидкий тест
Хто має виправляти технічну частину вашого сайту?
Наша порада для вас
Перевірте самі безкоштовними інструментами Google
Search Console показує сторінки, які Google не може прочитати, а PageSpeed Insights перевіряє швидкість. Багато дрібних проблем виправляються в налаштуваннях конструктора сайту.
Наша порада для вас
Веб-розробник
Проблема в коді або на сервері: вам потрібен розробник, який знається на SEO. Дайте йому список помилок із Search Console.
Наша порада для вас
Інструмент технічного аудиту
На вашому сайті багато сторінок: сканер читає їх усі так, як Google, і дає повний список помилок для виправлення, сторінка за сторінкою.
Наша порада для вас
Автоматичний аудит, потім контент
Ваш сайт працює, але відвідувачів мало: технічні проблеми рідко є причиною. Sorank перевіряє сайт, а потім пише сторінки, що приводять відвідувачів.
Статистика сканування є поглядом з боку Google на активність Googlebot на вашому сайті. Вона показує, що робив Googlebot, але не пояснює, чому ваші сторінки ранжуються або не ранжуються. Google описує звіт як призначений для досвідчених користувачів, а сайту з менш ніж тисячею сторінок він може взагалі не знадобитися. Якщо у вас невеликий сайт-візитка, можна пропустити його, поки нічого не змінюється.
Search Console є одним продуктом із багатьма звітами. Його публічна сторінка описує сканування та індексування загалом: карти сайту, перевірку URL, покриття індексу. Статистика сканування розташована в розділі «Налаштування», а не в головному меню, тому багато хто її ніколи не відкриває.
Звіт є лише у ресурсів рівня кореня: ресурсу «Домен» або ресурсу з префіксом URL, побудованого на корені сайту. Ресурс для підпапки, наприклад example.com/blog/, звіту не отримує. Дані охоплюють лише той домен, який ви обрали. Запити до сусідніх піддоменів не з'являються у звіті іншого піддомену, але подання батьківського домену включає всі його піддомени. Протоколи http і https враховуються в одному поданні.
Примітка
Якщо ваш сайт використовує мовні піддомени, наприклад en.example.com і de.example.com, відкривайте кожен окремо. У кожного свої дані, і зламаний німецький піддомен не видно в англійському поданні.
Відкрийте звіт, якщо правдиве щось із цього: ви публікуєте багато сторінок, ви змінили структуру URL або хостинг, Googlebot почав заходити на сайт рідше, або сторінки виявляються, але ніколи не індексуються. Сайт, на якому з'являється кілька статей на місяць, з цього звіту майже нічого не винесе, крім помилок, а помилки краще знаходити під час звичайного сканування сайту.
Відкрийте свій ресурс, перейдіть у «Налаштування», знайдіть «Статистику сканування» і натисніть «Відкрити звіт». Угорі три графіки: загальна кількість запитів на сканування, загальний обсяг завантаження і середній час відповіді. Нижче розташовані статус хоста і чотири розбивки: відповіді під час сканування, тип файлу, мета сканування та тип Googlebot. Кожна розбивка є відсотком від кількості запитів.
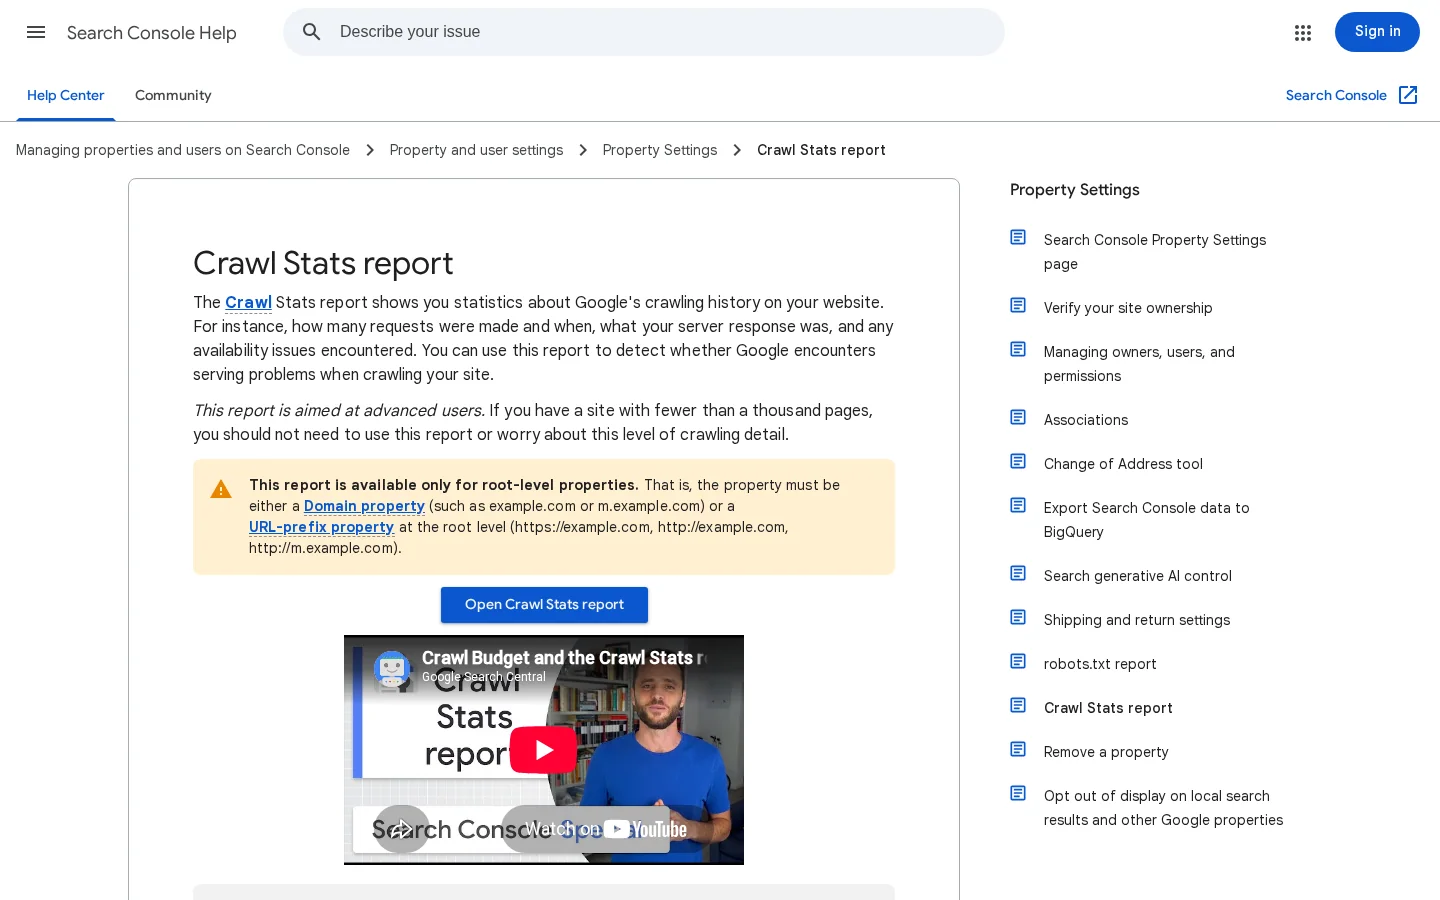
Ось що рахує кожна частина і як її читати.
| Частина звіту | Що рахує | Як читати |
|---|---|---|
| Загальна кількість запитів на сканування | Усі запити до ваших URL, успішні чи ні, включно з невдалими спробами DNS, з'єднання та циклів перенаправлень. Спроби, заблоковані robots.txt, також враховуються. | Різке падіння або стрибок: перевірте зміни robots.txt і структуру URL за ті самі дати. |
| Загальний обсяг завантаження | Байти, завантажені під час сканування. Кешований ресурс враховується лише при першому запиті. | Зростання байтів за незмінної кількості запитів означає, що сторінки стали важчими. |
| Середній час відповіді | Середній час отримання кожного ресурсу; кожен пов'язаний ресурс враховується окремо. | Дивіться на тренд, а не на одне значення. Стежте за ним після кожного оновлення. |
| Статус хоста | Завантаження robots.txt, розв'язання DNS і доступність сервера. Зелений означає відсутність значущих проблем за останні 90 днів, жовтий означає проблеми старші за тиждень, червоний означає проблеми за останній тиждень. | Будь-який червоний або жовтий пункт спершу є проблемою сервера або мережі, і лише потім проблемою SEO. |
| Відповіді під час сканування | Частка відповідей за типами, за кількістю запитів. | Стежте за часткою поганих відповідей у часі. Сирі цифри важать менше. |
| Тип файлу | Частка відповідей за типами: HTML, зображення, JavaScript, CSS, PDF, JSON, відео. Рахується за кількістю відповідей, а не байтів. | Показує, на що Googlebot витрачає запити. Велика частка JavaScript і CSS означає, що сторінки залежать від багатьох ресурсів. |
| Мета сканування | Виявлення (URL, який Google ніколи не сканував) або оновлення (повторне сканування відомого URL). | Див. розділ про виявлення та оновлення нижче. |
| Тип Googlebot | Smartphone, Desktop, Image, Video, Page resource load, AdsBot, StoreBot та інші. | Для сайту з індексуванням за мобільною версією Smartphone має бути найбільшою групою. Раптовий зсув варто перевірити. |
Кожна розбивка рахує запити. URL, який Googlebot завантажує 50 разів, враховується 50 разів. Тому «40% відповідей становлять 301» говорить про те, скільки запитів потрапляє на перенаправлення, а не про те, скільки URL перенаправляються. Щоб дізнатися, які саме URL задіяні, потрібні ваші логи. Приклади URL, які показує Google, є вибіркою, і Google каже, що вони не є повними.
Довідка Google зазначає, що звіт наразі враховує більшість запитів на сканування, але деякі запити можуть не враховуватися. Там також сказано, що невдалі запити, які не доходять до вашого сервера, не з'являються у логах. Тому звіт показує помилки DNS і з'єднання, яких ваші логи не бачать, і тому обидва джерела варто читати. Google не повідомляє строку зберігання графіків, тож якщо потрібна історія, зберігайте власну копію щомісяця: скриншот або короткий запис цифр.
Розбивка відповідей є тією частиною звіту, яка найчастіше веде до виправлення. Читайте її в такому порядку і зупиняйтеся на першому кроці, який показує реальну проблему.
Сортування відповідей під час сканування за п'ять кроків
Google ділить відповіді на три групи. Це групування є первинним фільтром, а не оцінкою кожного URL.
Відповідь 401 у звіті вважається поганою, але вона правильна, якщо сторінка за логіном, який має залишатися закритим. Вирішуйте це для кожного URL. Звіт показує, на яку групу дивитися, а що має повертати кожна відповідь, вирішуєте ви.
Відповідь 302 вважається доброю, тож частка перенаправлень може виглядати здоровою, попри те що вона все одно витрачає сканування. В аналізі великого сайту, опублікованому у квітні 2021 року в Search Engine Journal Томеком Рудзькі з Onely, 16% запитів вели на перенаправлені сторінки, а автор радив перевіряти кожен перехід у ланцюжку.
Ось як шкодить ланцюжок. Припустимо, /blog/seo-tips перенаправляє на /blog/seo-tips-2025, який перенаправляє на /blog/seo-tips-guide. Googlebot потрібні три запити, щоб дійти до вмісту, і кожне внутрішнє посилання, яке досі веде на першу URL, повторює цю витрату. Спрямуйте першу URL напряму на кінцеву адресу і оновіть внутрішні посилання, щоб вони перестали використовувати старі шляхи. Безкоштовна перевірка перенаправлень проходить ланцюжок URL крок за кроком, тож ви бачите шлях до виправлення. Якщо ви не певні, чи має перенаправлення бути постійним, прочитайте наш гід 301 проти 302: 301 означає, що переїзд постійний, 302 означає, що тимчасовий.
Порада
Відсортуйте URL з перенаправленнями за тим, як часто Googlebot запитує їх у ваших логах. Спершу виправте п'ять найчастіше запитуваних ланцюжків. Зазвичай саме на них припадає більша частина частки перенаправлень.
Посібник Google для великих сайтів говорить, що коли сайт відповідає помилками сервера (5XX) або сигналами обмеження частоти, такими як HTTP 429, Google знижує ліміт швидкості сканування. Тож сплеск 5XX коштує вам більше, ніж самі зламані URL. Він може сповільнити сканування і ваших справних сторінок. Краулінговий бюджет сайту частково залежить від того, наскільки добре відповідає сервер, і відповіді 5XX його зменшують.
Коли ви бачите сплеск 5XX, дивіться, коли він відбувається. Помилки в одну й ту саму годину щодня вказують на завдання резервного копіювання, плановий імпорт або пік трафіку. Помилки одразу після релізу вказують на реліз. Помилки, розкидані по всьому дню, вказують на брак потужності. Кожен шаблон має своє рішення, і жодне з них не вирішується правкою однієї сторінки.
Розбивка за метою сканування ділить запити на виявлення, коли Google вперше бачить URL, і оновлення, коли він повторно сканує вже відомий URL. Співвідношення між ними показує, на що Google витрачає час.
Один великий сайт, один день сканування
Джерело: Томек Рудзькі (Onely), Search Engine Journal, квітень 2021. Сайт приблизно на 1 мільйон сторінок із накопиченням URL у статусі «Discovered, currently not indexed».
Той самий аналіз зробив корисну грубу перевірку. За такого темпу автор оцінив, що накопичення зайняло б близько року на сканування. Ця цифра є розрахунком одного автора для одного сайту, а скриншоти датовані 2021 роком, тож не копіюйте її. Метод працює і на ваших даних: поділіть кількість URL, що очікують на виявлення, на кількість сканувань виявлення за день у вашому звіті. Якщо результат вимірюється місяцями, у вас є проблема зі скануванням, яку потрібно вирішити до публікації нових сторінок.
Розбивка за типами файлів рахує відповіді, а не байти, тож вона показує, скільки запитів іде на кожен тип ресурсу, але не те, наскільки вони важкі. Перенаправлення потрапляють у «Other file type», а невдалі запити відображаються як «Unknown (Failed)». Зростаюча частка Unknown (Failed) є сигналом помилки, а не типом файлу, і її слід розбирати разом із поганими відповідями.
Є три способи побачити, що робив Googlebot на вашому сайті: звіт «Статистика сканування», серверні логи та інструмент «Перевірка URL» у Search Console. Кожен відповідає на своє питання, і в кожного є сліпі зони, які закривають два інші. Для справжньої проблеми використовуйте всі три.
Принцип: зведення запитів Googlebot для всього ресурсу, яке рахує Google. Коли використовувати: для трендів, статусу хоста і первинного огляду проблеми. Переваги: він безкоштовний, охоплює помилки, які ніколи не доходять до вашого сервера, і додає призначення та тип Googlebot, яких логи напряму не дають. Обмеження: це зведення, частина запитів може не враховуватися, а приклади URL є вибіркою. Приклад: частка 5XX зростає три дні на одному хості. Звіт показує дні та хост, а ваші логи показують URL і години.
Принцип: сирий запис, який веб-сервер робить для кожного отриманого запиту. Коли використовувати: для точних списків URL, кодів статусу за годинами та даних, на яких ґрунтується тренд у звіті. Переваги: повні дані для кожного запиту, що дійшов до сервера, з точним URL і кодом статусу. Обмеження: вони не містять запитів, які не дійшли до сервера, user agent можна підробити, а більшість серверів ротують або видаляють логи через певний час. Ось команда, яка рахує коди статусу для запитів, визначених як Googlebot, у журналі у форматі combined:
grep "Googlebot" access.log | awk '{print $9}' | sort | uniq -c | sort -rnКоманда шукає рядок user agent, а потім рахує код статусу, який у форматі combined є дев'ятим полем. Якщо ваш сервер пише в іншому форматі, змініть номер поля. Результат є таблицею кількостей за кодами статусу, з найчастішим кодом угорі.
Увага
Будь-хто може надіслати запит, який видає себе за Googlebot. Перш ніж діяти за підозрілим сплеском, переконайтеся, що IP-адреси належать Google. Google описує перевірку зворотного DNS для цього, і її варто зробити, перш ніж блокувати або перенаправляти щось на основі user agent.
Принцип: перевірка одного URL, яка показує, коли Google востаннє його завантажував, що отримав і чи проіндексований він. Коли використовувати: щоб підтвердити одне виправлення, наприклад те, чи завантажив Google виправлену сторінку після зміни. Переваги: швидко, точно і легко читається для одного URL. Обмеження: один URL за раз, тож він не покаже закономірність по всьому сайту. В аналізі, згаданому вище, інструмент показав, що головна сторінка категорії не скановувалася три місяці, і автор використав його замість логів для цієї сторінки.
Звіт «Статистика сканування» проти серверних логів
| Метод | На яке питання відповідає | Охоплення | Сліпа зона |
|---|---|---|---|
| Статистика сканування | Чи здоровий Googlebot і як він поводиться загалом? | Весь ресурс, у зведенні | Вибірка прикладів URL, і частина запитів може не враховуватися |
| Серверні логи | Які точні URL отримали яку відповідь і коли? | Кожен запит, що дійшов до сервера | Невдалі спроби DNS і з'єднання, а також user agent, які можна підробити |
| Перевірка URL | Коли Google востаннє завантажував цю сторінку і що отримав? | Один URL | Нічого не каже про решту сайту |
Дані за один місяць мало що кажуть. Звіт стає корисним, коли ви порівнюєте його з власною нормою, тож ведіть короткий запис і переглядайте його в один і той самий день кожного місяця. Це рутина, яка працює для більшості сайтів.
Місячний огляд у шість кроків
Сигнали, що потребують дій цього місяця
Припустимо, ви переносите блог із /old-blog/ до /blog/ з перенаправленнями 301. Одразу після переїзду очікуйте зростання частки перенаправлень, адже Googlebot досі запитує старі шляхи. Протягом наступних тижнів частка має знижуватися, коли Google вивчить нові URL. Очікуйте також зростання частки виявлення, бо нові URL для Google нові. Якщо частка перенаправлень залишається високою через кілька тижнів, шукайте ланцюжки, старі внутрішні посилання або перенаправлення, які ви забули додати. Наш гід з виправлення битих посилань описує посилальну частину того самого прибирання.
Більшість помилок виникає, коли один графік читають як вирок. Кожна з п'яти помилок нижче має явну ознаку в звіті та виправлення, яке можна перевірити у ваших логах.
Що це: припущення, що більше запитів на сканування означає кращий SEO. Як помітити: запити різко зростають після релізу, що додав опції фільтрації чи сортування, а нові URL містять параметри. Як виправити: перевірте частку виявлення і шаблони URL у логах. Виправте генератор URL: припиніть посилатися на URL з параметрами або встановіть канонічний адрес і закрийте від індексування ті, що не мають пошукової цінності. Більша кількість зайвих запитів є витратою, а не виграшем.
Що це: дивитися на середнє і пропускати сплески, які воно приховує. Як помітити: середнє виглядає рівним, але ваші логи показують повільні відповіді в одну й ту саму годину щоночі. Як виправити: згрупуйте логи за годиною і URL та зіставте повільні години з резервними копіями, імпортами та релізами. Виправте повільне завдання або шаблон, а потім перевірте середнє знову. Середнє є лінією тренду, а лінія тренду не скаже, де починається сповільнення.
Що це: припущення, що сайт здоровий, бо він відкривається у вашому браузері. Як помітити: статус хоста жовтий або червоний за robots.txt, DNS чи з'єднанням, тоді як ваші сторінки працюють у вас. Googlebot потрапляє на сайт іншими мережевими шляхами, і брандмауер, правило CDN або запис DNS можуть його заблокувати, не впливаючи на ваш браузер. Як виправити: переконайтеся, що файл robots.txt завантажується з відповіддю 200, за допомогою перевірки robots.txt, а потім переглядте правила брандмауера та CDN за дати, коли статус став червоним.
Що це: зміна robots.txt, яка скорочує запити на сканування, а за нею звіт, що виглядає спокійнішим. Як помітити: загальна кількість запитів різко падає в день зміни robots.txt. Як виправити: спад може бути правильним, якщо ви заблокували сміттєві шляхи, але перевірте, що важливі розділи досі скануються. Подивіться в логах на розділи, які мають значення. Якщо потрібна сторінка заблокована, наш гід зі статусом заблоковано robots.txt пояснює, як знайти правило і що змінити.
Що це: вважати добре проскановану сторінку проіндексованою. Як помітити: Googlebot регулярно запитує URL, але його немає в результатах Google. Висока кількість сканувань не доводить, що Google зберігає сторінку. Як виправити: перейдіть від звіту «Статистика сканування» до звітів про індексування сторінок і перевірте статус URL. Наш гід про статус проскановано, але не проіндексовано пояснює причини, а гід про індексування в Google описує перевірки по порядку.
| Помилка | Як помітити | Як виправити |
|---|---|---|
| Загальна кількість запитів як оцінка | Запити зростають після появи параметрів URL | Припиніть створювати сміттєві URL і перерахуйте |
| Лише середній час відповіді | Повільні години приховані плоским середнім | Групуйте логи за годинами і зіставляйте повільні години із завданнями |
| Статус хоста ігнорується | Жовтий або червоний, поки сторінки відкриваються в браузері | Перевірте robots.txt, DNS, брандмауер і правила CDN |
| Спад сканування прийнято за прогрес | Запити падають у день зміни robots.txt | Переконайтеся, що важливі розділи досі скануються |
| Сканування сплутано з індексуванням | Регулярні сканування, URL відсутній у результатах | Перевірте статус індексування URL |
Панель GEO/SEO від Sorank поруч із відвідуваннями, які надсилають ШІ-асистенти (за даними Google Analytics), показує кліки, покази, CTR і позиції з Search Console. Вона не показує запитів Googlebot, тож для цього завдання залиште звіт «Статистика сканування». Два інструменти відповідають на різні питання: панель показує, що Google надсилає вам, а Статистика сканування показує, як Google заходить на ваш сервер.
Порада
Перш ніж витрачати час у логах на одну сторінку, перевірте, чи взагалі Google може її індексувати, за допомогою безкоштовної перевірки індексованості. Вона відповідає на перше питання за кілька секунд.
| Що ви бачите | Почніть із | Потім відкрийте |
|---|---|---|
| Статус хоста червоний або жовтий | Перевірка robots.txt, потім статус DNS і хостингу | Серверні логи за ті самі дати |
| Частка 5XX зростає | Логи, згруповані за годиною і URL | Потужність сервера або шаблон, що ламається |
| Висока частка перенаправлень | Перевірка перенаправлень на головних URL | Ланцюжки перенаправлень і старі внутрішні посилання |
| Багато URL виявлено, мало проіндексовано | Перевірка індексованості на вибірці | Наш гід з аналізу лог-файлів |
Звіт «Статистика сканування» є добрим першим екраном. Він підказує, яку проблему підозрювати і в які дати. Виправлення майже завжди міститься у списку URL, а цей список у ваших логах. Почніть зі звіту, а потім переходьте до URL.
Відкрийте ресурс, перейдіть у «Налаштування», виберіть «Статистику сканування» і натисніть «Відкрити звіт». Звіт є лише у ресурсів «Домен» і ресурсів з префіксом URL на рівні кореня, тож ресурс для підпапки його не покаже.
Саме по собі ні. Загальна кількість враховує кожен запит, включно з невдалими та заблокованими robots.txt, тож вона показує, скільки Googlebot заходить, а не наскільки здорові ці заходи. Читайте її разом із кодами відповідей і середнім часом відповіді.
Не лише на неї. Google каже, що частина запитів може не враховуватися, а його приклади URL не повні. Використовуйте звіт для трендів і категорій помилок, а логи для точних URL.
Ми аналізуємо ваших конкурентів, ваш сайт і вашу видимість у ШІ, щоб безкоштовно скласти персоналізований контент-план.
 ШІ-генератор брифів для контенту
 Генератор FAQ-розмітки
 ШІ-генератор ідей для статей у блозі
 Валідатор структурованих даних (валідатор Schema)
 Перевірка alt-тексту
 Аналізатор внутрішніх посилань
 Челендж із зворотних посилань
 ШІ-генератор мета-описів
 ШІ-генератор заголовків для блогу
 Перевірка індексованості в Google
 ШІ-генератор плану статті для блогу
 Конструктор UTM-посилань
 Інструмент кластеризації ключових слів
 Перевірка тегу canonical
 Генератор XML-карти сайту
 Перевірка битих посилань
 ШІ-генератор SEO-заголовків
 Аналізатор заголовків
 Попередній перегляд пошукової видачі
 Перевірка перенаправлень
 Генератор тегів hreflang
 Аналізатор структури заголовків
 Перевірка HTTP-заголовків
 Екстрактор фавіконок
 Калькулятор CTR у видачі
 Калькулятор економії SEO порівняно з платним пошуком
 Калькулятор частки голосу в SEO
 Калькулятор ROI від SEO
 Калькулятор прогнозу трафіку та доходу від SEO
 Калькулятор бюджету SEO
 Калькулятор беззбитковості SEO
 Калькулятор ROI від SEO для SaaS
 Калькулятор ROAS
 Калькулятор часу читання
 Симулятор приросту позицій
 Калькулятор вартості органічного трафіку
 Оцінювач органічного трафіку та перевірка відвідуваності сайту
 Калькулятор співвідношення LTV до CAC
 Калькулятор ROI локального SEO
 Калькулятор вартості лінкбілдингу
 Калькулятор вартості ключового слова
 Калькулятор оцінки можливостей ключових слів
 Калькулятор щільності ключових слів
 Калькулятор ROI GEO
 Калькулятор інвестицій у GEO-контент
 Калькулятор ROI SEO для інтернет-магазину
 Калькулятор пожиттєвої цінності клієнта
 Калькулятор вартості залучення клієнта
 Калькулятор CTR
 Калькулятор вартості статті
 Калькулятор коефіцієнта конверсії
 Калькулятор ROI контент-маркетингу
 Оцінювач реферального трафіку з ChatGPT
 Калькулятор показника відмов
 Калькулятор ROI зворотних посилань
 Калькулятор оцінки видимості у ШІ
 Калькулятор вартості AI-трафіку
 Калькулятор частки голосу в ШІ
 Калькулятор вартості невидимості в ШІ
 Калькулятор частоти цитування в ШІ
 Валідатор llms.txt
 Перевірка AI Overview і позицій в AI Overviews
 Перевірка robots.txt
 SEO-аудит для ШІ
 Перевірка читабельності для LLM
 Перевірка готовності до SearchGPT
 Аудит структурованих даних для LLM
 ШІ-аудит доступності сайту для краулерів
 Чому ChatGPT не рекомендує мій сайт
 Інструмент позицій у Gemini
 Перевірка позицій у Perplexity
 Перевірка цитування в LLM
 Аудит оптимізації для відповідних систем (AEO)
 GEO-аудит
 Тест видимості в ШІ-пошуку
 Перевірка видимості в ChatGPT
 Генератор llms.txt
 Екстрактор URL
 Веб-сторінка в Markdown
 Перевірка карти сайту
 Сенсор волатильності видачі
 Перевірка розміру сторінки
 Лічильник слів
 Генератор слагів
 Генератор Schema
 Генератор Robots
 Попередній перегляд Open Graph
 Генератор мета-тегів
 Компресор зображень
 Генератор фавіконок
 SEO-аудит сторінки: SEO-перевірка та SEO-аналіз
 Інструмент аналізу зворотних посилань
 Інструмент підбору ключових слів
 Перевірка авторитету домену
 “Я протестував Sorank на реальному сайті клієнта, і це неймовірно. Він робить усе, за що агенція виставила б вам рахунок на 1500 доларів на місяць. Тепер його запускають у роботу на цьому клієнті.”

 Guillaume Guersanguersanguillaume.com“Ми рекламна агенція і хотіли раз і назавжди повернути своє SEO в нормальне русло. Sorank дав нам чітке уявлення про наш сайт, допоміг розставити пріоритети оптимізацій і належним чином структурувати наш контент. Інструмент простий у використанні, добре продуманий для команди й дуже зручний для централізованого відстеження без жонглювання кількома платформами. Дуже міцна основа, щоб почати наше SEO з нуля.”
 Gaspard MadouiРекламна агенція
 “Я просто дозволив програмі Sorank повністю робити свою справу, і тепер мій показник DR дорівнює 25, а моя сторінка піднялася вище в пошуку.”
 Lucas Flandrefoundertrace.fr“Я спеціалізувалася на GEO завдяки Sorank. Рейтинг GEO дає змогу показувати клієнтам їхню позицію щодо конкурентів у ChatGPT. Це справжня комерційна перевага.”
 MélanieSEO-фрілансерка“Чудовий сервіс, добре працює для нашого сайту й допомагає зрозуміти, як його покращити, щоб вище ранжуватися в Google та поза ним. Вітаю, так тримати, рекомендую.”
 Hugo T.Власник інтернет-магазину