La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Explorée, actuellement non indexée : ce que cela signifie et comment corriger
Explorée, actuellement non indexée : Google a visité la page mais l'a laissée hors de son index. Trouvez la cause (qualité, doublons, rendu) et corrigez-la.
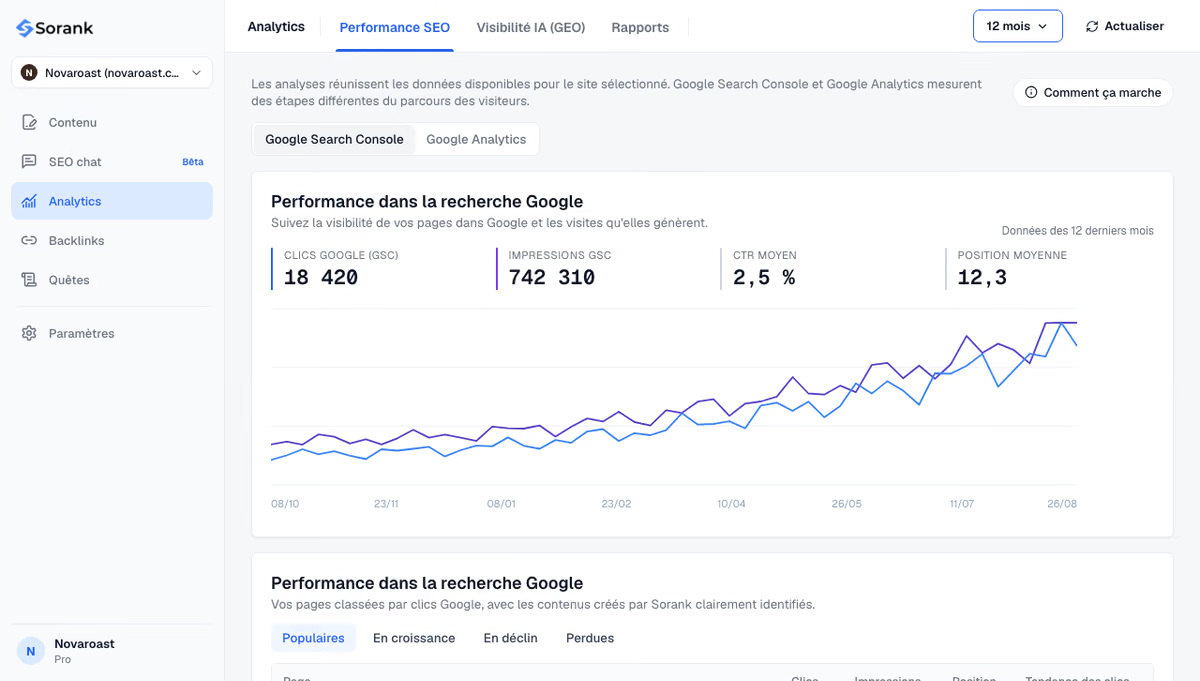
Couverture de l’article « Explorée, actuellement non indexée », avec une capture du logiciel Sorank à côté du titre
Outils
Sur cette page
En bref
« Explorée, actuellement non indexée » est un statut du rapport Indexation des pages de Google Search Console. Il signifie que Googlebot a récupéré la page, puis a décidé de ne pas l'ajouter à l'index, donc l'URL ne peut pas apparaître dans les résultats de recherche pour le moment. Les causes habituelles : un contenu que Google juge peu utile ou peu distinct, des quasi-doublons, un contenu qui n'apparaît qu'après l'exécution de JavaScript, ou des pages reliées par peu de liens internes. Corrigez la cause sur la page, renforcez ses liens internes, puis attendez une nouvelle exploration : soumettre seulement l'URL à nouveau ne change rien.
Qui doit corriger la partie technique de votre site ?
Question 1 sur 425%
Notre conseil pour vous
Le contenu apporte trop peu est la bonne solution pour vous
N°1 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
La page est trop proche d'une autre est la bonne solution pour vous
N°2 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
Le contenu n'existe qu'après l'exécution de JavaScript est la bonne solution pour vous
N°3 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
Le site signale que la page n'est pas importante est la bonne solution pour vous
N°4 de ce classement, le plus proche de vos réponses.
Explorée, actuellement non indexée fait partie des raisons listées sous « Pourquoi les pages ne sont pas indexées » dans Search Console, et c'est souvent la plus importante sur les sites de contenu et les boutiques en ligne. La documentation du rapport Indexation des pages de Google le décrit en deux phrases : « La page a été explorée par Google mais pas indexée. Elle peut l'être ou non à l'avenir ; inutile de soumettre de nouveau cette URL pour exploration. » Ce guide explique ce que Google a décidé, quelles URL peuvent rester dans ce statut, comment trouver la vraie cause pour celles qui comptent, et quelle correction convient à chaque cause.
Que signifie « Explorée, actuellement non indexée » ?
Google traite une URL en trois étapes : découverte et exploration, puis indexation, puis classement (notre entrée de glossaire sur l'exploration et l'indexation détaille chacune d'elles). Une page dans ce statut a franchi la première étape : Googlebot a demandé la page et reçu une réponse. Elle s'est arrêtée à la deuxième : après avoir traité le contenu, Google a choisi de ne pas le stocker dans son index.
Ce choix est délibéré et documenté. Le guide de Google sur le fonctionnement de la recherche indique que « l'indexation n'est pas garantie ; toutes les pages traitées par Google ne seront pas indexées ». Il cite trois raisons fréquentes : une faible qualité de contenu, des règles robots de type meta qui interdisent l'indexation, et une conception de site qui rend l'indexation difficile. Une règle noindex produit son propre statut (« Exclue par la balise « noindex » »), donc une page listée comme explorée mais non indexée pointe surtout vers la première et la troisième raison.
Trois points à garder en tête :
Ce n'est pas une pénalité. Aucune action manuelle n'est en jeu, et le reste du site n'est pas sanctionné.
Ce n'est pas définitif. Google indique que la page « peut être indexée ou non à l'avenir ». Chaque nouvelle exploration est une nouvelle décision.
Cela peut concerner des pages qui étaient indexées. Google retire régulièrement les URL qu'il ne juge plus utiles à conserver, donc un ancien article peut passer dans ce statut sans aucun changement de votre part.
Pour l'ensemble du processus d'indexation et les leviers qui l'accélèrent, voir notre guide sur l'indexation Google.
Explorée ou Détectée, actuellement non indexée : quelle différence ?
Les deux statuts se ressemblent, mais ils s'arrêtent à des étapes différentes, donc leurs corrections diffèrent.
Statut
Étape atteinte
Ce que dit Google
Levier principal
Détectée, actuellement non indexée
URL connue, pas encore explorée
« La page a été trouvée par Google, mais pas encore explorée », souvent parce que l'exploration « risquait de surcharger le site »
Capacité du serveur, budget d'exploration, moins d'URL peu utiles
Explorée, actuellement non indexée
Explorée, non indexée
« Explorée par Google mais pas indexée »
Qualité de la page, unicité, rendu, liens internes
Page en double sans URL canonique sélectionnée par l'utilisateur
En bref, « Détectée » relève surtout d'un problème d'exploration, et « Explorée » d'une décision d'indexation. Améliorer la vitesse du serveur déplace rarement une page explorée dans l'index ; améliorer la page elle-même, si.
Est-ce un problème, ou peut-on laisser ces URL tranquilles ?
Tout site d'une certaine taille a des URL dans ce statut, et beaucoup ne devraient jamais se classer. Avant de corriger quoi que ce soit, triez la liste par type d'URL. Un nombre stable d'URL peu utiles n'est pas inquiétant ; une hausse soudaine, ou des pages importantes dans la liste, le sont.
Type d'URL
Verdict habituel
Action
Flux RSS, URL /feed/
Normal
Aucune
Pages de pagination (page 2, 3...)
Généralement normal
Aucune, tant que les éléments listés sont indexés
URL avec paramètres (tri, filtre, suivi)
Normal
Vérifier que l'URL propre est indexée ; limiter les liens internes vers les versions avec paramètres
Pages d'étiquettes et archives pauvres
Souvent mérité
Améliorer, fusionner ou passer en noindex
Fiches produit épuisées ou expirées
Souvent mérité
Rediriger, mettre à jour ou laisser partir
Articles de blog, pages de services, pages de catégorie
Problème
Diagnostiquer et corriger (sections suivantes)
Pages publiées récemment
Souvent temporaire
Revérifier après quelques semaines
Astuce
Exportez la liste du rapport, puis regroupez les URL par dossier ou par motif dans un tableur. Dix motifs d'URL sont plus faciles à juger que 3000 URL isolées, et le motif révèle souvent la cause.
Pourquoi Google explore-t-il une page sans l'indexer ?
1. Le contenu apporte trop peu
C'est la cause la plus fréquente. Les pages de quelques lignes, au contenu générique qui répète ce que des dizaines de pages indexées disent déjà, ou les pages construites sur un modèle où seul un nom a changé, sont du contenu mince typique. Les recommandations de Google sur la création de contenu utile demandent si une page apporte « une valeur substantielle par rapport aux autres pages des résultats de recherche ». Une page qui échoue à ce test peut être explorée encore et encore sans être indexée.
2. La page est trop proche d'une autre
Les quasi-doublons (variantes de produit avec la même description, pages de villes qui ne changent que le nom de la ville, versions imprimables) sont souvent regroupés et laissés de côté. Quand Google identifie clairement le doublon, vous voyez en général un statut de canonique ; quand la similitude est partielle, la page peut atterrir ici. Une balise canonical cohérente et un contenu réellement distinct règlent la question.
3. Le contenu n'existe qu'après l'exécution de JavaScript
Les bases du SEO JavaScript de Google décrivent trois phases, exploration, rendu et indexation, et notent qu'une page en attente de rendu « peut rester dans cette file quelques secondes, mais parfois plus longtemps ». Si le HTML brut est presque vide et que le texte n'apparaît qu'après le rendu (ou si le rendu échoue parce qu'un script ou un appel d'API est bloqué), Google peut évaluer une page quasi vide. Le rendu côté serveur ou la pré-génération supprime ce risque ; notre guide sur le SEO JavaScript présente les options.
4. Le site signale que la page n'est pas importante
Une page accessible seulement depuis le sitemap, ou enfouie à cinq clics de profondeur avec un seul lien depuis une archive paginée, indique à Google qu'elle compte peu pour vous. Les liens internes venant de pages indexées et visitées sont l'un des signaux les plus forts que vous maîtrisez.
5. Autres cas
Certaines URL apparaissent ici pour des raisons extérieures à la page : le rapport a du retard (l'URL peut déjà être indexée), une cible de redirection a été explorée via l'ancienne URL, ou des pages d'erreur souple (recherche sans résultat, « aucun produit trouvé ») renvoient un code 200. Ces cas demandent une vérification, pas une réécriture.
Comment diagnostiquer « Explorée, actuellement non indexée » pas à pas
Ouvrez le rapport. Dans Search Console, allez dans Indexation, puis Pages, et cliquez sur « Explorée, actuellement non indexée » sous « Pourquoi les pages ne sont pas indexées ». Notez la tendance : une hausse soudaine suit souvent une migration, un changement de thème ou un lot de nouvelles pages.
Triez les URL par type avec le tableau ci-dessus, et ne gardez que les pages que vous voulez voir dans les résultats de recherche.
Inspectez chaque URL importante. Collez-la dans l'outil d'inspection d'URL. Confirmez le statut, la date de la dernière exploration, et que l'exploration comme l'indexation sont autorisées. Vous pouvez aussi tester une page en quelques secondes avec notre vérificateur d'indexabilité gratuit.
Écartez les faux positifs. Si « L'URL est sur Google » apparaît, le rapport est en retard et la page n'a besoin de rien.
Testez l'URL en direct et regardez le HTML rendu. Si le texte principal, les liens ou le titre manquent dans la version rendue, le problème vient du rendu.
Comparez avec les pages qui se classent. Cherchez la requête visée et lisez les premiers résultats. S'ils répondent plus complètement, ou dans un autre format, votre page présente un écart de qualité ou d'intention.
Comptez les liens internes pointant vers la page, par exemple avec notre analyseur de liens internes. Zéro ou un seul lien vers une page profonde est un signal faible.
Attention
Google indique qu'il n'y a « pas besoin de soumettre de nouveau cette URL pour exploration ». Demander l'indexation d'une page inchangée ne modifie pas la décision de Google. Faites-le une fois, après une modification significative de la page.
Comment corriger : une correction par cause
Cause trouvée
Correction
Contenu mince ou générique
Réécrire avec des informations originales : données, exemples, étapes, comparaisons, réponse claire à la requête
Plusieurs pages faibles sur un même sujet
Les fusionner en une page forte et rediriger les autres avec une 301
Quasi-doublon d'une autre page
La rendre distincte, ou pointer une balise canonical vers la version principale
Contenu généré par JavaScript
Rendu côté serveur ou pré-génération ; vérifier que les scripts et les API ne sont pas bloqués
Peu ou pas de liens internes
Ajouter des liens contextuels depuis des pages liées et indexées ; relier la page depuis les hubs et les menus si elle est importante
Intention de recherche mal ciblée
Adapter le format à ce qui se classe (guide, liste, outil, page produit)
Page sans raison de se classer
La passer en noindex, la rediriger ou la supprimer, et la retirer du sitemap
Deux habitudes rendent les corrections durables. D'abord, faites un audit de contenu régulier : élaguer ou fusionner les pages faibles élève la qualité moyenne de ce que Google explore. Ensuite, gardez le sitemap XML propre, avec seulement les URL canoniques et indexables que vous voulez voir classées, et soumettez-le de nouveau à Google après un grand nettoyage.
Combien de temps faut-il pour qu'une page soit indexée après une correction ?
Rien ne se passe tant que Googlebot n'a pas exploré la page de nouveau, ce qui peut prendre de quelques jours à plusieurs semaines selon la fréquence de passage de Google sur votre site. Une fois plusieurs URL corrigées, vous pouvez cliquer sur « Valider la correction » dans le rapport ; Google indique que la validation « prend en général environ deux semaines, mais peut parfois être bien plus longue ». La validation est facultative : le rapport se met à jour seul à mesure que les pages sont explorées de nouveau.
Pour un grand site, vérifier les URL une à une est lent. L'API d'inspection d'URL autorise 2000 requêtes par jour et 600 par minute pour chaque site, selon les limites d'utilisation de l'API Search Console, de quoi suivre quelques centaines de pages prioritaires dans le temps. Si une page reste dans ce statut après deux ou trois nouvelles explorations, la correction n'a pas suffi : reprenez d'abord la qualité et l'intention.
Pourquoi cela compte-t-il pour le SEO et pour la visibilité dans les assistants IA ?
Une page hors de l'index de Google n'apporte aucun clic organique, quelle que soit sa qualité. Sur un site de contenu, une grande part d'articles dans ce statut représente aussi un effort de production perdu, et signale à Google que le site publie des pages dont il n'a pas besoin, ce qui peut ralentir l'indexation des nouvelles.
Les assistants IA ajoutent une seconde raison. ChatGPT, Perplexity et Gemini répondent à de nombreuses questions en récupérant des pages dans les index de recherche du web, puis citent les sources utilisées. Une page non indexée a beaucoup moins de chances d'être récupérée, donc d'être citée. Notre étude sur les plateformes que les IA citent le plus montre les sources qu'elles privilégient quand elles répondent.
Sorank est notre produit : un logiciel SEO et GEO en autopilote. Son tableau de bord GEO et SEO affiche les clics, impressions et positions issus de Search Console, pour voir quand les pages corrigées commencent à recevoir des impressions, et son générateur d'articles rédige des articles sourcés avec les liens internes déjà en place, les deux éléments que ce statut sanctionne le plus souvent.
En résumé : triez les URL, ignorez celles qui ne doivent pas se classer, et corrigez la cause sur les pages qui comptent (contenu, doublons, rendu, liens internes) avant de demander à Google de regarder de nouveau. Pour publier dès le départ des pages qui sont indexées et citées, voir les offres Sorank, à partir de 49€ par mois, avec un essai gratuit de 3 jours.
Questions fréquentes
« Explorée, actuellement non indexée » nuit-il au reste de mon site ?
Non, aucune pénalité n'est appliquée au site, et les pages indexées conservent leur classement. Le statut signifie seulement que les URL listées ne sont pas dans l'index. Une part très importante de pages dans ce statut peut toutefois signaler un problème de qualité à l'échelle du site, qui mérite d'être corrigé par un nettoyage et une consolidation du contenu.
Faut-il demander l'indexation de chaque page dans ce statut ?
Non. Google indique qu'il n'est pas nécessaire de soumettre de nouveau ces URL, et une demande sur une page inchangée ne modifie pas sa décision. Améliorez d'abord la page, puis demandez l'indexation une seule fois dans l'outil d'inspection d'URL pour les URL importantes, et laissez les autres être explorées naturellement.
Pourquoi un ancien article qui était indexé est-il passé dans ce statut ?
Google réévalue les pages indexées au fil du temps et peut retirer celles qu'il ne juge plus utiles, par exemple lorsque des pages plus récentes et plus complètes couvrent le même sujet. Mettre l'article à jour avec des informations actuelles, ajouter des liens internes depuis des pages liées, ou le fusionner avec une page plus forte permet en général de le faire revenir.
y!
Audit SEO et GEO gratuit
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
Croissance organiqueGénération de leads pour installateurs
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne