La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Détectée, actuellement non indexée : ce que cela signifie et comment le corriger
« Détectée, actuellement non indexée » : Google connaît l'URL mais ne l'a pas explorée. Causes réelles (serveur, budget d'exploration, liens) et correctifs.
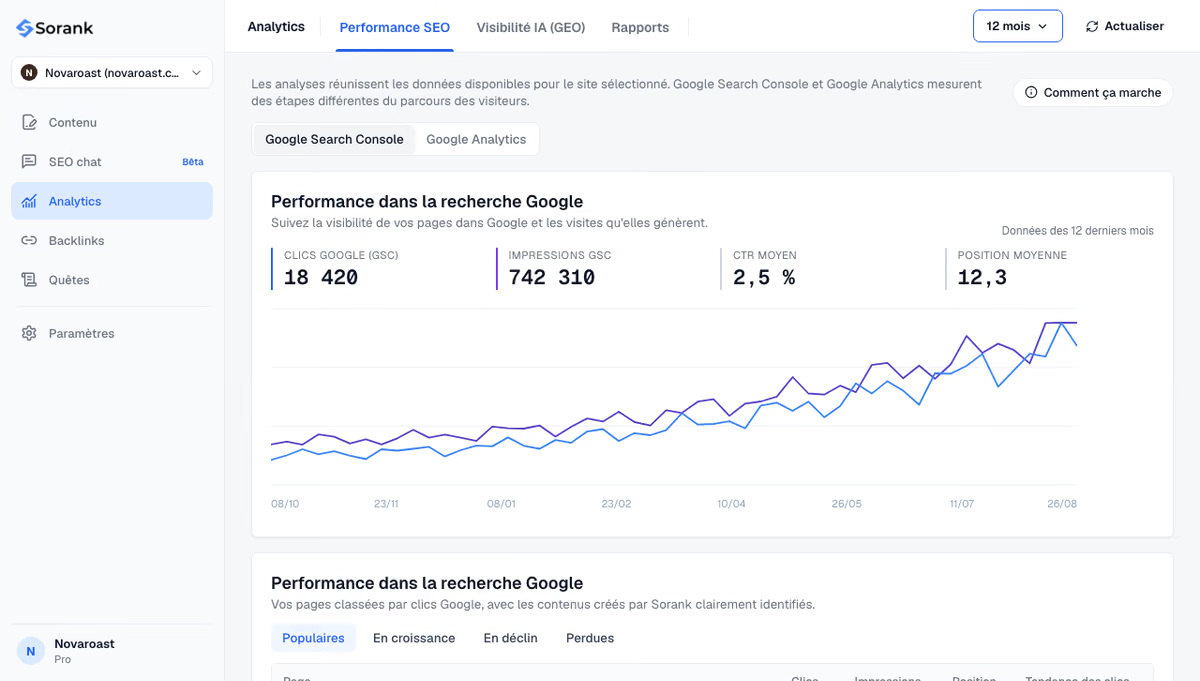
Couverture de l’article « Détectée, actuellement non indexée », avec une capture du logiciel Sorank à côté du titre
Outils
Sur cette page
En bref
« Détectée, actuellement non indexée » est un statut du rapport Indexation des pages dans Google Search Console. Il signifie que Google a trouvé l'URL (par un lien ou un plan de site) mais ne l'a pas encore explorée, généralement parce que l'exploration aurait surchargé le serveur ou parce que Google juge qu'elle n'apporte pas assez de valeur pour le moment. Pour quelques nouvelles pages, c'est normal et cela se règle tout seul. Quand il concerne une part importante du site, corrigez trois points dans cet ordre : la vitesse et les erreurs du serveur, le nombre d'URL à faible valeur, puis les liens internes vers les pages que vous voulez indexer.
Qui doit corriger la partie technique de votre site ?
Question 1 sur 425%
Notre conseil pour vous
Un serveur lent ou instable est la bonne solution pour vous
N°1 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
Trop d'URL à faible valeur en concurrence pour l'exploration est la bonne solution pour vous
N°2 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
Un maillage interne faible est la bonne solution pour vous
N°3 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
Des signaux de qualité à l'échelle du site est la bonne solution pour vous
N°4 de ce classement, le plus proche de vos réponses.
Détectée, actuellement non indexée fait partie des raisons les plus courantes listées sous « Pourquoi les pages ne sont pas indexées » dans Google Search Console, et l'une des plus mal comprises. La documentation du rapport Indexation des pages de Google la définit ainsi : « La page a été trouvée par Google, mais pas encore explorée. En général, Google voulait explorer l'URL, mais cela aurait probablement surchargé le site ; Google a donc reporté l'exploration. » Ce guide explique ce que cache cette phrase, comment distinguer un retard normal d'un vrai problème, et quels correctifs font sortir les URL de la file d'attente. Pour le processus complet d'indexation, consultez notre guide sur l'indexation des pages par Google.
Que signifie « Détectée, actuellement non indexée » ?
Google indexe une page en trois étapes : la découverte (il apprend que l'URL existe), l'exploration (Googlebot télécharge la page) et l'indexation (Google analyse le contenu et décide de le conserver ou non). Une URL dans ce statut n'a franchi que la première étape. Google connaît l'adresse, elle est dans sa file, mais il ne l'a jamais téléchargée et n'a donc pas encore évalué son contenu. C'est pourquoi le champ « Dernière exploration » est vide quand vous inspectez une telle URL.
Ce statut est souvent confondu avec son voisin, « Explorée, actuellement non indexée ». La différence indique où chercher la cause.
Statut
Google a-t-il exploré la page ?
Où se trouve généralement la cause
Premier contrôle
Détectée, actuellement non indexée
Non
Capacité d'exploration, priorité d'exploration, liens internes
Temps de réponse du serveur, nombre d'URL, liens vers la page
Explorée, actuellement non indexée
Oui
Qualité du contenu, duplication, rendu
Le contenu de la page elle-même
Exclue par une balise noindex
Oui
Une directive sur la page
Balise meta robots ou en-tête X-Robots-Tag
Bloquée par le fichier robots.txt
Non (interdit)
Une règle du fichier robots.txt
Les lignes Disallow qui correspondent à l'URL
En résumé, « Détectée » est un problème d'exploration, tandis que « Explorée » est une décision d'indexation. Réécrire le contenu d'une page que Google n'a jamais téléchargée ne changera rien tant que Googlebot ne reviendra pas la chercher.
« Détectée, actuellement non indexée » est-il un problème ?
Cela dépend du volume et des pages concernées. Trois situations sont normales et ne demandent aucune action :
Les nouvelles pages publiées ces derniers jours ou semaines. La découverte et l'exploration sont deux étapes distinctes, et Google les planifie.
Les URL que vous ne voulez pas indexer de toute façon : combinaisons de filtres, résultats de recherche interne, archives de tags, paramètres de suivi. Leur présence dans la liste est un signal pour les bloquer ou ne plus les lier, rien de plus.
Une petite part d'un grand site. Aucun site n'a toutes ses URL indexées.
Cela devient un problème lorsque vos pages importantes (produits, catégories, articles, pages de services) restent dans la liste pendant des semaines, ou lorsque leur nombre augmente plus vite que celui des pages indexées. La documentation de Google sur le budget d'exploration cite ce signal précis : les sites dont « une grande partie de l'ensemble des URL » est classée Détectée, actuellement non indexée doivent examiner la façon dont Google répartit son exploration.
Remarque
Attendre n'est pas une stratégie face à un grand retard. Interrogé sur la durée possible de ce statut, John Mueller, de Google, a répondu « Ça peut durer éternellement » (session Search Central, février 2022, rapportée par Search Engine Journal) et conseillé d'améliorer le site pour que Google y voie un intérêt à en explorer davantage.
Quelles sont les causes de « Détectée, actuellement non indexée » ?
Google décide de la quantité d'exploration selon deux paramètres décrits dans sa documentation sur le budget d'exploration : la limite de capacité d'exploration (ce que votre serveur peut absorber sans ralentir) et la demande d'exploration (l'intérêt de Google pour vos URL, selon leur taille, leur fréquence de mise à jour, la qualité des pages et leur pertinence par rapport aux autres sites). Chaque cause ci-dessous réduit l'un de ces deux paramètres. Le concept de budget d'exploration compte surtout pour les grands sites, mais un serveur lent ou une structure faible peuvent déclencher ce statut sur un site de quelques centaines de pages.
1. Un serveur lent ou instable
C'est la cause que Google cite en premier. Selon le guide sur le budget d'exploration, la capacité d'exploration augmente lorsque les temps de réponse « restent stables ou s'améliorent », et baisse lorsque le site ralentit ou renvoie des erreurs serveur. Un hébergement mutualisé, une base de données surchargée, un thème trop lourd ou un pare-feu qui limite Googlebot réduisent le nombre d'URL que Google accepte de télécharger chaque jour.
2. Trop d'URL à faible valeur en concurrence pour l'exploration
La navigation à facettes, les paramètres de tri, les identifiants de session, les calendriers sans fin, les pages de tags générées automatiquement et les variantes de produits presque identiques créent des milliers d'URL. Le guide de Google avertit que les URL en double ou sans intérêt consomment du temps d'exploration, et que les pages soft 404 « continueront d'être explorées et gaspilleront votre budget ». Vos bonnes pages attendent alors dans la même file.
3. Un maillage interne faible
Une URL présente uniquement dans le plan de site XML, ou liée depuis une page située à cinq clics de l'accueil, envoie un signal de priorité faible. La documentation de Google sur les liens explorables ajoute un piège technique : Google ne peut suivre un lien que s'il s'agit d'un élément HTML <a> avec un attribut href. Les menus ou boutons « Voir plus » construits uniquement avec des événements JavaScript peuvent donc cacher des pages à l'exploration.
4. Des signaux de qualité à l'échelle du site
La demande d'exploration dépend en partie de la note que Google attribue au reste du site. Si une grande part des pages déjà explorées sont du contenu mince ou du contenu dupliqué, Google n'a guère de raison de se presser pour les suivantes. C'est pourquoi ce statut apparaît souvent après la publication de centaines de pages similaires d'un coup.
5. Un site récent ou peu connu
Un domaine jeune, avec peu de backlinks et beaucoup de contenus frais, démarre avec une faible demande d'exploration. Lors de la même session de 2022, M. Mueller a indiqué qu'un site récent avec beaucoup de contenu doit s'attendre à ce qu'une grande partie reste dans ce statut un certain temps.
Comment diagnostiquer ce statut dans Search Console ?
Partez d'exemples avant de modifier quoi que ce soit. Cette démarche prend environ une heure sur la plupart des sites.
Ouvrez la liste. Dans Indexation > Pages, cliquez sur « Détectée, actuellement non indexée » et exportez les URL d'exemple (Search Console en affiche jusqu'à 1 000).
Triez-les par type. Regroupez les URL par dossier ou par modèle : produits, articles, URL avec paramètres, pagination, tags. Si la plupart sont des URL que vous ne voulez pas indexer, le correctif consiste à en réduire le nombre, pas à les pousser.
Inspectez quelques pages importantes. L'outil d'inspection d'URL confirme que la page n'a jamais été explorée et indique si Google l'a trouvée dans un plan de site ou via une page qui la référence.
Contrôlez le serveur. Ouvrez Paramètres > Statistiques d'exploration. Le rapport Statistiques d'exploration affiche l'état de l'hôte sur 90 jours (récupération du fichier robots.txt, résolution DNS, connectivité du serveur), la part d'erreurs 5XX et de délais dépassés, ainsi que le temps de réponse moyen. Un temps de réponse qui augmente alors que le nombre de requêtes baisse indique un problème de capacité.
Vérifiez le maillage interne. Comptez le nombre de liens internes qui pointent vers les pages concernées, et d'où ils viennent. Un analyseur de liens internes repère les pages orphelines et celles enfouies au fond de la structure.
Lisez vos journaux serveur si vous les avez. Les journaux montrent les URL que Googlebot demande réellement chaque jour et les endroits où il perd du temps, souvent sur des URL avec paramètres que vous ignoriez.
Astuce
Comparez l'export à votre plan de site XML. Si le plan contient des milliers d'URL redirigées, bloquées ou en noindex, nettoyez-le d'abord : un plan de site ne doit lister que les pages canoniques et indexables que vous voulez voir explorées. Un vérificateur de plan de site signale ces erreurs en quelques secondes.
Comment corriger « Détectée, actuellement non indexée » ?
Adaptez le correctif à la cause trouvée pendant le diagnostic. Le tableau résume les cas principaux.
Cause
Correctif
Comment vérifier
Serveur lent, erreurs 5XX, délais dépassés
Hébergement plus performant, mise en cache, pages plus légères, vérifier que le pare-feu ne bride pas Googlebot
Statistiques d'exploration : temps de réponse en baisse, plus de requêtes par jour
Trop d'URL avec paramètres ou filtres
Ne plus les lier, bloquer dans robots.txt les modèles inutiles, regrouper les variantes
Moins d'URL non canoniques dans les requêtes d'exploration
Soft 404 et pages vides
Renvoyer une vraie erreur 404 ou 410, ou rediriger vers la page la plus proche
Le nombre de soft 404 baisse dans le rapport Indexation des pages
Pages orphelines ou enfouies
Liens depuis le menu, les pages de catégorie, les articles liés et l'accueil
Les URL passent à « Explorée », puis « Indexée »
Beaucoup de pages similaires ou minces
Fusionner, enrichir ou supprimer ; publier moins de pages, mais de meilleure qualité
Les pages indexées progressent en part du total
Plan de site rempli d'erreurs
Ne garder que les URL canoniques indexables, avec des dates lastmod exactes
Rapport du plan de site : les pages découvertes rejoignent peu à peu les pages indexées
Renforcer d'abord la capacité du serveur
Si le rapport Statistiques d'exploration montre des erreurs serveur ou des temps de réponse en hausse, rien d'autre ne fonctionnera tant que ce point ne sera pas réglé, car Google réduit lui-même son rythme d'exploration pour protéger le site. Interrogez votre hébergeur sur ses limites, ajoutez la mise en cache des pages et un réseau de diffusion de contenu, et retirez les scripts lourds des modèles.
Réduire les URL dont vous n'avez pas besoin
Chaque URL inutile que Googlebot télécharge est une URL utile qu'il ne télécharge pas. Supprimez les liens internes vers les combinaisons de filtres et les paramètres de suivi, utilisez le vérificateur robots.txt pour tester les règles Disallow avant de bloquer des modèles, et corrigez les pages soft 404. Le guide de Google est clair sur les doublons : les éliminer pour « concentrer l'exploration sur le contenu unique plutôt que sur les URL uniques ».
Renforcer les liens internes vers les pages importantes
Liez les pages concernées depuis des pages que Google explore souvent : l'accueil, les catégories principales, les articles populaires. Utilisez des liens <a href> standards avec des ancres descriptives. Une architecture de site claire garde chaque page importante à trois ou quatre clics de l'accueil, ce qui augmente sa priorité d'exploration.
Nettoyer le plan de site et demander l'indexation avec modération
Soumettez un plan de site XML propre et utilisez le bouton « Demander une indexation » seulement pour quelques URL stratégiques : il est soumis à un quota quotidien et n'augmente pas la capacité d'exploration globale de votre site. Une fois la cause corrigée, cliquez sur « Valider la correction » dans le rapport. Google indique que la validation « prend généralement jusqu'à environ deux semaines, mais peut parfois durer beaucoup plus longtemps », et il ne faut pas relancer la validation tant qu'elle n'a pas abouti ou échoué.
Si des pages restent invisibles après ces étapes, la cause se trouve peut-être ailleurs : notre liste des raisons pour lesquelles un site n'apparaît pas sur Google couvre les pénalités, les balises noindex et les erreurs de canonical.
Pourquoi ce sujet compte-t-il pour la visibilité dans les IA (GEO) ?
Une page que Googlebot n'explore jamais ne peut pas se classer sur Google, et elle ne peut pas servir de source aux aperçus IA de Google ni au mode IA, qui puisent dans l'index de Google. Un retard d'exploration retarde donc à la fois votre visibilité dans les résultats classiques et dans les réponses IA.
ChatGPT, Perplexity et Claude s'appuient sur leurs propres robots et des index partenaires. Une page peut donc être récupérée par eux alors que Google l'ignore, ou l'inverse. Vos journaux serveur montrent quels robots IA visitent quelles pages ; notre entrée de glossaire sur les journaux des robots IA explique comment les lire. Les correctifs de ce guide (serveur rapide, moins d'URL inutiles, liens internes clairs) aident tous les robots, Googlebot comme les robots IA.
Sorank, notre produit, agit sur la partie contenu du problème. Son tableau de bord GEO et SEO se connecte à Search Console pour suivre les clics, les impressions et les positions après chaque correction, et son générateur d'articles publie moins d'articles, mais plus approfondis, avec des liens internes automatiques vers les pages existantes, si bien que les nouvelles URL sont liées dès leur mise en ligne.
En bref : « Détectée, actuellement non indexée » signifie que Google connaît votre URL mais n'a pas encore consacré de temps d'exploration à celle-ci. Ignorez ce statut pour quelques nouvelles pages, et agissez lorsqu'il touche des pages importantes : accélérez le serveur, supprimez les URL inutiles et reliez les pages qui comptent. Pour automatiser la partie contenu et maillage interne, consultez les offres Sorank, à partir de 49€ par mois facturé annuellement, avec un essai gratuit de 3 jours.
Questions fréquentes
Combien de temps dure le statut « Détectée, actuellement non indexée » ?
Pour quelques nouvelles pages sur un site sain, il disparaît en général en quelques jours ou semaines, une fois que Googlebot les a explorées. Google a aussi indiqué que ce statut peut durer indéfiniment, car il n'explore pas toutes les URL qu'il connaît. Si des pages importantes y restent plus d'un mois, cherchez les problèmes de serveur, de maillage interne ou d'URL à faible valeur.
Faut-il utiliser « Demander une indexation » pour les pages détectées ?
Seulement pour quelques URL stratégiques. Le bouton « Demander une indexation » de l'outil d'inspection d'URL est soumis à un quota quotidien et n'augmente pas la capacité d'exploration que Google accorde à votre site. Pour des dizaines ou des milliers d'URL, corrigez la cause (vitesse du serveur, URL inutiles, liens internes), puis cliquez sur « Valider la correction » dans le rapport Indexation des pages.
Un petit site peut-il avoir des pages « Détectée, actuellement non indexée » ?
Oui. Le budget d'exploration est rarement une limite en dessous de quelques milliers de pages. Sur un petit site, le statut pointe donc en général vers un serveur lent ou instable, des pages liées uniquement depuis le plan de site, ou une qualité perçue faible. Un nouveau domaine peu connu peut aussi voir ses premières pages attendre plus longtemps avant d'être explorées par Google.
y!
Audit SEO et GEO gratuit
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
Croissance organiqueGénération de leads pour installateurs
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne