La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Carte intitulée « Blocked by robots.txt » avec un court extrait de code robots.txt numéroté, une étiquette rouge Blocked et une étiquette verte Crawled
Outils
Sur cette page
En bref
« Bloquée par le fichier robots.txt » signifie qu'une règle de votre fichier robots.txt empêche Googlebot d'explorer une URL : Google ne peut pas lire la page, qui reste en général absente des résultats. Si le blocage est voulu (administration, panier, recherche interne), laissez-le. Si une page importante est touchée, trouvez la règle Disallow qui la vise, modifiez-la, testez l'URL puis demandez une nouvelle exploration. Pour sortir une page de Google, utilisez plutôt noindex : robots.txt contrôle l'exploration, pas l'indexation.
Qui doit corriger la partie technique de votre site ?
Question 1 sur 425%
Notre conseil pour vous
Exportez les URL concernées est la bonne solution pour vous
N°1 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
Séparez les blocages voulus des erreurs est la bonne solution pour vous
N°2 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
Trouvez la règle en cause est la bonne solution pour vous
N°3 de ce classement, le plus proche de vos réponses.
Notre conseil pour vous
Modifiez le fichier est la bonne solution pour vous
N°4 de ce classement, le plus proche de vos réponses.
Le statut bloquée par le fichier robots.txt apparaît dans le rapport d'indexation des pages de Google Search Console, parmi les raisons pour lesquelles des pages ne sont pas indexées. La documentation du rapport d'indexation des pages le résume en une ligne : la page a été bloquée par le fichier robots.txt de votre site. Derrière cette ligne se cachent deux situations très différentes, un blocage sain et un blocage accidentel, plus un cousin déroutant, « Indexée malgré le blocage par le fichier robots.txt ». Ce guide vous apprend à les distinguer et à corriger chacune sans rien casser ailleurs. Si le fichier lui-même vous est peu familier, commencez par notre définition du fichier robots.txt.
Que signifie « Bloquée par le fichier robots.txt » dans Search Console ?
Votre fichier robots.txt se trouve à la racine de l'hôte (exemple.com/robots.txt) et indique aux robots les chemins qu'ils peuvent récupérer. Quand Googlebot découvre une URL, par un lien ou un sitemap, il consulte d'abord ce fichier. Si une règle Disallow correspond au chemin pour son agent utilisateur, il ne récupère pas la page. Search Console range alors l'URL sous « Bloquée par le fichier robots.txt ».
Deux conséquences en découlent. Google ne voit ni le contenu, ni le titre, ni les liens internes, ni aucune balise meta de la page. Et comme il ne lit jamais la page, il ne voit pas non plus une éventuelle balise noindex. Le statut figure parmi les raisons de non-indexation : pour la plupart des sites, il est informatif, et Google note lui-même que les URL bloquées par robots.txt le sont probablement à dessein.
Le problème commence quand la liste contient des pages que vous voulez voir sur Google : fiches produits, articles, catégories, voire tout le site après une migration. Le blocage est alors une cause directe d'un site qui n'apparaît pas sur Google, et c'est l'un des problèmes techniques les plus rapides à corriger.
« Bloquée par le fichier robots.txt » ou « Indexée malgré le blocage » ?
Le second statut semble contradictoire, et c'est celui qui inquiète le plus les propriétaires de sites. L'introduction de Google au fichier robots.txt l'explique : robots.txt n'est pas un moyen d'empêcher une page d'apparaître dans Google. Si d'autres pages renvoient vers une URL interdite, Google peut indexer l'URL elle-même sans l'explorer. Le résultat affiche alors l'adresse sans description, puisque Google n'a jamais lu le texte.
Statut
Explorée par Google ?
Dans l'index ?
Catégorie du rapport
Correction habituelle
Bloquée par le fichier robots.txt
Non
Non
Raison de non-indexation
Rien si c'est voulu ; modifier la règle si la page compte
Indexée malgré le blocage par le fichier robots.txt
Non
Oui, l'URL seule, en général sans description
Avertissement (pages indexées)
La débloquer si vous la voulez dans Google ; la débloquer et ajouter noindex sinon
L'essentiel est de décider d'abord ce que vous voulez pour chaque URL : indexée ou non indexée. Robots.txt répond à une autre question (explorée ou non explorée), et mélanger les deux est à l'origine de la plupart des erreurs.
Attention
Ne bloquez jamais une page dans robots.txt en lui ajoutant en même temps noindex. La documentation de Google sur le blocage de l'indexation avec noindex est explicite : pour que la directive fonctionne, la page ne doit pas être bloquée par robots.txt. Sinon Googlebot ne voit jamais la balise.
Pourquoi vos pages sont-elles bloquées par robots.txt ?
La plupart des blocages accidentels viennent de quelques causes. Vérifiez-les dans cet ordre :
Une règle de préproduction passée en production.Disallow: / protège un site de test, puis part avec la mise en ligne et bloque tout.
Un réglage du CMS. WordPress propose l'option « Demander aux moteurs de recherche de ne pas indexer ce site » ; d'autres plateformes ont des interrupteurs équivalents qui modifient robots.txt ou ajoutent des en-têtes.
Une règle plus large que prévu.Disallow: /p bloque /produits/ et /prix/ autant que /p/. Les règles de robots.txt portent sur le début du chemin.
Les caractères génériques.* correspond à n'importe quelle suite de caractères et $ marque la fin d'une URL. Disallow: /*? bloque toutes les URL avec paramètre, y compris des pages paginées ou filtrées que vous voulez indexer.
Des ressources bloquées. Bloquer /assets/ ou /wp-includes/ cache le CSS et le JavaScript dont Google a besoin pour afficher la page, ce qui dégrade sa compréhension de votre contenu.
Une migration. Les chemins changent, l'ancien robots.txt reste, ou le nouvel hébergeur sert son propre fichier par défaut.
Le mauvais hôte. Chaque sous-domaine et chaque protocole a son propre fichier : les règles de www.exemple.com ne s'appliquent pas à boutique.exemple.com.
Retenez que Google suit la règle la plus spécifique (le chemin correspondant le plus long) et que, si une règle Allow et une règle Disallow sont aussi spécifiques l'une que l'autre, la moins restrictive l'emporte. Un Allow: /blog/ ciblé peut donc rouvrir un dossier situé sous un blocage plus large.
Corriger « Bloquée par le fichier robots.txt » étape par étape
1. Exportez les URL concernées
Dans Google Search Console, ouvrez Indexation, puis Pages, et cliquez sur la ligne « Bloquée par le fichier robots.txt ». Exportez la liste et triez-la par dossier. Un motif apparaît en général en une minute : un répertoire, un paramètre, un sous-domaine.
2. Séparez les blocages voulus des erreurs
Classez chaque motif en « à laisser bloqué » ou « doit être sur Google ». Paniers, tunnels de commande, comptes clients, résultats de recherche interne et zones d'administration vont dans le premier groupe. Tout ce qui répond à une recherche, reçoit des liens ou figure dans votre sitemap XML va dans le second. Une URL à la fois présente dans le sitemap et bloquée est une contradiction à résoudre.
3. Trouvez la règle en cause
Ouvrez l'outil Inspection de l'URL sur une URL d'exemple : il indique si l'exploration est autorisée. Lisez ensuite le fichier en ligne, ou collez l'URL dans notre vérificateur de robots.txt gratuit pour voir quelle ligne la bloque et pour quel agent utilisateur.
4. Modifiez le fichier
Supprimez ou resserrez la règle, ou ajoutez un Allow plus spécifique. Faites un changement minimal et testez-le à la fois sur une URL à débloquer et sur une URL qui doit rester bloquée. Si le fichier est désordonné, reconstruisez-en un propre avec notre générateur de robots.txt et comparez avant de publier.
5. Faites relire le nouveau fichier à Google
Google met en général robots.txt en cache jusqu'à 24 heures, selon sa spécification du fichier robots.txt. Pour accélérer, ouvrez Paramètres, puis le rapport robots.txt de Search Console (disponible pour les propriétés de domaine), et demandez une nouvelle exploration du fichier. Demandez ensuite l'indexation de vos URL débloquées les plus importantes dans l'Inspection de l'URL.
6. Validez et surveillez
Cliquez sur « Valider la correction » dans la page du problème. La validation peut prendre de plusieurs jours à quelques semaines, et les nouvelles URL sont vérifiées au fil des explorations. Notre guide de l'indexation Google explique ce qui se passe après l'exploration, quand Google décide si une page mérite d'être conservée.
Astuce
Avant de mettre en ligne un nouveau robots.txt, testez-le sur une courte liste de dix URL clés (accueil, une catégorie, un produit, un article, l'URL du sitemap). Une seule erreur de copier-coller dans une ligne Disallow peut bloquer tout un site, et la facture apparaît dans votre trafic en quelques jours.
Corriger « Indexée malgré le blocage par le fichier robots.txt »
La correction dépend de ce que vous voulez pour la page :
Vous voulez la page sur Google. Retirez le blocage. Google explorera la page, lira son contenu et affichera un résultat normal avec titre et description.
Vous ne voulez pas la page sur Google. Retirez aussi le blocage, puis ajoutez <meta name="robots" content="noindex"> dans le head, ou un en-tête HTTP X-Robots-Tag: noindex pour les PDF et autres fichiers. Une fois la page explorée à nouveau et retirée par Google, vous pouvez la rebloquer si le volume d'exploration compte, ce dont la plupart des sites n'ont jamais besoin. Notre définition de noindex détaille les options.
La page ne devrait pas être publique. Protégez-la par mot de passe ou supprimez-la (404 ou 410). Ni robots.txt ni noindex ne sont des mesures de sécurité.
Pour une navigation à facettes avec des milliers d'URL de filtres, un blocage dans robots.txt peut rester le bon outil pour économiser le budget d'exploration. L'avertissement « Indexée malgré le blocage » sur quelques-unes de ces URL est alors acceptable, tant que les versions canoniques de vos catégories sont explorables et indexées.
Vérifier que la correction a fonctionné
Trois signaux confirment une correction réussie. L'Inspection de l'URL sur l'URL en ligne affiche « Exploration autorisée : Oui ». Le nombre de pages bloquées dans le rapport d'indexation des pages baisse dans les semaines qui suivent. Et les pages débloquées commencent à recevoir des impressions dans le rapport Performances. Un passage rapide dans notre vérificateur d'indexabilité détecte aussi les autres freins qui accompagnent souvent les erreurs de robots.txt : un noindex oublié, une balise canonique erronée ou une redirection.
La surveillance compte, parce que ces erreurs reviennent. Une mise à jour de thème, une extension ou un script de déploiement peut réécrire robots.txt sans que personne ne le remarque. Suivre les pages dont les clics et les impressions chutent brusquement est l'alerte la plus rapide.
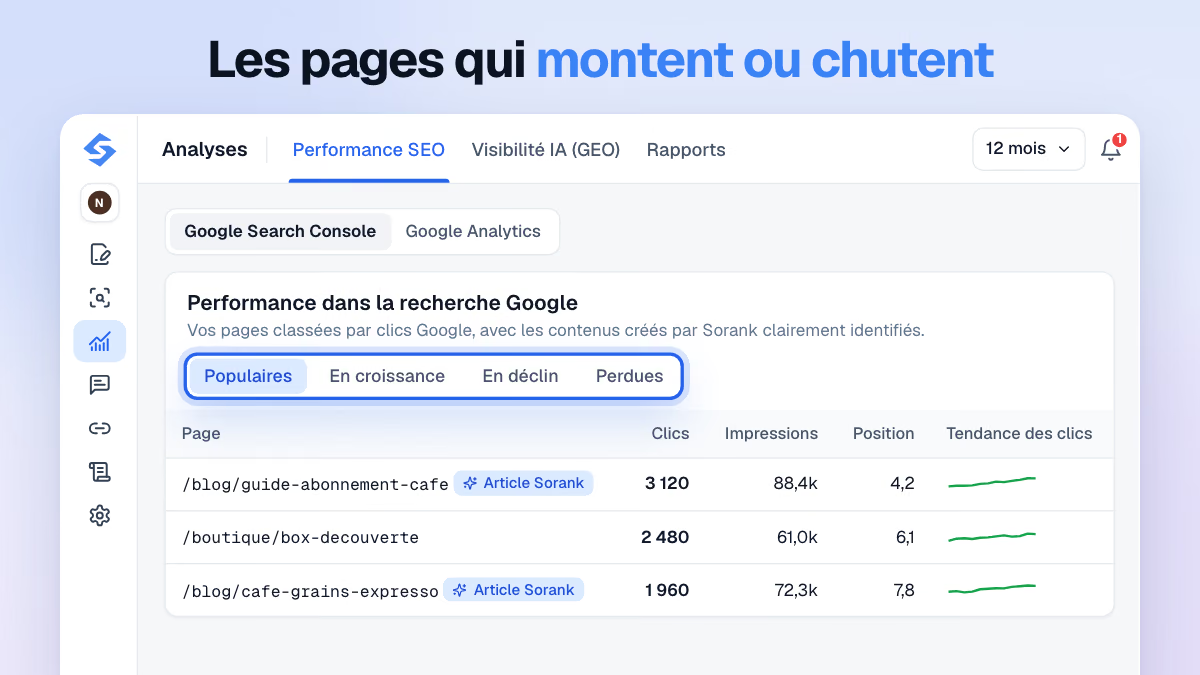
Pages qui gagnent ou perdent du trafic Google dans le tableau de bord GEO et SEO de Sorank : une chute soudaine sur un groupe d'URL est souvent le premier signe d'un blocage de l'exploration.
Le tableau de bord GEO et SEO de Sorank se connecte à Search Console et affiche ces pages en hausse et en baisse dans une seule vue : un blocage introduit par un déploiement apparaît comme un groupe d'URL en recul, et non comme une perte lente et inexpliquée.
Robots.txt, robots des IA et GEO
Robots.txt a désormais un second public : les robots d'exploration des assistants IA. OpenAI, Anthropic, Perplexity et Google publient chacun des agents utilisateurs (GPTBot et OAI-SearchBot, ClaudeBot, PerplexityBot, Google-Extended) qui respectent robots.txt. Une règle pensée pour l'un d'eux, ou un blocage général User-agent: *, décide si ChatGPT, Claude ou Perplexity peuvent lire vos pages quand ils cherchent sur le web pour construire une réponse.
Le raisonnement est le même qu'avec Google : décidez robot par robot ce que vous voulez. Bloquer les robots d'entraînement tout en autorisant les robots de recherche est un compromis fréquent, et notre guide du robots.txt pour les robots des IA liste les agents utilisateurs et les règles de chacun. L'entrée du glossaire sur les robots d'exploration des IA explique quel robot fait quoi.
À savoir
Une page que les assistants IA ne peuvent pas explorer peut encore être mentionnée via des sources tierces, mais elle est rarement citée directement. Notre étude des sources citées par les plateformes d'IA montre à quel point les citations dépendent des pages que les assistants peuvent lire.
Pour mesurer l'effet de ces choix, suivez les questions qui comptent pour votre activité. Le suivi des mentions dans les IA de Sorank montre si ChatGPT, Gemini ou Claude citent votre site, et quels concurrents ils citent à votre place.
La règle à retenir
Robots.txt décide de ce que les robots peuvent lire ; noindex décide de ce que les résultats peuvent afficher. Réservez les blocages aux zones sans valeur de recherche, ne bloquez jamais une page que vous voulez indexer ou désindexer, et consultez le rapport d'indexation des pages après chaque migration ou déploiement. La plupart des problèmes « bloquée par le fichier robots.txt » se règlent en quelques minutes une fois la règle en cause trouvée, et le tableau de bord Search Console de Sorank vous aide à repérer le prochain avant qu'il ne vous coûte du trafic.
Questions fréquentes
Combien de temps faut-il à Google pour explorer une page après l'avoir débloquée dans robots.txt ?
Google rafraîchit en général sa copie en cache de robots.txt en 24 heures, et vous pouvez demander une nouvelle exploration du fichier dans le rapport robots.txt de Search Console. L'exploration des pages débloquées elles-mêmes peut prendre de quelques jours à quelques semaines. Demander l'indexation dans l'Inspection de l'URL aide pour une poignée d'URL importantes.
Faut-il s'inquiéter du statut « Bloquée par le fichier robots.txt » ?
Seulement si la liste contient des pages que vous voulez voir apparaître sur Google. Les blocages sur les paniers, les comptes clients, l'administration ou la recherche interne sont normaux et ne demandent aucune action. Exportez la liste, regroupez-la par dossier et vérifiez si une section utile y figure.
Une page bloquée par robots.txt peut-elle quand même se positionner ?
Son URL peut être indexée si d'autres pages renvoient vers elle, mais Google ne peut pas lire son contenu : le résultat s'affiche en général sans description et se positionne rarement sur une requête utile. Si vous voulez que la page se positionne, débloquez-la pour que Google puisse l'explorer et l'évaluer.
y!
Audit SEO et GEO gratuit
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
Croissance organiqueGénération de leads pour installateurs
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne