העדפות
הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף
הפרטיות חשובה לנו, ולכן יש לך אפשרות להשבית סוגים מסוימים של אחסון שייתכן שאינם נחוצים לתפקוד הבסיסי של האתר. חסימת קטגוריות עלולה להשפיע על חווית השימוש שלך באתר. מידע נוסף

למה תשובות חיפוש AI משתנות בכל הרצה, בכמה הן זזות, ואיך מודדים את נוכחות המותג שלכם על פני שאילתות במקום לרדוף אחרי דירוג אחד.
כלים

בקצרה
תנודתיות בחיפוש AI היא המידה שבה המותגים, הכתובות וסדר ההופעה של תשובת AI משתנים מהרצה להרצה, ומשבוע לשבוע. אותה שאלה יכולה להחזיר רשימת מותגים שונה, ציטוטים אחרים וסדר אחר, כי התשובה נוצרת עם אלמנט של אקראיות וגם שלב האחזור משתנה. לכן מיקום בתוך תשובת AI הוא מדד חלש. מדדו כמה פעמים המותג שלכם מופיע לאורך שאלות רבות והרצות רבות, ואז בנו את המקורות שיגרמו לנוכחות הזאת להיות יציבה.
רוצים להעמיק? שאלו את
שאלון קצר
איך לגרום ל-ChatGPT ולעוזרי AI אחרים להזכיר אתכם?
Sorank מתאים לתשובות שלכם


נסו אותו 3 ימים באתר שלכם וראו איפה אתם עומדים ב-Google, ב-ChatGPT ובשאר מערכות הבינה המלאכותית.
התחילו ניסיון חינם ל-3 ימים3 ימים חינם, ואז מפסיקים מתי שרוצים. אחריות להחזר כספי למשך 90 יום, בכפוף לתנאים.
בחיפוש האורגני של Google, תנודתיות פירושה שהמיקום שלכם למילת מפתח עולה ויורד. בחיפוש AI זה רחב יותר. התשובה עצמה שונה בכל הרצה. תשובת AI תנודתית יכולה להשתנות בשלוש דרכים: אילו מותגים היא מזכירה, אילו כתובות היא מצטטת, ובאיזה סדר היא מציגה אותם. כל אחד מהם יכול לזוז בלי שום שינוי באתר שלכם.
ההבדל חשוב, כי דירוג הוא תוצר קבוע לרגע מסוים. Google מחזירה רשימה מסודרת, ולאותה שאילתה באותו שוק הרשימה הזאת ניתנת לשחזור ברובה. מודל AI מחזיר דגימה אחת מתוך טווח של תשובות אפשריות. למותג שלכם יש הסתברות להופיע בטווח הזה. ההסתברות הזאת היא מה שאפשר למדוד, והיא מה שאפשר להזיז.
שני מספרים ממחקר שפורסם ב-2026 מראים כמה גדול האפקט. Rand Fishkin מ-SparkToro עבד עם Patrick O'Donnell מ-Gumshoe.ai. כ-600 מתנדבים הריצו 12 שאילתות דרך ChatGPT, Claude ו-AI של Google, בסך הכול 2961 הרצות. החוקרים מצאו פחות מסיכוי של אחד ל-100 ש-ChatGPT או ה-AI של Google יחזירו את אותה רשימת מותגים פעמיים. הסיכוי לאותה רשימה באותו סדר היה בערך אחד ל-1000 הרצות. דוח SparkToro, מתאריך 28 בינואר 2026, מכסה נתונים שנאספו בנובמבר ובדצמבר 2025.
עד כמה רשימות המותגים ב-AI יציבות?
מקור: SparkToro ו-Gumshoe.ai, ינואר 2026
ברגע שמקבלים שהתוצאה היא דגימה, צריך לשנות את אופן המעקב. ההשוואה שלהלן מסכמת את שתי הגישות. זו הרעיון המרכזי של המדריך הזה כולו.
מעקב אחר דירוג מול מעקב אחר נוכחות
השינוי הבולט ביותר הוא רשימת המותגים עצמה. שאילתה כמו "כלי ניהול הפרויקטים הטוב ביותר לצוות של 10 אנשים" יכולה לציין חמישה מותגים בהרצה אחת, וחמישה אחרים בהרצה הבאה. יש מותגים שחוזרים לעתים קרובות, ואחרים נכנסים לרשימה ויוצאים ממנה. הנוכחות בתוך הקבוצה יציבה יותר מהמיקום בתוכה, ולכן החוקרים ממליצים לעקוב אחר נוכחות ולא אחר דירוג.
יש לכך השלכה מעשית. אם בדקתם שאילתה פעם אחת וראיתם את המותג שלכם במקום השני, אתם יודעים כמעט כלום. אם בדקתם אותה 60 פעמים וראיתם את המותג שלכם ב-40 מהתשובות, אתם יודעים משהו שימושי: אתם בחירה קבועה לשאלה הזאת.
ציטוטים הם הקישורים שמודל AI מציג כמקורות. הם זזים אפילו יותר מרשימת המותגים כשהמודל מבצע חיפוש חי ברשת, כי כל הרצה יכולה לאחזר קבוצה אחרת של דפים. ציטוט שנעלם אינו תמיד הפסד. ייתכן שהמותג שלכם עדיין מוזכר בטקסט בלי קישור. לכן כדאי לעקוב אחר שני דברים בנפרד: האזכור בשם והכתובת המצוטטת.
המיקום בתוך התשובה הוא האלמנט הכי פחות יציב. מודל AI עשוי לשים את המותג שלכם במקום הראשון בהרצה אחת ובמקום הרביעי בהרצה הבאה, בלי שום שינוי אמיתי בתפיסה שלו כלפיכם. התייחסו לסדר כרעש, אלא אם הוא זז לכיוון אחד לאורך עשרות הרצות.
שלושה מנגנונים מניעים את רוב השינוי. אי אפשר לכבות אותם, אבל הכרת אותם אומרת מה למדוד ומה להתעלם ממנו.
מודל שפה לא בוחר תשובה אחת הטובה ביותר. הוא בוחר כל מילה הבאה מתוך התפלגות הסתברותית. הגדרה שנקראת טמפרטורה (temperature) קובעת כמה רחב הבחירה הזאת. בערך נמוך הפלט קרוב יותר לשחזור, ובערך גבוה הוא משתנה יותר. מפתחים יכולים לקבוע טמפרטורה דרך ה-API, אבל אפליקציות הצרכנים שבהן רוב הקונים שלכם משתמשים לא חושפות אותה. הניחו שהדגימה פעילה תמיד. המתנדבים של SparkToro השאירו את ההגדרות הרגילות שלהם, מותאמות אישית או ברירת מחדל, ולכן התוצאות שלהם מתארות מה שמשתמש רגיל רואה.
כשמודל AI מחפש ברשת, הוא לא שולח את השאלה המדויקת שלכם למנוע חיפוש. הוא מנסח את השאלה מחדש לכמה תת-שאילתות, ומאחזר דפים לכל אחת מהן. שינוי קטן בניסוח, דף שאונדקס באותו בוקר, או תוצאה שונה לתת-שאילתה אחת, כולם יכולים לשנות אילו מקורות מגיעים לתשובה הסופית. הכתובות שממנן מצטטים הן תוצר של שלב אחזור שזז. המדריך שלנו על איך מודלי AI בוחרים את המקורות שלהם מסביר את המנגנונים, ומעקב Sorank אחר מה שה-AI מחפש בפועל נבנה בדיוק בשביל השאלה הזאת.
ספקים מעדכנים מודלים והמערכות סביבם בלי הודעה מוקדמת גדולה. גרסה חדשה של מודל, שינוי במועד שבו המודל מחליט לחפש, או שינוי באינדקס הרשת, כולם יכולים לשנות תשובות לנושא שלם ביום אחד. כשהנתונים שלכם מראים קפיצה חדה, בדקו קודם אם יש עדכון סביר, ואז השוו לקו הבסיס שלכם לפני שאתם מגיבים.
| מנגנון | מה זז | איך זה נראה | מה עושים |
|---|---|---|---|
| דגימה | רשימת המותגים, הניסוח והסדר | תשובות שונות לאותה שאילתה באותו יום | מדדו על פני הרצות רבות ודווחו על אחוז |
| אחזור | הכתובות המצוטטות | מקורות שונים מצוטטים משבוע לשבוע | חזקו את הדפים והמקורות החיצוניים שמאחזרים היטב |
| עדכוני מודל ואינדקס | סגנון התשובה כולה והמותגים המועדפים | קפיצה חדה בתאריך מסוים | שמרו קו בסיס ותייגו כל עדכון שאתם מזהים |
מספרים מדודים עדיין נדירים, ורובם מגיעים מספקי SEO ומפלטפורמות של נראות ב-AI. שני מקורות כדאי לקרוא בעיון. הראשון הוא מחקר של פלטפורמת ה-SEO Authoritas, שהשווה בין AI Overviews לתוצאות אורגניות. השני הוא מדידות של BrightEdge, שהשוו בין AI Overviews ל-AI Mode.
Authoritas מדדה את תנודתיות הדירוג בעזרת ציון. ככל שהציון גבוה יותר, כך התוצאות השתנו יותר לאורך התקופה. עבור AI Overviews הציון היה 0.68 בשמונה שבועות ו-0.73 בשלושה עשר שבועות. עבור תוצאות אורגניות הוא היה 0.49 ו-0.55. Digital Information World, שדיווח על המחקר בפברואר 2025, אמר גם שכ-70% מתוצאות AI Overviews השתנו תוך חודשיים עד שלושה. הכתבה הזאת לא ציינה את מדגם מילות המפתח או את תאריכי המדידה, ולכן בדקו את דוח Authoritas המקורי לפני שאתם מצטטים נתון בהצגה ללקוח.
תוצאות AI Overviews שהשתנו תוך 2 עד 3 חודשים
מקור: מחקר Authoritas, דווח על ידי Digital Information World, פברואר 2025
BrightEdge מדדה את אותה שאלה מזווית אחרת. הניתוח שלה מאוגוסט 2025 מצא תנודתיות גבוהה ב-16.7% באזכורי מותגים עבור AI Overviews לעומת AI Mode. הוא מצא גם ש-AI Overviews שמרו על 24% מהכתובות שלהן ללא שינוי, לעומת 20% ב-AI Mode. הטבלה מציבה את הנתונים זה לצד זה.
| מדד | AI Overviews | השוואה | מקור |
|---|---|---|---|
| ציון תנודתיות, 8 שבועות | 0.68 | 0.49 לתוצאות אורגניות | Authoritas |
| ציון תנודתיות, 13 שבועות | 0.73 | 0.55 לתוצאות אורגניות | Authoritas |
| תנודתיות באזכורי מותגים | גבוהה ב-16.7% | בהשוואה ל-AI Mode | BrightEdge, אוגוסט 2025 |
| כתובות שלא השתנו | 24% | 20% ב-AI Mode | BrightEdge, אוגוסט 2025 |
AI Overviews מופיעות בתוך עמוד התוצאות הרגיל של Google עבור חלק משאילתות. AI Mode הוא ממשק נפרד בסגנון שיחה. הנתונים של BrightEdge מרמזים ש-AI Overviews מתנודדות יותר במותגים שהן מזכירות, בעוד AI Mode שומרת על פחות כתובות יציבות. הלקח המעשי הוא לבדוק כל משטח לחוד. מספר אחד בשם "ה-AI של Google" מסתיר את ההבדל, וההבדל הזה הוא בדיוק מה שצריך לתכנן סביבו. ההשוואה שלנו בין מצב ה-AI של Google ל-AI Overviews מסבירה מה כל אחד מהם אומר ל-SEO.
הנקודה המרכזית היא שאי אפשר להניח שהיציבות האורגנית תעבור לחיפוש AI. תוצאות אורגניות פחות תנודתיות מ-AI Overviews בנתוני Authoritas, אבל הן לא סטטיות. דף ששומר על מקום שלישי לחודש יכול ליפול אחרי עדכון ליבה, ולכן צריך שיטה שמפרידה בין שינוי אמיתי לתנועה רגילה בשני המשטחים.
רוב כלי מעקב הדירוג נבנו עבור Google, שבה למילת מפתח יש רשימה מסודרת אחת שמשתנה לאט. כשמיישמים את אותה לוגיקה על מודל AI, מתקבל מספר שמבוסס על דגימה אחת. אם המותג שלכם מופיע שלישי בהרצה אחת ושמיני בהרצה הבאה, הממוצע של שתי ההרצות לא אומר לכם הרבה. כלי שמדווח "אתם במקום 3 ב-ChatGPT" מציג הטלה אחת כעובדה. המדריך שלנו למעקב דירוג מכסה את השיטה הקלאסית, והמאמר הזה מסביר מה משתנה כשהתשובה נוצרת במקום להיות רשומה ברשימה.
המסקנה של SparkToro היא שמוצרי מעקב דירוג שמבוססים על מיקומים קבועים מודדים רעש. ההמלצה של המחקר היא לעקוב אחר נוכחות ולא אחר דירוג. הוא מכנה אחוז נראות מדד סביר כשהוא נמדד על פני עשרות עד מאות שאילתות, כאשר כל שאילתה מורצת כמה פעמים. בקשו מכל ספק להראות את גודל המדגם ואת השיטה שמאחורי הציון לפני שאתם סומכים עליו.
שאילתה אחת, צילום מסך אחד מול אחוז נמדד
התיעוד של Google עצמה מצביע לאותו כיוון, מסיבה אחרת. Google אומרת שדף חייב להיות מאונדקס וכשיר להופיע בחיפוש עם קטע תצוגה כדי לשמש ב-AI Overviews או במצב ה-AI. היא גם אומרת שאין סימון מיוחד או קובץ ייעודי ל-AI שצריך להוסיף. אין הגדרה של "דירוג AI" לייעל, ולכן העבודה היא להיות נוכחים ומהימנים על פני מקורות רבים, ולמדוד את הנוכחות הזאת בכנות.
השיטה שלהלן דורשת כמה ימים להקמה ודקות ספורות בשבוע לתחזוקה. אפשר להריץ אותה בגיליון אלקטרוני. כלים ייעודיים בעיקר חוסכים את החזרתיות, לא את החשיבה.
שיטת המדידה בחמישה שלבים
אחוז הנראות הוא שיעור התשובות שמזכירות את המותג שלכם. מרווח הטעות אומר לכם כמה מהשינוי הוא אמיתי. השתמשו במרווח טעות ברמת ביטחון של 95%, המבוסס על השגיאה התקנית של שיעור:
visibility rate = answers that name your brand / total answers
standard error = sqrt(p x (1 - p) / n)     where p is the visibility rate and n the number of runs
95% margin of error = 1.96 x standard error
זו דוגמה המחשתית, עם מספרים בדויים ולא מדידה אמיתית. המותג שלכם מופיע ב-37 מתוך 80 הרצות, ולכן אחוז הנראות הוא 46%. השגיאה התקנית היא 5.6 נקודות, מה שנותן מרווח טעות של 95% בערך 11 נקודות. דווחו על התוצאה כ-46% פלוס או מינוס 11 נקודות. אם הקבוצה הבאה מראה 40%, זה נמצא בתוך הטווח, וזה לא סימן שצריך לכתוב מחדש את הדפים שלכם.
מותג יכול להיות מוזכר בלי קישור, להיות מקושר בלי שיומלץ, או להיות מומלץ במשפט שלא מזכיר מתחרה. תעדו את המצבים האלה בנפרד: מוזכר ומומלץ, מוזכר בלבד, וצוטט בלבד. השיעורים שלהם זזים מסיבות שונות, וכל אחד דורש תיקון אחר. ציטוט בלי אזכור הוא בעיית מקורות. אזכור בלי המלצה הוא בעיית מיצוב.
גיליון המדידה הראשון שלכם
הערה
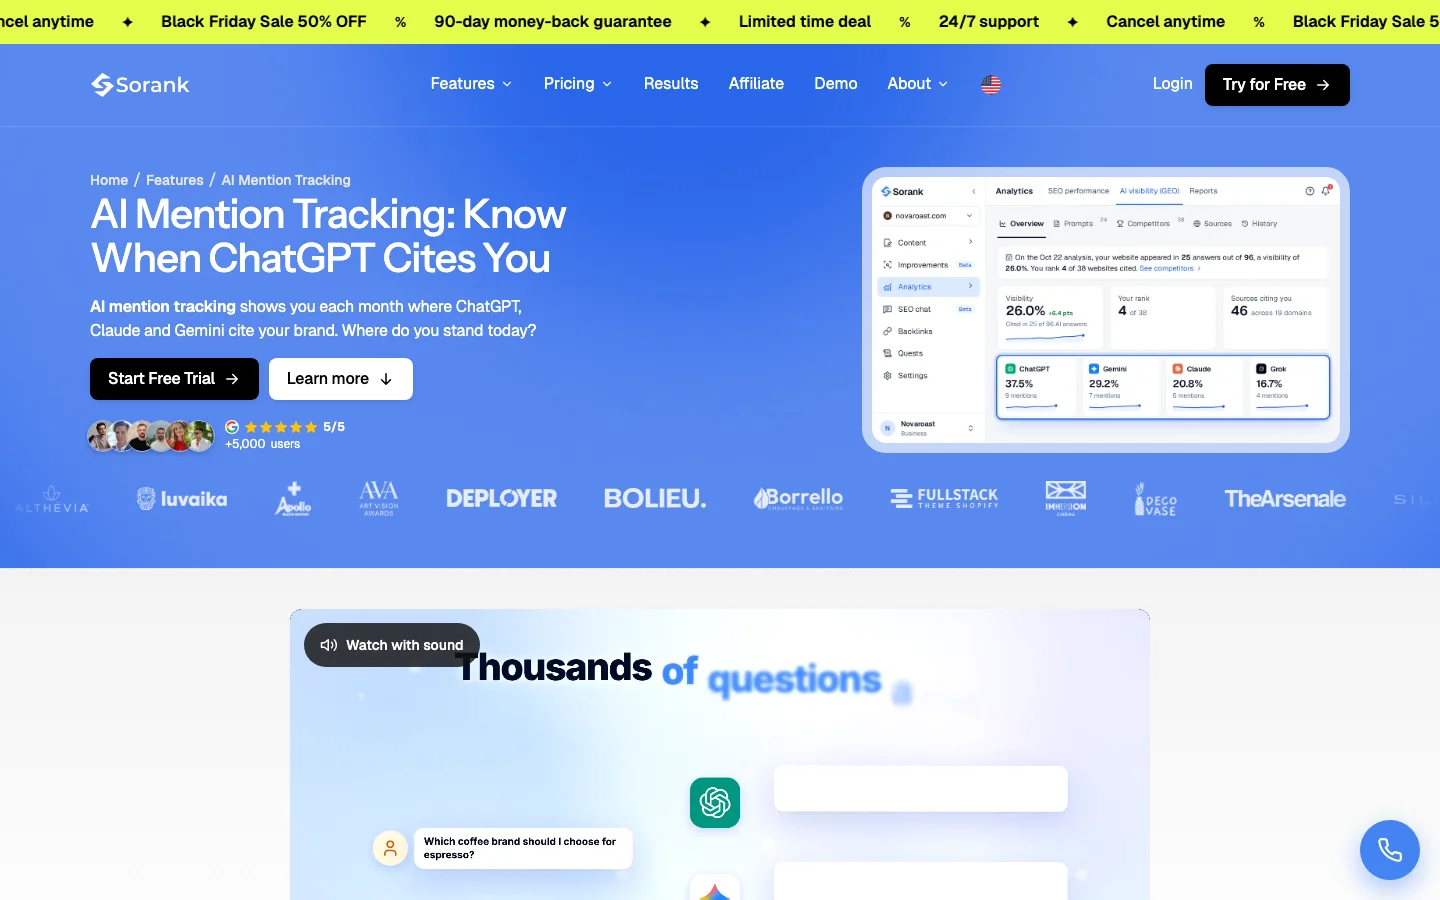
חזרה על כל שאילתה ביד נהיית מייגעת אחרי כמה שבועות. מעקב האזכורים ב-AI של Sorank מדווח, לכל שאילתה שאתם עוקבים אחריה, כמה פעמים ChatGPT, Claude ו-Gemini מזכירים את המותג שלכם, עם המקורות והחיפושים שמאחורי כל תשובה. הריצה שלו היא חודשית, וזה מדגם דליל לשאילתה בודדת, לכן קראו את המגמה שלו לאורך כמה חודשים, והוסיפו הרצות חוזרות משלכם לשאילתות החשובות ביותר.
דוח חודשי צריך לענות על שאלה אחת: האם הנוכחות שלכם זזה, והאם התנועה גדולה מהרעש? הציגו את אחוז הנראות לכל קבוצת שאילתות עם מרווח הטעות שלה, ולא מספר בודד. הוסיפו את התפלגות המיקומים, כלומר כמה פעמים המותג שלכם מופיע במקום הראשון, השני או נמוך יותר, בתשובות שבהן הוא מוזכר, כך שהסדר יופיע כפיזור ולא כדירוג. תנודה סביב מגמה שטוחה או עולה היא נורמלית. ירידה מתמשכת לאורך כמה אצוות אינה נורמלית, והיא ראויה לבדיקה של השאילתות, הערות השחרור של המודל והמקורות המצוטטים לפני שמישהו כותב מחדש דף. כתבו את כלל הפעולה בתוך הדוח עצמו: שינוי נחשב אמיתי רק אם הוא עובר את מרווח הטעות בשתי אצוות ברציפות.
אי אפשר לכבות את התנודתיות, אבל אפשר להפוך את הנוכחות לעקבית יותר. נוכחות גדלה כשהמותג מתואר באותו אופן במספר מקורות שמודלי AI כבר משתמשים בהם. ההנחיות של Google נותנות את הבסיס למה שהתכונות שלה צריכות.
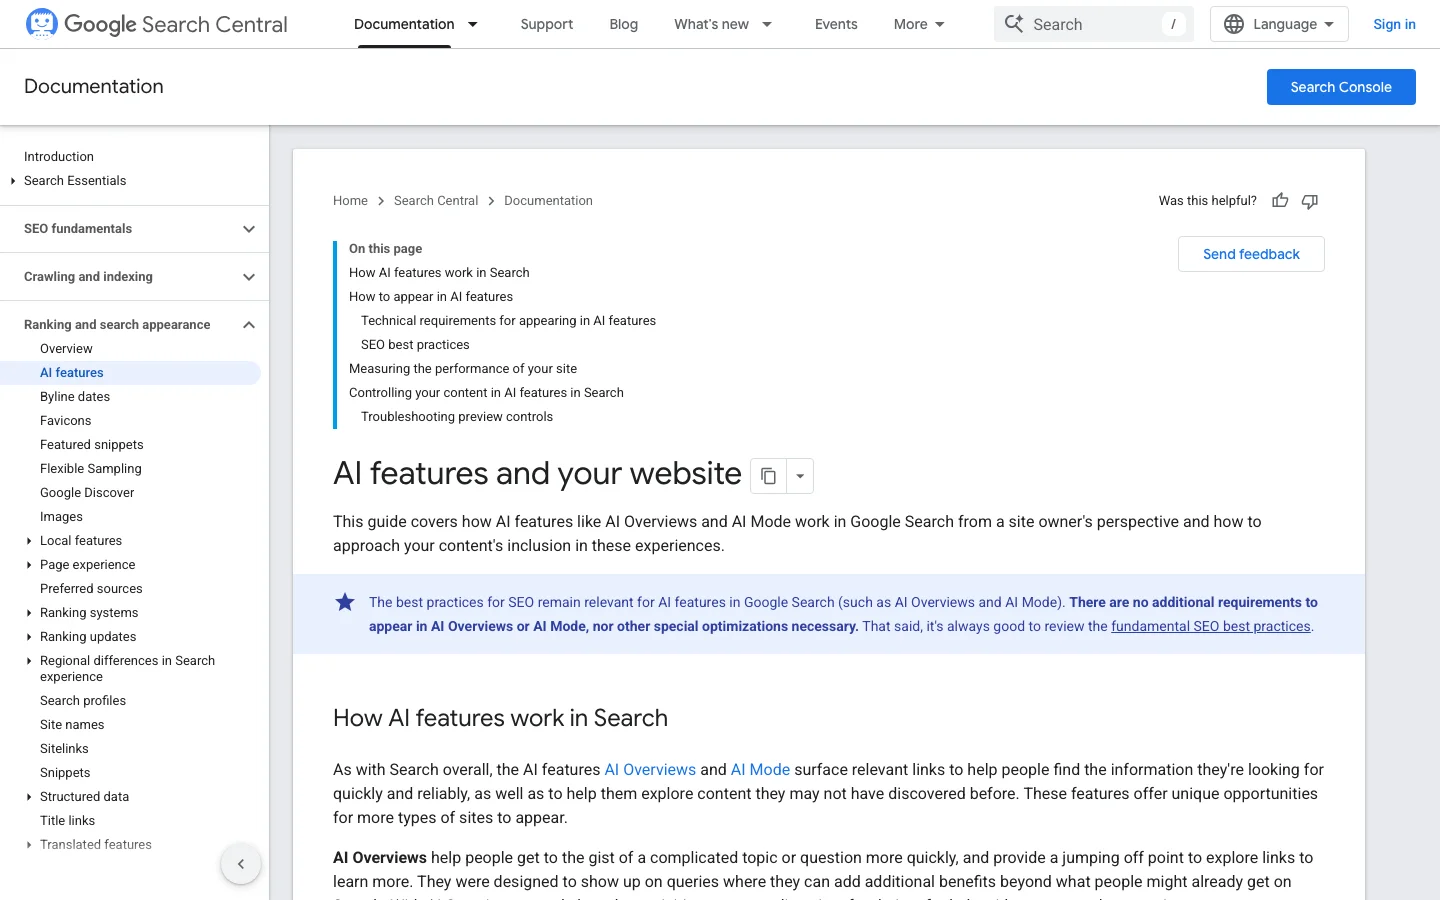
ההנחיות של Google על AI Overviews ועל מצב ה-AI קצרות. דף חייב להיות מאונדקס וכשיר להציג קטע תצוגה. היסודות הרגילים עדיין חלים: כללי robots.txt שמאפשרים זחילה, קישורים פנימיים, תוכן טקסטואלי שגלוי לקורא, ונתונים מובנים שתואמים את הטקסט הנראה. Google אומרת שאין צורך בקבצים חדשים קריאים למכונה, בקבצי טקסט מיוחדים ל-AI או בסכמה מיוחדת כדי להופיע.
מודלי AI בונים תמונה של מותג ממקומות רבים בבת אחת. אם השם, הקטגוריה, שימוש העיקרי והמיקום שלכם שונים בין האתר, הפרופילים ורשימות הספריות, התמונה מתטשטשת ורשימת המותגים הופכת לפחות יציבה. כתבו תיאור אחד קצר ועובדתי של החברה, עם הקטגוריה ושימושי המפתח, והשתמשו בו שוב בכל מקום שבו אתם שולטים בטקסט. בדקו אותו כל רבעון.
אישוש הדדי פירושו שכמה מקורות עצמאיים אומרים דברים דומים עליכם. ביקורות, מאמרי השוואה, ספריות תעשייה ופרסומים מקצועיים בתחום שלכם הם המקומות הרגילים. הרוויחו את האזכורים האלה דרך עבודה שימושית, כמו נתונים מקוריים, השוואת מוצרים ברורה או כלי שאנשים באמת משתמשים בו. אל תקנו אותם. מיקומים בתשלום מוסיפים רעש, והם סוג של דפוס שמתפרק ברגע שהתשלומים נפסקים.
מודלי AI מחלצים קטעים, לא דפים שלמים. דף שנותן הגדרה קצרה בפסקה הראשונה, תשובה ישירה לשאלה המרכזית וצעד הבא ברור, קל יותר לחילוץ ולציטוט מדויק. רשימת הבדיקה ל-GEO שלנו מפרטת את הנקודות לבדוק בכל דף.
רשימת יציבות למותג שלכם
צוותים מגיבים לתנודתיות בארבע דרכים נפוצות. לכל אחת יש שימוש וגבול. קראו אותן כאפשרויות שניתן לשלב, לא כדירוג של האפשרות הטובה ביותר. רוב הצוותים משתמשים בראשונה ובאחרונה יחד.
עיקרון: שאלו שאילתה אחת כל יום ורשמו את המיקום של המותג שלכם בתשובה. מתי להשתמש: אתם רוצים אזהרה מוקדמת כששאילתה מסוימת משתנה בחדות. יתרונות: מוכר, זול וקל לשרטט. מגבלות: זו דגימה אחת ביום, והיא לא יכולה להבחין בין הפסד אמיתי להגרלה רגילה. דוגמה: שאילתה מזכירה את המותג שלכם ביום שני ולא ביום רביעי. הגרף מראה ירידה, אבל הרצה בודדת לא יכולה לומר אם זו הפסד מיקום או וריאציה רגילה.
עיקרון: הריצו שאילתות רבות פעמים רבות, ודווחו על אחוז התשובות שמזכירות את המותג שלכם עם מרווח הטעות שלו. מתי להשתמש: אתם צריכים מספר לדיווח או להחלטה על השקעה בתוכן. יתרונות: זה תואם את האופן שבו התוצר נוצר, ונותן טווח במקום נקודה מזויפת. מגבלות: זה דורש הרצות רבות יותר, ודורש משמעת בשמירה על קבוצת שאילתות יציבה. דוגמה: אחוז הנראות שלכם הוא 46% פלוס או מינוס 11 נקודות על פני 80 הרצות. החודש הבא הוא 52%. אתם יכולים לומר שהמגמה עולה, אבל עדיין אי אפשר לומר שזה רווח אמיתי, ולכן מחכים לאצווה נוספת.
עיקרון: גרמו לאותן טענות מדויקות להופיע בכמה מקורות עצמאיים. מתי להשתמש: המיצוב שלכם ברור, ואתם רוצים המלצות שמחזיקות מעמד. יתרונות: זה עוזר בתשובות AI ובחיפוש הרגיל, והאפקט נשאר לאורך זמן. מגבלות: זה איטי, ונדיר שיש תוצאה תוך חודש. דוגמה: חברת תוכנה מקבלת את תיאור מקרי השימוש שלה בשתי ביקורות, בדף השוואה ובספריית תעשייה, כך שמודלי AI חוזרים על אותו תיאור בשאילתות שונות.
עיקרון: עדכנו את הדפים שעונים על השאלות המרכזיות שלכם, כך שהתשובה תהיה ברורה, מדויקת ומתוארכת. מתי להשתמש: הדף שלכם מצוטט אבל מתואר בצורה שגויה, או שדף של מתחרה מצוטט במקום שבו צריך להופיע הדף שלכם. יתרונות: זה מהיר לביצוע, ומשפר את האופן שבו קטעים מחולצים. מגבלות: דף טוב יותר לא מבטיח אזכור, ושינויים לוקחים זמן להופיע בנתונים שלכם. דוגמה: דף מילון מקבל הגדרה של משפט אחד בראש, טבלת השוואה קצרה והערת עדכון גלויה, ובאצוות המדידה הבאה מופיע התיאור הנכון.
| שיטה | מה היא מראה לכם | יציבות האות | מאמץ | הכי מתאימה ל |
|---|---|---|---|---|
| דירוג יומי | מיקום אחד ביום אחד | נמוכה | נמוך | זיהוי תזוזה חדה בשאילתה אחת |
| נוכחות על פני הרצות | אחוז התשובות שמזכירות את המותג שלכם | גבוהה, עם מרווח טעות | בינוני עד גבוה | דיווח והחלטות תקציב |
| אישוש הדדי | עד כמה מקורות מתארים אתכם בעקביות | גבוהה לאורך חודשים | גבוה | המלצות לטווח ארוך |
| רענון דף | עד כמה הדפים המרכזיים שלכם עונים על השאלה | בינונית | בינוני | תיקון תיאור שגוי או חסר |
תוצאות אורגניות של Google ותשובות AI דורשות מכשירים שונים. ערבוב ביניהם מוביל למסקנות שגויות, ולכן שמרו עליהם נפרדים בדיווח שלכם.
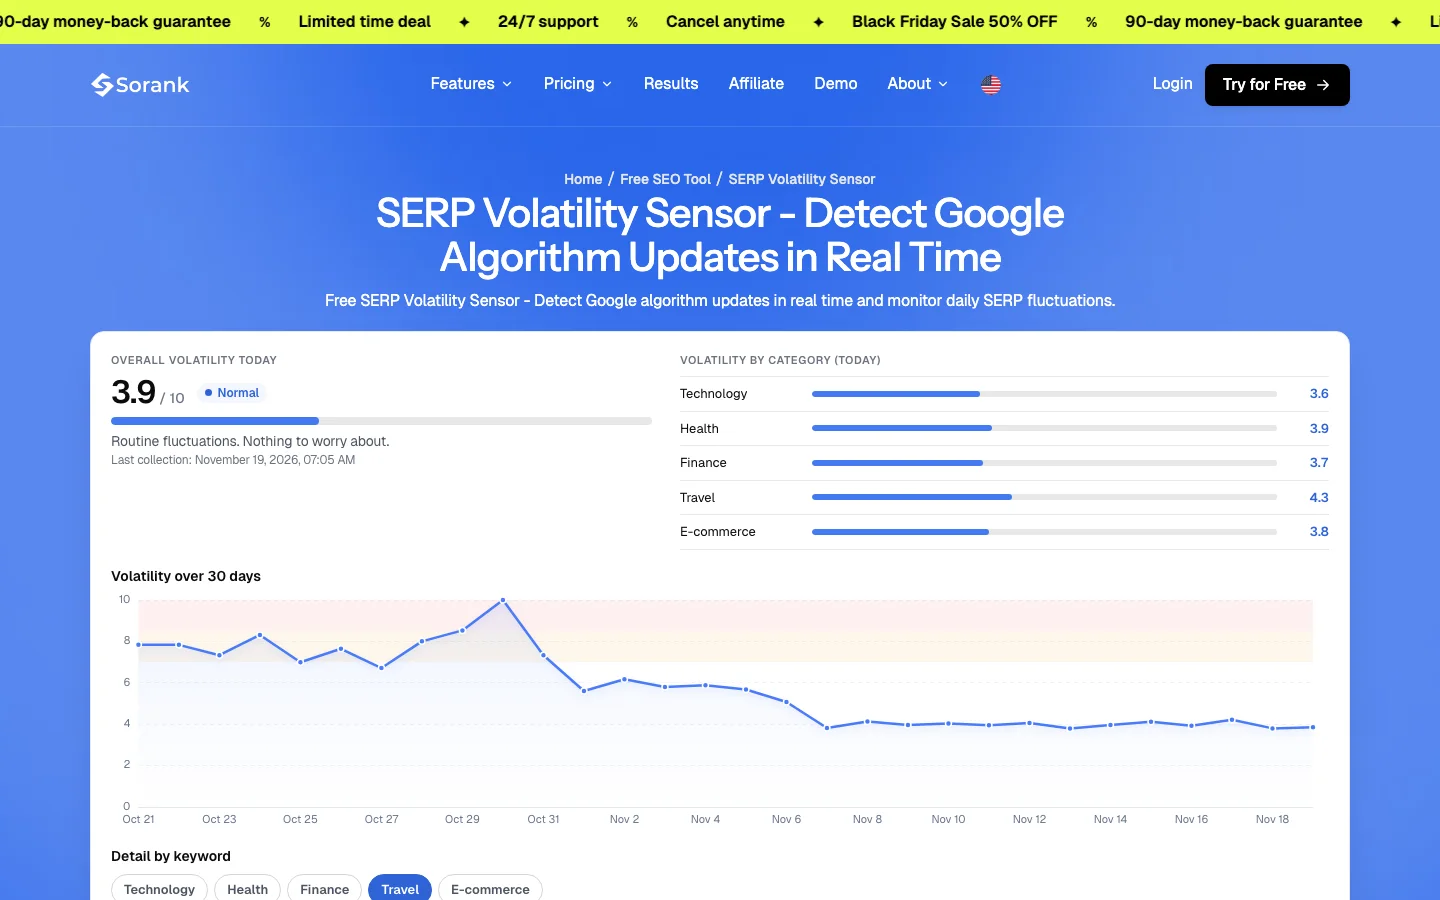
ה-SERP Volatility Sensor החינמי של Sorank מכסה את הסוג הראשון. כל בוקר הוא אוסף את 10 התוצאות האורגניות המובילות עבור 20 מילות מפתח באנגלית בארה"ב, בחמישה תחומים, משווה אותן ליום הקודם, ונותן ציון מ-0 עד 10, כולל ולכל תחום. הוא מראה כמה העמוד הראשון של Google זז, וזה הופך אותו לאות מוקדם שימושי לשינויי אלגוריתם. אבל הוא לא מודד תשובות AI, ולכן הוא לא מחליף את השיטה מבוססת השאילתות שתוארה למעלה. לחלק של Google בשאלה, קראו את ה-Sensor בעמוד שלו, ושמרו אותו ליד נתוני הדירוג שלכם, לא ליד מספרי הנראות שלכם ב-AI.
Search Console ו-Google Analytics מדווחים על קליקים מ-Google וביקורים מופנים. כלי מעקב דירוג מדווחים על מיקומים ב-Google. אף אחד מהם לא מראה אילו תשובות AI הזכירו את המותג שלכם. לשם כך צריך תשובות שנרשמות, או כלי שרושם אותן. לביקורים שמגיעים ממודלי AI, הצד של ההפניה מכוסה במדריך שלנו על דיווח GEO.
רוב טעויות התנודתיות נובעות מקריאת רעש כאות. כל טעות להלן מראה איך היא נראית, איך לזהות אותה בנתונים שלכם, ואיך לתקן אותה.
מה זה: צילום מסך אחד או תשובה אחת שמוצגים כמיקום שלכם. איך מזהים: הדוח מציג מיקום בלי גודל מדגם, בלי טווח תאריכים ובלי מרווח טעות. איך מתקנים: דווחו על אחוז הנראות על פני 30 הרצות לפחות לכל שאילתה, עם מרווח הטעות וטווח התאריכים.
מה זה: ניסוח מחדש של שאילתה בין שתי בדיקות, למשל "best CRM" בשבוע אחד ו-"best CRM for startups" בשבוע הבא, ואז קריאת התוצאה כמגמה. איך מזהים: טקסט השאילתה בגיליון שונה בין שני תאריכים לאותה שורה. איך מתקנים: הקפיאו את קבוצת השאילתות וגרסו אותה. הוסיפו שאילתה חדשה כשורה חדשה, ואל תערכו שאילתה ישנה לעולם.
מה זה: כתיבה מחדש של דף אחרי ירידה של חמש נקודות. איך מזהים: השינוי קטן ממרווח הטעות של אותה שאילתה. איך מתקנים: פעלו רק כשהשינוי חורג ממרווח הטעות בשתי אצוות ברציפות, ורשמו מה עוד השתנה באותה תקופה, כמו עדכון מודל או השקת מתחרה.
מה זה: רישום כל קישור לאתר שלכם כניצחון, גם כשהתשובה מציגה את המותג שלכם כאפשרות שיש להימנע ממנה או כהערת שוליים. איך מזהים: אף אחד לא קורא את המשפט שסביב הציטוט. איך מתקנים: תעדו את שלושת המצבים בנפרד (מוזכר ומומלץ, מוזכר בלבד, צוטט בלבד), וקראו את המשפט לפני שאתם מסמנים את התיבה.
מה זה: שאילתות שצוות השיווק כתב לצורך דוח. איך מזהים: השאילתות משתמשות בשמות מוצרים פנימיים או בז'רגון שלקוחות לעולם לא משתמשים בו. איך מתקנים: קחו שאילתות משיחות מכירה, משיחות תמיכה ומשאילתות Search Console, ובדקו כמה מהן עם לקוחות אמיתיים.
מה זה: הנחה שאחוז נראות גבוה יביא אוטומטית יותר ביקורים. איך מזהים: אחוז הנראות עולה בעוד שסשנים מופנים נשארים שטוחים. איך מתקנים: מדדו ביקורים מופנים בנפרד, בדקו אילו מודלי AI ואילו דפים שולחים אותם, וחברו את שני מערכי הנתונים בדוח חודשי אחד.
מה זה: השקת פרויקט לקובץ טקסט ייעודי ל-AI או לסימון חדש, בציפייה שזה יפעיל ציטוטים. איך מזהים: בפרויקט אין בדיקה של אינדוקס או של כשירות לקטע תצוגה. איך מתקנים: התחילו מההנחיות של Google. ודאו שהדפים המרכזיים מאונדקסים וכשירים להציג קטע תצוגה, ואז תקנו את הטקסט והקישורים הפנימיים לפני כל דבר אחר.
| טעות | הסימן בנתונים שלכם | תיקון |
|---|---|---|
| הרצה בודדת מוצגת כתוצאה | אין גודל מדגם ואין מרווח טעות | דווחו על אחוז על פני 30 הרצות לפחות |
| שאילתות נערכות בין בדיקות | אותה שורה, טקסט אחר, תאריכים אחרים | הקפיאו וגרסו את קבוצת השאילתות |
| תגובה בתוך מרווח הטעות | שינוי קטן מהמרווח | פעלו על שינויים שנשמרים בשתי אצוות |
| ספירת ציטוט כהמלצה | אין קריאה של המשפט שסביב | תעדו את שלושת המצבים בנפרד |
| שאילתות שאף אחד לא מקליד | ז'רגון פנימי ברשימת השאילתות | קחו שאילתות משפת הלקוחות האמיתית |
| נראות שמטופלת כתנועה | נראות עולה, הפניות שטוחות | מדדו הפניות בנפרד |
אתם לא צריכים תוכנית מלאה כדי להתחיל. השבוע הראשון עוסק בהקמת המדידה, כך ששישה החודשים הבאים יהיו קריאים. בצעו את הצעדים האלה לפי הסדר.
השבוע הראשון שלכם
ברגע שיש לכם קו בסיס, התנודתיות מפסיקה להיות מקור לחרדה. היא הופכת לטווח שאפשר למדוד, ולסט של שינויים שאפשר לתכנן סביבם.
מודלי שפה בוחרים כל מילה מתוך התפלגות הסתברותית, ולכן אותה שאילתה יכולה לייצר ניסוח, רשימות מותגים וסדר שונים. גם האחזור משתנה, כי מודל ה-AI מנסח את השאלה מחדש לתת-שאילתות, והדפים שהוא מאחזר יכולים להשתנות בין הרצות.
Authoritas מדדה ל-AI Overviews ציון תנודתיות של 0.68 בשמונה שבועות ו-0.73 בשלושה עשר שבועות, לעומת 0.49 ו-0.55 לתוצאות אורגניות. SparkToro מצאה פחות מסיכוי של אחד ל-100 ש-ChatGPT או ה-AI של Google יחזירו את אותה רשימת מותגים פעמיים.
מיקום בודד בתשובת AI לא יציב מספיק כדי לפעול לפיו. עקבו אחר התדירות שבה המותג שלכם מופיע על פני שאילתות והרצות רבות, דווחו על האחוז הזה כשיעור מאחוזים עם מרווח הטעות שלו, ושמרו על מעקב דירוג קלאסי לתוצאות האורגניות של Google, שבהן המיקומים זזים לאט יותר.
אנחנו מנתחים את המתחרים שלכם, את האתר שלכם ואת הנראות שלכם ב-AI כדי ליצור עבורכם תוכנית תוכן מותאמת אישית בחינם.
 מחולל תדריך תוכן בבינה מלאכותית
 מחולל סכמת FAQ
 מחולל רעיונות למאמרים בבינה מלאכותית
 בודק נתונים מובנים (Schema Validator)
 בודק טקסט חלופי
 מנתח קישורים פנימיים
 אתגר הבקלינקים
 מחולל תיאורי מטא ב-AI
 מחולל כותרות לבלוג ב-AI
 בודק יכולת אינדוקס ב-Google
 מחולל מבנה מאמר ב-AI
 מחולל קישורי UTM
 כלי לקיבוץ מילות מפתח
 בודק תגית קנונית
 מחולל מפת אתר XML
 בודק קישורים שבורים
 מחולל כותרות SEO ב-AI
 מנתח כותרות
 תצוגה מקדימה של תוצאות Google
 בודק הפניות
 מחולל תגיות hreflang
 מנתח מבנה כותרות
 בודק כותרות HTTP
 מחלץ Favicon
 מחשבון נתח קול ב-SEO
 מחשבון תחזית תנועה והכנסות SEO
 מחשבון תקציב SEO
 סימולטור שיפור דירוג
 מחשבון השקעה בתוכן GEO
 מחשבון CTR
 מחשבון חיסכון: SEO מול חיפוש ממומן
 מחשבון ציון הזדמנות למילת מפתח
 מחשבון תנועת הפניה מ-ChatGPT
 מחשבון נתח קול ב-AI
 כלי דירוג Gemini
 מחולל llms.txt
 בודק Sitemap
 ממיר עמודי אינטרנט ל-Markdown
 מונה מילים
 מחולל Schema
 תצוגה מקדימה של Open Graph
 כלי לדחיסת תמונות
 כלי לניתוח קישורים נכנסים
 מחשבון נקודת איזון ל-SEO
 מחשבון זמן קריאה
 מחשבון ROI ל-GEO
 מחשבון ROI לקישורים נכנסים
 בדיקת נתונים מובנים עבור LLM
 ביקורת GEO
 חיישן תנודתיות בתוצאות החיפוש
 מחולל כתובות URL
 מחולל תגיות מטא
 כלי מחקר מילות מפתח
 מחשבון CTR בתוצאות החיפוש
 מחשבון ROI ל-SEO
 מחשבון יחס LTV ל-CAC
 מעריך תנועה אורגנית ובודק תנועה לאתרים
 מחשבון עלות בניית קישורים
 מחשבון ערך חיי לקוח
 מחשבון עלות למאמר
 מחשבון שיעור המרה
 מחשבון שיעור נטישה
 מחשבון ערך התנועה מ-AI
 בודק AI Overview ובודק מיקומים ב-AI Overviews
 ביקורת AI SEO
 אודיט אופטימיזציה למנועי תשובות
 מחשבון ROI ל-SEO של SaaS
 מחשבון ROAS
 מחשבון ROI ל-SEO מקומי
 מחשבון ערך מילת מפתח
 מחשבון צפיפות מילות מפתח
 מחשבון ROI ל-SEO בסחר אלקטרוני
 מחשבון עלות רכישת לקוח
 מחשבון ROI לשיווק תוכן
 מחשבון ציון נראות ב-AI
 מחשבון עלות ההיעדרות מתשובות ה-AI
 מחשבון שיעור ציטוט בבינה מלאכותית
 בודק ציטוטי LLM
 בדיקת SEO בעמוד: בודק SEO ומנתח SEO
 מחשבון ערך תנועה אורגנית
 מאמת llms.txt
 בודק קריאות ל-LLM
 בדיקת מוכנות ל-SearchGPT
 בדיקת סריקה לסורקי בינה מלאכותית
 למה ChatGPT לא ממליץ על האתר שלי
 בודק דירוג ב-Perplexity
 בדיקת נראות בחיפוש מבוסס AI
 בודק נראות ב-ChatGPT
 מחלץ כתובות URL
 בודק גודל עמוד
 מחולל robots.txt
 מחולל Favicon
 בודק robots.txt
 בודק סמכות דומיין
 “אנחנו סוכנות פרסום (Ads) ורצינו סוף סוף להחזיר את ה-SEO שלנו למסלול. Sorank נתנה לנו תמונה ברורה של האתר שלנו, עזרה לנו לתעדף אופטימיזציות ולבנות נכון את התוכן. הכלי קל לשימוש, מעוצב היטב לעבודת צוות, ומאוד מעשי לריכוז המעקב בלי לקפוץ בין מספר פלטפורמות. בסיס איתן מאוד לפתיחת דף חדש עם ה-SEO שלנו.”
 Gaspard Madouiסוכנות פרסום (Ads)“במשך שנתיים, 100% מהלקוחות שלי הגיעו מ-LinkedIn. פרסום יומי, תגובות, מעקבים בהודעות פרטיות... תלות מוחלטת באלגוריתם. ידעתי שאני צריך לעבוד על SEO אבל תמיד דחיתי את זה: ארוך מדי, טכני מדי, לא התחום שלי. עם Sorank, סוף סוף עשיתי את הצעד. בתוך 4 חודשים, אני מייצר 15 לידים אורגניים בחודש בלי לפרסם כלום. זה עדיין לא 50/50 מול LinkedIn, אבל אני ישן טוב יותר בידיעה שיש לי עכשיו מקור לידים שני שגדל באופן אוטומטי.”

 Valentin Thomyoffbound.fr
 “פשוט נתתי לתוכנה של Sorank לעשות את שלה, ועכשיו ציון DR של האתר שלי הוא 25 והדף שלי מדורג גבוה יותר.”
 Lucas Flandrefoundertrace.fr“פתרון מצוין לניהול SEO בלי כאב ראש. הביקורות מהירות, הממשק ברור, ואתה רואה במהירות אילו פעולות ליישם. זה הפך לכלי חיוני למעקב ולשיפור ה-SEO של האתרים שלי. ממליץ בחום.”
 Xavיזם