設定
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら
当社はプライバシーを重視しており、ウェブサイトの基本機能に必要のない特定のストレージを無効にするオプションを提供しています。カテゴリーをブロックすると、ウェブサイトでの体験に影響が出る可能性があります。詳細はこちら

AI検索の回答が実行のたびに変わる理由、その変化の大きさ、そして一つの順位を追うのではなく、複数の質問にわたるブランドの露出を測定する方法を解説します。
ツール

要点
AI検索の変動(ボラティリティ)とは、AIの回答に出てくるブランド、URL、並び順が、実行のたびに、また週ごとにどれだけ変わるかを指します。同じ質問でも、ブランドの一覧、引用元、順番が異なることがあります。回答はランダム性を含んで生成され、検索(リトリーバル)の段階も変化するためです。そのため、AIの回答の中での順位は良い指標とは言えません。多くの質問と多くの実行にわたって自社ブランドが何回現れるかを測り、その露出を安定させる情報源を整えてください。
さらに詳しく知るには、こちらに質問
クイック診断
ChatGPTなどのAIアシスタントに紹介されるには、どうすればよいですか?
Sorankはあなたの回答にぴったりです


ご自身のサイトで3日間お試しいただき、Google、ChatGPT、その他のAIでの現状をご確認ください。
3日間の無料トライアルを開始3日間無料、いつでも解約できます。90日間成果保証(条件あり)。
Googleの自然検索では、変動とはキーワードでの順位が上下することを意味します。AI検索ではそれ以上の意味があります。回答そのものが実行ごとに異なるのです。変動するAIの回答は三つの点で変わりえます。どのブランドに言及するか、どのURLを引用するか、そしてどの順序で並べるかです。いずれも、あなたのウェブサイトに何も変更がなくても変わることがあります。
この違いは重要です。順位は、ある時点での固定された結果だからです。Googleは順序付きのリストを返し、同じ市場で同じ検索語を使えば、そのリストはおおむね再現できます。一方、AIモデルは考えうる回答の範囲から一つの標本を返します。自社ブランドは、その範囲の中に現れる確率を持っています。その確率こそが測定でき、動かせるものです。
2026年に発表された研究の二つの数字が、その影響の大きさを示しています。SparkToroのRand Fishkinは、Gumshoe.aiのPatrick O'Donnellと共同で研究しました。約600人のボランティアが12の質問をChatGPT、Claude、GoogleのAIに投げ、合計2961回の実行を行いました。研究者たちは、ChatGPTまたはGoogleのAIが同じブランド一覧を二度返す確率が100回に1回未満であることを明らかにしました。同じブランド一覧が同じ順序で返される確率は、約1000回に1回でした。SparkToroのレポートは2026年1月28日付で、2025年11月と12月に収集されたデータを対象としています。
AIのブランド一覧はどれほど安定しているか
出典:SparkToroとGumshoe.ai、2026年1月
出力が標本にすぎないと認めれば、追跡の仕方も変えなければなりません。以下の比較は二つの考え方を要約したものです。このガイド全体の中心となる考え方です。
順位を追うか、露出を追うか
最もはっきりした変化は、ブランド一覧そのものです。「10人チームに最適なプロジェクト管理ツール」のような質問は、ある実行では五つのブランドを挙げ、次の実行では別の五つを挙げることがあります。よく戻ってくるブランドもあれば、出たり入ったりするブランドもあります。一覧の中での順位より、一覧に入っているかどうかの方が安定しています。だから研究者たちは、順位ではなく露出を追うよう勧めているのです。
これは実務上の意味を持ちます。質問を一度だけ確認して、自社ブランドが二番目に出ていたとしても、ほとんど何もわかりません。60回確認して、40件の回答で自社ブランドが出ていたなら、有用なことがわかります。その質問に対して、あなたは安定して選ばれる存在だということです。
引用とは、AIモデルが情報源として示すリンクのことです。モデルがリアルタイムのウェブ検索を実行すると、実行ごとに異なるページの組み合わせが取得されるため、引用はブランド一覧よりさらに大きく動きます。引用が消えても、それが必ずしも損失とは限りません。ブランドは本文でリンクなしに言及されているかもしれません。だからこそ、言及された名称と引用されたURLという二つを別々に追跡する必要があります。
回答の中での位置は、最も安定しない要素です。AIモデルは、ある実行ではあなたのブランドを最初に挙げ、次の実行では四番目に挙げるかもしれません。その間にモデルがあなたをどう見ているかが実際に変わったわけではありません。何十回もの実行にわたって一方向に動かない限り、順序はノイズとして扱ってください。
大部分の変化は三つの仕組みから生じます。これらを止めることはできませんが、仕組みを知っていれば、何を測り、何を無視すべきかがわかります。
言語モデルは、最良の答えを一つ選んでいるわけではありません。次の単語を確率分布から一つずつ選んでいます。温度(temperature)と呼ばれる設定が、その選択の幅を決めます。値が低いと出力は再現性に近づき、値が高いとより多様になります。開発者はAPIで温度を設定できますが、お客様の多くが使う一般向けのアプリでは、この設定は公開されていません。サンプリングは常に働いていると想定してください。SparkToroのボランティアは、個人化されたものでも既定のものでも、普段の設定のまま使用したため、彼らの結果は一般のユーザーが目にするものを表しています。
AIモデルがウェブを検索するとき、あなたの質問をそのまま検索エンジンに送るわけではありません。質問を複数のサブクエリに書き換え、それぞれについてページを取得します。言い回しのわずかな違い、その朝にインデックスされたページ、あるサブクエリで異なる結果が出ることなどが、最終的な回答に届く情報源を変えてしまいます。あなたが引用されるURLは、動き続ける検索段階の結果なのです。AIの検索エンジンが情報源を選ぶ仕組みについては当社のガイドで解説しており、AIが実際に検索している内容を追跡するSorankのツールは、まさにこの問いのために作られています。
提供元は、大きな予告なしにモデルとその周辺のシステムを更新します。新しいモデルのバージョン、AIモデルが検索を行うかどうかを判断するタイミングの変化、ウェブ索引の変化などにより、ある一日にテーマ全体の回答が変わることがあります。データに急な段階的変化が見られたら、対応する前にまず更新の可能性を確認し、基準値と比較してください。
| 仕組み | 変わるもの | 現れ方 | 対処 |
|---|---|---|---|
| サンプリング | ブランド一覧、言い回し、順序 | 同じ日に同じ質問へ異なる回答 | 多数の実行で測定し、割合を報告する |
| 検索(リトリーバル) | 引用されるURL | 週ごとに異なる情報源が引用される | うまく検索される自社ページや外部の情報源を強化する |
| モデルと索引の更新 | 回答の全体的なスタイルと優遇されるブランド | 特定の日付での段階的な変化 | 基準値を保持し、特定できた更新をすべて記録する |
実測された数値はまだ少なく、その多くはSEOやAI露出のベンダーから出ています。注意深く読むべき情報源は二つあります。一つ目は、SEOプラットフォームのAuthoritasによる研究で、AI Overviewsとオーガニック検索結果を比較しています。二つ目は、BrightEdgeによる測定で、AI OverviewsとAI Modeを比較しています。
Authoritasは、順位の変動をスコアで測定しました。スコアが高いほど、その期間に結果が大きく変わったことを意味します。AI Overviewsのスコアは8週間で0.68、13週間で0.73でした。オーガニック結果では、それぞれ0.49と0.55でした。2025年2月にこの研究を報じたDigital Information Worldは、AI Overviewsの結果の約70%が2〜3か月の間に変化したとも伝えています。ただし、その記事はキーワードの標本や測定日を示していないため、クライアント向け資料で数字を引用する前に、Authoritasの原典レポートを確認してください。
2〜3か月以内に変化したAI Overviewsの結果
出典:Authoritasの研究、Digital Information Worldによる報道、2025年2月
BrightEdgeは、同じ問いを別の角度から測定しました。2025年8月の分析では、ブランド言及の変動はAI ModeよりもAI Overviewsの方が16.7%高いことがわかりました。また、AI Overviewsでは24%のURLが変わらずに残った一方、AI Modeでは20%でした。次の表は、これらの数字を並べて示したものです。
| 指標 | AI Overviews | 比較 | 出典 |
|---|---|---|---|
| 変動スコア、8週間 | 0.68 | オーガニック結果は0.49 | Authoritas |
| 変動スコア、13週間 | 0.73 | オーガニック結果は0.55 | Authoritas |
| ブランド言及の変動 | 16.7%高い | AI Modeとの比較 | BrightEdge、2025年8月 |
| 変わらなかったURL | 24% | AI Modeは20% | BrightEdge、2025年8月 |
AI Overviewsは、一部の検索について通常のGoogle検索結果ページの中に表示されます。AI Modeは、会話形式の独立したインターフェースです。BrightEdgeの数字は、AI Overviewsの方が言及するブランドの変動が大きく、AI Modeの方がURLを安定して保つ割合が低いことを示唆しています。実務上の教訓は、それぞれの画面を個別に確認することです。「GoogleのAI」という一つの数字では違いが見えなくなり、その違いこそが計画を立てる際に必要なものです。Google AI ModeとAI Overviewsの比較では、それぞれがSEOにとって何を意味するかを説明しています。
重要なのは、オーガニックの安定性がAIにもそのまま当てはまるとは考えられない、という点です。Authoritasのデータでは、オーガニック結果はAI Overviewsより変動が小さいものの、動かないわけではありません。一か月間3位を保っていたページでも、コアアップデートの後に下がることがあります。そのため、両方の画面で、実際の変化と通常の揺らぎを区別する方法が必要です。
多くの順位追跡ツールは、一つのキーワードに対して順序付きの一覧があり、それがゆっくりと変わるGoogle向けに作られています。同じ論理をAIモデルに当てはめると、一回の標本に基づく数字が生まれます。ブランドがある実行では3位、次の実行では8位だった場合、その二回の平均はほとんど何も教えてくれません。「ChatGPTで3位です」と報告するツールは、一度の抽選を事実のように見せています。順位追跡ガイドでは従来の手法を扱っており、この記事では、回答が一覧として掲示されるのではなく生成される場合に何が変わるのかを説明します。
SparkToroの結論は、固定された順位に基づく順位追跡製品は雑音を測定しているというものです。研究の助言は、順位ではなく露出を追跡することです。研究は、数十から数百の質問にわたって、各質問を複数回実行して測定した場合に、可視性の割合を妥当な指標と見なしています。どのベンダーのスコアを信頼する前にも、そのサンプルサイズと算出方法を示してもらってください。
一つの質問とスクリーンショットか、測定された割合か
Google自身のドキュメントも、別の理由から同じ方向を指しています。Googleによると、AI OverviewsやAI Modeで使われるには、ページがインデックスされ、スニペット付きで検索に表示される資格を持っている必要があります。また、特別なマークアップやAI専用のファイルを追加する必要もないとしています。最適化すべき「AIランキング」の設定は存在しません。だから取り組むべきは、多くの情報源で存在感と信頼を得ることであり、その存在感を正直に測定することです。
以下の方法は、設定に数日、その後の維持に週に数分かかります。スプレッドシートで実行できます。専用ツールが主に省いてくれるのは、繰り返しの作業であって、考える作業ではありません。
五段階の測定方法
可視性の割合は、自社ブランドに言及する回答の割合です。誤差の範囲は、どれだけの変化が本物かを示します。割合の標準誤差に基づく95%の誤差の範囲を使います。
visibility rate = answers that name your brand / total answers
standard error = sqrt(p x (1 - p) / n)     where p is the visibility rate and n the number of runs
95% margin of error = 1.96 x standard error
これは説明のための例であり、数字は架空のものです。実測ではありません。自社ブランドが80回の実行のうち37回に現れたとすると、可視性の割合は46%です。標準誤差は5.6ポイントで、95%の誤差の範囲は約11ポイントになります。結果は「46%プラスマイナス11ポイント」と報告します。次のバッチで40%となっても、その範囲内なので、ページを書き直す必要を示すものではありません。
ブランドは、リンクなしで言及されることもあれば、リンクされても推奨されないこともあり、競合を挙げずに推奨されることもあります。これらの状態は別々に記録してください。推奨と言及、言及のみ、引用のみです。それぞれの割合は異なる理由で動き、それぞれに異なる対策が必要です。言及のない引用は情報源の問題です。推奨のない言及は位置づけの問題です。
最初の測定シート
注意
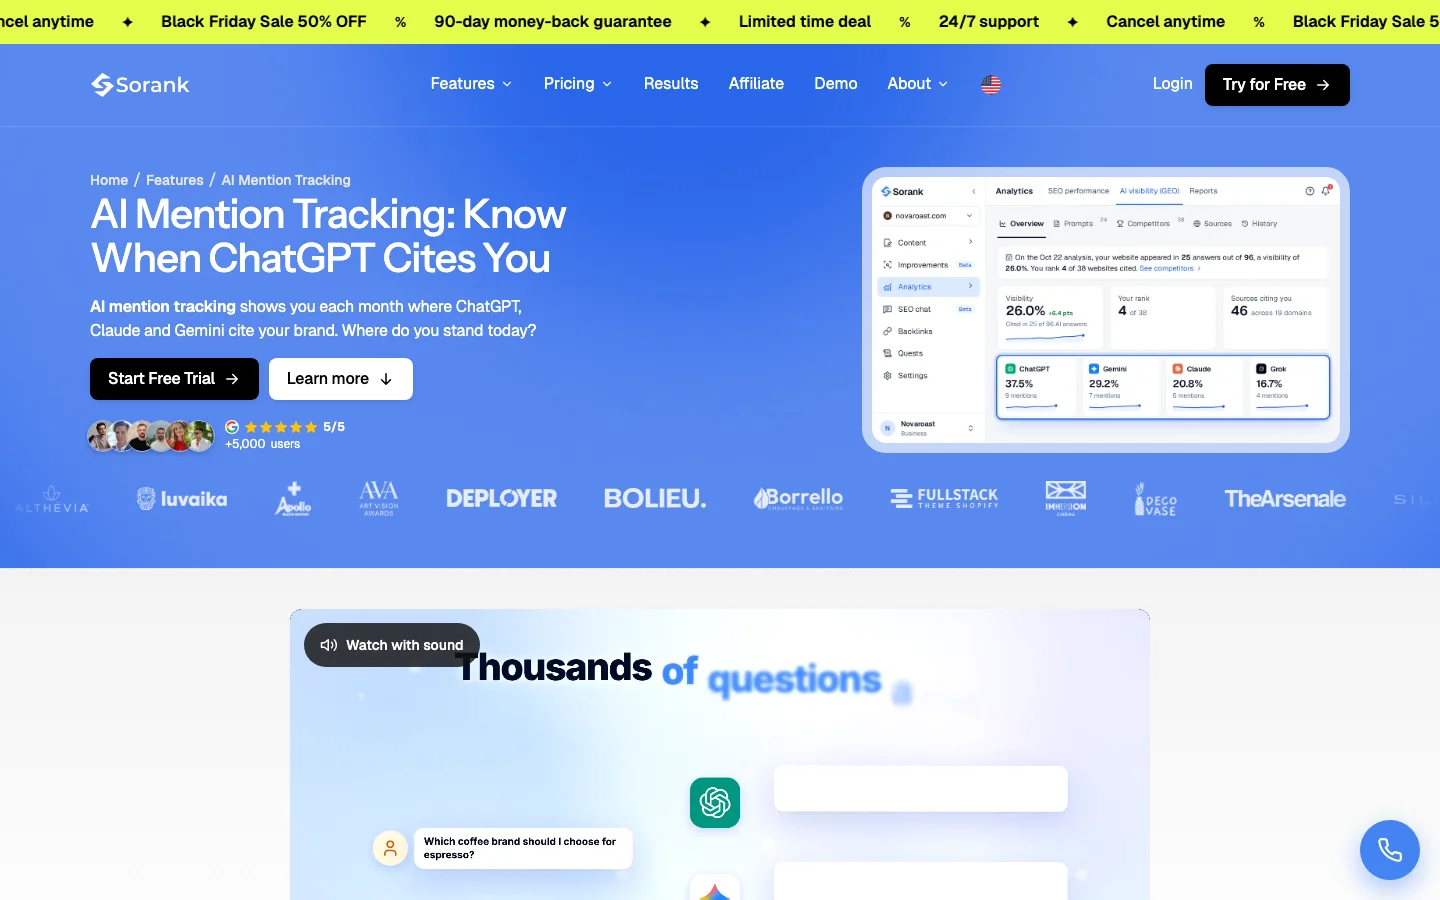
すべての質問を手作業で繰り返すのは、数週間もすれば面倒になります。SorankのAIメンション追跡は、追跡している質問ごとに、ChatGPT、Claude、Geminiがあなたのブランドに言及する頻度を、各回答の背後にある情報源や検索とともに報告します。実行は月に一度なので、一つの質問に対する標本としては少なめです。数か月の傾向で読み、特に重要な質問については自分でも繰り返し実行を追加してください。
月次レポートは一つの問いに答えるべきです。露出は動いているか、その動きはノイズより大きいか。単一の数字ではなく、質問グループごとの可視性の割合とその誤差の範囲を示してください。さらに、言及された回答の中で、自社ブランドが一番目、二番目、それ以下に現れる頻度の分布も加えます。こうすれば、順序は順位ではなく散らばりとして表れます。横ばいや上昇傾向の中での上下は正常です。しかし、数バッチにわたって下がり続けるのは正常ではありません。その場合は、ページを書き直す前に、質問、モデルのリリースノート、引用されている情報源を確認すべきです。行動のルールはレポート自体に書き込んでください。変化は、二つのバッチ連続で誤差の範囲を超えたときにのみ本物とみなす、というルールです。
変動を止めることはできませんが、露出を一貫したものにすることはできます。AIモデルがすでに使っている複数の情報源で、自社ブランドが同じように説明されていると、露出は強まります。Googleのドキュメントは、同社のAI機能が必要とするものの基本を示しています。
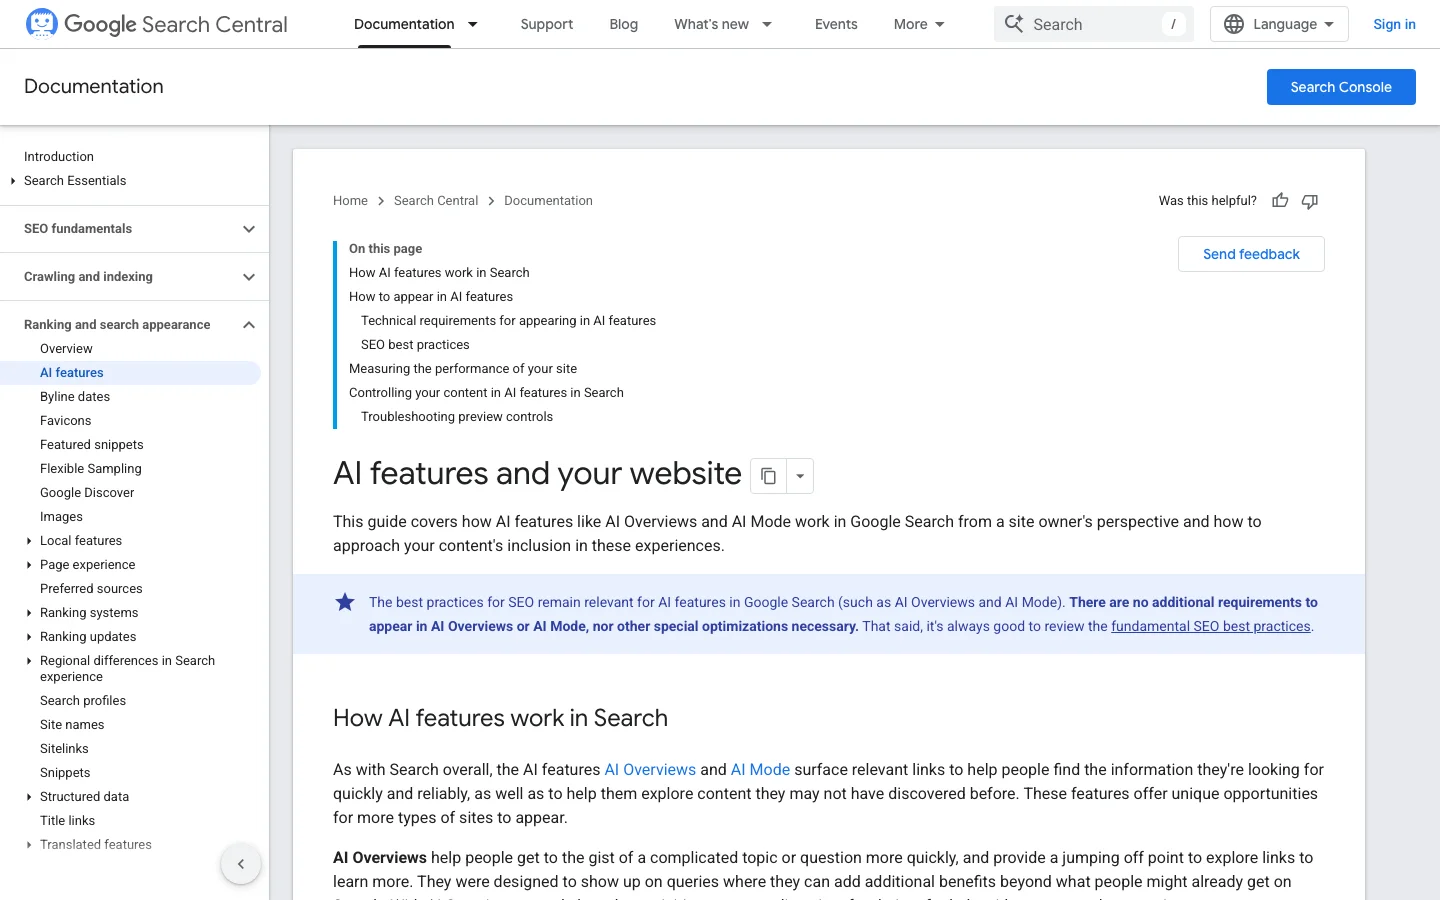
AI OverviewsとAI Modeに関するGoogleの指針は簡潔です。ページはインデックスされ、スニペットを表示できる資格を持つ必要があります。通常の基本事項も引き続き当てはまります。クロールを許可するrobots.txtのルール、内部リンク、読者に見えるテキストコンテンツ、そして表示されているテキストと一致する構造化データです。Googleは、表示されるために新しい機械可読ファイル、AI向けのテキストファイル、特別なスキーマは必要ないとしています。
AIモデルは、多くの場所から同時にブランドのイメージを作り上げます。自社の名称、カテゴリー、主な用途、所在地が、ウェブサイト、プロフィール、ディレクトリのリストで食い違っていると、イメージがぼやけ、ブランド一覧も不安定になります。会社の簡潔で事実に基づいた説明を一つ書き、カテゴリーと用途を含めて、文章を管理できる場所では必ず再利用してください。四半期ごとに確認しましょう。
裏付けとは、複数の独立した情報源が、あなたについて同じことを言っている状態です。レビュー、比較記事、業界ディレクトリ、そして自社の分野の専門メディアが代表的な場所です。こうした言及は、独自データ、明確な製品比較、人々が実際に使うツールなど、有益な仕事を通じて獲得してください。購入してはいけません。有料掲載は雑音を増やし、支払いが止まると崩れてしまうパターンです。
AIモデルが抽出するのはページ全体ではなく、段落です。冒頭の段落で短い定義を示し、主要な質問に直接答え、明確な次のステップを示しているページは、抽出されやすく、正確に引用されやすくなります。当社のGEOチェックリストは、各ページで確認すべき点を挙げています。
ブランドの安定性チェックリスト
チームは、変動に対して四つの一般的な方法で対応します。それぞれに用途と限界があります。最良のものを順位付けしたものとしてではなく、組み合わせて使える選択肢として読んでください。多くのチームは、最初のものと最後のものを一緒に使っています。
原則:毎日一つの質問を投げ、回答の中で自社ブランドの位置を記録します。使いどころ:特定の質問が急に変わったときに、早期警告を得たいとき。利点:なじみがあり、安価で、グラフにしやすい。限界:一日に一つの標本にすぎず、本当の損失と通常の揺らぎを区別できない。例:ある質問は月曜日には自社ブランドに言及したが、水曜日には言及しなかった。グラフは下落を示すが、一回の実行では、順位を失ったのか通常のばらつきなのかはわかりません。
原則:多くの質問を何度も実行し、自社ブランドに言及する回答の割合を誤差の範囲とともに報告します。使いどころ:報告用の数字や、コンテンツ投資の判断が必要なとき。利点:出力の生成方法に合っており、偽りの一点ではなく範囲を与えてくれます。限界:より多くの実行が必要で、質問のセットを安定させる規律が求められます。例:80回の実行で、可視性の割合は46%プラスマイナス11ポイントです。翌月は52%です。傾向が上向きだとは言えますが、それが本当の進歩だとはまだ言えないため、次のバッチを待ちます。
原則:同じ正確な主張を、複数の独立した情報源に掲載させます。使いどころ:位置づけは明確で、持続する推奨がほしいとき。利点:AIの回答にも従来の検索にも効果があり、その効果は長く続きます。限界:時間がかかり、一か月以内に結果が出ることはまれです。例:あるソフトウェア企業の利用ケースが、二つのレビュー、比較ページ、業界ディレクトリで説明されたため、AIモデルは異なる質問でも同じ説明を繰り返すようになりました。
原則:主要な質問に答えるページを更新し、答えを明確で正確、かつ日付入りにします。使いどころ:自社ページは引用されているが誤った説明がされている場合や、本来は自社ページが引用されるべきところで競合のページが引用されている場合。利点:すぐに実行でき、段落の抽出も改善します。限界:より良いページでも言及が保証されるわけではなく、変更が自社データに現れるまでには時間がかかります。例:用語集のページに、冒頭の一文の定義、短い比較表、目立つ更新の注記を加えたところ、次の測定バッチで正しい説明が表示されました。
| 方法 | わかること | シグナルの安定性 | 労力 | 最適な用途 |
|---|---|---|---|---|
| 日次の順位 | ある一日の一つの位置 | 低い | 低い | 一つの質問での急な変化の察知 |
| 多数の実行にわたる露出 | 自社ブランドに言及する回答の割合 | 高い(誤差の範囲付き) | 中〜高 | 報告と予算の判断 |
| 裏付け | 情報源があなたをどれだけ一貫して説明しているか | 数か月にわたり高い | 高い | 長期的な推奨 |
| ページの更新 | 主要なページがどれだけ質問に答えているか | 中程度 | 中程度 | 誤った、または欠けている説明の修正 |
Googleの自然検索結果とAIの回答には、異なる計測手段が必要です。混同すると誤った結論に至るため、報告では両者を分けておいてください。
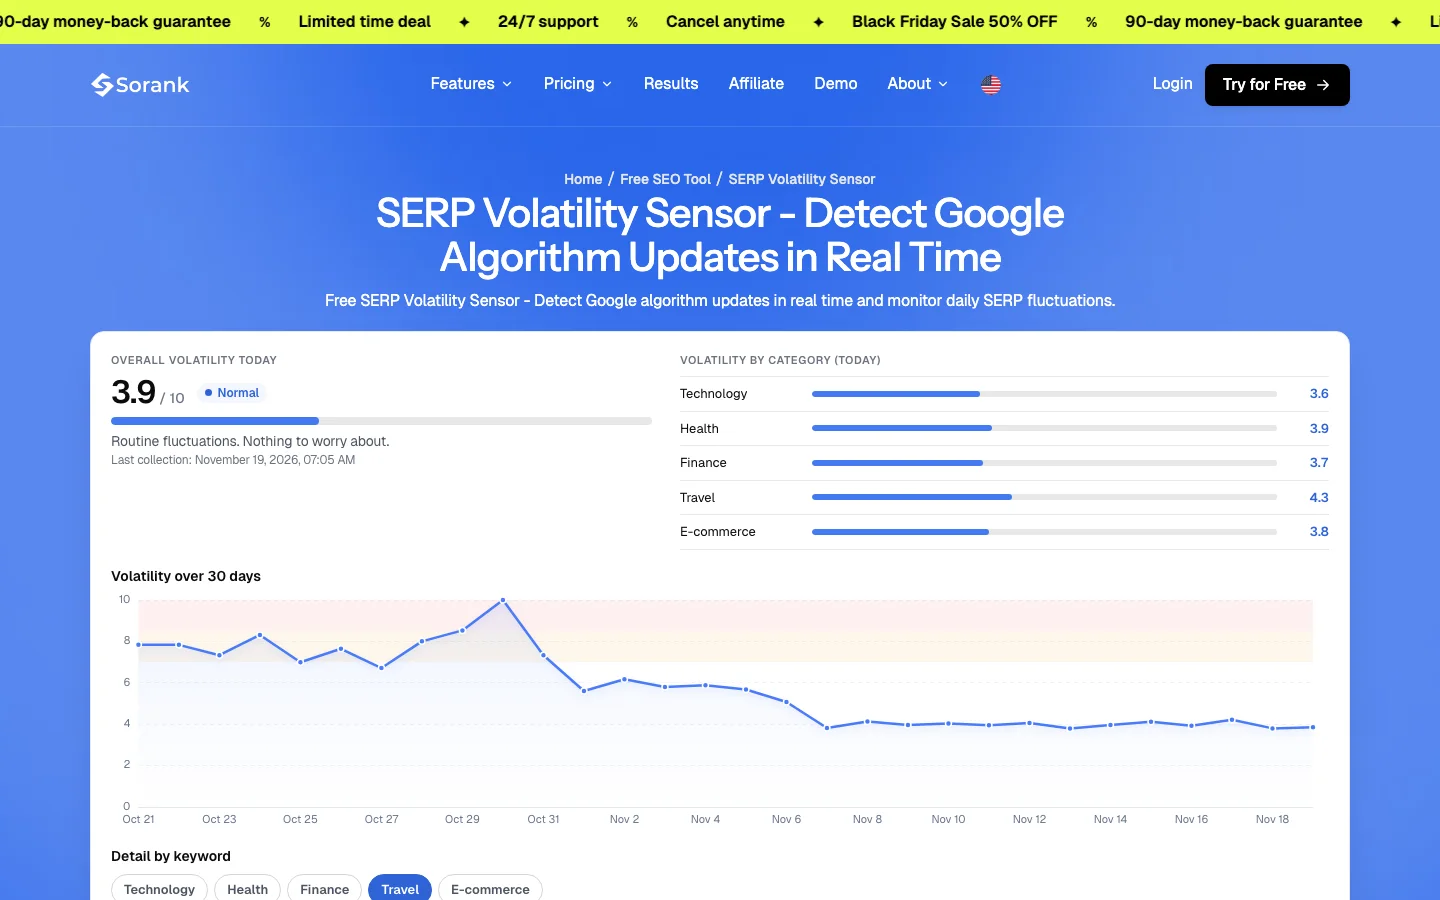
Sorankの無料ツールSERP Volatility Sensorは、一つ目の種類をカバーします。毎朝、米国の英語キーワード20個について、五つの業界にわたって自然検索結果の上位10件を収集し、前日と比較して、0から10のスコアを出します。全体と業界ごとのスコアがあります。Googleの一ページ目がどれだけ動いたかを示すため、アルゴリズム変更の有用な早期シグナルになります。ただし、AIの回答は計測しないため、上で説明したプロンプトベースの方法の代わりにはなりません。Googleの側面については、そのページでセンサーを確認し、AIの可視性の数字の隣ではなく、順位データの隣に置いてください。
Search ConsoleとGoogle Analyticsは、Googleのクリックと参照訪問を報告します。順位追跡ツールはGoogleでの順位を報告します。どちらも、どのAIの回答が自社ブランドに言及したかは示しません。それには、記録された回答か、それを記録するツールが必要です。AIモデルから届く訪問については、参照の側面をGEOレポートのガイドで扱っています。
変動に関する誤りの多くは、雑音をシグナルとして読んでしまうことから生じます。以下の各誤りについて、どのように見えるか、データのどこで見分けられるか、どう修正するかを示します。
これは何か:一枚のスクリーンショットや一つの回答を、自社の順位として提示すること。見分け方:報告には標本サイズも期間も誤差の範囲もなく、位置だけが示されている。修正方法:質問ごとに少なくとも30回の実行にわたる可視性の割合を、誤差の範囲と期間とともに報告する。
これは何か:二回の確認の間に質問の言い回しを変えること。たとえば、ある週は「best CRM」、次の週は「best CRM for startups」とし、その結果を傾向として読むこと。見分け方:同じ行の質問文が、二つの日付で異なっている。修正方法:質問のセットを固定し、バージョン管理する。新しい質問は新しい行として追加し、古い質問は決して編集しない。
これは何か:五ポイントの下落を受けて、ページを書き直すこと。見分け方:変化が、その質問の誤差の範囲より小さい。修正方法:変化が二つのバッチ連続で誤差の範囲を超えた場合にのみ行動し、同じ期間に起きた他の変化(モデルの更新や競合の公開など)も書き留める。
これは何か:自社サイトへのリンクをすべて勝利として記録すること。回答が自社ブランドを避けるべき選択肢として挙げていても、脚注に過ぎなくても同様。見分け方:誰も引用の周りの文を読んでいない。修正方法:三つの状態(推奨と言及、言及のみ、引用のみ)を別々に記録し、チェックを入れる前に文を読む。
これは何か:レポートのためにマーケティングチームが作った質問。見分け方:質問に、顧客が決して使わない社内の製品名や専門用語が含まれている。修正方法:営業の通話、サポートの会話、Search Consoleのクエリから質問を集め、そのいくつかを実際の顧客と照らし合わせる。
これは何か:可視性の割合が上がれば、自動的に訪問も増えると仮定すること。見分け方:可視性の割合は上がるのに、参照セッションが横ばいのまま。修正方法:参照訪問を別に測定し、どのAIモデルとどのページが訪問を送っているかを確認し、二つのデータセットを一つの月次レポートにまとめる。
これは何か:AI向けのテキストファイルや新しいマークアップを作るプロジェクトを立ち上げ、それが引用を引き起こすことを期待すること。見分け方:そのプロジェクトに、インデックスやスニペットの資格を確認する項目がない。修正方法:まずGoogleの指針から始める。主要なページがインデックスされ、スニペットを表示できる資格があることを確認してから、テキストと内部リンクを修正する。それ以外のことは後回しにする。
| 誤り | データ上の兆候 | 修正 |
|---|---|---|
| 一回の実行を結果として報告 | 標本サイズも誤差の範囲もない | 少なくとも30回の実行にわたる割合を報告する |
| 確認の間に質問を編集 | 同じ行で、文が違い、日付が違う | 質問のセットを固定し、バージョン管理する |
| 誤差の範囲内の変化に反応 | 範囲より小さい変化 | 二つのバッチにわたって持続する変化にのみ行動する |
| 引用を推奨として数える | 周囲の文が読まれていない | 三つの状態を別々に記録する |
| 誰も入力しない質問 | 質問リストに社内の専門用語 | 顧客の実際の言葉から質問を集める |
| 可視性を流入と扱う | 可視性は上がるが参照は横ばい | 参照を単独で測定する |
始めるのに、完全なプログラムは必要ありません。最初の週は、今後六か月のデータが読めるように測定を整えることに使います。以下の手順を順番に進めてください。
最初の一週間
基準値が一度できれば、変動は不安の種ではなくなります。測定できる範囲となり、その中で計画を立てられる変化の集まりになります。
言語モデルは、確率分布から単語を一つずつ選ぶため、同じ質問でも言い回し、ブランド一覧、順序が異なることがあります。検索(リトリーバル)も変化します。AIモデルは質問をサブクエリに書き換え、取得されるページが実行ごとに変わりうるためです。
Authoritasは、AI Overviewsの変動スコアを8週間で0.68、13週間で0.73と測定しました。オーガニック結果は、それぞれ0.49と0.55でした。SparkToroは、ChatGPTまたはGoogleのAIが同じブランド一覧を二度返す確率が100回に1回未満であることを明らかにしました。
AIの回答における単一の位置は、判断材料とするには不安定すぎます。多くの質問と実行にわたって、自社ブランドが現れる頻度を追跡し、その割合を誤差の範囲とともにパーセントで報告してください。Googleの自然検索結果については、従来の順位追跡を続けてください。こちらは順位の変化がよりゆっくりだからです。
競合、あなたのサイト、AIでの可視性を分析し、あなた専用のコンテンツプランを無料で作成します。
 AI コンテンツブリーフ生成ツール
 FAQ スキーマ生成ツール
 AI ブログ記事アイデア生成ツール
 構造化データ検証ツール(スキーマバリデーター)
 代替テキストチェッカー
 内部リンク分析ツール
 被リンクチャレンジ
 AI メタディスクリプション生成ツール
 AI ブログタイトル生成ツール
 Google インデックス可否チェッカー
 AI 記事構成案生成ツール
 UTM リンク作成ツール
 キーワードのグループ化ツール
 canonical タグチェッカー
 XML サイトマップ生成ツール
 リンク切れチェッカー
 AI SEO タイトル生成ツール
 見出しアナライザー
 検索結果プレビューツール
 リダイレクトチェッカー
 hreflang タグ生成ツール
 見出し構造チェッカー
 HTTP ヘッダーチェッカー
 Favicon 抽出ツール
 SEO トラフィック・売上予測計算ツール
 SEO 予算計算ツール
 順位上昇シミュレーター
 キーワード機会スコア計算ツール
 GEO コンテンツ投資計算ツール
 顧客生涯価値計算ツール
 CTR 計算ツール
 AI トラフィック価値計算ツール
 AI シェア・オブ・ボイス計算ツール
 Gemini ランキングツール
 ROAS 計算ツール
 自然検索トラフィック価値計算ツール
 ローカル SEO ROI 計算ツール
 被リンク獲得コスト計算ツール
 キーワード密度計算ツール
 顧客獲得コスト計算ツール
 記事単価計算ツール
 直帰率計算ツール
 AI 引用率計算ツール
 LLM 向け構造化データ監査
 llms.txt ジェネレーター
 Sitemap チェッカー
 SERP 変動センサー
 文字数カウンター
 Schema マークアップ生成ツール
 キーワード調査ツール
 SEO 損益分岐点計算ツール
 読了時間計算ツール
 自然検索トラフィック予測ツール・サイトのアクセス数チェック
 ChatGPT 参照トラフィック予測ツール
 AI 可視性スコア計算ツール
 AI 可読性チェッカー
 SearchGPT 対応チェッカー
 ChatGPT が自社サイトを推薦しない理由
 URL 抽出ツール
 ウェブページ Markdown 変換ツール
 robots.txt 生成ツール
 Open Graph プレビュー
 オンページ SEO 監査:SEO チェッカーと SEO 分析ツール
 LTV:CAC 比率計算ツール
 GEO ROI 計算ツール
 コンバージョン率計算ツール
 AI クローラー巡回監査
 AI 検索可視性テスト
 ページサイズチェッカー
 URL スラッグ生成ツール
 メタタグ生成ツール
 画像圧縮ツール
 ファビコン生成ツール
 ドメインオーソリティチェッカー
 検索結果 CTR 計算ツール
 EC SEO ROI 計算ツール
 コンテンツマーケティング ROI 計算ツール
 AI での不可視コスト計算ツール
 AI Overviews チェッカーと AI Overviews 順位チェック
 robots.txt チェッカー
 SEO・AI 監査
 Perplexity ランキングチェッカー
 アンサーエンジン最適化の監査
 ChatGPT 可視性チェッカー
 被リンク分析ツール
 SEO とリスティング広告の節約額計算ツール
 SEO シェア・オブ・ボイス計算ツール
 SaaS SEO ROI 計算ツール
 被リンク ROI 計算ツール
 llms.txt バリデーター
 LLM 引用チェッカー
 GEO 監査
 SEO ROI 計算ツール
 キーワード価値計算ツール
 “2年間、クライアントの100%がLinkedIn経由でした。毎日の投稿、コメント、DMでのフォローアップ…完全にアルゴリズム頼みでした。SEOに取り組むべきだとわかっていても、時間がかかる、技術的すぎる、自分の仕事ではないと、いつも後回しにしていました。Sorankでようやく一歩を踏み出しました。4か月で、何も投稿しなくても毎月15件のオーガニックリードを獲得しています。まだLinkedInと半々ではありませんが、自動で育つ2つ目のリード源ができたことで安心して眠れるようになりました。”

 Valentin Thomyoffbound.fr“Sorankは、クライアントに提供する成果を大きく変えてくれました。AIが実際に使っているキーワードを特定し、特定の競合が引用される理由を理解し、以前は完全に見落としていたチャンスを見つけられるようになりました。クライアントは、より早い順位上昇、AIの回答での可視性向上、そしてすべての施策のROIがより明確になったことを実感しています。”
 Benjamin Rouxovirank.com
 “私はマーケターではなく開発者です。私のShopifyテーマは口コミと広告だけで売れていました。Sorankのおかげで、SEOの組み立て方と上位表示される記事の書き方がようやくわかりました。監査で商品ページが遅すぎることも判明しました。2か月でオーガニックトラフィックは2倍になり、ShopifyテーマについてChatGPTで検索されたときの回答にも表示され始めています。しかも、週に約2時間の作業だけです。”
 Thème FullStackgo.themefullstack.com“Sorankのおかげで、私たちのSEOエージェンシーの働き方は大きく変わりました。すべてが一元化・自動化されたため、クライアント1社あたりにかける時間が大幅に減りました。以前は何時間もかかっていた作業が今では数分で終わり、ようやくビジネスの中で働くのではなく、ビジネスそのものに取り組めるようになりました。”
 Océane Bondismaison-leverage.com