La privacidad es importante para nosotros, por lo que tiene la opción de desactivar ciertos tipos de almacenamiento que pueden no ser necesarios para el funcionamiento básico del sitio web. Bloquear categorías puede afectar a su experiencia en el sitio web. Más información (Política de cookies)
Puntos azules sobre una cuadrícula blanca, la mayoría desplazándose mientras uno permanece anclado, ilustrando la volatilidad de la búsqueda con IA.
Herramientas
En esta página
En resumen
la volatilidad de la búsqueda con IA mide cuánto cambian las marcas, las URL y el orden de una respuesta de IA de una ejecución a otra, y de una semana a otra. La misma pregunta puede devolver una lista de marcas distinta, otras citas y otro orden, porque la respuesta se genera con aleatoriedad y el paso de recuperación también cambia. Por eso la posición dentro de una respuesta de IA es una métrica poco fiable. Mida con qué frecuencia aparece su marca en muchos prompts y muchas ejecuciones, y después construya las fuentes que hacen estable esa presencia.
3 días gratis y luego lo dejas cuando quieras. Garantía de resultados de 90 días, sujeta a condiciones.
Qué significa la volatilidad de la búsqueda con IA
En la búsqueda orgánica de Google, la volatilidad significa que su posición para una palabra clave sube y baja. En la búsqueda con IA significa algo más. La respuesta en sí es distinta en cada ejecución. Una respuesta de IA volátil puede cambiar de tres formas: qué marcas nombra, qué URL cita y en qué orden las enumera. Cualquiera de ellas puede moverse sin que cambie nada en su sitio web.
La diferencia importa porque un ranking es un resultado fijo en un momento dado. Google devuelve una lista ordenada, y para la misma consulta en el mismo mercado esa lista es en gran parte repetible. Un modelo de IA devuelve una sola muestra de un abanico de respuestas posibles. Su marca tiene una probabilidad de aparecer en ese abanico. Esa probabilidad es lo que puede medir, y lo que puede mover.
Dos cifras de un estudio publicado en 2026 muestran la fuerza del efecto. Rand Fishkin, de SparkToro, trabajó con Patrick O'Donnell, de Gumshoe.ai. Unos 600 voluntarios enviaron 12 prompts a ChatGPT, Claude y la IA de Google, en total 2961 ejecuciones. Los investigadores hallaron menos de un 1% de probabilidades de que ChatGPT o la IA de Google devolvieran dos veces la misma lista de marcas. La probabilidad de la misma lista en el mismo orden fue de aproximadamente 1 entre 1000 ejecuciones. El informe de SparkToro, fechado el 28 de enero de 2026, recoge datos recopilados en noviembre y diciembre de 2025.
¿Qué estables son las listas de marcas de la IA?
2961ejecuciones con 12 prompts y tres sistemas de IA
<1%probabilidad de que ChatGPT o la IA de Google devuelva dos veces la misma lista de marcas
<0,1%probabilidad de la misma lista de marcas en el mismo orden
Fuente: SparkToro y Gumshoe.ai, enero de 2026
Una vez que se acepta que la respuesta es una muestra, la forma de seguirla tiene que cambiar. La comparación siguiente resume las dos mentalidades. Es la idea central de toda esta guía.
Seguir una posición o seguir la presencia
Una posición aislada
Cambia en casi todas las ejecuciones
Una sola respuesta dice muy poco
Porcentaje de ejecuciones
Medido en decenas de prompts
Muestra una tendencia sobre la que se puede actuar
Volatilidad en las listas de marcas
El cambio más visible es la propia lista de marcas. Un prompt como «mejor herramienta de gestión de proyectos para un equipo de 10 personas» puede nombrar cinco marcas en una ejecución y otras cinco distintas en la siguiente. Algunas marcas vuelven con frecuencia, otras entran y salen. La presencia dentro del conjunto es más estable que la posición dentro de él, por eso los investigadores recomiendan seguir la presencia en lugar del ranking.
De ahí se deriva una consecuencia práctica. Si comprueba un prompt una sola vez y ve su marca en segunda posición, sabe casi nada. Si lo comprueba 60 veces y ve su marca en 40 respuestas, sabe algo útil: es una opción habitual para esa pregunta.
Volatilidad en las citas
Las citas son los enlaces que un modelo de IA muestra como fuentes. Cambian aún más que la lista de marcas cuando el modelo hace una búsqueda web en directo, porque cada ejecución puede recuperar un conjunto distinto de páginas. Una cita que desaparece no siempre es una pérdida. Su marca puede seguir mencionada en el texto sin enlace. Por eso conviene registrar dos cosas por separado: la mención nombrada y la URL citada.
Volatilidad en el orden
La posición dentro de una respuesta es el elemento menos estable. Un modelo de IA puede poner su marca en primer lugar en una ejecución y en cuarto en la siguiente, sin que haya cambiado realmente la forma en que lo ve. Trate el orden como ruido, salvo que se mueva en una sola dirección a lo largo de decenas de ejecuciones.
Por qué preguntas idénticas reciben respuestas distintas
Tres mecanismos explican la mayor parte de los cambios. No se pueden desactivar, pero conocerlos le dice qué medir y qué ignorar.
Muestreo
Un modelo de lenguaje no elige una única mejor respuesta. Elige cada palabra siguiente a partir de una distribución de probabilidades. Un ajuste llamado temperatura controla lo amplia que es esa elección. Con un valor bajo, la salida se acerca a ser repetible, y con un valor alto varía más. Los desarrolladores pueden fijar la temperatura en una API, pero las aplicaciones de consumo que usan la mayoría de sus compradores no la exponen. Suponga que el muestreo siempre está activo. Los voluntarios de SparkToro mantuvieron sus ajustes habituales, personalizados o por defecto, por eso sus resultados describen lo que ve un usuario corriente.
Recuperación y subconsultas
Cuando un modelo de IA busca en la web, no envía su pregunta exacta a un buscador. La reescribe en varias subconsultas y recupera páginas para cada una. Un pequeño cambio de redacción, una página indexada esa misma mañana o un resultado distinto para una sola subconsulta pueden cambiar qué fuentes llegan a la respuesta final. Las URL desde las que le citan son el resultado de un paso de recuperación que se mueve. Nuestra guía sobre cómo eligen sus fuentes los modelos de IA explica el mecanismo, y el rastreador de Sorank sobre lo que la IA busca realmente está diseñado justo para esa pregunta.
Actualizaciones de modelos e índices
Los proveedores actualizan los modelos y los sistemas que los rodean sin mucho aviso. Una nueva versión del modelo, un cambio en cuándo decide buscar o un cambio en el índice web pueden alterar las respuestas de todo un tema en un solo día. Cuando sus datos muestren un cambio brusco, compruebe primero si hay una actualización probable y compárelo con su referencia antes de reaccionar.
Mecanismo
Qué cambia
Cómo se ve
Qué hacer
Muestreo
Lista de marcas, redacción y orden
Respuestas distintas al mismo prompt el mismo día
Medir en muchas ejecuciones e informar un porcentaje
Recuperación
URL citadas
Fuentes distintas citadas de una semana a otra
Reforzar las páginas y fuentes de terceros que se recuperan bien
Actualizaciones de modelos e índices
Estilo general de la respuesta y marcas favorecidas
Un cambio brusco en una fecha concreta
Mantener una referencia y anotar cada actualización identificable
Las respuestas de IA cambian de una ejecución a otra. La presencia en muchas ejecuciones es lo que puede medir y construir.
Cuánto cambian las respuestas de la IA
Las cifras medidas siguen siendo escasas, y la mayoría proceden de proveedores de SEO y de visibilidad en IA. Hay dos fuentes que conviene leer con detalle. La primera es un estudio de la plataforma SEO Authoritas, que comparó las AI Overviews con los resultados orgánicos. La segunda son las mediciones de BrightEdge, que compararon las AI Overviews con el modo IA.
Authoritas midió la volatilidad de los rankings con una puntuación. Cuanto mayor es la puntuación, más cambiaron los resultados en el periodo. Para las AI Overviews, la puntuación fue de 0,68 a las 8 semanas y de 0,73 a las 13 semanas. Para los resultados orgánicos fue de 0,49 y 0,55. Digital Information World, que se hizo eco del estudio en febrero de 2025, también indicó que cerca del 70% de los resultados de las AI Overviews cambió en dos o tres meses. Ese artículo no precisaba la muestra de palabras clave ni las fechas de medición, así que compruebe el informe original de Authoritas antes de citar una cifra en un documento para un cliente.
Puntuación de volatilidad de los rankings a 8 semanas
AI Overviews0,68
Resultados orgánicos0,49
Fuente: estudio de Authoritas, publicado por Digital Information World, febrero de 2025
Resultados de las AI Overviews que cambiaron en 2 a 3 meses
70%de los resultados de AI Overviews analizados
Fuente: estudio de Authoritas, publicado por Digital Information World, febrero de 2025
BrightEdge midió la misma cuestión desde otro ángulo. Su análisis de agosto de 2025 encontró un 16,7% más de volatilidad en las menciones de marca en las AI Overviews que en el modo IA. También halló que las AI Overviews mantenían el 24% de sus URL sin cambios, frente al 20% del modo IA. La tabla pone estas cifras una al lado de otra.
Medida
AI Overviews
Comparación
Fuente
Puntuación de volatilidad, 8 semanas
0,68
0,49 en resultados orgánicos
Authoritas
Puntuación de volatilidad, 13 semanas
0,73
0,55 en resultados orgánicos
Authoritas
Volatilidad de las menciones de marca
16,7% más
Frente al modo IA
BrightEdge, agosto de 2025
URL sin cambios
24%
20% en el modo IA
BrightEdge, agosto de 2025
Por qué las AI Overviews y el modo IA se comportan de forma distinta
Las AI Overviews aparecen dentro de la página normal de resultados de Google para un subconjunto de consultas. El modo IA es una interfaz aparte, de estilo conversacional. Las cifras de BrightEdge sugieren que las AI Overviews oscilan más en las marcas que mencionan, mientras que el modo IA mantiene menos URL estables. La lección práctica es revisar cada superficie por separado. Una sola cifra de «IA de Google» oculta la diferencia, y esa diferencia es precisamente lo que hay que tener en cuenta al planificar. Nuestra comparación de Google AI Mode y AI Overviews explica qué significa cada uno para el SEO.
El punto clave es que no se puede suponer que la estabilidad orgánica se traslade. Los resultados orgánicos son menos volátiles que las AI Overviews en los datos de Authoritas, pero no están quietos. Una página que mantiene la posición 3 durante un mes puede caer después de una actualización principal, así que necesita un método que separe el cambio real del movimiento normal en ambas superficies.
Por qué el seguimiento de posiciones falla en la búsqueda con IA
La mayoría de los rastreadores de posiciones se diseñaron para Google, donde una palabra clave tiene una lista ordenada única que cambia despacio. Aplicada a un modelo de IA, la misma lógica produce un número basado en una sola muestra. Si su marca está tercera en una ejecución y octava en la siguiente, la media de esas dos ejecuciones no le dice casi nada. Una herramienta que informa de «está en el puesto 3 en ChatGPT» presenta una sola tirada como si fuera un hecho. Nuestra guía de seguimiento de posiciones cubre el método clásico, y este artículo explica qué cambia cuando la respuesta se genera en lugar de listarse.
La conclusión de SparkToro es que los productos de seguimiento de posiciones basados en posiciones fijas miden ruido. El consejo del estudio es seguir la presencia en lugar del ranking. Considera razonable un porcentaje de visibilidad cuando se mide en decenas o cientos de prompts, cada uno ejecutado varias veces. Pida a cualquier proveedor que muestre el tamaño de la muestra y el método detrás de una puntuación antes de confiar en ella.
Un prompt, una captura o un porcentaje medido
Antes
Informa de una posición única
Cambia en la siguiente ejecución
Sin margen de error, así que cada movimiento parece real
Después
Informa del porcentaje de ejecuciones que nombran su marca
Muestra una tendencia a lo largo de varias semanas
Indica cuánto debe cambiar algo para que importe
La documentación de Google apunta en la misma dirección, por otra razón. Google dice que una página debe estar indexada y ser apta para aparecer en la Búsqueda con un fragmento para usarse en las AI Overviews o en el modo IA. También dice que no hay que añadir ningún marcado especial ni ningún archivo específico de IA. No existe un ajuste de «ranking de IA» que optimizar, así que el trabajo consiste en estar presente y ser fiable en muchas fuentes, y en medir esa presencia con honestidad.
Cómo medir la volatilidad de la búsqueda con IA, paso a paso
El método siguiente requiere unos días de puesta en marcha y unos minutos a la semana para mantenerlo. Puede ejecutarlo en una hoja de cálculo. Las herramientas especializadas sobre todo le ahorran la repetición, no el razonamiento.
El método de medición en cinco pasos
Construya un conjunto de promptsElija entre 20 y 50 preguntas que hagan compradores reales. Tómelas de llamadas comerciales, chats de soporte y consultas de Search Console.
Ejecute cada prompt muchas vecesRepita cada prompt al menos 30 veces por modelo de IA, idealmente de 60 a 100 como hizo el equipo de SparkToro. Use los mismos ajustes y reparta las ejecuciones en varios días.
Registre cada respuestaAnote si su marca aparece nombrada, si se recomienda o solo se menciona, su posición y las URL citadas.
Calcule la tasa de visibilidadDivida las respuestas que nombran su marca entre todas las respuestas y añada el margen de error de cada prompt y cada modelo de IA.
Lea la tendencia cada semanaRepresente la tasa en el tiempo y anote las actualizaciones de modelos, sus cambios de contenido y los lanzamientos de competidores.
La fórmula, con un ejemplo resuelto
La tasa de visibilidad es la proporción de respuestas que nombran su marca. El margen de error indica cuánto de un cambio es real. Use un margen de error del 95% basado en el error estándar de una proporción:
tasa de visibilidad = respuestas que nombran su marca / total de respuestas
error estándar = raíz(p x (1 - p) / n)     donde p es la tasa de visibilidad y n el número de ejecuciones
margen de error al 95% = 1,96 x error estándar
Aquí tiene un ejemplo ilustrativo, con cifras inventadas y no una medición real. Su marca aparece en 37 de 80 ejecuciones, así que la tasa de visibilidad es del 46%. El error estándar es de 5,6 puntos, lo que da un margen de error al 95% de unos 11 puntos. Presente el resultado como 46% más o menos 11 puntos. Si el siguiente lote muestra un 40%, ese valor cae dentro del rango, y no es una señal para reescribir sus páginas.
Nombrada, recomendada y citada son tres estados distintos
Una marca puede ser nombrada sin enlace, enlazada sin ser recomendada, o recomendada en una frase que nunca nombra a un competidor. Registre estos estados por separado: nombrada y recomendada, solo nombrada y solo citada. Sus proporciones cambian por razones distintas, y cada una exige una solución diferente. Una cita sin mención es un problema de fuentes. Una mención sin recomendación es un problema de posicionamiento.
Su primera hoja de medición
Lista de prompts congelada y fechada, con los nuevos prompts añadidos como filas nuevas
Ejecuciones registradas por modelo de IA, con la fecha y los ajustes usados
Tres estados registrados: nombrada y recomendada, solo nombrada, solo citada
Tasa de visibilidad y margen de error calculados para cada prompt
Nota
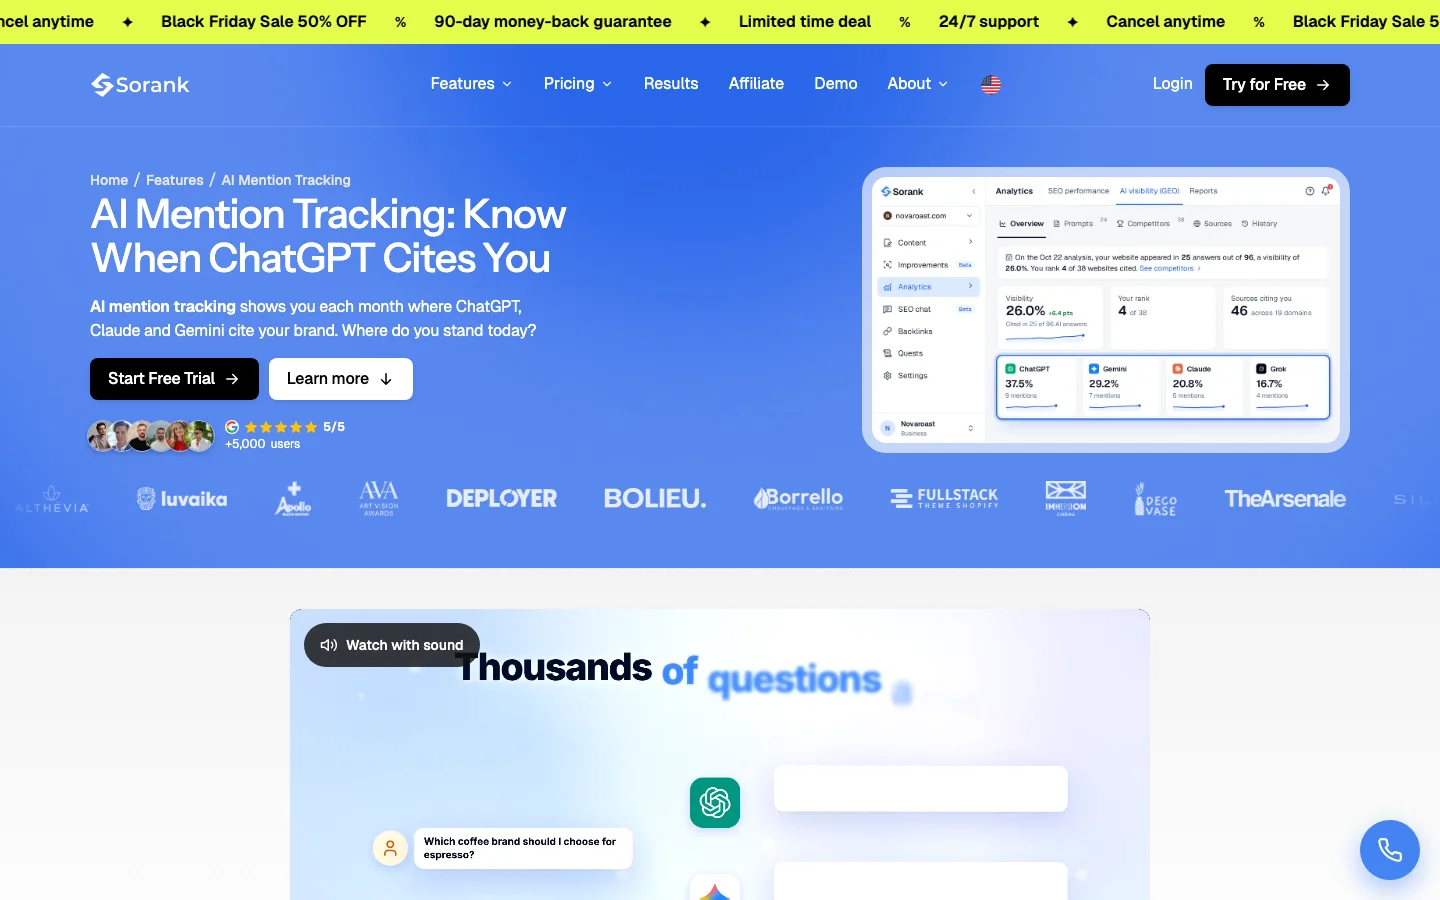
Repetir cada prompt a mano se vuelve tedioso al cabo de unas semanas. El AI Mention Tracking de Sorank indica, para cada prompt que sigue, con qué frecuencia ChatGPT, Claude y Gemini mencionan su marca, junto con las fuentes y las búsquedas detrás de cada respuesta. Su ejecución es mensual, lo que supone una muestra escasa para un solo prompt, así que lea su tendencia a lo largo de varios meses y añada sus propias ejecuciones repetidas para los prompts más importantes.
AI Mention Tracking informa de con qué frecuencia ChatGPT, Claude y Gemini citan su marca.
Informar a quienes pagan por ello
Un informe mensual debe responder a una sola pregunta: ¿se mueve su presencia y es el movimiento mayor que el ruido? Muestre la tasa de visibilidad por grupo de prompts con su margen de error, no una cifra única. Añada la distribución de posiciones, es decir, con qué frecuencia aparece su marca en primer, segundo o inferior lugar en las respuestas donde se nombra, para que el orden se vea como una dispersión y no como un ranking. Que haya oscilaciones alrededor de una tendencia plana o al alza es normal. Una caída constante a lo largo de varios lotes no lo es, y merece revisar los prompts, las notas de versión de los modelos y las fuentes citadas antes de que nadie reescriba una página. Escriba la regla de acción en el propio informe: un cambio solo cuenta como real si supera el margen de error en dos lotes consecutivos.
Cómo hacer su presencia más estable
No puede eliminar la volatilidad, pero sí hacer su presencia más constante. La presencia crece cuando su marca se describe de la misma manera en varias fuentes que los modelos de IA ya utilizan. La documentación de Google marca la base de lo que necesitan sus propias funciones de IA.
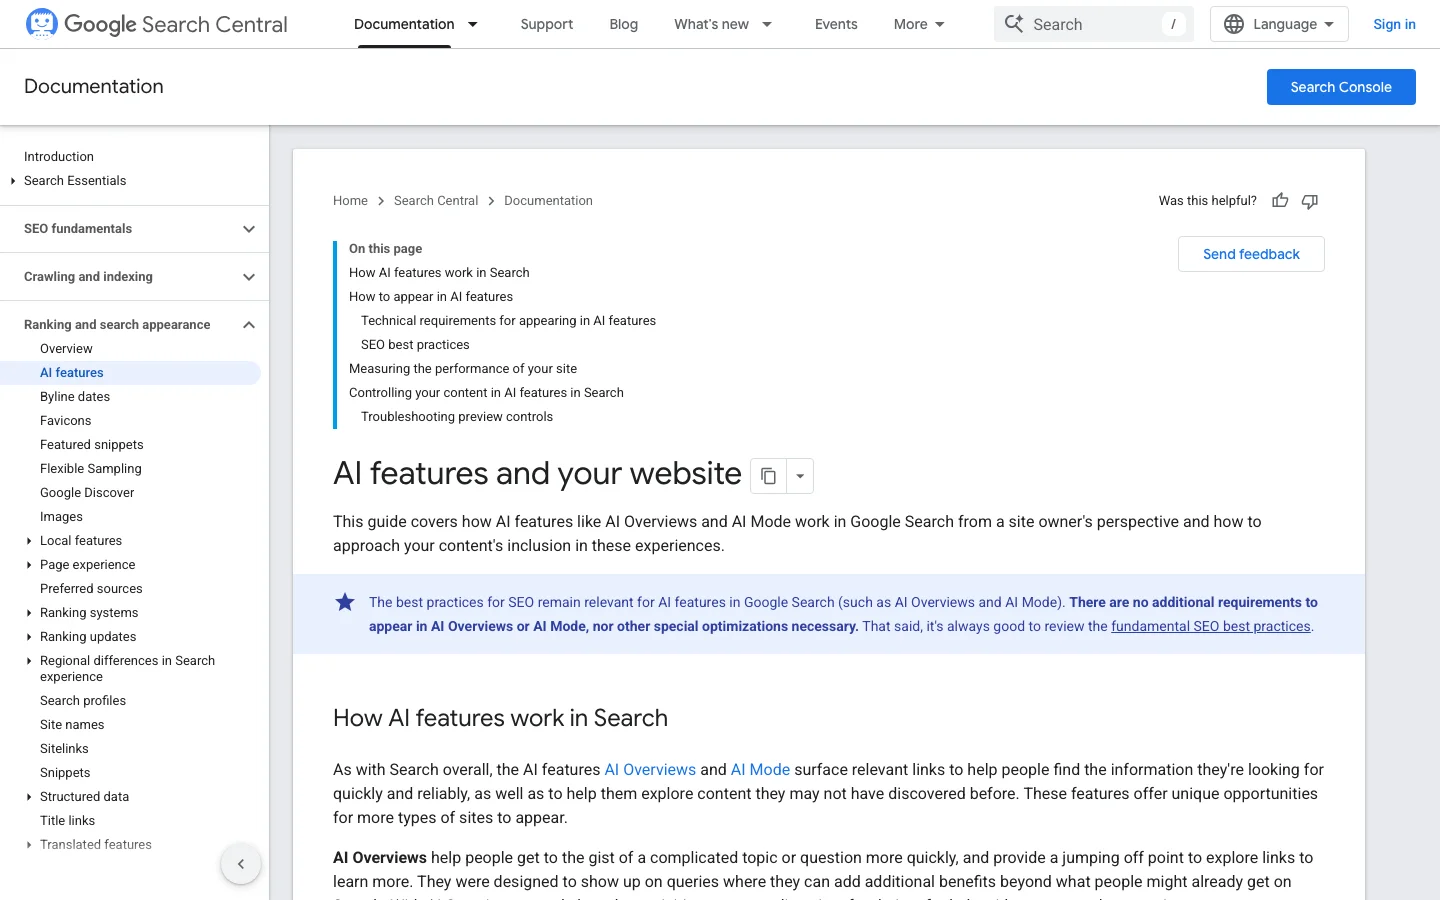
Las indicaciones de Google sobre las AI Overviews y el modo IA son breves. Una página debe estar indexada y ser apta para mostrar un fragmento. Los fundamentos siguen siendo los mismos: reglas de robots.txt que permitan el rastreo, enlaces internos, texto visible para los lectores y datos estructurados que coincidan con el texto visible. Google indica que no hace falta crear archivos nuevos legibles por máquinas, archivos de texto para la IA ni un esquema especial para aparecer.
Las indicaciones de Google sobre las AI Overviews y el modo IA: no es necesaria ninguna optimización especial.
Describa su marca de la misma manera en todas partes
Los modelos de IA construyen la imagen de una marca a partir de muchos lugares a la vez. Si su nombre, su categoría, su caso de uso principal y su ubicación difieren entre su web, sus perfiles y sus directorios, la imagen se difumina y la lista de marcas se vuelve menos estable. Escriba una descripción breve y objetiva de su empresa, con su categoría y sus casos de uso, y reutilícela siempre que pueda controlar el texto. Revísela cada trimestre.
Gane menciones en fuentes que ya son fiables
La corroboración significa que varias fuentes independientes dicen lo mismo sobre usted. Las reseñas, los artículos comparativos, los directorios sectoriales y las publicaciones especializadas de su nicho son los lugares habituales. Consiga estas menciones con trabajo útil, como datos originales, una comparativa de producto clara o una herramienta que la gente use de verdad. No las compre. Los contenidos patrocinados añaden ruido, y ese tipo de patrón se rompe en cuanto se dejan de pagar.
Responda la pregunta principal en cada página clave
Los modelos de IA extraen fragmentos, no páginas enteras. Una página que da una definición breve en el primer párrafo, una respuesta directa a la pregunta principal y un siguiente paso claro es más fácil de extraer y de citar con precisión. Nuestra lista de comprobación GEO enumera los puntos que revisar en cada página.
Lista de comprobación de estabilidad para su marca
Páginas clave indexadas y aptas para mostrar un fragmento
Mismo nombre de marca y misma categoría en cada perfil y directorio
Menciones en varios sitios independientes, no solo en el suyo
Datos estructurados que coinciden con el texto que ve el lector
Una respuesta directa en el primer párrafo de cada página clave
Cuatro formas de responder a la volatilidad
Los equipos responden a la volatilidad de cuatro formas habituales. Cada una tiene un uso y un límite. Léalas como opciones que se pueden combinar, no como un ranking de la mejor. La mayoría de los equipos usan la primera y la última juntas.
Seguir el ranking diario
Principio: consultar un prompt cada día y registrar la posición de su marca en la respuesta. Cuándo usarlo: quiere una alerta temprana rápida cuando una consulta concreta cambia bruscamente. Ventajas: es familiar, barato y fácil de representar. Límites: es una muestra por día, y no puede separar una pérdida real de una variación normal. Ejemplo: un prompt nombra su marca el lunes y el miércoles no. El gráfico muestra una caída, pero una sola ejecución no permite saber si perdió una posición o si es una variación normal.
Seguir la presencia en muchas ejecuciones
Principio: ejecutar muchos prompts muchas veces e informar la proporción de respuestas que nombran su marca, con su margen de error. Cuándo usarlo: necesita una cifra para un informe o para decidir cuánto invertir en contenido. Ventajas: encaja con la forma en que se genera la respuesta y le da un rango en lugar de un falso punto. Límites: cuesta más ejecuciones y exige disciplina para mantener estable el conjunto de prompts. Ejemplo: su tasa de visibilidad es del 46% más o menos 11 puntos en 80 ejecuciones. Al mes siguiente es del 52%. Puede decir que la tendencia sube, pero aún no que sea una ganancia real, así que espera a otro lote.
Construir corroboración entre fuentes
Principio: hacer que las mismas afirmaciones correctas aparezcan en varias fuentes independientes. Cuándo usarlo: su posicionamiento es claro y quiere recomendaciones que se sostengan. Ventajas: ayuda tanto en las respuestas de IA como en la búsqueda tradicional, y el efecto dura. Límites: es lento y rara vez muestra un resultado en un mes. Ejemplo: una empresa de software ve sus casos de uso descritos en dos reseñas, una página comparativa y un directorio sectorial, de modo que los modelos de IA repiten la misma descripción en distintos prompts.
Actualizar las páginas clave con respuestas directas
Principio: actualizar las páginas que responden a sus preguntas principales para que la respuesta sea clara, exacta y fechada. Cuándo usarlo: su página se cita pero se describe mal, o se cita una página de un competidor cuando debería citarse la suya. Ventajas: es rápido de hacer y mejora la extracción de fragmentos. Límites: una página mejor no garantiza una mención, y los cambios tardan en verse en sus datos. Ejemplo: una página de glosario recibe una definición de una frase al principio, una tabla comparativa corta y una nota visible de actualización, y el siguiente lote de medición muestra la descripción correcta.
Método
Qué indica
Estabilidad de la señal
Esfuerzo
Ideal para
Ranking diario
Una posición en un día
Baja
Bajo
Detectar un cambio brusco en una consulta
Presencia en muchas ejecuciones
Proporción de respuestas que nombran su marca
Alta, con margen de error
Medio a alto
Informes y decisiones de presupuesto
Corroboración
Coherencia con la que las fuentes le describen
Alta a lo largo de meses
Alto
Recomendaciones a largo plazo
Actualización de página
Qué tan bien responden sus páginas clave a la pregunta
Media
Medio
Corregir una descripción errónea o inexistente
Herramientas para dos tipos de volatilidad
Los resultados orgánicos de Google y las respuestas de IA necesitan instrumentos distintos. Confundirlos lleva a conclusiones erróneas, así que sepárelos en sus informes.
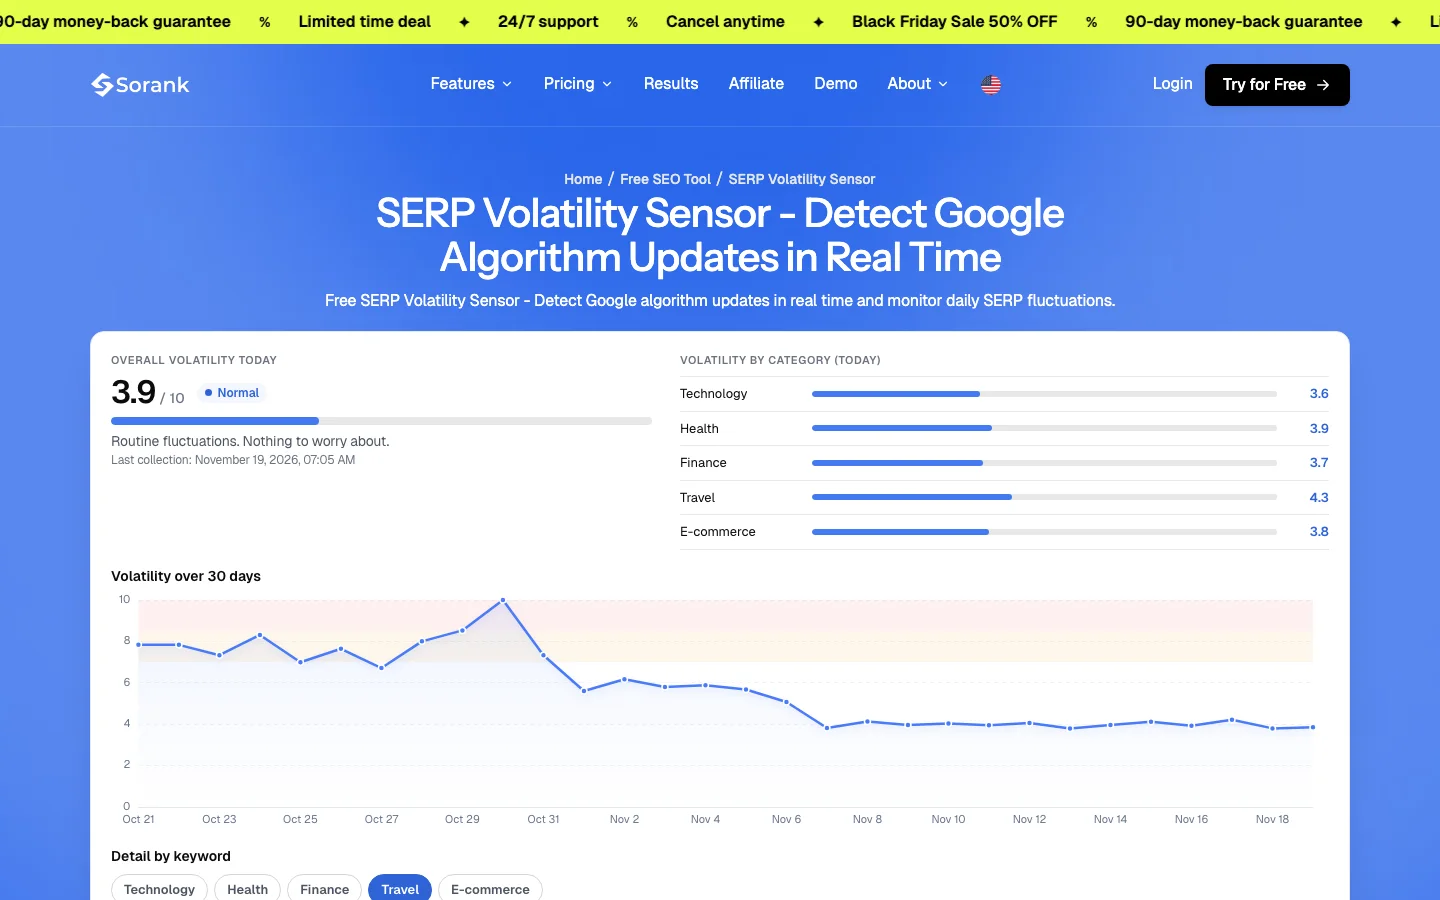
El Sensor de volatilidad SERP gratuito de Sorank cubre el primer tipo. Cada mañana recoge los 10 primeros resultados orgánicos de 20 palabras clave en inglés de Estados Unidos, repartidas en cinco sectores, los compara con el día anterior y da una puntuación de 0 a 10, global y por sector. Muestra cuánto se ha movido la primera página de Google, lo que lo convierte en una señal temprana útil para los cambios de algoritmo. No mide las respuestas de IA, así que no sustituye al método basado en prompts de arriba. Para la parte de Google de la cuestión, lea el sensor en su propia página, y guárdelo junto a sus datos de ranking, no junto a sus cifras de visibilidad en IA.
El Sensor de volatilidad SERP gratuito sigue los resultados orgánicos de Google, no las respuestas de IA.
Search Console y Google Analytics informan de los clics de Google y de las visitas por referencia. Un rastreador de posiciones informa de las posiciones en Google. Ninguno muestra qué respuestas de IA han nombrado su marca. Para eso necesita respuestas registradas o una herramienta que las registre. Para las visitas que llegan desde modelos de IA, la parte de referencias está cubierta en nuestra guía de informes GEO.
Errores comunes y cómo corregirlos
La mayoría de los errores de volatilidad vienen de leer el ruido como si fuera una señal. Cada error de abajo muestra cómo se ve, cómo detectarlo en sus datos y cómo corregirlo.
Informar de una sola ejecución como resultado
Qué es: una captura o una única respuesta presentada como su posición. Cómo detectarlo: el informe muestra una posición sin tamaño de muestra, sin periodo y sin margen de error. Cómo corregirlo: informe la tasa de visibilidad sobre al menos 30 ejecuciones por prompt, con el margen de error y el periodo.
Cambiar los prompts entre dos comprobaciones
Qué es: reformular un prompt entre dos comprobaciones, por ejemplo «mejor CRM» una semana y «mejor CRM para startups» la siguiente, y leer después el resultado como una tendencia. Cómo detectarlo: el texto del prompt en la hoja difiere entre dos fechas en la misma fila. Cómo corregirlo: congele el conjunto de prompts y versiónelo. Añada un prompt nuevo como fila nueva y nunca edite uno antiguo.
Reaccionar a movimientos dentro del margen de error
Qué es: reescribir una página tras una caída de cinco puntos. Cómo detectarlo: el cambio es menor que el margen de error de ese prompt. Cómo corregirlo: actúe solo cuando un cambio supere el margen de error durante dos lotes seguidos, y anote qué más cambió en el mismo periodo, como una actualización de modelo o el lanzamiento de un competidor.
Contar una cita como una recomendación
Qué es: registrar cada enlace a su sitio como una victoria, aunque la respuesta presente su marca como una opción a evitar o como una nota al pie. Cómo detectarlo: nadie lee la frase que rodea la cita. Cómo corregirlo: registre los tres estados por separado (nombrada y recomendada, solo nombrada, solo citada) y lea la frase antes de marcar la casilla.
Seguir prompts que nadie escribe
Qué es: prompts redactados por el equipo de marketing para un informe. Cómo detectarlo: los prompts usan nombres internos de producto o jerga que los clientes nunca emplean. Cómo corregirlo: tome los prompts de llamadas comerciales, conversaciones de soporte y consultas de Search Console, y compruebe algunos con clientes reales.
Esperar que la visibilidad en IA genere clics por sí sola
Qué es: suponer que una tasa de visibilidad mayor traerá más visitas automáticamente. Cómo detectarlo: la tasa de visibilidad sube mientras las sesiones por referencia se mantienen planas. Cómo corregirlo: mida las visitas por referencia por separado, compruebe qué modelos de IA y qué páginas las envían, y una los dos conjuntos de datos en un único informe mensual.
Añadir archivos específicos de IA para perseguir respuestas de IA
Qué es: lanzar un proyecto de archivo de texto para la IA o de nuevo marcado, esperando que eso provoque citas. Cómo detectarlo: el proyecto no comprueba la indexación ni la elegibilidad para mostrar fragmentos. Cómo corregirlo: empiece por las indicaciones de Google. Confirme que las páginas clave están indexadas y son aptas para mostrar un fragmento, y después corrija antes que nada el texto y los enlaces internos.
Error
Señal en sus datos
Corrección
Una ejecución informada como resultado
Sin tamaño de muestra ni margen de error
Informar una proporción sobre al menos 30 ejecuciones
Prompts editados entre comprobaciones
Misma fila, texto distinto, fechas distintas
Congelar y versionar el conjunto de prompts
Reaccionar dentro del margen de error
Cambio menor que el margen
Actuar solo sobre cambios que persisten en dos lotes
Cita contada como recomendación
Nadie lee la frase que la rodea
Registrar los tres estados por separado
Prompts que nadie escribe
Jerga interna en la lista de prompts
Tomar los prompts del lenguaje real de los clientes
Visibilidad tratada como tráfico
Visibilidad al alza, referencias planas
Medir las referencias por separado
Qué hacer esta semana
No necesita un programa completo para empezar. La primera semana sirve para montar la medición de forma que los seis meses siguientes se puedan leer. Siga estos pasos en orden.
Su primera semana
Elija 20 promptsTómelos del lenguaje real de sus clientes y congele la lista con una fecha.
Ejecute cada prompt 30 vecesUse los modelos de IA que usan sus compradores y registre los tres estados de cada respuesta.
Calcule la tasa de visibilidadObtenga la tasa y su margen de error para cada prompt, y escriba después una frase por prompt que diga qué muestra.
Compare sus páginas claveCompárelas con las descripciones que da la IA y anote cada afirmación errónea o que falte.
Programe el siguiente loteEjecútelo dos semanas después, para comparar los mismos prompts con un ritmo constante.
Una vez que tenga una referencia, la volatilidad deja de ser una fuente de inquietud. Pasa a ser un rango que puede medir y un conjunto de cambios con los que puede contar.
Preguntas frecuentes
¿Por qué ChatGPT da respuestas distintas a la misma pregunta?
Los modelos de lenguaje eligen cada palabra a partir de una distribución de probabilidades, así que el mismo prompt puede producir otra redacción, otra lista de marcas u otro orden. La recuperación también cambia, porque el modelo de IA reformula la pregunta en subconsultas y las páginas que recupera pueden variar de una ejecución a otra.
¿Cuánto cambian las respuestas de la búsqueda con IA con el tiempo?
Authoritas midió para las AI Overviews una puntuación de volatilidad de 0,68 a las 8 semanas y de 0,73 a las 13 semanas, frente a 0,49 y 0,55 en los resultados orgánicos. SparkToro halló menos de un 1% de probabilidades de que ChatGPT o la IA de Google devuelva dos veces la misma lista de marcas.
¿Sigue mereciendo la pena medir el ranking en la búsqueda con IA?
Una posición aislada en una respuesta de IA es demasiado inestable para actuar sobre ella. Mida con qué frecuencia aparece su marca en muchos prompts y ejecuciones, informe esa proporción en porcentaje con su margen de error y mantenga el seguimiento clásico de posiciones para los resultados orgánicos de Google, donde las posiciones se mueven más despacio.
y!
Consiga gratis su plan de contenidos para 30 días
Analizamos a sus competidores, su sitio web y su visibilidad en las IA para crear gratis un plan de contenidos a medida.
“He probado Sorank en el sitio real de un cliente y es una locura. Hace todo aquello por lo que una agencia cobra 1.500 € al mes. Ahora se pone en producción en ese cliente.”Guillaume Guersanguersanguillaume.com
“Somos una agencia de publicidad y queríamos poner en marcha nuestro SEO de una vez por todas. Sorank nos dio una visión clara de nuestro sitio, nos ayudó a priorizar las optimizaciones y a estructurar correctamente nuestro contenido. La herramienta es fácil de usar, bien diseñada para un equipo y muy práctica para centralizar el seguimiento sin tener que hacer malabares entre varias plataformas. Una base muy sólida para empezar de nuevo con nuestro SEO.”Gaspard MadouiAgencia de Publicidad
“Me especialicé en GEO gracias a Sorank. El GEO Leaderboard me permite mostrar a mis clientes su posicionamiento frente a sus competidores en ChatGPT. Es un verdadero diferenciador comercial.”MélanieFreelancer SEO
“Excelente servicio, funciona bien para nuestro sitio web y nos ayuda a entender cómo mejorarlo para posicionarnos mejor en Google y en otros lugares. Felicitaciones, continúen así, se lo recomiendo.”Hugo T.Comerciante e-commerce