Innstillinger
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon
Personvern er viktig for oss, så du kan velge å slå av enkelte typer lagring som ikke er nødvendig for at nettstedet skal fungere grunnleggende. Blokkering av kategorier kan påvirke opplevelsen din på nettstedet. Mer informasjon

Hvorfor AI-svar endrer seg ved hver kjøring, hvor mye de beveger seg, og hvordan du måler merkevarens tilstedeværelse over mange prompter i stedet for én rangering.

Verktøy

In short
AI-søkevolatilitet er hvor mye merkevarene, nettadressene og rekkefølgen i et AI-svar endrer seg fra én kjøring til neste, og fra én uke til den neste. Det samme spørsmålet kan gi en annen merkevareliste, andre kilder og en annen rekkefølge, fordi svaret genereres med tilfeldighet, og hentesteget endrer seg også. En plassering inne i et AI-svar er derfor en dårlig måleenhet. Mål hvor ofte merkevaren din dukker opp på tvers av mange prompter og mange kjøringer, og bygg deretter de kildene som gjør tilstedeværelsen din stabil.
Vil du vite mer? Spør
Rask quiz
Hvordan får du omtale fra ChatGPT og andre AI-assistenter?
Sorank passer til svarene dine


Prøv det i 3 dager på ditt eget nettsted, og se hvor du står på Google, ChatGPT og de andre AI-assistentene.
Start en gratis prøveperiode på 3 dager3 dager gratis, deretter kan du stoppe når du vil. 90 dagers resultatgaranti, vilkår gjelder.
I det organiske Google-søket betyr volatilitet at plasseringen din for et søkeord går opp og ned. I AI-søk er det mer enn som så. Selve svaret er ulikt ved hver kjøring. Et volatilt AI-svar kan endre seg på tre måter: hvilke merkevarer det nevner, hvilke nettadresser det siterer, og i hvilken rekkefølge de står. Ethvert av disse kan flytte seg uten én eneste endring på nettstedet ditt.
Forskjellen betyr noe fordi en rangering er et fast resultat for et gitt øyeblikk. Google returnerer en ordnet liste, og for samme søk i samme marked er den listen stort sett repeterbar. En AI-modell returnerer ett utvalg fra et spekter av mulige svar. Merkevaren din har en sannsynlighet for å dukke opp i det spekteret. Den sannsynligheten er det du kan måle, og det er den du kan flytte.
To tall fra en studie publisert i 2026 viser hvor sterk effekten er. Rand Fishkin fra SparkToro jobbet med Patrick O'Donnell fra Gumshoe.ai. Omtrent 600 frivillige kjørte 12 prompter gjennom ChatGPT, Claude og Googles AI, til sammen 2961 kjøringer. Forskerne fant under 1 sjanse av 100 for at ChatGPT eller Googles AI returnerer samme merkevareliste to ganger. Sjansen for samme merkevareliste i samme rekkefølge var omtrent 1 av 1000 kjøringer. SparkToro-rapporten, datert 28. januar 2026, dekker data samlet inn i november og desember 2025.
Hvor stabile er AI-ens merkevarelister?
Kilde: SparkToro og Gumshoe.ai, januar 2026
Når du godtar at resultatet er et utvalg, må måten du følger det på endres. Sammenligningen under oppsummerer de to tankesettene. Den er kjerneideen i hele denne guiden.
Å følge en rangering mot å følge tilstedeværelse
Den mest synlige endringen er selve merkevarelisten. En prompt som "beste prosjektstyringsverktøy for et team på 10 personer" kan nevne fem merkevarer i én kjøring og fem andre i den neste. Noen merkevarer kommer igjen ofte, andre kommer og går. Tilstedeværelse i settet er stabilere enn plasseringen i settet, og det er grunnen til at forskerne anbefaler å følge tilstedeværelse i stedet for rangering.
Det har en praktisk konsekvens. Hvis du sjekker en prompt én gang og ser merkevaren din på andre plass, vet du nesten ingenting. Hvis du sjekker den 60 ganger og ser merkevaren din i 40 av svarene, vet du noe nyttig: du er et fast valg for det spørsmålet.
Siteringer er lenkene en AI-modell viser som kilder. De beveger seg enda mer enn merkevarelisten når modellen gjør et livesøk på nettet, fordi hver kjøring kan hente et annet sett med sider. En sitering som forsvinner er ikke alltid et tap. Merkevaren din kan fortsatt være nevnt i teksten uten lenke. Derfor bør du følge to ting hver for seg: den navngitte omtalen og den siterte nettadressen.
Plasseringen inne i et svar er det minst stabile elementet. En AI-modell kan liste merkevaren din først i én kjøring og fjerde i den neste, uten reell endring i hvordan den ser på deg. Behandle rekkefølgen som støy med mindre den beveger seg i samme retning over dusinvis av kjøringer.
Tre mekanismer står for det meste av endringen. Du kan ikke slå dem av, men å kjenne til dem forteller deg hva du skal måle og hva du kan ignorere.
En språkmodell velger ikke ett beste svar. Den velger hvert neste ord fra en sannsynlighetsfordeling. En innstilling som kalles temperatur styrer hvor bredt valget er. Ved en lav verdi er resultatet nærmere repeterbart, og ved en høy verdi varierer det mer. Utviklere kan sette temperatur i et API, men forbrukerappene de fleste kjøperne dine bruker, viser ikke den. Anta at utvalg alltid er på. Frivillige i SparkToro-studien beholdt sine vanlige innstillinger, personlige eller standard, og derfor beskriver resultatene deres hva en vanlig bruker ser.
Når en AI-modell søker på nettet, sender den ikke det nøyaktige spørsmålet ditt til en søkemotor. Den skriver spørsmålet om til flere delspørsmål og henter sider for hvert av dem. En liten endring i formuleringen, en side indeksert den morgenen eller et annet resultat for ett delspørsmål kan endre hvilke kilder som når det endelige svaret. Nettadressene du siteres fra, er resultatet av et hentesteg som beveger seg. Guiden vår om hvordan AI-modeller velger kilder forklarer mekanismene, og Sorank sitt verktøy for det AI faktisk søker etter er laget nettopp for det spørsmålet.
Leverandører oppdaterer modeller og systemene rundt dem uten mye varsel. En ny modellversjon, en endring i når en AI-modell bestemmer seg for å søke, eller et skifte i nettindeksen kan endre svarene for et helt emne på én dag. Når dataene dine viser et plutselig sprang, sjekk først etter en sannsynlig oppdatering, og sammenlign deretter med utgangspunktet ditt før du reagerer.
| Mekanisme | Hva som beveger seg | Slik viser det seg | Hva du gjør |
|---|---|---|---|
| Trekking av svar | Merkevareliste, formulering og rekkefølge | Ulike svar på samme prompt samme dag | Mål over mange kjøringer og rapporter en andel |
| Henting | Siterte nettadresser | Ulike kilder siteres fra én uke til den neste | Styrk sidene og tredjepartskildene som henter godt |
| Oppdateringer av modell og indeks | Hele svarstilen og hvilke merkevarer som favoriseres | Et sprang på en bestemt dato | Behold et utgangspunkt og noter hver oppdatering du kan identifisere |
Målte tall er fortsatt sjeldne, og de fleste kommer fra leverandører av SEO og AI-synlighet. To kilder er verdt å lese nøye. Den første er en studie fra SEO-plattformen Authoritas, som sammenlignet AI-oversikter med organiske resultater. Den andre er målinger fra BrightEdge, som sammenlignet AI-oversikter med AI-modus.
Authoritas målte rangeringsvolatilitet med en poengsum. Jo høyere poengsum, desto mer endret resultatene seg i perioden. For AI-oversikter var poengsummen 0,68 etter 8 uker og 0,73 etter 13 uker. For organiske resultater var den 0,49 og 0,55. Digital Information World, som omtalte studien i februar 2025, skrev også at omtrent 70 % av resultatene i AI-oversikten endret seg i løpet av to til tre måneder. Artikkelen oppga ikke søkeordutvalget eller målingsdatoene, så sjekk den opprinnelige Authoritas-rapporten før du siterer et tall i en kundepresentasjon.
AI-oversiktsresultater som endret seg i løpet av 2 til 3 måneder
Kilde: Authoritas-studie, omtalt av Digital Information World, februar 2025
BrightEdge målte det samme spørsmålet fra en annen vinkel. Deres analyse fra august 2025 fant 16,7 % mer volatilitet i merkevareomtaler for AI-oversikter enn for AI-modus. Den fant også at AI-oversikter beholdt 24 % av nettadressene sine uendret, mot 20 % for AI-modus. Tabellen setter tallene side om side.
| Mål | AI-oversikter | Sammenligning | Kilde |
|---|---|---|---|
| Volatilitetspoengsum, 8 uker | 0,68 | 0,49 for organiske resultater | Authoritas |
| Volatilitetspoengsum, 13 uker | 0,73 | 0,55 for organiske resultater | Authoritas |
| Volatilitet i merkevareomtaler | 16,7 % høyere | Sammenlignet med AI-modus | BrightEdge, august 2025 |
| Uendrede nettadresser | 24 % | 20 % for AI-modus | BrightEdge, august 2025 |
AI-oversikter vises inne i den vanlige Google-resultatsiden for et utvalg søk. AI-modus er et eget grensesnitt i samtaleform. BrightEdge-tallene tyder på at AI-oversikter svinger mer i hvilke merkevarer de nevner, mens AI-modus holder færre av nettadressene sine stabile. Den praktiske lærdommen er å sjekke hver flate for seg. Et enkelt «Google AI»-tall skjuler forskjellen, og det er nettopp forskjellen du må planlegge rundt. Vår sammenligning av Google AI-modus og AI-oversikter dekker hva hver av dem betyr for SEO.
Poenget er at du ikke kan anta at organisk stabilitet følger med. Organiske resultater er mindre volatile enn AI-oversikter i Authoritas-dataene, men de står ikke stille. En side som holder plass 3 i en måned kan likevel falle etter en kjerneoppdatering, så du trenger en metode som skiller reell endring fra vanlig bevegelse på begge flatene.
De fleste rangeringsverktøy ble bygget for Google, der et søkeord har én ordnet liste som endrer seg sakte. Brukt på en AI-modell gir den samme logikken et tall basert på ett enkelt utvalg. Hvis merkevaren din er tredje i én kjøring og åttende i den neste, forteller et gjennomsnitt av de to nesten ingenting. Et verktøy som rapporterer «du er nummer 3 i ChatGPT», presenterer ett enkelt trekk som et faktum. Vår guide til rangeringssporing dekker den klassiske metoden, og denne artikkelen forklarer hva som endrer seg når svaret genereres i stedet for å listes.
Konklusjonen fra SparkToro er at rangeringsprodukter basert på faste plasseringer måler støy. Rådet fra studien er å følge tilstedeværelse i stedet for rangering. Den kaller en synlighetsprosent en fornuftig måling når den måles over dusinvis til hundrevis av prompter, der hver kjøres flere ganger. Be enhver leverandør om å vise utvalgsstørrelsen og metoden bak en poengsum før du stoler på den.
Én prompt, ett skjermbilde mot en målt andel
Googles egen dokumentasjon peker i samme retning, av en annen grunn. Google sier at en side må være indeksert og kvalifisert til å vises i søk med et utdrag for å brukes i AI-oversikter eller AI-modus. Den sier også at det ikke finnes noen spesiell markup eller AI-spesifikk fil å legge til. Det finnes ingen innstilling for «AI-rangering» å optimalisere, så arbeidet består i å være til stede og tiltrodd på tvers av mange kilder, og å måle den tilstedeværelsen ærlig.
Metoden under tar noen dager å sette opp og noen minutter i uken å vedlikeholde. Du kan kjøre den i et regneark. Dedikerte verktøy sparer deg mest for repetisjon, ikke for tenkingen.
Målemetoden i fem steg
Synlighetsraten er andelen svar som nevner merkevaren din. Feilmarginen forteller hvor mye av en endring som er reell. Bruk en feilmargin på 95 % basert på standardfeilen til en andel:
synlighetsrate = svar som nevner merkevaren din / alle svar
standardfeil = kvadratroten av (p x (1 - p) / n)     der p er synlighetsraten og n antall kjøringer
feilmargin på 95 % = 1,96 x standardfeil
Her er et illustrerende eksempel med oppdiktede tall, ikke en måling. Merkevaren din dukker opp i 37 av 80 kjøringer, så synlighetsraten er 46 %. Standardfeilen er 5,6 prosentpoeng, noe som gir en feilmargin på 95 % på omtrent 11 prosentpoeng. Rapporter resultatet som 46 % pluss eller minus 11 prosentpoeng. Hvis neste batch viser 40 %, ligger det innenfor intervallet, og det er ikke et signal om å skrive om sidene dine.
En merkevare kan nevnes uten lenke, lenkes uten å bli anbefalt, eller anbefales i en setning som aldri nevner en konkurrent. Logg disse tilstandene hver for seg: nevnt og anbefalt, bare nevnt og bare sitert. Andelene deres beveger seg av ulike grunner, og hver krever en annen løsning. En sitering uten omtale er et kildeproblem. En omtale uten anbefaling er et posisjoneringsproblem.
Ditt første målearket
Merk
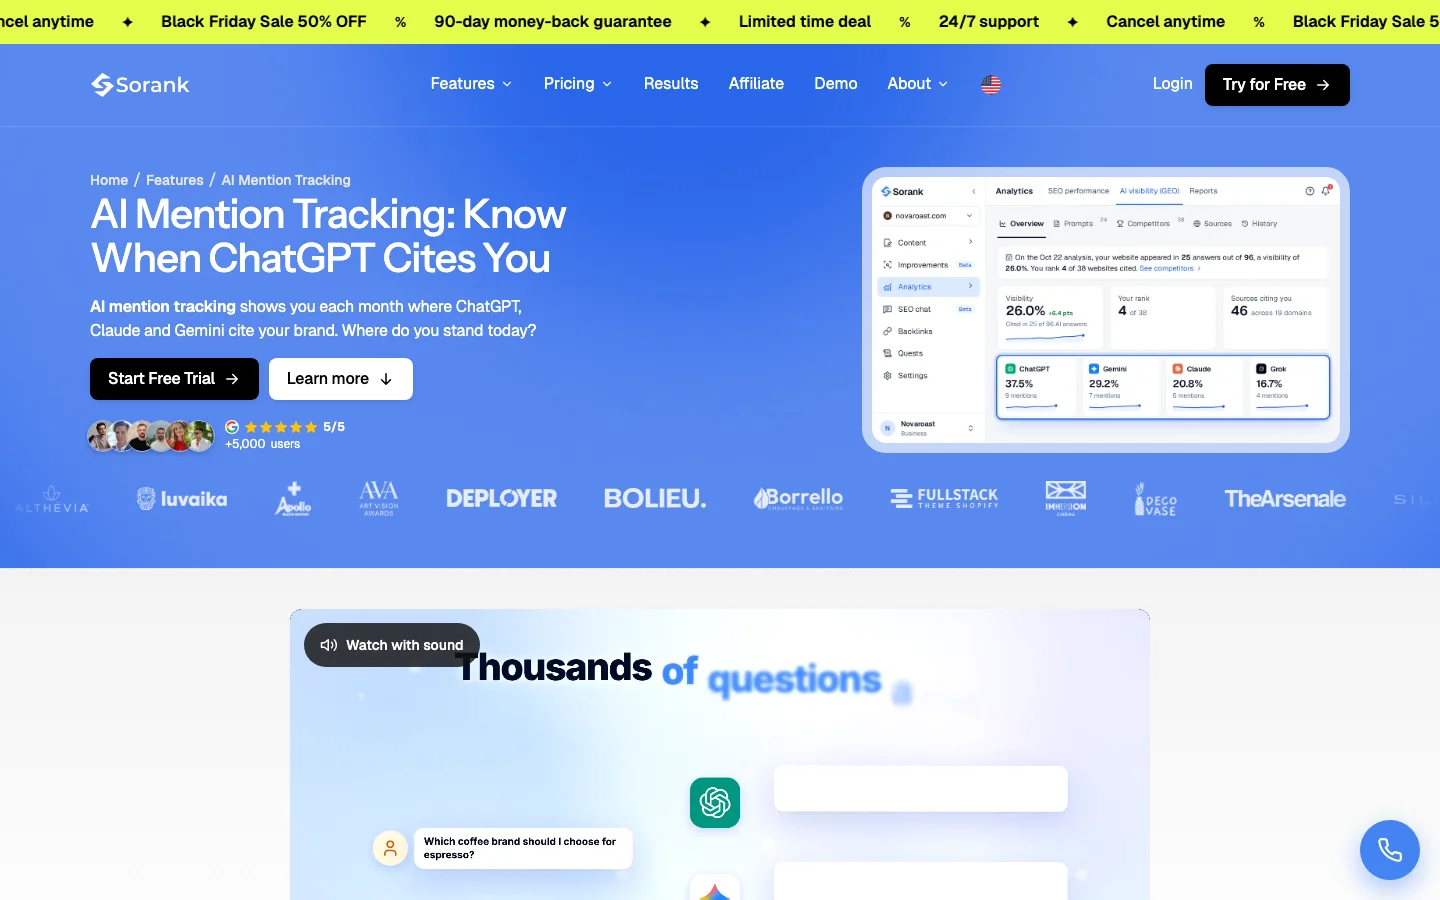
Å gjenta hver prompt for hånd blir slitsomt etter noen uker. Sorank sin AI Mention Tracking viser for hver prompt du følger, hvor ofte ChatGPT, Claude og Gemini nevner merkevaren din, med kildene og søkene bak hvert svar. Kjøringen er månedlig, noe som er et tynt utvalg for én prompt, så les trenden over flere måneder, og legg til egne gjentatte kjøringer for de promptene som betyr mest.
En månedlig rapport bør svare på ett spørsmål: beveger tilstedeværelsen din seg, og er bevegelsen større enn støyen? Vis synlighetsraten per promptgruppe med feilmarginen, ikke ett enkelt tall. Legg til plasseringsfordelingen, altså hvor ofte merkevaren din står først, andre eller lavere i svarene der den nevnes, slik at rekkefølgen vises som en spredning i stedet for en rangering. At den svinger rundt en flat eller stigende trend er normalt. Et jevnt fall over flere batcher er ikke normalt, og det fortjener en sjekk av promptene, modellens versjonsnotater og de siterte kildene før noen skriver om en side. Skriv handlingsregelen inn i selve rapporten: en endring teller bare som reell når den passerer feilmarginen i to batcher på rad.
Du kan ikke slå av volatilitet, men du kan gjøre tilstedeværelsen din mer konsistent. Tilstedeværelse vokser når merkevaren din beskrives likt på flere kilder som AI-modeller allerede bruker. Googles dokumentasjon gir utgangspunktet for hva dets egne AI-funksjoner krever.
Googles veiledning om AI-oversikter og AI-modus er kort. En side må være indeksert og kvalifisert til å vise et utdrag. Grunnleggende prinsipper gjelder fortsatt: robots.txt-regler som tillater crawling, interne lenker, tekstinnhold som leserne kan se, og strukturerte data som stemmer med den synlige teksten. Google sier at du ikke trenger nye maskinlesbare filer, AI-tekstfiler eller spesielt skjema for å dukke opp.
AI-modeller bygger et bilde av en merkevare fra mange steder samtidig. Hvis navnet, kategorien, hovedbruksområdet og plasseringen din avviker mellom nettstedet, profilene og katalogoppføringene, blir bildet utydelig, og merkevarelisten blir mindre stabil. Skriv én kort, faktabasert beskrivelse av selskapet, med kategori og bruksområder, og gjenbruk den der du kan styre teksten. Kontroller den hvert kvartal.
Korroborering betyr at flere uavhengige kilder sier det samme om deg. Anmeldelser, sammenligningsartikler, bransjekataloger og fagpublikasjoner i din nisje er de vanlige stedene. Tjen disse omtalene gjennom nyttig arbeid, som originale data, en tydelig produktsammenligning eller et verktøy folk faktisk bruker. Ikke kjøp dem. Betalte plasseringer legger til støy, og det er den typen mønster som brytes så snart betalingene stopper.
AI-modeller henter ut avsnitt, ikke hele sider. En side som gir en kort definisjon i første avsnitt, et direkte svar på hovedspørsmålet og et klart neste steg, er lettere å hente ut og lettere å sitere riktig. Vår GEO-sjekkliste lister opp hva du skal kontrollere på hver side.
Sjekkliste for merkevarens stabilitet
Team reagerer på volatilitet på fire vanlige måter. Hver har en bruk og en begrensning. Les dem som alternativer du kan kombinere, ikke som en rangering av den beste. De fleste team ender opp med å bruke den første og den siste sammen.
Prinsipp: spør én prompt hver dag og registrer plasseringen til merkevaren din i svaret. Når du bruker det: du vil ha et raskt tidlig varsel når ett bestemt søk endrer seg kraftig. Fordeler: det er kjent, billig og enkelt å tegne i et diagram. Begrensninger: det er ett utvalg per dag, og det kan ikke skille et reelt tap fra en vanlig tilfeldig variasjon. Eksempel: en prompt nevner merkevaren din på mandag, men ikke på onsdag. Diagrammet viser et fall, men én enkelt kjøring kan ikke si om det er en tapt plassering eller vanlig variasjon.
Prinsipp: kjør mange prompter mange ganger og rapporter andelen svar som nevner merkevaren din, med feilmargin. Når du bruker det: du trenger et tall til rapportering eller en beslutning om innholdsinvesteringer. Fordeler: det samsvarer med hvordan resultatet genereres, og gir et intervall i stedet for et falskt punkt. Begrensninger: det koster flere kjøringer, og det krever disiplin for å holde promptsettet stabilt. Eksempel: synlighetsraten din er 46 % pluss eller minus 11 prosentpoeng over 80 kjøringer. Neste måned er den 52 %. Du kan si at trenden er opp, men du kan ikke si at det er en reell gevinst ennå, så du venter på en ny batch.
Prinsipp: få de samme korrekte påstandene til å dukke opp på flere uavhengige kilder. Når du bruker det: posisjoneringen din er klar, og du vil ha anbefalinger som holder. Fordeler: det hjelper i AI-svar og i tradisjonelt søk, og effekten varer. Begrensninger: det er tregt, og det viser sjelden et resultat innen én måned. Eksempel: et programvareselskap får bruksområdene sine beskrevet i to anmeldelser, en sammenligningsside og en bransjekatalog, slik at AI-modeller gjentar samme beskrivelse på tvers av ulike prompter.
Prinsipp: oppdater sidene som besvarer hovedspørsmålene dine, slik at svaret er tydelig, korrekt og datert. Når du bruker det: siden din siteres, men beskrives feil, eller en konkurrents side siteres der din burde stå. Fordeler: det er raskt å gjøre og forbedrer hvordan avsnitt hentes ut. Begrensninger: en bedre side garanterer ikke en omtale, og endringer tar tid å vise seg i dataene dine. Eksempel: en ordlisteside får en definisjon på én setning øverst, en kort sammenligningstabell og en synlig oppdateringsnotis, og neste målebatch viser riktig beskrivelse.
| Metode | Hva den viser | Stabilitet i signalet | Innsats | Best for |
|---|---|---|---|---|
| Daglig rangering | Én plassering én dag | Lav | Lav | Å oppdage et kraftig skifte på ett søk |
| Tilstedeværelse over kjøringer | Andel svar som nevner merkevaren din | Høy, med feilmargin | Middels til høy | Rapportering og budsjettbeslutninger |
| Korroborering | Hvor konsekvent kildene beskriver deg | Høy over måneder | Høy | Langsiktige anbefalinger |
| Oppdatering av side | Hvor godt nøkkelsidene dine besvarer spørsmålet | Middels | Middels | Å rette en feil eller manglende beskrivelse |
Organiske Google-resultater og AI-svar krever ulike instrumenter. Blander du dem sammen, trekker du feil konklusjoner, så hold dem adskilt i rapporteringen.
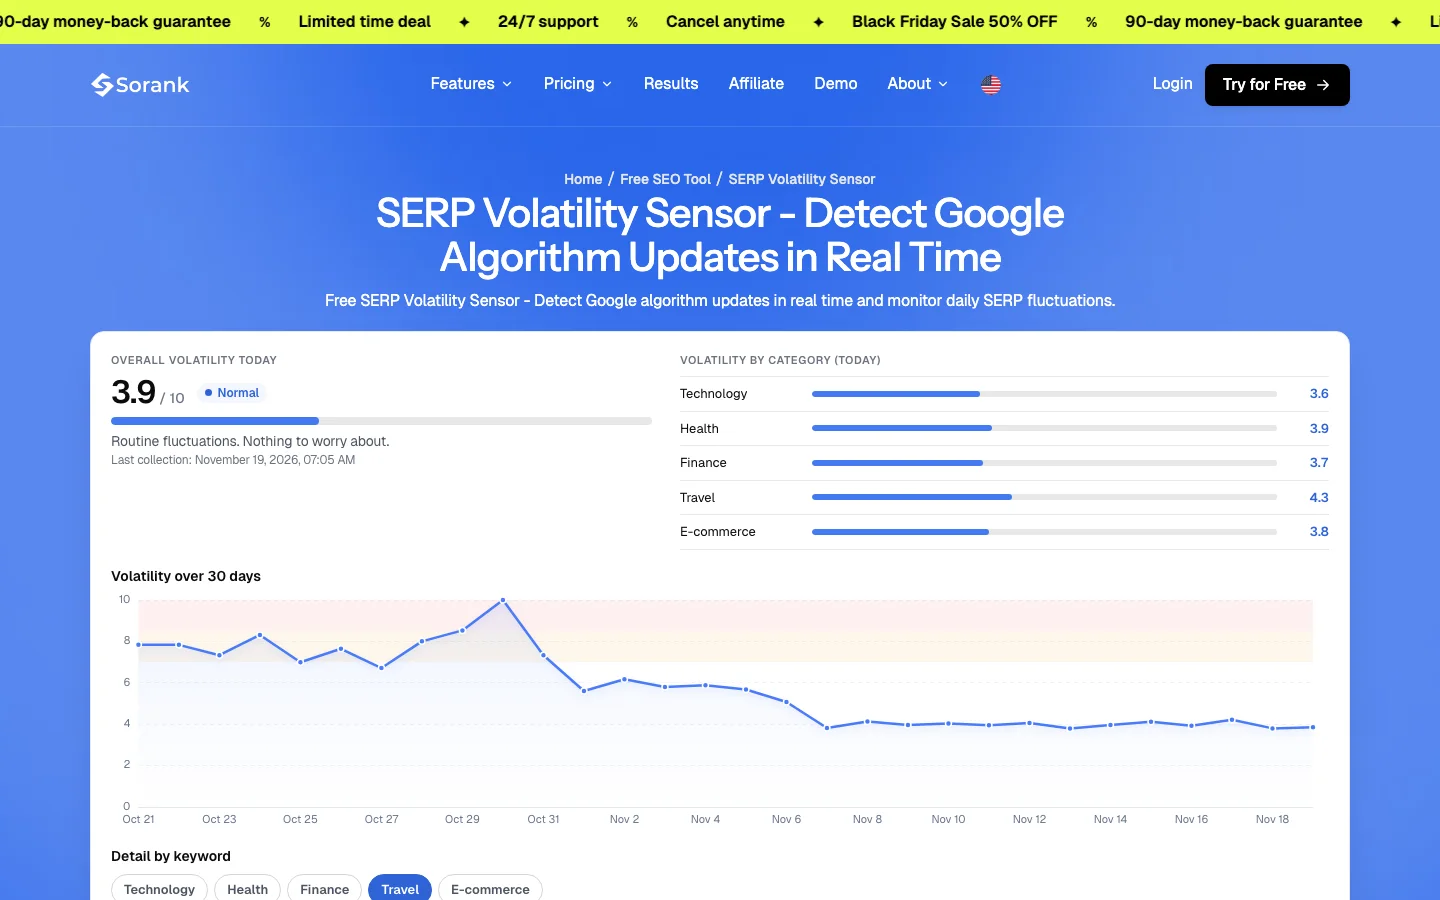
Sorank sin gratis SERP Volatility Sensor dekker den første typen. Hver morgen samler den inn de ti øverste organiske resultatene for 20 engelskspråklige søkeord i USA på tvers av fem bransjer, sammenligner dem med dagen før og gir en poengsum fra 0 til 10, samlet og per bransje. Den viser hvor mye første side på Google beveget seg, noe som gjør den til et nyttig tidlig signal for algoritmeendringer. Den måler ikke AI-svar, så den erstatter ikke den promptbaserte metoden ovenfor. For Google-siden av spørsmålet, les sensoren på sin egen side, og hold den ved siden av rangeringsdataene dine i stedet for ved siden av AI-synlighetstallene.
Search Console og Google Analytics rapporterer Google-klikk og henvisningsbesøk. Et rangeringsverktøy rapporterer plasseringer på Google. Ingen av dem viser hvilke AI-svar som nevnte merkevaren din. For det trenger du logget svar eller et verktøy som logger dem. For besøk som kommer fra AI-modeller, dekkes henvisningsdelen i vår guide til GEO-rapportering.
De fleste volatilitetsfeil kommer av at støy leses som signal. Hver feil under viser hvordan den ser ut, hvordan du oppdager den i dataene dine, og hvordan du retter den.
Hva det er: ett skjermbilde eller ett svar presentert som plasseringen din. Slik oppdager du det: rapporten viser en plassering uten utvalgsstørrelse, datointervall eller feilmargin. Slik retter du det: rapporter synlighetsraten over minst 30 kjøringer per prompt, med feilmargin og datointervall.
Hva det er: å omformulere en prompt mellom to kontroller, for eksempel «beste CRM» én uke og «beste CRM for oppstartsselskaper» den neste, og så lese resultatet som en trend. Slik oppdager du det: promptteksten i regnearket er ulik mellom to datoer for samme rad. Slik retter du det: frys promptsettet og versjonskontroller det. Legg til en ny prompt som en ny rad, og rediger aldri en gammel.
Hva det er: å skrive om en side etter et fall på fem prosentpoeng. Slik oppdager du det: endringen er mindre enn feilmarginen for den prompten. Slik retter du det: handle bare når en endring passerer feilmarginen i to batcher på rad, og skriv ned hva annet som endret seg i samme periode, for eksempel en modelloppdatering eller en konkurrentlansering.
Hva det er: å logge hver lenke til nettstedet ditt som en seier, selv når svaret lister merkevaren din som et alternativ å unngå eller som en fotnote. Slik oppdager du det: ingen leser setningen rundt siteringen. Slik retter du det: logg de tre tilstandene hver for seg (nevnt og anbefalt, bare nevnt, bare sitert), og les setningen før du huker av.
Hva det er: prompter skrevet av markedsteamet til en rapport. Slik oppdager du det: promptene bruker interne produktnavn eller fagjargong som kundene aldri bruker. Slik retter du det: hent prompter fra salgssamtaler, supportsamtaler og Search Console-spørringer, og sjekk noen av dem med ekte kunder.
Hva det er: å anta at en høyere synlighetsrate automatisk gir flere besøk. Slik oppdager du det: synlighetsraten stiger mens henvisningsøktene står stille. Slik retter du det: mål henvisningsbesøk separat, sjekk hvilke AI-modeller og hvilke sider som sender dem, og koble de to datasettene sammen i én månedlig rapport.
Hva det er: å starte et prosjekt for en AI-tekstfil eller ny markup i håp om at det utløser siteringer. Slik oppdager du det: prosjektet har ingen kontroll av indeksering eller kvalifisering for utdrag. Slik retter du det: start med Googles veiledning. Bekreft at nøkkelsider er indeksert og kvalifisert til å vise et utdrag, og fiks deretter teksten og de interne lenkene før noe annet.
| Feil | Tegn i dataene dine | Løsning |
|---|---|---|
| Enkeltkjøring rapportert som resultat | Ingen utvalgsstørrelse eller feilmargin | Rapporter en andel over minst 30 kjøringer |
| Prompter redigert mellom kontroller | Samme rad, ulik tekst, ulike datoer | Frys og versjonskontroller promptsettet |
| Reaksjon innenfor feilmarginen | Endring mindre enn marginen | Handle på endringer som varer over to batcher |
| Sitering talt som anbefaling | Ingen lesing av setningen rundt | Logg de tre tilstandene hver for seg |
| Prompter ingen skriver | Internt produktspråk i promptlisten | Hent prompter fra kundenes eget språk |
| Synlighet behandlet som trafikk | Stigende synlighet, flate henvisninger | Mål henvisninger separat |
Du trenger ikke et fullt program for å starte. Den første uken handler om å sette opp målingen slik at de neste seks månedene kan leses. Ta stegene i rekkefølge.
Din første uke
Når du har et utgangspunkt, slutter volatilitet å være en kilde til bekymring. Den blir et intervall du kan måle, og et sett med endringer du kan planlegge rundt.
Språkmodeller velger hvert ord fra en sannsynlighetsfordeling, så samme prompt kan gi ulik formulering, merkevarelister og rekkefølge. Hentingen endrer seg også, fordi modellen skriver spørsmålet om til delspørsmål, og sidene den henter kan skifte mellom kjøringer.
Authoritas målte volatilitetspoengsummen for AI-oversikter til 0,68 etter 8 uker og 0,73 etter 13 uker, mot 0,49 og 0,55 for organiske resultater. SparkToro fant under 1 prosent sjanse for at ChatGPT eller Googles AI returnerer samme merkevareliste to ganger.
En enkelt plassering i et AI-svar er for ustabil til å handle på. Følg hvor ofte merkevaren din dukker opp på tvers av mange prompter og kjøringer, rapporter andelen i prosent med feilmargin, og behold klassisk rangeringssporing for organiske Google-resultater, der plasseringene beveger seg saktere.
Vi analyserer konkurrentene dine, nettstedet ditt og synligheten din i AI for å lage en skreddersydd innholdsplan, gratis.
 KI-generator for innholdsbrief
 Generator for FAQ-schema
 Generator for blogg-ideer med AI
 Validator for strukturerte data (schema-validator)
 Sjekk av alt-tekst
 Analyse av interne lenker
 Lenkeutfordringen
 KI-generator for metabeskrivelser
 KI-generator for bloggtitler
 Indekserbarhetssjekker for Google
 KI-generator for bloggdisposisjon
 Generator for UTM-lenker
 Verktøy for gruppering av søkeord
 Sjekk av kanonisk tagg
 XML-sitemap-generator
 Sjekk av ødelagte lenker
 KI-generator for SEO-tittel
 Overskriftsanalyse
 SERP-forhåndsvisning
 Kontroll av omdirigeringer
 Generator for hreflang-tagger
 Analyse av overskriftsstruktur
 Kontroll av HTTP-headere
 Favikon-henter
 SERP CTR-kalkulator
 Sparekalkulator: SEO mot betalt søk
 Kalkulator for SEO-synlighetsandel
 ROI-kalkulator for SEO
 SEO-prognosekalkulator for trafikk og inntekter
 SEO-budsjettkalkulator
 SEO-nullpunktkalkulator
 ROI-kalkulator for SaaS-SEO
 ROAS-kalkulator
 Lesetidskalkulator
 Simulator for rangeringsgevinst
 Kalkulator for verdien av organisk trafikk
 Estimator for organisk trafikk og sjekk av nettstedstrafikk
 Kalkulator for LTV til CAC-forhold
 Kalkulator for avkastning på lokal SEO
 Kalkulator for kostnad ved lenkebygging
 Kalkulator for søkeordverdi
 Kalkulator for poengsum for søkeordmuligheter
 Kalkulator for tetthet av søkeord
 Kalkulator for GEO-avkastning
 Kalkulator for investering i GEO-innhold
 Kalkulator for SEO-avkastning i netthandel
 Kalkulator for kundens levetidsverdi
 Kalkulator for kundeanskaffelseskostnad
 CTR-kalkulator
 Kalkulator for kostnad per artikkel
 Kalkulator for konverteringsrate
 Kalkulator for ROI i innholdsmarkedsføring
 Estimator for ChatGPT-trafikk
 Kalkulator for avvisningsrate
 Kalkulator for backlink-ROI
 Kalkulator for AI-synlighetspoeng
 Kalkulator for verdien av AI-trafikk
 Kalkulator for AI-synlighetsandel
 Kalkulator for kostnaden av AI-usynlighet
 Kalkulator for AI-siteringsrate
 llms.txt-validator
 AI Overview-sjekker og rangeringssjekker for AI Overviews
 Robots.txt-sjekker
 KI-SEO-revisjon
 Sjekk av lesbarhet for LLM
 Sjekk av klargjøring for SearchGPT
 Revisjon av strukturerte data for LLM
 KI-revisjon av crawlbarhet
 Hvorfor ChatGPT ikke anbefaler nettstedet mitt
 Gemini-rangeringsverktøy
 Sjekk av rangering i Perplexity
 Sjekk av LLM-sitater
 AEO-revisjon
 GEO-revisjon
 Test av synlighet i AI-søk
 Sjekk av synlighet i ChatGPT
 llms.txt-generator
 URL-uttrekker
 Nettside til Markdown
 Sjekk av sitemap
 Sensor for SERP-volatilitet
 Sidestørrelsessjekk
 Ordteller
 Slug-generator
 Schema-generator
 Robotgenerator
 OG-forhåndsvisning
 Generator for metatagger
 Bildekomprimerer
 Favicon-generator
 Revisjon av on-page SEO: SEO-sjekk og SEO-analyse
 Verktøy for analyse av tilbakelenker
 Verktøy for søkeordforslag
 Sjekk av domeneautoritet
 “Jeg testet Sorank på et ekte kundenettsted, og det er helt utrolig. Det gjør alt et byrå ville tatt deg $1500 i måneden for. Nå går det i produksjon på den kunden.”

 Guillaume Guersanguersanguillaume.com“Vi er et annonsebyrå, og vi ville få SEO-en vår på rett spor en gang for alle. Sorank ga oss en tydelig oversikt over nettstedet vårt, hjalp oss å prioritere optimaliseringene og å strukturere innholdet vårt på riktig måte. Verktøyet er enkelt å bruke, godt utformet for et team, og veldig praktisk for å samle oppfølgingen på ett sted uten å jonglere med flere plattformer. Et veldig solid grunnlag for å starte på nytt med SEO.”
 Gaspard MadouiAnnonsebyrå
 “Jeg lot bare Sorank-programvaren gjøre jobben sin, og nå er DR-en min 25, og siden min rangerer høyere.”
 Lucas Flandrefoundertrace.fr“Jeg spesialiserte meg på GEO takket være Sorank. GEO-rangeringen lar meg vise kundene mine hvor de står mot konkurrentene på ChatGPT. Det er en reell kommersiell fordel.”
 MélanieSEO-frilanser“Kjempebra service, den fungerer godt for nettstedet vårt og hjelper oss å forstå hvordan vi kan forbedre det for å rangere bedre på Google og andre steder. Gratulerer, fortsett slik, jeg anbefaler det.”
 Hugo T.Netthandler