Datenschutz ist uns wichtig. Deshalb können Sie bestimmte Speicherarten deaktivieren, die für die grundlegende Funktion der Website nicht erforderlich sind. Das Blockieren einzelner Kategorien kann Ihr Erlebnis auf der Website beeinträchtigen. Weitere Informationen (Cookie-Richtlinie)
Vielen Dank! Ihre Auswahl wurde gespeichert.
Hoppla! Beim Absenden des Formulars ist ein Fehler aufgetreten.
Blaue Datenpunkte auf einem weißen Raster, die meisten verschieben sich, während einer fest verankert bleibt und die Volatilität der KI-Suche zeigt.
Werkzeuge
Auf dieser Seite
Kurz gesagt
KI-Suchvolatilität beschreibt, wie stark sich die Marken, URLs und die Reihenfolge einer KI-Antwort von einem Durchlauf zum nächsten und von einer Woche zur nächsten verändern. Dieselbe Frage kann eine andere Markenliste, andere Quellenangaben und eine andere Reihenfolge liefern, denn die Antwort wird mit Zufallsanteilen erzeugt und auch der Abrufschritt verändert sich. Eine Position innerhalb einer KI-Antwort ist deshalb eine schlechte Kennzahl. Messen Sie, wie oft Ihre Marke über viele Prompts und viele Durchläufe hinweg erscheint, und bauen Sie dann die Quellen auf, die Ihre Präsenz stabil machen.
3 Tage kostenlos, danach beenden Sie jederzeit. 90-Tage-Ergebnisgarantie, es gelten Bedingungen.
Was KI-Suchvolatilität bedeutet
In der organischen Google-Suche bedeutet Volatilität, dass Ihre Position für ein Keyword nach oben und unten wandert. In der KI-Suche geht es darüber hinaus. Die Antwort selbst ist bei jedem Durchlauf anders. Eine volatile KI-Antwort kann sich auf drei Arten ändern: welche Marken sie nennt, welche URLs sie zitiert und in welcher Reihenfolge sie diese auflistet. Jedes dieser Elemente kann sich verschieben, ohne dass sich an Ihrer Website etwas ändert.
Der Unterschied ist wichtig, weil ein Ranking ein fester Ausgabewert zu einem bestimmten Zeitpunkt ist. Google liefert eine geordnete Liste, und für dieselbe Suchanfrage im selben Markt ist diese Liste meist wiederholbar. Ein KI-Modell liefert dagegen eine einzelne Stichprobe aus einer Bandbreite möglicher Antworten. Ihre Marke hat eine Wahrscheinlichkeit, in dieser Bandbreite vorzukommen. Diese Wahrscheinlichkeit können Sie messen, und sie können Sie beeinflussen.
Zwei Zahlen aus einer Studie von 2026 zeigen, wie stark der Effekt ist. Rand Fishkin von SparkToro arbeitete mit Patrick O'Donnell von Gumshoe.ai zusammen. Rund 600 Freiwillige schickten 12 Prompts an ChatGPT, Claude und die KI von Google, insgesamt 2961 Durchläufe. Die Forscher fanden eine Chance von weniger als 1 zu 100, dass ChatGPT oder die KI von Google dieselbe Markenliste zweimal liefert. Die Chance auf dieselbe Markenliste in derselben Reihenfolge lag bei etwa 1 zu 1000 Durchläufen. Der SparkToro-Bericht vom 28. Januar 2026 deckt Daten aus November und Dezember 2025 ab.
Wie stabil sind KI-Markenlisten?
2961Durchläufe mit 12 Prompts und drei KI-Systemen
<1%Chance, dass ChatGPT oder die KI von Google zweimal dieselbe Markenliste liefert
<0,1%Chance auf dieselbe Markenliste in derselben Reihenfolge
Quelle: SparkToro und Gumshoe.ai, Januar 2026
Sobald man akzeptiert, dass die Ausgabe eine Stichprobe ist, muss sich die Art der Messung ändern. Der Vergleich unten fasst die beiden Denkweisen zusammen. Er ist der Kerngedanke dieses ganzen Leitfadens.
Rang verfolgen oder Präsenz verfolgen
Eine einzelne Position
Ändert sich bei fast jedem Durchlauf
Eine einzelne Antwort sagt sehr wenig
Anteil der Durchläufe
Gemessen über Dutzende Prompts
Zeigt einen Trend, auf den Sie reagieren können
Volatilität bei Markenlisten
Die auffälligste Veränderung betrifft die Markenliste selbst. Ein Prompt wie „bestes Projektmanagement-Tool für ein Team mit 10 Personen“ kann bei einem Durchlauf fünf Marken nennen und beim nächsten fünf andere. Manche Marken tauchen häufig auf, andere wechseln ein und aus. Die Präsenz in der Menge ist stabiler als die Position innerhalb der Menge, deshalb raten die Forscher dazu, Präsenz statt Rang zu verfolgen.
Daraus folgt ein praktischer Punkt. Wenn Sie einen Prompt einmal prüfen und Ihre Marke auf Platz zwei sehen, wissen Sie fast nichts. Prüfen Sie ihn 60-mal und sehen Ihre Marke in 40 Antworten, wissen Sie etwas Nützliches: Sie sind für diese Frage eine regelmäßige Wahl.
Volatilität bei Quellenangaben
Quellenangaben sind die Links, die ein KI-Modell als Belege anzeigt. Sie schwanken noch stärker als die Markenliste, wenn das Modell eine Live-Websuche durchführt, weil jeder Durchlauf eine andere Gruppe von Seiten abrufen kann. Eine verschwundene Quelle ist nicht immer ein Verlust. Ihre Marke kann weiterhin im Text genannt werden, ohne Link. Deshalb sollten Sie zwei Dinge getrennt erfassen: die namentliche Erwähnung und die zitierte URL.
Volatilität bei der Reihenfolge
Die Position innerhalb einer Antwort ist das am wenigsten stabile Element. Ein KI-Modell kann Ihre Marke bei einem Durchlauf an erster Stelle und beim nächsten an vierter Stelle nennen, ohne dass sich seine Einschätzung von Ihnen tatsächlich geändert hat. Betrachten Sie die Reihenfolge als Rauschen, solange sie sich nicht über Dutzende Durchläufe in eine Richtung bewegt.
Drei Mechanismen treiben den größten Teil der Veränderungen. Sie lassen sich nicht abschalten, aber wenn Sie sie kennen, wissen Sie, was Sie messen und was Sie ignorieren sollten.
Stichprobenziehung
Ein Sprachmodell wählt nicht die eine beste Antwort. Es wählt jedes nächste Wort aus einer Wahrscheinlichkeitsverteilung. Ein Parameter namens Temperatur bestimmt, wie breit diese Auswahl ist. Bei niedrigen Werten ist die Ausgabe eher wiederholbar, bei hohen Werten variiert sie stärker. Entwickler können die Temperatur in einer API festlegen, aber die Verbraucher-Apps, die Ihre Kunden meist nutzen, legen sie nicht offen. Gehen Sie davon aus, dass die Stichprobenziehung immer aktiv ist. Die Freiwilligen von SparkToro behielten ihre gewohnten Einstellungen bei, personalisiert oder Standard, deshalb beschreiben ihre Ergebnisse, was ein gewöhnlicher Nutzer sieht.
Abruf und Teilanfragen
Wenn ein KI-Modell das Web durchsucht, schickt es Ihre genaue Frage nicht an eine Suchmaschine. Es formuliert die Frage in mehrere Teilanfragen um und ruft für jede Seiten ab. Eine kleine Änderung im Wortlaut, eine Seite, die am Morgen indexiert wurde, oder ein anderes Ergebnis für eine einzelne Teilanfrage können verändern, welche Quellen in die finale Antwort gelangen. Die URLs, aus denen Sie zitiert werden, sind das Ergebnis eines Abrufschritts, der sich verschiebt. Unser Leitfaden zu der Frage, wie KI-Modelle ihre Quellen auswählen, erklärt die Mechanik, und Sorank's Tracker dafür, wonach die KI wirklich sucht, ist genau für diese Frage gebaut.
Modell- und Index-Updates
Anbieter aktualisieren Modelle und die Systeme darum herum oft ohne große Vorankündigung. Eine neue Modellversion, eine Änderung, wann ein Modell sich zur Suche entscheidet, oder eine Verschiebung im Web-Index können die Antworten zu einem ganzen Thema an einem einzigen Tag verändern. Wenn Ihre Daten einen plötzlichen Sprung zeigen, prüfen Sie zuerst auf ein wahrscheinliches Update und vergleichen Sie dann mit Ihrer Ausgangsbasis, bevor Sie reagieren.
Mechanismus
Was sich ändert
Wie es sich zeigt
Was Sie tun
Stichprobenziehung
Markenliste, Wortlaut und Reihenfolge
Unterschiedliche Antworten auf denselben Prompt am selben Tag
Über viele Durchläufe messen und einen Anteil berichten
Abruf
Zitierte URLs
Von Woche zu Woche andere Quellen
Seiten und Drittquellen stärken, die gut abgerufen werden
Modell- und Index-Updates
Gesamter Antwortstil und bevorzugte Marken
Ein Sprung an einem bestimmten Datum
Eine Ausgangsbasis führen und jedes erkennbare Update vermerken
KI-Antworten ändern sich von einem Durchlauf zum nächsten. Die Präsenz über viele Durchläufe ist das, was Sie verfolgen und aufbauen können.
Wie stark sich KI-Antworten verändern
Gemessene Zahlen sind noch rar, und die meisten stammen von Anbietern aus SEO und KI-Sichtbarkeit. Zwei Quellen lohnen eine genaue Lektüre. Die erste ist eine Studie der SEO-Plattform Authoritas, die KI-Übersichten mit organischen Ergebnissen verglich. Die zweite sind Messungen von BrightEdge, die KI-Übersichten mit dem KI-Modus verglichen.
Authoritas maß die Ranking-Volatilität mit einem Score. Je höher der Score, desto stärker änderten sich die Ergebnisse im Zeitraum. Bei den KI-Übersichten lag der Score bei 0,68 nach 8 Wochen und bei 0,73 nach 13 Wochen. Bei organischen Ergebnissen lag er bei 0,49 und 0,55. Digital Information World, das die Studie im Februar 2025 aufgriff, schrieb außerdem, dass etwa 70% der KI-Übersichts-Ergebnisse sich innerhalb von zwei bis drei Monaten änderten. Der Artikel nannte weder die Keyword-Stichprobe noch die Messzeitpunkte. Prüfen Sie daher den originalen Authoritas-Bericht, bevor Sie eine Zahl in einer Kundenpräsentation zitieren.
Volatilitäts-Score der Rankings nach 8 Wochen
KI-Übersichten0,68
Organische Ergebnisse0,49
Quelle: Authoritas-Studie, berichtet von Digital Information World, Februar 2025
KI-Übersichts-Ergebnisse, die sich in 2 bis 3 Monaten änderten
70%der verfolgten KI-Übersichts-Ergebnisse
Quelle: Authoritas-Studie, berichtet von Digital Information World, Februar 2025
BrightEdge hat dieselbe Frage aus einem anderen Blickwinkel gemessen. Seine Analyse vom August 2025 ergab bei den KI-Übersichten 16,7% mehr Volatilität bei Markenerwähnungen als im KI-Modus. Außerdem blieben bei den KI-Übersichten 24% der URLs unverändert, im KI-Modus waren es 20%. Die Tabelle stellt diese Zahlen nebeneinander.
Messgröße
KI-Übersichten
Vergleich
Quelle
Volatilitäts-Score, 8 Wochen
0,68
0,49 für organische Ergebnisse
Authoritas
Volatilitäts-Score, 13 Wochen
0,73
0,55 für organische Ergebnisse
Authoritas
Volatilität bei Markenerwähnungen
16,7% höher
Im Vergleich zum KI-Modus
BrightEdge, August 2025
Unveränderte URLs
24%
20% im KI-Modus
BrightEdge, August 2025
Warum sich KI-Übersichten und KI-Modus unterschiedlich verhalten
KI-Übersichten erscheinen für einen Teil der Suchanfragen innerhalb der normalen Google-Ergebnisseite. Der KI-Modus ist eine eigene, dialogartige Oberfläche. Die BrightEdge-Zahlen deuten darauf hin, dass KI-Übersichten bei den genannten Marken stärker schwanken, während der KI-Modus weniger seiner URLs stabil hält. Die praktische Lehre ist, jede Oberfläche einzeln zu prüfen. Eine einzige Zahl für „Google-KI“ verdeckt den Unterschied, und genau dieser Unterschied muss Ihre Planung bestimmen. Unser Vergleich von Google AI Mode und KI-Übersichten erklärt, was beide für die SEO bedeuten.
Der entscheidende Punkt ist, dass sich die Stabilität organischer Ergebnisse nicht einfach übertragen lässt. Organische Ergebnisse sind in den Authoritas-Daten weniger volatil als KI-Übersichten, aber sie stehen nicht still. Eine Seite, die einen Monat lang Platz 3 hält, kann nach einem Core-Update trotzdem fallen. Sie brauchen deshalb eine Methode, die echte Veränderungen von gewöhnlichen Schwankungen auf beiden Oberflächen trennt.
Warum Rank-Tracking in der KI-Suche versagt
Die meisten Rank-Tracker wurden für Google gebaut, wo ein Keyword eine einzige geordnete Liste hat, die sich langsam verändert. Auf ein KI-Modell angewandt, erzeugt dieselbe Logik eine Zahl, die auf einer einzigen Stichprobe beruht. Wenn Ihre Marke bei einem Durchlauf auf Platz drei und beim nächsten auf Platz acht steht, sagt Ihnen der Durchschnitt dieser beiden Läufe fast nichts. Ein Tool, das „Sie sind Nummer 3 in ChatGPT“ meldet, stellt einen einzelnen Zug als Tatsache dar. Unser Leitfaden zum Rank-Tracking behandelt die klassische Methode, dieser Artikel erklärt, was sich ändert, wenn die Antwort erzeugt statt aufgelistet wird.
Die Schlussfolgerung von SparkToro lautet, dass Rank-Tracking-Produkte mit festen Positionen Rauschen messen. Die Studie rät, Präsenz statt Rang zu verfolgen. Sie hält einen Sichtbarkeitsanteil für eine vernünftige Kennzahl, wenn er über Dutzende bis Hunderte Prompts gemessen wird, wobei jeder mehrfach läuft. Bitten Sie jeden Anbieter, Stichprobengröße und Methode hinter einem Score offenzulegen, bevor Sie ihm vertrauen.
Ein Prompt, ein Screenshot oder ein gemessener Anteil
Vorher
Meldet eine einzelne Position
Ändert sich beim nächsten Durchlauf
Keine Fehlermarge, daher wirkt jede Bewegung echt
Nachher
Meldet den Anteil der Durchläufe, die Ihre Marke nennen
Zeigt einen Trend über mehrere Wochen
Gibt an, wie groß eine Änderung sein muss, um zu zählen
Googles eigene Dokumentation zeigt in dieselbe Richtung, aus einem anderen Grund. Google schreibt, dass eine Seite indexiert und berechtigt sein muss, mit einem Snippet in der Suche zu erscheinen, damit sie in KI-Übersichten oder im KI-Modus verwendet wird. Außerdem gibt es laut Google kein spezielles Markup und keine KI-spezifische Datei, die man ergänzen müsste. Es gibt keine Einstellung für „KI-Ranking“, die man optimieren könnte. Die Arbeit besteht darin, über viele Quellen präsent und vertrauenswürdig zu sein und diese Präsenz ehrlich zu messen.
Wie Sie KI-Suchvolatilität Schritt für Schritt messen
Die folgende Methode braucht ein paar Tage Einrichtung und einige Minuten pro Woche für die Pflege. Sie können sie in einer Tabellenkalkulation umsetzen. Spezialtools nehmen Ihnen vor allem die Wiederholung ab, nicht das Nachdenken.
Die fünfstufige Messmethode
Ein Prompt-Set erstellenWählen Sie 20 bis 50 Fragen, die echte Käufer stellen. Nehmen Sie sie aus Verkaufsgesprächen, Support-Chats und Search-Console-Anfragen.
Jeden Prompt oft ausführenWiederholen Sie jeden Prompt mindestens 30-mal pro KI-Modell, idealerweise 60 bis 100-mal wie das SparkToro-Team. Verwenden Sie dieselben Einstellungen und verteilen Sie die Durchläufe über mehrere Tage.
Jede Antwort protokollierenNotieren Sie, ob Ihre Marke genannt wird, ob sie empfohlen oder nur erwähnt wird, ihre Position und die zitierten URLs.
Die Sichtbarkeitsrate berechnenTeilen Sie die Antworten, die Ihre Marke nennen, durch alle Antworten, und addieren Sie die Fehlermarge für jeden Prompt und jedes KI-Modell.
Den Trend wöchentlich lesenTragen Sie die Rate über die Zeit auf und vermerken Sie Modell-Updates, Ihre Inhaltsänderungen und Starts von Wettbewerbern.
Die Formel mit einem Rechenbeispiel
Die Sichtbarkeitsrate ist der Anteil der Antworten, die Ihre Marke nennen. Die Fehlermarge zeigt, wie viel einer Änderung real ist. Verwenden Sie eine Fehlermarge mit 95% Konfidenz, basierend auf dem Standardfehler eines Anteils:
Sichtbarkeitsrate = Antworten, die Ihre Marke nennen / alle Antworten
Standardfehler = Wurzel(p x (1 - p) / n)     wobei p die Sichtbarkeitsrate und n die Zahl der Durchläufe ist
Fehlermarge (95%) = 1,96 x Standardfehler
Hier ist ein illustratives Beispiel mit erfundenen Zahlen, keine Messung. Ihre Marke erscheint in 37 von 80 Durchläufen, die Sichtbarkeitsrate beträgt also 46%. Der Standardfehler liegt bei 5,6 Punkten, daraus ergibt sich eine Fehlermarge von etwa 11 Punkten bei 95%. Berichten Sie das Ergebnis als 46% plus oder minus 11 Punkte. Wenn der nächste Block 40% zeigt, liegt dieser Wert innerhalb der Spanne, und das ist kein Signal, Ihre Seiten umzuschreiben.
Genannt, empfohlen und zitiert sind drei verschiedene Zustände
Eine Marke kann ohne Link genannt, mit Link aber nicht empfohlen oder in einem Satz empfohlen werden, der nie einen Wettbewerber nennt. Erfassen Sie diese Zustände getrennt: genannt und empfohlen, nur genannt und nur zitiert. Ihre Anteile verändern sich aus unterschiedlichen Gründen, und jeder verlangt eine andere Maßnahme. Eine Quelle ohne Erwähnung ist ein Quellenproblem. Eine Erwähnung ohne Empfehlung ist ein Positionierungsproblem.
Ihr erstes Messblatt
Prompt-Liste eingefroren und datiert, neue Prompts als neue Zeilen ergänzt
Durchläufe je KI-Modell protokolliert, mit Datum und verwendeten Einstellungen
Drei Zustände erfasst: genannt und empfohlen, nur genannt, nur zitiert
Sichtbarkeitsrate und Fehlermarge für jeden Prompt berechnet
Hinweis
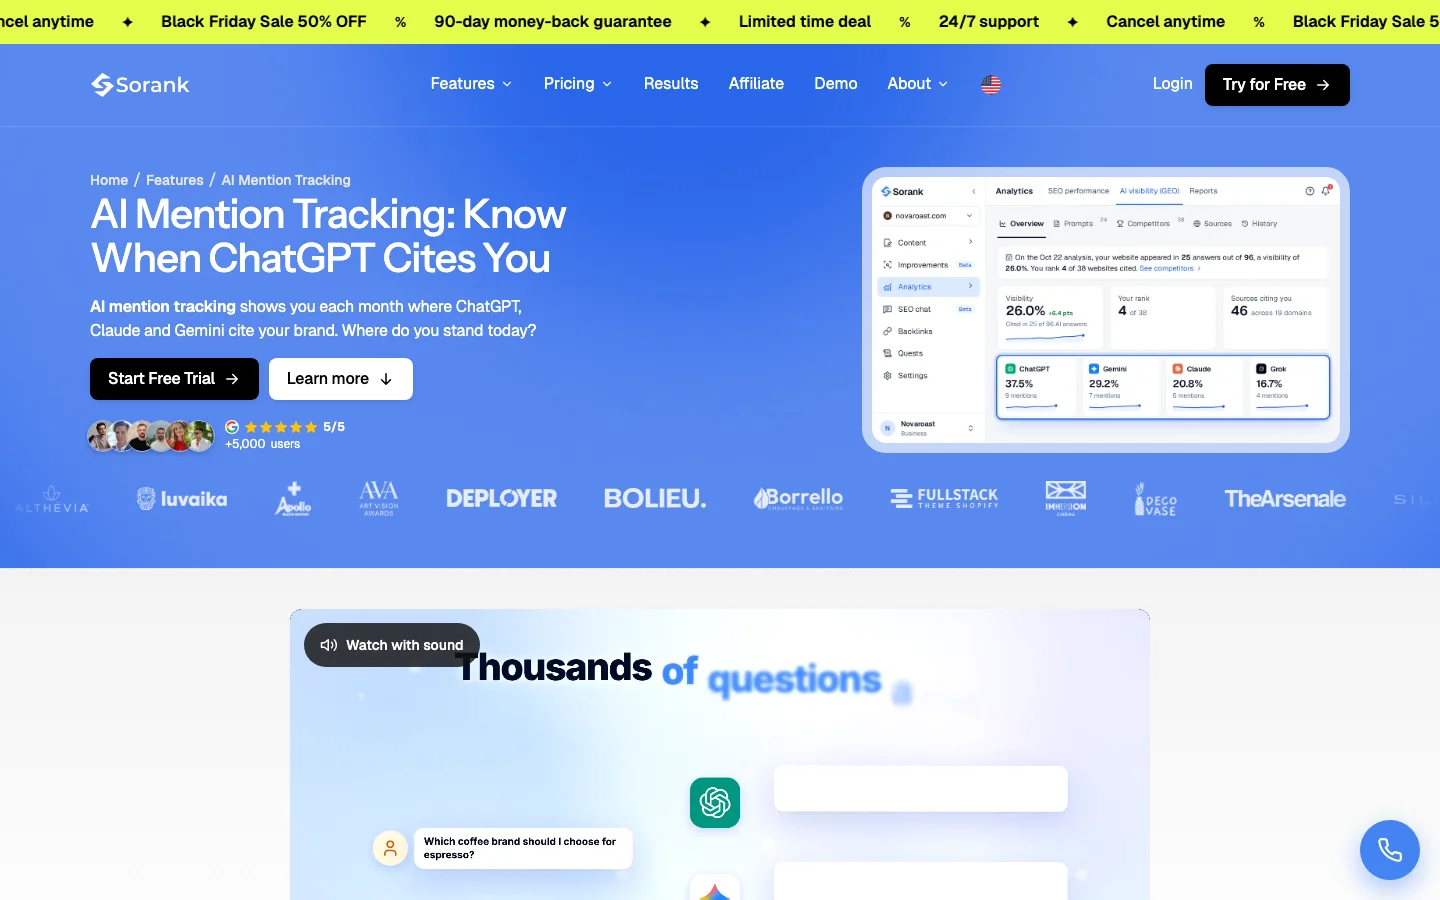
Jeden Prompt von Hand zu wiederholen wird nach ein paar Wochen mühsam. Sorank's AI Mention Tracking zeigt für jeden verfolgten Prompt, wie oft ChatGPT, Claude und Gemini Ihre Marke erwähnen, mit den Quellen und Suchen hinter jeder Antwort. Die Auswertung läuft monatlich, was für einen einzelnen Prompt eine dünne Stichprobe ist. Lesen Sie den Trend deshalb über mehrere Monate und ergänzen Sie eigene wiederholte Durchläufe für die wichtigsten Prompts.
AI Mention Tracking zeigt, wie oft ChatGPT, Claude und Gemini Ihre Marke zitieren.
Berichten an die, die dafür bezahlen
Ein Monatsbericht sollte eine Frage beantworten: Bewegt sich Ihre Präsenz, und ist die Bewegung größer als das Rauschen? Zeigen Sie die Sichtbarkeitsrate je Prompt-Gruppe mit ihrer Fehlermarge, nicht eine einzige Zahl. Ergänzen Sie die Positionsverteilung, also wie oft Ihre Marke in den Antworten, in denen sie genannt wird, an erster, zweiter oder einer niedrigeren Stelle erscheint, damit die Reihenfolge als Streuung und nicht als Rang sichtbar wird. Schwankungen um einen gleichbleibenden oder steigenden Trend sind normal. Ein stetiger Rückgang über mehrere Chargen ist es nicht. Er rechtfertigt eine Prüfung der Prompts, der Modell-Release-Notizen und der zitierten Quellen, bevor jemand eine Seite umschreibt. Schreiben Sie die Handlungsregel in den Bericht selbst: Eine Änderung gilt nur dann als real, wenn sie in zwei aufeinanderfolgenden Chargen die Fehlermarge überschreitet.
So machen Sie Ihre Präsenz stabiler
Volatilität können Sie nicht abschalten, aber Sie können Ihre Präsenz konsistenter machen. Präsenz wächst, wenn Ihre Marke auf mehreren Quellen, die KI-Modelle ohnehin nutzen, gleich beschrieben wird. Googles Dokumentation nennt die Grundlage dessen, was die eigenen KI-Funktionen brauchen.
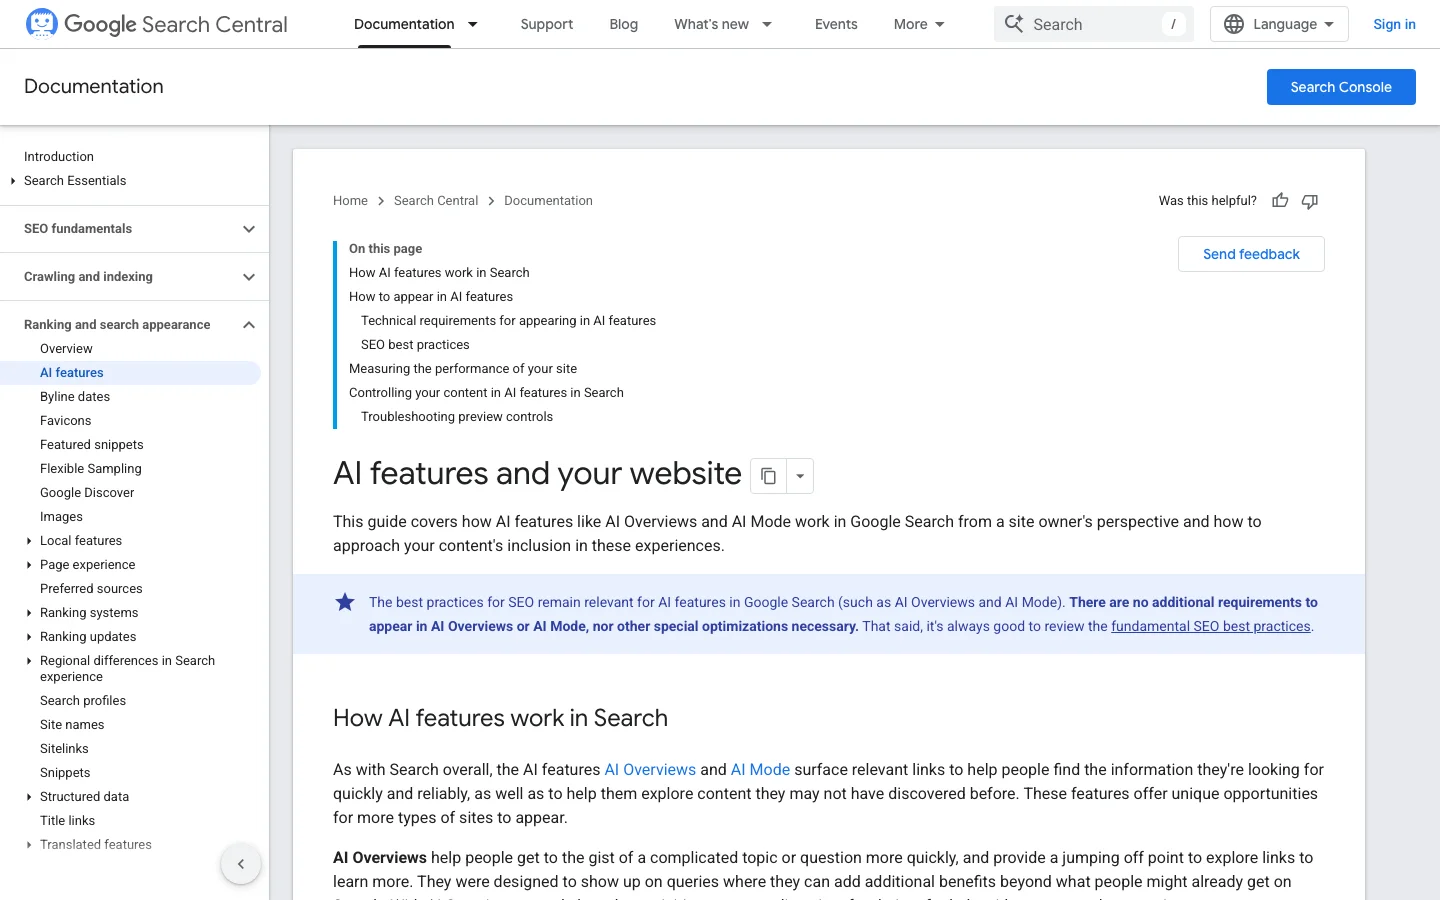
Googles Hinweise zu KI-Übersichten und zum KI-Modus sind knapp. Eine Seite muss indexiert sein und ein Snippet anzeigen dürfen. Die Grundlagen gelten weiterhin: robots.txt-Regeln, die Crawling erlauben, interne Links, für Leser sichtbarer Text und strukturierte Daten, die zum sichtbaren Text passen. Google sagt, dass man keine neuen maschinenlesbaren Dateien, KI-Textdateien oder spezielles Schema braucht, um zu erscheinen.
Googles Hinweise zu KI-Übersichten und zum KI-Modus: Eine besondere Optimierung ist nicht nötig.
Ihre Marke überall gleich beschreiben
KI-Modelle bilden sich ein Bild einer Marke aus vielen Quellen gleichzeitig. Wenn Ihr Name, Ihre Kategorie, Ihr Hauptanwendungsfall und Ihr Standort auf Ihrer Website, in Ihren Profilen und in Verzeichniseinträgen voneinander abweichen, verschwimmt das Bild, und die Markenliste wird weniger stabil. Schreiben Sie eine kurze, sachliche Beschreibung Ihres Unternehmens mit Kategorie und Anwendungsfällen und verwenden Sie sie überall dort wieder, wo Sie den Text kontrollieren. Prüfen Sie sie jedes Quartal.
Erwähnungen auf bereits vertrauenswürdigen Quellen verdienen
Bestätigung bedeutet, dass mehrere unabhängige Quellen dasselbe über Sie sagen. Bewertungen, Vergleichsartikel, Branchenverzeichnisse und Fachmedien Ihrer Nische sind die üblichen Orte. Verdienen Sie diese Erwähnungen mit nützlicher Arbeit, etwa mit eigenen Daten, einem klaren Produktvergleich oder einem Werkzeug, das Menschen tatsächlich nutzen. Kaufen Sie sie nicht. Bezahlte Platzierungen erzeugen Rauschen, und ein solches Muster bricht zusammen, sobald die Zahlungen enden.
Die Hauptfrage auf jeder Schlüsselseite beantworten
KI-Modelle extrahieren Textpassagen, nicht ganze Seiten. Eine Seite, die im ersten Absatz eine kurze Definition gibt, die Hauptfrage direkt beantwortet und einen klaren nächsten Schritt nennt, lässt sich leichter extrahieren und präziser zitieren. Unsere GEO-Checkliste listet die Punkte auf, die Sie auf jeder Seite prüfen sollten.
Checkliste zur Stabilität Ihrer Marke
Schlüsselseiten indexiert und berechtigt, ein Snippet anzuzeigen
Gleicher Markenname und gleiche Kategorie in jedem Profil und Verzeichnis
Erwähnungen auf mehreren unabhängigen Seiten, nicht nur auf Ihrer eigenen
Strukturierte Daten, die zum sichtbaren Text passen
Eine direkte Antwort im ersten Absatz jeder Schlüsselseite
Vier Wege, auf Volatilität zu reagieren
Teams reagieren auf vier übliche Weisen auf Volatilität. Jede hat einen Nutzen und eine Grenze. Lesen Sie sie als Optionen, die Sie kombinieren können, nicht als Rangliste. Die meisten Teams nutzen die erste und die letzte zusammen.
Täglichen Rang verfolgen
Prinzip: Einen Prompt täglich abfragen und die Position Ihrer Marke in der Antwort notieren. Wann sinnvoll: Sie wollen eine schnelle Frühwarnung, wenn sich eine bestimmte Anfrage stark ändert. Vorteile: Vertraut, günstig und leicht zu visualisieren. Grenzen: Es ist eine Stichprobe pro Tag, und sie kann keinen echten Verlust von einem gewöhnlichen Ausschlag unterscheiden. Beispiel: Ein Prompt nennt Ihre Marke am Montag, am Mittwoch nicht. Das Diagramm zeigt einen Abfall, aber ein einzelner Durchlauf kann nicht unterscheiden, ob eine Position verloren ging oder eine normale Schwankung vorliegt.
Präsenz über viele Durchläufe verfolgen
Prinzip: Viele Prompts vielfach ausführen und den Anteil der Antworten berichten, die Ihre Marke nennen, mit Fehlermarge. Wann sinnvoll: Sie brauchen eine Zahl für ein Reporting oder eine Entscheidung über Content-Investitionen. Vorteile: Es entspricht der Art, wie die Ausgabe entsteht, und liefert eine Spanne statt eines falschen Punkts. Grenzen: Es kostet mehr Durchläufe und verlangt Disziplin, das Prompt-Set stabil zu halten. Beispiel: Ihre Sichtbarkeitsrate liegt bei 46% plus oder minus 11 Punkten über 80 Durchläufe. Im Folgemonat liegt sie bei 52%. Sie können sagen, dass der Trend nach oben zeigt, aber noch nicht, dass es ein echter Gewinn ist. Also warten Sie auf eine weitere Charge.
Bestätigung über Quellen aufbauen
Prinzip: Dieselben korrekten Aussagen auf mehreren unabhängigen Quellen erscheinen lassen. Wann sinnvoll: Ihre Positionierung ist klar, und Sie wollen Empfehlungen, die halten. Vorteile: Es hilft in KI-Antworten wie in der klassischen Suche, und der Effekt bleibt. Grenzen: Es ist langsam und zeigt selten innerhalb eines Monats ein Ergebnis. Beispiel: Ein Softwareunternehmen sieht seine Anwendungsfälle in zwei Bewertungen, einer Vergleichsseite und einem Branchenverzeichnis beschrieben, sodass KI-Modelle bei verschiedenen Prompts dieselbe Beschreibung wiederholen.
Schlüsselseiten mit direkten Antworten auffrischen
Prinzip: Die Seiten aktualisieren, die Ihre Hauptfragen beantworten, damit die Antwort klar, korrekt und datiert ist. Wann sinnvoll: Ihre Seite wird zitiert, aber falsch beschrieben, oder an Ihrer Stelle wird eine Wettbewerberseite zitiert. Vorteile: Es ist schnell umgesetzt und verbessert die Extraktion von Passagen. Grenzen: Eine bessere Seite garantiert keine Erwähnung, und Änderungen brauchen Zeit, bis sie in Ihren Daten sichtbar werden. Beispiel: Eine Glossarseite bekommt oben eine Definition in einem Satz, eine kurze Vergleichstabelle und einen sichtbaren Aktualisierungsvermerk, und die nächste Messcharge zeigt die richtige Beschreibung.
Methode
Was sie zeigt
Stabilität des Signals
Aufwand
Ideal für
Täglicher Rang
Eine Position an einem Tag
Niedrig
Niedrig
Einen starken Ausschlag bei einer Anfrage erkennen
Präsenz über Durchläufe
Anteil der Antworten, die Ihre Marke nennen
Hoch, mit Fehlermarge
Mittel bis hoch
Reporting und Budgetentscheidungen
Bestätigung
Wie einheitlich Quellen Sie beschreiben
Hoch über Monate
Hoch
Langfristige Empfehlungen
Seiten-Refresh
Wie gut Ihre Schlüsselseiten die Frage beantworten
Mittel
Mittel
Eine falsche oder fehlende Beschreibung korrigieren
Werkzeuge für zwei Arten von Volatilität
Organische Google-Ergebnisse und KI-Antworten brauchen unterschiedliche Instrumente. Wenn man sie verwechselt, kommt man zu falschen Schlüssen, deshalb halten Sie sie in Ihrem Reporting getrennt.
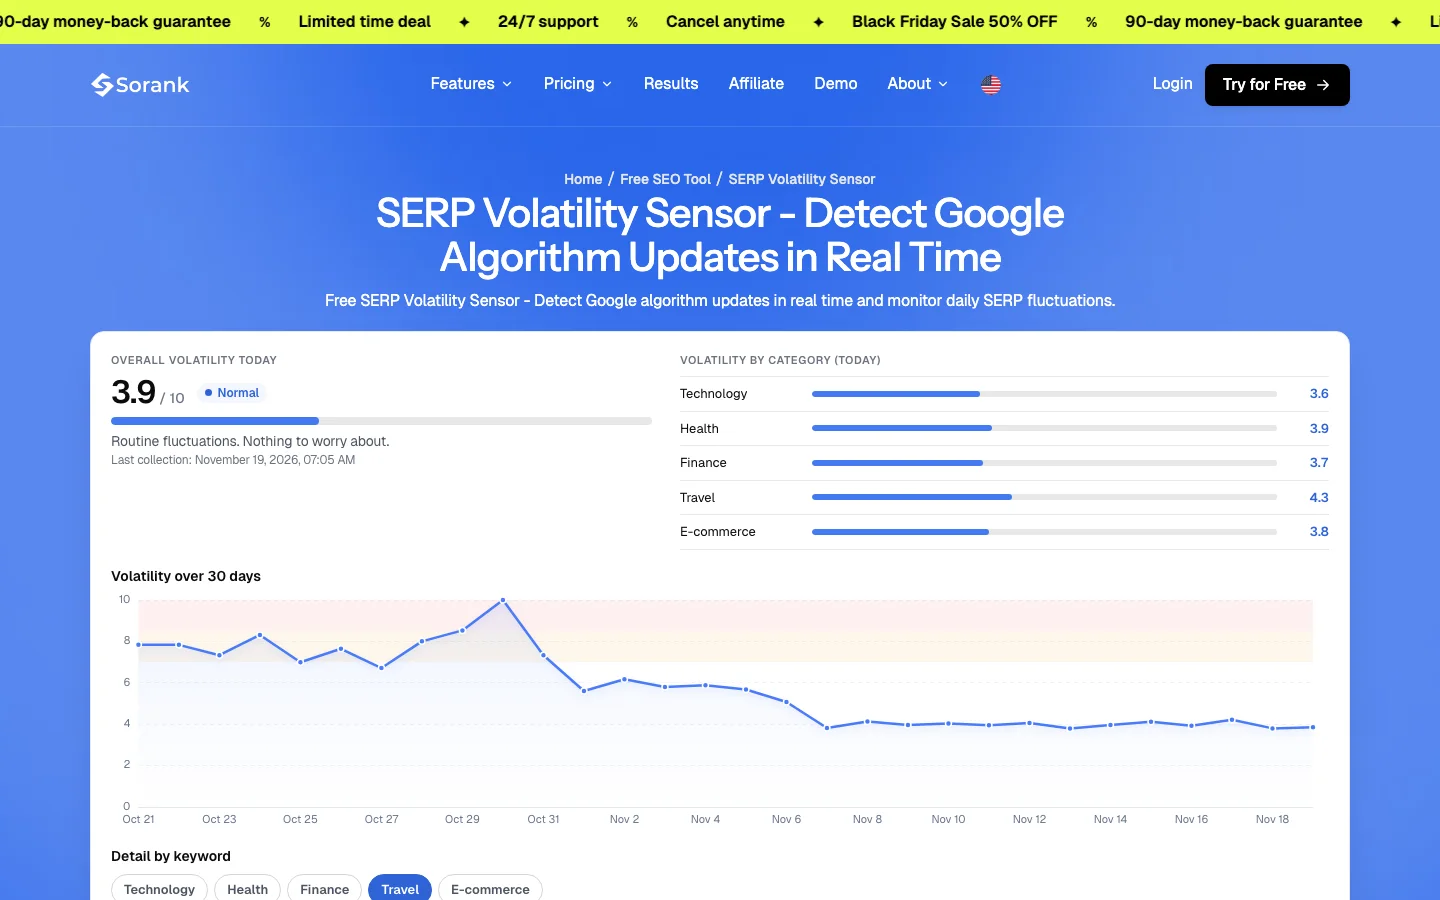
Sorank's kostenloser SERP Volatility Sensor deckt die erste Art ab. Jeden Morgen erfasst er die Top-10-Ergebnisse der organischen Suche für 20 englischsprachige US-Keywords aus fünf Branchen, vergleicht sie mit dem Vortag und vergibt einen Score von 0 bis 10, insgesamt und pro Branche. Er zeigt, wie stark sich die erste Google-Seite bewegt hat, und ist damit ein nützliches Frühsignal für Algorithmus-Änderungen. Er misst keine KI-Antworten und ersetzt daher nicht die promptbasierte Methode oben. Für den Google-Teil der Frage lesen Sie den Sensor auf seiner eigenen Seite und halten Sie ihn neben Ihren Rankingdaten, nicht neben Ihren KI-Sichtbarkeitszahlen.
Der kostenlose SERP Volatility Sensor verfolgt organische Google-Ergebnisse, nicht KI-Antworten.
Search Console und Google Analytics berichten über Google-Klicks und Verweisbesuche. Ein Rank-Tracker berichtet über Positionen bei Google. Keines davon zeigt, welche KI-Antworten Ihre Marke genannt haben. Dafür brauchen Sie protokollierte Antworten oder ein Tool, das sie protokolliert. Für Besuche, die von KI-Modellen kommen, behandelt unser Leitfaden zum GEO-Reporting die Verweisseite.
Häufige Fehler und wie Sie sie beheben
Die meisten Volatilitätsfehler entstehen, wenn man Rauschen als Signal liest. Jeder der folgenden Fehler zeigt, wie er aussieht, wie Sie ihn in Ihren Daten erkennen und wie Sie ihn beheben.
Einen einzelnen Durchlauf als Ergebnis melden
Was es ist: Ein Screenshot oder eine einzelne Antwort, die als Ihre Position dargestellt wird. Wie Sie es erkennen: Der Bericht zeigt eine Position ohne Stichprobengröße, ohne Zeitraum und ohne Fehlermarge. Wie Sie es beheben: Berichten Sie die Sichtbarkeitsrate über mindestens 30 Durchläufe pro Prompt, mit Fehlermarge und Zeitraum.
Die Prompts zwischen den Prüfungen ändern
Was es ist: Einen Prompt zwischen zwei Prüfungen umformulieren, etwa „bestes CRM“ in einer Woche und „bestes CRM für Startups“ in der nächsten, und das Ergebnis dann als Trend lesen. Wie Sie es erkennen: Der Prompt-Text in der Tabelle unterscheidet sich zu zwei Daten in derselben Zeile. Wie Sie es beheben: Frieren Sie das Prompt-Set ein und versionieren Sie es. Ein neuer Prompt kommt als neue Zeile, ein alter wird nie bearbeitet.
Auf Bewegungen innerhalb der Fehlermarge reagieren
Was es ist: Eine Seite umschreiben, nachdem die Rate um fünf Punkte gefallen ist. Wie Sie es erkennen: Die Änderung ist kleiner als die Fehlermarge für diesen Prompt. Wie Sie es beheben: Handeln Sie nur, wenn eine Änderung die Fehlermarge in zwei aufeinanderfolgenden Chargen überschreitet, und notieren Sie, was im selben Zeitraum sonst geschah, etwa ein Modell-Update oder der Start eines Wettbewerbers.
Eine Quellenangabe als Empfehlung zählen
Was es ist: Jeden Link zu Ihrer Website als Erfolg verbuchen, auch wenn die Antwort Ihre Marke als Option zum Vermeiden oder als Fußnote nennt. Wie Sie es erkennen: Niemand liest den Satz um die Quellenangabe. Wie Sie es beheben: Erfassen Sie die drei Zustände getrennt (genannt und empfohlen, nur genannt, nur zitiert) und lesen Sie den Satz, bevor Sie ein Kästchen abhaken.
Prompts verfolgen, die niemand tippt
Was es ist: Prompts, die das Marketingteam für einen Bericht geschrieben hat. Wie Sie es erkennen: Die Prompts verwenden interne Produktnamen oder Fachjargon, den Kunden nie benutzen. Wie Sie es beheben: Nehmen Sie Prompts aus Verkaufsgesprächen, Support-Unterhaltungen und Search-Console-Anfragen und prüfen Sie einige davon mit echten Kunden.
Erwarten, dass KI-Sichtbarkeit von allein Klicks bringt
Was es ist: Die Annahme, dass eine höhere Sichtbarkeitsrate automatisch mehr Besuche bringt. Wie Sie es erkennen: Die Sichtbarkeitsrate steigt, während die Verweissitzungen gleich bleiben. Wie Sie es beheben: Messen Sie Verweisbesuche getrennt, prüfen Sie, welche KI-Modelle und welche Seiten sie schicken, und verbinden Sie beide Datensätze in einem monatlichen Bericht.
KI-spezifische Dateien anlegen, um KI-Antworten nachzujagen
Was es ist: Ein Projekt für eine KI-Textdatei oder neues Markup starten, in der Hoffnung, damit Zitate auszulösen. Wie Sie es erkennen: Das Projekt prüft weder Indexierung noch Snippet-Berechtigung. Wie Sie es beheben: Beginnen Sie mit Googles Hinweisen. Bestätigen Sie, dass Schlüsselseiten indexiert sind und ein Snippet zeigen dürfen, und korrigieren Sie dann zuerst Text und interne Links.
Fehler
Anzeichen in Ihren Daten
Lösung
Einzelner Durchlauf als Ergebnis gemeldet
Keine Stichprobengröße und keine Fehlermarge
Einen Anteil über mindestens 30 Durchläufe melden
Prompts zwischen Prüfungen geändert
Gleiche Zeile, anderer Text, andere Daten
Prompt-Set einfrieren und versionieren
Reaktion innerhalb der Fehlermarge
Änderung kleiner als die Marge
Nur auf Änderungen handeln, die zwei Chargen bestehen
Zitat als Empfehlung gezählt
Kein Blick auf den umgebenden Satz
Die drei Zustände getrennt erfassen
Prompts, die niemand tippt
Interner Jargon in der Prompt-Liste
Prompts aus der echten Kundensprache ableiten
Sichtbarkeit als Traffic behandelt
Steigende Sichtbarkeit, gleichbleibende Verweise
Verweisbesuche separat messen
Was Sie diese Woche tun sollten
Sie brauchen kein vollständiges Programm, um zu beginnen. Die erste Woche dient dazu, die Messung so aufzusetzen, dass die nächsten sechs Monate lesbar sind. Gehen Sie diese Schritte der Reihe nach durch.
Ihre erste Woche
20 Prompts auswählenNehmen Sie sie aus der echten Sprache Ihrer Kunden und frieren Sie die Liste mit Datum ein.
Jeden Prompt 30-mal ausführenVerwenden Sie die KI-Modelle, die Ihre Käufer nutzen, und protokollieren Sie die drei Zustände für jede Antwort.
Die Sichtbarkeitsrate berechnenErmitteln Sie Rate und Fehlermarge für jeden Prompt und schreiben Sie dann einen Satz pro Prompt, der sagt, was er zeigt.
Ihre Schlüsselseiten vergleichenStellen Sie sie den Beschreibungen gegenüber, die die KI liefert, und notieren Sie jede falsche oder fehlende Aussage.
Die nächste Charge planenFühren Sie sie zwei Wochen später aus, damit Sie dieselben Prompts in festem Rhythmus vergleichen.
Sobald Sie eine Ausgangsbasis haben, ist Volatilität keine Quelle der Unruhe mehr. Sie wird zu einer Spanne, die Sie messen können, und zu einer Reihe von Änderungen, auf die Sie sich einstellen können.
Häufig gestellte Fragen
Warum gibt ChatGPT auf dieselbe Frage unterschiedliche Antworten?
Sprachmodelle wählen jedes Wort aus einer Wahrscheinlichkeitsverteilung, deshalb kann derselbe Prompt andere Formulierungen, Markenlisten und Reihenfolgen liefern. Auch der Abruf ändert sich, weil das KI-Modell die Frage in Teilanfragen umformuliert und die abgerufenen Seiten von Durchlauf zu Durchlauf wechseln können.
Wie stark ändern sich KI-Suchantworten im Zeitverlauf?
Authoritas maß für KI-Übersichten einen Volatilitäts-Score von 0,68 nach 8 Wochen und 0,73 nach 13 Wochen, gegenüber 0,49 und 0,55 bei organischen Ergebnissen. SparkToro fand eine Chance von weniger als 1 zu 100, dass ChatGPT oder die KI von Google zweimal dieselbe Markenliste liefert.
Sollte ich meinen Rang in der KI-Suche noch verfolgen?
Eine einzelne Position in einer KI-Antwort ist zu instabil, um darauf zu reagieren. Erfassen Sie, wie oft Ihre Marke über viele Prompts und Durchläufe erscheint, berichten Sie diesen Anteil in Prozent mit seiner Fehlermarge und behalten Sie das klassische Rank-Tracking für organische Google-Ergebnisse bei, wo sich Positionen langsamer bewegen.
y!
Erhalten Sie kostenlos Ihren Content-Plan für 30 Tage
Wir analysieren Ihre Wettbewerber, Ihre Website und Ihre KI-Sichtbarkeit, um kostenlos einen maßgeschneiderten Content-Plan für Sie zu erstellen.
“Ich habe Sorank auf einer echten Kundenwebsite getestet, und es ist der Wahnsinn. Es macht alles, wofür eine Agentur 1.500 € im Monat berechnet. Jetzt geht es bei diesem Kunden in den Produktivbetrieb.”Guillaume Guersanguersanguillaume.com
“Wir sind eine Ads-Agentur und wollten unser SEO endgültig wieder auf Kurs bringen. Sorank hat uns eine klare Übersicht über unsere Website verschafft, uns geholfen, Optimierungen zu priorisieren und unsere Inhalte richtig zu strukturieren. Das Tool ist einfach zu bedienen, gut für ein Team konzipiert und sehr praktisch, um das Tracking zu zentralisieren, ohne zwischen mehreren Plattformen jonglieren zu müssen. Eine sehr solide Grundlage, um mit unserem SEO neu zu starten.”Gaspard MadouiWerbeagentur
“Ich habe mich dank Sorank auf GEO spezialisiert. Das GEO Leaderboard ermöglicht es mir, meinen Kunden ihre Position im Vergleich zu ihren Wettbewerbern auf ChatGPT zu zeigen. Das ist ein echter kommerzieller Differenzierungsfaktor.”MélanieFreelancer im Bereich SEO
“Hervorragender Service, funktioniert gut für unsere Website und hilft uns zu verstehen, wie wir sie verbessern können, um auf Google und anderswo besser zu ranken. Herzlichen Glückwunsch, machen Sie weiter, ich empfehle es.”Hugo T.E-Commerce-Händler