Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Bedankt! Je aanmelding is ontvangen!
Oeps! Er ging iets mis bij het versturen van het formulier.
Blauwe datapunten op een wit raster, de meeste verschuivend terwijl één stevig verankerd blijft, als illustratie van AI-zoekvolatiliteit.
Tools
Op deze pagina
Kort samengevat
AI-zoekvolatiliteit is de mate waarin de merken, URL's en volgorde van een AI-antwoord veranderen van de ene run naar de volgende en van de ene week naar de andere. Dezelfde vraag kan een andere merkenlijst, andere bronvermeldingen en een andere volgorde opleveren, omdat het antwoord met willekeur wordt gegenereerd en de ophaalstap ook verandert. Een positie binnen een AI-antwoord is daarom een zwakke maatstaf. Meet hoe vaak uw merk voorkomt over veel prompts en veel runs, en bouw vervolgens de bronnen op die uw aanwezigheid stabiel maken.
3 dagen gratis, daarna stop je wanneer je wilt. 90 dagen geld-terug-garantie, onder voorwaarden.
Wat AI-zoekvolatiliteit betekent
In de organische Google-zoekresultaten betekent volatiliteit dat uw positie voor een zoekwoord op en neer gaat. In AI-zoeken betekent het meer dan dat. Het antwoord zelf verschilt bij elke run. Een volatiel AI-antwoord kan op drie manieren veranderen: welke merken het noemt, welke URL's het citeert en in welke volgorde het ze opsomt. Elk van die elementen kan verschuiven zonder dat er één wijziging op uw website is.
Het verschil is belangrijk, omdat een ranking een vaste uitkomst is op een bepaald moment. Google levert een geordende lijst, en voor dezelfde zoekopdracht in dezelfde markt is die lijst grotendeels herhaalbaar. Een AI-model levert één steekproef uit een reeks mogelijke antwoorden. Uw merk heeft een kans om in die reeks voor te komen. Die kans kunt u meten, en dat is wat u kunt bijsturen.
Twee cijfers uit een studie uit 2026 laten zien hoe sterk het effect is. Rand Fishkin van SparkToro werkte samen met Patrick O'Donnell van Gumshoe.ai. Ongeveer 600 vrijwilligers stuurden 12 prompts naar ChatGPT, Claude en de AI van Google, in totaal 2961 runs. De onderzoekers vonden minder dan een kans op 100 dat ChatGPT of de AI van Google twee keer dezelfde merkenlijst teruggeeft. De kans op dezelfde merkenlijst in dezelfde volgorde was ongeveer één op 1000 runs. Het rapport van SparkToro, gedateerd 28 januari 2026, behandelt gegevens die in november en december 2025 zijn verzameld.
Hoe stabiel zijn AI-merkenlijsten?
2961runs over 12 prompts en drie AI-systemen
<1%kans dat ChatGPT of de AI van Google twee keer dezelfde merkenlijst teruggeeft
<0,1%kans op dezelfde merkenlijst in dezelfde volgorde
Bron: SparkToro en Gumshoe.ai, januari 2026
Zodra u accepteert dat het antwoord een steekproef is, moet de manier waarop u het volgt veranderen. De vergelijking hieronder vat de twee denkwijzen samen. Het is het kernidee van deze hele gids.
Een rang volgen of aanwezigheid volgen
Eén positie
Verandert bij bijna elke run
Eén antwoord zegt heel weinig
Aandeel van de runs
Gemeten over tientallen prompts
Laat een trend zien waar u op kunt handelen
Volatiliteit in merkenlijsten
De meest zichtbare verandering is de merkenlijst zelf. Een prompt als "beste projectmanagementtool voor een team van 10 personen" kan bij de ene run vijf merken noemen en bij de volgende vijf andere. Sommige merken komen vaak terug, andere wisselen in en uit. De aanwezigheid in de set is stabieler dan de positie binnen de set, daarom adviseren de onderzoekers om aanwezigheid te volgen in plaats van rang.
Daar hangt een praktisch gevolg aan. Als u een prompt één keer controleert en uw merk op plek twee ziet, weet u bijna niets. Als u hem 60 keer controleert en uw merk in 40 antwoorden ziet, weet u iets nuttigs: u bent een vaste keuze voor die vraag.
Volatiliteit in citaten
Citaten zijn de links die een AI-model als bron toont. Ze bewegen nog meer dan de merkenlijst wanneer het model een live webzoekopdracht uitvoert, omdat elke run een andere set pagina's kan ophalen. Een citaat dat verdwijnt is niet altijd een verlies. Uw merk kan nog steeds in de tekst worden genoemd zonder link. Daarom moet u twee dingen apart bijhouden: de genoemde vermelding en de geciteerde URL.
Volatiliteit in volgorde
De positie binnen een antwoord is het minst stabiele element. Een AI-model kan uw merk in de ene run op de eerste plaats zetten en in de volgende op de vierde, zonder dat het u echt anders ziet. Behandel de volgorde als ruis, tenzij die over tientallen runs in één richting verschuift.
Waarom identieke vragen verschillende antwoorden krijgen
Drie mechanismen veroorzaken het meeste van de verandering. U kunt ze niet uitschakelen, maar als u ze kent, weet u wat u moet meten en wat u moet negeren.
Steekproeftrekking
Een taalmodel kiest niet één beste antwoord. Het kiest elk volgend woord uit een kansverdeling. Een instelling die temperatuur heet, bepaalt hoe breed die keuze is. Bij een lage waarde komt de uitvoer dichter bij herhaalbaar, bij een hoge waarde varieert hij meer. Ontwikkelaars kunnen de temperatuur in een API instellen, maar de consumentenapps die de meeste van uw kopers gebruiken, tonen die niet. Ga ervan uit dat steekproeftrekking altijd actief is. De vrijwilligers van SparkToro hielden hun gebruikelijke instellingen aan, gepersonaliseerd of standaard, en daarom beschrijven hun resultaten wat een gewone gebruiker ziet.
Ophalen en subquery's
Wanneer een AI-model het web doorzoekt, stuurt het uw exacte vraag niet naar een zoekmachine. Het herschrijft de vraag in meerdere subquery's en haalt voor elk pagina's op. Een kleine wijziging in de formulering, een pagina die die ochtend is geïndexeerd of een ander resultaat voor één subquery kan veranderen welke bronnen het eindantwoord bereiken. De URL's waaruit u wordt geciteerd, zijn het resultaat van een ophaalstap die beweegt. Onze gids over hoe AI-zoekmachines hun bronnen kiezen legt het mechanisme uit, en de tracker van Sorank voor wat AI echt zoekt is precies gebouwd voor die vraag.
Updates van modellen en indexen
Aanbieders werken modellen en de systemen eromheen bij zonder veel aankondiging. Een nieuwe modelversie, een verandering in het moment waarop een model besluit te zoeken of een verschuiving in de webindex kan antwoorden over een heel onderwerp op één dag veranderen. Als uw gegevens een plotselinge sprong laten zien, controleer dan eerst op een waarschijnlijke update en vergelijk met uw uitgangspunt voordat u reageert.
Mechanisme
Wat verschuift
Hoe het zich toont
Wat u doet
Steekproeftrekking
Merkenlijst, formulering en volgorde
Verschillende antwoorden op dezelfde prompt op dezelfde dag
Meten over veel runs en een aandeel rapporteren
Ophalen
Geciteerde URL's
Van week tot week andere bronnen geciteerd
Pagina's en bronnen van derden versterken die goed worden opgehaald
Updates van modellen en indexen
Algemene antwoordstijl en welke merken worden voorgetrokken
Een plotselinge sprong op een specifieke datum
Een uitgangspunt bewaren en elke herkenbare update noteren
AI-antwoorden veranderen van run tot run. Aanwezigheid over veel runs is wat u kunt volgen en opbouwen.
Hoeveel AI-antwoorden verschuiven
Gemeten cijfers zijn nog schaars, en de meeste komen van SEO- en AI-zichtbaarheidsleveranciers. Twee bronnen verdienen een nauwkeurige lezing. De eerste is een studie van het SEO-platform Authoritas, dat AI Overviews vergeleek met organische resultaten. De tweede is een reeks metingen van BrightEdge, die AI Overviews vergeleek met AI Mode.
Authoritas mat de volatiliteit van rankings met een score. Hoe hoger de score, hoe meer de resultaten in de periode veranderden. Voor AI Overviews was de score 0,68 na 8 weken en 0,73 na 13 weken. Voor organische resultaten was dat 0,49 en 0,55. Digital Information World, dat de studie in februari 2025 besprak, meldde ook dat ongeveer 70% van de AI Overview-resultaten binnen twee tot drie maanden veranderde. Dat artikel vermeldde geen zoekwoordsteekproef en geen meetdata, dus controleer het originele Authoritas-rapport voordat u een cijfer in een klantpresentatie citeert.
Volatiliteitsscore van rankings na 8 weken
AI Overviews0,68
Organische resultaten0,49
Bron: studie van Authoritas, besproken door Digital Information World, februari 2025
AI Overview-resultaten die binnen 2 tot 3 maanden veranderden
70%van de gevolgde AI Overview-resultaten
Bron: studie van Authoritas, besproken door Digital Information World, februari 2025
BrightEdge heeft dezelfde vraag vanuit een andere invalshoek gemeten. De analyse van augustus 2025 vond 16,7% meer volatiliteit in merkvermeldingen bij AI Overviews dan bij AI Mode. Ook hield AI Overviews 24% van zijn URL's onveranderd, tegenover 20% bij AI Mode. De tabel zet die cijfers naast elkaar.
Maatstaf
AI Overviews
Vergelijking
Bron
Volatiliteitsscore, 8 weken
0,68
0,49 voor organische resultaten
Authoritas
Volatiliteitsscore, 13 weken
0,73
0,55 voor organische resultaten
Authoritas
Volatiliteit van merkvermeldingen
16,7% hoger
Vergeleken met AI Mode
BrightEdge, augustus 2025
Onveranderde URL's
24%
20% voor AI Mode
BrightEdge, augustus 2025
Waarom AI Overviews en AI Mode zich verschillend gedragen
AI Overviews verschijnen binnen de gewone Google-resultatenpagina voor een deel van de zoekopdrachten. AI Mode is een aparte, gespreksachtige interface. De cijfers van BrightEdge suggereren dat AI Overviews meer schommelen in de merken die ze noemen, terwijl AI Mode minder van zijn URL's stabiel houdt. De praktische les is elk oppervlak apart te controleren. Eén "Google AI"-getal verbergt het verschil, en dat verschil is precies waar u op moet plannen. Onze vergelijking van Google AI Mode en AI Overviews legt uit wat elk voor SEO betekent.
Het belangrijkste punt is dat u niet kunt aannemen dat organische stabiliteit overdraagbaar is. Organische resultaten zijn volgens de Authoritas-gegevens minder volatiel dan AI Overviews, maar ze staan niet stil. Een pagina die een maand op plek 3 staat, kan na een core update toch dalen. U hebt dus een methode nodig die echte verandering scheidt van gewone beweging op beide oppervlakken.
Waarom rank tracking in AI-zoeken faalt
De meeste rank trackers zijn gebouwd voor Google, waar een zoekwoord één geordende lijst heeft die langzaam verandert. Toegepast op een AI-model levert dezelfde logica een getal op dat op één steekproef is gebaseerd. Als uw merk bij de ene run derde staat en bij de volgende achtste, zegt het gemiddelde van die twee runs u bijna niets. Een tool die meldt "u staat nummer 3 in ChatGPT" presenteert één worp als een feit. Onze gids voor rank tracking behandelt de klassieke methode, en dit artikel legt uit wat er verandert wanneer het antwoord wordt gegenereerd in plaats van opgesomd.
De conclusie van SparkToro is dat rank-trackingproducten op basis van vaste posities ruis meten. Het advies van de studie is aanwezigheid te volgen in plaats van rang. Het noemt een zichtbaarheidspercentage een redelijke maatstaf wanneer het wordt gemeten over tientallen tot honderden prompts, elk meerdere keren uitgevoerd. Vraag elke leverancier om de steekproefgrootte en de methode achter een score te laten zien voordat u erop vertrouwt.
Eén prompt, één screenshot of een gemeten aandeel
Voor
Meldt één positie
Verandert bij de volgende run
Geen foutmarge, dus elke beweging lijkt echt
Na
Meldt het aandeel runs dat uw merk noemt
Laat een trend zien over meerdere weken
Geeft aan hoe groot een verandering moet zijn om mee te tellen
De eigen documentatie van Google wijst in dezelfde richting, om een andere reden. Google zegt dat een pagina geïndexeerd en in aanmerking moet komen om met een snippet in Zoeken te verschijnen, wil ze worden gebruikt in AI Overviews of AI Mode. Er is volgens Google ook geen speciale markup of AI-specifiek bestand nodig. Er bestaat geen instelling voor "AI-ranking" om te optimaliseren, dus het werk bestaat eruit aanwezig en betrouwbaar te zijn over veel bronnen, en die aanwezigheid eerlijk te meten.
Hoe u AI-zoekvolatiliteit meet, stap voor stap
De onderstaande methode kost een paar dagen om op te zetten en een paar minuten per week om bij te houden. U kunt hem in een spreadsheet uitvoeren. Gespecialiseerde tools besparen vooral de herhaling, niet het denkwerk.
De meetmethode in vijf stappen
Bouw een promptsetKies 20 tot 50 vragen die echte kopers stellen. Haal ze uit verkoopgesprekken, supportchats en Search Console-zoekopdrachten.
Voer elke prompt vaak uitHerhaal elke prompt minstens 30 keer per AI-model, idealiter 60 tot 100 keer zoals het team van SparkToro deed. Gebruik dezelfde instellingen en spreid de runs over meerdere dagen.
Leg elk antwoord vastNoteer of uw merk wordt genoemd, of het wordt aanbevolen of alleen vermeld, de positie en de geciteerde URL's.
Bereken het zichtbaarheidspercentageDeel de antwoorden die uw merk noemen door alle antwoorden en tel de foutmarge op voor elke prompt en elk AI-model.
Lees elke week de trendZet het percentage in de tijd uit en noteer modelupdates, uw contentwijzigingen en lanceringen van concurrenten.
De formule, met een uitgewerkt voorbeeld
Het zichtbaarheidspercentage is het aandeel antwoorden dat uw merk noemt. De foutmarge laat zien hoeveel van een verandering echt is. Gebruik een foutmarge van 95% die is gebaseerd op de standaardfout van een proportie:
zichtbaarheidspercentage = antwoorden die uw merk noemen / totaal aantal antwoorden
standaardfout = wortel(p x (1 - p) / n)     waarbij p het zichtbaarheidspercentage is en n het aantal runs
foutmarge (95%) = 1,96 x standaardfout
Hier is een illustratief voorbeeld, met verzonnen cijfers en niet met een meting. Uw merk verschijnt in 37 van 80 runs, dus het zichtbaarheidspercentage is 46%. De standaardfout is 5,6 punten, wat een foutmarge van 95% van ongeveer 11 punten geeft. Rapporteer het resultaat als 46% plus of min 11 punten. Als de volgende batch 40% laat zien, valt dat binnen de marge en is het geen signaal om uw pagina's te herschrijven.
Genoemd, aanbevolen en geciteerd zijn drie verschillende toestanden
Een merk kan genoemd worden zonder link, gelinkt worden zonder aanbevolen te worden, of aanbevolen worden in een zin die nooit een concurrent noemt. Leg deze toestanden apart vast: genoemd en aanbevolen, alleen genoemd en alleen geciteerd. Hun aandelen bewegen om verschillende redenen, en elk vraagt om een andere oplossing. Een citaat zonder vermelding is een bronprobleem. Een vermelding zonder aanbeveling is een positioneringsprobleem.
Uw eerste meetblad
Promptlijst bevroren en gedateerd, met nieuwe prompts als nieuwe rijen toegevoegd
Runs per AI-model vastgelegd, met de datum en de gebruikte instellingen
Drie toestanden vastgelegd: genoemd en aanbevolen, alleen genoemd, alleen geciteerd
Zichtbaarheidspercentage en foutmarge berekend voor elke prompt
Notitie
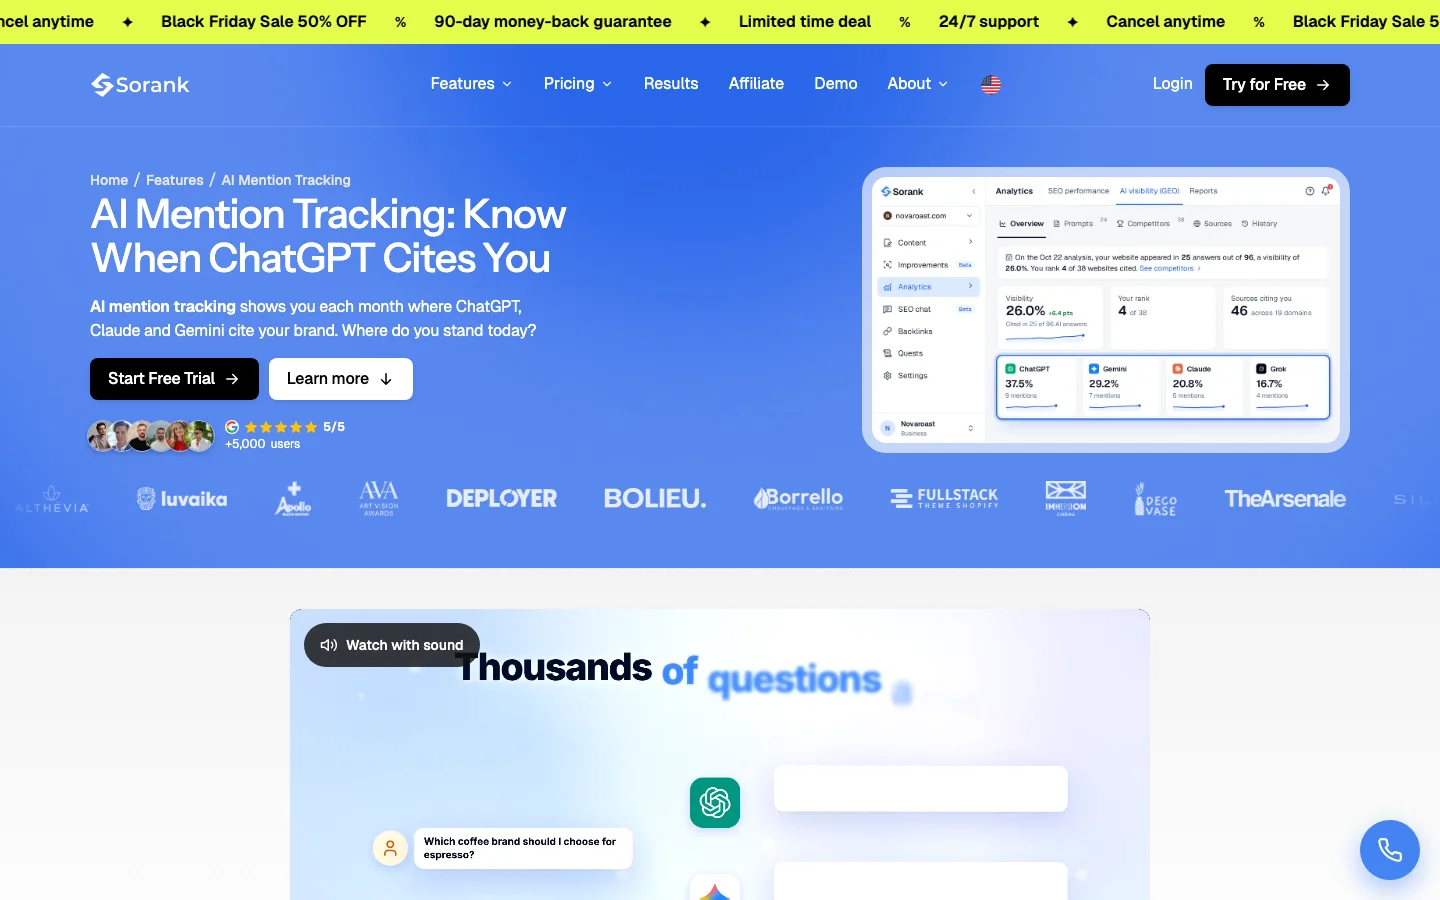
Elke prompt met de hand herhalen wordt na een paar weken vervelend. De AI Mention Tracking van Sorank laat voor elke gevolgde prompt zien hoe vaak ChatGPT, Claude en Gemini uw merk noemen, met de bronnen en zoekopdrachten achter elk antwoord. De meting draait maandelijks, wat voor één prompt een dunne steekproef is. Lees de trend dus over meerdere maanden en voeg uw eigen herhaalde runs toe voor de prompts die het belangrijkst zijn.
AI Mention Tracking rapporteert hoe vaak ChatGPT, Claude en Gemini uw merk citeren.
Rapporteren aan wie ervoor betaalt
Een maandelijks rapport moet één vraag beantwoorden: beweegt uw aanwezigheid, en is de beweging groter dan de ruis? Toon het zichtbaarheidspercentage per promptgroep met de foutmarge, niet één getal. Voeg de positieverdeling toe, dat wil zeggen hoe vaak uw merk op de eerste, tweede of een lagere plek staat in de antwoorden waarin het wordt genoemd, zodat de volgorde als spreiding zichtbaar wordt en niet als rang. Schommelen rond een vlakke of stijgende trend is normaal. Een gestage daling over meerdere batches is dat niet, en dan is het de moeite waard om de prompts, de releasenotities van de modellen en de geciteerde bronnen te controleren voordat iemand een pagina herschrijft. Schrijf de actieregel in het rapport zelf: een verandering telt pas als echt als ze twee batches achter elkaar de foutmarge overschrijdt.
Hoe u uw aanwezigheid stabieler maakt
U kunt volatiliteit niet uitschakelen, maar u kunt uw aanwezigheid consistenter maken. Aanwezigheid groeit wanneer uw merk op dezelfde manier wordt beschreven op meerdere bronnen die AI-modellen al gebruiken. De documentatie van Google geeft de basis van wat de eigen AI-functies nodig hebben.
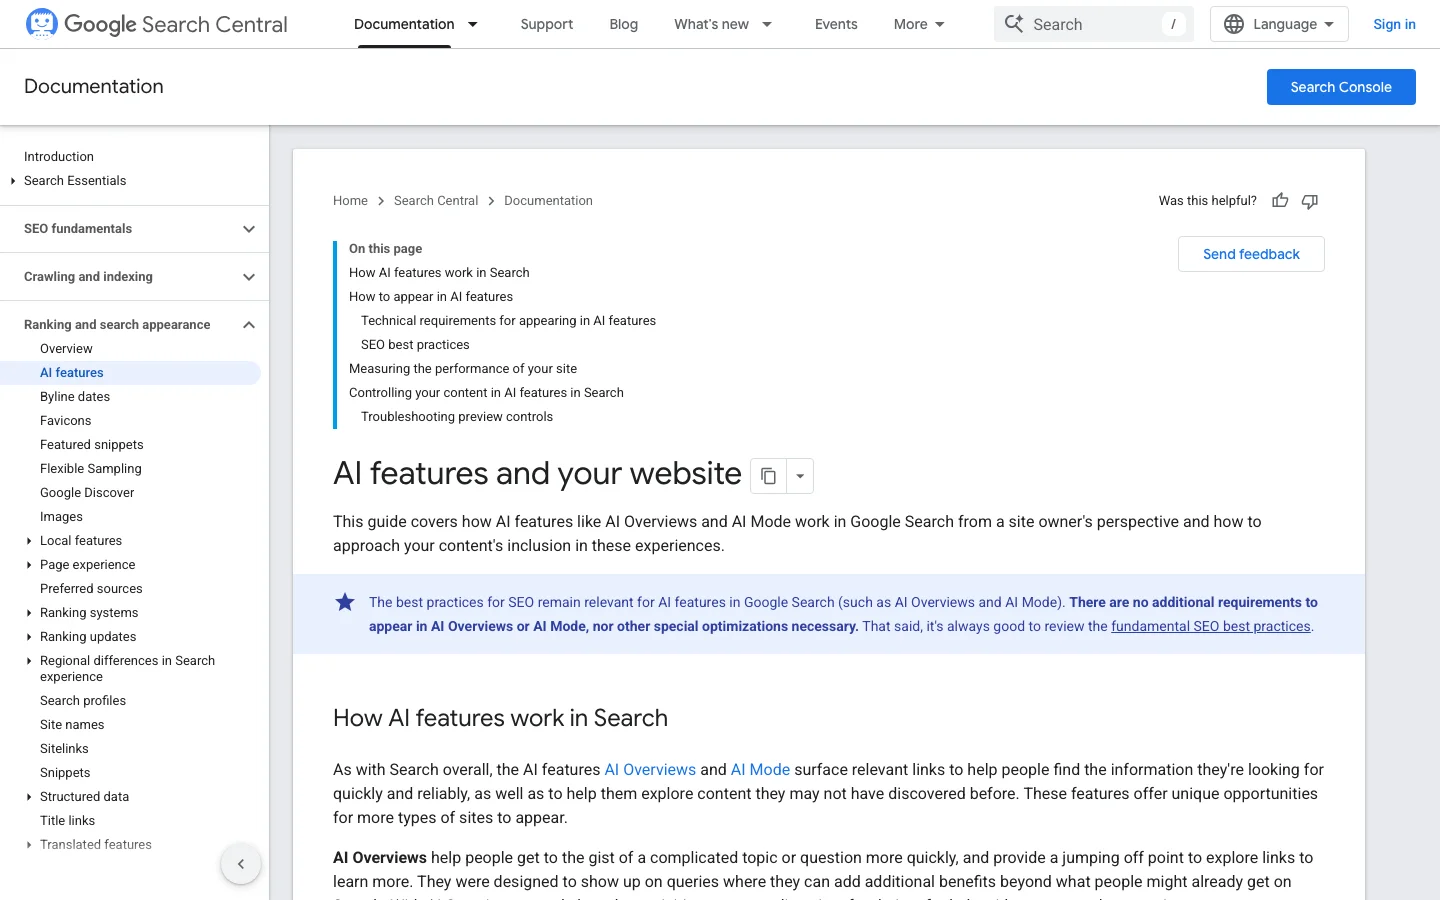
De richtlijnen van Google over AI Overviews en AI Mode zijn kort. Een pagina moet geïndexeerd zijn en in aanmerking komen om een snippet te tonen. De basisregels gelden nog steeds: robots.txt-regels die crawlen toestaan, interne links, voor lezers zichtbare tekst en gestructureerde gegevens die overeenkomen met de zichtbare tekst. Google zegt dat u geen nieuwe machineleesbare bestanden, AI-tekstbestanden of speciaal schema nodig hebt om te verschijnen.
De richtlijnen van Google over AI Overviews en AI Mode: er is geen speciale optimalisatie nodig.
Beschrijf uw merk overal op dezelfde manier
AI-modellen vormen een beeld van een merk uit veel plekken tegelijk. Als uw naam, categorie, belangrijkste gebruiksdoel en locatie verschillen tussen uw website, profielen en vermeldingen in directory's, wordt het beeld wazig en wordt de merkenlijst minder stabiel. Schrijf één korte, feitelijke beschrijving van uw bedrijf, met categorie en gebruiksdoelen, en hergebruik die waar u de tekst zelf beheert. Controleer die elk kwartaal.
Vermeldingen verdienen op bronnen die al betrouwbaar zijn
Bevestiging betekent dat meerdere onafhankelijke bronnen hetzelfde over u zeggen. Reviews, vergelijkingsartikelen, branchedirectory's en vakmedia in uw niche zijn de gebruikelijke plekken. Verdien die vermeldingen met nuttig werk, zoals originele data, een heldere productvergelijking of een tool die mensen echt gebruiken. Koop ze niet. Betaalde plaatsingen voegen ruis toe, en dat soort patroon breekt zodra de betalingen stoppen.
Beantwoord de hoofdvraag op elke kernpagina
AI-modellen halen passages op, geen hele pagina's. Een pagina die in de eerste alinea een korte definitie geeft, de hoofdvraag direct beantwoordt en een duidelijke volgende stap noemt, is makkelijker te extraheren en nauwkeuriger te citeren. Onze GEO-checklist somt de punten op die u op elke pagina moet controleren.
Stabiliteitschecklist voor uw merk
Kernpagina's geïndexeerd en in aanmerking voor een snippet
Dezelfde merknaam en categorie op elk profiel en in elke directory
Vermeldingen op meerdere onafhankelijke sites, niet alleen op de uwe
Gestructureerde gegevens die overeenkomen met de tekst die de lezer ziet
Een direct antwoord in de eerste alinea van elke kernpagina
Vier manieren om op volatiliteit te reageren
Teams reageren op volatiliteit op vier gebruikelijke manieren. Elk heeft een nut en een grens. Lees ze als opties die u kunt combineren, niet als een ranglijst van de beste. De meeste teams gebruiken de eerste en de laatste samen.
Dagelijkse rang volgen
Principe: elke dag één prompt uitvoeren en de positie van uw merk in het antwoord noteren. Wanneer gebruiken: u wilt een snelle vroege waarschuwing als één specifieke zoekopdracht sterk verandert. Voordelen: het is vertrouwd, goedkoop en makkelijk in een grafiek te zetten. Beperkingen: het is één steekproef per dag, en het kan geen echt verlies onderscheiden van een gewone schommeling. Voorbeeld: een prompt noemt uw merk op maandag en op woensdag niet. De grafiek toont een daling, maar één run kan niet bepalen of een positie verloren is of dat het een normale variatie is.
Aanwezigheid over veel runs volgen
Principe: veel prompts vaak uitvoeren en het aandeel antwoorden dat uw merk noemt rapporteren, met de foutmarge. Wanneer gebruiken: u hebt een getal nodig voor een rapport of voor een beslissing over contentinvesteringen. Voordelen: het sluit aan bij de manier waarop het antwoord wordt gegenereerd en geeft een bandbreedte in plaats van een vals punt. Beperkingen: het kost meer runs en vraagt discipline om de promptset stabiel te houden. Voorbeeld: uw zichtbaarheidspercentage is 46% plus of min 11 punten over 80 runs. Volgende maand is het 52%. U kunt zeggen dat de trend stijgt, maar nog niet dat het echte winst is, dus u wacht op nog een batch.
Bevestiging opbouwen over bronnen heen
Principe: dezelfde juiste uitspraken op meerdere onafhankelijke bronnen laten verschijnen. Wanneer gebruiken: uw positionering is helder en u wilt aanbevelingen die standhouden. Voordelen: het helpt in AI-antwoorden en in traditioneel zoeken, en het effect blijft. Beperkingen: het is traag en laat zelden binnen één maand resultaat zien. Voorbeeld: een softwarebedrijf ziet zijn gebruiksdoelen beschreven in twee reviews, een vergelijkingspagina en een branchedirectory, zodat AI-modellen dezelfde beschrijving herhalen bij verschillende prompts.
Kernpagina's verversen met directe antwoorden
Principe: de pagina's bijwerken die uw belangrijkste vragen beantwoorden, zodat het antwoord helder, correct en gedateerd is. Wanneer gebruiken: uw pagina wordt geciteerd maar verkeerd beschreven, of er wordt een concurrentpagina geciteerd waar die van u zou moeten staan. Voordelen: het is snel te doen en verbetert hoe passages worden opgehaald. Beperkingen: een betere pagina garandeert geen vermelding, en wijzigingen duren even voordat ze in uw gegevens zichtbaar zijn. Voorbeeld: een glossariumpagina krijgt bovenaan een definitie in één zin, een korte vergelijkingstabel en een zichtbare updatenotitie, en de volgende meetbatch toont de juiste beschrijving.
Methode
Wat het aangeeft
Stabiliteit van het signaal
Inspanning
Het best voor
Dagelijkse rang
Eén positie op één dag
Laag
Laag
Een scherpe verandering bij één zoekopdracht opmerken
Aanwezigheid over runs
Aandeel antwoorden dat uw merk noemt
Hoog, met foutmarge
Gemiddeld tot hoog
Rapportage en budgetbeslissingen
Bevestiging
Hoe consistent bronnen u beschrijven
Hoog over maanden
Hoog
Aanbevelingen op lange termijn
Paginaverversing
Hoe goed uw kernpagina's de vraag beantwoorden
Gemiddeld
Gemiddeld
Een foute of ontbrekende beschrijving corrigeren
Tools voor twee soorten volatiliteit
Organische Google-resultaten en AI-antwoorden hebben verschillende instrumenten nodig. Ze door elkaar halen leidt tot verkeerde conclusies, dus houd ze in uw rapportage gescheiden.
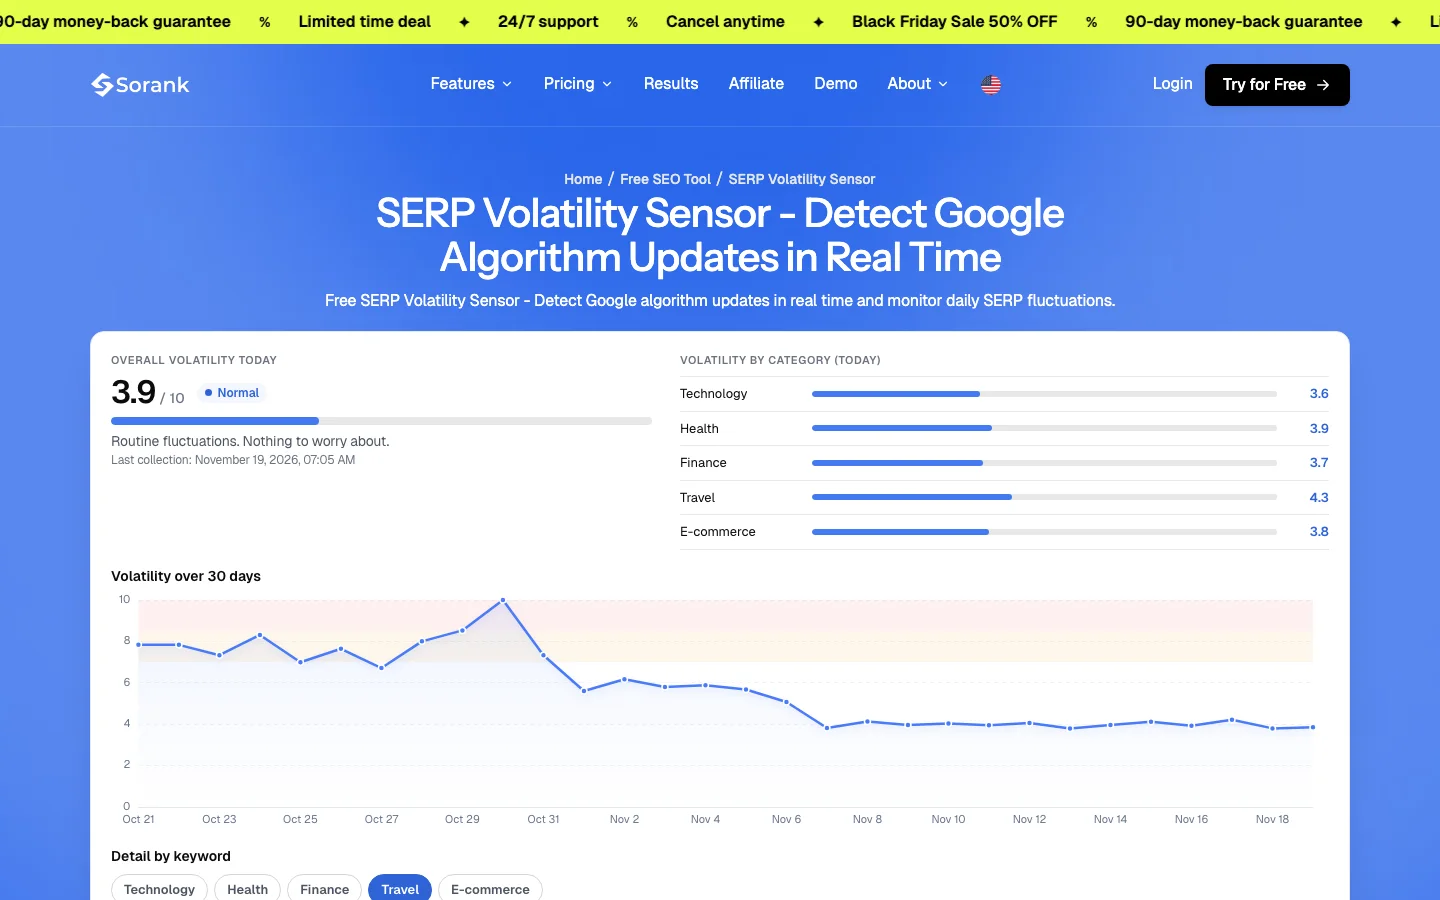
De gratis SERP Volatility Sensor van Sorank dekt het eerste type. Elke ochtend verzamelt hij de top 10 organische resultaten voor 20 Engelstalige Amerikaanse zoekwoorden uit vijf branches, vergelijkt ze met de dag ervoor en geeft een score van 0 tot 10, totaal en per branche. Hij laat zien hoeveel de eerste Google-pagina is veranderd, wat hem een nuttig vroeg signaal maakt voor algoritmewijzigingen. Hij meet geen AI-antwoorden en vervangt dus niet de promptmethode hierboven. Voor het Google-deel van de vraag leest u de sensor op zijn eigen pagina, en houdt u hem naast uw rankingdata, niet naast uw AI-zichtbaarheidscijfers.
De gratis SERP Volatility Sensor volgt organische Google-resultaten, niet AI-antwoorden.
Search Console en Google Analytics rapporteren Google-clicks en verwijzingsbezoeken. Een rank tracker rapporteert posities op Google. Geen van beide laat zien welke AI-antwoorden uw merk hebben genoemd. Daarvoor hebt u vastgelegde antwoorden nodig of een tool die ze vastlegt. Voor bezoeken die van AI-modellen komen, behandelt onze gids over GEO-rapportage de verwijzingskant.
Veelgemaakte fouten en hoe u ze oplost
De meeste volatiliteitsfouten ontstaan doordat ruis als signaal wordt gelezen. Elke fout hieronder laat zien hoe hij eruitziet, hoe u hem in uw gegevens herkent en hoe u hem oplost.
Eén run rapporteren als resultaat
Wat het is: één screenshot of één antwoord dat als uw positie wordt gepresenteerd. Hoe u het herkent: het rapport toont een positie zonder steekproefgrootte, zonder datumbereik en zonder foutmarge. Hoe u het oplost: rapporteer het zichtbaarheidspercentage over minstens 30 runs per prompt, met de foutmarge en het datumbereik.
De prompts wijzigen tussen controles
Wat het is: een prompt tussen twee controles herformuleren, bijvoorbeeld "beste CRM" in de ene week en "beste CRM voor startups" in de volgende, en het resultaat daarna als trend lezen. Hoe u het herkent: de prompttekst in het blad verschilt tussen twee data voor dezelfde rij. Hoe u het oplost: bevries de promptset en versioneer hem. Voeg een nieuwe prompt toe als nieuwe rij en wijzig nooit een oude.
Reageren op bewegingen binnen de foutmarge
Wat het is: een pagina herschrijven na een daling van vijf punten. Hoe u het herkent: de verandering is kleiner dan de foutmarge voor die prompt. Hoe u het oplost: handel alleen wanneer een verandering twee batches achter elkaar de foutmarge overschrijdt, en noteer wat er in dezelfde periode nog meer veranderde, zoals een modelupdate of de lancering van een concurrent.
Een citaat tellen als aanbeveling
Wat het is: elke link naar uw site als een overwinning registreren, ook wanneer het antwoord uw merk als een optie om te mijden of als voetnoot noemt. Hoe u het herkent: niemand leest de zin rond het citaat. Hoe u het oplost: leg de drie toestanden apart vast (genoemd en aanbevolen, alleen genoemd, alleen geciteerd) en lees de zin voordat u het vakje aanvinkt.
Prompts volgen die niemand intypt
Wat het is: prompts die het marketingteam voor een rapport heeft geschreven. Hoe u het herkent: de prompts gebruiken interne productnamen of jargon die klanten nooit gebruiken. Hoe u het oplost: haal prompts uit verkoopgesprekken, supportgesprekken en Search Console-zoekopdrachten, en toets er een paar bij echte klanten.
Verwachten dat AI-zichtbaarheid vanzelf kliks oplevert
Wat het is: aannemen dat een hoger zichtbaarheidspercentage automatisch meer bezoeken oplevert. Hoe u het herkent: het zichtbaarheidspercentage stijgt terwijl het aantal verwijzingssessies gelijk blijft. Hoe u het oplost: meet verwijzingsbezoeken apart, controleer welke AI-modellen en welke pagina's ze sturen, en koppel de twee datasets in één maandelijks rapport.
AI-specifieke bestanden toevoegen om AI-antwoorden na te jagen
Wat het is: een project starten voor een AI-tekstbestand of nieuwe markup, in de verwachting dat dit citaten oplevert. Hoe u het herkent: het project controleert niet op indexering of snippetgeschiktheid. Hoe u het oplost: begin met de richtlijnen van Google. Bevestig dat kernpagina's geïndexeerd zijn en in aanmerking komen voor een snippet, en corrigeer daarna eerst de tekst en de interne links.
Fout
Signaal in uw gegevens
Oplossing
Eén run gerapporteerd als resultaat
Geen steekproefgrootte of foutmarge
Een aandeel rapporteren over minstens 30 runs
Prompts bewerkt tussen controles
Zelfde rij, andere tekst, andere data
De promptset bevriezen en versioneren
Reageren binnen de foutmarge
Verandering kleiner dan de marge
Alleen handelen op veranderingen die twee batches standhouden
Citaat geteld als aanbeveling
Geen lezing van de zin eromheen
De drie toestanden apart vastleggen
Prompts die niemand intypt
Intern jargon in de promptlijst
Prompts afleiden uit de echte taal van klanten
Zichtbaarheid behandeld als verkeer
Stijgende zichtbaarheid, vlakke verwijzingen
Verwijzingen apart meten
Wat u deze week kunt doen
U hebt geen volledig programma nodig om te beginnen. De eerste week gaat over het opzetten van de meting, zodat de komende zes maanden leesbaar zijn. Volg deze stappen in volgorde.
Uw eerste week
Kies 20 promptsHaal ze uit de echte taal van uw klanten en bevries de lijst met een datum.
Voer elke prompt 30 keer uitGebruik de AI-modellen die uw kopers gebruiken en leg voor elk antwoord de drie toestanden vast.
Bereken het zichtbaarheidspercentageWerk het percentage en de foutmarge uit voor elke prompt, en schrijf daarna per prompt één zin die zegt wat hij laat zien.
Vergelijk uw kernpagina'sZet ze naast de beschrijvingen die AI geeft en noteer elke foute of ontbrekende bewering.
Plan de volgende batchVoer hem twee weken later uit, zodat u dezelfde prompts in een vast ritme vergelijkt.
Zodra u een uitgangspunt hebt, houdt volatiliteit op een bron van onrust te zijn. Ze wordt een bandbreedte die u kunt meten, en een reeks wijzigingen waar u op kunt plannen.
Veelgestelde vragen
Waarom geeft ChatGPT verschillende antwoorden op dezelfde vraag?
Taalmodellen kiezen elk woord uit een kansverdeling, dus dezelfde prompt kan andere formuleringen, merkenlijsten en volgordes opleveren. Ook de ophaalstap verandert, omdat het AI-model de vraag herschrijft in subquery's en de opgehaalde pagina's per run kunnen verschillen.
Hoeveel veranderen AI-zoekantwoorden in de tijd?
Authoritas mat voor AI Overviews een volatiliteitsscore van 0,68 na 8 weken en 0,73 na 13 weken, tegenover 0,49 en 0,55 voor organische resultaten. SparkToro vond minder dan een kans op 100 dat ChatGPT of de AI van Google twee keer dezelfde merkenlijst teruggeeft.
Moet ik mijn rang in AI-zoeken nog volgen?
Eén positie in een AI-antwoord is te instabiel om erop te handelen. Meet hoe vaak uw merk voorkomt over veel prompts en runs, rapporteer dat aandeel als percentage met de foutmarge, en houd klassieke rank tracking aan voor organische Google-resultaten, waar posities trager bewegen.
y!
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je $1500 per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer