Jouw privacy is belangrijk voor ons, daarom kun je bepaalde soorten opslag uitschakelen die niet nodig zijn voor de basiswerking van de website. Het blokkeren van categorieën kan invloed hebben op je ervaring op de website. Meer informatie (Cookiebeleid)
Hoe AI-assistenten hun bronnen kiezen: RAG, query fan-out en citatiecriteria
Hoe AI-assistenten bronnen kiezen: retrieval, query fan-out, wat OpenAI, Google, Perplexity, Anthropic en Microsoft documenteren, en wat onze data laten zien.
3 dagen gratis, daarna stop je wanneer je wilt. 90 dagen geld-terug-garantie.
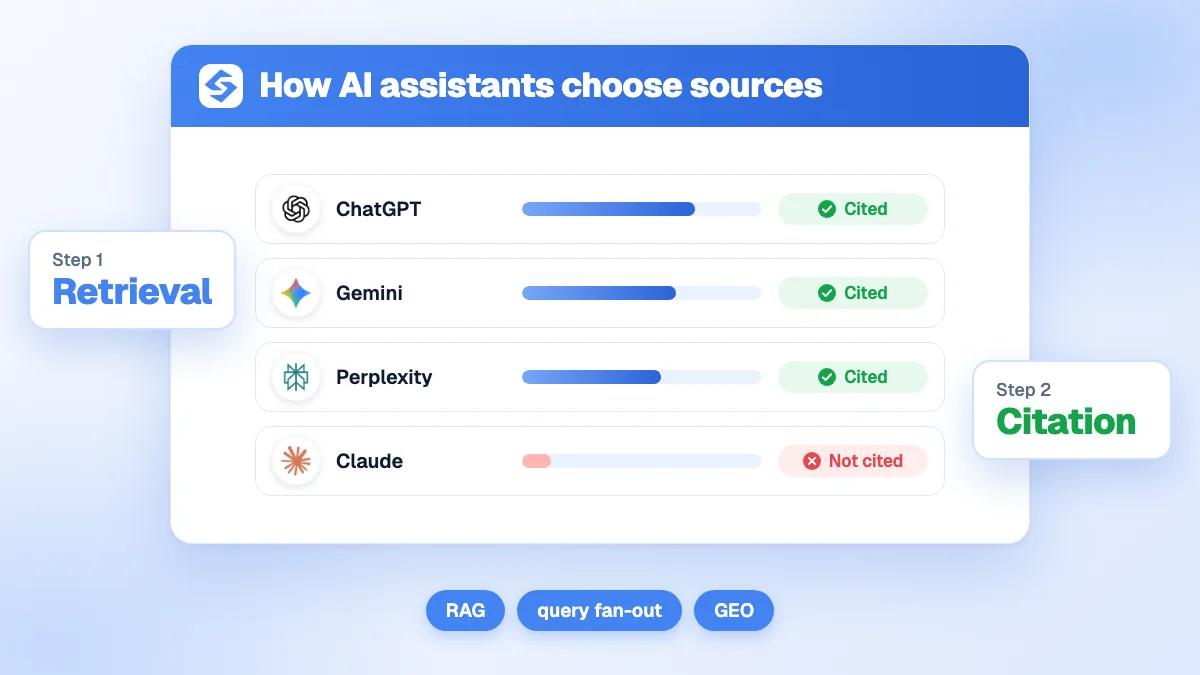
Kort gezegd: AI-assistenten kiezen hun bronnen in twee stappen. Eerst zoeken ze: het model zet de vraag om in een of meer webzoekopdrachten (query fan-out) en haalt kandidaat-pagina's op uit een zoekindex (Google, Bing, Brave of een eigen index). Daarna selecteren ze: het model leest passages, houdt de passages die een deelvraag helder en onderbouwd beantwoorden, en citeert ze. Een pagina moet dus bereikbaar zijn voor de bot van de assistent, geïndexeerd zijn, aansluiten op de verborgen deelzoekopdrachten en makkelijk te citeren zijn, en elke assistent geeft de voorkeur aan andere soorten sites.
Begrijpen hoe AI-assistenten hun bronnen kiezen is het startpunt van elk werk aan zichtbaarheid in AI. Het goede nieuws: de aanbieders documenteren meer dan je denkt. Google schrijft in zijn documentatie over AI-functies dat AI Overviews en AI Mode meerdere verwante zoekopdrachten over subonderwerpen kunnen uitvoeren, en dat een pagina alleen geïndexeerd en geschikt voor een snippet hoeft te zijn om als ondersteunende link te verschijnen. OpenAI, Perplexity, Anthropic en Microsoft publiceren vergelijkbare regels voor hun eigen assistenten. Deze gids bundelt wat officieel is, scheidt het van giswerk en voegt toe wat wij hebben gemeten op 301.025 AI-antwoorden.
Wat gebeurt er tussen een vraag en een antwoord met bronnen?
Bijna elke assistent met webtoegang volgt hetzelfde patroon, retrieval-augmented generation (RAG): het model antwoordt niet alleen uit het geheugen, het haalt eerst documenten op en schrijft daarna op basis daarvan. Dit zijn de stappen.
Beslissen of er gezocht wordt. Een vast feit (een definitie, een rekenregel) wordt uit de trainingsdata beantwoord. Een vraag over prijzen, producten, actualiteit of een bepaald bedrijf start een zoekopdracht.
Herformuleren en uitwaaieren. Het model zet de zin van de gebruiker om in een of meer kortere zoekopdrachten, elk voor één aspect van de vraag. Dat is query fan-out.
Kandidaten ophalen. Elke zoekopdracht gaat naar een zoekindex, die een lijst pagina's teruggeeft. Alleen pagina's die al in die index staan, kunnen worden opgehaald.
Passages lezen en filteren. Het model (of een filterstap) leest de resultaten en houdt de passages die een deelvraag beantwoorden. Pagina's concurreren passage per passage, daarom telt passage ranking zwaarder dan de pagina als geheel.
Schrijven en citeren. Het antwoord wordt opgebouwd uit de behouden passages, met links naar de pagina's waar ze vandaan komen.
Daaruit volgen twee dingen. Een pagina die niet in de index van de assistent staat, doet nooit mee, hoe goed ze ook is. En een pagina kan in Google op één staan voor de exacte vraag van de gebruiker en toch de citatie mislopen, omdat de assistent naar iets anders zocht.
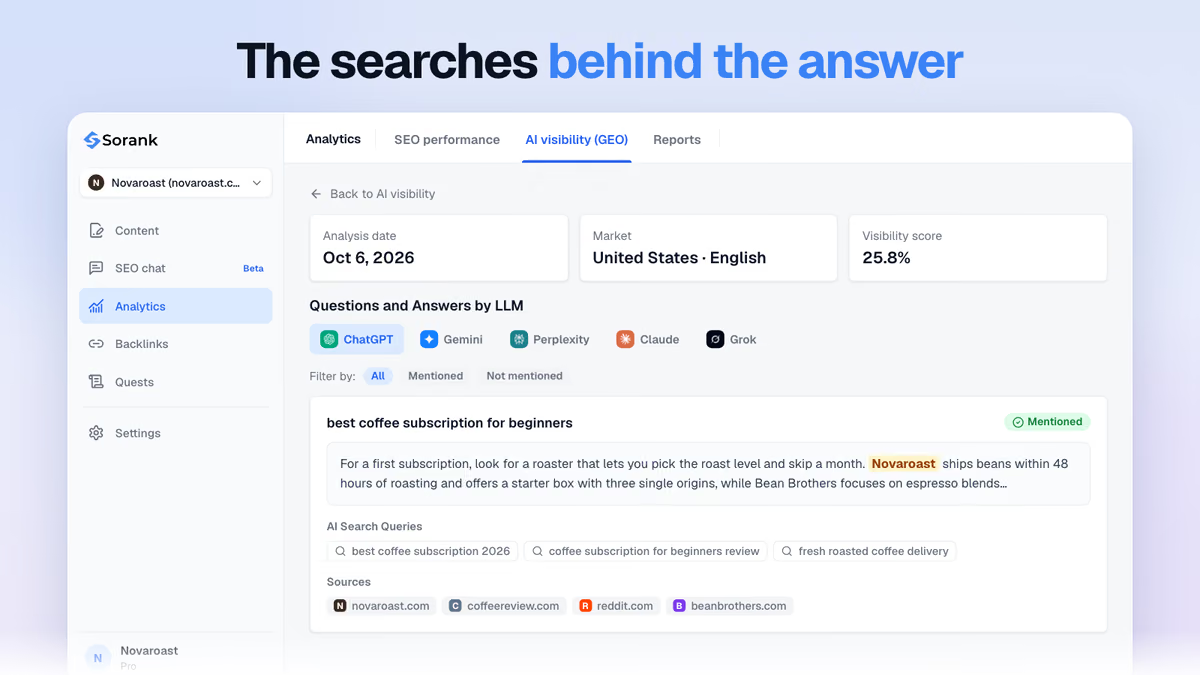
In Sorank toont elk gevolgd antwoord de zoekopdrachten die de AI achter de schermen uitvoerde: de zoekopdrachten waarop je pagina's moeten aansluiten om opgehaald te worden.
Wat documenteren OpenAI, Google, Perplexity, Anthropic en Microsoft?
Geen van de vijf publiceert een rankingformule. Elk van hen publiceert wel regels over toegang, indexering en citatie, en die regels zijn de enige vaste grond.
Assistent
Waar de kandidaten vandaan komen
Wat de aanbieder documenteert
Google (AI Overviews, AI Mode)
De index van Google
Query fan-out over subonderwerpen; een pagina moet geïndexeerd en snippet-geschikt zijn; geen speciaal bestand, markup of schema nodig
ChatGPT Search
Eigen crawler en zoekpartners
Sites die OAI-SearchBot blokkeren, verschijnen niet in de zoekantwoorden van ChatGPT; GPTBot gaat alleen over training
Perplexity
Eigen index, opgebouwd door PerplexityBot
PerplexityBot toont en linkt websites in de resultaten; Perplexity-User haalt een pagina op als de vraag van een gebruiker dat vereist
Claude
Een externe zoekindex (volgens berichten Brave) plus de bots van Anthropic
Claude beslist wanneer hij zoekt, kan per verzoek meerdere keren zoeken en voegt altijd citaties toe
Microsoft Copilot
De index van Bing
Citaties worden uitgelokt door grounding-zoekopdrachten, zichtbaar in Bing Webmaster Tools; actuele, gestructureerde en onderbouwde content wordt aanbevolen
OpenAI (ChatGPT)
De documentatie van OpenAI over zijn crawlers onderscheidt drie agents. OAI-SearchBot bouwt de zoekindex: sites die hem blokkeren, verschijnen niet in de zoekantwoorden van ChatGPT. GPTBot verzamelt trainingsdata, en hem blokkeren heeft geen effect op zoeken. ChatGPT-User bezoekt een pagina namens een gebruiker en bepaalt niet wat er in de zoekresultaten verschijnt. Onze gids over ranken in ChatGPT beschrijft de rest.
Google (AI Overviews en AI Mode)
Google is het duidelijkst: de AI-functies gebruiken dezelfde index en dezelfde kwaliteitssystemen als de klassieke zoekmachine, ze kunnen een fan-out van verwante zoekopdrachten uitvoeren en meer ondersteunende links tonen dan de tien blauwe links. Er is geen AI-specifieke markup nodig. Met andere woorden: SEO voor Google blijft het toegangsbewijs voor de AI-antwoorden van Google.
Perplexity
De botdocumentatie van Perplexity zegt dat PerplexityBot websites in de resultaten toont en linkt, en niet wordt gebruikt om basismodellen te trainen. Perplexity-User haalt pagina's in realtime op voor de vraag van een gebruiker. PerplexityBot toestaan in robots.txt is de voorwaarde om in de index te komen.
Anthropic (Claude)
De documentatie van Anthropic over webzoeken beschrijft de lus precies: Claude bepaalt op basis van de prompt wanneer hij zoekt, de zoekopdracht kan binnen één verzoek meerdere keren worden herhaald, en het eindantwoord bevat altijd citaties, elk met maximaal 150 tekens uit de bron. Claude zoekt bij actuele prijzen, nieuws en informatie over specifieke bedrijven of producten, en beantwoordt vaste kennis zonder te zoeken. Onze gids over ranken in Claude behandelt zijn crawlers en index.
Microsoft (Copilot)
Copilot steunt op Bing. Sinds februari 2026 bevat Bing Webmaster Tools een AI Performance-rapport dat laat zien hoe vaak een site in Copilot wordt geciteerd en via welke grounding-zoekopdrachten de pagina's werden opgehaald. Het advies van Microsoft in dezelfde aankondiging: houd content actueel (met IndexNow), structureer met duidelijke koppen, tabellen en FAQ's, en onderbouw beweringen met data en bronnen. Zie onze gids over ranken in Copilot, en die over ranken in Grok, de assistent van xAI, die veel minder documenteert.
Goed om te weten
Veel artikelen sommen "rankingfactoren" voor AI-antwoorden op met gewichten in procenten. Geen enkele aanbieder heeft zulke gewichten gepubliceerd. Behandel elke precieze formule als hypothese en baseer je op de gedocumenteerde regels hierboven en je eigen metingen.
Welke criteria bepalen wie wordt geciteerd?
Combineer je de officiële documentatie met wat je in antwoorden ziet, dan verklaren zes criteria de meeste citaties. De eerste twee zijn gedocumenteerde vereisten, de andere vaste patronen.
1. Toegang en indexering
De zoekbot van de assistent moet toegelaten zijn en de pagina moet in de index staan die hij raadpleegt: die van Google voor Gemini en AI Overviews, die van Bing voor Copilot, de eigen indexen van OpenAI en Perplexity, Brave voor Claude. Controleer je regels met onze gids over robots.txt voor AI-crawlers.
2. Aansluiting op de verborgen deelzoekopdrachten
Ophalen gebeurt op de fan-out-zoekopdrachten, niet op de zin van de gebruiker. Een pagina die "beste CRM" in het algemeen beantwoordt, kan verliezen van een pagina die "CRM voor een makelaarskantoor met 5 mensen, prijs per gebruiker" beantwoordt, omdat de assistent precies daarnaar zocht.
3. Passages die op zichzelf te citeren zijn
AI-assistenten citeren passages. Een sectie die opent met een direct antwoord, een definitie, een tabelrij of een genummerde stap kan uit de pagina worden gehaald en blijft begrijpelijk. Een vage inleiding niet.
4. Bewijs en actualiteit
Claude zoekt juist wanneer informatie veranderd kan zijn, en Microsoft raadt aan beweringen met data en bronnen te onderbouwen. Gedateerde cijfers, genoemde bronnen, prijzen die op een bepaalde datum zijn "gecontroleerd" en zichtbare updatedata maken een pagina veiliger om te citeren.
5. Bevestiging elders
Een assistent die hetzelfde feit op meerdere onafhankelijke sites vindt, kan het met zekerheid noemen. Dat is entiteitsconsensus: reviews, vergelijkingen, gidsen en persvermeldingen die je merk op dezelfde manier beschrijven.
6. Het soort bron dat elk model verkiest
Elke assistent heeft zijn gewoonten. Sommige leunen op encyclopedische bronnen, andere op video, forums of reviewplatforms. Het volgende deel laat zien hoe groot die verschillen zijn.
Tip
Stel de vraag aan twee of drie assistenten voordat je een pagina voor AI-zichtbaarheid schrijft, en noteer welke zoekopdrachten ze uitvoeren en welke sites ze citeren. De zoekopdrachten vertellen je welke invalshoek je moet dekken; de geciteerde sites welk format wint.
Wat laten onze citatiestudies zien?
Onze studie naar de platforms die AI citeert analyseerde 301.025 antwoorden van ChatGPT, Gemini, Perplexity, Claude en Grok, verzameld tussen augustus 2025 en augustus 2026 op een panel van koopvragen (79% in het Frans gesteld). Ze telde 1.820.738 AI-citaties naar 131.349 verschillende domeinen. Twee bevindingen zijn belangrijk voor de bronselectie.
Ten eerste citeren assistenten niet evenveel bronnen. Gemini noemt gemiddeld 11,1 bronnen per antwoord, Grok 7,1, ChatGPT 4,1, Claude 3,5 en Perplexity 3,3. Bij de laatste drie biedt een vraag drie of vier plaatsen: de op één na beste pagina zijn betekent vaak dat je helemaal niet wordt geciteerd.
Platform
ChatGPT
Gemini
Perplexity
Claude
Grok
Wikipedia
3,43%
1,38%
0,19%
0,03%
1,08%
YouTube
0,04%
3,69%
3,46%
0%
2,76%
Reddit
0,33%
2,5%
1,51%
0%
4,11%
Trustpilot
2,7%
4,33%
1,21%
1,57%
1,8%
Ten tweede verschillen de voorkeursbronnen volledig per assistent. Wikipedia verschijnt in 3,43% van de ChatGPT-antwoorden en in 0,03% van de Claude-antwoorden; YouTube in 3,69% van de Gemini-antwoorden en in 0,04% van de ChatGPT-antwoorden. Slechts 6 platforms worden door alle vijf de modellen geciteerd. Onze ChatGPT-citatiestudie laat ook zien dat de selectie in de tijd verandert: ChatGPT ging in de periode van 5,8 naar 4,1 bronnen per antwoord, met een dieptepunt van 1,7 in juni 2026.
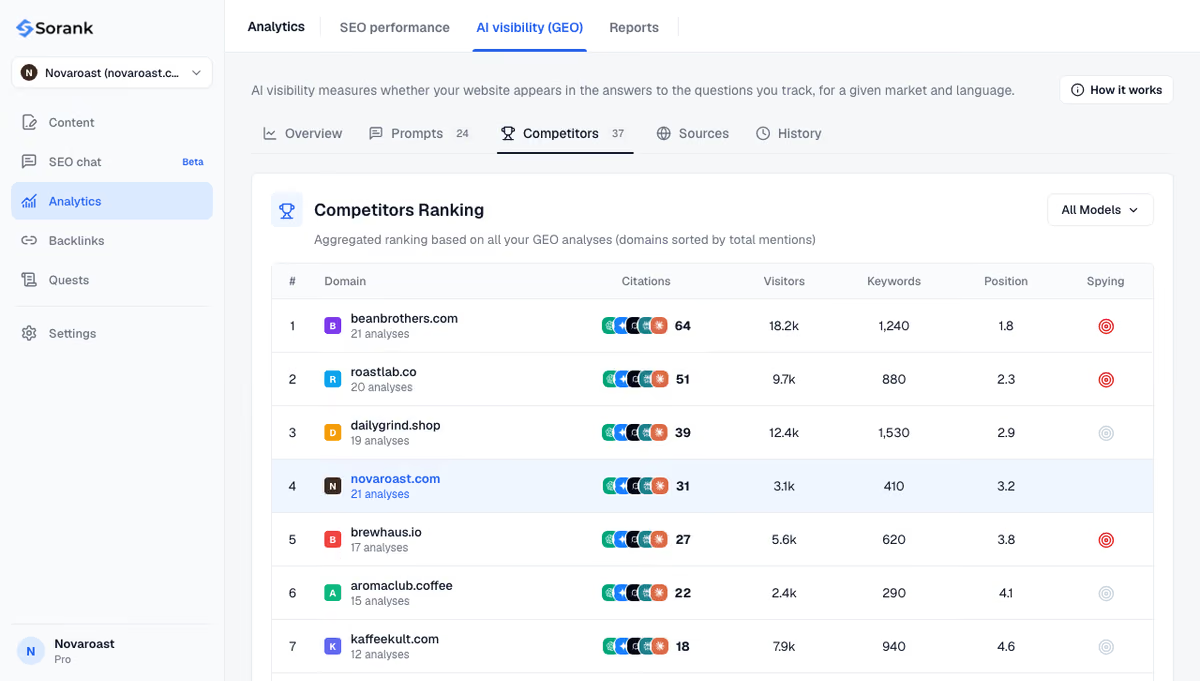
De GEO-ranglijst van Sorank rangschikt de domeinen die AI het vaakst citeert op de vragen in jouw markt, zodat je ziet wie de plaatsen bezet.
Hoe word je een van de bronnen die AI-assistenten kiezen?
Het selectieproces vertaalt zich in een korte lijst acties, die zowel voor Google als voor AI gelden.
Zet de deuren open: sta OAI-SearchBot, PerplexityBot, Claude-SearchBot, Claude-User, Googlebot en Bingbot toe; controleer dat je CDN ze niet blokkeert.
Wees geïndexeerd waar het telt: Google Search Console en Bing Webmaster Tools, een schone sitemap, IndexNow voor snelle updates.
Dek de deelzoekopdrachten: één pagina per precieze vraag, opgebouwd uit de zoekopdrachten die assistenten echt uitvoeren.
Schrijf passages met het antwoord vooraan: een direct antwoord bovenaan elke sectie, tabellen voor vergelijkingen, één idee per sectie, zoals in onze gids over content optimaliseren voor AI-zoeken.
Bewijs en dateer: bronnen, cijfers, auteurs, zichtbare updatedata.
Verdien bevestiging: reviews en vermeldingen op de platforms die de assistenten van je kopers echt citeren.
Voorbeeld
Een koper vraagt: "welke boekhoudsoftware voor een zzp'er in Nederland?". De assistent zoekt op "boekhoudsoftware zzp prijs" en "facturatieprogramma zzp vergelijken". Een aanbieder met een openbare prijspagina en een vergelijking die dit jaar is gedateerd, sluit aan op beide zoekopdrachten; een aanbieder met alleen een slogan op de homepage op geen enkele.
Antwoorden verschillen per keer, dus bronselectie volg je het best over weken. AI-query-fan-out van Sorank registreert de zoekopdrachten die elke assistent op je prompts uitvoert en telt ze in de tijd, en AI-vermeldingstracking laat zien of je merk wordt geciteerd en welke bronnen de plaats innemen als dat niet zo is. AI-assistenten kiezen de pagina's die ze kunnen bereiken, die aansluiten op hun verborgen zoekopdrachten en die bewijzen wat ze zeggen: meet die drie punten op je eigen vragen en je weet wat je moet verbeteren.
Veelgestelde vragen
Gebruiken AI-assistenten Google om bronnen te vinden?
Dat hangt af van de assistent. AI Overviews, AI Mode en Gemini gebruiken de index van Google, Microsoft Copilot gebruikt Bing, ChatGPT en Perplexity hebben eigen crawlers en indexen, en Claude gebruikt volgens berichten Brave Search. Een pagina die goed geïndexeerd is in Google en Bing dekt de meeste gevallen, mits ook de bot van elke assistent is toegestaan.
Garandeert een eerste plek in Google een citatie in AI-antwoorden?
Nee. Assistenten zoeken met hun eigen geherformuleerde zoekopdrachten en citeren passages, geen posities. Een pagina die op één staat voor de exacte vraag van de gebruiker kan worden overgeslagen als ze de deelvraag waarnaar de assistent zocht niet beantwoordt, of als een andere pagina het antwoord helderder en onderbouwd geeft. Goede posities in Google vergroten de kans, zonder iets te garanderen.
Waarom citeren ChatGPT, Gemini en Claude verschillende sites voor dezelfde vraag?
Ze gebruiken verschillende indexen, voeren verschillende zoekopdrachten uit en hebben verschillende bronvoorkeuren. Onze studie van 301.025 antwoorden laat bijvoorbeeld zien dat Wikipedia in 3,43% van de ChatGPT-antwoorden verschijnt maar in slechts 0,03% van de Claude-antwoorden, terwijl YouTube vaak voorkomt bij Gemini en bijna afwezig is bij ChatGPT. Optimaliseren voor één assistent werkt niet automatisch door naar de andere.
y!
Gratis SEO- en GEO-audit
Ontvang gratis je contentplan voor 30 dagen
We analyseren je concurrenten, je website en je AI-zichtbaarheid om gratis een contentplan op maat voor je te maken.
“Ik heb Sorank getest op de site van een echte klant en het is waanzinnig. Het doet alles waar een bureau je 1500€ per maand voor rekent. Het gaat nu bij die klant in productie.”Guillaume Guersanguersanguillaume.com
“Wij zijn een advertentiebureau en wilden onze SEO eens en voor altijd weer op de rails krijgen. Sorank gaf ons een helder beeld van onze site, hielp ons optimalisaties te prioriteren en onze content goed te structureren. De tool is makkelijk in gebruik, goed ontworpen voor een team en erg handig om het volgen te centraliseren zonder met meerdere platforms te hoeven jongleren. Een heel solide basis om met onze SEO opnieuw te beginnen.”Gaspard MadouiAdvertentiebureau
“Dankzij Sorank heb ik me gespecialiseerd in GEO. Met de GEO-ranglijst kan ik mijn klanten hun positie ten opzichte van concurrenten in ChatGPT laten zien. Het is een echt commercieel onderscheidend vermogen.”MélanieFreelance SEO-specialist
“Geweldige service, werkt goed voor onze website en helpt ons begrijpen hoe we die kunnen verbeteren om beter te scoren in Google en elders. Gefeliciteerd, ga zo door, ik raad het aan.”Hugo T.E-commerce-ondernemer