A privacidade é importante para nós, então você tem a opção de desativar certos tipos de armazenamento que podem não ser necessários para o funcionamento básico do site. O bloqueio de categorias pode afetar sua experiência no site. Mais informações (Política de cookies)
Como os assistentes de IA escolhem suas fontes: RAG, fan-out de consultas e critérios de citação
Como as IAs escolhem suas fontes: recuperação, fan-out de consultas, o que OpenAI, Google, Perplexity, Anthropic e Microsoft documentam, e nossos dados.
Capa do guia da Sorank sobre como os assistentes de IA escolhem as fontes que citam
Ferramentas
Nesta página
Em resumo
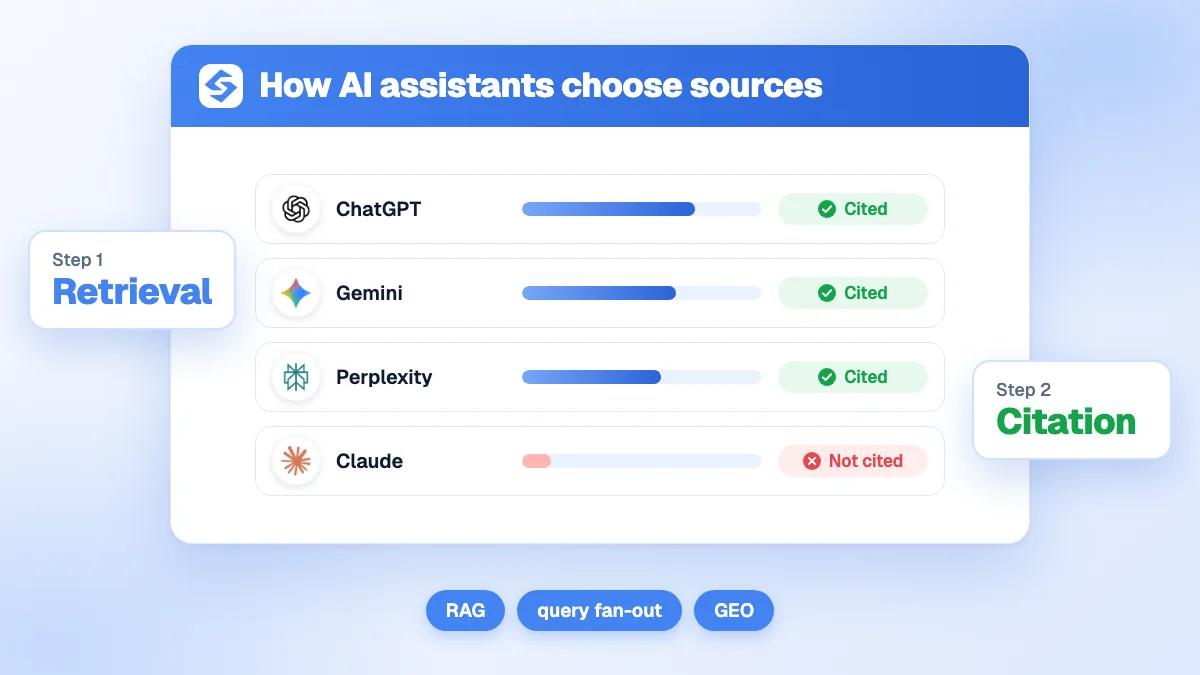
os assistentes de IA escolhem suas fontes em duas etapas. Primeiro eles buscam: o modelo transforma a pergunta em uma ou várias buscas na web (o fan-out de consultas) e obtém páginas candidatas de um índice de busca (Google, Bing, Brave ou um próprio). Depois eles selecionam: o modelo lê trechos, mantém os que respondem a uma subpergunta com clareza e com provas, e os cita. Por isso uma página precisa estar acessível ao bot do assistente, indexada, ser pertinente para as subconsultas ocultas e fácil de citar, e cada assistente prefere tipos de sites diferentes.
3 dias grátis, depois você para quando quiser. Garantia de reembolso de 90 dias.
Entender como as IAs escolhem suas fontes é o ponto de partida de qualquer trabalho de visibilidade nas IAs. A boa notícia é que as empresas documentam mais do que se imagina. O Google afirma em sua documentação sobre recursos de IA que AI Overviews e o Modo IA podem fazer várias buscas relacionadas sobre subtemas, e que uma página só precisa estar indexada e qualificada para snippet para aparecer como link de apoio. OpenAI, Perplexity, Anthropic e Microsoft publicam regras parecidas para seus assistentes. Este guia reúne o que é oficial, separa isso das suposições e acrescenta o que medimos em 301.025 respostas de IA.
O que acontece entre uma pergunta e uma resposta com fontes?
Quase todo assistente com acesso à web segue o mesmo padrão, chamado geração aumentada por recuperação (RAG): o modelo não responde só de memória, ele primeiro recupera documentos e depois escreve com base neles. As etapas são as seguintes.
Decidir se vai buscar. Um fato estável (uma definição, uma regra de cálculo) é respondido com os dados de treinamento. Uma pergunta sobre preços, produtos, notícias ou uma empresa específica dispara uma busca.
Reformular e desdobrar. O modelo transforma a frase do usuário em uma ou várias consultas mais curtas, cada uma cobrindo uma faceta da pergunta. É o fan-out de consultas.
Recuperar candidatos. Cada consulta vai para um índice de busca, que devolve uma lista de páginas. Só podem ser recuperadas as páginas que já estão nesse índice.
Ler e filtrar trechos. O modelo (ou uma etapa de filtragem) lê os resultados e mantém os trechos que respondem a uma subpergunta. As páginas competem trecho a trecho, por isso o ranqueamento de trechos pesa mais que a página inteira.
Escrever e citar. A resposta é montada com os trechos retidos, com links para as páginas de origem.
Daí vêm duas consequências. Uma página que não está no índice usado pelo assistente nunca entra na disputa, por melhor que seja. E uma página pode estar em primeiro no Google para a pergunta exata do usuário e ainda assim perder a citação, porque o assistente buscou outra coisa.
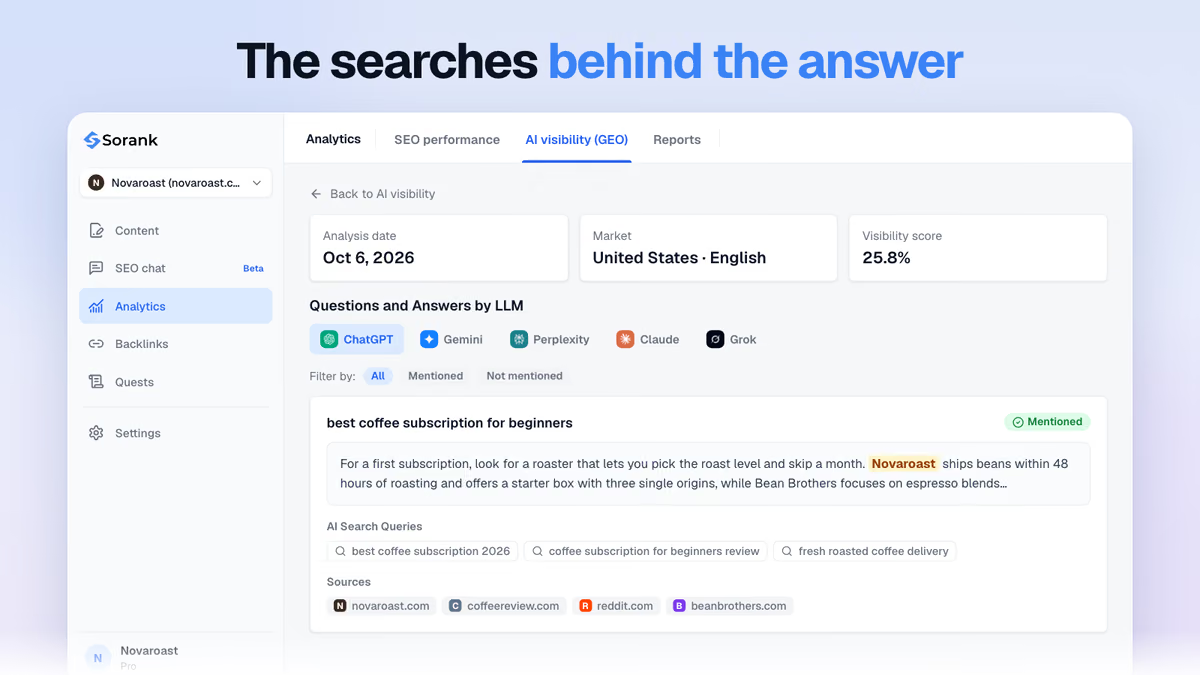
Na Sorank, cada resposta acompanhada mostra as buscas que a IA fez nos bastidores: as consultas com as quais suas páginas precisam coincidir para serem recuperadas.
O que OpenAI, Google, Perplexity, Anthropic e Microsoft documentam?
Nenhuma das cinco publica uma fórmula de ranqueamento. Todas publicam, por outro lado, regras de acesso, indexação e citação, e essas regras são o único terreno firme.
Assistente
De onde vêm os candidatos
O que a empresa documenta
Google (AI Overviews, Modo IA)
O índice do Google
Fan-out de consultas sobre subtemas; a página precisa estar indexada e qualificada para snippet; nenhum arquivo, marcação ou schema especial é exigido
Busca do ChatGPT
Rastreador próprio e parceiros de busca
Sites que bloqueiam o OAI-SearchBot não aparecem nas respostas de busca do ChatGPT; o GPTBot só diz respeito ao treinamento
Perplexity
Índice próprio, construído pelo PerplexityBot
O PerplexityBot exibe e cria links para sites nos resultados; o Perplexity-User busca uma página quando a pergunta de um usuário exige
Claude
Um índice de busca externo (Brave, segundo a imprensa) mais os bots da Anthropic
O Claude decide quando buscar, pode buscar várias vezes por pedido e sempre anexa citações
Microsoft Copilot
O índice do Bing
As citações são disparadas por consultas de grounding, visíveis no Bing Webmaster Tools; recomenda-se conteúdo atualizado, estruturado e com fontes
OpenAI (ChatGPT)
A documentação da OpenAI sobre seus rastreadores distingue três agentes. O OAI-SearchBot constrói o índice de busca: sites que o bloqueiam não aparecem nas respostas de busca do ChatGPT. O GPTBot coleta dados de treinamento, e bloqueá-lo não tem efeito sobre a busca. O ChatGPT-User visita uma página em nome de um usuário e não decide o que aparece na busca. Nosso guia para ranquear no ChatGPT detalha o resto.
Google (AI Overviews e Modo IA)
O Google é o mais explícito: os recursos de IA usam o mesmo índice e os mesmos sistemas de qualidade da busca clássica, podem fazer um fan-out de buscas relacionadas e mostrar mais links de apoio do que os dez links azuis. Não há nenhuma marcação específica para IA a adicionar. Em outras palavras, o SEO no Google continua sendo o ingresso para as respostas de IA do Google.
Perplexity
A documentação dos bots do Perplexity informa que o PerplexityBot existe para exibir e criar links para sites em seus resultados e não é usado para treinar modelos de base. O Perplexity-User busca páginas em tempo real para a pergunta de um usuário. Permitir o PerplexityBot no robots.txt é a condição para estar em seu índice.
Anthropic (Claude)
A documentação de busca na web da Anthropic descreve o ciclo com precisão: o Claude determina quando buscar de acordo com o prompt, a busca pode se repetir várias vezes em um mesmo pedido e a resposta final sempre traz citações, cada uma com até 150 caracteres da fonte. O Claude busca para preços atuais, notícias e informações sobre empresas ou produtos específicos, e responde sem buscar sobre conhecimentos estáveis. Nosso guia para ranquear no Claude trata de seus rastreadores e de seu índice.
Microsoft (Copilot)
O Copilot se apoia no Bing. Desde fevereiro de 2026, o Bing Webmaster Tools inclui um relatório AI Performance que mostra quantas vezes um site é citado no Copilot e as consultas de grounding que recuperaram suas páginas. Os conselhos da Microsoft no mesmo anúncio: manter o conteúdo atualizado (com IndexNow), estruturá-lo com títulos claros, tabelas e perguntas frequentes, e apoiar as afirmações com dados e fontes. Veja nosso guia para ranquear no Copilot, e o guia para ranquear no Grok, o assistente da xAI, que documenta bem menos.
Observação
Muitos artigos listam "fatores de ranqueamento" das respostas de IA com pesos em porcentagem. Nenhuma empresa publicou esses pesos. Trate qualquer fórmula precisa como hipótese e baseie-se nas regras documentadas acima e nas suas próprias medições.
Quais critérios decidem quem é citado?
Cruzando a documentação oficial com o que se observa nas respostas, seis critérios explicam a maioria das citações. Os dois primeiros são requisitos documentados; os demais, padrões constantes.
1. Acesso e indexação
O bot de busca do assistente precisa estar liberado e a página precisa estar no índice que ele consulta: o do Google para o Gemini e os AI Overviews, o do Bing para o Copilot, os índices próprios da OpenAI e do Perplexity, o Brave para o Claude. Confira suas regras com nosso guia de robots.txt para rastreadores de IA.
2. Correspondência com as subconsultas ocultas
A recuperação acontece nas consultas do fan-out, não na frase do usuário. Uma página que responde a "melhor CRM" de forma geral pode perder para uma página que responde a "CRM para uma imobiliária de 5 pessoas, preço por usuário", porque foi isso que o assistente buscou.
3. Trechos citáveis sozinhos
As IAs citam trechos. Uma seção que começa com uma resposta direta, uma definição, uma linha de tabela ou um passo numerado pode ser extraída da página e manter o sentido. Uma introdução vaga, não.
4. Provas e atualização
O Claude busca justamente quando uma informação pode ter mudado, e a Microsoft recomenda apoiar as afirmações com dados e fontes. Números datados, fontes nomeadas, preços "verificados" em uma data e datas de atualização visíveis tornam uma página mais segura de citar.
5. Confirmação em outros lugares
Um assistente que encontra o mesmo fato em vários sites independentes pode afirmá-lo com segurança. É o consenso de entidade: avaliações, comparativos, diretórios e menções na imprensa que descrevem sua marca da mesma forma.
6. O tipo de fonte que cada modelo prefere
Cada assistente tem seus hábitos. Alguns se apoiam em fontes enciclopédicas, outros em vídeo, fóruns ou plataformas de avaliação. A próxima seção mostra o tamanho dessas diferenças.
Dica
Antes de escrever uma página para visibilidade nas IAs, faça a pergunta a dois ou três assistentes e anote as buscas que eles fazem e os sites que citam. As buscas dizem qual ângulo cobrir; os sites citados, qual formato vence.
O que mostram nossos estudos de citações?
Nosso estudo das plataformas citadas pelas IAs analisou 301.025 respostas do ChatGPT, Gemini, Perplexity, Claude e Grok, coletadas entre agosto de 2025 e agosto de 2026 em um painel de perguntas de compradores (79% feitas em francês). Ele contou 1.820.738 citações de IA apontando para 131.349 domínios distintos. Dois resultados importam para a seleção de fontes.
Primeiro, os assistentes não citam o mesmo número de fontes. O Gemini cita em média 11,1 fontes por resposta, o Grok 7,1, o ChatGPT 4,1, o Claude 3,5 e o Perplexity 3,3. Nesses três últimos, uma pergunta oferece três ou quatro vagas: ser a segunda melhor página muitas vezes significa não ser citado.
Plataforma
ChatGPT
Gemini
Perplexity
Claude
Grok
Wikipedia
3,43%
1,38%
0,19%
0,03%
1,08%
YouTube
0,04%
3,69%
3,46%
0%
2,76%
Reddit
0,33%
2,5%
1,51%
0%
4,11%
Trustpilot
2,7%
4,33%
1,21%
1,57%
1,8%
Segundo, os tipos de fonte preferidos mudam completamente de um assistente para outro. A Wikipedia aparece em 3,43% das respostas do ChatGPT e em 0,03% das do Claude; o YouTube em 3,69% das respostas do Gemini e em 0,04% das do ChatGPT. Apenas 6 plataformas são citadas pelos cinco modelos. Nosso estudo de citações do ChatGPT mostra também que a seleção muda com o tempo: o ChatGPT passou de 5,8 para 4,1 fontes por resposta no período, com um mínimo de 1,7 em junho de 2026.
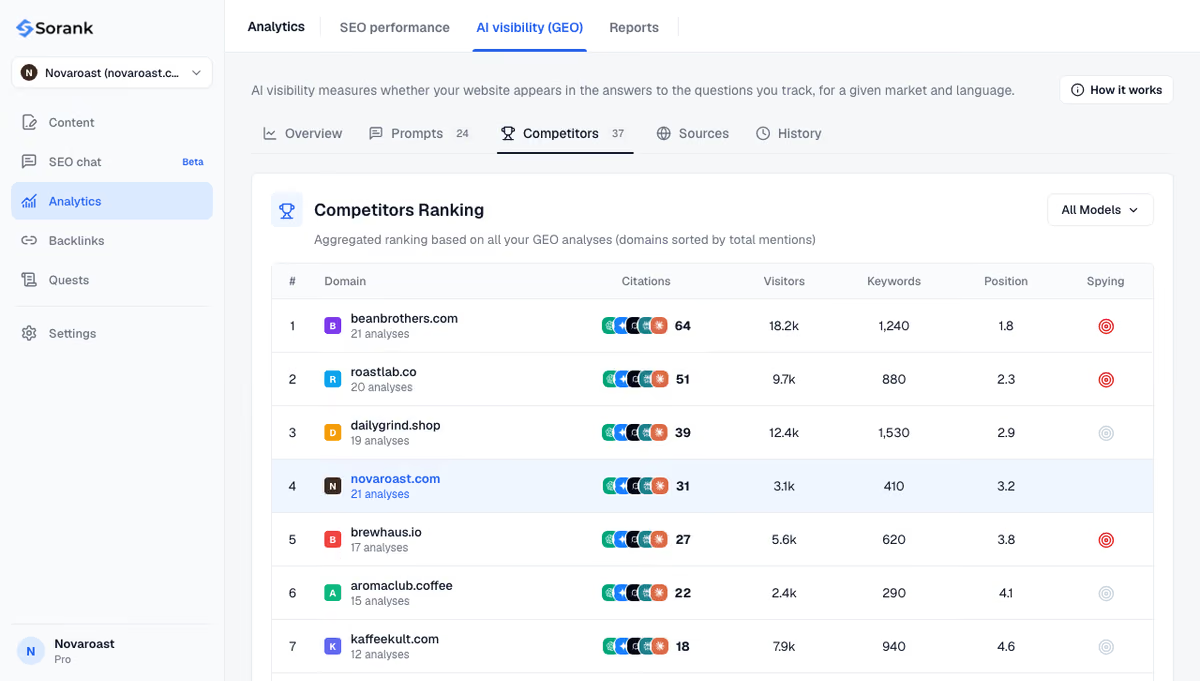
O ranking GEO da Sorank ordena os domínios que as IAs mais citam nas perguntas do seu mercado, para você ver quem ocupa as vagas.
Como se tornar uma das fontes escolhidas pelas IAs?
O processo de seleção se traduz em uma lista curta de ações, válidas tanto para o Google quanto para as IAs.
Abrir as portas: libere OAI-SearchBot, PerplexityBot, Claude-SearchBot, Claude-User, Googlebot e Bingbot; confira se o seu CDN não os bloqueia.
Estar indexado onde importa: Google Search Console e Bing Webmaster Tools, um sitemap limpo, IndexNow para atualizações rápidas.
Cobrir as subconsultas: uma página por pergunta precisa, construída a partir das buscas que os assistentes fazem.
Escrever trechos com a resposta primeiro: uma resposta direta no início de cada seção, tabelas para comparar, uma ideia por seção, como no nosso guia para otimizar conteúdo para a busca com IA.
Provar e datar: fontes, números, autores, datas de atualização visíveis.
Conquistar confirmações: avaliações e menções nas plataformas que os assistentes dos seus compradores citam.
Exemplo
Um comprador pergunta "qual software de contabilidade para um autônomo no Brasil?". O assistente busca "software contabilidade autônomo preço" e "comparativo emissor de nota fiscal MEI". Uma empresa com página de preços pública e um comparativo datado deste ano corresponde às duas buscas; outra com apenas um slogan na página inicial não corresponde a nenhuma.
As respostas variam de uma execução para outra, então a seleção de fontes é mais bem observada ao longo de semanas. O rastreamento do fan-out de consultas de IA da Sorank registra as buscas que cada assistente faz nos seus prompts e as conta ao longo do tempo, e o monitoramento de menções em IA mostra se a sua marca é citada e quais fontes ficam com a vaga quando não é. As IAs escolhem as páginas que conseguem alcançar, que correspondem às suas buscas ocultas e que provam o que dizem: meça esses três pontos nas suas próprias perguntas e você saberá o que corrigir.
Perguntas frequentes
As IAs usam o Google para encontrar fontes?
Depende do assistente. AI Overviews, o Modo IA e o Gemini usam o índice do Google, o Microsoft Copilot usa o Bing, o ChatGPT e o Perplexity têm rastreadores e índices próprios, e o Claude usaria o Brave Search segundo a imprensa. Uma página bem indexada no Google e no Bing cobre a maioria dos casos, desde que o bot de cada assistente também esteja liberado.
Estar em primeiro no Google garante uma citação nas respostas de IA?
Não. Os assistentes buscam com suas próprias consultas reformuladas e citam trechos, não posições. Uma página em primeiro para a pergunta exata do usuário pode ficar de fora se não responder à subpergunta que o assistente buscou, ou se outra página apresentar a resposta com mais clareza e provas. Boas posições no Google aumentam as chances sem garantir nada.
Por que ChatGPT, Gemini e Claude citam sites diferentes para a mesma pergunta?
Eles usam índices diferentes, fazem buscas diferentes e têm preferências de fontes diferentes. Nosso estudo de 301.025 respostas mostra, por exemplo, que a Wikipedia aparece em 3,43% das respostas do ChatGPT mas em apenas 0,03% das do Claude, enquanto o YouTube é frequente no Gemini e quase ausente no ChatGPT. Otimizar para um assistente não se transfere automaticamente para os outros.
y!
Free SEO & GEO audit
Receba gratuitamente o seu plano de conteúdo para 30 dias
Analisamos seus concorrentes, seu site e sua visibilidade nas IA para criar, gratuitamente, um plano de conteúdo sob medida.
“Testei o Sorank no site real de um cliente e é uma loucura. Faz tudo aquilo que uma agência cobra 1.500 € por mês. Agora vai para produção nesse cliente.”Guillaume Guersanguersanguillaume.com
“Somos uma agência de publicidade e queríamos colocar nosso SEO nos trilhos de uma vez por todas. A Sorank nos deu uma visão clara do nosso site, ajudou-nos a priorizar as otimizações e estruturar corretamente nosso conteúdo. A ferramenta é fácil de usar, bem projetada para uma equipe e muito prática para centralizar o acompanhamento sem ter que fazer malabarismos entre várias plataformas. Uma base muito sólida para recomeçar do zero com nosso SEO.”Gaspard MadouiAgência de Publicidade
“Me especializei em GEO graças à Sorank. O GEO Leaderboard me permite mostrar aos meus clientes o seu posicionamento em relação aos concorrentes no ChatGPT. É um verdadeiro diferencial comercial.”MélanieFreelancer SEO
“Excelente serviço, funciona bem para o nosso site e nos ajuda a entender como melhorá-lo para nos posicionarmos melhor no Google e em outros lugares. Parabéns, continuem assim, eu recomendo.”Hugo T.Comerciante de e-commerce