La confidentialité est importante pour nous. Vous avez donc la possibilité de désactiver certains types de stockage qui peuvent ne pas être nécessaires au fonctionnement de base du site Web. Le blocage des catégories peut avoir un impact sur votre expérience sur le site Web. Plus d'informations (Politique de cookies)
Comment les IA choisissent leurs sources : RAG, fan-out des requêtes et critères de citation
Comment les IA choisissent leurs sources : recherche, fan-out des requêtes, ce que documentent OpenAI, Google, Perplexity, Anthropic et Microsoft, et nos données.
Couverture du guide Sorank sur la façon dont les IA choisissent les sources qu'elles citent
Outils
Sur cette page
En bref
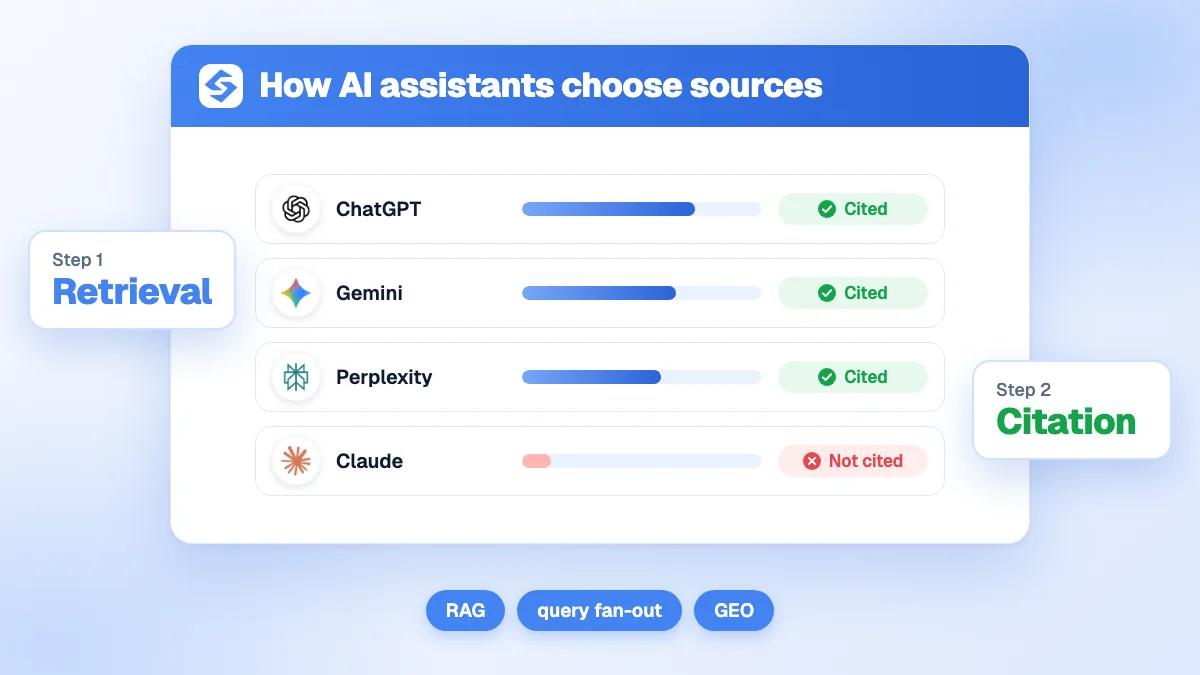
les IA choisissent leurs sources en deux temps. D'abord elles cherchent : le modèle transforme la question en une ou plusieurs recherches web (le fan-out des requêtes) et récupère des pages candidates dans un index (Google, Bing, Brave ou le leur). Ensuite elles sélectionnent : le modèle lit des passages, garde ceux qui répondent clairement à une sous-question, preuves à l'appui, et les cite. Une page doit donc être accessible au robot de l'assistant, indexée, pertinente pour les sous-requêtes cachées et facile à citer, et chaque IA privilégie des types de sites différents.
3 jours offerts, puis vous arrêtez quand vous voulez. Satisfait ou remboursé pendant 90 jours.
Comprendre comment les IA choisissent leurs sources est le point de départ de tout travail sur la visibilité dans les IA. Bonne nouvelle : les éditeurs en documentent plus qu'on ne le croit. Google indique dans sa documentation sur les fonctionnalités d'IA que les AI Overviews et le mode IA peuvent lancer plusieurs recherches liées sur des sous-thèmes, et qu'une page doit seulement être indexée et éligible à un extrait pour apparaître comme lien d'appui. OpenAI, Perplexity, Anthropic et Microsoft publient des règles comparables pour leurs propres assistants. Ce guide rassemble ce qui est officiel, le sépare des suppositions et ajoute ce que nous avons mesuré sur 301'025 réponses d'IA.
Que se passe-t-il entre une question et une réponse sourcée ?
Presque tous les assistants connectés au web suivent le même schéma, appelé génération augmentée par la recherche (RAG) : le modèle ne répond pas de mémoire seulement, il récupère d'abord des documents puis rédige à partir d'eux. Les étapes sont les suivantes.
Décider de chercher ou non. Un fait stable (une définition, une règle de calcul) est tiré des données d'entraînement. Une question sur des prix, des produits, une actualité ou une entreprise nommée déclenche une recherche.
Reformuler et démultiplier. Le modèle transforme la phrase de l'utilisateur en une ou plusieurs requêtes plus courtes, chacune couvrant une facette de la question. C'est le fan-out des requêtes.
Récupérer des candidats. Chaque requête part vers un index de recherche, qui renvoie une liste de pages. Seules les pages déjà présentes dans cet index peuvent être récupérées.
Lire et filtrer les passages. Le modèle (ou une étape de filtrage) lit les résultats et garde les passages qui répondent à une sous-question. Les pages s'affrontent passage par passage, d'où l'importance du classement des passages plutôt que de la page entière.
Rédiger et citer. La réponse est composée à partir des passages retenus, avec des liens vers les pages d'origine.
Deux conséquences en découlent. Une page absente de l'index utilisé par l'assistant n'entre jamais dans la course, quelle que soit sa qualité. Et une page peut être première sur Google pour la question exacte de l'utilisateur et perdre pourtant la citation, parce que l'assistant a cherché autre chose.
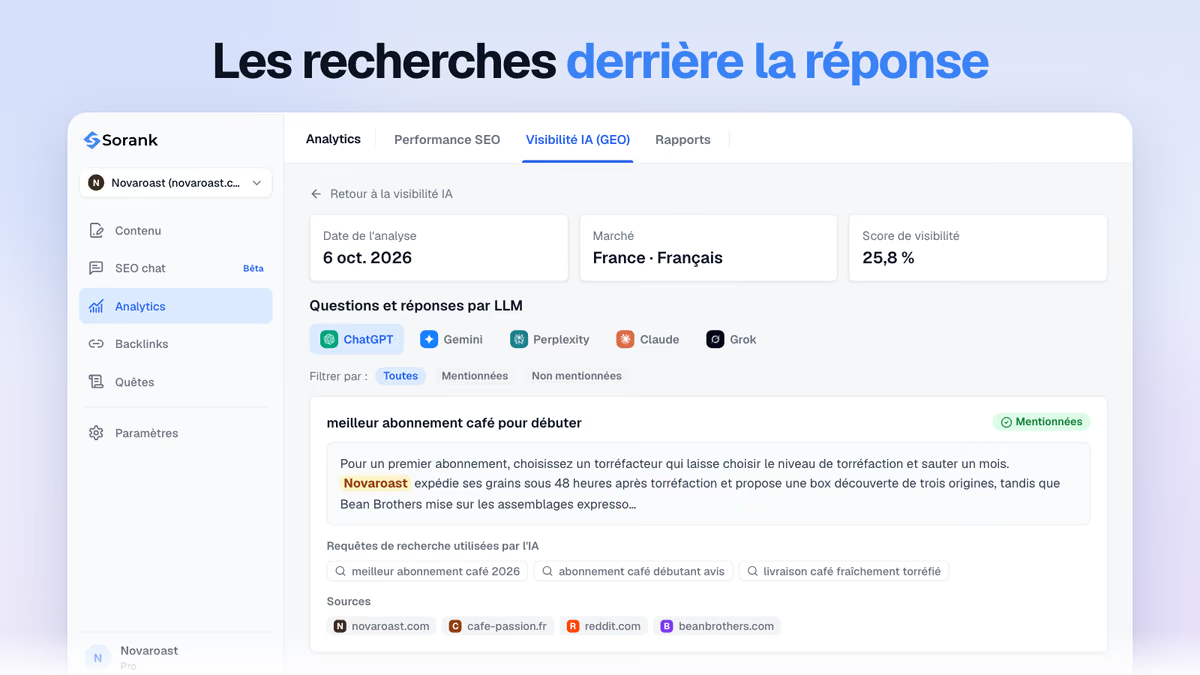
Dans Sorank, chaque réponse suivie affiche les recherches lancées en coulisses par l'IA : les requêtes auxquelles vos pages doivent correspondre pour être récupérées.
Que documentent OpenAI, Google, Perplexity, Anthropic et Microsoft ?
Aucun des cinq ne publie de formule de classement. Chacun publie en revanche des règles d'accès, d'indexation et de citation, et ces règles sont le seul terrain solide.
Assistant
Origine des pages candidates
Ce que l'éditeur documente
Google (AI Overviews, mode IA)
L'index de Google
Fan-out des requêtes sur des sous-thèmes ; une page doit être indexée et éligible à un extrait ; aucun fichier, balisage ou schéma particulier n'est requis
Recherche ChatGPT
Son propre robot et des partenaires de recherche
Les sites qui bloquent OAI-SearchBot n'apparaissent pas dans les réponses de recherche de ChatGPT ; GPTBot ne concerne que l'entraînement
Perplexity
Son propre index construit par PerplexityBot
PerplexityBot fait apparaître et lie les sites dans les résultats ; Perplexity-User récupère une page quand la question d'un utilisateur l'exige
Claude
Un index de recherche externe (Brave, selon la presse) et les robots d'Anthropic
Claude décide quand chercher, peut chercher plusieurs fois par demande et joint toujours des citations
Microsoft Copilot
L'index de Bing
Les citations sont déclenchées par des requêtes d'ancrage, visibles dans Bing Webmaster Tools ; un contenu frais, structuré et sourcé est recommandé
OpenAI (ChatGPT)
La documentation d'OpenAI sur ses robots distingue trois agents. OAI-SearchBot construit l'index de recherche : les sites qui le bloquent n'apparaissent pas dans les réponses de recherche de ChatGPT. GPTBot collecte des données d'entraînement, et le bloquer n'a aucun effet sur la recherche. ChatGPT-User visite une page pour le compte d'un utilisateur et ne décide pas de ce qui apparaît dans la recherche. Notre guide pour se positionner dans ChatGPT détaille la suite.
Google (AI Overviews et mode IA)
Google est le plus explicite : les fonctionnalités d'IA utilisent le même index et les mêmes systèmes de qualité que la recherche classique, elles peuvent lancer un fan-out de recherches liées et afficher un éventail de liens d'appui plus large que les dix liens bleus. Aucun balisage propre à l'IA n'est à ajouter. Autrement dit, le SEO sur Google reste le ticket d'entrée pour les réponses d'IA de Google.
Perplexity
La documentation des robots de Perplexity précise que PerplexityBot sert à faire apparaître et à lier des sites dans ses résultats, et qu'il n'est pas utilisé pour entraîner des modèles de fondation. Perplexity-User récupère des pages en temps réel pour la question d'un utilisateur. Autoriser PerplexityBot dans le robots.txt est la condition pour figurer dans son index.
Anthropic (Claude)
La documentation de la recherche web d'Anthropic décrit la boucle avec précision : Claude détermine quand chercher selon le prompt, la recherche peut se répéter plusieurs fois au cours d'une même demande, et la réponse finale porte toujours des citations, chacune reprenant jusqu'à 150 caractères de la source. Claude cherche pour les prix actuels, l'actualité et les informations sur des entreprises ou des produits précis, et répond sans chercher sur les connaissances stables. Notre guide pour se positionner dans Claude couvre ses robots et son index.
Microsoft (Copilot)
Copilot s'appuie sur Bing. Depuis février 2026, Bing Webmaster Tools comprend un rapport AI Performance qui montre combien de fois un site est cité dans Copilot et les requêtes d'ancrage qui ont fait remonter ses pages. Les conseils de Microsoft dans la même annonce : garder le contenu à jour (avec IndexNow), le structurer avec des titres clairs, des tableaux et des FAQ, et appuyer les affirmations sur des données et des sources. Voir notre guide pour se positionner dans Copilot, et celui pour se positionner dans Grok, l'assistant de xAI, qui en documente beaucoup moins.
À savoir
Beaucoup d'articles listent des « facteurs de classement » des réponses d'IA avec des poids en pourcentage. Aucun éditeur n'a publié de tels poids. Considérez toute formule précise comme une hypothèse, et fiez-vous aux règles documentées ci-dessus et à vos propres mesures.
Quels critères décident de qui est cité ?
En croisant la documentation officielle et ce qu'on observe dans les réponses, six critères expliquent la plupart des citations. Les deux premiers sont des exigences documentées ; les autres sont des tendances constantes.
1. Accès et indexation
Le robot de recherche de l'assistant doit être autorisé et la page doit figurer dans l'index qu'il interroge : celui de Google pour Gemini et les AI Overviews, celui de Bing pour Copilot, les index propres d'OpenAI et de Perplexity, Brave pour Claude. Vérifiez vos règles avec notre guide du robots.txt pour les robots d'IA.
2. Correspondance avec les sous-requêtes cachées
La récupération se fait sur les requêtes du fan-out, pas sur la phrase de l'utilisateur. Une page qui répond à « meilleur CRM » en général peut perdre face à une page qui répond à « CRM pour une agence immobilière de 5 personnes, prix par utilisateur », parce que c'est cela que l'assistant a cherché.
3. Des passages citables seuls
Les IA citent des passages. Une section qui s'ouvre sur une réponse directe, une définition, une ligne de tableau ou une étape numérotée peut être extraite de la page et garder son sens. Une introduction vague, non.
4. Preuves et fraîcheur
Claude cherche justement quand une information a pu changer, et Microsoft recommande d'appuyer les affirmations sur des données et des sources. Des chiffres datés, des sources nommées, des prix « vérifiés » à une date donnée et des dates de mise à jour visibles rendent une page plus sûre à citer.
5. Une confirmation ailleurs
Une IA qui trouve le même fait sur plusieurs sites indépendants peut l'affirmer avec assurance. C'est le consensus d'entité : avis, comparatifs, annuaires et mentions presse qui décrivent votre marque de la même façon.
6. Le type de source que préfère chaque modèle
Chaque assistant a ses habitudes. Certains s'appuient sur des sources encyclopédiques, d'autres sur la vidéo, les forums ou les plateformes d'avis. La section suivante montre l'ampleur de ces écarts.
Astuce
Avant d'écrire une page pour la visibilité dans les IA, posez la question à deux ou trois assistants et notez les recherches qu'ils lancent et les sites qu'ils citent. Les recherches vous disent quel angle couvrir ; les sites cités, quel format l'emporte.
Que montrent nos études de citations ?
Notre étude des plateformes citées par les IA a analysé 301'025 réponses de ChatGPT, Gemini, Perplexity, Claude et Grok, collectées entre août 2025 et août 2026 sur un panel de questions d'acheteurs (79 % posées en français). Elle a compté 1'820'738 citations d'IA pointant vers 131'349 domaines distincts. Deux résultats comptent pour la sélection des sources.
D'abord, les IA ne citent pas le même nombre de sources. Gemini nomme 11,1 sources par réponse en moyenne, Grok 7,1, ChatGPT 4,1, Claude 3,5 et Perplexity 3,3. Sur ces trois derniers, une question offre trois ou quatre places : être la deuxième meilleure page revient souvent à ne pas être cité du tout.
Plateforme
ChatGPT
Gemini
Perplexity
Claude
Grok
Wikipedia
3,43 %
1,38 %
0,19 %
0,03 %
1,08 %
YouTube
0,04 %
3,69 %
3,46 %
0 %
2,76 %
Reddit
0,33 %
2,5 %
1,51 %
0 %
4,11 %
Trustpilot
2,7 %
4,33 %
1,21 %
1,57 %
1,8 %
Ensuite, les types de sources préférés changent complètement d'une IA à l'autre. Wikipedia apparaît dans 3,43 % des réponses de ChatGPT et 0,03 % de celles de Claude ; YouTube dans 3,69 % des réponses de Gemini et 0,04 % de celles de ChatGPT. Seules 6 plateformes sont citées par les cinq modèles. Notre étude des citations de ChatGPT montre aussi que la sélection évolue dans le temps : ChatGPT est passé de 5,8 à 4,1 sources par réponse sur la période, avec un creux à 1,7 en juin 2026.
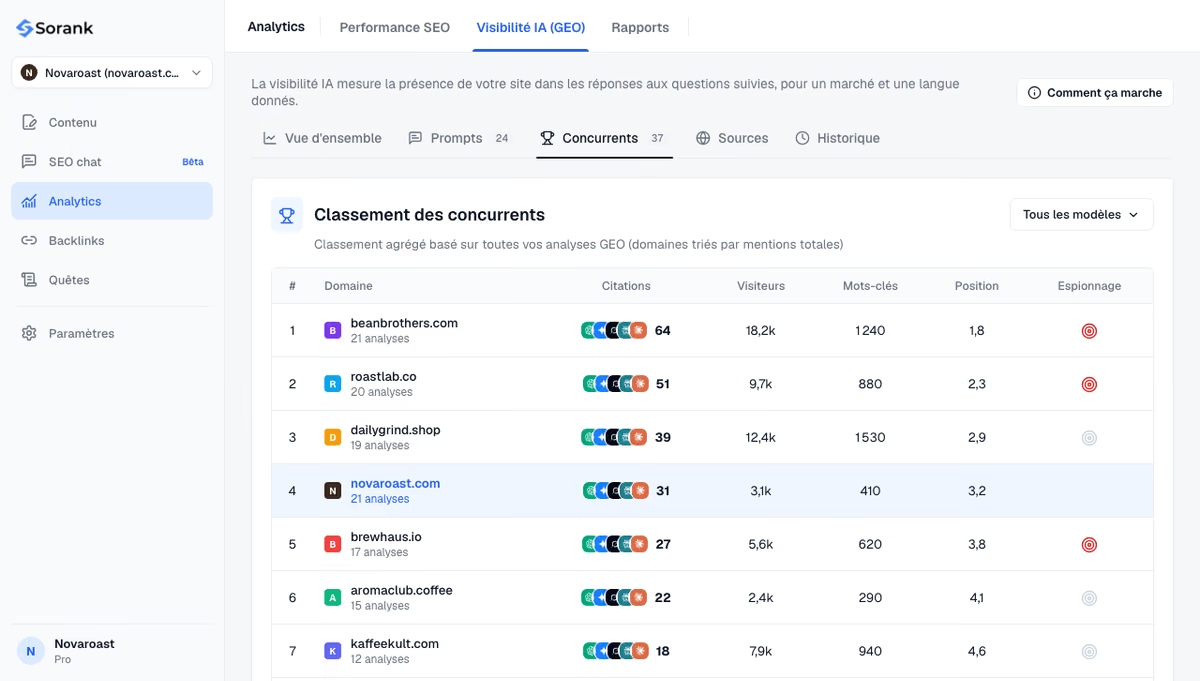
Le classement GEO de Sorank range les domaines que les IA citent le plus sur les questions de votre marché : vous voyez qui occupe les places.
Comment devenir l'une des sources choisies par les IA ?
Le processus de sélection se traduit en une courte liste d'actions, valables pour Google comme pour les IA.
Ouvrir les portes : autorisez OAI-SearchBot, PerplexityBot, Claude-SearchBot, Claude-User, Googlebot et Bingbot ; vérifiez que votre CDN ne les bloque pas.
Être indexé là où ça compte : Google Search Console et Bing Webmaster Tools, un sitemap propre, IndexNow pour les mises à jour rapides.
Couvrir les sous-requêtes : une page par question précise, construite à partir des recherches que lancent les assistants.
Écrire des passages qui répondent d'abord : une réponse directe en tête de chaque section, des tableaux pour comparer, une idée par section, comme dans notre guide pour optimiser son contenu pour les IA.
Prouver et dater : sources, chiffres, auteurs, dates de mise à jour visibles.
Obtenir des confirmations : avis et mentions sur les plateformes que citent les assistants utilisés par vos acheteurs.
Exemple
Un acheteur demande « quel logiciel de comptabilité pour un indépendant en France ? ». L'IA cherche « logiciel comptabilité freelance France prix » et « comparatif logiciel facturation micro-entrepreneur ». Un éditeur avec une page de tarifs publique et un comparatif daté de cette année correspond aux deux recherches ; un autre avec un simple slogan en page d'accueil ne correspond à aucune.
Les réponses varient d'une fois à l'autre : la sélection des sources s'observe donc sur plusieurs semaines. Le suivi du fan-out des requêtes IA de Sorank enregistre les recherches que lance chaque assistant sur vos prompts et les compte dans le temps, et le suivi des mentions dans les IA montre si votre marque est citée et quelles sources prennent la place quand elle ne l'est pas. Les IA choisissent les pages qu'elles peuvent atteindre, qui correspondent à leurs recherches cachées et qui prouvent ce qu'elles avancent : mesurez ces trois points sur vos propres questions, et vous saurez quoi corriger.
Questions fréquentes
Les IA utilisent-elles Google pour trouver leurs sources ?
Cela dépend de l'assistant. Les AI Overviews, le mode IA et Gemini s'appuient sur l'index de Google, Microsoft Copilot sur Bing, ChatGPT et Perplexity sur leurs propres robots et index, et Claude utiliserait Brave Search selon la presse. Une page bien indexée sur Google et Bing couvre la plupart des cas, à condition d'autoriser aussi le robot de chaque assistant.
Être premier sur Google garantit-il une citation dans les réponses d'IA ?
Non. Les assistants cherchent avec leurs propres requêtes reformulées et citent des passages, pas des positions. Une page première sur la question exacte de l'utilisateur peut être écartée si elle ne répond pas à la sous-question que l'IA a cherchée, ou si une autre page énonce la réponse plus clairement, preuves à l'appui. De bonnes positions sur Google augmentent les chances sans rien garantir.
Pourquoi ChatGPT, Gemini et Claude citent-ils des sites différents pour la même question ?
Ils utilisent des index différents, lancent des recherches différentes et ont des préférences de sources différentes. Notre étude de 301'025 réponses montre par exemple que Wikipedia apparaît dans 3,43 % des réponses de ChatGPT mais 0,03 % de celles de Claude, tandis que YouTube est fréquent sur Gemini et quasi absent de ChatGPT. Optimiser pour une IA ne se transpose pas automatiquement aux autres.
y!
Audit SEO et GEO gratuit
Recevez gratuitement votre plan de contenu pour 30 jours
Nous analysons vos concurrents, votre site et votre visibilité dans les IA pour créer gratuitement un plan de contenu sur mesure.
“J'ai testé Sorank sur un vrai site client et c'est dingue. Il fait tout ce qu'une agence facture 1'500€ par mois. Là, ça part en production sur ce client.”Guillaume Guersanguersanguillaume.com
“Nous sommes une agence Ads et nous voulions remettre notre SEO sur les rails une bonne fois pour toutes. Sorank nous a donné une vue claire de notre site, nous a aidés à prioriser les optimisations et à structurer correctement notre contenu. L'outil est facile à utiliser, bien pensé pour une équipe et très pratique pour centraliser le suivi sans avoir à jongler entre plusieurs plateformes. Une base très solide pour repartir à zéro avec notre SEO.”Gaspard MadouiAgence Publicitaire
“J'ai simplement laissé le logiciel Sorank faire son travail, et aujourd'hui mon DR est de 25 et ma page se positionne mieux.”Lucas Flandrefoundertrace.fr
“Je me suis spécialisée en GEO grâce à Sorank. Le GEO Leaderboard me permet de montrer à mes clients leur positionnement vs leurs concurrents sur ChatGPT. C'est un vrai différenciateur commercial.”MélanieSEO indépendant
“Excellent service, fonctionne bien pour notre site web et nous aide à comprendre comment l'améliorer pour mieux nous positionner sur Google et ailleurs. Félicitations, continuez, je vous le recommande.”Hugo T.Marchand en ligne