Prywatność jest dla nas ważna, dlatego możesz wyłączyć niektóre rodzaje przechowywania danych, które nie są niezbędne do podstawowego działania strony. Zablokowanie kategorii może wpłynąć na Twoje doświadczenie podczas korzystania z witryny. Więcej informacji (Polityka cookies)
Jak asystenci AI wybierają źródła: RAG, query fan-out i kryteria cytowania
Jak asystenci AI wybierają źródła: wyszukiwanie, query fan-out, co dokumentują OpenAI, Google, Perplexity, Anthropic i Microsoft oraz co pokazują nasze dane.
Okładka przewodnika Sorank o tym, jak asystenci AI wybierają cytowane źródła
Narzędzia
Na tej stronie
W skrócie
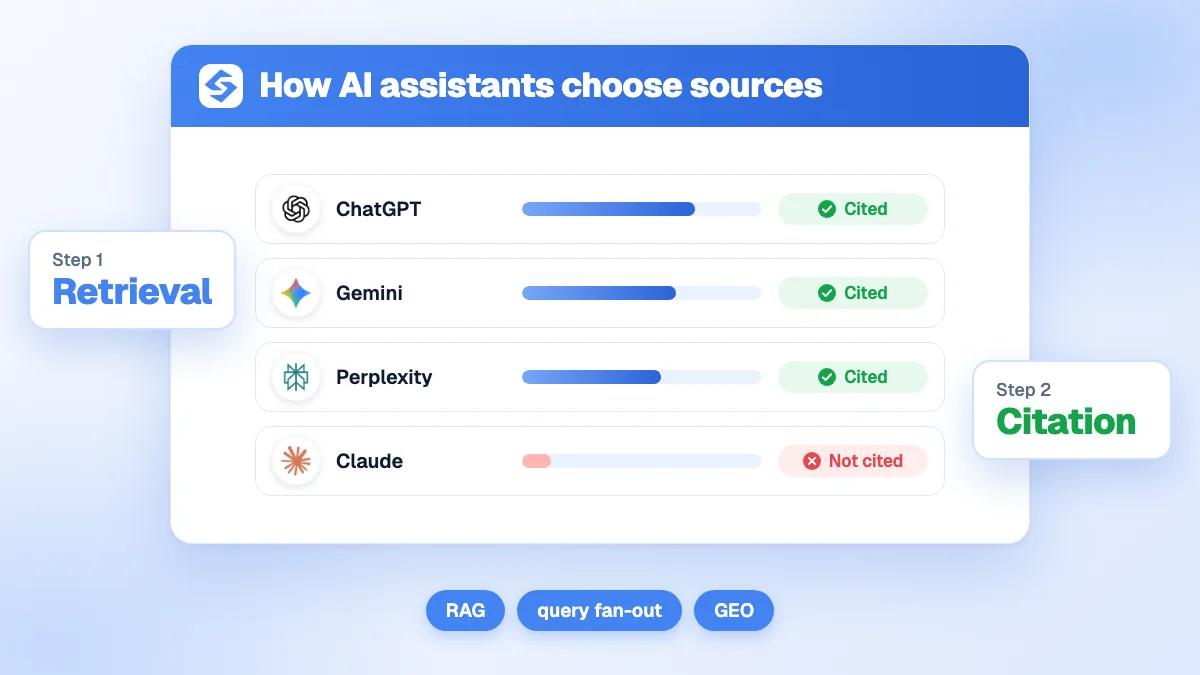
asystenci AI wybierają źródła w dwóch etapach. Najpierw szukają: model zamienia pytanie na jedno lub kilka wyszukiwań w sieci (query fan-out) i pobiera strony kandydujące z indeksu wyszukiwania (Google, Bing, Brave lub własnego). Potem wybierają: model czyta fragmenty, zostawia te, które jasno i z dowodami odpowiadają na pytanie cząstkowe, i je cytuje. Strona musi więc być dostępna dla bota asystenta, zaindeksowana, dopasowana do ukrytych zapytań cząstkowych i łatwa do zacytowania, a każdy asystent preferuje inne typy witryn.
3 dni za darmo, potem rezygnujesz, kiedy chcesz. 90-dniowa gwarancja wyników lub zwrotu pieniędzy.
Zrozumienie, jak asystenci AI wybierają źródła, to punkt wyjścia każdej pracy nad widocznością w AI. Dobra wiadomość: dostawcy dokumentują więcej, niż się wydaje. Google pisze w swojej dokumentacji funkcji AI, że AI Overviews i tryb AI mogą wykonywać wiele powiązanych wyszukiwań dotyczących podtematów, a strona musi tylko być zaindeksowana i kwalifikować się do fragmentu, aby pojawić się jako link pomocniczy. OpenAI, Perplexity, Anthropic i Microsoft publikują podobne zasady dla swoich asystentów. Ten przewodnik zbiera to, co oficjalne, oddziela to od domysłów i dodaje to, co zmierzyliśmy na 301 025 odpowiedziach AI.
Co dzieje się między pytaniem a odpowiedzią ze źródłami?
Prawie każdy asystent z dostępem do sieci działa według tego samego schematu, zwanego generowaniem wspomaganym wyszukiwaniem (RAG): model nie odpowiada wyłącznie z pamięci, najpierw pobiera dokumenty, a potem na ich podstawie pisze. Oto kolejne kroki.
Decyzja, czy szukać. Na stały fakt (definicję, regułę obliczeniową) model odpowiada z danych treningowych. Pytanie o ceny, produkty, bieżące wydarzenia lub konkretną firmę uruchamia wyszukiwanie.
Przeformułowanie i rozgałęzienie. Model zamienia zdanie użytkownika na jedno lub kilka krótszych zapytań, z których każde obejmuje jeden aspekt pytania. To query fan-out.
Pobranie kandydatów. Każde zapytanie trafia do indeksu wyszukiwania, który zwraca listę stron. Pobrać można tylko strony, które już są w tym indeksie.
Czytanie i filtrowanie fragmentów. Model (lub etap filtrowania) czyta wyniki i zostawia fragmenty odpowiadające na pytanie cząstkowe. Strony rywalizują fragment po fragmencie, dlatego ranking fragmentów waży więcej niż cała strona.
Pisanie i cytowanie. Odpowiedź powstaje z zachowanych fragmentów, z linkami do stron, z których pochodzą.
Wynikają z tego dwie rzeczy. Strona, której nie ma w indeksie używanym przez asystenta, nigdy nie bierze udziału w wyścigu, niezależnie od jakości. A strona może być pierwsza w Google na dokładne pytanie użytkownika i mimo to przegrać cytowanie, bo asystent szukał czegoś innego.
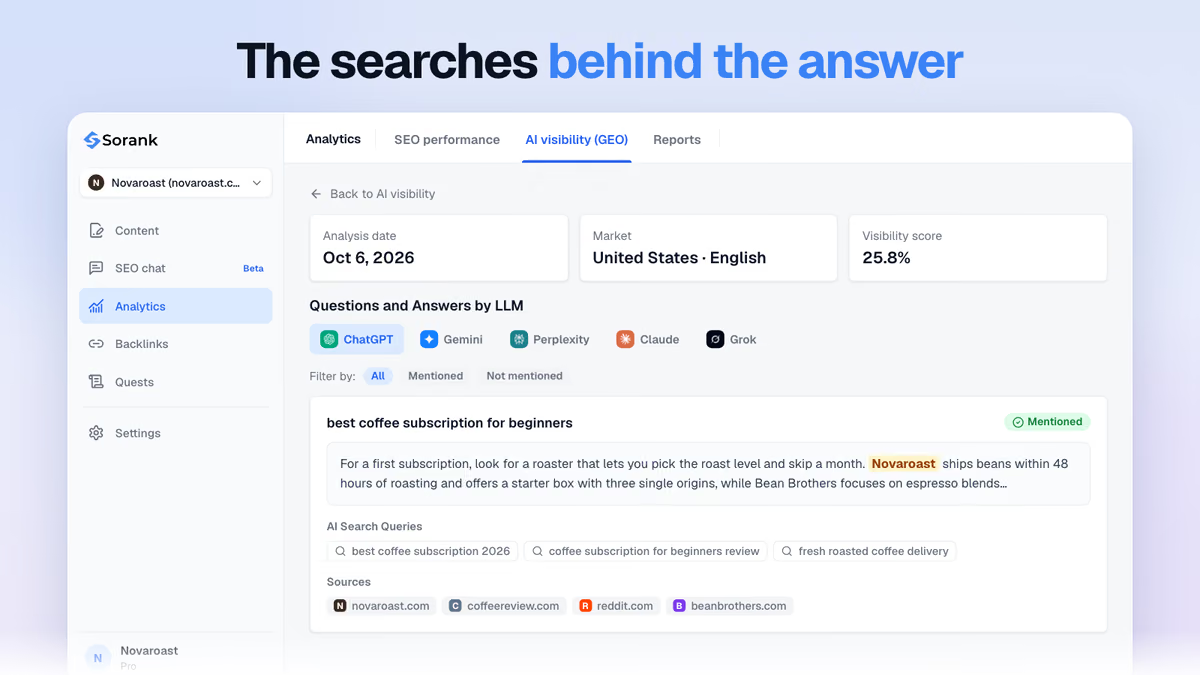
W Sorank każda śledzona odpowiedź pokazuje wyszukiwania wykonane przez AI w tle: zapytania, do których Twoje strony muszą pasować, aby zostały pobrane.
Co dokumentują OpenAI, Google, Perplexity, Anthropic i Microsoft?
Żaden z pięciu nie publikuje formuły rankingu. Każdy publikuje natomiast zasady dostępu, indeksowania i cytowania, i te zasady są jedynym pewnym gruntem.
Asystent
Skąd pochodzą kandydaci
Co dokumentuje dostawca
Google (AI Overviews, tryb AI)
Indeks Google
Query fan-out na podtematy; strona musi być zaindeksowana i kwalifikować się do fragmentu; nie trzeba żadnego specjalnego pliku, znaczników ani schematu
Wyszukiwanie ChatGPT
Własny crawler i partnerzy wyszukiwania
Witryny blokujące OAI-SearchBot nie pojawiają się w odpowiedziach wyszukiwania ChatGPT; GPTBot dotyczy tylko trenowania
Perplexity
Własny indeks budowany przez PerplexityBot
PerplexityBot pokazuje i linkuje witryny w wynikach; Perplexity-User pobiera stronę, gdy wymaga tego pytanie użytkownika
Claude
Zewnętrzny indeks wyszukiwania (według doniesień Brave) oraz boty Anthropic
Claude decyduje, kiedy szukać, może szukać kilka razy w jednym zapytaniu i zawsze dołącza cytowania
Microsoft Copilot
Indeks Bing
Cytowania wywołują zapytania groundingowe, widoczne w Bing Webmaster Tools; zalecane są treści aktualne, uporządkowane i poparte źródłami
OpenAI (ChatGPT)
Dokumentacja crawlerów OpenAI rozróżnia trzech agentów. OAI-SearchBot buduje indeks wyszukiwania: witryny, które go blokują, nie pojawiają się w odpowiedziach wyszukiwania ChatGPT. GPTBot zbiera dane treningowe, a jego zablokowanie nie wpływa na wyszukiwanie. ChatGPT-User odwiedza stronę w imieniu użytkownika i nie decyduje o tym, co pojawia się w wyszukiwaniu. Nasz przewodnik o pozycjonowaniu w ChatGPT opisuje resztę.
Google (AI Overviews i tryb AI)
Google mówi najwięcej: funkcje AI korzystają z tego samego indeksu i tych samych systemów jakości co klasyczne wyszukiwanie, mogą wykonać fan-out powiązanych wyszukiwań i pokazać więcej linków pomocniczych niż dziesięć niebieskich linków. Nie trzeba dodawać żadnych znaczników specyficznych dla AI. Innymi słowy, SEO w Google pozostaje biletem wstępu do odpowiedzi AI od Google.
Perplexity
Dokumentacja botów Perplexity wyjaśnia, że PerplexityBot służy do pokazywania i linkowania witryn w wynikach i nie jest używany do trenowania modeli bazowych. Perplexity-User pobiera strony w czasie rzeczywistym na potrzeby pytania użytkownika. Dopuszczenie PerplexityBot w robots.txt to warunek obecności w jego indeksie.
Anthropic (Claude)
Dokumentacja wyszukiwania internetowego Anthropic dokładnie opisuje pętlę: Claude na podstawie promptu ustala, kiedy szukać, wyszukiwanie może się powtarzać kilka razy w ramach jednego zapytania, a końcowa odpowiedź zawsze zawiera cytowania, każde z maksymalnie 150 znakami źródła. Claude szuka przy aktualnych cenach, wiadomościach i informacjach o konkretnych firmach lub produktach, a na stałą wiedzę odpowiada bez wyszukiwania. Nasz przewodnik o pozycjonowaniu w Claude omawia jego crawlery i indeks.
Microsoft (Copilot)
Copilot opiera się na Bing. Od lutego 2026 roku Bing Webmaster Tools zawiera raport AI Performance, który pokazuje, jak często witryna jest cytowana w Copilot i jakie zapytania groundingowe pobrały jej strony. Rady Microsoftu z tego samego ogłoszenia: dbać o aktualność treści (z IndexNow), porządkować je przejrzystymi nagłówkami, tabelami i FAQ oraz popierać twierdzenia danymi i źródłami. Zobacz nasz przewodnik o pozycjonowaniu w Copilot oraz ten o pozycjonowaniu w Grok, asystencie xAI, który dokumentuje znacznie mniej.
Warto wiedzieć
Wiele artykułów wymienia „czynniki rankingowe” odpowiedzi AI z wagami w procentach. Żaden dostawca nie opublikował takich wag. Traktuj każdą precyzyjną formułę jako hipotezę i opieraj się na udokumentowanych zasadach powyżej oraz własnych pomiarach.
Jakie kryteria decydują, kto zostaje zacytowany?
Łącząc oficjalną dokumentację z tym, co widać w odpowiedziach, sześć kryteriów wyjaśnia większość cytowań. Dwa pierwsze to udokumentowane wymagania, pozostałe to stałe prawidłowości.
1. Dostęp i indeksowanie
Bot wyszukujący asystenta musi mieć dostęp, a strona musi być w indeksie, z którego korzysta: Google dla Gemini i AI Overviews, Bing dla Copilot, własne indeksy OpenAI i Perplexity, Brave dla Claude. Sprawdź swoje reguły z naszym przewodnikiem po robots.txt dla crawlerów AI.
2. Dopasowanie do ukrytych zapytań cząstkowych
Pobieranie odbywa się na zapytaniach z fan-outu, a nie na zdaniu użytkownika. Strona odpowiadająca ogólnie na „najlepszy CRM” może przegrać ze stroną odpowiadającą na „CRM dla 5-osobowego biura nieruchomości, cena za użytkownika”, bo właśnie tego szukał asystent.
3. Fragmenty, które można zacytować samodzielnie
AI cytuje fragmenty. Sekcja, która zaczyna się od bezpośredniej odpowiedzi, definicji, wiersza tabeli lub numerowanego kroku, da się wyjąć ze strony i nadal ma sens. Ogólnikowy wstęp nie.
4. Dowody i aktualność
Claude szuka właśnie wtedy, gdy informacja mogła się zmienić, a Microsoft zaleca popieranie twierdzeń danymi i źródłami. Datowane liczby, wymienione z nazwy źródła, ceny „sprawdzone” w określonym dniu i widoczne daty aktualizacji sprawiają, że stronę bezpieczniej zacytować.
5. Potwierdzenie gdzie indziej
Asystent, który znajduje ten sam fakt w kilku niezależnych witrynach, może go podać z pewnością. To konsensus encji: opinie, porównania, katalogi i wzmianki w prasie, które opisują Twoją markę w ten sam sposób.
6. Typ źródła preferowany przez każdy model
Każdy asystent ma swoje nawyki. Jedne opierają się na źródłach encyklopedycznych, inne na wideo, forach lub platformach z opiniami. Następna sekcja pokazuje, jak duże są te różnice.
Wskazówka
Zanim napiszesz stronę pod widoczność w AI, zadaj pytanie dwóm lub trzem asystentom i zanotuj wykonywane przez nie wyszukiwania oraz cytowane witryny. Wyszukiwania mówią, jaki aspekt pokryć; cytowane witryny, który format wygrywa.
Co pokazują nasze badania cytowań?
Nasze badanie platform cytowanych przez AI objęło 301 025 odpowiedzi ChatGPT, Gemini, Perplexity, Claude i Grok, zebranych od sierpnia 2025 do sierpnia 2026 roku na panelu pytań kupujących (79% zadanych po francusku). Policzyło 1 820 738 cytowań AI prowadzących do 131 349 różnych domen. Dla wyboru źródeł ważne są dwa wnioski.
Po pierwsze, asystenci nie cytują tej samej liczby źródeł. Gemini podaje średnio 11,1 źródła na odpowiedź, Grok 7,1, ChatGPT 4,1, Claude 3,5, a Perplexity 3,3. W trzech ostatnich jedno pytanie daje trzy lub cztery miejsca: bycie drugą najlepszą stroną często oznacza brak cytowania.
Platforma
ChatGPT
Gemini
Perplexity
Claude
Grok
Wikipedia
3,43%
1,38%
0,19%
0,03%
1,08%
YouTube
0,04%
3,69%
3,46%
0%
2,76%
Reddit
0,33%
2,5%
1,51%
0%
4,11%
Trustpilot
2,7%
4,33%
1,21%
1,57%
1,8%
Po drugie, preferowane typy źródeł całkowicie różnią się między asystentami. Wikipedia pojawia się w 3,43% odpowiedzi ChatGPT i w 0,03% odpowiedzi Claude; YouTube w 3,69% odpowiedzi Gemini i w 0,04% odpowiedzi ChatGPT. Tylko 6 platform cytuje wszystkich pięć modeli. Nasze badanie cytowań ChatGPT pokazuje też, że wybór zmienia się w czasie: ChatGPT przeszedł w tym okresie z 5,8 do 4,1 źródła na odpowiedź, z minimum 1,7 w czerwcu 2026 roku.
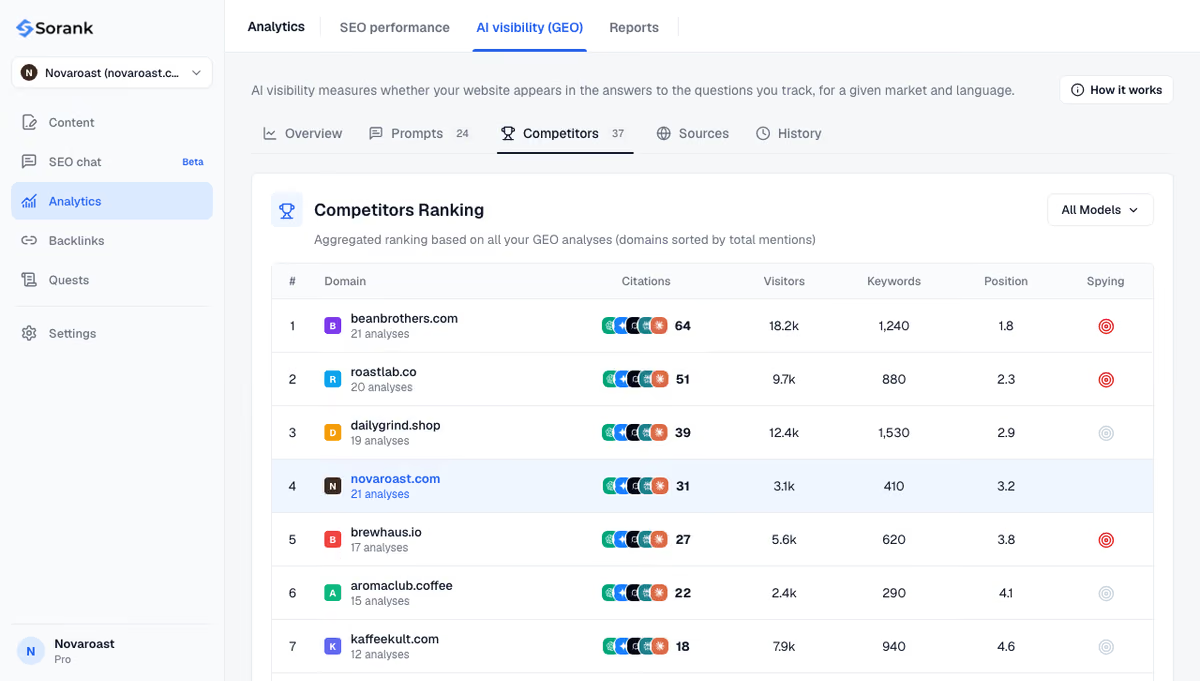
Ranking GEO w Sorank porządkuje domeny, które AI najczęściej cytuje w pytaniach z Twojego rynku, aby było widać, kto zajmuje miejsca.
Jak stać się jednym ze źródeł wybieranych przez asystentów AI?
Proces wyboru przekłada się na krótką listę działań, ważnych zarówno dla Google, jak i dla AI.
Otwórz drzwi: dopuść OAI-SearchBot, PerplexityBot, Claude-SearchBot, Claude-User, Googlebot i Bingbot; sprawdź, czy CDN ich nie blokuje.
Bądź zaindeksowany tam, gdzie to ważne: Google Search Console i Bing Webmaster Tools, czysta mapa witryny, IndexNow do szybkich aktualizacji.
Pokryj zapytania cząstkowe: jedna strona na jedno precyzyjne pytanie, zbudowana na wyszukiwaniach, które asystenci faktycznie wykonują.
Pisz fragmenty z odpowiedzią na początku: bezpośrednia odpowiedź na początku każdej sekcji, tabele do porównań, jedna myśl na sekcję, jak w naszym przewodniku o optymalizacji treści pod wyszukiwanie AI.
Dowódź i datuj: źródła, liczby, autorzy, widoczne daty aktualizacji.
Zdobywaj potwierdzenia: opinie i wzmianki na platformach, które cytują asystenci używani przez Twoich klientów.
Przykład
Kupujący pyta: „jaki program księgowy dla jednoosobowej działalności w Polsce?”. Asystent szuka „program księgowy JDG cena” i „porównanie programów do fakturowania”. Dostawca z publicznym cennikiem i porównaniem datowanym na ten rok pasuje do obu wyszukiwań; ten, który ma tylko slogan na stronie głównej, nie pasuje do żadnego.
Odpowiedzi różnią się między uruchomieniami, więc wybór źródeł najlepiej obserwować przez kilka tygodni. Funkcja Query fan-out AI w Sorank zapisuje wyszukiwania, które każdy asystent wykonuje dla Twoich promptów, i liczy je w czasie, a śledzenie wzmianek w AI pokazuje, czy Twoja marka jest cytowana i które źródła zajmują miejsce, gdy nie jest. Asystenci AI wybierają strony, do których mogą dotrzeć, które pasują do ich ukrytych wyszukiwań i które udowadniają to, co mówią: zmierz te trzy rzeczy na własnych pytaniach, a będziesz wiedzieć, co poprawić.
Najczęściej zadawane pytania
Czy asystenci AI korzystają z Google, by znaleźć źródła?
To zależy od asystenta. AI Overviews, tryb AI i Gemini korzystają z indeksu Google, Microsoft Copilot z Bing, ChatGPT i Perplexity mają własne crawlery i indeksy, a Claude według doniesień korzysta z Brave Search. Strona dobrze zaindeksowana w Google i Bing obejmuje większość przypadków, pod warunkiem że bot każdego asystenta również ma dostęp.
Czy pierwsze miejsce w Google gwarantuje cytowanie w odpowiedziach AI?
Nie. Asystenci szukają za pomocą własnych, przeformułowanych zapytań i cytują fragmenty, a nie pozycje. Strona pierwsza na dokładne pytanie użytkownika może zostać pominięta, jeśli nie odpowiada na pytanie cząstkowe, którego szukał asystent, albo jeśli inna strona podaje odpowiedź jaśniej i z dowodami. Dobre pozycje w Google zwiększają szanse, ale niczego nie gwarantują.
Dlaczego ChatGPT, Gemini i Claude cytują różne witryny przy tym samym pytaniu?
Korzystają z różnych indeksów, wykonują różne wyszukiwania i mają różne preferencje źródeł. Nasze badanie 301 025 odpowiedzi pokazuje na przykład, że Wikipedia pojawia się w 3,43% odpowiedzi ChatGPT, ale tylko w 0,03% odpowiedzi Claude, a YouTube jest częsty w Gemini i prawie nieobecny w ChatGPT. Optymalizacja pod jednego asystenta nie przenosi się automatycznie na pozostałych.
y!
Darmowy audyt SEO i GEO
Odbierz za darmo plan treści na 30 dni
Analizujemy Twoich konkurentów, Twoją stronę i Twoją widoczność w AI, aby bezpłatnie przygotować dla Ciebie dopasowany plan treści.
“Przetestowałem Sorank na prawdziwej stronie klienta i to jest szalone. Robi wszystko, za co agencja policzyłaby Ci 1500€ miesięcznie. Teraz trafia na produkcję u tego klienta.”Guillaume Guersanguersanguillaume.com
“Jesteśmy agencją reklamową i chcieliśmy raz na zawsze uporządkować nasze SEO. Sorank dał nam przejrzysty obraz naszej strony, pomógł ustalić priorytety optymalizacji i właściwie uporządkować nasze treści. Narzędzie jest proste w obsłudze, dobrze zaprojektowane do pracy zespołowej i bardzo praktyczne do centralizacji monitoringu bez żonglowania wieloma platformami. Bardzo solidna podstawa, by zacząć SEO od nowa.”Gaspard MadouiAgencja reklamowa
“Dzięki Sorank wyspecjalizowałem się w GEO. Ranking GEO pozwala mi pokazywać klientom ich pozycję na tle konkurencji w ChatGPT. To realna przewaga handlowa.”MélanieFreelancer SEO
“Świetna usługa, dobrze działa dla naszej strony i pomaga zrozumieć, jak ją ulepszyć, aby lepiej pozycjonować się w Google i nie tylko. Gratulacje, tak trzymać, polecam.”Hugo T.Sprzedawca e-commerce