Prywatność jest dla nas ważna, dlatego możesz wyłączyć niektóre rodzaje przechowywania danych, które nie są niezbędne do podstawowego działania strony. Zablokowanie kategorii może wpłynąć na Twoje doświadczenie podczas korzystania z witryny. Więcej informacji (Polityka cookies)
Dziękujemy! Twoje zgłoszenie zostało odebrane!
Ups! Podczas wysyłania formularza coś poszło nie tak.
Robots.txt dla robotów AI: co zezwolić, a co zablokować
Robots.txt dla robotów AI: user agenty OpenAI, Anthropic, Perplexity i Google, co robi każdy z nich oraz konfiguracja, dzięki której nadal jesteś cytowany.
Niebieska kreskówkowa ikona robota obok pomarańczowego znaku zakazu na jasnym tle w kropki, sugerująca zablokowane roboty AI.
Narzędzia
Na tej stronie
W skrócie
aby pozostać widocznym w odpowiedziach AI, zezwól robotom wyszukiwania i robotom pobierającym strony na żądanie użytkownika (OAI-SearchBot, ChatGPT-User, Claude-SearchBot, Claude-User, PerplexityBot, Perplexity-User i Googlebot), a osobno zdecyduj, czy zezwolić robotom trenującym modele (GPTBot, ClaudeBot, Google-Extended, Applebot-Extended, CCBot). Zablokowanie bota trenującego nie usuwa Cię z wyszukiwania AI; zablokowanie bota wyszukiwania zwykle tak. Każda reguła trafia do pliku robots.txt pod dokładną nazwą user agenta, którą podaje dostawca.
3 dni za darmo, potem rezygnujesz, kiedy chcesz. 90-dniowa gwarancja wyników, obowiązują warunki.
Twój robots.txt dla robotów AI stał się decyzją biznesową, a nie tylko plikiem technicznym. Ten sam plik, który kiedyś rozmawiał wyłącznie z Googlebotem, decyduje dziś o tym, czy ChatGPT, Claude, Perplexity i Gemini mogą czytać, cytować i linkować Twoje strony. Sam format się nie zmienił: to nadal Robots Exclusion Protocol ustandaryzowany jako RFC 9309, z user agentami oraz wierszami Allow i Disallow. Zmieniła się liczba agentów i to, że jeden dostawca może prowadzić kilka botów o różnych celach.
Jakie roboty AI istnieją i co robią?
Większość dostawców AI rozdziela dziś trenowanie, indeksowanie wyszukiwania i pobieranie na żądanie użytkownika między różne user agenty. Tabela podsumowuje główne z nich zgodnie z dokumentacją każdego dostawcy.
Dostawca
User agent
Cel
Skutek zablokowania
OpenAI
GPTBot
Dane treningowe dla modeli OpenAI
Treść nie jest używana do przyszłego trenowania
OpenAI
OAI-SearchBot
Indeksowanie dla wyszukiwania ChatGPT
Strony mogą nie pojawiać się jako cytowane wyniki w wyszukiwaniu ChatGPT
OpenAI
ChatGPT-User
Strony pobierane, gdy użytkownik prosi ChatGPT o ich odwiedzenie
ChatGPT nie może otworzyć Twojej strony na żądanie
Anthropic
ClaudeBot
Dane treningowe dla modeli Claude
Treść nie jest używana do przyszłego trenowania
Anthropic
Claude-SearchBot, Claude-User
Jakość wyszukiwania i pobieranie na żądanie użytkownika
Mniejsza widoczność w odpowiedziach Claude, które przeszukują sieć
Perplexity
PerplexityBot, Perplexity-User
Indeks wyszukiwania i pobieranie na żądanie użytkownika
Mniejsza szansa na cytowanie w Perplexity
Google
Googlebot
Wyszukiwarka Google, w tym AI Overviews i Tryb AI
Całkowite usunięcie z wyszukiwarki
Google
Google-Extended (token)
Wykorzystanie treści w modelach Gemini i do ugruntowania poza wyszukiwarką
Brak wpływu na pozycje w wyszukiwarce
Apple
Applebot-Extended (token)
Wykorzystanie treści w generatywnych modelach Apple
Applebot nadal może skanować dla Siri i Spotlight
Common Crawl
CCBot
Otwarte archiwum sieci wykorzystywane w wielu zbiorach danych AI
Dla większości firm, które chcą pozyskiwać klientów: nie. Zablokuj trenowanie, jeśli musisz, ale roboty wyszukiwania zostaw otwarte. Kompromis zależy od tego, co sprzedajesz:
Marki, SaaS, e-commerce, firmy lokalne: odpowiedzi AI są kanałem pozyskiwania. Zablokowanie robotów wyszukiwania Cię z niego usuwa. Zezwolenie robotom trenującym pomaga też przyszłym modelom poznać Twoją markę.
Wydawcy żyjący z odsłon lub subskrypcji: blokowanie robotów trenujących chroni wartość treści; pozostawienie otwartych robotów wyszukiwania nadal przynosi cytowania i linki.
Witryny z treściami prywatnymi lub licencjonowanymi: blokuj szeroko i egzekwuj to na poziomie serwera, ponieważ robots.txt jest prośbą, a nie kontrolą dostępu.
Jak wygląda zalecany robots.txt?
Jawne grupy dla każdego user agenta, z dozwolonymi botami wyszukiwania i wyraźnym wyborem dla botów trenujących. Przykład dla firmy, która chce widoczności w AI, ale woli nie zasilać danych treningowych:
Usuń drugą grupę, jeśli nie masz nic przeciwko wykorzystaniu Twoich treści do trenowania. Nasz darmowy generator robots.txt buduje plik, a sprawdzacz robots.txt pokazuje, którym agentom działający plik faktycznie zezwala.
Jakie błędy przypadkowo blokują widoczność w AI?
Najczęstszym jest zbiorcza reguła skopiowana z forum. Częste błędy:
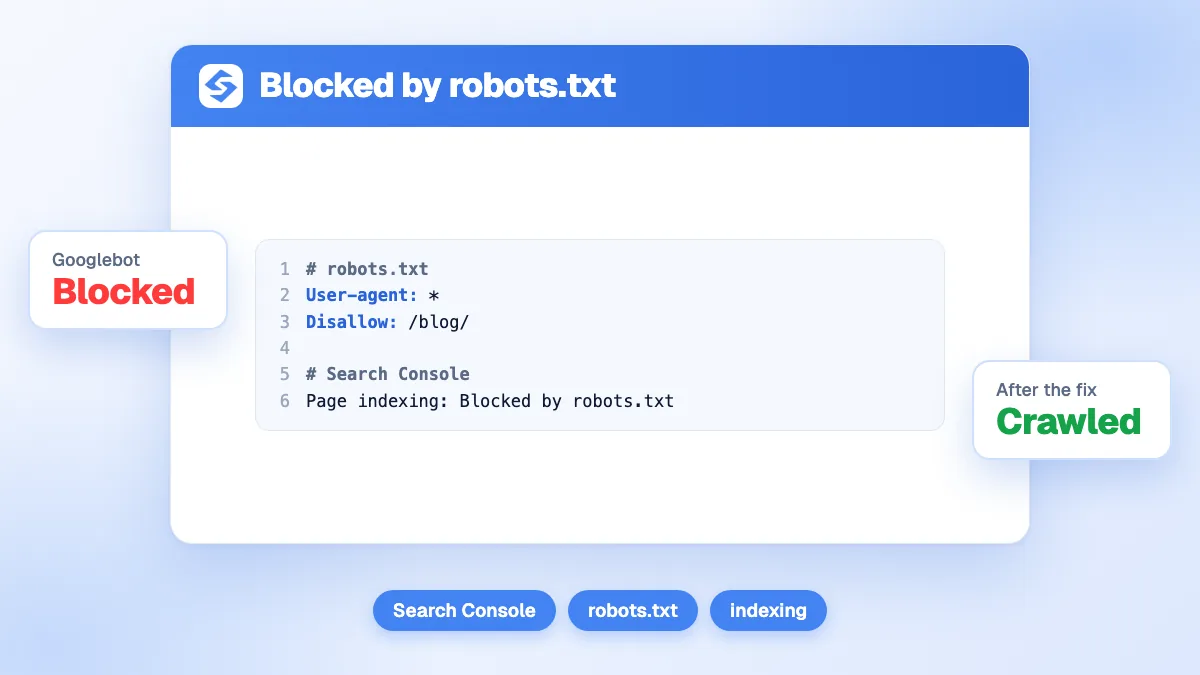
„User-agent: * / Disallow: /” pozostawione po wersji testowej, co blokuje każdego bota, w tym Googlebota.
Zablokowanie OAI-SearchBot zamiast GPTBot, co usuwa Cię z wyszukiwania ChatGPT, a nie tylko z trenowania.
Reguła ochrony przed botami w CDN lub zaporze, która zwraca 403 user agentom AI niezależnie od robots.txt. Sprawdź logi serwera.
Blokowanie CSS i JavaScriptu potrzebnych do wyrenderowania strony, przez co roboty widzą pustą powłokę.
Ważna treść ładowana wyłącznie po stronie klienta; wiele robotów AI nie wykonuje JavaScriptu, więc główny tekst umieść w HTML.
Czy robots.txt wystarczy, by być cytowanym?
Nie, on tylko otwiera drzwi. Gdy roboty mogą czytać Twoje strony, o cytowaniu decyduje to, czy te strony jasno odpowiadają na pytania, są ustrukturyzowane do wyodrębniania treści i potwierdzone przez inne źródła. Czyste dane strukturalne dla wyszukiwania AI, sekcje zaczynające się od odpowiedzi i opcjonalny plik llms.txt pomagają w następnym kroku.
Podsumowanie
Traktuj roboty AI jako osobne decyzje: otwórz boty wyszukiwania i pobierania na żądanie użytkownika, świadomie wybierz w przypadku botów trenujących i sprawdź, czy Twój serwer stosuje tę samą politykę. Potem zmierz, czy otwarte drzwi zamieniają się w cytowania. Sorank co miesiąc śledzi Twoją markę w ChatGPT, Claude i Gemini i publikuje treści ustrukturyzowane tak, by były cytowane: zacznij od 3-dniowego darmowego okresu próbnego.
Najczęściej zadawane pytania
Czy zablokowanie GPTBot usuwa moją witrynę z odpowiedzi ChatGPT?
Nie samo w sobie. GPTBot zbiera dane do trenowania modeli OpenAI. Wyszukiwanie ChatGPT opiera się na innym robocie, OAI-SearchBot, oraz na ChatGPT-User dla stron, które użytkownik prosi o otwarcie. Zablokowanie samego GPTBot ogranicza użycie do trenowania, a Twoje strony nadal mogą pojawiać się i być linkowane w wyszukiwaniu ChatGPT.
Czy Google-Extended wpływa na moje pozycje lub AI Overviews?
Nie. Google-Extended to token robots.txt, a nie osobny robot, i Google stwierdza, że nie wpływa on na uwzględnienie ani pozycje w wyszukiwarce Google. AI Overviews i Tryb AI są częścią wyszukiwarki i używają Googlebota. Google-Extended kontroluje, czy Twoje treści są używane w modelach Gemini i do ugruntowania poza wyszukiwarką.
Czy wszystkie roboty AI przestrzegają robots.txt?
Najwięksi dostawcy dokumentują swoje user agenty i deklarują, że ich roboty przestrzegają robots.txt, z niuansami dla pobrań wywołanych bezpośrednio przez użytkownika. Zgłaszano, że niektóre mniej przejrzyste boty go ignorują. Dla ścisłego egzekwowania połącz robots.txt z regułami serwera lub zapory opartymi na user agencie i opublikowanych zakresach adresów IP.
y!
Odbierz za darmo plan treści na 30 dni
Analizujemy Twoich konkurentów, Twoją stronę i Twoją widoczność w AI, aby bezpłatnie przygotować dla Ciebie dopasowany plan treści.
“Przetestowałem Sorank na prawdziwej stronie klienta i to jest szalone. Robi wszystko, za co agencja policzyłaby Ci $1500 miesięcznie. Teraz trafia na produkcję u tego klienta.”Guillaume Guersanguersanguillaume.com
“Jesteśmy agencją reklamową i chcieliśmy raz na zawsze uporządkować nasze SEO. Sorank dał nam przejrzysty obraz naszej strony, pomógł ustalić priorytety optymalizacji i właściwie uporządkować nasze treści. Narzędzie jest proste w obsłudze, dobrze zaprojektowane do pracy zespołowej i bardzo praktyczne do centralizacji monitoringu bez żonglowania wieloma platformami. Bardzo solidna podstawa, by zacząć SEO od nowa.”Gaspard MadouiAgencja reklamowa
“Dzięki Sorank wyspecjalizowałem się w GEO. Ranking GEO pozwala mi pokazywać klientom ich pozycję na tle konkurencji w ChatGPT. To realna przewaga handlowa.”MélanieFreelancer SEO
“Świetna usługa, dobrze działa dla naszej strony i pomaga zrozumieć, jak ją ulepszyć, aby lepiej pozycjonować się w Google i nie tylko. Gratulacje, tak trzymać, polecam.”Hugo T.Sprzedawca e-commerce


 Perplexity