Настройки
Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее

Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее

Как ИИ-ассистенты выбирают источники: поиск, query fan-out, что документируют OpenAI, Google, Perplexity, Anthropic и Microsoft и что показывают наши данные.
Инструменты

Коротко
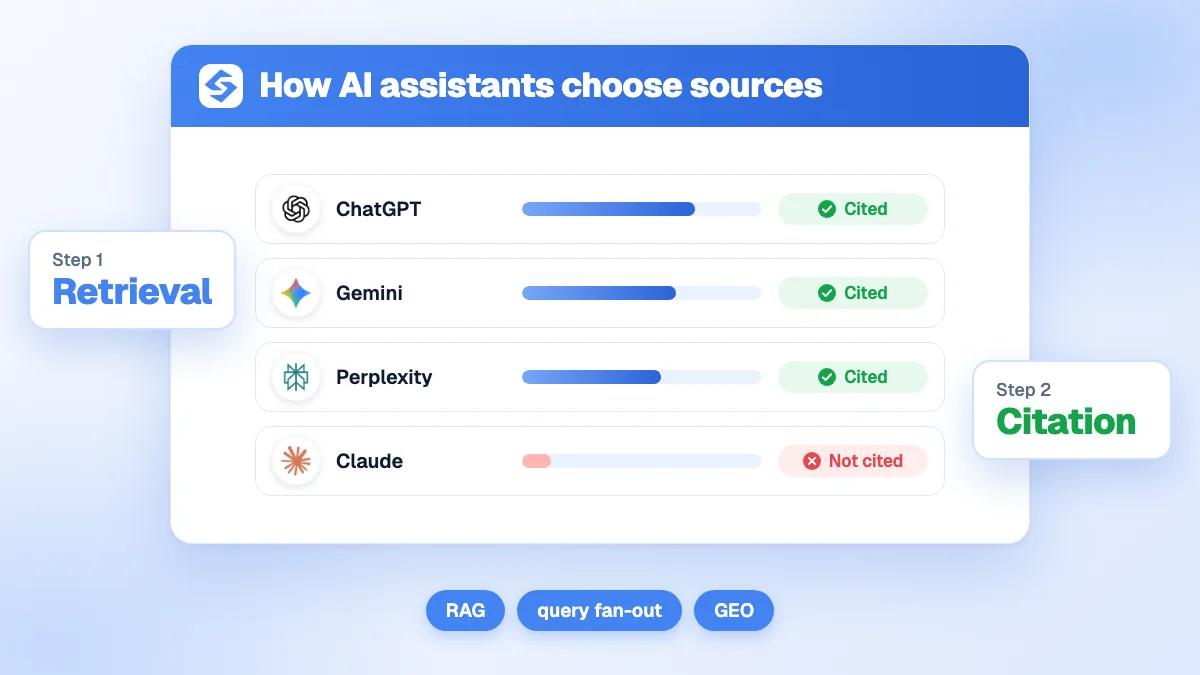
ИИ-ассистенты выбирают источники в два этапа. Сначала они ищут: модель превращает вопрос в один или несколько веб-запросов (query fan-out) и получает страницы-кандидаты из поискового индекса (Google, Bing, Brave или собственного). Затем они отбирают: модель читает фрагменты, оставляет те, что ясно и с доказательствами отвечают на подвопрос, и цитирует их. Поэтому страница должна быть доступна боту ассистента, проиндексирована, соответствовать скрытым подзапросам и легко цитироваться, а каждый ассистент предпочитает разные типы сайтов.
Хотите узнать больше? Спросите
Короткий тест
Как добиться, чтобы ChatGPT и другие ИИ упоминали вас?
Sorank подходит под ваши ответы


Попробуйте его 3 дня на своём сайте и узнайте, где вы находитесь в Google, ChatGPT и других ИИ.
Попробовать 3 дня бесплатно3 дня бесплатно, потом вы можете остановиться в любой момент. Гарантия возврата денег 90 дней.
Понимание того, как ИИ-ассистенты выбирают источники, служит отправной точкой любой работы над видимостью в ИИ. Хорошая новость: компании документируют больше, чем принято думать. Google пишет в своей документации о функциях ИИ, что AI Overviews и AI Mode могут выполнять несколько связанных поисков по подтемам, а странице достаточно быть проиндексированной и подходить для сниппета, чтобы появиться как вспомогательная ссылка. OpenAI, Perplexity, Anthropic и Microsoft публикуют похожие правила для своих ассистентов. Это руководство собирает официальное, отделяет его от догадок и добавляет то, что мы измерили на 301 025 ответах ИИ.
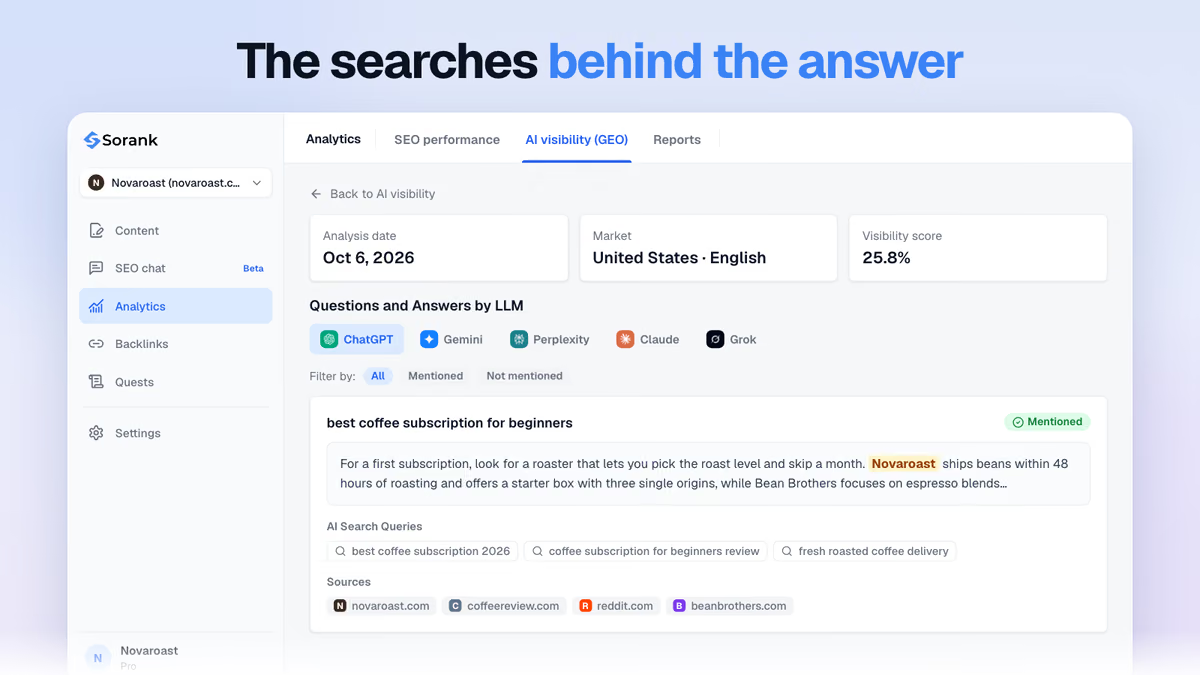
Почти каждый ассистент с доступом к вебу работает по одной схеме, которая называется генерацией с дополненным поиском (RAG): модель отвечает не только по памяти, а сначала извлекает документы и затем пишет на их основе. Шаги такие.
Отсюда два следствия. Страница, которой нет в индексе ассистента, никогда не участвует в гонке, каким бы хорошим ни было её содержание. А страница может быть первой в Google по точному вопросу пользователя и всё равно проиграть цитирование, потому что ассистент искал другое.
Ни одна из пяти компаний не публикует формулу ранжирования. Зато каждая публикует правила доступа, индексации и цитирования, и эти правила остаются единственной твёрдой почвой.
| Ассистент | Откуда берутся кандидаты | Что документирует компания |
|---|---|---|
| Google (AI Overviews, AI Mode) | Индекс Google | Query fan-out по подтемам; страница должна быть проиндексирована и подходить для сниппета; никаких особых файлов, разметки или схем не требуется |
| Поиск ChatGPT | Собственный краулер и поисковые партнёры | Сайты, блокирующие OAI-SearchBot, не показываются в поисковых ответах ChatGPT; GPTBot касается только обучения |
| Perplexity | Собственный индекс, который строит PerplexityBot | PerplexityBot показывает сайты в результатах и ссылается на них; Perplexity-User загружает страницу, когда этого требует вопрос пользователя |
| Claude | Внешний поисковый индекс (по сообщениям прессы, Brave) и боты Anthropic | Claude решает, когда искать, может искать несколько раз за запрос и всегда прикладывает цитаты |
| Microsoft Copilot | Индекс Bing | Цитаты вызываются grounding-запросами, которые видны в Bing Webmaster Tools; рекомендуется свежий, структурированный и подкреплённый источниками контент |
Документация OpenAI о краулерах различает трёх агентов. OAI-SearchBot строит поисковый индекс: сайты, которые его блокируют, не показываются в поисковых ответах ChatGPT. GPTBot собирает данные для обучения, и его блокировка не влияет на поиск. ChatGPT-User посещает страницу от имени пользователя и не определяет, что появится в поиске. Наше руководство о продвижении в ChatGPT описывает остальное.
Google говорит яснее всех: функции ИИ используют тот же индекс и те же системы качества, что и классический поиск, могут выполнять fan-out связанных поисков и показывать больше вспомогательных ссылок, чем десять синих ссылок. Специальная разметка для ИИ не нужна. Иначе говоря, SEO в Google остаётся входным билетом в ответы ИИ от Google.
Документация ботов Perplexity указывает, что PerplexityBot нужен, чтобы показывать сайты в результатах и ссылаться на них, и не используется для обучения базовых моделей. Perplexity-User загружает страницы в реальном времени для вопроса пользователя. Разрешение PerplexityBot в robots.txt является условием попадания в его индекс.
Документация Anthropic о веб-поиске точно описывает цикл: Claude определяет, когда искать, исходя из промпта, поиск может повторяться несколько раз в рамках одного запроса, а итоговый ответ всегда содержит цитаты, каждая из которых приводит до 150 символов источника. Claude ищет, когда речь идёт о текущих ценах, новостях и сведениях о конкретных компаниях или продуктах, а на устойчивые знания отвечает без поиска. Наше руководство о продвижении в Claude рассказывает о его краулерах и индексе.
Copilot опирается на Bing. С февраля 2026 года в Bing Webmaster Tools есть отчёт AI Performance, который показывает, как часто сайт цитируется в Copilot и по каким grounding-запросам были извлечены его страницы. Советы Microsoft в том же анонсе: поддерживать контент свежим (с IndexNow), структурировать его понятными заголовками, таблицами и FAQ и подкреплять утверждения данными и источниками. Смотрите наше руководство о продвижении в Copilot и руководство о продвижении в Grok, ассистенте xAI, который документирует гораздо меньше.
Важно
Многие статьи перечисляют «факторы ранжирования» ответов ИИ с весами в процентах. Ни одна компания таких весов не публиковала. Считайте любую точную формулу гипотезой и опирайтесь на задокументированные правила выше и на собственные измерения.
Если сопоставить официальную документацию с тем, что видно в ответах, шесть критериев объясняют большинство цитат. Первые два являются задокументированными требованиями, остальные устойчивыми закономерностями.
Поисковый бот ассистента должен быть разрешён, а страница должна находиться в индексе, к которому он обращается: в индексе Google для Gemini и AI Overviews, Bing для Copilot, в собственных индексах OpenAI и Perplexity, в Brave для Claude. Проверьте свои правила по нашему руководству о robots.txt для ИИ-краулеров.
Извлечение идёт по запросам fan-out, а не по фразе пользователя. Страница, которая в общем отвечает на «лучшая CRM», может проиграть странице, отвечающей на «CRM для агентства недвижимости из 5 человек, цена за пользователя», потому что ассистент искал именно это.
ИИ цитирует фрагменты. Раздел, который начинается с прямого ответа, определения, строки таблицы или пронумерованного шага, можно вынуть из страницы, и он сохранит смысл. Расплывчатое вступление нельзя.
Claude ищет как раз тогда, когда информация могла измениться, а Microsoft советует подкреплять утверждения данными и источниками. Датированные цифры, названные источники, цены, «проверенные» на определённую дату, и видимые даты обновления делают страницу более надёжной для цитирования.
Ассистент, который находит один и тот же факт на нескольких независимых сайтах, может уверенно его утверждать. Это консенсус сущности: отзывы, сравнения, каталоги и упоминания в прессе, которые описывают ваш бренд одинаково.
У каждого ассистента свои привычки. Одни опираются на энциклопедические источники, другие на видео, форумы или платформы отзывов. Следующий раздел показывает, насколько велики эти различия.
Совет
Прежде чем писать страницу ради видимости в ИИ, задайте вопрос двум или трём ассистентам и запишите поиски, которые они выполняют, и сайты, которые они цитируют. Поиски подскажут, какой угол раскрыть; цитируемые сайты покажут, какой формат выигрывает.
Наше исследование платформ, которые цитирует ИИ, проанализировало 301 025 ответов ChatGPT, Gemini, Perplexity, Claude и Grok, собранных с августа 2025 по август 2026 года на панели вопросов покупателей (79% заданы на французском). Оно насчитало 1 820 738 цитирований ИИ, ведущих на 131 349 различных доменов. Для выбора источников важны два вывода.
Во-первых, ассистенты цитируют разное число источников. Gemini называет в среднем 11,1 источника на ответ, Grok 7,1, ChatGPT 4,1, Claude 3,5 и Perplexity 3,3. У последних трёх вопрос даёт три-четыре места: быть второй лучшей страницей часто означает не попасть в цитаты вовсе.
| Платформа | ChatGPT | Gemini | Perplexity | Claude | Grok |
|---|---|---|---|---|---|
| Wikipedia | 3,43% | 1,38% | 0,19% | 0,03% | 1,08% |
| YouTube | 0,04% | 3,69% | 3,46% | 0% | 2,76% |
| 0,33% | 2,5% | 1,51% | 0% | 4,11% | |
| Trustpilot | 2,7% | 4,33% | 1,21% | 1,57% | 1,8% |
Во-вторых, предпочитаемые типы источников полностью различаются от ассистента к ассистенту. Wikipedia встречается в 3,43% ответов ChatGPT и в 0,03% ответов Claude; YouTube в 3,69% ответов Gemini и в 0,04% ответов ChatGPT. Только 6 платформ цитируют все пять моделей. Наше исследование цитирования ChatGPT также показывает, что отбор меняется со временем: за период ChatGPT перешёл с 5,8 на 4,1 источника на ответ, с минимумом 1,7 в июне 2026 года.
Процесс отбора сводится к короткому списку действий, которые работают и для Google, и для ИИ.
Пример
Покупатель спрашивает: «какая бухгалтерская программа подойдёт фрилансеру?». Ассистент ищет «бухгалтерия для фрилансера цена» и «сравнение сервисов выставления счетов». Компания с публичной страницей цен и сравнением, датированным этим годом, соответствует обоим поискам; компания, у которой на главной только слоган, не соответствует ни одному.
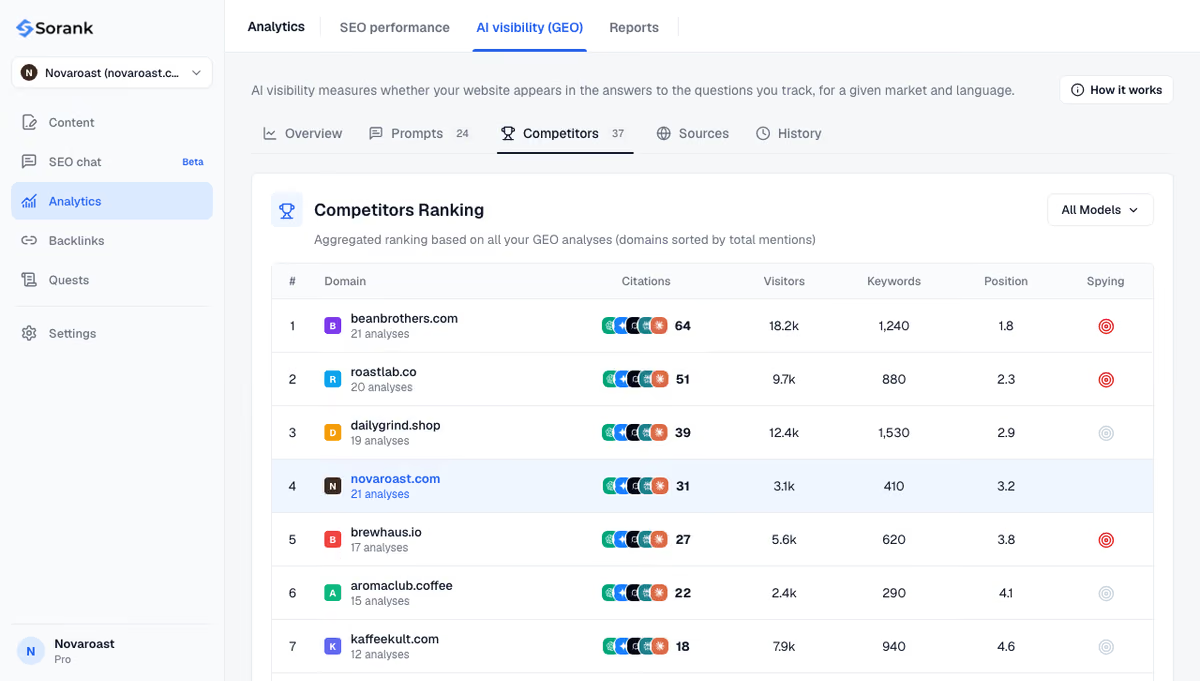
Ответы меняются от запуска к запуску, поэтому отбор источников лучше наблюдать неделями. Функция «Разветвление запросов в ИИ» в Sorank записывает поиски, которые каждый ассистент выполняет по вашим промптам, и считает их во времени, а отслеживание упоминаний в ИИ показывает, цитируется ли ваш бренд и какие источники занимают место, когда нет. ИИ-ассистенты выбирают страницы, до которых могут добраться, которые соответствуют их скрытым поискам и которые доказывают сказанное: измерьте эти три пункта на своих вопросах, и вы будете знать, что исправить.

Зависит от ассистента. AI Overviews, AI Mode и Gemini используют индекс Google, Microsoft Copilot опирается на Bing, у ChatGPT и Perplexity собственные краулеры и индексы, а Claude, по сообщениям прессы, использует Brave Search. Страница, хорошо проиндексированная в Google и Bing, покрывает большинство случаев при условии, что бот каждого ассистента тоже разрешён.
Нет. Ассистенты ищут по собственным переформулированным запросам и цитируют фрагменты, а не позиции. Страница, первая по точному вопросу пользователя, может быть пропущена, если она не отвечает на подвопрос, который искал ассистент, или если другая страница излагает ответ яснее и с доказательствами. Хорошие позиции в Google повышают шансы, но ничего не гарантируют.
Они используют разные индексы, выполняют разные поиски и предпочитают разные источники. Наше исследование 301 025 ответов показывает, например, что Wikipedia встречается в 3,43% ответов ChatGPT, но лишь в 0,03% ответов Claude, а YouTube часто появляется в Gemini и почти отсутствует в ChatGPT. Оптимизация под одного ассистента не переносится автоматически на остальных.
Мы бесплатно анализируем ваших конкурентов, ваш сайт и вашу видимость в ИИ и составляем персональный контент-план.
 ИИ-генератор брифа для контента
 Генератор схемы FAQ
 ИИ-генератор идей для постов в блоге
 Валидатор структурированных данных (валидатор Schema)
 Проверка альтернативного текста
 Анализатор внутренних ссылок
 Челлендж по обратным ссылкам
 ИИ-генератор метаописаний
 ИИ-генератор заголовков для блога
 Проверка индексируемости в Google
 ИИ-генератор плана статьи для блога
 Конструктор UTM-ссылок
 Инструмент кластеризации ключевых слов
 Проверка тега canonical
 Генератор XML-карты сайта
 Проверка битых ссылок
 ИИ-генератор SEO-заголовков
 Анализатор заголовков
 Предпросмотр поисковой выдачи
 Проверка редиректов
 Генератор тегов hreflang
 Анализатор структуры заголовков
 Проверка HTTP-заголовков
 Экстрактор фавиконок
 Калькулятор CTR в выдаче
 Калькулятор экономии SEO в сравнении с платным поиском
 Калькулятор доли голоса в SEO
 Калькулятор ROI от SEO
 Калькулятор прогноза трафика и выручки от SEO
 Калькулятор бюджета на SEO
 Калькулятор точки безубыточности SEO
 Калькулятор ROI от SEO для SaaS
 Калькулятор ROAS
 Калькулятор времени чтения
 Симулятор прироста позиций
 Калькулятор стоимости органического трафика
 Оценка органического трафика и проверка посещаемости сайта
 Калькулятор соотношения LTV к CAC
 Калькулятор ROI от локального SEO
 Калькулятор стоимости линкбилдинга
 Калькулятор ценности ключевого слова
 Калькулятор оценки возможностей ключевого слова
 Калькулятор плотности ключевых слов
 Калькулятор ROI от GEO
 Калькулятор инвестиций в GEO-контент
 Калькулятор ROI от SEO для интернет-магазина
 Калькулятор пожизненной ценности клиента
 Калькулятор стоимости привлечения клиента
 Калькулятор CTR
 Калькулятор стоимости статьи
 Калькулятор коэффициента конверсии
 Калькулятор ROI контент-маркетинга
 Оценка реферального трафика из ChatGPT
 Калькулятор показателя отказов
 Калькулятор ROI обратных ссылок
 Калькулятор AI Visibility Score
 Калькулятор стоимости AI-трафика
 Калькулятор доли голоса в ИИ
 Калькулятор стоимости невидимости в ИИ
 Калькулятор частоты цитирования в ИИ
 Валидатор llms.txt
 Проверка AI Overview и позиций в AI Overviews
 Проверка robots.txt
 ИИ SEO-аудит
 Проверка читаемости для LLM
 Проверка готовности к SearchGPT
 Аудит структурированных данных для LLM
 Аудит доступности сайта для ИИ-роботов
 Почему ChatGPT не рекомендует мой сайт
 Инструмент позиций в Gemini
 Проверка позиций в Perplexity
 Проверка цитирования в LLM
 Аудит Answer Engine Optimization
 GEO-аудит
 Тест видимости в ИИ-поиске
 Проверка видимости в ChatGPT
 Генератор llms.txt
 Извлечение URL
 Веб-страница в Markdown
 Проверка карты сайта
 Датчик волатильности выдачи
 Проверка размера страницы
 Счётчик слов
 Генератор slug
 Генератор Schema
 Генератор robots
 Предпросмотр OG
 Генератор метатегов
 Компрессор изображений
 Генератор фавиконок
 Аудит внутренней SEO-оптимизации: SEO-проверка и SEO-анализ
 Инструмент анализа обратных ссылок
 Инструмент подбора ключевых слов
 Проверка авторитета домена
ОНИ ПОПРОБОВАЛИ SORANK ДО ВАС
 “Я протестировал Sorank на реальном клиентском сайте, и это потрясающе. Он делает всё то, за что агентство выставило бы вам счёт на $1500 в месяц. Теперь он запускается в работу на этом клиенте.”

 Guillaume Guersanguersanguillaume.com“Мы рекламное агентство и хотели раз и навсегда вернуть своё SEO в нужное русло. Sorank дал нам чёткое представление о нашем сайте, помог расставить приоритеты в оптимизации и правильно структурировать наш контент. Инструмент прост в использовании, хорошо продуман для работы в команде и очень удобен для централизованного отслеживания без необходимости жонглировать несколькими платформами. Очень прочная основа, чтобы начать наше SEO с чистого листа.”
 Gaspard MadouiРекламное агентство
 “Я просто позволил программе Sorank делать своё дело, и теперь мой показатель DR равен 25, а моя страница ранжируется выше.”
 Lucas Flandrefoundertrace.fr“Я специализировался на GEO благодаря Sorank. Рейтинг GEO позволяет мне показывать клиентам их позицию относительно конкурентов в ChatGPT. Это реальное коммерческое преимущество.”
 MélanieФрилансер по SEO“Отличный сервис, хорошо подходит для нашего сайта и помогает понять, как его улучшить, чтобы лучше ранжироваться в Google и не только. Поздравляю, так держать, рекомендую.”
 Hugo T.Владелец интернет-магазина