
Настройки
Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее

Конфиденциальность важна для нас, поэтому вы можете отключить отдельные виды хранения данных, которые не нужны для базовой работы сайта. Блокировка некоторых категорий может повлиять на ваше впечатление от сайта. Подробнее

Query Fanout (расщепление запроса): так ИИ-поиск делит один вопрос на множество параллельных подзапросов. Узнайте, как это работает и как попасть в цитаты ответа.






Инструменты


Кратко
Query Fanout это приём, при котором система ИИ-поиска разбивает один вопрос на множество связанных подзапросов, выполняет их параллельно по многим источникам и объединяет результаты в один исчерпывающий ответ.
Хотите узнать больше? Спросите
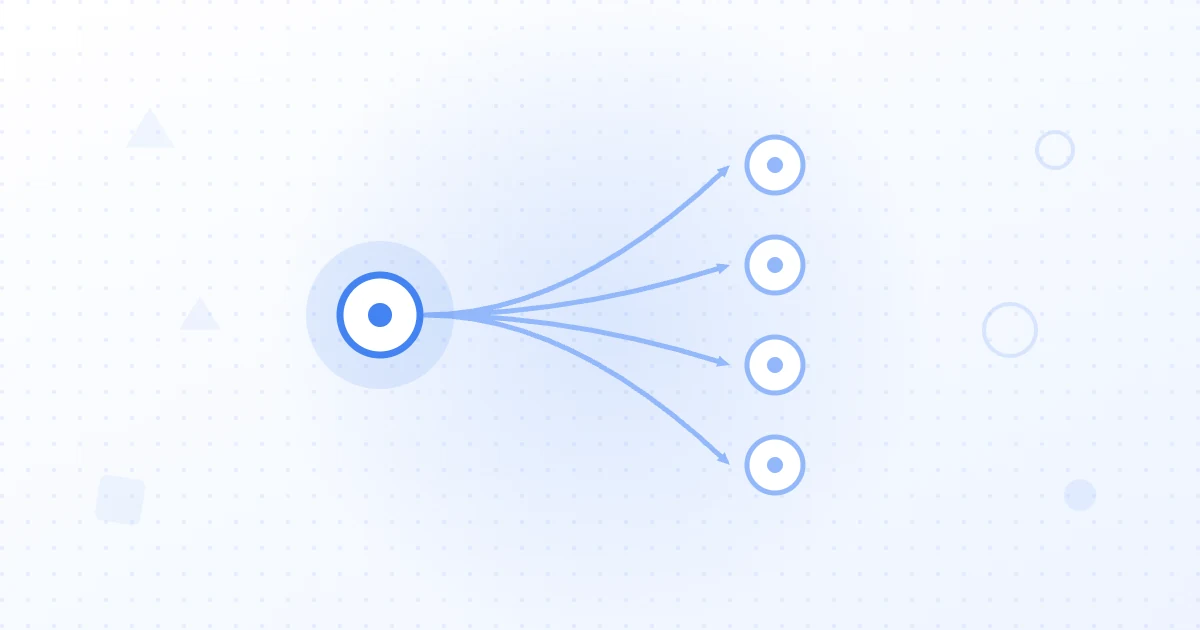
Query Fanout это набор одновременных связанных запросов, которые ИИ-модель формирует, чтобы собрать больше информации, чем вернул бы один поиск. Вместо того чтобы отвечать на ваш вопрос одним обращением, система раскладывает его на подтемы, одновременно отправляет множество запросов от вашего имени, берёт контент из многих источников и объединяет находки в один связный ответ.
Это двигатель режима AI Mode в Google и подобных систем, и он меняет саму логику видимости. Когда один вопрос превращается в десяток поисков, страница, которую нужно выиграть, это уже не страница, ранжирующаяся по исходной фразе, а страница, лучше всех отвечающая на один из многих подвопросов, которые придумывает модель.
Query Fanout, иногда пишут query fan-out, это метод информационного поиска, который расширяет один запрос пользователя до нескольких подзапросов, охватывающих разные грани намерения. Google описывает это как разбиение вопроса на подтемы и одновременную отправку множества запросов. Цель: охват. Исследуя несколько ракурсов сразу, система собирает более полный и лучше обоснованный ответ, чем мог бы дать любой отдельный результат.
Не каждый вопрос запускает сильное расщепление. Простой фактологический запрос, например столица страны, может не требовать его почти совсем, тогда как сложный, сравнительный или открытый вопрос расщепляется широко. Модель решает, насколько расширять запрос, исходя из его сложности и намерения.
Процесс идёт по этапам. Сначала система анализирует запрос методами обработки естественного языка, чтобы понять намерение, сложность и необходимость расщепления. Затем она формирует подзапросы, исследующие альтернативные формулировки, подтемы и вероятные уточняющие вопросы. Каждый подзапрос направляется в подходящий источник: от живого веба и графа знаний до отзывов, форумов, товарных фидов и расшифровок видео.
Принципиально важно, что эти поиски выполняются параллельно, а не друг за другом, и именно этим расщепление отличается от одиночного обращения. Затем система выполняет синтез из нескольких источников, извлекая самодостаточные, насыщенные фактами фрагменты из многих страниц и сплетая их в один ответ. Весь этот цикл питает AI Mode и сопоставимые генеративные сервисы.
Возьмём вопрос «как избавиться от сорняков на газоне». Google использовал именно этот пример: расщепление может включать «лучшие гербициды для газонов», «удалить сорняки без химии» и «как предотвратить появление сорняков на газоне». Вопрос о покупке Bluetooth-наушников может расщепиться на комфорт, время работы от батареи, отзывы, сравнения, цену и шумоизоляцию.
Каждый из этих подзапросов берёт данные потенциально с разных страниц, поэтому итоговый ответ может цитировать полдюжины источников, ни один из которых не был первым по исходному вопросу. В этом практическая суть того, почему расщепление меняет видимость.
Число зависит от сложности. Отраслевой анализ показывает, что системы обычно формируют около 5-11 подзапросов на один запрос, а иногда гораздо больше, и, по имеющимся данным, Gemini может разбить один запрос примерно на десяток и более параллельных подзапросов. Сложные темы увеличивают это число.
Точная цифра важна меньше, чем вывод: один вопрос теперь открывает множество дверей в ваш контент. Каждый подзапрос это новая возможность быть найденным и процитированным, и это поощряет широту охвата, а не одну страницу с точным вхождением.
Расщепление, как правило, следует узнаваемым шаблонам. Сравнительные подзапросы сопоставляют один вариант с другим, подзапросы об отзывах ищут мнения и оценки, а подзапросы о свежести добавляют модификаторы текущего года, чтобы найти последнюю информацию. Варианты по сценариям использования исследуют бюджет, уровень подготовки или конкретные ситуации, а альтернативные подзапросы ищут другие варианты, которые пользователь не назвал.
Знание этих шаблонов позволяет их предугадывать. Если вы можете предсказать подзапросы, которые породит тема, вы можете создать контент, прямо отвечающий на каждый, и в этом суть картирования темы с помощью подробной тематической карты.
Расщепление разрушает старую модель «одно ключевое слово, одна страница». Чтобы быть видимым, контент должен охватывать весь кластер вопросов вокруг темы, а не только основной запрос, потому что модель ищет ответы на собственные подзапросы. Цитаты внутри синтезированного ответа становятся новым уровнем видимости, и завоёвываются они на уровне подвопросов.
Это делает тематический авторитет решающим. Сайт, который исчерпывающе охватывает предмет, с чётким ответом на каждую грань и смысловыми связями, даёт модели много шансов найти его в ходе расщепления. Согласование такого охвата с реальными запросами, которые задают люди, при поддержке структурированного подбора ключевых слов и планирования контента, помогает брендам оставаться заметными, когда один вопрос превращается во множество.
Начните с создания тематических кластеров, которые отвечают на несколько подвопросов, а не отдельных изолированных страниц, и структурируйте каждую страницу на извлекаемые фрагменты с чёткими заголовками, списками и таблицами, чтобы модель могла взять чистый ответ. Отвечайте на вопросы прямо и в начале, создавайте явный контент со сравнениями и отзывами и добавляйте признаки свежести там, где важна актуальность. Google также советует предлагать самобытные материалы экспертов, а не перерабатывать общеизвестные знания.
Два предостережения Google стоит учесть. Чтобы появляться в ИИ-функциях, страницы должны быть проиндексированы, общедоступны и доступны для сканирования, а множить почти одинаковые страницы, чтобы обмануть систему, нельзя: это нарушает политику против спама. Некоторые из таких расширений при извлечении напоминают запросы для заземления, поэтому чистый, фактический, хорошо разбитый на фрагменты контент остаётся долговечным преимуществом.
Query Fanout превращает один вопрос во множество параллельных подзапросов, берёт фрагменты из многих источников и синтезирует единый ответ, и именно так на самом деле работает современный ИИ-поиск. Видимость теперь зависит от ответов на весь кластер подвопросов, которые порождает тема, а не только от ранжирования по одной фразе, и призом становятся цитаты внутри ответа.
Выигрышный ход: исчерпывающий, хорошо структурированный тематический охват, построенный вокруг подзапросов, которые порождает предмет, при поддержке инструментов исследования и планирования контента Sorank. Источники: Aleyda Solis, Similarweb и Google Search Central.
Источники

Query Fanout: это когда система ИИ-поиска берёт ваш единственный вопрос и незаметно делит его на множество связанных подвопросов, а затем выполняет их все сразу по разным источникам. Она собирает лучшие фрагменты из каждого поиска и объединяет их в один ответ. Смысл в том, чтобы охватить тему с разных сторон, а не полагаться на единственное обращение.
Это зависит от сложности вопроса. Анализ показывает, что системы часто формируют около 5-11 подзапросов на один запрос, а иногда и больше, и, по имеющимся данным, Gemini может создавать примерно десяток и более для сложных вопросов. Простые фактологические запросы могут почти не запускать расщепления, а открытые или сравнительные расщепляются сильнее всего.
Охватывайте тему целиком, а не одно ключевое слово, чтобы ваш контент мог отвечать на многие подвопросы, порождаемые запросом. Структурируйте страницы на чёткие самодостаточные фрагменты с заголовками, списками и таблицами и отвечайте на каждый вопрос прямо. Наращивайте тематический авторитет с помощью контента со сравнениями и отзывами, держите страницы доступными для сканирования и индексации и не плодите почти одинаковые страницы, чтобы обмануть систему.
ОНИ ПОПРОБОВАЛИ SORANK ДО ВАС
 “Я протестировал Sorank на реальном клиентском сайте, и это потрясающе. Он делает всё то, за что агентство выставило бы вам счёт на $1500 в месяц. Теперь он запускается в работу на этом клиенте.”

 Guillaume Guersanguersanguillaume.com“Мы рекламное агентство и хотели раз и навсегда вернуть своё SEO в нужное русло. Sorank дал нам чёткое представление о нашем сайте, помог расставить приоритеты в оптимизации и правильно структурировать наш контент. Инструмент прост в использовании, хорошо продуман для работы в команде и очень удобен для централизованного отслеживания без необходимости жонглировать несколькими платформами. Очень прочная основа, чтобы начать наше SEO с чистого листа.”
 Gaspard MadouiРекламное агентство
 “Я просто позволил программе Sorank делать своё дело, и теперь мой показатель DR равен 25, а моя страница ранжируется выше.”
 Lucas Flandrefoundertrace.fr“Я специализировался на GEO благодаря Sorank. Рейтинг GEO позволяет мне показывать клиентам их позицию относительно конкурентов в ChatGPT. Это реальное коммерческое преимущество.”
 MélanieФрилансер по SEO“Отличный сервис, хорошо подходит для нашего сайта и помогает понять, как его улучшить, чтобы лучше ранжироваться в Google и не только. Поздравляю, так держать, рекомендую.”
 Hugo T.Владелец интернет-магазина



















