
Præferencer
Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Privatliv er vigtigt for os, så du kan vælge at slå visse typer lagring fra, som ikke er nødvendige for, at websitet fungerer grundlæggende. Hvis du blokerer kategorier, kan det påvirke din oplevelse af websitet. Mere information

Query fanout er den måde, AI-søgning deler ét spørgsmål op i mange delforespørgsler, der køres parallelt. Lær hvordan det virker, og hvordan du bliver citeret i svaret.






Værktøjer


Grundlægger af Sorank, 7+ års erfaring inden for SEO, GEO-entusiast.
Resumé
Query fanout er en teknik, hvor et AI-søgesystem bryder ét spørgsmål op i mange beslægtede delforespørgsler, kører dem parallelt mod mange kilder og syntetiserer resultaterne til ét samlet svar.
Vil du vide mere? Spørg
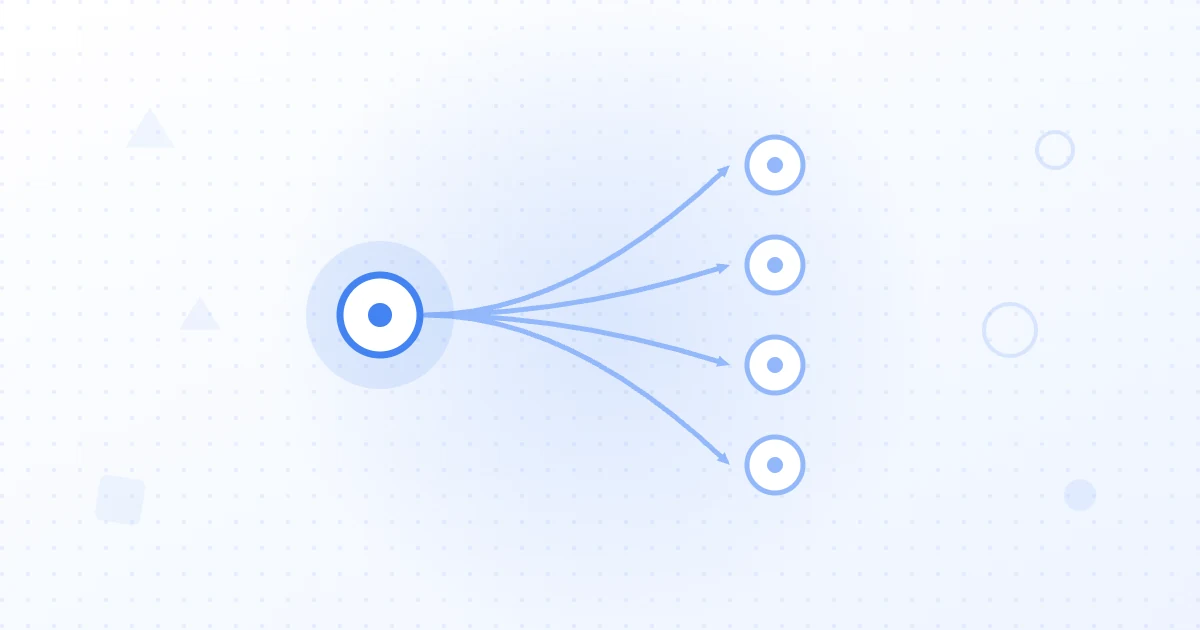
Query fanout er et sæt samtidige, beslægtede forespørgsler, som en AI-model genererer for at indsamle mere information, end én enkelt søgning ville give. I stedet for at besvare dit spørgsmål med ét opslag nedbryder systemet det i delemner, sender en lang række forespørgsler på dine vegne på én gang, henter indhold fra mange kilder og samler resultaterne i ét sammenhængende svar.
Det er motoren bag Googles AI-tilstand og lignende systemer, og det ændrer, hvordan synlighed fungerer. Når ét spørgsmål bliver til et dusin søgninger, er siden, du skal vinde, ikke længere den, der rangerer på den oprindelige formulering, men den, der bedst besvarer et af de mange delspørgsmål, modellen selv finder på.
Query fanout, nogle gange skrevet query fan-out, er en informationssøgningsmetode, der udvider en enkelt brugerforespørgsel til flere delforespørgsler, der dækker forskellige facetter af intentionen. Google beskriver det som at bryde dit spørgsmål op i delemner og sende mange forespørgsler samtidig. Målet er dækning: ved at undersøge flere vinkler på én gang sætter systemet et fyldigere og bedre underbygget svar sammen, end noget enkelt resultat kunne give.
Ikke alle spørgsmål udløser kraftig fanout. Et simpelt faktuelt spørgsmål som hovedstaden i et land har måske næsten ingen brug for det, mens et komplekst, sammenlignende eller åbent spørgsmål fanner bredt ud. Modellen bestemmer, hvor langt den udvider, ud fra spørgsmålets kompleksitet og intention.
Processen foregår i trin. Først analyserer systemet queryen med sprogteknologi for at læse intentionen, kompleksiteten og om fanout er nødvendig. Derefter genererer det delforespørgsler, der udforsker alternative formuleringer, delemner og sandsynlige opfølgende spørgsmål. Hver delforespørgsel sendes til en passende kilde, fra det levende web og vidensgrafen til anmeldelser, fora, shoppingfeeds og transskriptioner af video.
Det afgørende er, at søgningerne kører parallelt og ikke efter hinanden, og det adskiller fanout fra et enkelt opslag. Systemet udfører derefter syntese fra flere kilder, hvor selvstændige, faktatætte stykker udtrækkes fra mange sider og væves sammen til ét svar. Hele denne løkke driver AI-tilstand og sammenlignelige generative oplevelser.
Tag spørgsmålet hvordan man fjerner ukrudt i en plæne fuld af ukrudt. Google har brugt netop dette eksempel: fanout kan omfatte de bedste ukrudtsmidler til plæner, fjern ukrudt uden kemikalier og hvordan man forebygger ukrudt i plæner. Et shoppingspørgsmål om trådløse høretelefoner kan forgrene sig ud i komfort, batteritid, anmeldelser, sammenligninger, priser og støjisolering.
Hver af disse delforespørgsler henter potentielt fra forskellige sider, så det endelige svar kan citere et halvt dusin kilder, hvoraf ingen rangerede først på det oprindelige spørgsmål. Det er den praktiske kerne i, hvorfor fanout ændrer synligheden.
Antallet varierer med kompleksiteten. Branchens analyser tyder på, at systemer typisk genererer omkring 5 til 11 delforespørgsler pr. prompt, og nogle gange langt flere, med rapporter om, at Gemini kan nedbryde en enkelt query i cirka et dusin eller flere parallelle delforespørgsler. Komplekse emner trækker tallet op.
Det præcise tal betyder mindre end konsekvensen: ét spørgsmål åbner nu mange døre ind til dit indhold. Hver delforespørgsel er en ny chance for at blive hentet og citeret, og det belønner bredde i dækningen frem for en enkelt side med eksakt match.
Fanout følger tit genkendelige mønstre. Sammenlignende delforespørgsler undersøger den ene mulighed mod den anden, anmeldelsesbaserede delforespørgsler søger meninger og bedømmelser, og friskhedsdelforespørgsler tilføjer modifikatorer for det aktuelle år for at finde de nyeste oplysninger. Brugsvariationer udforsker budget, færdighedsniveau eller bestemte scenarier, og alternative delforespørgsler leder efter andre muligheder, som brugeren ikke har nævnt.
Når du kender disse mønstre, kan du forudse dem. Kan du forudsige de delforespørgsler, et emne vil udløse, kan du bygge indhold, der besvarer hver enkelt direkte, og det er kernen i at kortlægge et emne med et grundigt emnekort.
Fanout opløser den gamle model med ét søgeord og én side. For at blive synlig skal indholdet tage fat på hele klyngen af spørgsmål omkring et emne, ikke kun hovedbegrebet, fordi modellen søger efter svar på sine egne delforespørgsler. Citater i det syntetiserede svar bliver det nye synlighedslag, og de vindes på delspørgsmålsniveau.
Det gør emnemæssig autoritet afgørende. Et site, der dækker et emne udtømmende, med hver facet besvaret klart og forbundet semantisk, giver modellen mange chancer for at finde det på tværs af fanout. At matche den dækning med de queries, folk faktisk stiller, understøttet af struktureret søgeordsanalyse og indholdsplanlægning, er måden, hvorpå brands forbliver til stede, når ét spørgsmål bliver til mange.
Start med at bygge emneklynger, der dækker flere delintentioner frem for isolerede sider, og strukturér hver side i stykker, der kan udtrækkes, med tydelige overskrifter, lister og tabeller, så modellen kan løfte et rent svar. Besvar spørgsmål direkte og tidligt, lav eksplicit sammenligningsindhold og anmeldelser, og tilføj friskhedssignaler, hvor aktualitet betyder noget. Google anbefaler også at tilbyde særpræget, ekspertdrevet materiale frem for at genbruge almen viden.
To forbehold fra Google er værd at tage alvorligt. Sider skal være indekseret, offentligt tilgængelige og crawlbare for at vises i AI-funktioner, og du bør ikke oprette mange næsten identiske sider for at snyde systemet, hvilket er i strid med spampolitikkerne. Nogle af disse udvidelser under hentning ligner grounding-queries, så rent, faktuelt og godt opdelt indhold er den varige fordel.
Query fanout gør ét spørgsmål til mange samtidige delforespørgsler, henter stykker fra mange kilder og syntetiserer ét svar, og det er sådan moderne AI-søgning faktisk virker. Synlighed afhænger nu af at besvare hele klyngen af delspørgsmål, et emne skaber, og ikke blot af at rangere på ét udtryk, og citater i svaret er præmien.
Den vindende løsning er udtømmende, velstruktureret emnedækning bygget omkring de delforespørgsler, et emne udløser, understøttet af Sorank's værktøjer til analyse og indholdsplanlægning. Referencekilder: Aleyda Solis, Similarweb og Google Search Central.
Kilder

Query fanout er, når et AI-søgesystem tager dit ene spørgsmål og stille og roligt deler det op i mange beslægtede delspørgsmål, og derefter kører dem alle samtidig på tværs af forskellige kilder. Det samler de bedste stykker fra hver søgning og sætter dem sammen i ét svar. Pointen er at dække et emne fra mange vinkler i stedet for at stole på ét enkelt opslag.
Det afhænger af, hvor kompleks spørgsmålet er. Analyser tyder på, at systemer ofte genererer omkring 5 til 11 delforespørgsler pr. prompt, og nogle gange flere, og der er rapporter om, at Gemini kan lave cirka et dusin eller flere ved komplekse spørgsmål. Simple faktuelle queries udløser måske lidt eller ingen fanout, mens åbne eller sammenlignende spørgsmål fanner bredest ud.
Dæk hele emnet, ikke kun ét søgeord, så dit indhold kan besvare de mange delspørgsmål, en query skaber. Strukturér sider i klare, selvstændige stykker med overskrifter, lister og tabeller, og besvar hvert spørgsmål direkte. Opbyg emnemæssig autoritet med sammenligningsindhold og anmeldelser, hold siderne crawlbare og indekserede, og undgå at oprette næsten identiske sider for at snyde systemet.
DE PRØVEDE SORANK, FØR DU GJORDE DET
 “Jeg testede Sorank på en rigtig kundes site, og det er vanvittigt. Det gør alt, et bureau ville opkræve dig 1500 dollar om måneden for. Det går nu i produktion på den kunde.”

 Guillaume Guersanguersanguillaume.com“Vi er et annoncebureau, og vi ville have vores SEO på rette spor en gang for alle. Sorank gav os et klart overblik over vores site, hjalp os med at prioritere optimeringer og strukturere vores indhold ordentligt. Værktøjet er nemt at bruge, velegnet til et team og meget praktisk til at samle opfølgningen et sted uden at jonglere med flere platforme. Et meget solidt fundament til at starte forfra med vores SEO.”
 Gaspard MadouiAnnoncebureau
 “Jeg lod bare Sorank-softwaren gøre sit arbejde, og nu er min DR 25, og min side rangerer højere.”
 Lucas Flandrefoundertrace.fr“Jeg specialiserede mig i GEO takket være Sorank. GEO-ranglisten gør det muligt at vise mine kunder deres placering i forhold til konkurrenterne på ChatGPT. Det er en reel kommerciel fordel.”
 MélanieSEO-freelancer“Fantastisk service, den virker godt til vores hjemmeside og hjælper os med at forstå, hvordan vi kan forbedre den for at rangere bedre på Google og andre steder. Tillykke, bliv ved, jeg anbefaler det.”
 Hugo T.Netbutiksejer


















